VFACamou: Видо-интегрированная состязательная маскировка для физического уклонения с адаптацией к среде
Аннотация
Состязательная маскировка в физическом мире остается крайне сложной задачей, особенно в условиях разведки с помощью UAV, где цели претерпевают непрерывные геометрические изменения и экстремальные колебания освещенности. Существующие методы либо оптимизируют двумерные цифровые возмущения, которые не способны обобщаться на динамические точки обзора, либо создают визуально неестественные текстуры, которые невозможно применить в реальных сценариях. Поэтому мы предлагаем VFACamou, сквозную структуру для генерации состязательной маскировки, которая автоматически создает носимые состязательные паттерны и поддерживает стабильную эффективность атаки в реальных физических условиях при изменяющихся точках обзора, позах и условиях освещения. Наш метод объединяет UV-объемный рендеринг с генератором текстур на основе диффузии, обеспечивая согласованный внешний вид при различных масштабах, позах и условиях освещения. Для обеспечения экологического реализма мы предлагаем оценщик согласованности освещения и цвета, который извлекает доминирующие атрибуты фона и направляет функцию потерь естественной текстуры для приведения сгенерированной UV-текстуры в соответствие с окружающей средой. Многомасштабная стратегия динамического обучения дополнительно повышает устойчивость к смещениям точки обзора и деформации тела. Обширные эксперименты с использованием нескольких основных детекторов демонстрируют, что VFACamou достигает высокой и стабильной эффективности физической атаки, сохраняя при этом высокую перцептивную естественность и снижая показатели обнаружения человеком без внесения неестественных артефактов..
Предметные рубрики:
Физический состязательный камуфляж, обнаружение людей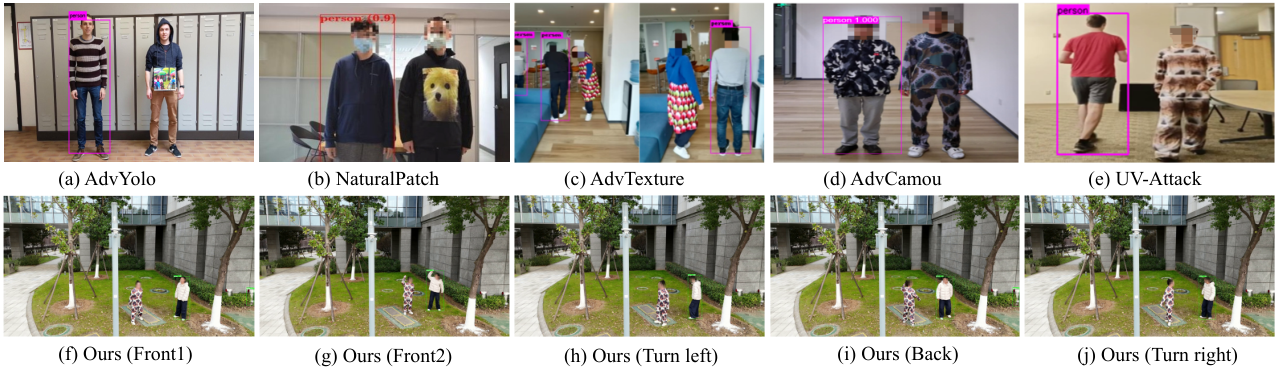
I Введение
С быстрым развитием deep learning беспилотные летательные аппараты, оснащенные интеллектуальными системами технического зрения, играют все более важную роль в патрулировании границ, мониторинге территорий и ситуационной осведомленности[22, 18, 1]. Недавние исследования показывают, что современные детекторы объектов сталкиваются с различными рисками безопасности [37, 4, 25, 35, 36, 29, 28, 11, 27, 34, 32] и крайне уязвимы к adversarial attacks, при которых тщательно созданные возмущения могут ввести детекторы в заблуждение[43, 40, 31, 20, 10, 21]. В военных сценариях создание эффективного adversarial camouflage для защиты персонала от автоматического обнаружения имеет существенное значение[38, 42]⟧.
Существующие состязательные атаки демонстрируют заметные ограничения в сценариях разведки с помощью UAV, поскольку большинство исследований сосредоточены на условиях 2D-изображений, игнорируя сложности реального мира[30]. В частности, текущим методам не хватает устойчивости к геометрическим преобразованиям, возникающим из-за изменения высоты и углов обзора, которые вызывают непрерывные изменения масштаба и перспективы и, таким образом, снижают эффективность атаки. Более того, они недостаточно эффективны при работе в динамических условиях окружающей среды, особенно при сильных колебаниях освещенности. Изменения интенсивности освещения, цветовой температуры и направления, вызванные такими факторами, как время, погода и рельеф местности, существенно меняют визуальный облик целей, из-за чего текстуры, созданные в предположении постоянного освещения, с трудом сохраняют согласованность в реальных приложениях[14]⟧.
Более того, существенным ограничением существующих подходов является их ограниченная естественность. Чтобы максимизировать силу атаки, многие сгенерированные текстуры содержат неестественные высокочастотные артефакты или цвета, которые не соответствуют окружающей среде[12]. Такие состязательные камуфляжные паттерны легко обнаруживаются людьми и поэтому их сложно эффективно использовать в сценариях реального мира..
Для устранения этих ограничений данная работа направлена на решение центральной проблемы: создание состязательного камуфляжа, который стабильно обманывает как глубокие нейронные сети, так и наблюдателей-людей в условиях физической разведки с БПЛА. Эта проблема представляет собой две ключевые задачи: Устойчивость при динамическом наблюдении. Созданный камуфляж должен сохранять эффективные и стабильные состязательные атаки при постоянных изменениях масштаба и точки обзора, вызванных движением БПЛА. Баланс между состязательным эффектом и слиянием с окружающей средой. С одной стороны, текстура должна обладать сильными состязательными свойствами в пространстве признаков DNN для обмана машинных детекторов. С другой стороны, она должна обладать высокой визуальной естественностью, чтобы избежать обнаружения человеком и сливаться с окружающей средой..
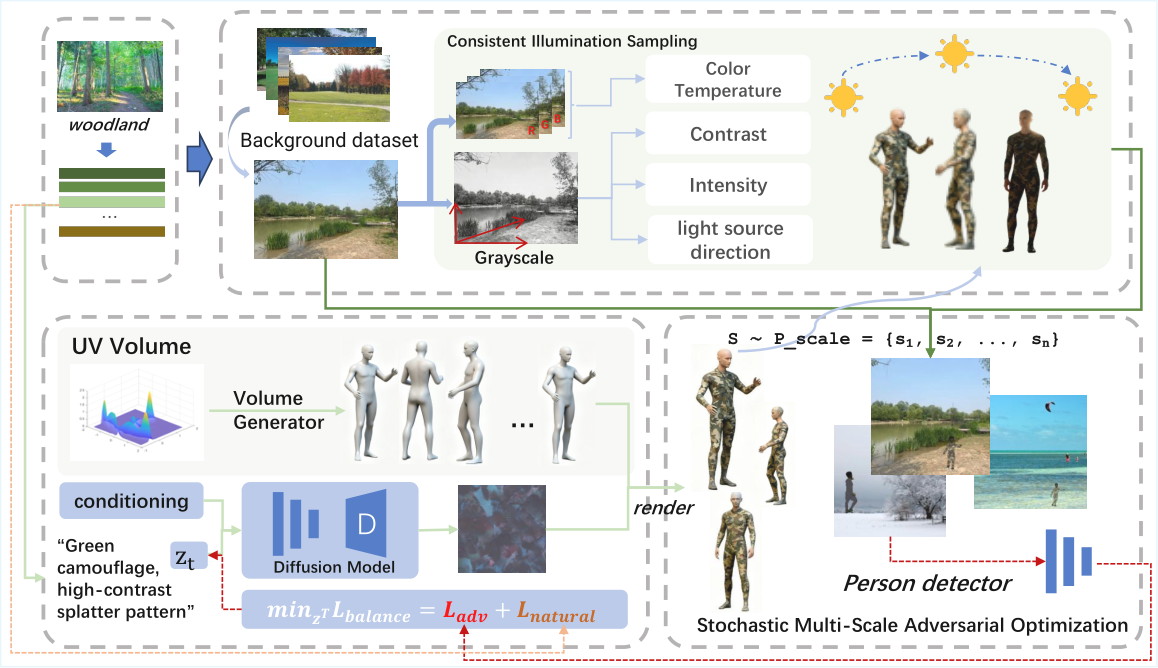
Для преодоления этих проблем мы предлагаем VFACamou — фреймворк, который объединяет адаптацию к окружающей среде с устойчивостью к множественным ракурсам. VFACamou сначала обеспечивает визуальную согласованность с помощью модуля оценки освещенности и цвета, который извлекает и выравнивает фоновое освещение и доминирующие цвета для достижения естественного слияния со сценой. Далее он справляется с вариациями масштаба и позы посредством стратегии динамического многомасштабного обучения, имитируя разнообразные условия наблюдения БПЛА для поддержания эффективности при различных точках обзора. Кроме того, VFACamou внедряет специализированную функцию потерь для камуфляжа, которая оптимизирует соответствие цветового распределения в выделенном цветовом пространстве, совместно обучаемую с функцией потерь состязательного обнаружения для баланса между скрытностью и эффективностью уклонения. Эксперименты на нескольких детекторах подтверждают, что VFACamou значительно снижает показатели обнаружения, сохраняя при этом согласованность с окружающей средой, что демонстрирует практический подход к физическому состязательному камуфляжу. Наш вклад суммирован следующим образом:
- ⟦• Мы разрабатываем совершенно новый метод генерации носимого состязательного камуфляжа с полным циклом, который автоматически создает состязательные текстуры для условий физического наблюдения с помощью UAV..
- ⟦• Мы предлагаем функцию потерь для уклонения от обнаружения, основанную на IoU, и функцию потерь для адаптации цветового паттерна, которые значительно снижают показатели обнаружения на множестве основных детекторов, сохраняя при этом естественность текстуры..
- ⟦• Наши обширные эксперименты на восьми детекторах объектов демонстрируют, что VFACamou достигает надежной эффективности физической атаки, сохраняя при этом высокую перцептивную естественность, превосходя существующие методы.
II Связанные работы
II-A Детекторы объектов для обнаружения пешеходов
С быстрым внедрением детекторов объектов на основе deep learning в критически важных для безопасности приложениях, таких как наблюдение и автономное вождение, обнаружение пешеходов стало одной из самых важных и широко изучаемых задач обнаружения. Современные детекторы пешеходов обычно строятся на базе универсальных фреймворков обнаружения объектов, включая двухстадийные детекторы, такие как Faster R-CNN[18], и одностадийные детекторы, такие как серия YOLO[17]. Эти детекторы достигают высокой производительности за счет обучения устойчивым визуальным представлениям внешнего вида человека на крупномасштабных наборах данных. Параллельно исследователи все чаще изучают состязательные атаки на детекторы объектов. Однако уязвимость детекторов пешеходов к состязательным возмущениям, особенно в физическом мире, остается открытой и критической проблемой..
II-B Состязательные атаки на человеческие тела
Недавние исследования изучили состязательные атаки [19, 33, 44], которые специально нацелены на сценарии обнаружения, связанные с людьми. Хотя атаки в цифровой области могут напрямую манипулировать входными пикселями, состязательные атаки в физическом мире должны оставаться эффективными при различном освещении, углах обзора, свойствах материалов и геометрических преобразованиях, что делает их значительно более сложными [23, 39, 41]. В сценариях обнаружения пешеходов эта проблема дополнительно усугубляется высокодинамичной и нежесткой природой человеческих целей. Большинство существующих физических атак разработаны для жестких или слабо деформируемых объектов [23] и поэтому плохо обобщаются на людей, чей внешний вид значительно варьируется в зависимости от позы, одежды и углов обзора. Хотя недавние исследования изучают 3D-реконструкцию, ограничения с нескольких ракурсов или атаки на основе текстур для улучшения устойчивости [9, 6], они обычно полагаются на модели с фиксированной топологией и не способны адекватно учитывать динамику человека и нежесткие деформации, что приводит к ограниченной адаптивности в реальных условиях..
III Методология
III-A Постановка задачи
Основная цель VFACamou заключается в разработке узора для носимой одежды, который при захвате визуальным сенсором может систематически вводить в заблуждение предварительно обученный детектор пешеходов. Пусть обозначает набор предсказанных ограничивающих рамок, сгенерированных целевым детектором для входного изображения , где каждая ограничивающая рамка содержит координаты и уверенность в классе . представляет собой набор истинных ограничивающих рамок людей..
III-B Мотивация
Существующие состязательные атаки на детекторы объектов обычно достигают уклонения путем прямого снижения уверенности для класса «человек». Однако для людей как нежестких целей одного лишь снижения уверенности классификации недостаточно для обеспечения эффективного уклонения: детектор все еще может выдавать точно локализованные ограничивающие рамки, которые раскрывают присутствие цели.
Мы утверждаем, что при физическом наблюдении с БПЛА эффективные состязательные атаки на людей должны нарушать общее пространственное восприятие цели детектором, а не просто ослаблять его уверенность в классификации. В частности, успешное уклонение удовлетворяет по меньшей мере одному из следующих условий:
- ⟦• Исчезновение цели: детектор не выдает предсказаний с высокой степенью уверенности в области нахождения реального человека.
- ⟦• Ошибочная идентификация цели: предсказания, которые перекрываются с истинной областью нахождения человека, ошибочно классифицируются как категории, отличные от «человек».
Следуя этой интуиции, мы разрабатываем функцию потерь для уклонения от обнаружения с использованием IoU, которая напрямую ограничивает пространственное перекрытие между предсказанными ограничивающими рамками и истинными рамками объектов человека, тем самым эффективно нарушая структуру вывода детектора..
III-C Многоцелевая гибридная структура оптимизации
Мы формулируем генерацию состязательных текстур как задачу многокритериальной оптимизации. Общая функция потерь определяется как:
| (1) |
где — это максимальная функция потерь IoU, — это функция потерь адаптации к естественной среде, — это балансирующий коэффициент, контролирующий компромисс между силой атаки и естественностью.
В условиях наблюдения с БПЛА внешний вид цели может значительно варьироваться из-за изменений угла обзора, расстояния и освещения. Чтобы поддерживать стабильную состязательную эффективность в этих динамических условиях, мы создаем конвейер аугментации трехмерной среды, который повышает устойчивость по трем измерениям: точка обзора, масштаб и освещенность..
Рандомизация точки обзора. Чтобы учесть изменчивость траекторий БПЛА и направлений обзора, мы случайным образом выбираем азимутальные углы и углы возвышения во время обучения: , . Эта стратегия заставляет генератор изучать инвариантные к точке обзора состязательные паттерны, тем самым сохраняя эффективность атаки с различных позиций БПЛА и смягчая переобучение, характерное для рендеринга с фиксированной точки обзора..
Многомасштабная визуализация человека Для учета вариаций масштаба, вызванных изменениями высоты полета БПЛА, мы применяем схему дискретизированной многомасштабной выборки:
| (2) |
Это не только имитирует непрерывные изменения размера человека на изображениях с БПЛА, но и направляет генератор на разработку текстурных паттернов с учетом масштаба.
Рендеринг с учетом освещения. Для обеспечения реалистичности освещения мы интегрируем физически корректный рендеринг с модулем оценки освещенности. Предварительно обученный оценщик выводит глобальные параметры освещения — такие как интенсивность окружающего света, направление основного источника света и цвет — из фонового изображения. В процессе рендеринга 3D-модель человека с состязательной текстурой помещается в условия освещения для создания изображения, соответствующего фоновому освещению.:
| (3) |
| (4) |
III-C1 Максимальная функция потерь IoU
В общей функции потерь вышеупомянутой задачи многокритериальной оптимизации функция потерь на основе Maximum IoU определяется как:
| (5) |
где — порог достоверности. — индикаторная функция класса. гарантирует, что учитываются только предсказания, превышающие порог достоверности..
III-C2 Функция потерь адаптации к естественной среде
Хотя сгенерированные состязательные текстуры могут вводить детекторы в заблуждение, их высокочастотные артефакты и неестественные цвета делают их легко обнаружимыми в реальных условиях. Поэтому мы вводим функцию потерь адаптации к естественной среде. Цвет служит основным фактором визуальной маскировки. Мы кодируем распространенные военные цветовые схемы — такие как лесной зеленый, пустынный желтый и городской серый — в эталонный набор цветов . Функция потерь цветовой адаптации определяется как:
| (6) |
где — это динамически корректируемый вес в соответствии с целевой средой развертывания. Минимизируя расстояние между сгенерированной текстурой и эталонными цветовыми схемами, эта функция потерь обеспечивает глобальную тональную согласованность с окружающим фоном. Формулировка минимального расстояния позволяет различным областям текстуры подстраиваться под разные доминирующие цвета, тем самым улавливая естественные цветовые вариации, обычно наблюдаемые в реальных условиях..
Кроме того, наблюдения за дизайном военного образца показывают, что эффективная маскировка обычно демонстрирует умеренный локальный контраст и многомасштабную нерегулярность. Поэтому мы вводим локальную дисперсию в качестве меры сложности паттерна. Функция потерь контроля паттерна определяется как:
| (7) |
где вычисляет локальную дисперсию текстуры в пределах скользящих окон, обозначает целевой уровень дисперсии, а представляет математическое ожидание по нескольким масштабам изображения. Объединение целей адаптации цвета и контроля паттерна дает итоговую функцию потерь адаптации к естественной среде:
| (8) |
где гарантирует, что цвета текстуры соответствуют палитре военного камуфляжа. контролирует локальную вариативность текстурного паттерна в заданных пределах.
IV Эксперименты
| Method | Victim Models | |||||||
|---|---|---|---|---|---|---|---|---|
| FRCNN | YOLOv8 | MRCNN | Retina | SSD | YOLOv3 | YOLOv9 | FCOS | |
| AdvYolo | 2.70 | 47.78 | 1.28 | 6.14 | 36.56 | 3.82 | 0.12 | 5.94 |
| AdvTexture | 12.08 | 39.42 | 8.18 | 41.52 | 37.30 | 12.06 | 12.20 | 19.20 |
| AdvCamou | 3.64 | 15.80 | 2.46 | 7.82 | 31.38 | 17.66 | 0.08 | 5.98 |
| UV-Attack | 43.28 | 36.96 | 52.42 | 45.94 | 48.66 | 11.86 | 5.08 | 62.18 |
| Ours | 93.02 | 66.10 | 95.60 | 89.72 | 78.40 | 40.32 | 56.34 | 95.60 |
| AdvYolo | 2.40 | 28.38 | 1.54 | 6.66 | 32.38 | 15.52 | 0.14 | 5.26 |
| AdvTexture | 3.14 | 26.58 | 1.08 | 7.82 | 24.78 | 5.20 | 0.22 | 5.58 |
| AdvCamou | 2.42 | 11.36 | 1.54 | 5.48 | 26.58 | 5.88 | 0.12 | 4.06 |
| UV-Attack | 52.00 | 58.36 | 72.02 | 62.14 | 60.86 | 35.88 | 21.90 | 70.06 |
| Ours | 53.74 | 66.86 | 78.72 | 57.96 | 57.14 | 24.56 | 13.64 | 68.46 |
| Method | Faster R-CNN | YOLOv8 | ||||||
|---|---|---|---|---|---|---|---|---|
| AdvYolo | 2.70 | 2.70 | 3.50 | 2.72 | 29.38 | 28.38 | 29.38 | 30.42 |
| AdvTexture | 8.12 | 12.08 | 37.22 | 62.20 | 28.06 | 26.58 | 27.78 | 26.76 |
| AdvCamou | 3.64 | 3.64 | 3.50 | 3.68 | 11.74 | 11.36 | 12.04 | 12.08 |
| UV-Attack | 43.96 | 43.28 | 45.42 | 46.60 | 58.12 | 58.36 | 57.50 | 57.58 |
| Ours | 93.10 | 93.02 | 93.34 | 93.18 | 66.82 | 66.86 | 68.76 | 66.84 |
IV-A Экспериментальная установка
Наборы данных и модели. Для всесторонней оценки мы используем набор данных ZJU-Mocap [16]. В частности, мы выбираем следующие модели: Faster R-CNN [2], Mask R-CNN [3], RetinaNet [13], SSD [15], YOLOv3 [17], YOLOv8 [8], YOLOv9 [26] и FCOS [24]⟧.
Метрики оценки. Мы используем показатель успешности атаки (ASR) в качестве метрики оценки для измерения эффективности атаки. ASR определяется как доля случаев, в которых целевой человек не был успешно обнаружен детектором. Для обеспечения всесторонней оценки ASR приводится при нескольких пороговых значениях IoU в диапазоне от 0.01 до 0.5, где IoU представляет собой перекрытие между ограничивающими рамками обнаружения и аннотациями истинных значений..
Детали реализации. Процесс обучения длится 300 эпох с размером пакета 4, а все процедуры оптимизации и вывода проводятся на одном графическом процессоре NVIDIA A100. Наши состязательные текстуры обучаются и оцениваются в условиях множественных поз, где каждый образец содержит разнообразные позы человека и углы обзора, чтобы отразить реалистичные сценарии движения человека..
| Metric | w/ | w/o |
| Color Similarity (%) | 75.32 | 64.22 |
| Metric | w/ MDT | w/o MDT |
| ASR (%) | 93.02 | 58.96 |
IV-B Эффективность цифровых атак
Мы проводим цифровые эксперименты на различных детекторах объектов для оценки эффективности и переносимости предложенной атаки в сценариях с множественными позами. Состязательные текстуры оптимизируются на Faster R-CNN и YOLOv8, а затем переносятся на неизученные модели. Производительность измеряется с помощью показателя успешности атаки (ASR) при пороге IoU 0,1 и пороге достоверности 0,5. Мы проводим сравнение с репрезентативными методами на основе текстур и патчей, включая AdvCamou [6], UV-Attack [12], AdvTexture [7] и AdvYOLO [23]. Для обеспечения справедливости методы на основе патчей распределяются по поверхности текстуры..
Как показано в Table I, предложенный метод стабильно превосходит все базовые модели как в условиях «белого ящика», так и при переносе между моделями. При обучении на Faster R-CNN он достигает высоких показателей на исходной модели, сохраняя при этом высокую переносимость между гетерогенными детекторами. Аналогичным образом, обучение на YOLOv8 обеспечивает превосходную эффективность атаки, превосходя конкурирующие подходы. В целом, результаты демонстрируют устойчивую эффективность цифровой атаки и высокую переносимость между моделями в сценариях с несколькими ракурсами..
IV-C Сравнительное исследование
Для дальнейшей оценки конкурентоспособности нашего метода мы проводим сравнительное исследование с существующими состязательными атаками на обнаружение людей при согласованных настройках обучения и тестирования для различных поз, включая AdvCamou [6], UV-Attack [12], AdvTexture [7] и AdvYOLO [23]. Эксперименты проводятся на Faster R-CNN и YOLOv8 в качестве целевых детекторов. Показатель ASR оценивается при нескольких пороговых значениях IoU (0.01,0.1,0.3,0.5) с порогом уверенности 0.5.
Как показано в Table II, наш метод достигает наивысшего ASR по всем порогам IoU на обоих детекторах. На Faster R-CNN наш метод демонстрирует исключительную производительность с ASR, стабильно превышающим 93% при всех настройках IoU, значительно превосходя все базовые методы. На YOLOv8 наш метод также достигает более высоких показателей атаки, чем другие методы. Примечательно, что наш метод показывает относительно стабильную производительность при различных порогах IoU, что указывает на то, что наши сгенерированные состязательные текстуры обеспечивают более надежную и последовательную эффективность атаки..
IV-D Эффективность физической атаки
Мы оцениваем эффективность предложенной атаки в реальных условиях путем проведения физических экспериментов при различных позах, ракурсах и расстояниях на открытом воздухе. Состязательные текстуры, обученные на Faster R-CNN, напечатаны на футболке с длинным рукавом и брюках, а человек, одетый в эту одежду, записывается на видео с помощью беспилотного летательного аппарата. Собранная видеопоследовательность содержит непрерывные изменения позы, точки обзора камеры и расстояния от объекта до камеры. Затем каждая последовательность оценивается на нескольких детекторах, и кадр считается успешно атакованным, если человек не обнаружен в этом кадре. , где обозначает количество кадров, в которых человек обнаружен, а обозначает общее количество кадров в последовательности. Результаты ASR для Faster R-CNN, RetinaNet, SSD, YOLOv3 и YOLOv8 при различных порогах уверенности показаны в Fig. 3. Эти результаты демонстрируют, что сгенерированные текстуры сохраняют сильную состязательную способность в реальных условиях и остаются эффективными при изменениях позы, угла обзора и расстояния..
IV-E Абляционное исследование
В этом разделе мы анализируем вклад ключевых компонентов в нашу структуру. Все эксперименты по абляции проводятся на детекторе Faster R-CNN при тех же настройках обучения и оценки, что и в основных экспериментах..
Эффект функции потерь адаптации к естественной среде. Мы сначала исследуем влияние включения функции потерь адаптации к естественной среде в процессе оптимизации. Эта функция потерь побуждает состязательные текстуры лучше соответствовать реальному освещению и цветовым распределениям. Мы вычисляем значения цветового сходства, состоящие из сходства пересечения гистограмм и сходства цветового расстояния с и без него, как показано в Table III, что демонстрирует, что текстуры сохраняют более близкую визуальную согласованность с окружающей средой..
Эффект многомасштабного динамического обучения. Мы дополнительно оцениваем роль стратегии многомасштабного динамического обучения, которая имитирует изменения расстояния наблюдения и масштаба человека во время обучения. Эта стратегия позволяет состязательным текстурам оставаться эффективными в различных условиях обзора. Результаты в Table IV показывают, что использование многомасштабного динамического обучения значительно повышает коэффициент успешности атаки..
V Заключение
В данной статье мы предлагаем VFACamou, комплексную структуру для создания носимого состязательного камуфляжа, который сохраняет эффективность в условиях разведки с БПЛА, включая динамические углы обзора, деформацию тела и сложное освещение. VFACamou объединяет UV-объемный рендеринг с генератором текстур на основе диффузии для обеспечения геометрически согласованного внешнего вида при различных позах и масштабах, в то время как оценщик согласованности освещения и цвета способствует адаптивной настройке текстуры для реалистичного слияния с окружающей средой. Для повышения устойчивости применяется стратегия многомасштабного динамического обучения, позволяющая имитировать вызванные БПЛА вариации расстояния, угла обзора и артикуляции. Обширные цифровые и физические эксперименты показывают, что VFACamou стабильно превосходит существующие методы, достигая превосходной эффективности атак на множестве популярных детекторов..
Список литературы
- ⟦[1] Д. Ду, П. Чжу, Л. Вэнь, С. Бянь, Х. Линь, Ц. Ху, Т. Пэн, Дж. Чжэн, С. Ван и Ю. Чжан (2018) Набор данных VisDrone для обнаружения и отслеживания объектов на аэрофотоснимках. В материалах Европейской конференции по компьютерному зрению (ECCV), стр. 733–749. Внешние ссылки: https://arxiv.org/abs/1804.07437 Цитируется: §I.
- ⟦[2] Р. Гиршик (2015) Fast r-cnn. В материалах международной конференции IEEE по компьютерному зрению, стр. 1440–1448. Цитируется в: §IV-A.
- ⟦[3] К. Хе, Г. Гиоксари, П. Доллар и Р. Гиршик (2018) Mask R-CNN. Цитируется в: §IV-A⟧.
- ⟦[4] С. Ху, З. Чжоу, Ю. Чжан, Л. И. Чжан, Ю. Чжэн, Ю. Хэ и Х. Цзинь (2022) Badhash: Невидимые бэкдор-атаки на глубокое хеширование с чистой меткой. В материалах 30-й Международной конференции ACM по мультимедиа (ACM MM'22), стр. 678–686. Цитируется в: §I.
- ⟦[5] И. Ху, Б. Кунг, Д. С. Тан, Дж. Чен, К. Хуа и У. Ченг (2021) Натуралистичный физический состязательный патч для детекторов объектов. В материалах Международной конференции по компьютерному зрению IEEE/CVF, стр. 7848–7857. Цитируется в: Fig. 1.
- ⟦[6] З. Ху, В. Чу, Х. Чжу, Х. Чжан, Б. Чжан и Х. Ху (2023) Физически реализуемые текстуры одежды с естественным внешним видом позволяют обходить детекторы людей с помощью 3D-моделирования. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 16975–16984. Цитируется в: Fig. 1, §II-B, §IV-B, §IV-C⟧.
- ⟦[7] З. Ху, С. Хуан, Х. Чжу, Ф. Сунь, Б. Чжан и Х. Ху (2022) Состязательная текстура для обмана детекторов людей в физическом мире. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 13307–13316. Цитируется в: Fig. 1, §IV-B, §IV-C⟧.
- ⟦[8] Дж. Джочер, А. Чаурасия и Дж. Цю (2023) Ultralytics YOLO. Цитируется в: §IV-A.
- ⟦[9] Л. Ли, К. Лиань и Ю. Чен (2023) Adv3D: Генерация 3D состязательных примеров для 3D обнаружения объектов в сценариях вождения с использованием NeRF. 2024 IEEE/RSJ Международная конференция по интеллектуальным роботам и системам (IROS), стр. 10813-10820. Внешние ссылки: https://api.semanticscholar.org/CorpusID:261530011 Цитируется: §II-B⟧.
- ⟦[10] М. Ли, Дж. Ван, Х. Чжан, З. Чжоу, С. Ху и Х. Пей (2024) Переносимые состязательные изображения лиц для защиты конфиденциальности. В материалах 32-й Международной конференции ACM по мультимедиа (ACM MM'24), стр. 10649–10658. Цитируется в: §I.
- ⟦[11] М. Ли, Х. Ван, З. Ю, С. Ху, З. Чжоу, Л. Чжан и Л. И. Чжан (2025) Обнаружение и повреждение примеров, не поддающихся обучению, на основе свертки. В материалах конференции Ассоциации по развитию искусственного интеллекта (AAAI'25), стр. 18403–18411. Цитируется в: §I.
- ⟦[12] И. Ли, К. Лян и Б. Сяо (2025) Uv-attack: Физические состязательные атаки на обнаружение людей с помощью uv-маппинга на основе dynamic-nerf. arXiv preprint arXiv:2501.05783. Цитируется в: Fig. 1, §I, §IV-B, §IV-C⟧.
- ⟦[13] Т. Лин, П. Гойал, Р. Гиршик, К. Хе и П. Доллар (2018) Фокусная функция потерь для плотного обнаружения объектов. Цитируется в: §IV-A⟧.
- ⟦[14] Х. Лю, С. Жуань, Ю. Хуан, С. Чжао и Х. Вэй (2025) Когда освещение обманывает: раскрытие уязвимости моделей зрения-языка к освещению посредством атаки через преобразование освещения. arXiv препринт arXiv:2503.06903. Цитируется в: §I.
- ⟦[15] У. Лю, Д. Ангелов, Д. Эрхан, К. Сегеди, С. Рид, К. Фу и А. К. Берг (2016) Ssd: Single shot multibox detector. В сборнике: Компьютерное зрение--ECCV 2016: 14-я Европейская конференция, Амстердам, Нидерланды, 11--14 октября 2016 г., Труды, Часть I 14, стр. 21–37. Цитируется в: §IV-A.
- ⟦[16] С. Пэн, Ю. Чжан, Ю. Сюй, Ц. Ван, Ц. Шуай, Х. Бао и Х. Чжоу (2021) Neural Body: Неявные нейронные представления со структурированными латентными кодами для синтеза новых ракурсов динамических людей. В CVPR, Цитируется: §IV-A.
- ⟦[17] Дж. Редмон и А. Фархади (2018) Yolov3: Инкрементальное улучшение. arXiv препринт arXiv:1804.02767. Цитируется в: §II-A, §IV-A.
- ⟦[18] С. Рен, К. Хе, Р. Гиршик и Дж. Сан (2015) Faster R-CNN: На пути к обнаружению объектов в реальном времени с помощью сетей формирования предложений регионов. В сборнике: Достижения в системах нейронной обработки информации (NeurIPS), стр. 91–99. Внешние ссылки: https://arxiv.org/abs/1506.01497 Цитируется в: §I, §II-A.
- ⟦[19] Й. Сонг, З. Чжоу, М. Денг, Й. Ху, С. Ху, М. Ли и Л. Й. Чжан (2026) Атака эрозией для состязательного обучения с целью повышения устойчивости семантической сегментации. В материалах IEEE Международной конференции по акустике, речи и обработке сигналов (ICASSP'26), Цитируется по: §II-B.
- ⟦[20] И. Сун, З. Чжоу, М. Ли, С. Ван, М. Дэн, В. Ван, С. Ху и Л. И. Чжан (2025) PB-UAP: Гибридная универсальная состязательная атака для сегментации изображений.. В материалах Международной конференции IEEE по акустике, речи и обработке сигналов (ICASSP'25), Цитируется по: §I⟧.
- ⟦[21] И. Сун, З. Чжоу, К. Лу, Х. Чжан, И. Ху, Л. Сюэ, С. Ху, М. Ли и Л. И. Чжан (2025) SegTrans: Переносимые состязательные примеры для моделей сегментации. IEEE Transactions on Multimedia. Цитируется в: §I.
- ⟦[22] Г. Танг, Дж. Ни, Ю. Чжао, Ю. Гу и В. Цао (2024) Обзор методов обнаружения объектов для БПЛА на основе глубокого обучения. Remote Sensing 16 (1), стр. 149. Внешние ссылки: 10.3390/rs16010149, https://www.mdpi.com/2072-4292/16/1/149 Цитируется: §I⟧.
- ⟦[23] С. Тайс, В. Ван Ранст и Т. Гудеме (2019) Обман автоматизированных камер наблюдения: состязательные патчи для атаки на обнаружение людей. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, семинары, стр. 0–0. Цитируется в: Fig. 1, §II-B, §IV-B, §IV-C⟧.
- ⟦[24] З. Тянь, К. Шен, Х. Чен и Т. Хе (2019) FCOS: Полностью сверточное одностадийное обнаружение объектов. Цитируется в: §IV-A.
- ⟦[25] У. Ван, Ю. Нин, З. Хуан, К. Хонг, С. Ху, З. Чжоу, Ю. Чжан, Т. Чжу, В. Чжоу и Л. И. Чжан (2025) MARS: Защита от бэкдоров с учетом вредоносности в федеративном обучении. В материалах 39-й ежегодной конференции по нейронным системам обработки информации (NeurIPS'25), Цитируется по: §I.
- ⟦[26] К. Ван, И. Йе и Х. М. Ляо (2024) YOLOv9: Обучение тому, что вы хотите изучить, с использованием программируемой градиентной информации. В материалах Европейской конференции по компьютерному зрению (ECCV) 2024, Конспекты лекций по информатике, (А. Леонардис, Э. Риччи, С. Рот, О. Руссаковский, Т. Саттлер и Г. Варол, ред.), Шпрингер, Шам, Швейцария, стр. 1–21. Цитируется: §IV-A.
- ⟦[27] Х. Ван, С. Ху, Ю. Чжан, З. Чжоу, Л. И. Чжан, П. Сюй, В. Ван и Х. Цзинь (2024) ECLIPSE: Устранение неразборчивых отравлений с чистой меткой посредством разреженной диффузионной очистки. В Европейском симпозиуме по исследованиям в области компьютерной безопасности, стр. 146–166. Цитируется: §I.
- ⟦[28] Х. Ван, М. Ли, В. Лю, Х. Чжан, С. Ху, Ю. Чжан, З. Чжоу и Х. Цзинь (2024) Необучаемые трехмерные облака точек: поклассовое преобразование — это все, что вам нужно. В материалах 38-й ежегодной конференции по системам нейронной обработки информации (NeurIPS'24), стр. 99404–99432. Цитируется по: §I.
- ⟦[29] Х. Ван, Х. Пан, Х. Чжан, М. Ли, С. Ху, З. Чжоу, Л. Сюэ, П. Го, Ю. Ван, В. Ван и др. (2024) Trojanrobot: Бэкдор-атаки на роботизированные манипуляции в физическом мире. arXiv e-prints, стр. arXiv–2411. Цитируется в: §I⟧.
- ⟦[30] Й. Ван, Й. Чоу, З. Чжоу, Х. Чжан, В. Ван, С. Ху и М. Ли (2025) Преодоление барьеров в состязательных примерах физического мира: повышение устойчивости и переносимости с помощью надежных признаков. В материалах 39-й ежегодной конференции Ассоциации по развитию искусственного интеллекта (AAAI'25), Цитируется по: §I.
- ⟦[31] И. Ван, Х. Чжан, П. Хэвэнь, З. Чжоу, С. Ван, П. Го, Л. Сюэ, С. Ху, М. Ли, Л. И. Чжан и Яо (2025) ADVEDM: Мелкозернистая состязательная атака на воплощенных агентов на основе VLM. В материалах 39-й ежегодной конференции по системам нейронной обработки информации (NeurIPS'25), Цитируется: §I.
- ⟦[32] Л. Сюэ, С. Ху, В. Лу, Ю. Шэнь, Д. Ли, П. Го, З. Чжоу, М. Ли, Ю. Чжан и Л. Ю. Чжан (2026) На пути к надежному забыванию: обзор верификации машинного обучения без учителя. ACM Computing Surveys. Цитируется в: §I.
- ⟦[33] С. Ян, З. Чжоу, Ю. Сонг, Ю. Ху, М. Ли и С. Ху (2026) Переносимые состязательные патчи физического мира против моделей обнаружения пешеходов. arXiv preprint arXiv:2604.22552. Цитируется в: §II-B.
- ⟦[34] Л. Ю, И. Чжан, З. Чжоу, И. У, В. Ван, М. Ли, С. Ху, П. Сяобин и Дж. Ван (2025) Spa-VLM: Скрытые атаки отравления на RAG-основанные VLM. arXiv препринт arXiv:2505.23828. Цитируется в: §I.
- ⟦[35] Х. Чжан, С. Ху, Ю. Ван, Л. Ю. Чжан, З. Чжоу, С. Ван, Ю. Чжан и К. Чен (2024) Крах детектора: внедрение бэкдоров в обнаружение объектов для вызова катастрофической перегрузки или слепоты. В материалах Тридцать третьей международной объединенной конференции по искусственному интеллекту (IJCAI'24), Цитируется по: §I.
- ⟦[36] Х. Чжан, И. Ван, С. Янь, Ч. Чжу, З. Чжоу, Л. Хоу, С. Ху, М. Ли, И. Чжан и Л. И. Чжан (2025) Обнаружение бэкдоров во время тестирования для моделей обнаружения объектов. В материалах Конференции по компьютерному зрению и распознаванию образов (CVPR'25), стр. 24377–24386. Цитируется: §I.
- ⟦[37] З. Чжоу, М. Дэн, Ю. Сун, Х. Чжан, В. Ван, С. Ху, М. Ли, Л. И. Чжан и Д. Яо (2025) Darkhash: атака типа бэкдор без использования данных против глубокого хеширования. IEEE Transactions on Information Forensics and Security. Цитируется в: §I.
- ⟦[38] З. Чжоу, С. Ху, М. Ли, Х. Чжан, Ю. Чжан и Х. Цзинь (2023) Advclip: Состязательные примеры, не зависящие от нисходящих задач, в мультимодальном контрастивном обучении. В материалах 32-й Международной конференции ACM по мультимедиа (MM'23), стр. 6311–6320. Цитируется в: §I.
- ⟦[39] З. Чжоу, С. Ху, Р. Чжао, К. Ван, Л. И. Чжан, Дж. Хоу и Х. Цзинь (2023) Состязательные примеры, не зависящие от нисходящих задач. В материалах международной конференции IEEE/CVF по компьютерному зрению 2023 года (ICCV'23), стр. 4345–4355. Цитируется в: §II-B.
- ⟦[40] З. Чжоу, Ю. Ху, Ю. Сун, З. Ли, С. Ху, Л. Ю. Чжан, Д. Яо, Л. Чжэн и Х. Цзинь (2025) Раствориться в воздухе: универсальные состязательные атаки с использованием кросс-промптов для SAM2. В материалах 39-й ежегодной конференции по нейронным системам обработки информации (NeurIPS'25), Цитируется по: §I.
- ⟦[41] З. Чжоу, Б. Ли, Ю. Сун, С. Ху, В. Ван, Л. И. Чжан, Д. Яо и Х. Цзинь (2025) NumbOD: Атака на основе пространственно-частотного слияния против детекторов объектов. В материалах 39-й ежегодной конференции AAAI по искусственному интеллекту (AAAI'25), Цитируется в: §II-B.
- ⟦[42] З. Чжоу, М. Ли, В. Лю, С. Ху, Ю. Чжан, В. Ван, Л. Сюэ, Л. Ю. Чжан, Д. Яо и Х. Цзинь (2024) Безопасная дообучение (fine-tuning) предварительно обученных энкодеров для защиты от состязательных примеров. В материалах симпозиума IEEE 2024 года по безопасности и конфиденциальности (SP'24), Цитируется: §I.
- ⟦[43] З. Чжоу, Ю. Сун, М. Ли, С. Ху, С. Ван, Л. И. Чжан, Д. Яо и Х. Цзинь (2024) Darksam: обман модели segment anything с целью сегментировать ничто. В материалах 38-й ежегодной конференции по системам нейронной обработки информации (NeurIPS'24), Цитируется по: §I.
- ⟦[44] З. Чжу, З. Чжоу, И. Ван, Л. Сюэ, М. Ли и С. Ху (2026) Переносимые состязательные паттерны физического мира против обнаружения объектов в автономном вождении. arXiv preprint arXiv:2604.23105. Цитируется в: §II-B.