Насколько хороши линейные модели
для прогнозирования временных рядов?
Аннотация
Исследования прогнозирования временных рядов уверенно движутся к более крупным архитектурам — от специализированных transformers к универсальным foundation models, исходя из предположения, что именно масштабирование мощностей открывает путь к точности. Мы занимаем противоположную позицию: большую часть этого разрыва можно существенно сократить при гораздо меньших затратах за счет настройки препроцессинга, а не за счет масштабирования моделей. В качестве тестовой площадки мы используем Ridge regression 10, поскольку у нее есть аналитическое решение в замкнутом виде и интерпретируемые веса, что позволяет считывать оптимальные гиперпараметры напрямую из поиска. Мы проводим поиск по длине контекста, локальной нормализации, регуляризации и аугментации на восьми стандартных бенчмарках и обнаруживаем три закономерности. (1) Оптимальная глубина просмотра (lookback) сильно зависит от конкретного ряда и часто немонотонна по горизонту прогноза: подобранные показатели степени степенного закона (power-law exponents) варьируются от на ETTm2 до на Exchange и Traffic, что ставит под сомнение общепринятое мнение о том, что для более дальних горизонтов требуется более длинная история. (2) Нормализация по обученной затухающей доле контекста, а не по всему контексту, почти повсеместно оказывается предпочтительной. (3) Ряды в рамках одного и того же датасета часто расходятся по гиперпараметрам; оптимальная степень межрядового обмена варьируется от полностью общей до полностью индивидуальной для каждого ряда. Получившиеся модели обыгрывают предшествующие линейные предикторы на большинстве записей датасет–горизонт и превосходят базовые модели Transformer, MLP и CNN на шести из восьми бенчмарков. Оптимизированные гиперпараметры также служат диагностикой самих данных, выявляя структуры, которые более крупные модели безмолвно «впитывают» в свои обученные параметры. Мы приводим сопутствующий interactive online demonstration и codebase.
1 Введение
Литература по долгосрочному прогнозированию временных рядов в последние несколько лет следовала знакомой дуге. Transformers 21 были адаптированы к задаче с прогрессирующе более сложными механизмами внимания и доработок (25; 27; 16; 15), альтернативы на основе Multi-Layer Perceptron (MLP) и Convolutional Neural Network (CNN) показали, что сопоставимая точность может быть достигнута с более простыми индуктивными смещениями (24; 22; 6; 9), а линейные модели вступили в обсуждение, когда 26 показало, что один линейный слой, применяемый после разложения тренд-сезонность, может превзойти несколько современных transformers. Возникшее распространение линейных вариантов, например DLinear, NLinear 26, RLinear13, SparseTSF 14, создало впечатление богатого пространства проектирования, пока 20 не показало, что эти модели функционально эквивалентны несвязанной линейной регрессии с подходяще дополненными признаками, и что решения в замкнутом виде для обычных наименьших квадратов могут соответствовать или превосходить их аналоги, обученные с помощью SGD. Это сведение кажущегося разнообразия архитектур в один класс моделей порождает естественный вопрос: если модель фактически фиксирована, где следует тратить оставшиеся степени свободы?
Мы утверждаем, что ответ заключается в предварительной обработке. Стандартный протокол оценки в прогнозировании временных рядов фиксирует длину контекста, стратегию нормализации и способы увеличения данных в единой настройке для каждого набора данных и затем сравнивает архитектуры. Такая договоренность имеет смысл, когда цель состоит в выделении эффекта от конструкции модели, но она систематически ухудшает положение моделей, чья вместимость слишком ограничена, чтобы компенсировать неоптимальные входные представления посредством обучаемых параметров. Transformers с миллионами параметров могут частично компенсировать неудачно выбранное окно просмотра или неинформативную схему нормализации; линейная модель — нет. В результате линейные методы выглядят слабее, чем они есть на самом деле, не потому что им не хватает выразительной способности для задачи, а потому что они более чувствительны к выборам, которые редко настраивают. Мы проверяем эту гипотезу с Ridge regression 10, применяя систематический поиск по длине контекста, локальным окнам нормализации, силе регуляризации и увеличению данных во временной и частотной областях на восьми стандартных наборах данных с гранулярностью по горизонту и по отдельному ряду. Ridge имеет решение в замкнутом виде, не содержит скрытой нелинейности, выполняет один эксперимент за несколько миллисекунд на GPU и выдает веса, которые можно непосредственно проверить. Та же прозрачность, которая делает его конкурентоспособным предиктором, превращает его и в диагностический инструмент: структура оптимальных гиперпараметров выявляет свойства данных, которые более глубокие модели молча впитывают в свои выученные представления.
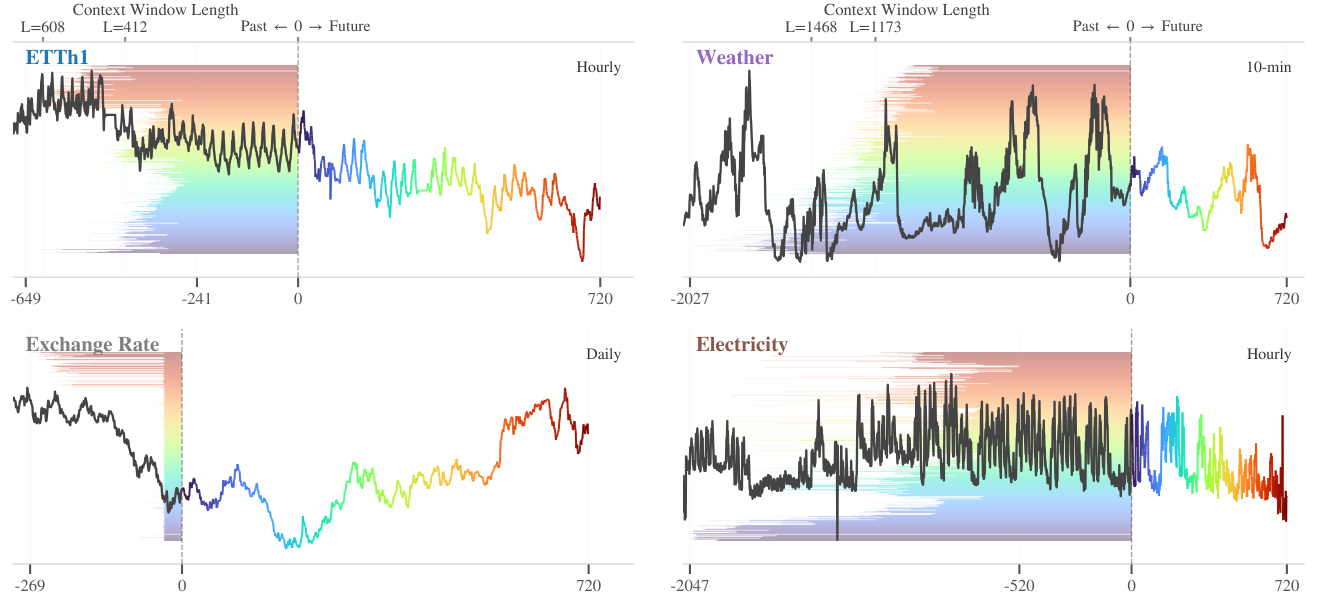
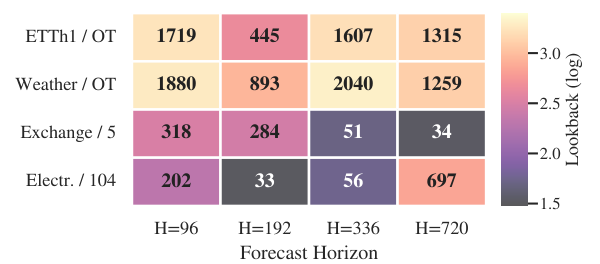
Поиск выявляет три интригующие наблюдения. Во-первых, связь между оптимальным размером окна ретроспективы и горизонтом прогноза сильно зависит от набора данных (Рисунки 1&2) и часто является немонотонной (Рисунок 3). При подборе степенного закона для найденного оптимального размера окна ретроспективы и горизонта предсказания показатель изменяется от на ETTm2 до на Exchange и Traffic, что противоречит распространенному предположению, что более длинные горизонты требуют более длинной истории 17; 5. Во-вторых, нормирование по изученной доле контекста, относящейся к его последней части, а не по всему контексту, как в предыдущих работах, последовательно улучшает точность, указывая на то, что недавняя локальная статистика несет больше сигнала, чем глобальная (Рисунок 7). В-третьих, ряды в рамках одного и того же набора данных часто предпочитают разные гиперпараметры (Рисунок 4), а оптимальная степень совместного использования данных между рядами варьируется от полностью общего для ETTh1 до полностью отдельного для Weather, предполагая, что неоднородность между каналами представляет собой слабо изученную ось в прогнозировании.
Наши основные вклады следующие. Во-первых, мы показываем, что тщательно настроенная Ridge regression превосходит ранее применявшиеся линейные предикторы на большинстве наборов данных и горизонтов времени, а также сопоставима или превосходит архитектуры на основе Transformer и MLP на шести из восьми тестов при том, что ее обучение обходится на порядки дешевле. Во-вторых, мы демонстрируем, что оптимальный ландшафт гиперпараметров прозрачной линейной модели кодирует структурные свойства данных временных рядов (масштабное поведение, предпочтения к нормализации, неоднородность рядов), которые информативны за пределами самой модели и могут служить ориентиром при проектировании более сложных предикторов. В-третьих, мы выпускаем SearchCast (URL) — воспроизводимый конвейер, который поддерживает поиск по каждому горизонту и по каждому ряду с настраиваемыми элементами контроля абляций, облегчая будущие исследования по диагностике собственных наборов данных с использованием той же методологии.
2 Сопутствующие работы
Прогнозировщики на основе трансформеров.
Ранее архитектуры, основанные на внимании, доминировали в долгосрочном прогнозировании в течение нескольких лет. Autoformer (25) и FEDformer (27) заменили стандартное самовнимание операторами в частотной области, чтобы уловить сезонную структуру. PatchTST (16) сегментировал входные данные на фрагменты и обрабатывал каждый канал независимо, и остается самым сильным базовым вариантом трансформера в долгосрочных тестах. iTransformer (15) инвертировал ось внимания, чтобы моделировать зависимости между каналами. Недавние бенчмарки (18; 20) показывают, что ни один трансформер не выигрывает на всех наборах данных и горизонтах, что ставит вопрос о том, откуда должны прийти оставшиеся улучшения.
Альтернативы MLP и CNN.
Параллельное направление исследований изучало более простые архитектуры. TimesNet (24) преобразует одномерные ряды в двумерные тензоры и применяет свёртки. TiDE (9) и TimeMixer (22) представляют собой энкодер-декодерные MLP, причём последнее выполняет смешивание по временным разрешениям. TSMixer (6) достигает конкурентной точности с MLP-мешалкой без внимания.
Линейные модели.
DLinear (26) показал, что разложение на тренд и сезонность с последующим двумя линейными слоями может превзойти mordern transformers; NLinear, RLinear (13) и SparseTSF (14) расширили этот рецепт, добавив соответственно нормализацию по последнему значению, обратимую инстанс-нормализацию (12) и прогнозирование с разреженными параметрами. Затем Toner и Darlow 20 доказали, что DLinear, NLinear и несколько родственных вариантов функционально эквивалентны неконстрейнт-ной линейной регрессии по дополненным признакам, и что решения для метода наименьших квадратов в замкнутом виде (OLS) совпадают с теми же моделями, обученными с помощью SGD, или превосходят их. Это сводит разнообразных линейных форкастеров в единый класс моделей.
Фундаментальные модели для временных рядов.
Более новая линия исследований предлагает прогнозаторы общего назначения, обученные на больших корпусах и применяемые в режиме zero-shot, включая Chronos (3), TimesFM (1), Moirai (23) и DAM 8. Эти модели ориентированы на широкое покрытие, а не на точность для каждого набора данных, и на стандартных задачных проверках в контролируемом обучении. Однако достижение такой общности требует больших предобучающих корпусов и существенно больших вычислений по сравнению с подгонкой под каждый набор данных, в то время как точность на стандартных задачных проверках в контролируемом обучении часто сопоставима с настроенными по конкретному набору данных базовыми моделями, и отдача по добавочной стоимости невелика.
Позиционирование.
Мы опираемся на унификацию (20). Вместо предложения очередного линейного варианта мы фиксируем модель как Ridge regression 10 и расходуем оставшийся бюджет на предварительную обработку: длину контекста, локальную нормализацию, регуляризацию и аугментацию, с поиском по горизонтам и по сериям на восьми бенчмарках. Это закрывает большую часть разрыва с более глубокими базовыми подходами и превращает оптимизированные гиперпараметры в диагностический инструмент: как оптимальная длина контекста масштабируется с горизонтом, превосходит ли хвостовая доля окна полное окно для нормализации, и насколько вариативность в наборе данных расходится между собой, всё это читается по результатам поиска и в основном невидимо в параметрах более глубоких моделей.
3 Метод
3.1 Предварительно: Ridge Regression
Toner and Darlow 20 показали, что недавние варианты линейного прогнозирования функционально эквивалентны неконстрейнированной линейной регрессии по соответствующим образом дополненным наборам признаков. Мы берем это объединение как исходную точку и опираемся на простую и эффективную настройку: Ridge regression 10 с замкнутым решением в явном виде. При контекстном окне из прошлых наблюдений для одной вариаты и горизонте прогнозирования модель предсказывает , где и . Матрица весов получается путем решения
| (1) |
где и являются обучающим контекстом и целевыми матрицами, собранными из скользящих окон; а — это сила регуляризации. Решение вычисляется в замкнутом виде без итерационной оптимизации, что делает обучение фактически мгновенным на одной GPU и чрезвычайно удобным для крупномасштабного поиска по гиперпараметрам. Каждая вариата моделируется независимо в соответствии с парадигмой независимости по каналам, которая доказала свою эффективность как для линейных (26), так и для прогнозаторов на базе Transformer-based (16).
3.2 Конвейер предобработки
Предобработка, применяемая перед простой Ridge-регрессией, где сосредоточена основная доля гибкости моделирования. Мы параметризуем ее по четырем осям.
Нормализация.
Мы рассматриваем два масштаба нормализации. Глобальная нормализация вычисляет статистики по всему обучающему набору для каждой вариаты; локальная нормализация вычисляет их по последним временным шагам каждого входного окна, где является локальным отношением. В любом случае мы поддерживаем два метода: стандартизацию (вычитание среднего, деление на стандартное отклонение) и робастную нормализацию (вычитание медианы, деление на межквартильный размах ). Локальная нормализация с восстанавливает полнокадровую instance normalization, использованную в предшествующих работах (20); значения ограничивают статистики долей контекста с запаздыванием, позволяя модели адаптироваться к последнему режиму распределений. Локальное отношение подбирается в логарифмической шкале между и . Согласно 20, при локальной нормализации мы добавляем покадровый масштаб в качестве дополнительного признака вместо свободного члена (который неинформативен, когда контекст имеет нулевое локальное среднее), позволяя регрессии выучить сдвиг, зависящий от волатильности; нулевой коэффициент на восстанавливает чистую instance normalization.
Длина контекста.
Учетный интервал определяет, сколько истории видит модель, и напрямую управляет размерностью задачи регрессии. Мы ищем по логарифмической шкале, при этом верхние границы ограничены размером данных и горизонтом прогноза.
Аугментация.
Мы при необходимости нарушаем окна обучения добавочным шумом, масштабированным на , либо во времени (гауссовский шум), либо в частотной области (гауссовское возмущение коэффициентов Фурье), где выполняется поиск в логарифмическом масштабе между и . Третья опция не применяет никакого аугментирования вовсе.
Регуляризация.
Вместо выбора одного мы оцениваем сетку из 21 логарифмически разнесенного значения (в диапазоне ) и сохраняем то, которое минимизирует величину потерь на валидации, по сути рассматривая регуляризацию как внутренний оптимизационный цикл, который не добавляет дополнительных затрат на поиск.
3.3 Группированный поиск по гиперпараметрам
Предыдущие работы почти всегда фиксируют один набор гиперпараметров предобработки для каждого набора данных, горизонта и вариации. Это вычислительно удобно, но предполагает определенную однородность внутри наборов данных, которая редко выполняется на практике: для разных горизонтов/вариаций могут требоваться разные длины контекста. Обратный крайний вариант — независимый поиск для каждого шага горизонта и для каждой вариации — позволил бы учесть эту неоднородность, но применяется редко, потому что бюджет поиска растет комбинаторно. Мы вводим групповую схему поиска, которая непрерывно перемещается между этими двумя крайними точками.
Горизонтальная группировка.
Мы разбиваем шагов прогноза на непрерывные блоки размера и делимся гиперпараметрами в каждом блоке. Установка восстанавливает полностью настройку для каждого шага; установка восстанавливает глобальную базовую линию. Промежуточные значения позволяют гиперпараметрам изменяться плавно вдоль горизонта прогноза без необходимости отдельного поиска для каждого шага.
Группировка серий.
Также вариации разбиваются на группы размера . Установка дает полностью по-рядный поиск, который может улавливать неоднородную динамику между каналами; установка разделяет веса и гиперпараметры для всех вариатов.
Единое представление.
Пара задает сетку ячеек поиска гиперпараметров по горизонтупризнакового пространства. Каждая ячейка выполняет независимый поиск Optuna с Tree-structured Parzen Estimator (2) по совместному пространству предварительной обработки: lookback , область и метод нормализации, local ratio , тип и интенсивность аугментации , где выбирается посредством внутреннего поиска по сетке для каждого испытания. Глобальная модель () и полностью локальная модель () являются частными случаями этой структуры.
Перекрёстная проверка.
Каждая попытка Optuna оценивает набор кандидатных гиперпараметров с использованием -кратной расширяющейся оконной кросс-валидации с окном на обучающем наборе, при этом разбиения формируются хронологически, чтобы учитывать временной порядок. Мы используем во всех основных экспериментах. Затем лучшие гиперпараметры применяются к удержанному тестовому набору, который никогда не используется во время поиска.
| Linear Models | Nonlinear Models | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| Dataset | SearchCast | OLS | FITS | DLinear | PatchTST | iTransformer | TimeMixer | TimesNet | Autoformer | |
| ETTm1 | 96 | 0.297 | 0.307 | 0.309 | 0.312 | 0.329 | 0.334 | 0.320 | 0.338 | 0.505 |
| 192 | 0.332 | 0.336 | 0.338 | 0.341 | 0.367 | 0.377 | 0.361 | 0.374 | 0.553 | |
| 336 | 0.357 | 0.365 | 0.367 | 0.372 | 0.401 | 0.426 | 0.408 | 0.410 | 0.621 | |
| 720 | 0.396 | 0.415 | 0.417 | 0.422 | 0.456 | 0.491 | 0.469 | 0.478 | 0.671 | |
| Avg | 0.346 | 0.356 | 0.358 | 0.362 | 0.388 | 0.407 | 0.389 | 0.400 | 0.588 | |
| ETTm2 | 96 | 0.160 | 0.162 | 0.162 | 0.163 | 0.175 | 0.180 | 0.175 | 0.187 | 0.255 |
| 192 | 0.212 | 0.216 | 0.217 | 0.217 | 0.241 | 0.250 | 0.241 | 0.249 | 0.281 | |
| 336 | 0.256 | 0.268 | 0.269 | 0.269 | 0.305 | 0.311 | 0.305 | 0.321 | 0.339 | |
| 720 | 0.323 | 0.349 | 0.350 | 0.354 | 0.402 | 0.412 | 0.378 | 0.408 | 0.433 | |
| Avg | 0.237 | 0.249 | 0.250 | 0.251 | 0.281 | 0.288 | 0.275 | 0.291 | 0.327 | |
| ETTh1 | 96 | 0.369 | 0.375 | 0.377 | 0.379 | 0.414 | 0.386 | 0.375 | 0.384 | 0.449 |
| 192 | 0.400 | 0.413 | 0.413 | 0.419 | 0.460 | 0.441 | 0.405 | 0.436 | 0.500 | |
| 336 | 0.423 | 0.445 | 0.432 | 0.451 | 0.501 | 0.487 | 0.439 | 0.491 | 0.521 | |
| 720 | 0.430 | 0.460 | 0.428 | 0.470 | 0.507 | 0.503 | 0.469 | 0.521 | 0.514 | |
| Avg | 0.405 | 0.423 | 0.412 | 0.430 | 0.471 | 0.454 | 0.422 | 0.458 | 0.496 | |
| ETTh2 | 96 | 0.268 | 0.270 | 0.270 | 0.275 | 0.302 | 0.297 | 0.289 | 0.340 | 0.346 |
| 192 | 0.330 | 0.331 | 0.331 | 0.342 | 0.388 | 0.380 | 0.333 | 0.402 | 0.456 | |
| 336 | 0.354 | 0.354 | 0.354 | 0.359 | 0.426 | 0.428 | 0.374 | 0.452 | 0.482 | |
| 720 | 0.383 | 0.380 | 0.377 | 0.384 | 0.431 | 0.427 | 0.416 | 0.462 | 0.515 | |
| Avg | 0.334 | 0.334 | 0.333 | 0.340 | 0.387 | 0.383 | 0.353 | 0.414 | 0.450 | |
| Electricity | 96 | 0.130 | 0.133 | 0.133 | 0.134 | 0.129 | 0.148 | 0.150 | 0.168 | 0.201 |
| 192 | 0.145 | 0.148 | 0.148 | 0.149 | 0.147 | 0.162 | 0.163 | 0.184 | 0.222 | |
| 336 | 0.161 | 0.164 | 0.164 | 0.165 | 0.163 | 0.178 | 0.178 | 0.198 | 0.231 | |
| 720 | 0.199 | 0.203 | 0.203 | 0.205 | 0.197 | 0.225 | 0.220 | 0.220 | 0.254 | |
| Avg | 0.159 | 0.162 | 0.162 | 0.163 | 0.159 | 0.178 | 0.178 | 0.192 | 0.227 | |
| Traffic | 96 | 0.379 | 0.385 | 0.386 | 0.387 | 0.360 | 0.395 | 0.392 | 0.593 | 0.613 |
| 192 | 0.391 | 0.397 | 0.398 | 0.399 | 0.379 | 0.417 | 0.408 | 0.617 | 0.616 | |
| 336 | 0.404 | 0.410 | 0.411 | 0.412 | 0.392 | 0.433 | 0.422 | 0.629 | 0.622 | |
| 720 | 0.441 | 0.448 | 0.449 | 0.450 | 0.432 | 0.467 | 0.459 | 0.640 | 0.660 | |
| Avg | 0.404 | 0.410 | 0.411 | 0.412 | 0.391 | 0.428 | 0.420 | 0.620 | 0.628 | |
| Weather | 96 | 0.141 | 0.141 | 0.142 | 0.142 | 0.149 | 0.174 | 0.164 | 0.172 | 0.266 |
| 192 | 0.184 | 0.184 | 0.185 | 0.185 | 0.194 | 0.221 | 0.215 | 0.219 | 0.307 | |
| 336 | 0.234 | 0.234 | 0.236 | 0.235 | 0.245 | 0.278 | 0.272 | 0.280 | 0.359 | |
| 720 | 0.304 | 0.307 | 0.307 | 0.310 | 0.314 | 0.358 | 0.351 | 0.365 | 0.419 | |
| Avg | 0.215 | 0.217 | 0.218 | 0.218 | 0.225 | 0.258 | 0.250 | 0.259 | 0.338 | |
| Exchange | 96 | 0.081 | 0.086 | 0.087 | 0.085 | 0.088 | 0.086 | 0.086 | 0.107 | 0.197 |
| 192 | 0.167 | 0.180 | 0.183 | 0.178 | 0.176 | 0.177 | 0.177 | 0.226 | 0.300 | |
| 336 | 0.305 | 0.343 | 0.344 | 0.335 | 0.301 | 0.331 | 0.338 | 0.367 | 0.509 | |
| 720 | 0.811 | 0.992 | 0.965 | 0.920 | 0.901 | 0.901 | 0.920 | 0.964 | 1.447 | |
| Avg | 0.341 | 0.400 | 0.395 | 0.380 | 0.366 | 0.374 | 0.380 | 0.416 | 0.613 | |
4 Эксперименты
4.1 Экспериментальная установка
Наборы данных
Мы оцениваем на восьми широко используемых многомерных наборах для прогнозирования, охватывающих различные области и временные масштабы: ETTh1 и ETTh2 (температура преобразователя электричества, почасовая), ETTm1 и ETTm2 (тот же источник, интервалы 15 минут), Weather (21 метеорологический показатель, 10-минутный), Electricity (321 клиент, почасовая), Traffic (862 дорожных сенсора, почасовая) и Exchange (ежедневные курсы обмена для 8 стран). Следуя стандартному протоколу (25; 26; 20), каждый набор данных хронологически разделяется на обучающую, валидационную и тестовую части в соотношении 6:2:2 для ETT и 7:1:2 для остальных.
Протокол оценки.
Мы сообщаем MSE на горизонтах и для усреднений по каждому набору данных. Поиск использует 20 Optuna-испытаний на ячейку и трехкратную перекрестную проверку. Поскольку наш метод выполняет поиск по длине контекста , каждый фолд перекрестной проверки включает дополнительную предвалидационную историю, необходимую для формирования входного окна, но сохраняет число целевых точек валидации фиксированным для всех кандидатов . Таким образом, более длинные контексты не получают больше валидационных примеров и не используют другой интервал валидации.
Базовые модели.
Линейный: OLS, FITS (с нормализацией экземпляра, из 20) и DLinear 26. Они выделяют прирост, связанный с поиском по предварительной обработке, а не с возможностями модели. Нелинейный: PatchTST 16, iTransformer (15), TimeMixer (22), TimesNet (24) и Autoformer (25), охватывающие семейства Transformer, MLP и CNN. Нелинейные базовые модели используют наилучший период предыстории , как опубликовано; линейные базовые модели из 20 используют . Наш метод выполняет поиск по (при сохранении фиксированного набора валидационных образцов для корректного сравнения) — степень свободы, которую мы утверждаем, недоисследовали.
4.2 Основные результаты
Таблица 1 сообщает MSE по восьми наборам. В линейном классе наш конвейер SearchCast достигает наилучшего среднего MSE на семи из восьми наборов данных и сравнивается с FITS на ETTh2 ( vs. ). Снижение по сравнению с OLS дает на ETTm2, на ETTh1 и на Exchange. Разрыв согласован по , а не обусловлен одним горизонтом, что указывает на то, что выигрыш возникает за счет вариантов препроцессинга, которые обобщаются. По сравнению с нелинейными базовыми методами, наш выигрывает среднее на шести из восьми бенчмарков, несмотря на отсутствие нелинейности и отсутствие обученного представления. Оба проигрыша PatchTST: Electricity (сравнены на ) и Traffic ( vs. ), по двум крупнейшим наборам данных ( и каналов), где совместные представления по похожим сериям, вероятно, помогают Transformers больше, чем простое Ridge. Это согласуется с Рисунок 4, где умеренная группировка серий благоприятна для этих двух наборов данных. На оставшихся шести наборах данных преимущество над PatchTST варьируется от (Weather) до (ETTm2). Линейное сравнение изолирует вклад поиска препроцессинга; нелинейное сравнение показывает, что он достаточно велик, чтобы закрыть разрыв на большинстве бенчмарков.
5 Анализ
Мы используем выход поиска как диагностический показатель данных. Сначала мы изучаем, как оптимальная длина ретроспективного окна изменяется в зависимости от горизонта и ряда (§5.1), затем насколько безопасно выполнять совместное использование гиперпараметров между рядами и горизонтами (§5.2). Прогнозы и перенастройка весов Ridge связывают эти решения с поведением модели (§5.3). Оставшиеся подразделы выделяют основные варианты предобработки: локальная нормализация (§5.4), вариативность на уровне ряда в и (§5.5), а также тип и интенсивность аугментации (§5.6).
5.1 Период ретроспективного обзора v.s.. Горизонт по всем наборам данных
Рисунок 3(a,b) соответствует искомому оптимальному контексту на каждой группе горизонтов по каждому набору данных. Показатели охватывают оба знака и порядок величины: от на ETTm2 до на Exchange и Traffic. ETTm2 — единственный набор данных, где традиционная интуиция подтверждается особенно сильно: на более длинных горизонтах требуется больше истории, хотя и сублинейно. ETTm1 и ETTh2 находятся в мягком положительном режиме (–); Weather и Electricity почти не меняются (), сходясь к шагам независимо от горизонта. Отрицательные показатели на Exchange и Traffic — самые информативные: более длинные горизонты предпочитают более короткий контекст, что согласуется с нестационарностью, при которой дальняя история активно вводит модель в заблуждение. Стандартное значение поэтому неверно одновременно в двух противоположных направлениях: оно недодает Weather и Electricity примерно на порядок величины и переоценивает Exchange и Traffic на длинных горизонтах, где оптимум опускается ниже .
Рисунок 3(c) повторяет точность для каждой вариаты. Показатели степени на уровне датасета агрегируются по значительному разбросу внутри датасета. Погода является единственным бенчмарком, чьи показатели степени для отдельных рядов плотно группируются вокруг медианы; ETTh2, Electricity и Traffic пересекают ноль, что означает: некоторые каналы предпочитают растущий контекст по горизонту, в то время как другие — уменьшающийся. Это подчеркивает, что одна общая длина окна ретроспективы недостаточна даже внутри одного датасета, что и мотивирует анализ группирования рядов/горизонта ниже.
5.2 Серийная и группировка горизонтов
Рисунок 4 (верхний) последовательно меняет размер группы серий от раздельного для каждой серии () до полностью общего (), сообщая о деградации MSE относительно наилучшего для набора данных. На изображении наблюдается немонотонность. Полностью общая настройка лучше на обоих ETT-бенчмарках, где поиск по каждой серии ухудшает MSE на –, что предполагает физически связанные вариации, которые взаимно регуляризуют друг друга. Полностью раздельная настройка лучше для Weather, где деградация растет монотонно с до при , что предполагает, что его 21 канал (давление, влажность, ветер, дождевые осадки) существуют на несовместимых шкалах. Electricity предпочитает промежуточные размеры (). Результат указывает, что оптимальная степень взаимного обмена между сериями является свойством набора данных.
Нижняя строка последовательно охватывает . группы объединяют последовательные горизонты в интервалы ширины , которые имеют одну и ту же настройку HP: при горизонты и настраиваются отдельно; при все используют единую настройку. Четыре порога оценки достаточно разнесены, чтобы попадать в разные интервалы для каждого допустимого . Поэтому по мере роста четыре сообщаемых порога сохраняют свои собственные настроенные HP; только горизонты вблизи каждого порога постепенно поглощаются его интервалом. Кривые плоские ( деградация), с оптимумами при для ETTm2 и Electricity, и при для ETTh1 и Weather. Это говорит о том, что HP изменяются плавно с в окрестности из 48 шагов, согласуясь с плавными тенденциями в §5.1. Мы принимаем по умолчанию из-за его эффективности и расходуем бюджет испытаний на поиск вместо этого.
5.3 Прогнозы и визуализация обученных весов
Рисунок 5 показывает наблюдаемый эффект поиска. При фиксированных настройках по умолчанию на уровне набора данных Ridge смещается к среднему значению по мере роста горизонта, особенно для Weather и Exchange. Настроенная модель продолжает следовать медленному дрейфу, поскольку эти наборы данных выбирают короткий эффективный контекст, небольшие локальные окна нормализации или и то и другое (Рисунки 3b и 7).
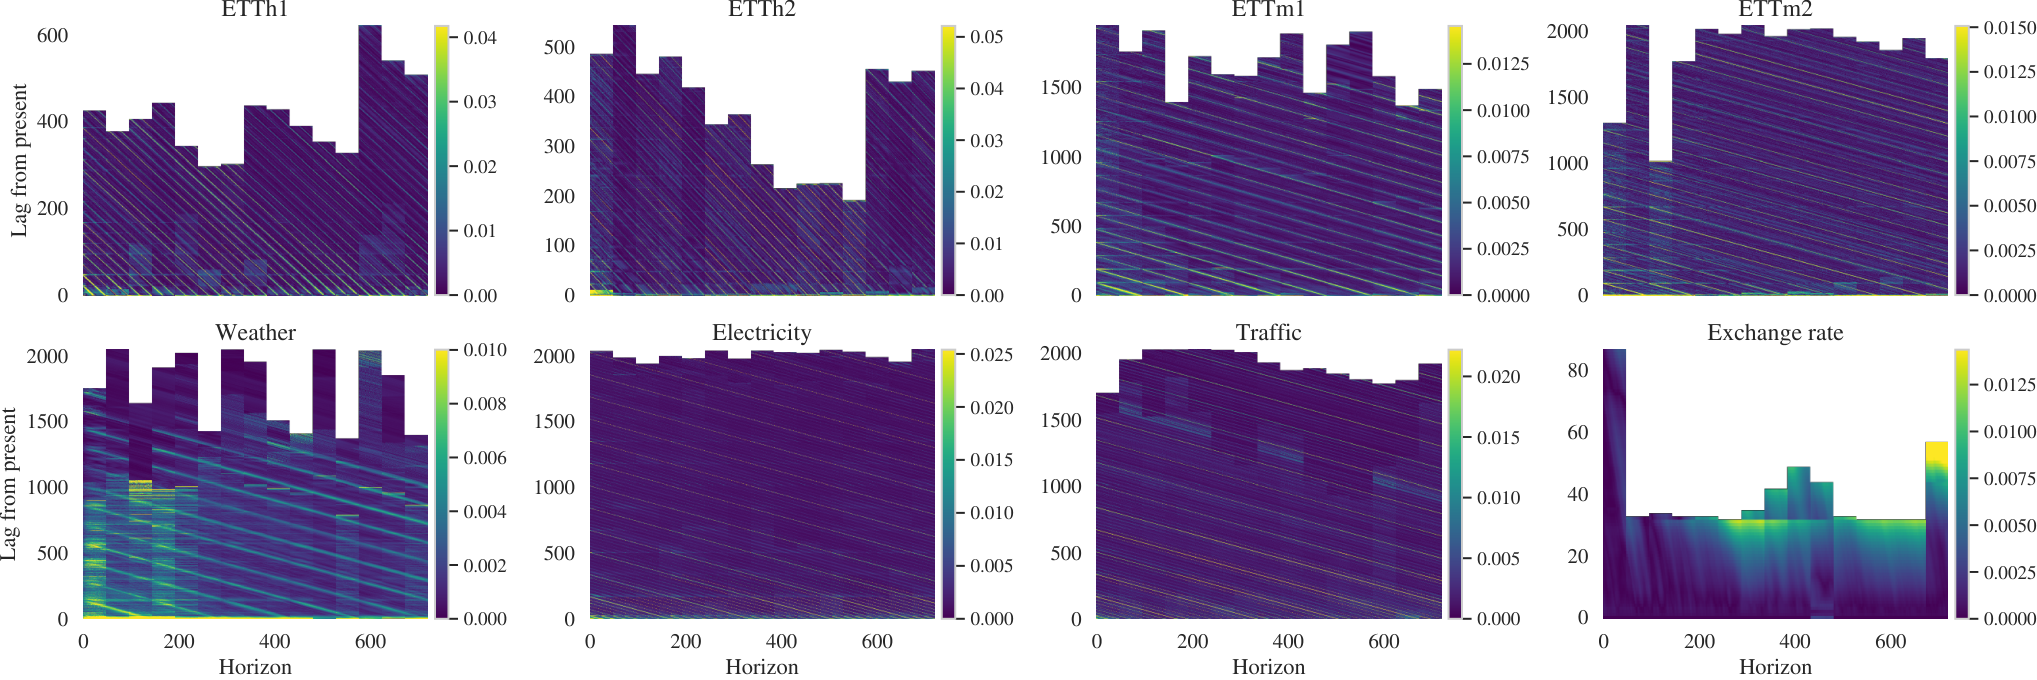
Рисунок 6 показывает, для чего используются выбранные окна просмотра. Exchange почти все весовые значения возлагает на недавние задержки, что соответствует его поведению с короткой памятью. Traffic и ETTh2 используют календарные задержки: Traffic имеет выраженные недельные полосы около , тогда как ETTh2 демонстрирует более короткую дневную «расческу». Electricity смешивает зависимость от lag- с удалёнными якорями. Наборы данных Weather и ETTm часто размещают свои наибольшие веса сотнями шагов назад. Таким образом, длинный в основном даёт модели доступ лишь к нескольким наблюдениям, согласованным по фазе, а не ко всей истории. Переходы на границах бинов показывают компромисс: группировка по горизонту слабо меняет MSE (; §5.2), но она может резко менять веса.
5.4 Глобальный v.s. Локальная нормализация
Предикторы на основе линейной модели нормализуют либо глобально (статистики обучающего набора), либо локально (полное окно входных данных) (20; 26). Мы ослабляем локальный случай до изучаемой доли запаздывания : восстанавливает нормализацию с полным окном, ограничивает статистики последними шагами. На ETTh1, ETTm2, Weather и Exchange мы обнаружили, что локальный вариант выбирается в 62–100% ячеек для сочетаний набор данных–горизонт; колонка local-ratio на Рисунке 7 показывает, что оптимальное почти всегда строго отрицательно, группируясь в — долях запаздывания между и окна. Нормализация с полным окном практически никогда не выбирается. Эффект наиболее силён для ETTm2 и Exchange, где многие ячейки располагаются рядом с : только последние несколько процентов набора для просмотра задают масштаб. Эти ряды нестационарны на шкале , и статистики полного окна размывают режимы, которые модели выгоднее сохранять различимыми. Мы также проверили устойчивую вариантность на основе медианы/IQR для локальной нормализации, но она во всех протестированных настройках показала худшие результаты по сравнению с mean/std, что указывает на то, что вариации хвоста и большие отклонения несут полезную информацию о масштабе в этих бенчмарках. Поэтому мы используем локальную стандартизацию в Таблице 1 и ищем только долю запаздывания .
5.5 Вариации гиперпараметров по сериям
Рисунки 3 и 7 определяют, какие гиперпараметры определяют различие между Weather и ETTh1. Горизонт просмотра одинаков в рамках рядов на ETTh1 и распределён на Weather (Рисунок 3c). Локальное соотношение и тепловые карты на Рисунке 7 уточняют картину. ETTh1: обе строки визуально однородны по четырём вариациям и изменяются больше с горизонтом, чем с рядом, что согласуется с вариациями из одной физической системы. Weather: две строки расходятся — локальное соотношение широко варьирует (OT при против LULL рядом с ), а показывает большой разрыв между OT () и остальными каналами (около ). Поэтому прирост на ряд в Weather (Рисунок 4) обусловлен локальным соотношением и , а не lookback. ETTm2 и Exchange находятся между этими крайностями; группирование по типу измерения или по нескольким кластерам, вероятно, позволит уловить большую часть неоднородности за долю полной стоимости по каждому ряду.
5.6 Выбор и интенсивность аугментации
Рисунок 8(a): дополнение выбрано в – групп горизонтов на каждом наборе данных, при этом шум во временной и частотной областях разделен примерно поровну (время встречается немного чаще). Рисунок 8(b) показывает, как они выбираются. Разброс оптимального внутри набора данных сам по себе зависит от набора: Weather и Exchange имеют самый широкий разброс (ближние и дальние группы горизонтов требуют разных уровней шума); ETTm1, Electricity и Traffic — более узкие.
6 Вывод
Репутация линейных моделей как неконкурентоспособных базовых решений в долгосрочном прогнозировании отражает недостаточно настроенную предобработку, а не ограниченную емкость модели. Подбор Ridge regression по длине контекста, локальной нормализации, регуляризации и аугментации обеспечивает совпадение или превосходство ранее использовавшихся линейных базовых решений, а также базовых решений на Transformer, MLP и CNN на большинстве стандартных бенчмарков, при значительно меньших затратах на обучение. Помимо точности, оптимизированные гиперпараметры служат диагностическим инструментом для данных: оптимальный период наблюдения может увеличиваться, выходить на плато или уменьшаться в зависимости от горизонта прогноза и стационарности набора данных; нормализация почти всегда локальная и ограничена отстающей долей окна; межсерийное разделение зависит от набора данных — от полностью разделяемого до полностью по сериям, и неоднородность определяется нормализацией и регуляризацией, а не периодом наблюдения; и та же локальность и сезонность, которые извлекаются поиском в гиперпараметрах, непосредственно видны в обученных весах. Эти решения по предобработке переносятся на любой класс моделей, а выпущенный конвейер SearchCast позволяет запускать ту же диагностику на новых наборах данных с минимальными затратами.
Ссылки
- [1] Д. Абхиманью (2024) Декодер-ориентированная базовая модель для прогнозирования временных рядов. На Международной конференции по машинному обучению, Цитируется: §2.
- [2] T. Akiba, S. Sano, T. Yanase, T. Ohta и M. Koyama (2019) Optuna: платформа для гиперпараметрической оптимизации следующего поколения. В материалах 25-й международной конференции ACM SIGKDD по поиску знаний и интеллектуальному анализу данных, стр. 2623–2631. Цитируется: Appendix F, §3.3.
- [3] A. F. Ansari, L. Stella, A. C. Turkmen, X. Zhang, P. Mercado, H. Shen, O. Shchur, S. S. Rangapuram, S. P. Arango, S. Kapoor, et al. (2024) Chronos: Learning the Language of Time Series. Transactions on Machine Learning Research. Cited by: §2.
- ⟦[4] W. A. Brock, W. D. Dechert, J. A. Scheinkman, and B. LeBaron (1996) Тест на независимость на основе корреляционного измерения. Econometric Reviews 15 (3), стр. 197–235. Cited by: Appendix C.
- ⟦C. Challu, K. G. Olivares, B. N. Oreshkin, F. G. Ramirez, M. M. Canseco и A. Dubrawski (2023) Nhits: Neural hierarchical interpolation for time series forecasting. In Proceedings of the AAAI conference on artificial intelligence, pp. 6989–6997. Cited by: §1.
- [6] S. Chen, C. Li, N. Yoder, S. O. Arik, and T. Pfister (2023) Tsmixer: Архитектура только на MLP для прогнозирования временных рядов. arXiv preprint arXiv:2303.06053. Ссылается: §1, §2.
- [7] Р. Б. Кливленд, У. С. Кливленд, Дж. Э. МакРэ, и И. Терпеннинг (1990) STL: Процедура сезонно-трендового разложения на основе Loess. Journal of Official Statistics 6 (1), стр. 3–73. Цитируется: Appendix A.
- [8] L. Darlow, Q. Deng, A. Hassan, M. Asenov, R. Singh, A. Joosen, A. Barker, and A. Storkey (2025) DAM: К развитию базовой модели для прогнозирования. In International Conference on Learning Representations, Cited by: §2.
- [9] A. Das, W. Kong, A. Leach, S. Mathur, R. Sen, and R. Yu (2023) Долгосрочное прогнозирование приливов: плотный временной рядовой энкодер. предварительная публикация arXiv arXiv:2304.08424. Цитируется по: §1, §2.
- [10] А. Е. Хёрл и Р. У. Кеннард (1970) Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics 12, стр. 55–67. Цитируется: §1, §2, §3.1, Abstract.
- [11] Р. Дж. Хиндман и Г. Атанасопулос (2021) Прогнозирование: принципы и практика. OTexts. Цитируется: Appendix A, Appendix B.
- [12] Т. Ким, Дж. Ким, Й. Тэ, С. Парк, Дж. Чой и Дж. Чу (2022) Обратимая нормализация экземпляров для точного прогнозирования временных рядов при сдвиге распределения. На Международной конференции по обучению представлениям, Цитируется: §2.
- [13] З. Ли, С. Ци, И. Ли и З. Сюй (2023) Переосмысление прогнозирования временных рядов на длительном горизонте: исследование линейного отображения. arXiv preprint arXiv:2305.10721. Цитируется: §1, §2.
- [14] С. Лин, У. Лин, У. У, Х. Чен и Дж. Ян (2024) Sparsetsf: моделирование долгосрочного прогнозирования временных рядов с 1k параметрами. arXiv preprint arXiv:2405.00946. Цитируется: §1, §2.
- [15] Ю. Лю, Т. Ху, Х. Чжан, Х. У, С. Ван, Л. Ма и М. Лонг (2023) itransformer: Инвертированные transformers эффективны для прогнозирования временных рядов. arXiv preprint arXiv:2310.06625. Цитируется: 3rd item, §1, §2, §4.1.
- ⟦[16] И. Нье, Н. Х. Нгуен, П. Синтхунг и Дж. Каланагнам (2022) Временной ряд стоит 64 слова: долгосрочное прогнозирование с помощью transformers. arXiv preprint arXiv:2211.14730. Цитируется: 2nd item, §1, §2, §3.1, §4.1.
- [17] Б. Н. Орешкин, Д. Карпов, Н. Шападос и Й. Бенжио (2020) N-BEATS: Neural basis expansion analysis for interpretable time series forecasting. In International Conference on Learning Representations, Ссылки: §1.
- [18] X. Qiu, J. Hu, L. Zhou, X. Wu, J. Du, B. Zhang, C. Guo, A. Zhou, C. S. Jensen, Z. Sheng, и др. (2024) Tfb: К всестороннему и справедливому сравнению методов прогнозирования временных рядов. Предварительная публикация arXiv arXiv:2403.20150. Цитируется: Appendix D, 7th item, §2.
- [19] С. Сиболд и Дж. Перктолд (2010) statsmodels: Эконометрическое и статистическое моделирование на Python. В материалах 9-й конференции Python в науке (SciPy), стр. 92–96. Цитируется: Appendix C, Appendix F.
- [20] W. Toner and L. Darlow (2024) Анализ моделей прогнозирования временных рядов линейного времени. В материалах 41-й Международной конференции по машинному обучению, стр. 48404–48427. Цитируется: Appendix F, §1, §2, §2, §2, §3.1, §3.2, Table 1, §4.1, §4.1, §5.4.
- [21] A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, Ł. Kaiser, and I. Polosukhin (2017) Внимание — это всё, что нужно. Труды нейронных систем обработки информации 30. Цитируется: §1.
- [22] С. Ван, Х. У, С. Ши, Т. Ху, Х. Луо, Л. Ма, Ц. Ю. Чжан и Дж. Чжоу (2024) Timemixer: Decomposable multiscale mixing for time series forecasting. arXiv preprint arXiv:2405.14616. Cited by: 4th item, §1, §2, §4.1.
- ⟦[23] G. Woo, C. Liu, A. Kumar, C. Xiong, S. Savarese, и D. Sahoo (2024) Единое обучение универсальных трансформаторов для прогнозирования временных рядов. На Международной конференции по машинному обучению, Цитируется: §2.
- [24] Х. У, Т. Ху, Ю. Лю, Х. Чжоу, Дж. Ван и М. Лонг (2022) Timesnet: моделирование временной двухмерной вариации для общего анализа временных рядов. препринт arXiv arXiv:2210.02186. Цитируется: 5th item, §1, §2, §4.1.
- ⟦H. Wu, J. Xu, J. Wang, and M. Long (2021) Autoformer: Decomposition transformers with auto-correlation for long-term series forecasting. Advances in neural information processing systems 34, pp. 22419–22430. Цитируется: Appendix A, 6th item, Appendix F, §1, §2, §4.1, §4.1.
- ⟦[26] А. Зенг, М. Чэнь, Л. Чжан и Ц. Сюй (2023) Действительно ли transformers эффективны для прогнозирования временных рядов?. В материалах конференции AAAI по искусственному интеллекту, стр. 11121–11128. Цитируется: Appendix A, Appendix A, 1st item, §1, §2, §3.1, §4.1, §4.1, §5.4.
- [27] Т. Чжоу, З. Ма, Ц. Вэнь, С. Ван, Л. Сун и Р. Цзинь (2022) Fedformer: Frequency enhanced decomposed transformer для долгосрочного прогнозирования временных рядов. На Международной конференции по machine learning, стр. 27268–27286. Цитируется: Appendix A, Appendix A, §1, §2.
Appendix A Дальнодействующая линейная автокорреляция в тестовой серии
Поиск по каждому датасету из Раздела 5.1 выбирает длины контекста, отличающиеся на два порядка величины: от нескольких десятков шагов на Exchange до примерно тысячи на Weather и Electricity (Рисунок 3). В этом приложении рассматривается базовый вопрос, лежащий в основе такого результата. Когда поиск назначает модели длинный контекст, действительно ли существует полезная информация так далеко в прошлом, или модель лишь повторно представляет очевидный ежедневный либо еженедельный цикл, который гораздо более простой сезонный метод (26; 27) мог бы уловить без длинного контекста? Мы отвечаем на это, измеряя, насколько сильно каждая временная серия линейно связана со своим собственным прошлым: как на исходной серии, так и после устранения сезонности. Устранение сезонности здесь означает удаление известных периодических циклов серии (например, ежедневного и еженедельного), так что любая оставшаяся корреляция не может быть объяснена только этими циклами. Мы применяем четыре метода устранения сезонности возрастающей силы (определены ниже) и проверяем, сохраняется ли дальняя корреляция при всех них.
Автокорреляция с лагом — это коэффициент корреляции Пирсона между рядом во времени и тем же рядом шагов ранее, , вычисляемый по всем и затем усредняемый по каналам набора данных (11). Она изменяется от до . Значение, близкое к , означает, что значение шагов назад несет по существу никакой линейной информации о настоящем, тогда как большая по модулю величина означает, что она несет существенную такую информацию. Поскольку мы сосредоточиваемся на линейной связи, автокорреляция является именно тем типом структуры, который наш предсказатель может использовать. Перед измерением каждый ряд стандартизируют с помощью z-оценки, используя только статистики обучающего набора, то есть сдвигают и масштабируют так, чтобы получить среднее и дисперсию , применяя величины, вычисленные только по обучающей части, чтобы измерение было сопоставимым между рядами и не использовало тестовые данные.
От самых слабых к самым сильным мы применяем четыре метода устранения сезонности. В исходном варианте ничего не удаляется. В варианте «для каждой позиции в периоде» вычитается среднее значение для каждой позиции доминирующего цикла (например, среднее для каждого часа суток). В гармоническом варианте вычитаются подогнанные синусоидальные и косинусоидальные волны на всех известных периодах, таких как ежедневный и еженедельный. В варианте STL применяется стандартная процедура, которая разделяет ряд на тренд, сезонную составляющую и остаток, оставляя только остаток (7). Обоснование попытки всех четырех заключается в том, что если бы корреляция на больших лагах полностью являлась периодическим циклом, модель, которая явно представляет циклы, такая как разложение тренд-сезонность внутри DLinear (26) или операторы в частотной области Autoformer и FEDformer (25; 27), могла бы воспроизвести это с низкими затратами, и длинный контекст не давал бы никакого подлинного преимущества для чисто линейной модели. Каждая сообщаемая корреляция снабжена доверительным интервалом , полученным с помощью bootstrap по парной пересэмплировке. Мы пересэмплируем наблюдаемые пары с возвращением ( раз), каждый раз заново вычисляем корреляцию и сообщаем средний из этих значений. Узкий интервал означает, что оценка статистически надежна.
Рисунок 9 показывает автокорреляцию по всем измеренным задержкам для четырех вариантов, а Таблица 2 приводит срез при задержке — самом длинном прогнозном горизонте, оцененном в Разделе 4. Все шесть наборов данных сохраняют существенную корреляцию на , между и , при этом доверительные интервалы значительно превышают . Четыре метода удаления согласуются на больших задержках, так что сохраняющаяся корреляция не является артефактом какого-либо одного варианта сезонной декомпозиции. На ETTm1 и ETTm2 декоррелированная корреляция на самом деле выше, чем исходная, потому что удаление сильного дневного цикла выявляет более медленную структуру, которую этот цикл скрывал.
| Dataset | 95% CI | |
|---|---|---|
| ETTh1 | 0.387 | [0.381, 0.394] |
| ETTh2 | 0.526 | [0.521, 0.531] |
| ETTm1 | 0.435 | [0.433, 0.438] |
| ETTm2 | 0.725 | [0.723, 0.728] |
| Weather | 0.428 | [0.400, 0.451] |
| Exchange | 0.532 | [0.527, 0.538] |
Even after the obvious daily and weekly cycles are removed, a value from steps in the past still carries a real and moderately strong linear association with the current value (correlation to ). Therefore, when the search provides the linear model with a long context on these datasets, the model is genuinely exploiting long-range information rather than re-representing a cycle that a simpler seasonal method could capture.
Appendix B How much accuracy comes from context length alone
Section 5.1 shows which context length the full search prefers on each dataset. This appendix isolates a narrower question. Of the accuracy our method gains, how much is due to the context length by itself, as opposed to the other preprocessing choices (normalization, regularization, augmentation)? To answer it we hold every other preprocessing setting fixed and vary only .
We use a single fixed preprocessing configuration everywhere, which we call the universal default. This default uses local mean normalization, the standard regularization grid described in Section 3, and no augmentation. Keeping this configuration identical across datasets means that any change in error can be attributed to alone. We sweep , forecast at the longest horizon , and report the test mean squared error (MSE, the held-out squared prediction error used throughout our evaluation in Section 4, where lower is better). For each we report the median MSE across channels and random seeds, the median being robust to a few unusually hard channels.
Figure 10 plots the full error-versus- curves and Table 3 lists the endpoints. The datasets fall into three clear regimes. In the strong regime (ETTh1, ETTh2, Weather) the error continues to decrease as grows to , for a total reduction between and . In the plateau regime (ETTm2) most of the reduction is achieved by –, after which the curve saturates, for a reduction. In the flat regime (ETTm1) additional context yields almost no improvement. Exchange is shown only partially because its test split is too short to form windows with both and . Two points follow. First, on the strong-regime datasets a fixed short default such as forfeits most of the attainable accuracy before any other preprocessing setting is tuned. Second, which regime a dataset falls into cannot be predicted from its metadata in advance and must instead be measured, which is why our method (Section 3) searches per dataset rather than fixing it. We also note that re-running the full preprocessing search while holding fixed at a short value does not recover the long-context gain, which indicates that context length itself, rather than the other settings, is the source of the improvement.
| Dataset | Total drop | |||
|---|---|---|---|---|
| ETTh1 | 0.91 | 0.75 | 0.55 | |
| ETTh2 | 0.47 | 0.38 | 0.22 | |
| Weather | 0.45 | 0.37 | 0.29 | |
| ETTm2 | 0.31 | 0.25 | 0.26 | |
| ETTm1 | 0.66 | 0.63 | 0.66 | flat |
| Exchange | 1.75 | 1.33 | – | partial |
To confirm that the model performs substantive forecasting rather than merely repeating recent values, we compare it against a persistence forecast, the naive rule that predicts the future to equal the last observed value, (also called a no-change or random-walk forecast) (11). Table 4 reports the ratio of the persistence error to the Ridge error at . Ridge is between and times more accurate on every dataset.
| Dataset | Persistence MSE | Ridge MSE | Ratio (Persistence / Ridge) |
|---|---|---|---|
| ETTh1 | 1.10 | 0.43 | 2.56 |
| ETTh2 | 0.60 | 0.38 | 1.56 |
| ETTm1 | 2.33 | 0.40 | 5.87 |
| ETTm2 | 0.46 | 0.32 | 1.44 |
| Weather | 0.55 | 0.30 | 1.81 |
| Exchange | 1.42 | 0.81 | 1.75 |
For some datasets (ETTh1, ETTh2, Weather), extending the linear model’s context, with no other change, reduces its error by to . For others (ETTm1) it yields almost no improvement. No single context length is best for every dataset, so the only reliable way to identify each dataset’s optimal value is to search for it (Section 3). The persistence comparison confirms that the model performs genuine forecasting rather than reproducing the most recent value.
Appendix C Does a nonlinear model capture structure the linear model misses?
Our main results (Section 4, Table 1) show that the tuned linear model matches or beats the strongest nonlinear baseline, PatchTST, on six of the eight benchmarks. A natural concern is that MSE may fail to reflect everything a model captures. Perhaps a nonlinear model captures genuine structure that does not register in the error value, so that the linear model would only appear competitive. This appendix addresses that concern directly by examining the prediction errors that each model produces.
The residuals of a model are its prediction errors at the forecast step, . If a model has captured everything predictable in a series, its residuals should resemble random noise with no remaining pattern. A linear model can only represent linear relationships (weighted sums of past values), so any nonlinear structure (a pattern in which the influence of the past is not a fixed linear weight) remains in its residuals. We therefore assess how closely each model’s residuals resemble pure noise, using the Brock–Dechert–Scheinkman (BDS) test (4), a standard statistical test of whether a sequence is independent random noise or still contains residual dependence, as implemented in statsmodels (19). We apply it at embedding dimension two, meaning it inspects how often pairs of points fall close together relative to the frequency expected under pure randomness. A larger BDS statistic indicates more residual non-random structure. We compare the statistic itself rather than its -value, because with this many points every -value is driven to and can no longer distinguish the models.
For each model we form the per-cell difference , matched on the same (dataset, context length, horizon, seed, channel). A negative means that model’s residuals are closer to noise than the linear model’s, that is, it captured nonlinear structure that the linear model did not. As in Appendix A, each comparison carries a confidence interval from resampling, and we call a cell significant when that interval excludes (for example, does, whereas does not). Table 5 aggregates the comparison over the six standard benchmarks (ETTh1, ETTh2, ETTm1, ETTm2, Weather, Exchange) and, separately, over the two large many-channel datasets (Electricity with channels and Traffic with ), where Section 4 reports that PatchTST tends to achieve lower error (Table 1). DLinear, itself a linear model, lies near , as expected, and serves as a control confirming that the test does not report differences where none exist.
| Comparison | Group | cells | Mean | Significant cells | Mean fraction |
|---|---|---|---|---|---|
| DLinear Ridge | standard | 24 | 13/24 | 0.59 | |
| DLinear Ridge | large | 16 | 9/16 | 0.61 | |
| Transformer Ridge | standard | 24 | 10/24 | 0.55 | |
| Transformer Ridge | large | 16 | 9/16 | 0.38 | |
| iTransformer Ridge | standard | 24 | 14/24 | 0.44 | |
| iTransformer Ridge | large | 16 | 9/16 | 0.45 | |
| PatchTST Ridge | standard | 24 | 18/24 | 0.70 | |
| PatchTST Ridge | large | 8 | 1/8 | 0.62 |
On the six standard benchmarks PatchTST shows a clear negative difference (mean , significant in of cells). It does leave less non-random structure in its residuals than the linear model, indicating that it captures nonlinear patterns the linear model cannot. However, on those same six datasets this additional structure does not change the accuracy ranking, on which the tuned linear model still matches or outperforms PatchTST in Table 1. Two further observations qualify a simple “more capacity captures more structure” interpretation. On Weather the difference is positive and significant at three of four horizons, indicating that PatchTST’s residuals are more structured than the linear model’s on that dataset. On the two large datasets, where PatchTST does achieve lower error, only one of eight comparisons is significant, so its advantage there is not explained by the capture of nonlinear structure.
In summary, the strongest nonlinear model does extract some patterns that the linear model does not capture, and the test detects them clearly on the six standard datasets. However, on those same datasets this additional structure does not translate into lower error. The tuned linear model still matches or outperforms the nonlinear one (Table 1). In other words, most of what determines accuracy on these benchmarks is the long-range linear signal documented in Appendix A, exploited through an appropriate context length as documented in Appendix B. The additional nonlinear structure that a higher-capacity model captures is real but yields little or no accuracy benefit here. On the two large datasets, where a higher-capacity model does achieve lower error, this test indicates that its advantage arises from a source other than the capture of nonlinear structure.
Appendix D Limitations
Our study is limited to standard numeric long-horizon forecasting benchmarks, so the lookback-scaling, locality, and heterogeneity patterns we report should be read as findings for this regime rather than universal claims. We follow prior work in reporting point-estimate MSE; very small margins should therefore be treated as ties. Nonlinear baselines are quoted from their original publications, so comparisons reflect published configurations rather than a jointly retuned preprocessing protocol (18). Per-series search scales with channel count, which motivates our practical choice of and moderate ; finer-grained search may yield further gains. Finally, our claims are specific to Ridge with searched preprocessing. Applying the same preprocessing search to deeper models, and comparing all model classes under jointly tuned preprocessing, remains future work.
Appendix E Broader Impact
This work is methodological and is evaluated entirely on public numeric time-series benchmarks. It does not use human-subject data, target individual users, or study deployment in a real operational system. Its most direct positive impact is practical: closed-form Ridge models with searched preprocessing provide a strong, reproducible baseline at substantially lower compute cost than many nonlinear forecasters, making rigorous long-horizon forecasting comparisons more accessible in settings without large GPU budgets. The transparency of the resulting models also supports diagnostics: selected context length, locality, and per-series disagreement can be inspected directly and may inform the design of larger forecasters.
The main potential negative impacts are generic to forecasting research. More accurate long-horizon forecasts can be applied to sensitive operational signals, including energy, traffic, and financial time series, where misuse could affect privacy, resource allocation, infrastructure operation, or markets. We do not study such deployments, and the released pipeline is a reusable forecasting method rather than a system targeted at individuals or groups. We therefore see no additional risks specific to this work beyond these general dual-use concerns.
Appendix F Licenses and Terms of Use for Existing Assets
We use existing public benchmark datasets, baseline numbers, and standard scientific software, and credit the original creators below. All assets are used unmodified and within their stated terms of use. Where we have verified the license against the asset’s distribution channel, we name it; otherwise we point to the canonical repository, whose terms govern use.
Benchmark datasets.
The eight multivariate forecasting benchmarks used in Table 1 are obtained from the public benchmark distribution accompanying 25 (https://github.com/thuml/Autoformer, MIT License). Their original sources and terms are:
- • ETTh1, ETTh2, ETTm1, ETTm2 (Electricity Transformer Temperature). Originally released by the authors of Informer at https://github.com/zhouhaoyi/ETDataset. Refer to the repository for the dataset’s terms of use.
- • Electricity (ElectricityLoadDiagrams20112014). UCI Machine Learning Repository, https://archive.ics.uci.edu/dataset/321/electricityloaddiagrams20112014, distributed under the Creative Commons Attribution 4.0 International (CC BY 4.0) license.
- • Traffic (Caltrans PeMS road-occupancy data). California Department of Transportation, https://pems.dot.ca.gov/, made publicly available by Caltrans for research and operational use.
- • Weather. Max Planck Institute for Biogeochemistry, https://www.bgc-jena.mpg.de/wetter/, publicly distributed by the institute.
- • Exchange Rate. Released by the authors of LSTNet at https://github.com/laiguokun/multivariate-time-series-data under the MIT License.
Baseline numbers and reference implementations.
The linear baseline numbers (OLS, FITS, DLinear) in Table 1 are quoted from 20. The nonlinear baseline numbers (PatchTST, iTransformer, TimeMixer, TimesNet, Autoformer) are quoted from the corresponding original publications. The reference implementations released by their authors are:
- • DLinear / NLinear (26): https://github.com/cure-lab/LTSF-Linear (Apache License 2.0).
- • PatchTST (16): https://github.com/yuqinie98/PatchTST (Apache License 2.0).
- • iTransformer (15): https://github.com/thuml/iTransformer (MIT License).
- • TimeMixer (22): https://github.com/kwuking/TimeMixer (Apache License 2.0).
- • TimesNet (24) via the Time-Series-Library: https://github.com/thuml/Time-Series-Library (MIT License).
- • Autoformer (25): https://github.com/thuml/Autoformer (MIT License).
- • TFB (18): https://github.com/decisionintelligence/TFB (Apache License 2.0).
Software libraries.
The pipeline is built on standard open-source scientific Python: PyTorch (BSD-3-Clause), NumPy (BSD-3-Clause), Pandas (BSD-3-Clause), SciPy (BSD-3-Clause), scikit-learn (BSD-3-Clause), statsmodels (19) (BSD-3-Clause), Matplotlib (PSF-style Matplotlib license), Seaborn (BSD-3-Clause), and Optuna (2) (MIT License). All libraries are used unmodified and within their respective licenses.