Нейроморфное энергоэффективное обучение для адаптивной глубокой стимуляции мозга
Аннотация
Исследования в области нейроморфных и периферийных вычислений были сосредоточены на снижении стоимости вывода контроллеров нейронных сетей, однако в физических системах с замкнутым контуром исполнительный механизм может соперничать с эффективным контроллером по энергопотреблению или превосходить его. Таким образом, эффективный контроллер необходим, но недостаточен, поскольку исполнительный механизм становится тем компонентом, затраты на который стоит сокращать, как только вывод перестает доминировать. Здесь мы представляем обучение с учетом энергопотребления — подход, который включает энергию исполнительного механизма непосредственно в вознаграждение reinforcement learning, и демонстрируем его в глубокой стимуляции мозга (DBS) с замкнутым контуром при болезни Паркинсона. Глубокая spiking neural network с Q-обучением, обученная на биофизической модели кортико-базально-ганглиозно-таламической цепи, учится подавлять патологические альфа-бета-осцилляции на 45,2%, сокращая при этом заряд стимуляции на 80,0% по сравнению с непрерывной DBS. Дистилляция знаний с ограничением разреженности сжимает стратегию для нейроморфного процессора SynSense XyloAudio 3 с мощностью вывода 0,52 мВт, обеспечивая на 28,1 меньшее энергопотребление на вывод, чем эквивалентная искусственная нейронная сеть на обычном периферийном оборудовании. Благодаря совместной оптимизации энергии стимуляции и эффективности вывода, данная структура решает обе основные задачи энергопотребления в имплантируемой нейромодуляции..
1 Введение
Развертывание нейронных сетей на периферийных и нейроморфных архитектурах позволило существенно снизить затраты вычислительной мощности. Однако, когда эти сети функционируют в качестве контроллеров в физических системах с замкнутым контуром, энергия, расходуемая актуатором, является первостепенной статьей затрат, сопоставимой с самим процессом вывода или превышающей его, как только контроллер начинает работать на энергоэффективном оборудовании. В глубокой стимуляции мозга (DBS) непрерывная подача заряда нейростимулятором потребляет мощность порядка сотен микроватт — одного милливатта 41; 15, что соответствует диапазону субмилливаттного нейроморфного контроллера. Таким образом, снижение затрат только на вывод решает лишь часть проблемы энергопотребления имплантата. Это наблюдение обосновывает необходимость обучения с учетом энергопотребления: включение выходной энергии управляемой системы непосредственно в целевую функцию обучения, чтобы стратегия оптимизировала то, что она может практически сократить..
Мы демонстрируем этот принцип в системах DBS с обратной связью для лечения болезни Паркинсона. DBS является основным хирургическим методом лечения поздних стадий болезни Паркинсона, уменьшающим тремор, ригидность и брадикинезию 3, однако традиционные устройства подают непрерывные (cDBS) высокочастотные электрические импульсы независимо от клинического состояния, что приводит к побочным эффектам, вызванным стимуляцией (например, дизартрии, нарушениям походки), и нерациональному расходу заряда батареи 13. В неперезаряжаемых имплантируемых генераторах импульсов (IPG) высокие коэффициенты заполнения требуют частых хирургических замен, при этом длительность импульса демонстрирует отрицательную корреляцию со временем до замены 42. Эти ограничения вызвали интерес к адаптивной DBS (aDBS), которая модулирует параметры стимуляции в режиме реального времени на основе биомаркеров патологической сетевой активности 1; 46. Поскольку стимуляция составляет значительную часть бюджета мощности IPG при условии эффективного вывода, эффективный контроллер aDBS должен оптимизировать энергию стимуляции наряду с терапевтической эффективностью, а не просто минимизировать собственные затраты на вывод..
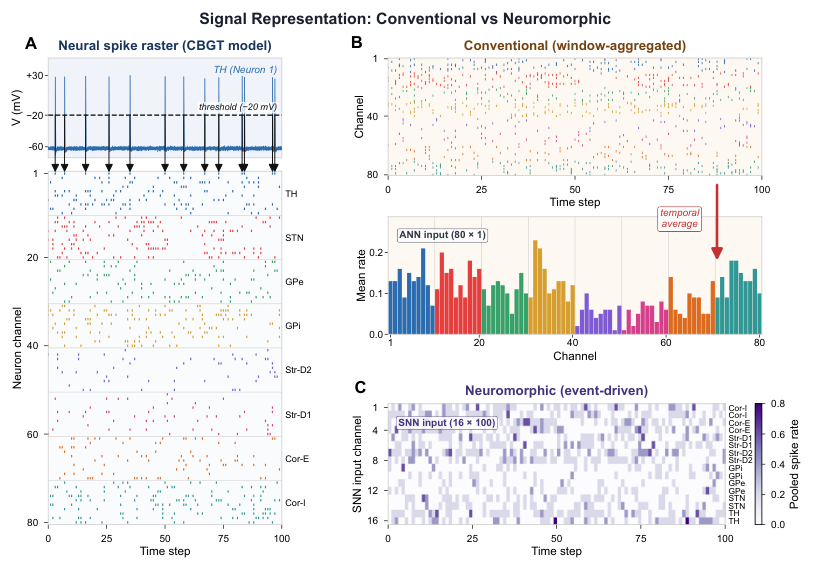
Наиболее значимым биомаркером при болезни Паркинсона является преувеличенная осцилляция в - диапазоне (7–35 Гц; также называемом -диапазоном или просто бета-ритмом), наблюдаемая в субталамическом ядре (STN) и внутреннем сегменте бледного шара (GPi) 14; 24. В предыдущих работах применялись контроллеры на основе нейронных сетей для систем DBS с обратной связью, что позволило достичь энергоэффективного подавления бета-ритма в вычислительных моделях кортико-базально-ганглионарно-таламокортикальных (CBGT) связей 26; 11; 7; 27; 44. Однако эти подходы опираются на традиционное аппаратное обеспечение и обработку с агрегацией по окнам, что требует объединения нейронных данных в статические оконные признаки (например, среднюю спектральную мощность) и приводит к потере мелкозернистой временной структуры исходного потока спайков. На рисунке 1 показано, что необработанные сигналы CBGT, связывающие непрерывные мембранные потенциалы с дискретными спайковыми событиями (рис. 1A), кодируют точные моменты разрядов в восьми популяциях базальных ганглиев, тогда как традиционная обработка сводит это к средним частотам для каждого окна (рис. 1B), отбрасывая межбарстовые интервалы, которые отслеживают патологическую синхронию. Развертывание таких контроллеров на имплантируемых генераторах импульсов (IPG) дополнительно ограничивается пределами безопасности по нагреву тканей — имплантат не должен повышать температуру окружающих тканей более чем на 2∘C 36 — а также необходимостью обеспечения многолетнего срока службы батареи. В совокупности эти ограничения сужают возможности постоянно работающего контроллера до субмилливаттного диапазона энергопотребления, что на порядки ниже ваттного уровня потребления традиционных ускорителей Edge AI 2.
К счастью, нейроморфные вычисления работают естественным образом в этом ограниченном режиме. Импульсные нейронные сети (SNNs), которые имитируют событийную обработку биологических нейронов, могут обрабатывать нейронные сигналы при мощности менее милливатта и задержке менее миллисекунды 45. В отличие от обычных искусственных нейронных сетей (ANNs) и рекуррентных нейронных сетей (RNNs), SNNs выполняют вычисления только при поступлении входных импульсов и способны использовать внутренние задержки для захвата пространственно-временных зависимостей 29, что делает их хорошо подходящими для асинхронной природы биологических сигналов. Такое кодирование сохраняет временные взаимосвязи в объединенном, событийном формате, который напрямую поступает в контроллер SNN (Рис. 1C).
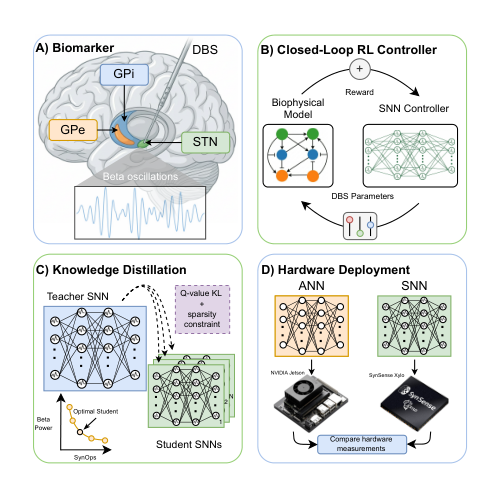
В данной работе мы представляем нейроморфную систему глубокой стимуляции мозга с замкнутым контуром, которая обрабатывает нейронную активность в ее естественном импульсном домене (рис. 2). Мы обучаем Deep Spiking Q-Network (DSQN) 32; 33, функция вознаграждения которой совместно оптимизирует терапевтическое подавление и физический заряд, доставляемый нейростимулятором, а затем развертываем полученную стратегию на нейроморфном оборудовании посредством дистилляции знаний с ограничением разреженности..
Наш вклад охватывает три области:
- ⟦• Управление с учетом энергопотребления: функция вознаграждения в RL напрямую штрафует за подачу заряда стимуляции, ориентируясь на потребность в мощности первого порядка в имплантате. При мощности вывода 0,52 мВт нейроморфный контроллер работает в пределах субмилливаттного диапазона, требуемого строгими тепловыми ограничениями и ограничениями по многолетнему сроку службы батареи, гарантируя, что сам контроллер не нивелирует экономию энергии от стимуляции..
- ⟦• Нейроморфное бенчмаркирование: развертывание SNN на нейроморфном процессоре SynSense XyloAudio 3 4 и сравнение с базовыми моделями ANN и RNN на NVIDIA Jetson Orin Nano 34, мы достигаем сокращения энергопотребления на один вывод в 28.1 раз, одновременно количественно оценивая компромиссы между мощностью и задержкой.
- ⟦• Биофизическая валидация: Мы проводим валидацию всех стратегий управления в симуляции на основе динамики Ходжкина-Хаксли 16 в модели сети CBGT у крыс с поражением 6-гидроксидофамином (6-OHDA) 21, достигая снижения мощности патологического - диапазона на 45,2% (автономная спектральная метрика с использованием нескольких окон) и сокращения совокупного заряда стимуляции на 80,0% по сравнению с непрерывной DBS..
2 Методы
2.1 Биофизическая среда моделирования
Мы валидировали стратегии управления в биофизически детализированной симуляции цепи CBGT крысы, основанной на работе Kumaravelu et al. 21. Сеть включает 80 однокамерных нейронов, распределенных по восьми популяциям: кортикальные возбуждающие и тормозные (динамика Izhikevich 17), а также субталамическое ядро (STN), наружный бледный шар (GPe), внутренний бледный шар (GPi), стриатум (средние шипиковые нейроны D1 и D2) и таламус (TH), все из которых смоделированы с использованием динамики Ходжкина-Хаксли на основе проводимости 16. Каждая субкортикальная популяция обладает специфичными для ядра ионными токами (например, L-типа и T-типа кальциевые, A-типа калиевые и кальций-зависимые калиевые токи в STN), которые создают характерные паттерны импульсации, включая пейсмейкерную активность и пачечный разряд. Полные мембранные уравнения, кинетика гейтирования и таблицы параметров приведены в приложениях A и B⟧.
Паркинсоническое состояние с дефицитом дофамина было вызвано снижением максимальной проводимости стриатального М-тока () и кортикостриатальной синаптической силы () при одновременном усилении внутри-GPe торможения () 21, что воспроизводит преувеличенные --диапазонные (7–35 Гц) осцилляции, характерные для PD 13. Для обеспечения устойчивости к биологической изменчивости связность сети и начальные условия рандомизировались для каждого эпизода обучения. Межпопуляционные синапсы используют кинетику на основе проводимости с биэкспоненциальным нарастанием и затуханием, вводя реалистичные временные задержки (например, NMDA – мс), которые должен учитывать контроллер (см. Приложение A для синаптических уравнений). Уравнения интегрируются с использованием метода Эйлера вперед с мс.
События спайков регистрируются как пересечения порога фазы нарастания на уровне мВ, формируя 80-канальную бинарную матрицу спайков (8 популяций 10 нейронов), которая составляет наблюдение состояния контроллера на каждом шаге принятия решения. Мощность GPi - вычисляется с помощью многооконного точечного оценочного алгоритма с использованием дискретных пролатных сфероидальных последовательностей (DPSS) на окнах анализа по 100 мс, применяемого единообразно для всей количественной оценки мощности полос в данной работе 18 (см. Приложение A). Тот же оценочный алгоритм предоставляет онлайн-биомаркер, который симулятор передает в награду RL и прокси-показатель, используемый для ранжирования кандидатов при поиске по фронту Парето (Рис. 5), где терапевтическая эффективность представляет собой среднее значение сокращений для каждого сида по десяти сидам, что соответствует протоколу, использованному для Рис. 3. В обоих случаях оценки учитель и все модели-ученики получают пространственно объединенное 16-канальное представление, и вся последующая оценка стратегии использует это в качестве входных данных из 80-канальной матрицы спайков биофизической модели CBGT. Эта интегрированная за 4 секунды мощность - является метрикой, представленной на Рис. 3 (терапевтическая эффективность), и осью эффективности на Рис. 5 (компромисс между энергией и эффективностью). Для парных сравнений подавления по сидам мы приводим Коэна в качестве размера эффекта, вычисленного как среднее разностей по каждому сиду, деленное на их стандартное отклонение..
2.2 Архитектура глубокой импульсной Q-сети
DSQN реализован для выбора дискретных параметров стимуляции, модулирующих ток, подаваемый стимулятором. Q-network — это архитектура обучения с подкреплением на основе значений, которая оценивает ожидаемое будущее совокупное вознаграждение (Q-value), связанное с выполнением конкретного действия в заданном состоянии. Мы специально выбрали этот off-policy подход с дискретными действиями вместо методов градиента непрерывной политики (например, Proximal Policy Optimization или Actor-Critic) по трем основным причинам: (i) клинические нейростимуляторы DBS по своей сути работают с использованием дискретных, ограниченных по безопасности пошаговых настроек параметров, а не непрерывных аналоговых значений, что делает Q-learning структурно согласованным с аппаратным интерфейсом; (ii) его off-policy природа позволяет использовать буфер воспроизведения опыта, что существенно повышает эффективность выборки при обучении на вычислительно затратных биофизических симуляциях; и (iii) детерминированный argmax выбор максимальных Q-values естественным образом отображается на конкурентный слой считывания winner-take-all (WTA), оптимальную стратегию декодирования для нейроморфных ядер, управляемых событиями. Одновременная ко-модуляция этих переменных определяет как профиль побочных эффектов 9, так и долговечность батареи 42. Сеть реализована в PyTorch 37 с использованием нейроморфной библиотеки Rockpool 30, которая обеспечивает дифференцируемую динамику, подходящую для оптимизации на основе градиентов через surrogate gradients 10. SNN построена с использованием нейронов Leaky Integrate-and-Fire (LIF) с явной динамикой синаптического тока. В формулировке прямого метода Эйлера с дискретным временем, используемой в Rockpool, синаптический ток и мембранный потенциал развиваются как связанная система:
| (1) | ||||
| (2) | ||||
| (3) |
где и — синаптическая и мембранная постоянные времени, — вектор входных импульсов, — бинарный вектор выходных импульсов, и — матрицы входных и рекуррентных весов, — ток смещения, — порог срабатывания, — ступенчатая функция Хевисайда, а — шаг симуляции. Агент обучается максимизировать ожидаемую отдачу, используя правило обновления Q-learning.:
| (4) |
где — это функция ценности действия для состояния и действия , — это скорость обучения, — это вознаграждение, полученное на следующем временном шаге, а — это коэффициент дисконтирования.
Учитель DSQN наблюдает 80-канальную матрицу спайков из модели CBGT (8 популяций нейронов по 10 нейронов в каждой), которая сокращается до 16 каналов посредством фиксированного этапа усредняющего пулинга без параметров (раздел 2.7.1) перед подачей в обучаемую сеть; таким образом, учитель и все дистиллированные ученики работают с идентичным 16-канальным входом. Обучаемая сеть состоит из двух скрытых слоев по 128 LIF нейронов в каждом, с постоянной времени мембраны мс, синаптической постоянной времени мс, порогом генерации импульсов и шагом симуляции мс. Выходной слой содержит 9 LIF нейронов, соответствующих 9 дискретным действиям. Каждое наблюдение охватывает 100 временных шагов (1 с симулированной нейронной активности), что обеспечивает рекуррентной динамике достаточный временной контекст для оценки состояния..
2.3 Декодирование действий посредством партиционированного популяционного кодирования
Мы декодируем действия посредством партиционированного популяционного кодирования для преобразования высокоразмерной нейронной активности в низкоразмерные клинические элементы управления. Выходной слой SNN () разделен на три отдельные субпопуляции, каждая из которых предназначена для определенного параметра стимуляции: частоты (), длительности импульса () и амплитуды (). Мы используем считывание WTA на основе частоты импульсов, где сеть оценивает Q-values путем накопления мембранных потенциалов в течение окна симуляции . Для каждого параметра дискретное действие (соответствующее уменьшению, поддержанию или увеличению) определяется нейроном с максимальной совокупной активностью:
| (5) |
где представляет собой мембранный потенциал -го нейрона в -й субпопуляции в момент времени . Данная схема декодирования создает надежный интерфейс между стохастической областью импульсов и детерминированным управлением, необходимым для контроллера DBS..
2.4 Пространство действий и клинические ограничения
Политика выдает действия , соответствующие относительным корректировкам в , и . Чтобы гарантировать, что обученная политика остается клинически применимой и может быть развернута на маломощном оборудовании, мы наложили строгие ограничения насыщения на эти параметры (Таблица 1).
Частота (): Верхний предел в 180 Гц был выбран для приведения в соответствие со стандартным терапевтическим окном высокочастотной стимуляции при болезни Паркинсона, которое обычно варьируется от 130 до 185 Гц 20; 5. Этот предел также соответствует базовым показателям, установленным в средах RL и исследованиях управления на основе моделей для стабилизации таламической активации 11; 23.
Ширина импульса (): Мы ограничили ширину импульса диапазоном 60–400 с. Нижняя граница обеспечивает эффективную нейронную деполяризацию, соответствующую хронаксии миелинизированных аксонов, в то время как верхняя граница позволяет сохранить заряд батареи 22; 42.
Амплитуда (): В моделировании реализована стимуляция с управлением по току, что соответствует конструкции современных имплантируемых генераторов импульсов, которые напрямую регулируют подаваемый заряд 36. В данной формулировке напряжение не является независимо управляемым параметром; оно неявно возникает как произведение инжектируемого тока и импеданса ткани на границе раздела с электродом и, следовательно, не ограничивается явно. Мы ограничили амплитуду тока максимальным значением 250 А, что согласуется с рабочим диапазоном нейроморфных интегральных схем сверхнизкого энергопотребления следующего поколения, предназначенных для хронической имплантации 36, и служит пределом безопасности против чрезмерной плотности заряда на границе раздела электрод-ткань..
Мы определяем штрафной коэффициент с учетом энергопотребления , основанный на приложенном токе стимуляции, для количественной оценки энергопотребления стратегии DBS. Этот коэффициент рассчитывается как среднеквадратичное значение (RMS) формы волны инжектируемого тока стимуляции, , за заданное окно моделирования. Формально, для непрерывной формы волны стимуляции на временном интервале , прокси-показатель энергии определяется как:
| (6) |
В контексте нашего биофизического моделирования с дискретным временем с шагом и общим количеством шагов моделирования , среднеквадратичная энергия вычисляется эмпирически как:
| (7) |
где — это мгновенный ток стимуляции (в ), подаваемый на STN на -м временном шаге. Интегрируя квадрат амплитуды по времени, данная формулировка учитывает совокупное влияние всех трех настраиваемых параметров DBS на общее энергопотребление..
| Parameter | Range | Rationale |
|---|---|---|
| Frequency () | 0 – 180 Hz | Upper bound of therapeutic window |
| Pulse Width () | 60 – 400 s | Chronaxie limits and battery preservation |
| Amplitude () | 0 – 250 A | Next-gen low-power integrated circuit limits |
2.5 Адаптивная формулировка вознаграждения
Основная сила нашего подхода заключается в совместной оптимизации терапевтической эффективности и энергии стимуляции. Для достижения этой цели мы формулируем функцию вознаграждения DSQN как разрывную функцию, которая отдает приоритет подавлению клинических симптомов выше определенного порога мощности (), а ниже него — сохранению энергии.:
| (8) |
где — мгновенная мощность в -диапазоне, — мгновенный прокси-показатель энергии RMS моделирования (уравнение 7), — константа нормализации, — базовая терапевтическая награда, — коэффициент штрафа за подавление, а — гиперпараметр, балансирующий целевой результат и градиент энергосбережения. Энергетический член входит в награду как нормализованное отношение , а не как абсолютный ток. Таким образом, стратегия оптимизирует долю доставляемого заряда относительно собственного рабочего диапазона, а достигнутая экономия представляет собой пропорцию от базового уровня, а не фиксированную величину. сопоставляется с для установления пропорциональных стимулов для подавления симптомов и нарушения пороговых значений; оба параметра установлены достаточно большими, чтобы удерживать ошибки временных различий в режиме функции потерь Huber на протяжении раннего этапа обучения, стабилизируя обновление градиентов до того, как стратегия обнаружит терапевтический режим. Данная формулировка гарантирует, что агент получает положительное подкрепление только тогда, когда патологическая сигнатура в -диапазоне подавлена в достаточной степени. Мы отмечаем, что — это эмпирически полученный фиксированный абсолютный порог, используемый для формирования награды при обучении. Полная процедура deep spiking Q-learning обобщена в алгоритме 1. Полные детали реализации, включая структуру многоголовочных действий, считывание Q-значений и регуляризацию разреженности, приведены в алгоритме S1 (приложение C⟧).
2.6 Дистилляция знаний с ограничением разреженности
Дистилляция знаний (KD) применяется для переноса стратегии из плотной учительской сети в оптимизированную студенческую SNN, что позволяет согласовать высокоразмерную стратегию управления со строгими ресурсными ограничениями целевого аппаратного обеспечения. Мы минимизируем дивергенцию Кульбака-Лейблера (KL) между мягкими Q-значениями учителя () и Q-значениями студента () для всех симулированных состояний и действий , масштабированными с помощью температурного параметра ⟧:
| (9) |
Хотя KD эффективно сжимает представление стратегии, он не минимизирует пропускную способность синапсов по своей сути. Поскольку динамическое энергопотребление в нейроморфных архитектурах линейно масштабируется с частотой SynOps 2, мы дополняем целевую функцию оптимизации явным штрафом за разреженность. Этот член регуляризует среднюю частоту импульсов каждого скрытого слоя по направлению к целевой разреженности с использованием дивергенции Кульбака-Лейблера Бернулли:
| (10) |
где — средняя частота импульсов всех нейронов и временных шагов в слое , а — целевая разреженность (меньшие значения способствуют уменьшению количества импульсов). Данная формулировка побуждает фактическое распределение частоты импульсов соответствовать разреженному априорному распределению Бернулли. Общая функция потерь объединяет потери дистилляции и взвешенный штраф за разреженность для всех скрытых слоев:
| (11) |
где — это гиперпараметр, определяющий компромисс между эффективностью выполнения задачи и метаболическими затратами. Варьируя в ходе различных циклов обучения при неизменном для целевого уровня разреженности, мы напрямую управляем рабочей точкой нейронной сети на фронте Парето энергоэффективности. Алгоритм S2 (Приложение D) обобщает полную процедуру дистилляции, включая график прогрева разреженности, используемый для стабилизации начального этапа обучения..
2.7 Аппаратное развертывание и бенчмаркинг
Соответствие нашей дистиллированной стратегии управления строгим эксплуатационным ограничениям имплантируемой биоэлектроники было подтверждено путем развертывания SNN на нейроморфном процессоре SynSense XyloAudio 3. Эта валидация служит для преодоления разрыва «от симуляции к реальности» путем подтверждения того, что теоретическая задержка и пропускная способность разреженной стратегии согласуются с измерениями на физическом оборудовании 2. Чтобы контекстуализировать прирост эффективности нейроморфных вычислений, мы провели сравнительный анализ SNN с двумя независимо обученными базовыми моделями, развернутыми на NVIDIA Jetson Orin Nano (CUDA) 34. Базовая модель ANN представляет собой нейронную сеть прямого распространения с частотным кодированием и согласованной архитектурой из двух скрытых слоев (80 входных каналов, 128 скрытых нейронов, 9 выходных действий), которая сворачивает временную размерность входных данных посредством усредняющего пулинга перед выполнением единичного прохода прямого распространения. Базовая модель RNN заменяет скрытые слои на GRU 8 — рекуррентную архитектуру, которая поддерживает выученное скрытое состояние на протяжении временных шагов, позволяя последовательно обрабатывать полное 100-шаговое наблюдение. Обе базовые модели используют ту же целевую функцию обучения DQN и пространство действий, что и SNN, что позволяет изолировать влияние вычислительной парадигмы (импульсная обработка на основе событий против прямого распространения с частотным кодированием против рекуррентной вентильной обработки) от архитектурных различий..
2.7.1 Аппаратно-совместимое снижение размерности
Сопряжение биологически масштабных симуляций с нейроморфным аппаратным обеспечением сверхнизкого энергопотребления сталкивается с несоответствием пропускной способности каналов. Биофизическая симуляция генерирует импульсные выходные сигналы от независимых нейронов. Однако SynSense XyloAudio 3 поддерживает максимум 16 входных каналов. Это несоответствие было устранено путем внедрения слоя пространственного усредняющего пулинга, который уменьшает размерность пространства состояний с до с использованием операции пулинга с шагом без перекрытия. Для входного импульсного тензора выход вычисляется как:
| (12) |
где и индексируют размерности пакета и времени соответственно, — это размер ядра и шаг, а — индекс выходного канала. Эта операция эффективно агрегирует активность кластеров из 5 соседних нейронов в единый канал «супернейрона». Данная специфическая стратегия понижающей дискретизации сохраняет статистику частоты импульсов субзон ядра без внесения сложных вычислительных накладных расходов, гарантируя, что сигнальная цепь остается строго энергоэффективной и пригодной для развертывания на Edge AI. Учитель и каждый дистиллированный ученик обучаются и оцениваются на идентичном 16-канальном представлении.
2.7.2 Архитектура и конвейер развертывания
XyloAudio 3 — это асинхронный процессор со смешанными сигналами, разработанный для постоянно активной обработки с энергопотреблением менее милливатта 4. Наша реализация использует цифровое SNN ядро устройства для обработки прямой инъекции импульсов. Поскольку ядро работает на основе событий, состояния инстанцированных LIF нейронов обновляются только при поступлении входных импульсов, что минимизирует динамическое энергопотребление в периоды низкой нейронной активности..
Для согласования высокоуровневого моделирования с низкоуровневыми аппаратными ограничениями мы использовали библиотеку Rockpool 30. Архитектура Xylo опирается на 8-битное целочисленное представление как для синаптических весов, так и для мембранных потенциалов. Соответственно, мы реализовали конвейер обучения с учетом квантования, используя суррогатные градиентные слои Rockpool, которые учитывают эффекты усечения во время обучения для предотвращения снижения производительности при развертывании. Используя стандартизированные промежуточные представления 38, обученный вычислительный граф отображается на физические ресурсы ядра Xylo, оптимизируя распределение нейронных блоков и синаптической памяти. Наконец, отображенная сеть преобразуется в двоичный конфигурационный поток битов и загружается через интерфейс среды выполнения Samna на аппаратное обеспечение, где частота тактового сигнала ядра может быть настроена для оптимального баланса между пропускной способностью вывода и энергопотреблением..
2.7.3 Протокол сравнительного тестирования
Для количественной оценки преимущества нейроморфного подхода мы выполнили протокол автономного тестирования, используя идентичные входные данные в виде синтетических импульсных последовательностей длительностью 100 временных шагов с разрешением 10 мс для всех моделей. Для Xylo SNN необработанные последовательности импульсной активности из биофизического моделирования агрегировались посредством пространственного пулинга и передавались во входной буфер оборудования в виде пакетов Address Event Representation; ядро работало на частоте 6,25 МГц, а мощность измерялась с частотой 20 Гц через встроенный интерфейс мониторинга. Мощность на базовых моделях Jetson записывалась с использованием tegrastats с интервалами 100 мс во время инференса. Энергия на один инференс представляет собой произведение средней мощности инференса и задержки выполнения, что соответствует недавним протоколам тестирования эффективных временных архитектур на периферийном оборудовании 39.
2.7.4 Учет мощности стимуляции
Мощность, которую стимулятор подает в ткань, отличается от мощности, которую он потребляет от имплантата, и только последняя определяет срок службы батареи (Таблица 2). Стандартная метрика TEED 19 дает мощность, подаваемую в ткань , но она учитывает только резистивное рассеяние на границе раздела электрод-ткань. Поскольку ток, доставляющий этот заряд, поступает от шины напряжения, поддерживаемой значительно выше падения напряжения на ткани, драйвер рассеивает разницу. Измеренная эффективность драйверов тока для имплантируемых стимуляторов составляет около – 35. Таким образом, мы определяем мощность, потребляемую устройством, как , принимая из этого измеренного диапазона. Мы учитываем только стимуляцию и инференс — две затраты, которыми фактически управляют архитектура контроллера и энергоэффективная политика. Фиксированный показатель накладных расходов устройства, такой как телеметрия, сенсорика и тактирование 41, добавлялся бы в равной степени ко всем условиям и лишь размывал бы относительный процент сэкономленной энергии. Поэтому его исключение является консервативным подходом и не меняет относительных сравнений. Более того, поскольку токи масштаба грызунов, используемые в моделировании (250 A), занижают клиническую доставку заряда примерно на порядок, мы привязываем абсолютные значения к клиническому эталону cDBS (130 Гц, 90 с, 3.5 В, к). Измеренное снижение заряда для каждого контроллера относительно cDBS (Рис. 4) затем масштабирует этот базовый уровень, оставаясь при этом независимым от конкретных границ устройства..
3 Результаты
3.1 Терапевтическая эффективность при патологическом состоянии
Мы обучили контроллер SNN, получающий вознаграждение совместно за (1) подавление патологических - осцилляций и (2) минимизацию энергии нейростимуляции, в замкнутом контуре с биофизической моделью цепи CBGT с дефицитом дофамина. Мы отдельно развернули сжатую версию этой стратегии на нейроморфном процессоре SynSense XyloAudio 3 для измерения его мощности и задержки на аппаратном обеспечении. Полный конвейер показан на рис. 2, с дополнительными подробностями в разделе Методы..
Сначала мы подтвердили способность контроллера смягчать симптомы во время активной фазы заболевания. В биофизической модели с дефицитом дофамина популяция GPi демонстрирует преувеличенные - осцилляции, являющиеся характерным электрофизиологическим признаком паркинсонической акинезии (Рис. 3A).
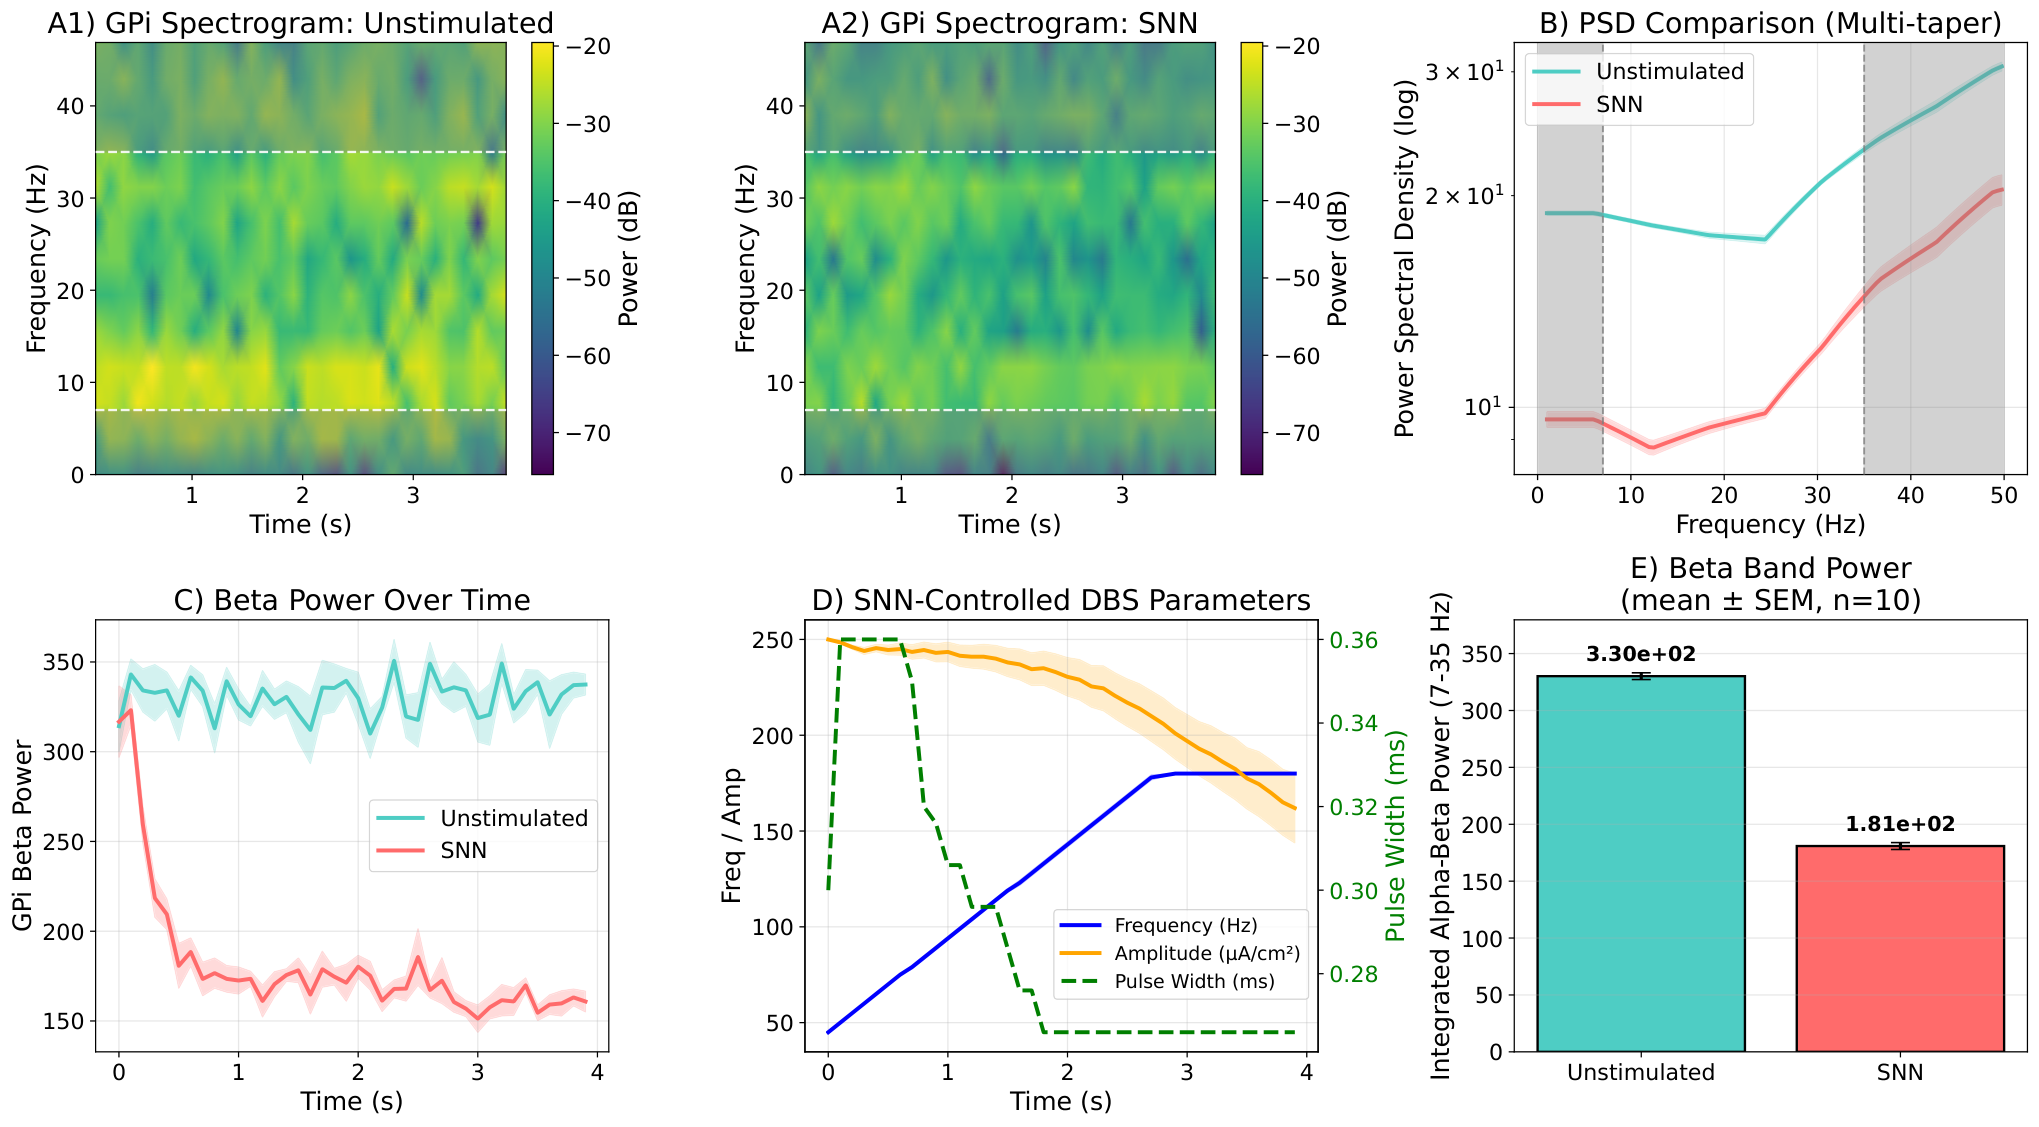
По результатам 10 независимых запусков контроллер SNN снижает интегральную мощность в диапазоне - на (95% ДИ [42.6, 47.7]; ; диапазон 40–50% по результатам запусков; рис. 3E). Это снижение является значительным и высокодостоверным по сравнению с исходным состоянием при болезни Паркинсона без стимуляции (двусторонний парный , ; Коэна; критерий знаковых рангов Уилкоксона ). Агент RL быстро обнаруживает патологическое состояние на основе обратной связи от GPi и инициирует высокочастотную стимуляцию для прерывания рекуррентной синхронизации между STN и наружным бледным шаром (GPe), выравнивая кривую спектральной плотности мощности (PSD) в диапазоне 7–35 Гц (рис. 3B).
Сравнения спектрограмм (рис. 3A2) показывают, что контроллер восстанавливает десинхронизированный режим импульсации, сопоставимый со здоровым базовым состоянием. Как показано на рис. 3D, SNN контроллер демонстрирует четкую стратегию постепенного наращивания. Начиная с исходного состояния стимуляции (частота 40 Гц, амплитуда 250 A и длительность импульса 0,3 мс), SNN быстро увеличивает частоту до предельных 180 Гц, в то время как амплитуда постепенно снижается от своего начального максимума. Длительность импульса незначительно варьируется в зависимости от начальных условий, что согласуется с его узким трехшаговым диапазоном действий, а не с выраженным предпочтением стратегии. В этом фиксированном состоянии дефицита дофамина, при отсутствии здоровых интервалов для снижения регуляции, стимуляция с максимальным воздействием является оптимальной стратегией с точки зрения вознаграждения. Чтобы подтвердить, что эта решительная модуляция обусловлена динамическим наблюдением с обратной связью, а не вырожденной стратегией с разомкнутым контуром, мы провели исследование с сенсорной абляцией (Приложение F). Результаты демонстрируют, что сеть активно отслеживает лежащую в основе физиологическую динамику, возвращаясь в спокойное состояние с нулевой стимуляцией при отсутствии входных спайков..
3.2 Энергоэффективность стимуляции
Для количественной оценки экономии энергии стимуляции при использовании стратегии с учетом энергопотребления мы сравнили контроллер SNN с традиционными стратегиями DBS и двумя базовыми моделями без импульсных нейронных сетей при чередующихся здоровом и паркинсоническом состояниях (Рис. 4). Было оценено шесть условий: отсутствие стимуляции (патологический базовый уровень), cDBS (130 Гц, 300 A, 0.3 мс), клиническая эвристика aDBS с двойным порогом, которая переключает стимуляцию на основе -power 25; 46, базовая модель прямого распространения ANN (Deep Q-Network, DQN), базовая модель рекуррентной RNN (Gated Recurrent Unit, GRU-DQN) и наш адаптивный контроллер SNN. Функция вознаграждения, пространство действий и среда остаются неизменными для всех трех обученных контроллеров. Стратегия с двойным порогом представляет собой текущий клинический стандарт для адаптивной DBS, при котором стимуляция включается или выключается, когда спектральный биомаркер пересекает заданные верхнюю и нижнюю границы. Это требует непрерывной онлайн-оценки мощности -диапазона на основе локального полевого потенциала (LFP). Контроллер SNN, напротив, получает только необработанный многоканальный растр импульсов и, следовательно, не вычисляет спектральный биомаркер ни на одном из этапов..
Стратегия SNN обеспечивает сокращение совокупной подачи заряда на 80,0% по сравнению с cDBS (рис. 4E), при этом поддерживая -мощность значительно ниже терапевтического порога во время паркинсонических блоков. SNN также превосходит эвристику с двойным порогом, которая представляет собой текущий клинический стандарт для адаптивной DBS. В эксперименте с цикличностью эвристика aDBS с двойным порогом снижает совокупный заряд лишь на 57,0% по сравнению с cDBS, поэтому SNN подает на 53,5% меньше заряда, чем эвристика. Эта большая экономия не требует затрат в плане эффективности: на протяжении паркинсонических блоков данного эксперимента SNN удерживает -мощность GPi на 85,9% ниже уровня без стимуляции (среднее значение ) против 56,2% для aDBS с двойным порогом (среднее значение , которое по своей структуре отслеживается чуть ниже порога ). Часть этого запаса является структурной, поскольку эвристика переключает стимуляцию при фиксированных параметрах включения cDBS, в то время как SNN также может модулировать ширину и амплитуду импульса, поэтому контроллер с двойным порогом и оптимизированным по энергии состоянием включения сократил бы этот разрыв. Даже с учетом этого предостережения, SNN обеспечивает как меньший заряд, так и более глубокое подавление, чем эвристика. Вместо бинарного переключения вкл/выкл, SNN непрерывно модулирует амплитуду в диапазоне 200–230 A, поддерживая частоту на уровне 180 Гц и ширину импульса 0,06 мс (рис. 4B–D). Эта стратегия узких импульсов с субмаксимальной амплитудой минимизирует заряд на импульс, сохраняя при этом терапевтическую нейронную рекрутируемость (см. приложение E). Сравнение цикличности представляет собой единичный репрезентативный прогон данного протокола чередующихся состояний, в то время как статистическая валидация по нескольким начальным значениям в данной работе охватывает результат острого подавления (рис. 3).
Ни один из базовых методов без импульсных нейронных сетей не позволил получить жизнеспособную стратегию управления. ANN, работающая на основе усредненной частоты импульсного входного сигнала, сошлась к вырожденной стратегии, которая минимизирует амплитуду до порогового значения (фактически не осуществляя стимуляцию), что обеспечивает снижение заряда на 94,8%, но без подавления (Рис. 4A). RNN, которая обрабатывает полное наблюдение из 100 временных шагов через рекуррентные вентили, не смогла обучиться адаптивному поведению, вместо этого приняв статичную, не зависящую от состояния стратегию, которая фиксирует все три параметра на их максимальных значениях (180 Гц, 0,4 мс, 250 А) непрерывно, независимо от физиологического состояния. Хотя это подавляет -осцилляции, потребление энергии при этом на 50,6% выше, чем при cDBS..
3.3 Аппаратно-эффективное сжатие посредством ограничений разреженности
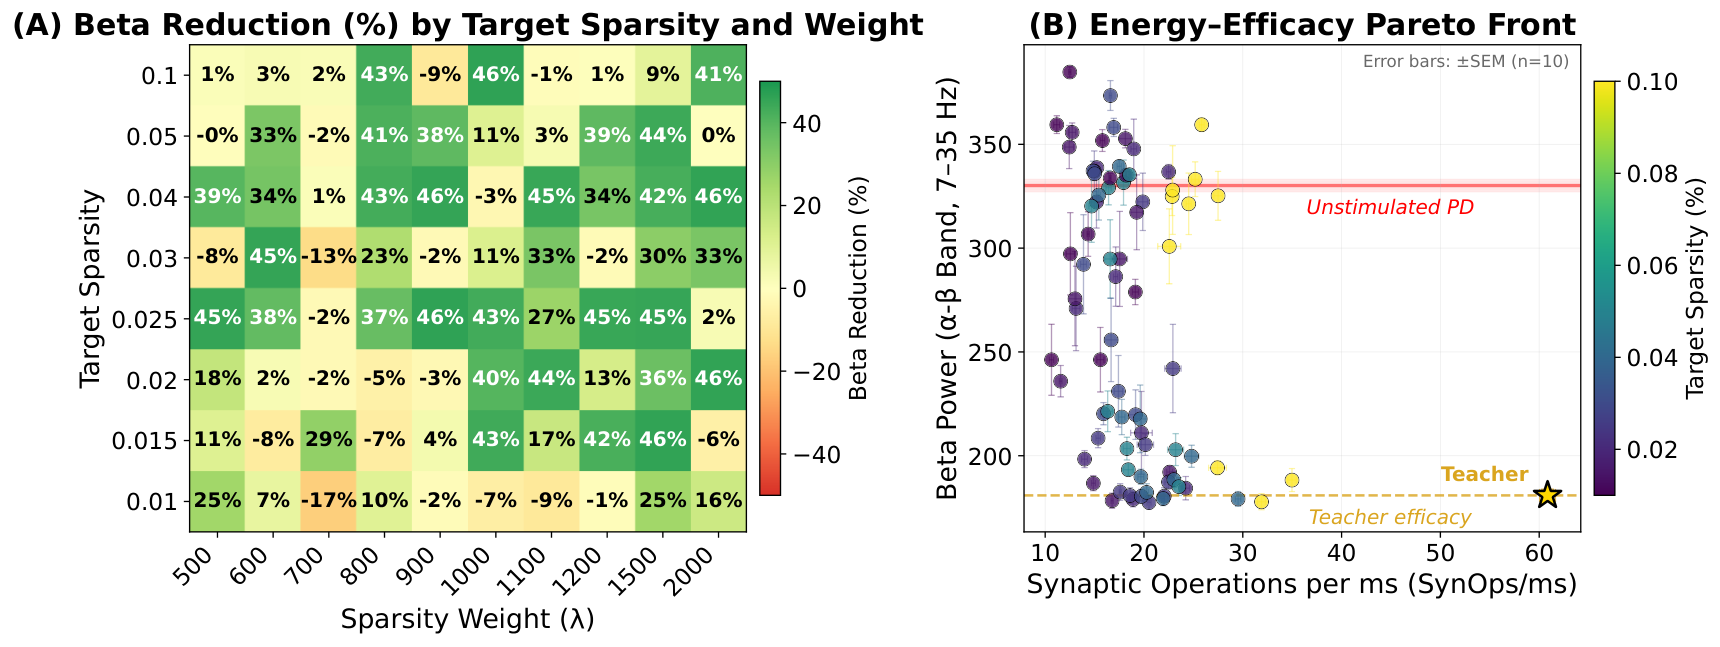
Установленная выше экономия энергии стимуляции имеет клиническое значение только в том случае, если сам контроллер укладывается в бюджет мощности имплантата. Учитель и каждый дистиллированный ученик используют одни и те же входные данные и топологию, различаясь только синаптической активностью. Исходный 80-канальный выход CBGT подвергается пространственной понижающей дискретизации до 16 каналов (применяется идентично при обучении и развертывании, см. Методы) и подается на идентичную двухслойную сеть. При обучении без ограничений на частоту импульсов учитель генерирует плотный поток со скоростью 60,8 синаптических операций (SynOps; одно накопление веса на импульс на исходящий синапс) в миллисекунду, что превышает энергоэффективный режим целевого аппаратного обеспечения. Поскольку динамическая мощность на нейроморфных ядрах масштабируется в зависимости от частоты SynOps, контроллер должен генерировать меньше импульсов без потери терапевтической эффективности. Поиск этого баланса напрямую с помощью RL непрактичен. Каждый эпизод запускает биофизическую симуляцию 50 медленнее реального времени, что делает тестирование множества настроек разреженности непомерно дорогим. Дистилляция от единого фиксированного учителя позволяет избежать этих затрат, поскольку регуляризация каждого ученика в направлении целевой частоты импульсов позволяет нам перебрать десятки конфигураций разреженности за часы, вместо того чтобы заново запускать RL с нуля для каждой из них..
Мы интегрировали аппаратные ограничения непосредственно в целевую функцию дистилляции, дополнив функцию потерь штрафным слагаемым за разреженность (, Eq. 11). Студенческая сеть обучается представлять терапевтическую стратегию, используя разреженность активаций, что позволяет получить «аппаратно-эффективную» стратегию, которая минимизирует количество SynOps наряду с выполнением основной терапевтической задачи..
Мы провели детальный перебор гиперпараметров для систематической характеристики взаимосвязи между разреженностью и терапевтической емкостью. Мы обучили 80 студенческих стратегий для различных целевых уровней разреженности () и весов штрафов (), как показано на Рисунке 5. Лучшая по Парето студенческая модель (, ) соответствует эффективности учительской модели при SynOps/мс, что на меньше SynOps, чем у учителя (Рис. 5B). На другом конце диапазона перебора чрезмерно разреженные модели не дают преимуществ по сравнению с отсутствием стимуляции при болезни Паркинсона. Более высокий вес штрафа при умеренной целевой разреженности стабильно сохраняет эффективность — закономерность, заметная на тепловой карте (Рис. 5A). При оценке по тому же конвейеру с использованием мульти-тейперного анализа, что и у учителя (10 начальных значений, 4-секундное окно), лучшая студенческая модель подавляет мощность - на ( SEM; ), что статистически неотличимо от показателя учителя (парный , ; критерий Уилкоксона ). Таким образом, сжатие оказывает минимальное влияние на терапевтический эффект, позволяя студенческой модели достичь эквивалентной эффективности при меньшем количестве SynOps..
3.4 Эффективность нейроморфного оборудования
Сравнение лучшего студента на SynSense XyloAudio 3 4 с эквивалентными базовыми моделями на NVIDIA Jetson Orin Nano (CUDA) выявило разрыв в энергопотреблении примерно в 11,000. Этот студент достигает подавления - при SynOps/мс, что соответствует эффективности учителя при более низкой синаптической пропускной способности (см. выше).
3.4.1 Энергопотребление и задержка вывода
На рисунке 6 представлены измеренные показатели энергопотребления, задержки и энергии на один вывод для всех конфигураций. Средняя системная мощность вывода Xylo SNN составила 0,52 мВт (включая ввод-вывод и аналоговый интерфейс) по сравнению с 5,7 Вт (ANN) и 5,6 Вт (RNN) у Jetson Orin Nano на шине VDD_IN. Чтобы соотнести это различие с клиническим применением, отметим, что питание модуля Jetson от гипотетической неперезаряжаемой батареи DBS емкостью 5 Вт·ч привело бы к исчерпанию всей емкости имплантата менее чем за 53 минуты только за счет накладных расходов на обработку. Напротив, мощность вывода процессора Xylo, равная 0,52 мВт, позволяет обеспечить более одного года непрерывной работы в режиме постоянной активности (9600 часов, рассчитано как 5 Вт·ч / 0,52 мВт). Эти измерения отражают различные границы систем (автономный нейроморфный чип против полноценного модуля Edge AI). Хотя оба процессора в конечном итоге потребуют интеграции с системой сбора данных имплантата, данное сравнение иллюстрирует базовый уровень мощности, необходимый для выполнения нейронных сетей в рамках этих двух вычислительных парадигм..
Развернутая на Xylo SNN затрачивала в среднем 315,10 мс на один вывод по сравнению с 0,81 мс (ANN) и 2,13 мс (RNN) на базовых моделях Jetson CUDA, жертвуя скоростью ради энергоэффективности. Большая задержка RNN по сравнению с ANN отражает последовательную природу рекуррентности GRU, которая не может быть полностью распараллелена на GPU. Задержка вывода в 315 мс является умеренной по отношению к окну наблюдения в 1 с, на основе которого вычисляется каждое состояние (100 шагов 10 мс/шаг), что дает общую задержку цикла 1,3 с на решение. Это согласуется с временным масштабом, в котором варьируются огибающие мощности -диапазона при паркинсоническом состоянии 25, а также с опубликованными адаптивными системами DBS, которые обновляют стимуляцию с секундным или досекундным интервалом 46.
3.4.2 Энергопотребление на одну операцию вывода
Энергия на один вывод представляет собой произведение средней мощности вывода и задержки выполнения. Накапливаясь за время работы контроллера в непрерывном режиме, именно она разряжает аккумулятор. Студенческая модель Xylo потребляла Дж на один вывод по сравнению с Дж для ANN и Дж для RNN на Jetson CUDA, что соответствует сокращению на 28.1 и 72.5 соответственно. Более высокое энергопотребление RNN отражает как более длительный последовательный вывод, так и постоянное потребление мощности на уровне ватт у Jetson. Как и в случае со сравнением мощности, эти коэффициенты противопоставляют ядро Xylo всей системе Jetson..
Работа, управляемая событиями, также позволяет процессору Xylo динамически масштабировать свою мощность, переходя в состояние низкого энергопотребления в режиме ожидания ( Вт), когда входные спайки отсутствуют, в отличие от Jetson, который работает непрерывно независимо от входной активности. Для разреженных паттернов возбуждения, характерных для биологических сигналов, такая эффективность в режиме ожидания еще больше увеличила бы разрыв при развертывании в реальных условиях..
3.4.3 Бюджет мощности имплантата
Контроллер нейронной сети является лишь одним из компонентов общего энергопотребления системы. Сам нейростимулятор потребляет значительную часть энергетического бюджета, что также необходимо учитывать. Чтобы оценить, приводят ли меры по экономии стимуляции из раздела 3.2 к существенному увеличению срока службы батареи, мы сравнили мощность стимуляции, потребляемую устройством, с измеренной мощностью вывода для каждой платформы (Таблица 2). При использовании контроллера класса Jetson мощность вывода превышает даже клинический уровень стимуляции на четыре порядка, что делает систему неработоспособной независимо от эффективности управления стимуляцией, и именно поэтому нейроморфный вывод с потреблением менее милливатта является необходимым условием для имплантируемости. Только в этом режиме обе величины становятся сопоставимыми: на долю стимуляции приходится около 38% энергетического бюджета системы Xylo при использовании клинического cDBS в качестве эталона. Сокращение мощности стимуляции на 85,6% за счет стратегии SNN в сочетании с низкой мощностью вывода позволяет снизить долю стимуляции ниже 10% и довести общее потребление системы до 0,57 мВт, что обеспечивает примерно год непрерывной работы от элемента питания емкостью 5 Вт·ч. RNN не удается достичь такого сокращения, потребляя на 28,2% больше энергии, чем cDBS..
| Component | Xylo SNN | Jetson ANN | Jetson RNN |
|---|---|---|---|
| Stim. power, cDBS ref. (drawn) | 0.32 mW | 0.32 mW | 0.32 mW |
| Stim. power, learned policy (drawn) | 0.05 mW | mW | 0.41 mW |
| Inference (measured) | 0.52 mW | 5,703 mW | 5,592 mW |
| Total (learned policy + inference) | 0.57 mW | 5,703 mW | 5,592 mW |
| Stim. share at cDBS baseline | 38% | 0.01% | 0.01% |
| Stim. TEED reduction versus cDBS | 85.6% | — | 28.2% |
| Projected battery life (5 Wh) | 1.0 yr | 1 hr | 1 hr |
⟦ANN сошлась к стимуляции, близкой к нулевой (снижение заряда на 94,8% по сравнению с cDBS; отсутствие терапевтического подавления). Эталон cDBS: 130 Гц, 90 с, 3,5 В, к, (проекция клинического масштаба). В моделировании использовались 130 Гц, 300 А, 0,3 мс; см. Методы.
4 Обсуждение и заключение
Аппаратная эффективность является обучаемым свойством нейронного контроллера, которое целевая функция обучения может оптимизировать напрямую. Этот вывод выходит за рамки энергоэффективного вывода: включение энергии стимуляции в вознаграждение заставляет стратегию находить способы эффективного расхода заряда, которые стандартная целевая функция не обнаружила бы. Как только контроллер укладывается в тепловой бюджет имплантата, стимуляция становится основной остаточной стоимостью, и только сигнал вознаграждения, наказывающий за нее, побудит агента к ее снижению..
Совместная оптимизация энергии контроллера и актуатора. Сокращение только одной из двух статей энергопотребления не обеспечивает экономии, что наглядно демонстрирует прогнозируемый бюджет мощности (Таблица 2). Субмилливаттный инференс является обязательным условием. Без него один только контроллер превышает весь бюджет мощности имплантата, и любая экономия на стимуляции становится неактуальной. Однако одного лишь низкопотребляющего инференса недостаточно, поскольку стимулятор по-прежнему составляет значительную часть бюджета мощности. Эта совместная оптимизация отличает представленную структуру от подходов, которые оптимизируют только протоколы стимуляции 7 или только эффективность инференса в отрыве от остального, поскольку терапевтическая экономия энергии достижима только на оборудовании, которое не нивелирует её. Энергопотребление на один инференс, которое на 28.1 ниже, чем у базовой модели ANN Jetson (Рис. 6C), показывает, что преимущество сохраняется при расчете на один инференс, хотя оно и наследует асимметрию системных границ из сравнения мощностей (Рис. 6B). Кроме того, Jetson является универсальным Edge AI модулем, а не самым энергоэффективным традиционным вариантом; маломощный микроконтроллер, выполняющий квантованную ANN, потреблял бы гораздо меньше ватт, ограничивая разрыв 11,000 по сравнению с универсальным Edge AI, а не со специализированным маломощным решением. Тем не менее, потребление на уровне ватт полносистемных AI ускорителей неосуществимо для хронических имплантатов, где операция по замене батареи является основным ограничением 42; 36.
Компромисс между энергоэффективностью и сбоями дистилляции. Структура Парето на рис. 5B напрямую следует из функции вознаграждения в виде ступенчатой функции. Ученик, который не может поддерживать подавление при различных начальных значениях, не получает терапевтического подкрепления. Поскольку обучение формируется только штрафом за разреженность, оно сходится к минимальным частотам импульсов и подаче стимуляции, не обеспечивая улучшения по сравнению с состоянием без стимуляции. Таким образом, чрезмерная разреженность приводит к тому же вырожденному результату, что и ANN, а не к постепенному снижению эффективности. Более того, штраф за разреженность обеспечивает успешное сжатие, заставляя ученика тратить свой ограниченный репрезентативный бюджет на воспроизведение стратегии учителя. Этого достаточно при умеренной регуляризации; дальнейшее ее усиление привело бы к тому, что ученик потерял бы способность поддерживать подавление при изменчивости от начального значения к начальному значению..
Обобщаемость. Выявленный здесь компромисс между энергопотреблением и эффективностью не является специфичным для болезни Паркинсона (Рис. 5). Системы адаптивной нейростимуляции при эпилепсии 31 и стимуляторы спинного мозга с замкнутым контуром для лечения хронической боли 28 сталкиваются с теми же эксплуатационными ограничениями: входные данные нейронных биомаркеров, параметры актуатора с границами безопасности и ограничения по мощности хронических имплантатов в диапазоне милливатт. В каждом случае доставка заряда стимуляции становится доминирующей стоимостью актуатора, как только инференс становится эффективным, что делает формулировку вознаграждения с учетом энергопотребления применимой к этим условиям. Этапы дистилляции с ограничением разреженности и развертывания на neuromorphic оборудовании также не зависят от архитектуры, требуя для адаптации только соответствующей задаче среды моделирования. По мере того как клиническая нейромодуляция переходит от жестких эвристик к непрерывному управлению, зависящему от состояния, совместное проектирование аппаратного и программного обеспечения такого рода станет необходимым, чтобы энергопотребление контроллера не нивелировало терапевтическую экономию энергии, которую он обеспечивает..
Импульсная динамика как индуктивное смещение. При фиксированных вознаграждении, пространстве действий и среде для всех трех моделей, трехстороннее абляционное исследование (ANN, RNN, SNN) позволяет изолировать вклад временной обработки и импульсной динамики в качество стратегии. Изменения касаются архитектуры и способа обработки входных данных каждой моделью: усредненный по пулингу 80-канальный вектор для ANN, полная 80-канальная последовательность для RNN и пространственно-пулированная 16-канальная последовательность для SNN. Учитывая только эти различия, две базовые модели потерпели неудачу в противоположных направлениях. При усреднении временных характеристик импульсов внутри окна, ANN коллапсировала до нижнего предела амплитуды и прекратила стимуляцию. RNN повела себя иначе, зафиксировав каждый параметр на верхнем пределе безопасности и никогда не снижая уровень (Рис. 4A). SNN оказалась единственной архитектурой, которая нашла энергоэффективную стратегию, модулируя амплитуду при удержании частоты и ширины импульса на их граничных значениях..
Поскольку RNN сохраняет как полную временную структуру, так и более богатую канальную информацию, но все же не может найти эффективную стратегию, неудачу ANN нельзя объяснить только потерей временных характеристик импульсов. Временная обработка необходима, но недостаточна. Динамика leaky integrate-and-fire в SNN накладывает структурное ограничение, отсутствующее в GRU-гейтах с непрерывными значениями. Активации являются разреженными и бинарными, с затуханием состояния на уровне мембраны. Эта динамика ограничивает репрезентативную способность сети таким образом, что предотвращает сходимость к локальному оптимуму методом грубой силы, который находит RNN. В нашей настройке механизм импульсов, по-видимому, действует как неявный архитектурный регуляризатор, параллельный роли явного ограничения разреженности во время дистилляции. Оба метода предотвращают сходимость к вырожденным стратегиям, но через разные механизмы (нейронная динамика против штрафа функции потерь).).
Возможность клинического внедрения. Современные клинические стандарты, такие как Medtronic PerceptTM PC 43; 6; 46, опираются на жесткие эвристики с двумя порогами, которые сводят многомерную нейронную динамику к медленным спектральным средним по одной переменной. Они также требуют калибровки порогов для каждого пациента. Обрабатывая непосредственно исходный растр спайков, SNN не нуждается в настройке порогов и вместо этого может обучаться нелинейным, зависящим от состояния стратегиям, которые одновременно координируют частоту, амплитуду и ширину импульса — комбинаторная задача, с которой жесткие эвристики с трудом справляются в динамике 26. Асинхронная архитектура процессора Xylo, управляемая событиями, выполняет эти стратегии при энергопотреблении менее милливатта, совместимом с IPG. Работая в пределах безопасного лимита нагрева тканей в 2∘C 36 и обеспечивая более года непрерывной работы от стандартной батареи IPG, это решает аппаратное ограничение, которое ранее препятствовало использованию контроллеров на базе нейронных сетей в хронических имплантатах. Нейроморфное ядро медленнее в расчете на один вывод, чем базовые модели на GPU, но для aDBS с огибающей амплитуды ограничивающими факторами являются мощность и энергия, а не скорость. Эта задержка также является проектным решением, а не внутренним ограничением, поскольку ядро Xylo работало на частоте 6,25 МГц, а разрыв 390 по сравнению с Jetson можно было бы компенсировать за счет мощности путем повышения тактовой частоты..
Ограничения. Несмотря на то что наша нейроморфная архитектура обеспечивает терапевтическое управление по замкнутому контуру в рамках прогнозируемых бюджетов мощности имплантата, биофизическая среда моделирования вводит ряд практических ограничений. Во-первых, поскольку наши результаты основаны на биофизической модели грызуна, они представляют собой аппроксимацию кортико-базально-ганглионарно-таламической цепи человека, что означает, что перенос в клинические условия в конечном итоге потребует валидации на моделях, специфичных для пациента, и проведения экспериментов in vivo. Величина, которую мы рассчитываем перенести через этот разрыв, — это относительная экономия, а не абсолютное значение масштаба грызуна, поскольку вознаграждение с учетом энергопотребления оптимизирует нормализованный заряд, и стратегия, снижающая подаваемый заряд на 80%, обеспечивает такую же долю экономии независимо от абсолютного значения тока. При клинических амплитудах та же доля соответствует большей абсолютной экономии, хотя точное значение для человека будет зависеть от динамики, специфичной для пациента. Во-вторых, контроллер в настоящее время оптимизирует один биомаркер (мощность в -диапазоне). Внедрение подходов с использованием нескольких биомаркеров 12 увеличило бы размерность входных данных и потребовало бы более крупных архитектур SNN, что вызвало бы необходимость переоценки с учетом выявленных здесь аппаратных ограничений. Наконец, скорость биофизического моделирования, которая примерно в 50 раз медленнее реального времени, стала основным узким местом обучения, ограничивающим пропускную способность эпизодов и систематическое исследование архитектур нейронных сетей, формулировок вознаграждения и конфигураций гиперпараметров. Тем не менее, эти результаты демонстрируют полезность обучения с учетом энергопотребления для имплантируемой нейромодуляции, где подавление патологической служит демонстрационным примером использования, который одновременно повышает эффективность контроллера и улучшает управление энергопотреблением нейростимулятора..
Благодарности и раскрытие информации о финансировании
Для данной работы не было получено специального внешнего финансирования, и авторы заявляют об отсутствии конфликта интересов. Все данные сгенерированы программным путем с помощью биофизической симуляционной модели CBGT; внешние наборы данных не использовались. Код для воспроизведения всех экспериментов доступен по адресу https://github.com/howyoubinh/CL-DBS-RL.
Список литературы
- ⟦ М. Арлотти, С. Марчелья, Г. Фоффани, Дж. Фолькманн, А. М. Лозано, Э. Моро, Ф. Коджаманян, М. Пренасси, Т. Боччи, Ф. Кортезе, П. Рампини, С. Барбьери и А. Приори Восьмичасовая адаптивная глубокая стимуляция мозга у пациентов с болезнью Паркинсона. Neurology 90 (11), стр. e971–e976. Внешние ссылки: ISSN 0028-3878, Document Цитируется в: §1⟧.
- ⟦ Ф. Барки, Э. Паризи, Л. Занатта, А. Бартолини и А. Аквавива Энергоэффективные и низкозадержечные импульсные нейронные сети на встроенных микроконтроллерах посредством настройки импульсной активности. Neural Computing and Applications 36 (30), стр. 18897–18917. Внешние ссылки: ISSN 1433-3058, Document Цитируется в: §1, §2.6, §2.7⟧.
- ⟦ А. Л. Бенабид, С. Шабардес, Дж. Митрофанис и П. Поллак Глубинная стимуляция головного мозга субталамического ядра для лечения болезни Паркинсона. The Lancet. Neurology 8 (1), стр. 67–81. Внешние ссылки: ISSN 1474-4422, Document Цитируется: §1.
- ⟦ Х. Бос и Д. Мьюр Нейроморфные SNN-приложения для обработки аудио с субмилливаттным энергопотреблением на базе Rockpool и Xylo. arXiv. Внешние ссылки: 2208.12991, Document Цитируется в: 2nd item, §2.7.2, §3.4⟧.
- ⟦ Д. Т. Брокер, Б. Д. Суон, Р. К. Со, Д. А. Тернер, Р. Э. Гросс и У. М. Грилл Оптимизированный временной паттерн стимуляции головного мозга, разработанный с помощью вычислительной эволюции. Science Translational Medicine 9 (371), стр. eaah3532. Внешние ссылки: ISSN 1946-6242, Document Цитируется в: §2.4⟧.
- ⟦ Х. М. Бронте-Стюарт, М. Бёдель, Дж. Л. Острем, С. Литтл, Л. Алмейда, А. Рамирес-Замора, А. Фасано, Т. Хасселл, К. Т. Митчелл, Э. Моро, М. Гостковски, Г. Чаттри, Р. М. А. Де Би, М. Де Нилинг, Д. Пинья-Фуэнтес, Б. Свиннен, П. А. Старр, Л. Х. Хаммер, К. Д. Фут, Р. М. Ричардсон, А. Флаэрти, А. Бугерс, К. Са’ди, С. Меони, А. Кастриото, С. Стансласки, Р. Л. С. Саммерс, Л. Тондер, И. Тан, Х. Берриер, Т. Дж. Гобл, Р. С. Райк, Т. М. Херрингтон, исследователи ADAPT-PD, П. Р. Схурман, У. Шуайб, Ф. Фиббс, Э. Даррио, С. Линч, Дж. Куни, Д. Тернер, В. Фрэкс, Х. Захед и Н. Сарангмат Долгосрочная персонализированная адаптивная глубокая стимуляция мозга при болезни Паркинсона: нерандомизированное клиническое исследование. JAMA Neurology 82 (11), стр. 1171. Внешние ссылки: ISSN 2168-6149, Document Цитируется в: §4⟧.
- ⟦ К. Чо, П. Хуан, М. Чен и К. Лин Глубинная стимуляция мозга с обратной связью с использованием обучения с подкреплением и нейронного моделирования. IEEE Transactions on Neural Systems and Rehabilitation Engineering 32, стр. 3615–3624. Внешние ссылки: ISSN 1558-0210, Document Цитируется в: §1, §4.
- ⟦ К. Чо, Б. ван Мерриенбур, Д. Бахданау и И. Бенджио О свойствах нейронного машинного перевода: подходы кодировщика-декодировщика. В материалах SSST-8, восьмого семинара по синтаксису, семантике и структуре в статистическом переводе, Доха, Катар, стр. 103–111. Внешние ссылки: Document Цитируется: §2.7⟧.
- ⟦ Э. Донати и Г. Валле Нейроморфное аппаратное обеспечение для соматосенсорных нейропротезов. Nature Communications 15 (1), стр. 556. Внешние ссылки: ISSN 2041-1723, Document Цитируется в: §2.2⟧.
- ⟦ Дж. К. Эшрагиан, М. Уорд, Э. О. Нефтчи, Х. Ван, Г. Ленц, Г. Двиведи, М. Беннамун, Д. С. Чжон и У. Д. Лу Обучение Spiking Neural Networks с использованием уроков Deep Learning. Proceedings of the IEEE 111 (9), стр. 1016–1054. Внешние ссылки: ISSN 1558-2256, Document Цитируется в: §2.2⟧.
- ⟦ К. Гао, М. Науманн, И. Йованов, В. Леси, К. Камаравелу, У. М. Грилл и М. Паич Проектирование на основе моделей контроллера глубокой стимуляции мозга с замкнутым контуром с использованием Reinforcement Learning. В материалах 11-й международной конференции ACM/IEEE по киберфизическим системам (ICCPS) 2020 года, стр. 108–118. Внешние ссылки: ISSN 2642-9500, Document, Link Цитируется в: §1, §2.4⟧.
- ⟦ Р. Гилрон, С. Литтл, Р. Перроне, Р. Уилт, К. де Хемтинн, М. С. Ярошински, К. А. Расин, С. С. Ван, Дж. Л. Острем, П. С. Ларсон, Д. Д. Ван, Н. Б. Галифианакис, И. О. Бледсо, М. Сан Лучано, Х. Э. Доус, Г. А. Уоррелл, В. Кремен, Д. А. Бортон, Т. Денисон и П. А. Старр Длительная беспроводная потоковая передача нейронных записей для обнаружения контуров и адаптивной стимуляции у лиц с болезнью Паркинсона. Nature Biotechnology 39 (9), стр. 1078–1085. Внешние ссылки: ISSN 1546-1696, Document Цитируется в: §4⟧.
- ⟦ Дж. Г.В. Хабетс, М. Хейманс, М. Л. Кёйф, М. Л.Ф. Янссен, И. Темель и П. Л. Куббен Обновленная информация об адаптивной глубокой стимуляции мозга при болезни Паркинсона. Movement Disorders 33 (12), стр. 1834–1843. Внешние ссылки: ISSN 1531-8257, Document, Link Цитируется в: §1, §2.1⟧.
- ⟦ К. Хэммонд, Х. Бергман и П. Браун Патологическая синхронизация при болезни Паркинсона: сети, модели и методы лечения. Trends in Neurosciences 30 (7), стр. 357–364. Внешние ссылки: ISSN 0166-2236, 1878-108X, Document Цитируется в: §1⟧.
- ⟦ А. Хелмерс, И. Люббинг, Г. Дойшль, К. Витт, М. Синовиц, Х. М. Мехдорн и Д. Фальк Сравнение срока службы батареи неперезаряжаемых генераторов для глубокой стимуляции мозга. Нейромодуляция: Журнал Международного общества нейромодуляции 21 (6), стр. 593–596. Внешние ссылки: ISSN 1525-1403, Document Цитируется: §1, Table 2.
- ⟦ А. Л. Ходжкин и А. Ф. Хаксли Количественное описание мембранного тока и его применение к проводимости и возбуждению в нерве. Журнал физиологии 117 (4), стр. 500–544. Внешние ссылки: ISSN 1469-7793, Document Цитируется в: 3rd item, §2.1.
- ⟦ Е.М. Ижикевич Простая модель импульсных нейронов. IEEE Transactions on Neural Networks 14 (6), стр. 1569–1572. Внешние ссылки: ISSN 1941-0093, Document Цитируется: §2.1.
- ⟦ М. Р. Джарвис и П. П. Митра Свойства выборки спектра и когерентности последовательностей потенциалов действия. Нейронные вычисления 13 (4), стр. 717–749. Внешние ссылки: ISSN 0899-7667, Document Цитируется: §2.1⟧.
- ⟦ А. М. Косс, Р. Л. Альтерман, М. Тальяти и Дж. Л. Шилс Расчет полной электрической энергии, доставляемой системами глубокой стимуляции мозга. Annals of Neurology 58 (1), стр. 168–168. Внешние ссылки: ISSN 1531-8249, Document Цитируется в: §2.7.4, Table 2.
- ⟦ Дж. К. Краусс, Н. Липсман, Т. Азиз, А. Буте, П. Браун, Дж. У. Чанг, Б. Дэвидсон, У. М. Грилл, М. И. Хариз, А. Хорн, М. Шульдер, А. Маммис, П. А. Тасс, Дж. Фолькман и А. М. Лозано Технология глубокой стимуляции мозга: текущее состояние и будущие направления. Nature Reviews Neurology 17 (2), стр. 75–87. Внешние ссылки: ISSN 1759-4758, Document, Link Цитируется в: §2.4⟧.
- ⟦ К. Кумаравелу, Д. Т. Брокер и У. М. Грилл Биофизическая модель сети кора-базальные ганглии-таламус в модели болезни Паркинсона у крыс с поражением 6-OHDA. Журнал вычислительной нейронауки 40 (2), стр. 207–229. Внешние ссылки: ISSN 1573-6873, Document Цитируется: §A.2, 3rd item, §2.1, §2.1⟧.
- ⟦ А. М. Кунсел и У. М. Грилл Выбор параметров стимуляции для глубокой стимуляции мозга. Клиническая нейрофизиология 115 (11), стр. 2431–2441. Внешние ссылки: ISSN 1388-2457, Document, Link Цитируется в: §2.4⟧.
- ⟦ Е. Кузьмина, Д. Крюков, М. Лебедев и Д. В. Дылов Нейрофизиологически реалистичная среда для сравнения адаптивных алгоритмов глубокой стимуляции мозга при болезни Паркинсона. Примечание: Препринт Внешние ссылки: 2505.09624, Document, Link Цитируется: §2.4⟧.
- ⟦ С. Литтл и П. Браун Какие сигналы мозга подходят для управления глубокой стимуляцией мозга с обратной связью при болезни Паркинсона?. Анналы Нью-Йоркской академии наук 1265 (1), стр. 9–24. Внешние ссылки: ISSN 1749-6632, Document Цитируется: §1⟧.
- ⟦ С. Литтл, А. Погосян, С. Нил, Б. Завала, Л. Зринзо, М. Хариз, Т. Фолтини, П. Лимузен, К. Ашкан, Дж. Фицджеральд, А. Л. Грин, Т. З. Азиз и П. Браун Адаптивная глубокая стимуляция мозга при прогрессирующей болезни Паркинсона. Анналы неврологии 74 (3), стр. 449–457. Внешние ссылки: ISSN 1531-8249, Document Цитируется в: §3.2, §3.4.1.
- ⟦ С. Лю, Г. Чжао, Дж. Ван, Х. Ву, Х. Ли, К. Феткевич и К. А. Лопаро Глубинная стимуляция мозга с замкнутым контуром на основе нейронных сетей для модуляции патологических осцилляций при болезни Паркинсона. IEEE Access 8, стр. 161067–161079. Внешние ссылки: ISSN 2169-3536, Document Цитируется в: §1, §4.
- ⟦ М. Лу, С. Вэй, Ю. Че, Дж. Ван и К. А. Лопаро Применение обучения с подкреплением для глубокой стимуляции мозга в вычислительной модели болезни Паркинсона. IEEE transactions on neural systems and rehabilitation engineering: a publication of the IEEE Engineering in Medicine and Biology Society 28 (1), стр. 339–349. Внешние ссылки: ISSN 1558-0210, Document Цитируется: §1⟧.
- ⟦ Н. Мехаил, Р. М. Леви, Т. Р. Дир, Л. Капурал, С. Ли, К. Амирделфан, К. У. Хантер, С. М. Розен, С. Дж. Костанди, С. М. Фаловски, А. Х. Бургер, Дж. Э. Поуп, К. А. Гилмор, Ф. А. Куреши, П. С. Стаатс, Дж. Сковкрофт, Дж. Карлсон, К. К. Ким, М. И. Янг, Т. Стаусс, Л. Пори, Д. Браунштейн, Р. Горман, Г. Э. Гмель, Э. Хансон, Д. М. Карантонис, А. Хуррам, Д. Кифер, А. Лейтнер, Д. Муган, М. Обрадович, Дж. Паркер, П. Сингл и Н. Солидей Долгосрочная безопасность и эффективность стимуляции спинного мозга с замкнутым контуром для лечения хронической боли в спине и ногах (Evoke): двойное слепое рандомизированное контролируемое исследование. The Lancet Neurology 19 (2), стр. 123–134. Внешние ссылки: ISSN 1474-4422, 1474-4465, Document Цитируется в: §4⟧.
- ⟦ Б. Месарош, Дж. К. Найт и Т. Новотны Эффективное обучение задержкам на основе событий в импульсных нейронных сетях. Nature Communications 16 (1), стр. 10422. Внешние ссылки: ISSN 2041-1723, Document Цитируется в: §1⟧.
- ⟦ Д. Р. Мьюир, Ф. Бауэр и П. Вейдель Документация Rockpool. Zenodo. Внешние ссылки: Document, Link Цитируется в: §2.2, §2.7.2.
- ⟦ Д. Р. Нэр, К. Д. Лаксер, П. Б. Вебер, А. М. Мурро, Ю. Д. Парк, Г. Л. Баркли, Б. Дж. Смит, Р. П. Гвинн, М. Дж. Доэрти, К. Х. Ноэ, Р. С. Циммерман, Г. К. Берги, У. С. Андерсон, К. Хек, К. Ю. Лю, Р. У. Ли, Т. Садлер, Р. Б. Дакроу, Л. Дж. Хирш, Р. Э. Уарен, У. Татум, С. Сринивасан, Г. М. Макханн, М. А. Агостини, А. В. Алексопулос, Б. К. Джобст, Д. У. Робертс, В. Саланова, Т. К. Уитт, С. С. Кэш, А. Дж. Коул, Г. А. Уоррелл, Б. Н. Лундстром, Дж. К. Эдвардс, Дж. Дж. Халфорд, Д. К. Спенсер, Л. Эрнст, К. Т. Скидмор, М. Р. Сперлинг, И. Миллер, Э. Б. Геллер, М. Дж. Берг, А. Дж. Фесслер, П. Рутецки, А. М. Голдман, Э. М. Мизрахи, Р. Э. Гросс, Д. К. Шилдс, Т. Х. Шварц, Д. Р. Лабар, Н. Б. Фаунтейн, У. Дж. Элиас, П. У. Олейничак, Н. Р. Виллемаретт-Питтман, С. Айзеншенк, С. Н. Ропер, Дж. Г. Боггс, Т. А. Кортни, Ф. Т. Сан, К. Г. Сил, К. Л. Миллер, Т. Л. Скарпаас, М. Дж. Моррелл, от имени исследовательской группы RNS System LTT Девятилетняя проспективная оценка эффективности и безопасности нейростимуляции, реагирующей на активность мозга, при фокальной эпилепсии. Neurology 95 (9), стр. e1244–e1256. Внешние ссылки: Document Цитируется: §4⟧.
- ⟦ Б. Нгуен, Э. Мигетто, Д. Луи и Дж. Эшрагиан Ускорение нейроморфной глубокой стимуляции мозга посредством дистилляции знаний и принудительной разреженности. В материалах конференции IEEE по нейроинженерии (NER), Цитируется: §1.
- ⟦ Б. Нгуен, Э. Мигетто, Д. Луи, К. Ю и Дж. Эшрагиан Нейроморфная глубокая стимуляция мозга с замкнутым контуром с использованием глубоких импульсных Q-сетей. В материалах Международного симпозиума IEEE по схемам и системам (ISCAS) 2025 года, стр. 1–5. Внешние ссылки: ISSN 2158-1525, Document Цитируется: §1.
- ⟦ Корпорация NVIDIA Руководство пользователя комплекта разработчика Jetson Nano. NVIDIA. Примечание: Редакция 1.2 Внешние ссылки: Link Цитируется в: 2nd item, §2.7.
- ⟦ Д. Паломеке-Мангут, А. Родригес-Васкес и М. Дельгадо-Реституто Полностью интегрированный, энергоэффективный высоковольтный нейростимулятор с током 0,07–2,08 мА в стандартном технологическом процессе CMOS. Sensors (Базель, Швейцария) 22 (17), стр. 6429. Внешние ссылки: ISSN 1424-8220, Document Цитируется в: §2.7.4, Table 2.
- ⟦ М. Парастарфейзабади и А. З. Коузани Достижения в области устройств для глубокой стимуляции мозга с замкнутым контуром. Журнал нейроинженерии и реабилитации 14 (1), стр. 79. Внешние ссылки: ISSN 1743-0003, Document Цитируется в: §1, §2.4, §4, §4⟧.
- ⟦ А. Пашке, С. Гросс, Ф. Масса, А. Лерер, Дж. Брэдбери, Г. Чанан, Т. Киллин, З. Лин, Н. Гимельшейн, Л. Антига, А. Демезон, А. Копф, Э. Янг, З. ДеВито, М. Рейсон, А. Теджани, С. Чилaмкурты, Б. Штайнер, Л. Фанг, Дж. Бай и С. Чинтала PyTorch: императивная высокопроизводительная библиотека глубокого обучения. В сборнике Достижения в системах нейронной обработки информации 32, стр. 8024–8035. Внешние ссылки: Link Цитируется в: §2.2⟧.
- ⟦ Дж. Э. Педерсен, С. Абреу, М. Джобст, Г. Ленц, В. Фра, Ф. К. Бауэр, Д. Р. Мьюир, П. Чжоу, Б. Фоггингер, К. Хекель, Г. Ургезе, С. Шанкар, Т. К. Стюарт, С. Шейк и Дж. К. Эшрагиан Нейроморфное промежуточное представление: унифицированный набор инструкций для интероперабельных вычислений, вдохновленных работой мозга. Nature Communications 15 (1), стр. 8122. Внешние ссылки: ISSN 2041-1723, Document Цитируется: §2.7.2⟧.
- ⟦ А. Пьерро, С. Абреу, Дж. Тимчек, П. Стратманн, А. Уайлд и С. Б. Шреста Ускорение линейных рекуррентных нейронных сетей для Edge с использованием неструктурированной разреженности. arXiv. Внешние ссылки: 2502.01330, Document Цитируется: §2.7.3.
- ⟦ Дж. Э. Рубин и Д. Терман Высокочастотная стимуляция субталамического ядра устраняет патологическую ритмичность таламуса в вычислительной модели. Журнал вычислительной нейронауки 16 (3), стр. 211–235. Внешние ссылки: Document Цитируется: §A.2.
- ⟦ С. Сарика, К. Иорио-Морин, Д. Х. Агирре-Падилья, А. Наджар, М. Пафф, А. Фоменко, К. Ямамото, А. Земмар, Н. Липсман, Г. М. Ибрагим, К. Хамани, М. Ходаи, А. М. Лозано, Р. П. Муньос, А. Фасано и С. К. Калия Имплантируемые генераторы импульсов для глубокой стимуляции мозга: проблемы, осложнения и стратегии практичности и долговечности. Frontiers in Human Neuroscience 15. Внешние ссылки: ISSN 1662-5161, Document Цитируется в: §1, §2.7.4.
- ⟦ П. Шарма, В. В. Холла, С. Гуррам, Н. Камбле, Р. Ядав, Д. Сринивас и П. К. Пал Исследование характеристик замены батареи у пациентов с болезнью Паркинсона и факторов, влияющих на разряд батареи. Анналы Индийской академии неврологии 26 (4), стр. 580–583. Внешние ссылки: ISSN 0972-2327, Document Цитируется: §1, §2.2, §2.4, §4⟧.
- ⟦ С. Стансласки, Р. Л. С. Саммерс, Л. Тондер, Ю. Тан, М. Кейс, Р. С. Рейк, Н. Морелли, Т. М. Херрингтон, М. Бёдель, Дж. Л. Острем, С. Литтл, Л. Алмейда, А. Рамирес-Замора, А. Фасано, Т. Хасселл, К. Т. Митчелл, Э. Моро, М. Гостковски, Н. Сарангмат и Х. Бронте-Стюарт Данные сенсоров и методология клинического исследования алгоритма адаптивной DBS для персонализированной терапии болезни Паркинсона (ADAPT-PD). npj Parkinson’s Disease 10 (1), стр. 174. Внешние ссылки: ISSN 2373-8057, Document Цитируется в: §4⟧.
- ⟦ Ф. Су, К. Кумаравелу, Дж. Ван и У. М. Грилл Оценка контроллера глубокой стимуляции мозга с замкнутым контуром на основе модели для адаптации к динамическим изменениям в опорном сигнале. Frontiers in Neuroscience 13, стр. 956. Внешние ссылки: ISSN 1662-4548, Document Цитируется: §1⟧.
- ⟦ К. С. Тхакур, Дж. Л. Молин, Г. Каувенбергс, Г. Индивери, К. Кумар, Н. Цяо, Дж. Шеммель, Р. Ван, Э. Чикка, Дж. Олсон Хаслер, Дж. Сео, С. Ю, Ю. Цао, А. ван Шайк и Р. Этьен-Каммингс Крупномасштабные нейроморфные импульсные матричные процессоры: стремление имитировать мозг. Frontiers in Neuroscience 12. Внешние ссылки: ISSN 1662-453X, Document Цитируется в: §1⟧.
- ⟦ А. Велисар, Дж. Сиркин-Николау, З. Блюменфельд, М.Х. Трейгер, М.Ф. Афзал, В. Прабхакар и Х. Бронте-Стюарт Двухпороговая нейронная глубокая стимуляция мозга с замкнутым контуром у пациентов с болезнью Паркинсона. Brain Stimulation 12 (4), стр. 868–876. Внешние ссылки: ISSN 1935861X, Document Цитируется: §1, §3.2, §3.4.1, §4⟧.
Приложение
Appendix A Детальная нейронная динамика и кинетика гейтирования
В этом разделе представлен полный набор алгебраических уравнений, определяющих зависящие от напряжения переменные ворот для биофизической сетевой модели, описанной в методах основного текста..
A.1 Нейроны субталамического ядра (STN)
Модель нейрона субталамического ядра включает вклады токов от натриевых (), калиевых (), калиевых A-типа (), кальциевых L-типа (), кальциевых T-типа () и кальций-зависимых калиевых () каналов. Функции активации/инактивации в установившемся состоянии () и постоянные времени () для переменной ворот определены ниже. Напряжение указано в мВ, а представляет внутриклеточную концентрацию кальция..
- ⟦•
Натриевый ток (): кинетика
(S1) (S2) - ⟦•
Калиевый ток (): кинетика
(S3) - ⟦•
А-тип калиевого тока (): кинетика
(S4) (S5) - ⟦•
L-тип кальциевого тока (): кинетика
(S6) (S7) (S8) - ⟦•
Т-тип кальциевого тока (): кинетика
(S9) (S10) - ⟦•
Кальций-зависимый калиевый ток (): кинетика
⟧(S11) - ⟦•
Динамика внутриклеточного кальция ():
где — коэффициент преобразования, описывающий поток ионов на единицу тока ( — валентность иона кальция, а Кл/моль — постоянная Фарадея), а скорость выведения кальция равна .(S12)
A.2 Другие нейронные популяции
Нейрональные характеристики и переменные стробирования для нейронов бледного шара (GPe/GPi), таламуса (Th) и стриатума (D1/D2) основаны на общепринятых моделях в стиле Ходжкина-Хаксли, первоначально разработанных Рубином и Терманом 40. Однако конкретные уравнения, параметры и реализации кортикальных нейронов Ижикевича, используемые в данном моделировании, заимствованы из комплексной сетевой модели кортико-базально-ганглиозно-таламической (CBGT) системы крысы, описанной Кумаравелу и соавторами 21.
A.3 Синаптическая динамика
Синапсы между популяциями моделируются с использованием кинетики на основе проводимости. Синаптический ток для заданного соединения равен:
| (S13) |
где — максимальная синаптическая проводимость, — потенциал синаптического реверса, а переменная синаптического гейтирования следует кинетике второго порядка с различными постоянными времени нарастания () и спада (). Это вводит реалистичные временные задержки (например, N-метил-D-аспартат (NMDA) – мс), которые должен учитывать нейроморфный контроллер.
A.4 Многоконусный спектральный анализ точечных процессов ⟦K0⟧
Для автономной валидации и спектрального анализа мы вычислили спектральные плотности мощности непосредственно из дискретных моментов спайков популяции GPi, используя метод мультитаперного точечного процесса. Этот подход оценивает спектральную дисперсию путем усреднения независимых оценок, полученных из набора ортогональных таперов данных, вычисленных в точные моменты спайков. Оценка спектра на частоте для набора моментов спайков определяется как:
| (S14) |
| (S15) |
где представляет собой -й ортогональный конус Слепяна (дискретную вытянутую сфероидальную последовательность), интерполированный до момента спайка , а второе слагаемое центрирует точечный процесс путем вычитания компоненты средней частоты, при этом определяет преобразование Фурье конуса на всей длительности . Мы выбрали произведение времени и полосы пропускания , что математически допускает максимум сильно концентрированных конусов Слепяна. Усреднение по этим независимым конусам обеспечивает надежную оценку колебательной мощности с низкой дисперсией, не зависящую от допущений синаптической фильтрации или артефактов дискретного временного биннинга.
Appendix B Параметры сети
Внутренние параметры для каждого типа нейронов, используемые в моделировании, приведены в Таблице S1.
| Parameter | Thalamus | STN | GPe | GPi | Striatum (D1/D2) |
|---|---|---|---|---|---|
| Leak Conductance () | 0.05 | 0.35 | 0.1 | 0.1 | 0.1 |
| Leak Reversal () | -70 | -60 | -65 | -65 | -67 |
| Sodium () | 3.0 | 49.0 | 120.0 | 120.0 | 100.0 |
| Potassium () | 5.0 | 57.0 | 30.0 | 30.0 | 80.0 |
| A-Type Potassium () | – | 5.0 | – | – | – |
| T-type Calcium () | 5.0 | 5.0 | 0.5 | 0.5 | – |
| L-type Calcium () | – | 15.0 | – | – | – |
| High-Thresh Ca () | – | – | 0.15 | 0.15 | – |
| Ca-dependent K () | – | 1.0 | – | – | – |
| AHP Conductance () | – | – | 10.0 | 10.0 | – |
AHP: проводимость послегиперполяризации.
| Source Target | Receptor | Delay ( ms) | (ms) | (ms) |
|---|---|---|---|---|
| Cortex STN | AMPA | 5.9 | 0.5 | 2.49 |
| Cortex STN | NMDA | 5.9 | 2.0 | 90.0 |
| Cortex Striatum | AMPA | 5.1 | – | 5.0* |
| STN GPe | AMPA | 2.0 | 0.4 | 2.5 |
| STN GPe | NMDA | 2.0 | 2.0 | 67.0 |
| STN GPi | AMPA | 1.5 | – | 5.0* |
| GPe STN | GABA | 4.0 | 0.4 | 7.7 |
| GPe GPi | GABA | 3.0 | – | 5.0* |
| GPe GPe | GABA | 1.0 | – | 5.0* |
| GPi Thalamus | GABA | 5.0 | – | 5.0* |
| Striatum (D2) GPe | GABA | 5.0 | – | 5.0* |
| Striatum (D1) GPi | GABA | 4.0 | – | 5.0* |
| Thalamus Cortex | AMPA | 5.0 | – | 5.0* |
*Моделируется с использованием одиночного экспоненциального затухания (-функция), где доминирует в динамике. AMPA: -амино-3-гидрокси-5-метил-4-изоксазолпропионовая кислота; NMDA: N-метил-D-аспартат; GABA: -аминомасляная кислота.
Appendix C EA-DSQN: Полные детали реализации
В этом разделе расширяется Алгоритм 1 из основного текста, предоставляя полную процедуру на уровне реализации, необходимую для точной воспроизводимости. Ключевыми дополнениями по отношению к версии из основного текста являются: (i) 3-головочное декодирование действий по независимым выходным субпопуляциям; (ii) явное считывание Q-значений посредством накопления мембранного потенциала; (iii) целевые значения Беллмана для каждой головы; (iv) функция потерь регуляризации разреженности, применяемая к двум скрытым слоям LIF; и (v) отсечение градиентов через clip_grad_value_(100) вместо отсечения по норме..
Заметка о градиентном клиппинге.
В реализации используется clip_grad_value_(100), который ограничивает каждый отдельный элемент градиента до , вместо более распространенного clip_grad_norm_. Этот выбор предотвращает дестабилизацию начального этапа обучения выбросами градиентов, когда мембранные потенциалы SNN инициализируются случайным образом..
| Hyperparameter | Symbol | Value |
| Discount factor | 0.99 | |
| Soft update coefficient | 0.005 | |
| Learning rate | ||
| Replay buffer size | 100,000 | |
| Mini-batch size | 128 | |
| initial | 0.9 | |
| final | 0.05 | |
| decay steps | — | 2,000 |
| Energy-balance weight | 0.5 | |
| Base therapeutic reward | 3000 | |
| Suppression penalty | 30 | |
| -power threshold | 150 V2 | |
| Max stimulation energy | 250.0 A | |
| Sparsity weight | 0.0 (teacher/baseline); grid-searched in KD | |
| Target sparsity | 0.0 (teacher/baseline); grid-searched in KD | |
| Gradient clip value | — | 100 |
| SNN time steps per obs. | 100 |
Appendix D Алгоритм дистилляции знаний с ограничением разреженности
Appendix E Экспериментальный протокол стимуляции с учетом энергоэффективности
Для количественной оценки экономии энергии стимуляции при использовании стратегии управления с учетом энергопотребления мы провели циклический эксперимент, сравнивающий шесть условий при чередовании здорового состояния и состояния при болезни Паркинсона. Симуляция циклически проходила через пять блоков по 100 шагов (по 10 с каждый): Healthy PD Healthy PD Healthy, что в сумме составило 500 шагов (50 с). Было оценено шесть условий:
- ⟦1. Без стимуляции: стимуляция не применяется (патологическая базовая линия)).
- ⟦2. Постоянная глубокая стимуляция мозга (cDBS): фиксированная стимуляция на частоте 130 Гц, 300 А, 0,3 мс.
- ⟦3. Клиническая адаптивная DBS (aDBS; с двойным порогом): эвристика с двойным порогом, смоделированная на основе клинического протокола, валидированного с использованием нейростимулятора Medtronic Activa PC. Эвристика использует мгновенную мощность -диапазона в GPi в качестве единственного биомаркера и применяет гистерезисную полосу для предотвращения быстрого циклического переключения стимуляции: стимуляция активируется с клиническими параметрами (130 Гц, 300 А, 0,3 мс), когда мощность превышает верхний порог (), и деактивируется, когда она опускается ниже нижнего порога (). Между двумя границами сохраняется предыдущее состояние стимуляции..
- ⟦4. Базовая модель ANN (DQN): прямоточная глубокая Q-сеть, обрабатывающая матрицу импульсов как вектор частоты, усредненный по пулингу.
- ⟦5. Базовая модель RNN (GRU-DQN): рекуррентная сеть GRU, обрабатывающая полное наблюдение из 100 временных шагов посредством управляемых рекуррентных блоков.
- ⟦6. Адаптивная SNN: энергоэффективный контроллер SNN, который непрерывно совместно модулирует все три параметра стимуляции.
Appendix F Абляция сенсорных данных, зависящая от состояния
Чтобы исключить гипотезу о том, что контроллер SNN с учетом энергопотребления перешел к стратегии с разомкнутым контуром, мы провели исследование сенсорной абляции во время непрерывного моделирования. Этот эксперимент изолирует динамически вычисляемые действия сети, зависящие от состояния, от ее укоренившихся структурных базовых реакций путем полного отключения пути сенсорного ввода..
Импульсная нейронная сеть была оценена в ходе семи 500-шаговых имитационных блоков, подвергая контроллер симметричной последовательности состояний окружающей среды и сенсорной депривации (Рисунок S1⟧):
- ⟦1. Здоровое состояние (Блок 1): Естественная физиологическая импульсная активность из здорового бледного шара.
- ⟦2. Паркинсоническое состояние (Блок 2): управление с обратной связью против высокочастотных -диапазонных осцилляций, типичных для болезни Паркинсона.
- ⟦3. Тихий мозг (Блок 3): Сенсорные пути математически разорваны (), что имитирует полный отказ датчиков в рамках патологического состояния..
- ⟦4. Здоровое восстановление (Блок 4): Сенсорные пути повторно подключаются к здоровой нейронной активности.
- ⟦5. Тихий мозг (Блок 5): Второй период сенсорного затемнения.
- ⟦6. Восстановление при болезни Паркинсона (Блок 6): Немедленное противодействие патологическому состоянию.
- ⟦7. Здоровое состояние (Блок 7): Окончательное возвращение к здоровому физиологическому базовому уровню.
Во время активных периодов с замкнутым контуром (блоки 2 и 6) SNN подавляет патологические осцилляции GPi с базового уровня до и соответственно, что значительно ниже клинического порога . Эти значения отражают динамику данного конкретного протокола чередующихся состояний и не являются напрямую сопоставимыми с измерениями острой эффективности в основном тексте; цель здесь состоит в том, чтобы охарактеризовать, как выученная динамика SNN сохраняется и реактивируется при переходах между состояниями, а не в воспроизведении конкретного терапевтического результата..
Когда симуляция переходит к блокам Silent Brain (блоки 3 и 5), векторы сенсорного ввода падают до нуля. Внутренние мембранные потенциалы и синаптические токи SNN естественным образом затухают при отсутствии входных спайков. Вместо вывода хаотичных или чрезмерно стимулирующих параметров, SNN безопасно переходит к амплитуде стимуляции A. В результате необработанная сеть GPi возвращается в свое полное патологическое состояние (). Такое отказоустойчивое поведение подтверждает, что SNN действует как чисто реактивный контроллер, который ведет себя стабильно и предсказуемо при отсутствии входных данных..
Контроллер демонстрирует высокую устойчивость и быстрое восстановление после сенсорной депривации. При переходе от блока 5 к блоку 6, сразу после 500 шагов в полностью слепом состоянии со стимуляцией A, SNN повторно подвергается воздействию живой патологической паркинсонической обратной связи. Она мгновенно возобновляет управление по замкнутому циклу, быстро увеличивая амплитуду стимуляции обратно до A и успешно восстанавливая подавление биомаркеров. Наконец, во время здоровых блоков, следующих непосредственно за тихими блоками (блоки 4 и 7), средний локальный полевой потенциал (LFP) остается временно повышенным () по сравнению с исходным здоровым базовым уровнем. Этот гистерезис возникает из-за того, что биофизическая популяция GPi, оставленная без лечения в состоянии выраженной патологии во время тихих блоков, устанавливает устойчивую резонансную осцилляцию, которой требуется время для естественного затухания после того, как среда переключается обратно в здоровое состояние без активных патологических входных сигналов, стимулирующих SNN..