Границы погрешности линеаризации с параллельным ускорением на GPU для систем реального времени
Робастное оптимальное управление нелинейными и нейросетевыми динамическими системами
Аннотация
В данной статье исследуется робастное оптимальное управление в реальном времени для неопределенных нелинейных систем, где линейно-изменяющиеся во времени (LTV) аппроксимации делают планирование выполнимым, но требуют надежных границ ошибки линеаризации (LEB) для гарантии робастного выполнения ограничений. Мы разрабатываем точные, дифференцируемые, параллельные на GPU LEB для LTV-аппроксимаций нелинейной динамики и динамики нейронных сетей (NN). Для аналитической динамики мы вводим основанные на путях границы Гессиана, которые являются более точными, чем стандартные интервальные методы. Для динамики NN мы выводим сертифицированные LEB, используя аффинные релаксации, сгенерированные верификатором NN, и локальные поправки Якобиана. Мы адаптируем решатель робастного управления на основе LTV с использованием системного синтеза (system-level synthesis), параллельный на GPU, для совместимости с этими LEB, расширяя его для работы с правообратимыми матрицами возмущений и множествами возмущений с ненулевым центром для точного распространения зонотопической неопределенности. Наш метод, GPUSLS-LEO, обеспечивает онлайн-оптимизацию робастных стратегий обратной связи, которые учитывают ошибку линеаризации, создавая точные, формально верифицированные достижимые трубки. На сложной нелинейной динамике и динамике NN размерностью до 168 состояний наш метод позволяет вычислять стратегии робастного управления на GPU с частотой до 67 Гц, сокращая время решения и консервативность по сравнению с базовыми методами при сохранении формальных гарантий и производительности в реальном времени..
I Введение
Безопасное нелинейное управление в реальном времени в условиях неопределенности имеет решающее значение для отказоустойчивой работы роботов, дронов и космических аппаратов. Это стимулирует разработку методов решения задачи робастного нелинейного оптимального управления (RNOCP), целью которой является поиск стратегии управления, гарантирующей выполнение ограничений при наихудших возмущениях. На практике решатели RNOCP обычно оптимизируют (1) номинальную траекторию и (2) стабилизирующий контроллер обратной связи для ее отслеживания при наличии возмущений. Робастное выполнение ограничений обеспечивается путем ужесточения номинальных ограничений с использованием аппроксимации сверху достижимой трубки ошибки слежения замкнутой системы, что гарантирует нахождение динамики замкнутой системы в безопасном подмножестве пространства состояний и входов. Однако точный анализ достижимости посредством распространения ошибки через нелинейную динамику [1, 2, 3], как правило, невыполним в реальном времени. Чтобы решить эту проблему, [4, 5, 6, 7] аппроксимируют нелинейную динамику вдоль номинальной траектории с помощью линейной нестационарной (LTV) системы и вычисляют достижимые множества, используя LTV-динамику. Синтез на системном уровне (SLS) [8, 4] является одной из таких структур робастного управления LTV, которую можно решать в реальном времени на больших горизонтах для многомерных систем [9, 10].
Несмотря на высокую эффективность, методы на основе LTV гарантируют соблюдение ограничений устойчивости только при наличии границы ошибки линеаризации, которая отражает отклонение между истинной нелинейной динамикой и ее LTV-аппроксимацией. Существующие методы часто используют глобальные границы [4, 11], что приводит к консервативным (широким) трубкам достижимости. Более точные локальные границы вокруг номинальной траектории часто возможны, но должны вычисляться эффективно для планирования в реальном времени и быть достаточно информативными, чтобы направлять оптимизатор к безопасным траекториям с минимальной ошибкой линеаризации. Таким образом, задача состоит в разработке границ, которые одновременно являются (1) точными, (2) вычислимыми в реальном времени и (3) дифференцируемыми, чтобы решатель RNOCP мог использовать их для изменения формы номинальной траектории и сужения трубок достижимости. Поскольку существующие методы не удовлетворяют всем трем требованиям, многие решатели RNOCP на основе LTV вынуждены игнорировать ошибку линеаризации, жертвуя формальными гарантиями ради производительности [12, 13].
Чтобы устранить этот разрыв, мы предлагаем семейство точных дифференцируемых границ ошибки линеаризации (LEBs) для решателей RNOCP с нелинейной динамикой, описываемой аналитическими функциями и нейронными сетями (NNs), с реализацией параллельных вычислений на GPU в JAX. Чтобы сделать эти LEBs совместимыми с решателем SLS реального времени из [10, 9], мы расширяем решатель: 1) для поддержки правообратимых матриц возмущений, что позволяет выполнять прямое зонотопическое распространение LEBs, избегая консервативных сверхаппроксимаций из [9]; и 2) для обработки множеств возмущений, не центрированных в нуле. Наконец, мы эмпирически показываем, что эти границы обеспечивают вычисление формально верифицированных решений RNOCP в реальном времени на GPU с ограниченным консерватизмом для систем с числом состояний до 168 и временем решения от 15 мс. Наш вклад заключается в следующем::
- ⟦• Набор точных, доказательно обоснованных методов оценки ошибки линеаризации, включая интервальные границы на основе путей для аналитических систем и границы на основе верификаторов NN для динамики NN.
- ⟦• Новая формулировка нелинейного SLS, включающая ошибку линеаризации посредством точного зонотопного распространения, включая обработку правообратимых матриц возмущений и множеств возмущений с ненулевым центром, что гарантирует робастное выполнение ограничений для исходной нелинейной системы.
- ⟦• Ускоренный графическим процессором решатель нелинейных SLS, GPUSLS-LEO, который использует формулировку этих границ линеаризации в JAX для обеспечения дифференцируемой, параллельной на графическом процессоре оценки и робастного нелинейного оптимального управления на основе градиента.
- ⟦• Оценка на аналитических и NN моделях динамики с поддержанием частоты управления в реальном времени (до 67 Гц) для систем размерностью до 168D и задач с переменными решения.
II Связанные работы
Хотя существуют методы анализа достижимости без линеаризации [1, 2, 3], прямое распространение ошибки через нелинейную динамику, как правило, является вычислительно неразрешимым в режиме реального времени, особенно при размерности более 10 состояний [3, 1]. Таким образом, решатели RNOCP часто полагаются на линеаризованное распространение ошибки для повышения эффективности [14, 13], однако это вносит ошибку линеаризации, которую трудно строго ограничить, и которую часто игнорируют [14, 15, 13, 10], недооценивают посредством выборки [11, 4] или обрабатывают, предполагая наличие оракула границ линеаризации [16, 17, 18, 19, 20]. Решатели RNOCP, которые явно вычисляют LEB, обычно полагаются на глобальные оценки Липшица [11] или интервальную арифметику [7, 5, 6, 21]. Интервальная арифметика использовалась как для вычисления достижимых множеств [22, 23], так и для поддержки анализа достижимости путем построения границ линейного дифференциального включения (LDI) для нелинейной динамики [24]. В частности, в [25] используется ограничение якобиана для получения более точных LDI для анализа достижимости, но этот подход не применяется для проектирования управления или прямого вычисления LEB. С вычислительной точки зрения существующие методы ограничения линеаризации являются автономными [4], медленными или недифференцируемыми [7], что ограничивает их использование при планировании. Чтобы устранить эти пробелы, наш метод использует интервальную арифметику и JAX для вычисления точных дифференцируемых LEB для непосредственного использования в оптимальном управлении. Более того, мы также адаптируем инструменты верификации neural-network (NN) [26] для вывода аффинных границ ошибки линеаризации для динамики NN..
Поскольку вычисление LEB может занимать много времени [4], их часто генерируют один раз в автономном режиме [4, 11], однако они оказываются неточными, если мы хотим ограничить ошибку вокруг одной траектории, как в RMPC. Таким образом, специалисты часто пренебрегают ошибкой линеаризации, получая эвристические достижимые трубки, которые жертвуют формальными гарантиями ради производительности [12]. Чтобы решить эту проблему, мы показываем, что точные локальные LEB с параллельным ускорением на GPU могут вычисляться в режиме реального времени, обеспечивая при этом как быстродействие для многомерных систем, так и строгие гарантии..
III Предварительные сведения и постановка задачи
Обозначения: Мы обозначаем как единичную матрицу, норму Фробениуса матрицы как . Пусть , и для . Для матрицы мы определяем построчную -норму как . Для мы определяем как её диагональную матрицу. Для заданной с линейно независимыми строками мы определяем так, что , где . Мы обозначаем сумму Минковского двух множеств и как . Для функции с (или явно ) мы определяем и как первую и вторую частные производные по -му и -му компонентам векторного входа. Мы определяем как множество всех -мерных интервалов. Пусть , тогда ⟧.
Определения: Мы рассматриваем неопределенную нелинейную динамику
| (1) |
где — состояние системы на временном шаге , обозначает управляющее воздействие, — функцию динамики, — функцию масштабирования возмущений, а — возмущение, нормализованное таким образом, чтобы оно находилось внутри единичного -шара.
Мы стремимся разработать контроллер , который решает следующую задачу робастного нелинейного оптимального управления (RNOCP):
| (2a) | ||||
| s.t. | (2b) | |||
| (2c) | ||||
| (2d) | ||||
| (2e) | ||||
| (2f) | ||||
где представляет собой последовательность причинно-следственных стратегий управления, — начальное состояние, функции обозначают поэтапные ограничения на состояния и входы, а — терминальное ограничение. Мы определяем замкнутое достижимое множество состояний и управлений как
| (3) |
Поскольку (2) является неразрешимой бесконечномерной задачей, решатели RNOCP часто упрощают её путем вычисления (A) номинальной траектории состояния-входа и (B) следящего контроллера вокруг этой траектории. В данной статье мы используем один из таких методов, GPUSLS [10], который адаптирует [9] для решения в реальном времени на GPU. Затем мы расширяем [10], чтобы учесть ошибку линеаризации в разд. V. Наш подход использует SLS, который мы теперь рассмотрим.
III-A Синтез на системном уровне (SLS)
Рассмотрим следующую неопределенную LTV динамику
| (4) |
SLS — это концепция проектирования управления, которая выполняет оптимизацию по причинно-следственным регуляторам обратной связи по возмущению
| (5) |
с номинальным управлением , то есть мы назначаем матрицу обратной связи по возмущению для каждого возмущения и управление для . Для динамики LTV (4) можно показать с помощью алгебраических преобразований [8], что результирующая последовательность состояний замкнутой системы может быть выражена как
| (6) |
где — номинальное состояние, а замкнутый отклик отражает влияние возмущения на состояние . Начиная с , SLS распространяет возмущение через , для всех и . Поскольку (5)–(6) являются истинной траекторией замкнутой системы при заданной последовательности возмущений, точные достижимые множества замкнутой системы представляют собой и . Чтобы применить методы разд. III-A к нелинейной динамике (1), мы аппроксимируем (1) с помощью номинальной динамики и LTV-динамики ошибки вдоль номинальной траектории состояния-управления , . Для номинального мы строим LTV-аппроксимацию вида (4), определяя
| (7) |
Обозначим и . Тогда остаточную ошибку между (1) и её аппроксимацией Тейлора первого порядка относительно , то есть , можно записать как,
| (8a) | ||||
| (8b) | ||||
| (8c) | ||||
В частности, (8c) учитывает остаточный член Тейлора нелинейной динамики , в то время как (8b) учитывает ошибку, вызванную зависимостью матрицы возмущений от состояния. Учитывая данную постановку, мы изучаем следующие задачи.
III-B Постановка задачи
Задача 1 (Граница ошибки линеаризации). Для всех найти множественнозначную аппроксимацию сверху , а также соответствующую масштабирующую матрицу и смещение , где
| (9) | ||||
IV Границы погрешности линеаризации с параллельным ускорением на GPU
Для упрощения изложения мы рассматриваем векторнозначную функцию от расширенного состояния . Пусть — компактное множество, а — номинальная точка. Ошибка линеаризации, то есть остаточный член Лагранжа разложения в ряд Тейлора первого порядка для в точке , имеет вид,
| (10) |
Для частного случая, когда , (10) совпадает с (8c). Наша цель — вычислить корректную покомпонентную интервальную оболочку для , то есть .
IV-A Границы погрешности линеаризации для аналитической динамики
Согласно теореме Тейлора в форме Лагранжа, для каждого компонента существует такое, что
| (11) |
где является -м элементом Гессиана в точке . Для оценки интервального включения в предыдущих работах [7, 5, 6, 21] отдельно вычисляются и в интервальной арифметике, а затем выполняются интервальные произведения, как в (12), что дает включение ⟧:
| (12) |
где обозначает множество смещений, а представляет собой интервальное приближение Гессиана на с элементами (где ). На практике обычно выбирается в центре [7], что приводит к симметричному для более узкого приближения ⟧.
Сохраняя строгую квадратичную форму, (11) можно сначала разложить покомпонентно, а затем выполнить интервальную арифметику над этим разложением. Это дает (13), где интервал обозначает -й срез после применения симметрии интервального гессиана. Когда является симметричным, гарантируется, поскольку (13) сохраняет неотрицательность для всех и для всех :
| (13) |
Однако классические границы в 12 и 13 оценивают все интервальные оболочки элементов Гессиана по всему множеству , что приводит к консервативности из-за эффектов зависимости и наматывания. Чтобы смягчить это, мы используем покоординатный путь от до , который позволяет получить более точные границы для членов второго порядка. Для любого определим последовательность промежуточных точек
| (14) |
с и . Это определяет покоординатный путь [24, 25], который инкрементально перемещается от к вдоль каждой координаты. Соответственно, определим префиксные множества .
Theorem 1 (Граница Гессиана на основе путей)
Пусть будет дважды непрерывно дифференцируемой на интервале , и пусть . Определим множество смещений . Для каждого определим покоординатный путь и соответствующие множества префиксов . Тогда для каждого компонента ошибка линеаризации удовлетворяет
| (15) |
Доказательство:
Зафиксируем и определим . Используя метод телескопической суммы вдоль покомпонентного пути, получаем . Для каждого применение теоремы Тейлора в одномерном случае дает
| (16) |
для некоторого . Суммирование (16) по и вычитание дает в левой части, что равно , а правая часть находится в . Разлагая разность градиентов вдоль того же пути для , получаем . Согласно теореме о среднем значении, для каждого существует такое, что . Подстановка дает . Поскольку , и , взятие интервальных оболочек дает (15). ∎
Теорема 1 подразумевает, что наша граница Гессиана, основанная на путях, никогда не является менее точной, чем расширенная интервальная граница Гессиана, поскольку каждый элемент Гессиана вычисляется на подмножестве полной области..
Corollary 1 (Путевой Гессиан никогда не бывает слабее)
Доказательство:
Для каждого , множество префиксов удовлетворяет по построению. Затем, для каждого элемента Гессиана,
Умножение на и сохраняет включение, а суммирование полученных членов дает . ∎
В отличие от , и сохраняют покомпонентное расширение для получения точных интервалов со смещенным центром (посредством квадратичной формы, а не симметричных границ). Мы используем повышенную точность в контексте RNOCP (разд. V).
IV-B Границы погрешности линеаризации для нейронной динамики
Для динамики NN вычисление точного интервала гессиана может быть затруднительным. Вместо этого мы используем CROWN [26, 27] для получения аффинных границ NN на множестве входных данных в виде параллелепипеда и преобразуем их в интервальное включение ⟧.
Theorem 2 (Границы CROWN (Thm. 3.2 [26]))
Для заданной NN, , и ограниченного входного сигнала , где является интервалом, существуют линейные нижние/верхние границы для :
| (18) |
где и ⟧.
Граница в 18 не ограничивает напрямую , поскольку наклоны , как правило, не совпадают с якобианом . Мы решаем эту проблему посредством дальнейшей релаксации в теореме 3.⟧.
Theorem 3 (Граница ошибки линеаризации от CROWN)
Пусть — это NN, — это параллелепипед, , — это якобиан в точке , и пусть удовлетворяет границам CROWN (18) на . Тогда ⟧:
| (19) |
| (20) | ||||
Затем интервальное замыкание задается как
| (21) |
IV-C Зонотопные границы ⟦K0⟧
Для получения границы зонотопа для (9) мы вычисляем оболочку ошибки линеаризации , как в разд. IV-A или IV-B, и оболочку ошибки возмущения с помощью интервальной арифметики в (22), где — это интервальная оболочка на ⟧:
| (22) |
Наконец, мы получаем , где и . Его зонотопная граница задается выражением , где и . Мы обозначаем это отображение компактно как
| (23) |
IV-D Дифференцируемая параллельная реализация границ
Мы реализуем наши LEBs в JAX, при этом PBH использует immrax для интервальной арифметики, а jax_verify предоставляет границы на основе CROWN для динамики NN. JAX обеспечивает дифференцируемость и параллелизацию на GPU, что позволяет выполнять уточнение номинальной точки на основе градиента и масштабируемое разбиение входной области для снижения консервативности для SLS.
V Использование границ ошибки линеаризации в GPUSLS
Мы обсуждаем использование наших LEBs в SLS (разд. V-A) и описываем эффективную реализацию на базе GPU (разд. V-B⟧).
V-A Формулировка нелинейного SLS
Следуя [9, App. A], SLS может быть расширен на нелинейные системы путем планирования номинальной траектории для динамики без возмущений и моделирования динамики ошибки слежения через LTV-систему из (4). Для приближенного решения (2) мы модифицируем формулировку нелинейного SLS из [9, App. A] так, чтобы она была совместима с 1) множествами возмущений с ненулевым центром и 2) LEB, приведенными в разд. IV-A-IV-B⟧:
| (24a) | ||||
| s.t. | (24b) | |||
| (24c) | ||||
| (24d) | ||||
| (24e) | ||||
| (24f) | ||||
| (24g) | ||||
| (24h) | ||||
где — это линеаризованная динамика (7) в момент времени , а функции (24d)–(24e) представляют собой суммы Минковского внешнего возмущения и ошибки линеаризации как функции номинальных значений (,), смещения центра достижимой трубки и ширин соответственно [12, 4] и . Формально, для всех в (24d)–(24e), и задаются как
| (25a) | ||||
| (25b) | ||||
| (25c) | ||||
где — это смещение, а — это порождающая матрица зонотопа для суммы Минковского внешнего возмущения и ошибки линеаризации: . Используя (25b) и (25c), получаем аппроксимацию сверху достижимой трубки:,
| (26) | |||
Устойчивое удовлетворение ограничений обеспечивается за счет ужесточения ограничений и . Вкратце, эти ужесточения отражают распространение единично-нормализованных возмущений в (26), которые затем масштабируются границами возмущений и смещаются на величину . Для простоты мы выводим ужесточения, предполагая линейные ограничения, т.е. и , для . Допустимые ужесточения могут быть получены для нелинейных и путем включения дополнительных членов ошибки [12, Eq. 22]. Формально мы определяем центр трубки (27) и ширину (28), объединенные (терминальные) ужесточения ограничений (29)-(30) и суррогатную стоимость отклика на системном уровне (31) как,
| (27) | ||||
| (28) | ||||
| (29) | ||||
| (30) | ||||
| (31) | ||||
где , собирает для всех , и . Сужения ограничений и ширины трубок в (28)-(30) выведены для наихудшего случая возмущений с использованием свойства двойственной нормы [28]. Функционал стоимости (31) штрафует неопределенность (ширины трубок (28)). Следуя [9, 10], мы решаем (24) посредством итерационного процесса, который чередуется между поиском (A) номинальной траектории и (B) робастного контроллера. Чтобы решить (A), мы находим путем решения NOCP с суженными ограничениями (32⟧),
| (32a) | ||||
| s.t. | (32b) | |||
| (32c) | ||||
| (32d) | ||||
Затем (32) повторяет структуру (2) и может быть решена с использованием метода параллельных вычислений на GPU из [10, Sec. IV]. После решения (A) (32) мы проводим линеаризацию вокруг полученного и находим робастный контроллер (B) путем поиска , который оптимизирует (31):
| (33a) | ||||
| s.t. | (33b) | |||
| (33c) | ||||
где определены в соответствии с [9, Eq. 20, 23] (см. прил. E) для обеспечения согласованности между (32) и (33). Примечательно, что умножение справа на препятствует представлению функции стоимости в (33a) в виде стандартной целевой функции LQR в и . Таким образом, она не может быть решена напрямую с использованием методов на основе уравнения Риккати из [9, 10]. Вместо этого мы решаем (34), которая имеет стоимость LQR и может быть решена с помощью эффективных решателей [9, 10]⟧:
| (34a) | ||||
| s.t. | (34b) | |||
| (34c) | ||||
Заметим, что (34) совпадает с (33), если для всех . В предложении 1 мы доказываем, что множества минимизаторов (33) и (34) эквивалентны, если является правообратимым для всех (см. прил. C для доказательства).
Proposition 1
При реализации метода из разд. IV мы добавляем небольшое положительное диагональное дополнение к , чтобы она всегда была обратимой, и, таким образом, (25) всегда была правообратимой для всех . После решения (34) мы вычисляем члены ужесточения ограничений в (27)–(30). Это обновляет центры достижимых трубок и ширины : которые используются в качестве ужесточений ограничений на следующей итерации оптимизации номинальной траектории (32). Этот процесс повторяется до сходимости (как в [9, Alg. 1]); мы завершаем работу после фиксированного числа итераций или если изменение итератов оказывается ниже порогового значения (см. прил. B для алгоритмического блока).
Новизна формулировки: Здесь мы суммируем изменения, внесенные в предыдущие формулировки нелинейного SLS [9, App. A] [4]⟧:
- ⟦1. Зонотопы позволяют выполнять точное вычисление сужения (27)–(30) путем конкатенации генераторов внешнего возмущения и ошибки линеаризации, в отличие от предыдущих эллипсоидальных методов [9, App. A], однако это приводит к правообратимым , несовместимым с существующими решателями [9, 10]. Мы решаем эту проблему путем установки и включения масштабирования возмущения непосредственно в сужения и функцию стоимости (31) с помощью совместимой переформулировки (34), обоснованной предл. 1⟧.
- ⟦2. Наконец, мы расширяем [4, 9] для обработки возмущений с ненулевым средним значением, что позволяет напрямую использовать интервальные границы из (23) без дополнительного консерватизма, связанного с центрированием относительно нуля..
V-B Эффективная реализация SLS на GPU
Мы предлагаем GPUSLS-Linearization Error Optimization (GPUSLS-LEO), который опирается на GPUSLS [10] для явного учета распространения ошибки линеаризации. Мы сначала заменяем эллипсоидальное представление возмущений из [10] на зонотоп, модифицируя сужения ограничений и стоимостные слагаемые посредством (29)-(31). При каждом обновлении контроллера мы модифицируем GPUSLS, включая зонотопическую границу ошибки линеаризации посредством (25). Затем мы модифицируем инициализацию посредством (34c).
Все остальные шаги в точности следуют процедуре GPUSLS. В частности, GPUSLS-LEO решает (24) итеративно посредством последовательного квадратичного программирования (SQP). На каждой итерации GPUSLS-LEO аппроксимирует стоимость квадратичной функцией и линеаризует вокруг текущего для получения (4). Затем он решает (A) локальную QP-аппроксимацию (32) для обновления , (B) (34) для получения , и обновляет (C) сужения посредством (24f). Поскольку наши LEB дифференцируемы, мы можем штрафовать накопление ошибки во время шага (A) путем модификации номинальной целевой функции (32a) до , где
| (35) |
штрафует распространяемую остаточную ошибку (8a). Здесь взяты из предыдущей итерации, а является весовым коэффициентом. Примечательно, что (35) смещает в сторону областей с низкими возмущениями от распространяемых экзогенных ошибок и ошибок линеаризации. Наконец, мы показываем, что путем решения (24), GPUSLS-LEO обеспечивает удержание в достижимых трубках (26), т.е. и , для всех . Формально мы имеем (доказательство в приложении D).⟧):
VI Результаты
Мы оцениваем точность LEB (разд. VI-A) и робастные контроллеры, полученные с помощью GPUSLS-LEO (разд. VI-B). Тесты времени выполнения используют NVIDIA RTX 4090, за исключением экспериментов с несколькими квадрокоптерами и длинным горизонтом, для которых требуется NVIDIA H200. Определения систем приведены в прил. A⟧.
VI-A Ошибка линеаризации
Мы сравниваем LEB, полученную с помощью нашего метода на основе траекторий Hessian (PBH), для систем спутника (, ) и квадрокоптера (, ) (прил. A) с несколькими базовыми методами. Глобальная выборка [4] оценивает кривизну наихудшего случая в автономном режиме (занимая более 7 минут [4]) по глобальному множеству , что дает эмпирическую аппроксимацию сверху. Интервальный Hessian (IH) (классический) [6, 7] вычисляет (12) на локальном множестве . IH (классический)-CORA обозначает стандартную реализацию IH в CORA [6, 29]. Случайная выборка использует 10 тысяч образцов из локального множества и дает аппроксимацию снизу. Мы выбираем номинальные точки из и определяем локальные множества с помощью . Рис. 2 показывает среднюю ширину интервала (23). Для спутника, где нелинейность умеренная, все методы аппроксимации сверху остаются близкими к нижней границе случайной выборки по мере роста , хотя PBH все равно является наиболее точным. Для квадрокоптера PBH неизменно дает наиболее точные границы. Напротив, глобальная выборка дает неточные результаты при малых , что говорит о том, что глобальная кривизна не учитывает локальное поведение, в то время как интервальный Hessian становится чрезмерно консервативным при . Таблица I сравнивает время выполнения в режиме онлайн. PBH выполняется менее чем за 1 мс, что позволяет использовать его в реальном времени. Несмотря на то, что он медленнее глобальной границы, которая эффективно вычисляется онлайн после медленных автономных вычислений, PBH на 60% и 27% (для спутника и квадрокоптера соответственно) быстрее плотной случайной выборки и имеет пренебрежимо малое время выполнения по сравнению с CORA IH.
| System | Random | Global | IH-classic | IH-classic-CORA | Path-based |
|---|---|---|---|---|---|
| Satellite | 0.894 | 0.143 | 0.218 | 11570 | 0.361 |
| Quadrotor | 1.278 | 0.156 | 0.453 | 227200 | 0.936 |
| System | Initial | Sampling | PGD | PGD better (%) |
|---|---|---|---|---|
| Satellite | 0.2680 | 0.2365 | 0.2241 | 100 |
| Quadrotor | 0.02253 | 0.01639 | 0.01590 | 100 |
Чтобы количественно оценить преимущество дифференцируемости в нашей реализации Гессиана на основе путей, мы ищем номинальную точку в пределах фиксированного радиуса возмущения , которая минимизирует размер LEB. Начиная со случайных номинальных точек, мы запускаем проекционный градиентный спуск (PGD) в пределах локальной окрестности радиуса , чтобы уменьшить ширину интервала ошибки. Мы сравниваем PGD со случайной выборкой номинальных точек при том же временном бюджете, где оба метода используют PBH для оценки ошибки линеаризации. Таблица II показывает, что в 100% тестовых случаев PGD дает меньшую ширину интервала ошибки, чем случайная выборка для обеих систем, что демонстрирует ценность градиентной оптимизации для поиска номинальных точек с более узкими LEB, что может быть полезно для последующего SLS..
VI-B Использование границ линеаризации для RNOCP
В этом разделе мы оцениваем GPUSLS-LEO на наборе аналитических и нейронных динамических систем в сравнении с различными базовыми методами RNOCP. Мы дополнительно оцениваем влияние ключевых абляций, включая эффект оптимизации по градиентам ошибки линеаризации и использование зонотопов с ненулевым центром. Все сравниваемые методы оцениваются при одинаковом наборе возмущений для заданной динамической системы и, где это применимо, запускаются максимум на 100 итераций SQP..
VI-B1 Спутник
Мы оцениваем наш метод на задаче управления ориентацией 7D спутника, где целью является стабилизация системы в желаемой ориентации при наличии ограниченных возмущений. Мы используем экспериментальную установку из [4] и проводим сравнение с их подходом. На рис. 3 (a) мы сравниваем ширины трубок для: GPUSLS-LEO, GPUSLS-E (эллипсоидальное распространение, как в [9, App. A]), GPUSLS (без распространения ошибки линеаризации) [10] и NL-SLS ( [4]). Наш метод позволяет получить наиболее узкие трубки среди всех базовых подходов. В среднем наши трубки на 20% меньше, чем у NL-SLS, который опирается на глобальную максимальную границу Гессиана и поэтому является локально чрезмерно консервативным вдоль траектории. По сравнению с GPUSLS-E наш метод позволяет получить трубки на 45% меньше, так как он включает аппроксимацию суммы Минковского для эллипсоидов сверху, в то время как наша комбинация на основе зонотопов является точной. Мы наблюдаем, что внедрение нашего конвейера LEB не вносит существенного консерватизма, поскольку ширина трубок увеличивается лишь на 4% по сравнению с GPUSLS. На рис. 3 (b) мы показываем результаты 20 случайных и 64 состязательных возмущений для состояний кватернионов, демонстрируя 100% удержание в рамках нашего метода..
VI-B2 Планарный квадрокоптер
Мы оцениваем наш метод на 6D планарном квадрокоптере в сравнении с метриками сжатия управления (CCM) [30]. Оба метода должны перемещаться через плотное поле препятствий на горизонте в 40 шагов. Рис. 4(a) показывает, что наш метод достигает на 91% меньшей площади трубки, чем CCM для позиционных состояний . Это происходит потому, что CCM подтверждает безопасность во всем пространстве состояний, что вносит присущую консервативность. GPUSLS-LEO, с другой стороны, подтверждает безопасность вдоль конкретной траектории, обеспечивая более узкие, зависящие от траектории границы. Мы также оцениваем замкнутую систему с помощью инструмента интервального анализа достижимости immrax [24], показывая, что рассчитанная им площадь трубки расходится через несколько шагов..
На рис. 4(b) мы сравниваем рассчитанные траектории и трубки для нашего метода и CCM. Наш подход менее консервативен, что позволяет выбрать более прямой, оптимальный для задачи путь, в то время как CCM вынужден выбирать более длинный маршрут. На рис. 5(a) мы показываем траекторию и трубки на длинном горизонте в 7500 шагов, что включает оптимизацию траектории состояния-управления с переменными решения. Благодаря точности наших LEB и оптимизации контроллера с обратной связью в SLS, наши трубки остаются хорошо ограниченными и конечными на протяжении всего горизонта (рис. 5(b)), что демонстрирует масштабируемость метода для длинных горизонтов..
VI-B3 Связанный трехмерный квадрокоптер
Чтобы продемонстрировать масштабируемость для высокоразмерных систем, мы оцениваем наш метод на связанной системе из 14 трехмерных квадрокоптеров (168D) на горизонте 25. Перед системой стоит задача навигации через поле препятствий, при этом квадрокоптеры связаны силой пружины, направленной к центроиду группы. Мы показываем запланированные траектории и трубки на рис. 6(a) и наблюдаем, что все реализации остаются внутри узких трубок, несмотря на высокоразмерное пространство состояний, что демонстрирует масштабируемость метода по отношению к размерности состояния. На рис. 6(b) мы строим графики трубок и соответствующие им реализации для и для 100 состязательных возмущений.
VI-B4 Нейронный T-толкатель
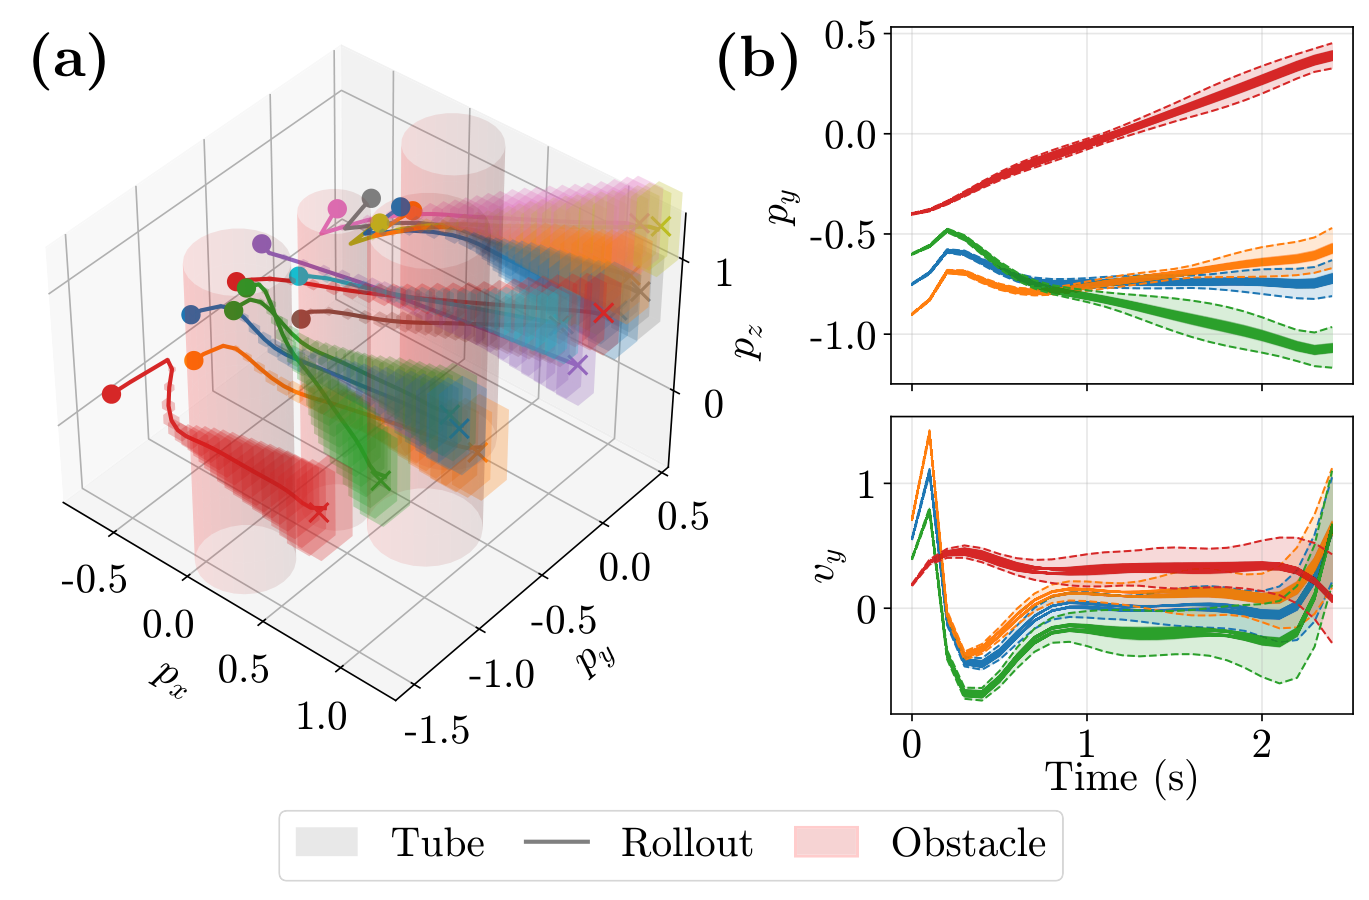
Мы демонстрируем, что наша формулировка позволяет учитывать распространение ошибки линеаризации через обученную нейронную динамику. Мы обучаем модель на основе MLP для системы T-pusher и ставим перед ней задачу вращения и перемещения объекта в целевую конфигурацию (Рис. 1). Мы оцениваем наш метод на нескольких абляциях (Рис. 7(a)), включая GPUSLS, GSL (сокращение для GPUSLS-LEO), GSL-C (центрированные в нуле зонотопы) и GSL (), который включает штраф за ошибку линеаризации, как определено в V-B. По сравнению с GPUSLS, GPUSLS-LEO создает трубки, которые в среднем на 99% больше. Однако Рис. 7(b) показывает, что наш метод достигает 100% охвата всех развертываний, в то время как Рис. 7(c) иллюстрирует, как траектории из GPUSLS выходят за пределы трубки, демонстрируя необходимость формального учета ошибки линеаризации..
На рис. 7(a) показано, что добавление штрафов за ошибку линеаризации позволяет снизить консервативность, при этом уменьшает ширину трубок на 8%. Мы также демонстрируем важность зонотопов с ненулевым центром, поскольку использование зонотопов с центром в нуле приводит к увеличению трубок на 25%. Мы представляем результаты прогонов и отклонения от возмущений на рис. 1(a). На рис. 1(b) мы демонстрируем возможности метода для замкнутого MPC на симулированной динамике контактов, где толкатель успешно выполняет задачу. Отметим, что мы формально не учитываем ошибку обучения; однако она может быть включена, как в [31, 32].
| System | GPUSLS | Lin. Error Grad. | Remainder | Total | DT |
|---|---|---|---|---|---|
| Satellite | 11 | 3 | 15 | 1000 | |
| Planar Quadrotor | 18 | 1 | 20 | 150 | |
| Coupled Quadrotor (96D) | 40 | – | 48 | 88 | 100 |
| Neural T-Dynamics | 630 | 100 | 32 | 762 | 1000 |
VI-B5 Время выполнения
Мы оцениваем время выполнения нашего метода для всех систем. В табл. III мы приводим распределение времени выполнения различных компонентов нашей методологии на итерацию в миллисекундах. Во всех системах, за исключением связанного квадрокоптера, основная вычислительная нагрузка приходится на GPUSLS, что показывает, что предложенные нами модификации не приводят к резкому увеличению времени выполнения. Мы также показываем, что все общие времена выполнения меньше шага дискретизации DT, что демонстрирует жизнеспособность нашего метода в рамках схемы MPC с итерациями в реальном времени [10].
Наконец, мы оцениваем масштабируемость метода при увеличении размерностей состояния и управления с использованием возрастающего числа связанных квадрокоптеров. Рис. 8 показывает, что GPUSLS требует большего начального времени выполнения, но благоприятно масштабируется с размерностью состояния и управления благодаря логарифмической зависимости [10]. PBH, с другой стороны, демонстрирует низкое начальное время выполнения, но может замедляться в более высоких размерностях из-за стоимости вычислений Гессиана..
VII Заключение
В данной статье представлена структура для вычисления точных, дифференцируемых и корректных границ ошибок линеаризации (LEBs) для нелинейных аналитических и NN динамических систем, а также их использования в GPUSLS-LEO — решателе RNOCP с параллелизацией на GPU в реальном времени, основанном на SLS. Данный подход снижает консервативность, превосходя современные инструменты анализа достижимости, при этом сохраняя формальные гарантии и обеспечивая производительность на системах с количеством состояний до 168, частотой управления в реальном времени (до 67 Гц) и задачах с переменными решения. В будущих работах будет исследовано, как наши LEBs могут быть расширены для ограничения ошибок линеаризации при планировании с учетом контактов [28] и нелинейном управлении с обратной связью по выходу, в том числе посредством расширений методов на основе SLS, описанных в [33, 34, 35].
Список литературы
- ⟦[1] А. Маджумдар и Р. Тедрейк, «Библиотеки воронок для робастного планирования движения с обратной связью в реальном времени», IJRR, том 36, № 8, 2017.
- ⟦[2] М. Альтхофф, «Анализ достижимости нелинейных систем с использованием консервативной полиномиализации и невыпуклых множеств», в HSCC, 2013.
- ⟦[3] С. Бансал, М. Чен, С. Герберт и К. Дж. Томлин, «Гамильтоново-якобиева достижимость: краткий обзор и последние достижения», в CDC, 2017.
- ⟦[4] А. Лиман, Дж. Кёлер, А. Занелли, С. Беннани и М. Цайлингер, «Робастное нелинейное оптимальное управление посредством синтеза на системном уровне», TAC, 2025.
- ⟦[5] Л. Шефер и М. Альтхофф, «Робастное оптимальное управление с использованием теоретико-множественного анализа достижимости», в сб. Европейской конференции по управлению (ECC). IEEE, 2025.
- ⟦[6] Д. Д. Лейстер и Дж. П. Коэлн, «Робастное модельное предиктивное управление для нелинейных систем с дискретным временем с использованием итеративного сужения ограничений, изменяющихся во времени», в Американской конференции по управлению (ACC). IEEE, 2025.
- ⟦[7] М. Альтхофф, О. Стурсберг и М. Бусс, «Анализ достижимости нелинейных систем с неопределенными параметрами с использованием консервативной линеаризации», в CDC. IEEE, 2008, стр. 4042–4048.
- ⟦[8] Дж. Андерсон, Дж. К. Дойл, С. Х. Лоу и Н. Матни, «Синтез на системном уровне», Annu. Rev. Control., том 47, стр. 364–393, 2019.
- ⟦[9] А. П. Лиман, Дж. Колер, Ф. Мессерер, А. Лар, М. Диль и М. Н. Цайлингер, «Быстрый синтез на системном уровне: робастное модельное предиктивное управление с использованием рекурсий Риккати», IFAC, том 58, № 18, 2024.
- ⟦[10] Дж. Фанг и Г. Чоу, «Безопасное крупномасштабное робастное нелинейное mpc за миллисекунды посредством синтеза на системном уровне с ограничением достижимости на gpu», в Robotics: Science and Systems (RSS), 2026.
- ⟦[11] Т. Ким, П. Эланго и Б. Ачикмеше, «Совместный синтез траектории и контролируемой инвариантной воронки для дискретных нелинейных систем с локально липшицевыми нелинейностями», IJRNC, том 34, № 6, 2024.
- ⟦[12] С. Чжан, К.-И. Чиу, А. Лиман и Г. Чоу, «Устойчиво ограниченные динамические игры для неопределенной нелинейной динамики», в ICRA, 2026.
- ⟦[13] Ф. Мессерер и М. Диль, «Эффективный алгоритм для робастного нелинейного оптимального управления на основе трубок с оптимальной линейной обратной связью», 2021.
- ⟦[14] З. Манчестер и С. Куиндерсма, «Dirtrel: Робастная нелинейная прямая транскрипция с эллипсоидальными возмущениями и обратной связью LQR», 2017.
- ⟦[15] М. Диль, Х. Г. Бок и Э. Костина, «Метод аппроксимации для робастной нелинейной оптимизации», Math. Prog., том 107, № 1, 2006.
- ⟦[16] Б. Хауска, Ф. Логист, Дж. Ван Импе и М. Диль, «Робастная оптимизация нелинейных динамических систем с применением к трубчатому реактору с рубашкой», Journal of Process Control, том 22, № 6, 2012.
- ⟦[17] М. Вильянуэва, Р. Киринен, М. Диль, Б. Чачуат и Б. Хуска, «Робастное mpc посредством дифференциальных неравенств типа мин-макс», Automatica, 2017.
- ⟦[18] М. Кэннон, Д. Нг и Б. Куваритакис, «Последовательная линеаризация нелинейного прогнозного управления для класса стохастических нелинейных систем», в NMPC, 2009.
- ⟦[19] М. Кэннон, Дж. Бюргер, Б. Куваритакис и С. Ракович, «Робастные трубки в нелинейном прогностическом управлении моделями», TAC, том 56, № 8, 2011.
- ⟦[20] А. Ричардс, «Робастное модельное предиктивное управление для нестационарных систем», в CDC. IEEE, 2005, стр. 3747–3752.
- ⟦[21] М. Рунггер и М. Замани, «Точный анализ достижимости неопределенных нелинейных систем», в HSCC, 2018, стр. 61–70.
- ⟦[22] Д. Лимон, Дж. Браво, Т. Аламо и Э. Камачо, «Робастное mpc нелинейных систем с ограничениями на основе интервальной арифметики», IEE Proceedings-Control Theory and Applications, том 152, № 3, 2005.
- ⟦[23] К. Шен и Г. Чоу, «Параллельная дифференцируемая достижимость для обучения и планирования с сертифицированной нейронной динамикой и контроллерами», в Робототехника: наука и системы (RSS), 2026.
- ⟦[24] А. Харапанахалли, С. Джафарпур и С. Куган, «immrax: распараллеливаемый и дифференцируемый инструментарий для интервального анализа и смешанной монотонной достижимости в jax», ADHS, том 58, № 11, 2024.
- ⟦[25] А. Харапанахалли и С. Куган, «Линейное дифференциальное включение для анализа сжатия к известным траекториям», IEEE TAC, 2025.
- ⟦[26] Х. Чжан, Т.-У. Венг, П.-И. Чен, К.-Дж. Се и Л. Дэниел, «Эффективная сертификация робастности нейронных сетей с общими функциями активации», NeurIPS, том 31, 2018.
- ⟦[27] К. Сюй, З. Ши, Х. Чжан, Ю. Ван, К.-В. Чанг, М. Хуанг, Б. Кайлкура, Х. Лин и К.-Дж. Се, «Автоматический анализ возмущений для масштабируемой сертифицированной устойчивости и не только», NeurIPS, 2020.
- ⟦[28] У.-С. Ли и Г. Чоу, «Сертифицированное манипулирование с интенсивным контактом на основе градиента с помощью достижимых трубок с ошибкой сглаживания», в Robotics: Science and Systems (RSS), 2026.
- ⟦[29] М. Альтхофф, «Введение в CORA 2015», в сборнике трудов семинара по прикладной верификации непрерывных и гибридных систем, 2015.
- ⟦[30] А. Сасфи, М. Н. Цайлингер и Дж. Кёлер, «Робастное адаптивное управление с прогнозирующими моделями с использованием метрик сжатия управления», Automatica, том 155, стр. 111169, 2023.
- ⟦[31] А. Сринивасан, А. Лиман и Г. Чоу, «Безопасность за пределами обучающих данных: робастное MPC вне распределения посредством конформного синтеза на системном уровне», Обучение для динамики и управления (L4DC), 2026.
- ⟦[32] Д. Нат, А. Сринивасан, Х. Инь, Р. Цзян, Дж. Фанг и Г. Чоу, «От пикселей к доказательствам: вероятностно-безопасное управление латентной моделью мира посредством параллельного конформного робастного MPC», препринт arXiv:2606.15594, 2026.
- ⟦[33] А. П. Лиман, С. Чжан, М. Н. Цайлингер и Г. Чоу, «Vision-sls: Безопасное управление на основе восприятия с использованием изученных визуальных представлений посредством синтеза на системном уровне», Robotics: Science and Systems (RSS), 2026.
- ⟦[34] Х. Чжоу и В. Цумас, «Безопасное управление частично наблюдаемыми линейными нестационарными системами с минимальным динамическим сожалением в наихудшем случае», в 2023 62-я Конференция IEEE по принятию решений и управлению (CDC). IEEE, 2023, стр. 8781–8787.
- ⟦[35] У.-Ч. Ли, Дж. Фанг, С. Полисетти, Ю. Сонг и Г. Чоу, «Устойчивость без складок: параллельное моделирование и робастное mpc для сертифицированных манипуляций с деформируемыми объектами», препринт arXiv arXiv:2606.14188, 2026.
В приложении мы сначала обсуждаем детали динамики систем, использованной в экспериментальных результатах (App. A). Затем мы приводим блок алгоритма, описывающий, как последовательное квадратичное программирование используется для решения GPUSLS-LEO (App. B). Далее мы обсуждаем и доказываем Proposition 1 и вспомогательную лемму в App. C. Затем мы приводим доказательства для остальных теоретических результатов, которые были опущены в основной рукописи в App. D. Наконец, мы более подробно обсуждаем переменную множителя Лагранжа , используемую в нашей структуре в App. E⟧.
Appendix A Определения динамических систем
В этом разделе мы приводим обзор определений динамических систем с дискретным временем для каждой системы. Динамика с дискретным временем получена посредством дискретизации методом Эйлера вперед с шагом по времени , .
A-A Спутник
Мы используем ту же динамику спутника и экспериментальную установку, что и [4]. В частности, мы определяем динамику как,
| (36a) | ||||
| (36b) | ||||
с состояниями , где — кватернион ориентации, — угловая скорость вращения, — входной управляющий момент, а — симметричная матрица инерции. Мы определяем постоянное масштабирование возмущения .
A-B Плоский квадрокоптер
Мы рассматриваем планарный квадрокоптер со следующей динамикой
| (37a) | ||||
Состояние определяется как , а вход как . Положение обозначается как , — угол тангажа, — поступательные скорости, а — угловая скорость. Входы представляют собой тягу отдельных роторов. Мы определяем массу , ускорение свободного падения , длину плеча и момент инерции . Мы определяем масштабирование возмущения как .
A-C Связанный трехмерный квадрокоптер
Мы рассматриваем систему из квадрокоптеров. Для заданного квадрокоптера мы определяем его динамику как
| (38a) | ||||
Состояние квадрокоптера определяется как , где обозначает положение, — углы крена, тангажа и рыскания, — поступательные скорости, а обозначают угловые скорости корпуса. Входные данные определяются как , где — суммарная тяга, а — моменты сил, действующие на корпус..
Для системы из связанных квадрокоптеров мы объединяем состояния и входные воздействия, получая общие векторы состояния и управления,
| (39) |
Мы дополнительно включаем центроидную пружинно-демпферную связь в поступательную динамику. Мы определяем положение и скорость центроида как
| (40) |
Ускорение связи, примененное к квадрокоптеру , составляет
| (41) |
где и представляют собой коэффициенты связи, при этом определяет жесткость пружинного члена, а управляет коэффициентом демпфирования. В наших экспериментах мы задаем и . Таким образом, динамика в дискретном времени принимает вид
| (42) |
Мы используем матрицу масштабирования возмущений
Appendix B Блок алгоритма
Здесь соответствует квадратичной аппроксимации номинальной стоимости.
Appendix C О решении для
Решение (33) дает оптимальные значения для и , которые штрафуют размер сужений (31). Однако это приводит к появлению в (33a) членов, которые масштабируют матрицы отклика и на в функции стоимости (33a). Это по-прежнему квадратичная стоимость относительно , но она больше не сохраняет структуру функции стоимости LQR. Чтобы решить эту проблему, мы вместо этого решаем (34), которая имеет структуру LQR и может быть решена с помощью рекурсий Риккати. Для полноты изложения мы приводим исходную задачу (33), переформулированную задачу (34) и эквивалентное утверждение оптимизатора (Prop. 1) ниже.:
Proposition 1 (Эквивалентные оптимизаторы)
Доказательство:
Заметьте, что (33) может быть переписано в (43) с помощью замены переменной , поскольку при использовании (33b) и (33c) мы имеем, что,
| and | ||||
| (43a) | ||||
| s.t. | (43b) | |||
| (43c) | ||||
Из [10], (43) может быть решено посредством параллельных рекурсий Риккати,
| (44) | ||||
и параллельные прямые распространения
| (45) | ||||
Затем, поскольку является правообратимой, а (43) представляет ограничение системного уровня (SLC), принятое в лемме 1, коэффициенты усиления контроллера подчиняются,
| (46) | ||||
Затем, путем раскрытия рекурсии (46), мы получаем для ⟧,
| (47) |
в то время как остальные коэффициенты усиления (, где ) равны нулю, при этом мы определяем упорядоченное матричное произведение .
Для восстановления оптимальных коэффициентов усиления для (33) мы используем свойство правой обратимости и подставляем в (47⟧):
| (48) |
Второе равенство следует из того, что удовлетворяет (33c). Теперь заметим, что (34) имеет те же рекурсии Риккати, что и (44), что приводит к оптимальному коэффициенту усиления, структурированному аналогично (47), где заменено на , :
| (49) |
где , как ограничено (34c). Следовательно , таким образом . ∎
Lemma 1
Пусть , где для всех является правообратимым, и . Обеспечение неопределенной динамики LTV
| (50) |
эквивалентно соблюдению ограничения на системном уровне (51), то есть (50)(51),
| (51) |
Более того, отображение коэффициентов усиления контроллера для SLC в (51) представляет собой,
| (52) |
где . Наконец, при заданном , прямое распространение коэффициентов усиления возмущений подчиняется:
| (53) | ||||
Доказательство:
Во-первых, пусть будет таким, что
| (54) |
Теперь пусть . Тогда, определяя отображения коэффициентов усиления и таким образом, что,
| (55) |
мы имеем из [8]:
| (56) |
Определяя , мы наблюдаем:
| (57) |
Затем отображение коэффициентов усиления от к и через и следует из (55) и (57):
| (58) |
Это устанавливает, что и . Следовательно, умножая (56) на , мы приходим к (51). Таким образом, мы показали . Чтобы показать эквивалентность между (50) и (51), мы можем показать , путем прямого восстановления матриц из (51) для получения (50⟧).
Чтобы доказать (52), мы замечаем, что , [8]. Затем, используя подстановки и из (58), мы приходим к первому равенству в (52). Второе равенство возникает из алгебраических преобразований с использованием определения . Наконец, преобразуя (52), чтобы увидеть , и раскрывая ограничение системного уровня в (51), мы получаем, что
| (59) | ||||
∎
Appendix D Доказательства
Theorem 4
Доказательство:
Сначала мы докажем, что 26 является корректным при условии допустимых возмущений. Пусть определяет возмущение . Тогда, исходя из SLS [4], мы имеем, что аппроксимация сверху достижимого множества представляет собой,
| (60) | |||
Теперь предположим, что может быть выражено как зонотоп, . Выполнив эту подстановку в (60), мы приходим к,
| (61) | |||
Используя ассоциативность и коммутативность суммы Минковского, 61 можно переписать в,
| (62) | |||
Затем, вспоминая, что является суммой Минковского одноэлементных множеств, мы можем заменить его на (и аналогично поступить для ) и прийти к множеству достижимости возмущений (26). Теперь мы покажем, что границы возмущений , в (24d)-(24e) являются корректными аппроксимациями сверху (9) и подтвердим, что замкнутые множества достижимости и аппроксимируют сверху истинное множество достижимости и (3⟧).
Базовый случай: возмущение на временном шаге в точности равно , что учитывается в (25), и, таким образом, (24d)-(24e) обеспечивает верхнюю аппроксимацию границ возмущения.
Индуктивный шаг: Предположим, что для всех временных шагов , . Тогда мы имеем переаппроксимированные достижимые множества, и , на временном шаге . Определим . Затем заметим, что , как определено в (25a). Тогда, по построению, для всех и для всех , мы имеем, что , где вычисляется с использованием в (25). Аналогично, номинальное возмущение . Таким образом, полное возмущение (8a), . Конкатенация двух матриц-генераторов дает (25b). Таким образом, граница возмущения на временном шаге в (24d)-(24e) является переаппроксимацией и содержит истинную остаточную ошибку, т.е. (8a).
После установления допустимых границ возмущений для всех шагов , SLS гарантирует, что аппроксимация сверху достижимого множества замкнутой системы (26), и являются корректными, то есть и для всех ⟧. ∎
Appendix E Двойственные задачи GPUSLS
Как обсуждалось в разд. V-A, задача RNOCP решается путем итеративного чередования между решением задачи оптимизации номинальной траектории и обновлением контроллера. Поскольку эти две задачи оптимизации решаются раздельно, мы используем двойственную переменную для обеспечения согласованности между ними, как обсуждалось в [10, App. B]. В связи с нашей переформулировкой мы изменяем процедуру следующим образом. Как и в [10, App. B], мы определяем вспомогательные члены и , где
| (63a) | ||||
| (63b) | ||||
| (63c) | ||||
| (63d) | ||||
где обозначает поэлементное возведение в квадрат. Затем мы можем вычислить наши двойственные переменные с помощью
| (64) |
где мы обозначаем как двойственную переменную оптимизации номинальной траектории (соответствующую двойственной переменной в [10]), введенную здесь во избежание конфликта обозначений. Наконец, мы можем определить наши стоимостные слагаемые как
| (65) | ||||
Следуя [9] и [10], данная формулировка сохраняет двойственную согласованность и приводит к эквивалентной переформулировке RNOCP в рамках предложенной декомпозиции.