ResearchStudio-Яdеа: Набор навыков для генерации исследовательских идей с опорой на доказательную базу
из результатов конференции по ML
4CFAR, A*STAR)
ResearchStudio-Idea: Набор навыков для генерации исследовательских идей на основе фактических данных ⟦BROKEN_K0⟧ из результатов конференций по ML
Цихао Чжао1, Янъюй Хуан2‡, Ялунь Дай1,2, Лингао Сяо2,3, Цзяньцзюнь Гао1, Синь Чжан2, Вэньшань У2
Скарлетт Ли2, Ян Хэ3,4, Ян Лу2, Яп Ким Хуэй1‡
1Наньянский технологический университет 2Майкрософт Рисерч 3Национальный университет Сингапура 4ЦФАР, А*СТАР
1 Введение
1.1 Проблема и область применения
Исследовательские агенты на базе LLM упростили масштабирование процесса генерации научных идей. Современные системы способны находить статьи, выдвигать гипотезы, координировать работу специализированных агентов, планировать эксперименты, писать код и составлять черновики отчетов [29, 40, 49, 18, 11, 25]. Методы, основанные на поиске, расширяют пространство кандидатов. Инструменты для оценки новизны делают проверку предшествующего уровня техники более явной. Этот прогресс смещает «узкое место». Сложный вопрос теперь заключается не в том, может ли LLM создать правдоподобное предложение. Вопрос в том, можно ли организовать исследовательскую работу на ранних стадиях в виде повторно используемых навыков, которые обосновывают доказательства, формируют одно аргументированное направление и проверяют его дистанцию от предшествующего уровня техники до начала экспериментов..
ResearchStudio-Idea решает эту проблему «первой мили» как набор из трех открытых навыков. Paper-Search обеспечивает повторно используемое обоснование литературы по arXiv, DBLP, OpenAlex, OpenReview, Semantic Scholar и Crossref. Scoop-Check выполняет проверку на наличие предшествующего уровня техники на уровне утверждений путем декомпозиции предлагаемой новизны на постановку проблемы, основной механизм, ключевое понимание и область применения, а затем сравнивает эти оси с найденными предыдущими работами. IdeaSpark — это комплексный навык: он объединяет обоснование литературы, диагностику «узких мест», построение кандидатов на основе паттернов, поиск коллизий, аудит и оформление карточек идей в единый рабочий процесс от исследовательской проблемы до карточки идеи. Таким образом, Paper-Search и Scoop-Check не являются скрытыми деталями реализации; это самостоятельные навыки, которые также предоставляют функции поиска и обзора для повторного использования внутри более крупного цикла генерации идей..
Эмпирическим центром данного отчета является IdeaSpark, поскольку это точка, в которой функции поиска, генерации и рецензирования ResearchStudio-Idea должны работать совместно. Мы изучаем его как индукцию навыков на основе результатов для LLM-исследований в области генерации идей. Объект, который мы индуцируем, — это навык, применяемый во время вывода, а не предиктор принятия, показатель новизны или агент для написания статей. Навык состоит из карточек паттернов генерации идей, промптов для рабочих процессов, схем, механизмов поиска и валидаторов, которые LLM загружает при создании структурированной идеи. Мы обосновываем это результатами публичных ML-конференций, поскольку эти результаты содержат следы исследовательской практики. Устные доклады демонстрируют случаи, которые программные комитеты выделили особо. Статьи с высоким уровнем цитирования показывают, что именно сообщество использовало повторно. Отклоненные заявки показывают, как терпят неудачу схожие попытки. Цель состоит в том, чтобы превратить эти следы в оперативное руководство, оставляя вопросы принятия и исполнения за рамками утверждения..
В этом отчете рассматриваются два вопроса. Во-первых, можно ли на основе результатов конференций составить компактную, но пригодную для использования карту паттернов генерации идей? Во-вторых, можно ли упаковать эту карту в виде набора навыков, не зависящего от конкретной модели, рабочий процесс которого позволяет генерировать и проверять одну исследовательскую идею? Мы отвечаем на первый вопрос посредством анализа 1,947 статей с конференций ICLR, ICML и NeurIPS. Мы отвечаем на второй вопрос, выпуская три навыка ResearchStudio-Idea и оценивая идеи, сгенерированные IdeaSpark, с помощью слепых автоматизированных судей. Оценка ограничена стадией формирования идеи. Она не проверяет успешность реализации, экспертную оценку или отбор программным комитетом..
1.2 Мотивация
Существующие системы решают важные задачи генерации исследовательских идей, однако между данными о результатах и процессом генерации остается пробел в уровне навыков. Сквозные системы автоматизируют длительные исследовательские рабочие процессы [29, 40, 49, 61]. Мультиагентные и поисковые системы исследуют более широкие пространства предложений [60, 17, 53, 38, 4]. Методы с использованием Retrieval-augmented обосновывают гипотезы на основе смежной литературы [23, 14, 56, 8]. Инструменты для оценки новизны, бенчмарки и методы индукции паттернов проверяют пересечения с предшествующими работами или определяют повторяющиеся исследовательские приемы [55, 59, 7, 43, 41, 26, 13, 22, 44]. Эти компоненты дополняют друг друга. Недостаточно проработанным остается вопрос о том, как превратить их в интероперабельные навыки и как преобразовать результаты конференций в исполняемый рабочий процесс генерации идей: многоразовый процедурный объект, который помогает LLM структурировать пробел в знаниях, реализовать исследовательскую стратегию, отличить ее от смежных работ и провести аудит предложения перед его реализацией..
Научные ассистенты становятся все более способными к поиску литературы, синтезу доказательств, генерации идей-кандидатов и итеративному уточнению предложений. Однако переход от найденных доказательств к практически применимым исследовательским возможностям остается слабо структурированным. Исследователям по-прежнему необходимо решать, какие ограничения представляют собой значимые «узкие места», какие возможности остаются нереализованными и какие направления достаточно отличаются от предыдущих работ, чтобы оправдать дальнейшие инвестиции..
Текущие оценки идей, сгенерированных LLM, делают этот разрыв конкретным. Крупное слепое исследование показывает, что идеи в области NLP, сгенерированные LLM, могут оцениваться как более оригинальные, чем идеи экспертов, при этом являясь менее осуществимыми [46]. Последующее исследование реализации сообщает, что разрыв становится более выраженным, как только идеи воплощаются в жизнь [45]. HindSight аналогичным образом обнаруживает, что идеи, оцененные LLM как более оригинальные, с меньшей вероятностью соответствуют реальным будущим работам [19]. Эти результаты не означают, что навык генерации идей может заменить их реализацию. Они показывают, что поверхностная новизна, связность предложений и апостериорная оценка новизны являются слабыми индикаторами полезного процесса генерации идей..
Полезный навык должен, напротив, демонстрировать, как в реальных статьях пробел в знаниях связывается с методом. Он должен показывать, как авторы собирают доказательства дифференциации и как похожие попытки терпят неудачу еще до начала экспериментов. Мы называем эти повторяющиеся процедурные объекты паттернами генерации идей. Паттерн — это не просто ярлык, такой как «декомпозиция задачи» или «добавление обучения с учителем». Он должен определять, к какому типу пробела он применим, как конструируется метод, что отличает его от близких по тематике предыдущих работ, какие доказательства делают его достоверным и где терпят неудачу аналогичные попытки..
Таким образом, недостающее звено представляет собой уровень навыков, основанный на результатах, который связывает научные доказательства, выявленные узкие места, повторно используемые шаблоны генерации идей и перспективные направления исследований. Извлеченные статьи раскрывают наблюдения, ограничения, замечания рецензентов и нерешенные вопросы. Сгенерированные предложения требуют стратегических шагов, которые связывают эти наблюдения с правдоподобными направлениями. Недостающий слой — это механизм, который преобразует доказательства в возможности, а возможности — в проверяемые исследовательские предложения..
Нам необходимо знать, как эти паттерны повторяются в статьях по ML, как они сочетаются внутри вкладов и чем они различаются в принятых, высокоцитируемых и отклоненных работах. Нам также нужно знать, можно ли их операционализировать как повторно используемые навыки на этапе вывода. ResearchStudio-Idea решает эту проблему отсутствующего связующего звена в виде набора инструментов, а IdeaSpark проверяет наиболее сильную версию этого утверждения: можно ли объединить поиск, генерацию на основе паттернов, проверку на коллизии и аудит в единый достоверный рабочий процесс генерации идей, а не просто в очередной общий запрос для мозгового штурма или оценщик новизны. В разделе 2.6 приведено подробное сравнение с современными методами генерации идей..
1.3 Обзор подхода
ResearchStudio-Idea упаковывает ранние стадии генерации идей в три повторно используемых навыка. Paper-Search предоставляет примитив для обоснования на основе литературы. Scoop-Check предоставляет примитив для обзора предшествующего уровня техники на уровне утверждений. IdeaSpark выводит паттерны генерации идей из результатов конференций и упаковывает их в структурированный навык генерации идей полного цикла. Получив исследовательскую проблему и набор доказательств, IdeaSpark выполняет оценку доказательств, диагностику узких мест, поиск паттернов инноваций, построение кандидатов, анализ дифференциации, поиск коллизий и аудит на основе результатов. Результатом является не только кандидатное направление исследования, но и обоснование, исторические прецеденты и диагностические доказательства, необходимые для его оценки. На рисунке 2 обобщен этот поток данных в навык от построения корпуса до использования во время выполнения..
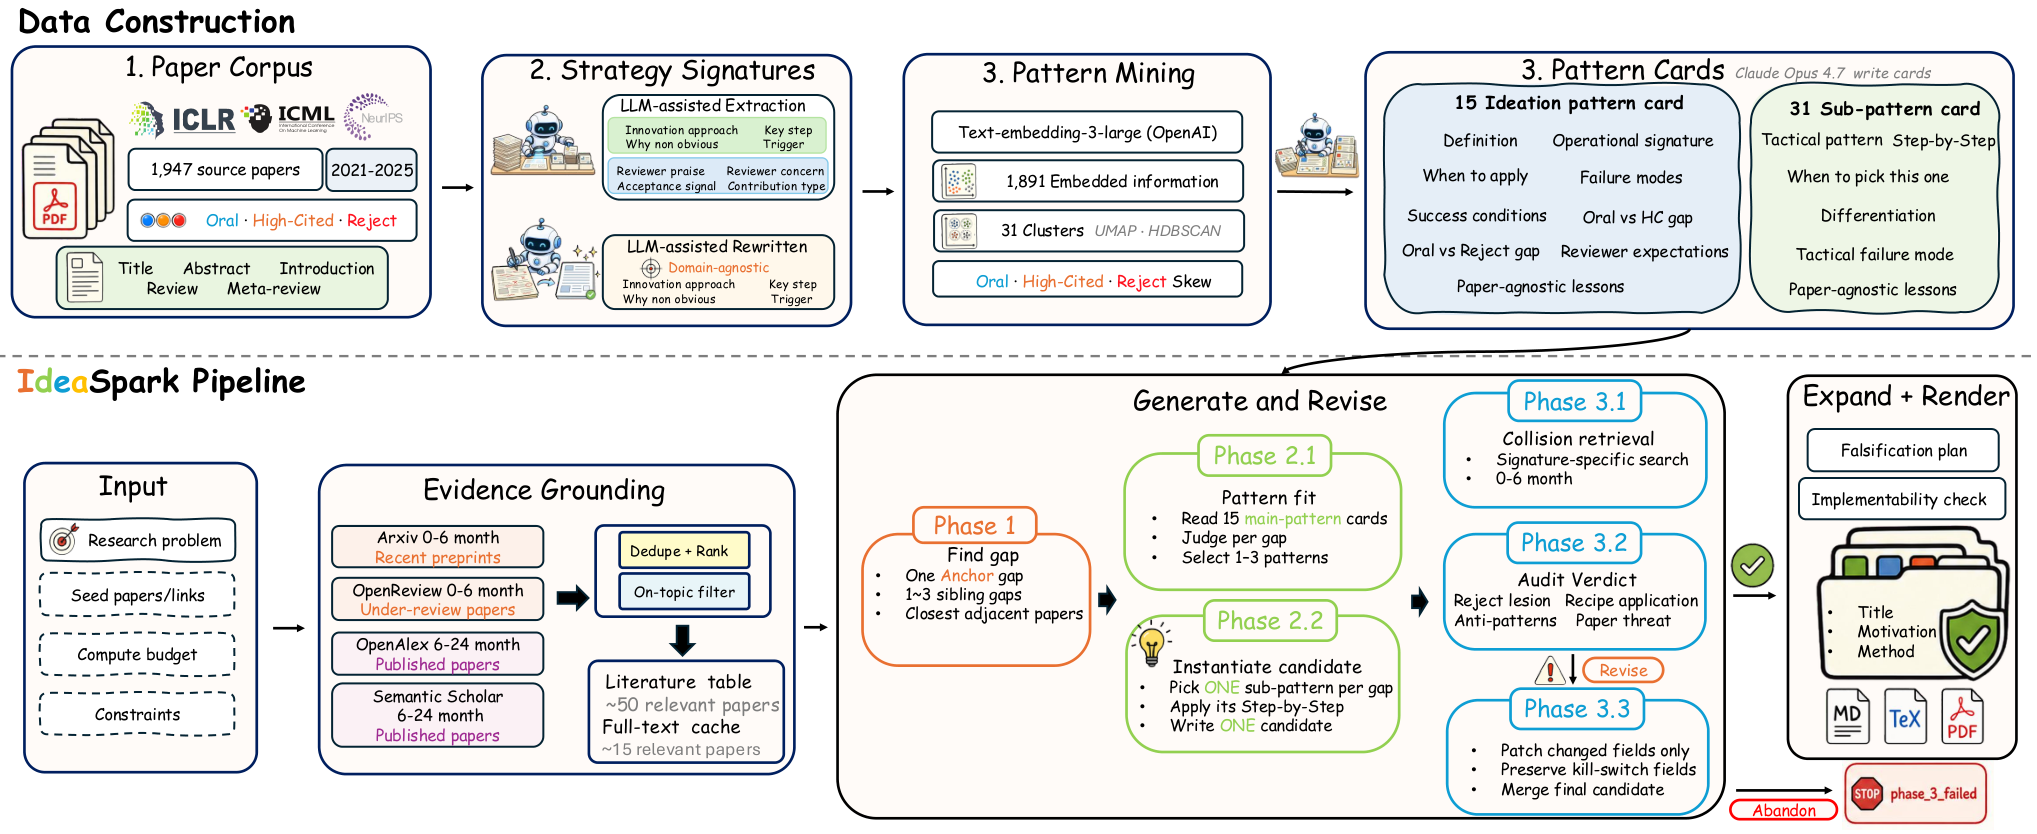
Эмпирический конвейер состоит из четырех этапов. Во-первых, мы собираем статьи с ICLR, ICML и NeurIPS, используя общедоступные метаданные OpenReview и информацию о цитировании из Semantic Scholar [34, 42]. Каждая статья помечается как Oral, High-Cited, Reject или их комбинацией в случае пересечения меток. Во-вторых, мы извлекаем поля инноваций на уровне стратегий и переписываем их в виде описаний, не зависящих от предметной области. Это отделяет методологическую операцию от тематической лексики. В результате кластеризация группирует статьи по исследовательской стратегии, а не по области применения. В-третьих, мы встраиваем и кластеризуем эти сигнатуры стратегий, используя рабочий процесс, вдохновленный представлениями научных документов и обнаружением тем на основе плотности [6, 47, 1, 12, 31, 30, 33]. В-четвертых, мы выводим более высокоуровневые паттерны генерации идей из мелкозернистых кластеров и преобразуем каждый паттерн в операционную карточку..
Полученные карточки не являются метками таксономии. Каждая карточка фиксирует исследовательскую ситуацию, на которую направлен паттерн, структуру, извлеченную из принятых примеров, дифференцирующий механизм по отношению к близким предшествующим работам, ожидания относительно доказательств, делающие утверждение проверяемым, и типы сбоев, абстрагированные из отклоненных заявок. Этот контраст между успехом и неудачей дает понимание, выходящее за рамки индукций, основанных только на принятых работах. В навыке исполнения (runtime skill) карточки выполняют две роли. Они направляют структурированную генерацию идей и предоставляют контрольный справочный материал для проверки того, сохраняет ли кандидат задуманную структуру, избегает ли известных типов сбоев и называет ли правдоподобные угрозы со стороны предшествующего уровня техники. Генерация и аудит используют один и тот же объект, полученный из корпуса, в то время как утверждение статьи остается на стадии идеи..
Слой IdeaSpark следует агностической по отношению к модели двухуровневой архитектуре. Уровень исполнения включает в себя упрощенную спецификацию навыков, фазовые промпты, схемы, хуки поиска и детерминированные валидаторы. Уровень доказательств состоит из 15 карточек паттернов генерации идей, 31 карточки подпаттернов, матрицы доменов по паттернам, записей о насыщении и инвентаря режимов отказа, полученного из корпуса данных. Такое разделение соответствует недавним рекомендациям по созданию навыков: сохранять легковесность уровня исполнения, использовать прогрессивное раскрытие для детализированных доказательств и проверять границы фаз с помощью детерминированных проверок, где это возможно [3, 39, 54, 58]. В результате навык является достоверным по своей структуре, а не по инструкции. Каждое значимое утверждение либо восходит к извлеченной записи, либо явно помечено как предоставленное моделью. Шлюзы поиска и детерминированные валидаторы обеспечивают соблюдение этого контракта, а не полагаются на следование промпту (§13.5).
1.4 Основные эмпирические результаты
В данном отчете представлены пять выводов:
Во-первых, индуцированное пространство паттернов является компактным, но нетривиальным. Из 31 мелкозернистого субпаттерна генерации идей конвейер индуцирует 15 паттернов генерации идей более высокого уровня. Число 15 не является канонической онтологией инноваций в ML. Это операционная гранулярность, полученная в результате текущего конвейера извлечения, абстракции, встраивания, кластеризации и индукции. Поскольку это результат единственного вызова индукции Opus 4.7, исследование стабильности между промптами, начальными значениями и моделями остается задачей на будущее; мы ожидаем, что сопоставимый запуск приведет к 12–18 категориям со значительным перекрытием..
Во-вторых, отклоненные и принятые статьи часто разделяют одно и то же пространство высокоуровневых паттернов. Перекластеризация только отклоненных работ отображает каждый кластер отклоненных статей обратно на существующий словарь из 15 паттернов, без использования категории вне таксономии. Это говорит о том, что отклоненные заявки наиболее полезны в качестве контрастирующих доказательств слабых реализаций, режимов сбоев и граничных случаев, а не как отдельный класс негативных стратегий..
В-третьих, композиция из нескольких паттернов является нормой. Отдельный анализ на уровне статей с использованием мультилейбл-классификации показывает, что в статьях обычно комбинируется несколько паттернов генерации идей, а не выполняется один изолированный ход. В данном корпусе является модальным размером композиции для статей категорий Oral, HC и Reject, с «хвостом» на уровне . Это обосновывает выбор при проектировании навыков: генерировать от одного до трех ролей паттернов вместо выбора одного паттерна в качестве рецепта..
В-четвертых, паттерны генерации идей широко охватывают предметные области, но их эффект зависит от конкретной области. Наиболее крупные паттерны проявляются во многих индуцированных исследовательских доменах, что подтверждает целесообразность использования доменно-независимых карточек паттернов. Однако профили принятия и влияния варьируются в зависимости от ячейки «домен-паттерн». Таким образом, данный навык рассматривает статистику домена как контекст для аудита, а не как детерминированный априорный показатель генерации..
В-пятых, качество конечных идей подтверждается исследованием с использованием автоматизированного судьи, но не экспертной оценкой людей. Оценка конечных результатов автоматизированным судьей (раздел 14) показывает, что IdeaSpark улучшает качество генерируемых идей по сравнению с базовыми моделями без навыков и с общими навыками. Утверждения об уровне принятия все еще требуют проведения слепого исследования с участием людей..
1.5 Вклад
В данном отчете представлены три вклада.
Карта паттернов, основанная на результатах. Мы представляем анализ корпуса из 1 947 статей, охватывающий устные доклады, высокоцитируемые работы и отклоненные статьи с крупнейших конференций по ML. Анализ выявляет 15 паттернов генерации идей, 31 подпаттерн и 28 областей исследований. Затем он измеряет профили принятия на уровне паттернов, цитируемость, доменную принадлежность, конференции, временные характеристики и профили композиции нескольких паттернов..
Контрастные, учитывающие ошибки карточки паттернов. Мы превращаем противопоставление принятых и отклоненных работ в содержание карточек. Каждая карточка объединяет условия успеха, извлеченные из принятых работ, с типами ошибок, извлеченными из отклоненных. Индукция только на основе принятых работ не может предоставить такой объект. Эмпирическим обоснованием служит отображение только отклоненных работ из §10: отклоненные статьи не занимают отдельное пространство стратегий, поэтому их ценность заключается в качестве контрастных доказательств относительно слабых реализаций и граничных случаев..
Набор навыков ResearchStudio-Idea и конечная оценка. Мы упаковываем работу в виде трех повторно используемых навыков: Paper-Search для обоснования литературы, Scoop-Check для проверки на совпадение с предшествующим уровнем техники и IdeaSpark для генерации и аудита идей от начала до конца. Мы также представляем слепую автоматизированную оценку идей, сгенерированных IdeaSpark, по осям качества и новизны..
1.6 Структура отчета
Раздел 2 сопоставляет ResearchStudio-Idea и IdeaSpark с недавними работами в области научных открытий на основе LLM, генерации идей, оценки новизны, бенчмарков и индукции паттернов. Разделы 3–6 описывают набор данных, процедуру извлечения, конвейер кластеризации и индукцию паттернов генерации идей. Разделы 7–9 анализируют профили принятия, структуру предметной области, временные тренды и вариативность на уровне конференций. Раздел 10 валидирует таксономию на отклоненных статьях. Раздел 11 представляет результаты абляционных исследований эмбеддингов и абстракции. Раздел 12 обобщает эмпирические выводы. Раздел 13 определяет среду выполнения IdeaSpark и рабочий процесс аудита в рамках набора инструментов ResearchStudio-Idea, а раздел 14 представляет результаты автоматизированной оценки сгенерированных идей. Раздел 15 консолидирует ограничения и угрозы валидности в отношении корпуса, навыков и оценки. Раздел 16 представляет выпущенные данные, модель и артефакты карт навыков..
2 Связанные работы
Литература 2024–2026 годов по генерации исследовательских идей с помощью LLM быстро расширяется. Мы группируем её по семействам, наиболее релевантным для IdeaSpark, и рассматриваем каждое из них ниже. Чтобы сохранить последовательность сравнения, мы откладываем прямое сопоставление до §2.6.
2.1 Системы «ИИ-ученый» полного цикла
Сквозные системы автоматизируют полный жизненный цикл исследования. AI Scientist [29] составляет черновики, реализует, оценивает и описывает исследовательские идеи в рамках единого цикла, хотя его результаты часто оценивались как инкрементальные. AI-Researcher [49] развивает это направление с помощью структурированных архитектур и разделенных конвейеров обучения для автономных инноваций. Agent Laboratory [40] начинает работу с предоставленной человеком исследовательской идеи и создает отчет об исследовании и код, с вариативным контролем участия человека. Idea2Plan [18] связывает генерацию идей и планирование исследований посредством каркаса в стиле ReAct с использованием инструментов arXiv. Sakana AI Scientist v2 [57] добавляет уточнение на основе эволюционного поиска, в то время как Google AI co-scientist [11] использует мультиагентную архитектуру на базе Gemini для генерации гипотез и предложений. Auto Research [25] охватывает обзор литературы, генерацию идей, паттерны инноваций, экспериментирование, написание статей и опровержения в рамках мультиагентной структуры..
Параллельная критическая литература документирует, почему автономность полного жизненного цикла остается хрупкой. Trehan et al. [51] выделяют шесть повторяющихся режимов сбоев из четырех попыток создания автономных ML-paper: предвзятость по умолчанию при обучении, дрейф реализации под давлением выполнения, деградация контекста на длинных горизонтах, преждевременные заявления об успехе, скудные предметные знания и слабый экспериментальный вкус. Bisht et al. [5] утверждают, что современные агентные ученые еще не созданы для автономности. Они подчеркивают предвзятость при выборе проблемы, отсутствие неявных лабораторных знаний, гомогенизацию результатов из-за оптимизации предпочтений и отсутствие циклов экспериментальной обратной связи. Эта линия критики обосновывает более узкую направленность IdeaSpark: улучшить идею до того, как начнется последующее выполнение..
2.2 Мультиагентное и основанное на поиске генерирование идей
Мультиагентные и поисковые системы более непосредственно фокусируются на этапе генерации идей. VirSci [48] и IRIS [9] моделируют научную командную работу посредством агентов с разделением ролей, таких как генераторы идей, рецензенты и поисковики. Deep Ideation [60] внедряет рабочий процесс исследования-расширения-эволюции в сети научных концепций с использованием критического движка, обученного на реальных отзывах рецензентов. Nova [17] добавляет итеративный цикл планирования и поиска, который извлекает внешние знания для обогащения каждого кандидата и повышения новизны и разнообразия..
Другие системы делают сам поиск основным механизмом генерации идей. FlowPIE [53] представляет генерацию идей как процесс эволюции во время тестирования, управляемый поиском по дереву Монте-Карло с направляющим потоком по научной литературе. Такая архитектура позволяет исследованию и генерации идей адаптироваться совместно, а не выполняться как отдельные этапы. Бенчмарк с несколькими рабочими процессами [38] сравнивает уточнение на основе рефлексии, эволюцию в стиле Sakana, многоагентное рассуждение Google Co-Scientist, рекурсивную декомпозицию GPT Deep Research и мультимодальные рабочие процессы Gemini с длинным контекстом. Он показывает, что рабочие процессы, основанные на декомпозиции и длинном контексте, достигают средней новизны 4,17/5. Alien Science [4] формализует взаимодополняющий разрыв в креативности, когнитивную доступность и обучается выбирать связные, но когнитивно недоступные направления из кластеризованных «атомов идей»..”
2.3 Индукция паттернов на основе результатов конференций
Наиболее близкое к нашему направление исследований выявляет паттерны инноваций на основе статей с ведущих конференций. Liu et al. [26] аннотируют статьи категории Oral в соответствии с заранее определенной таксономией из 12 категорий. MoRI [13] извлекает пары мотивацияпаттерн инновации из статей, принятых на ICLR 2024–2025. Затем система обучает стратегию рассуждения посредством SFT и контролируемого обучения с подкреплением по критериям осуществимости, новизны и эффективности. MotivGraph-SoIQ [22] строит граф знаний о мотивации и объединяет его с сократовским диалогом для генерации идей. Navigating Ideation Space [44] декомпозирует научные идеи на концептуальные представления для позиционирования новых идей..
Параллельная парадигма основывает генерацию идей на графах знаний, извлеченных из крупных корпусов научной литературы. SciMuse [14] строит граф знаний на основе 58 миллионов научных статей. В ходе оценки, проведенной 100 руководителями исследовательских групп, его междисциплинарные пути в графе помогли идеям, сгенерированным ИИ, восприниматься как новые и значимые. Генерация гипотез на основе KG [56] извлекает релевантные подструктуры графа для ограничения вывода гипотез LLM и демонстрирует улучшенную новизну и правдоподобность на биомедицинских бенчмарках. Graphs of Research [8] превращает структуру цитирования в обучающий сигнал. Он извлекает направленный ациклический граф эволюции цитирований для каждой исходной статьи из 2-хопового соседства ссылок и дообучает LLM для генерации идей, которые правдоподобно расширяют его..
2.4 Новизна, оценка и бенчмарки
Отдельное семейство оценивает идеи, а не генерирует их. Первое направление фокусируется на столкновении новизны. NovBench [55] предоставляет крупномасштабный бенчмарк для оценки новизны, включающий 1 684 пары «статья-рецензия» и четырехмерную структуру, охватывающую релевантность, корректность, полноту и ясность. RINoBench [41] дополняет его 1 381 идеей, оцененной экспертами, с фокусом на суждении о новизне. Установлено, что вердикты LLM о новизне могут существенно расходиться с экспертными эталонами, даже когда модель приводит обоснования, подобные человеческим. Мы рассматриваем это как мотивацию для обоснования проверок новизны извлеченными доказательствами, а не мнением модели. OpenNovelty [59] создает прозрачные отчеты о новизне на основе доказательств для более чем 500 заявок на ICLR 2026. GraphMind [7] связывает ключевые элементы статьи с извлеченной литературой для интерактивной оценки новизны. Literature-Grounded Novelty Assessment / Idea Novelty Checker [43] использует RAG с двухэтапным процессом «извлечение-затем-переранжирование» и обоснованиями, опирающимися на литературу. Scideator [36] объединяет аспекты статьи и модули оценки новизны для генерации идей в связке человек-LLM. Augmenting Research Ideation with Data [27] интегрирует метаданные и автоматизированную предварительную валидацию в процесс генерации идей, сообщая о повышении осуществимости и качества в задачах социальных наук..
Вторая строка оценивает качество идей напрямую. Si et al. [46] провели слепое исследование с участием более 100 исследователей в области NLP, показавшее, что идеи, сгенерированные LLM, оцениваются как более оригинальные, но менее осуществимые, чем идеи экспертов. Их последующее исследование реализации [45] сообщает, что идеи ИИ получают значительно более низкие оценки после реализации, чем идеи людей. Таким образом, разрыв является операционным, а не просто стилистическим или связанным с новизной. AI Can Learn Scientific Taste [50] обучает модель вкуса на парах принятых/отклоненных работ. HindSight [19] оценивает идеи, сгенерированные LLM, через влияние будущих цитирований. Learning to Predict Future-Aligned Research Proposals [52] предсказывает, соответствует ли кандидатское предложение будущим направлениям исследований. MIRAI [24] прогнозирует будущее влияние статьи на основе названия и аннотации, а затем использует этот предиктор для направления генерации идей в сторону более значимых направлений..
Третья строка объединяет эти суждения в качестве постоянных эталонных тестов. IdeaBench [15] оценивает генерацию исследовательских идей относительно базовых показателей на основе цитируемых работ. AI Idea Bench 2025 [35] содержит 3495 статей из числа 2% лучших работ ICLR и избранных публикаций CVPR в качестве эталона. ResearchBench [28] декомпозирует научное открытие на поиск вдохновения, составление гипотез и ранжирование гипотез. NewtonBench [62] оценивает открытие научных законов на 324 задачах по физике с контрфактическими сдвигами законов..
2.5 Обзоры и практика проектирования навыков
Два недавних обзора описывают более широкий ландшафт. «От автоматизации к автономии» [61] классифицирует системы через таксономию Инструмент / Аналитик / Ученый. «На пути к научному интеллекту» [37] рассматривает архитектуры, бенчмарки и этические вопросы. С инженерной точки зрения, практики Anthropic по созданию навыков [3] формируют двухуровневый дизайн IdeaSpark: прогрессивное раскрытие, упрощенная спецификация верхнего уровня, детерминированные процедуры для повторяющихся шагов и границы этапов, проверенные по схеме. Подложка для эмбеддингов и кластеризации описана там, где она используется, в §6 и §11.⟧.
2.6 Чем IdeaSpark отличается от современных методов генерации идей
Современные методы генерации идей делятся на три семейства. Сквозные системы «AI scientist» автоматизируют полный жизненный цикл исследования. Системы, основанные на поиске, генерируют множество кандидатов и фильтруют их с помощью обученных сигналов новизны, предпочтений или значимости. Методы индукции паттернов и графов знаний извлекают из принятых статей или обширных графов литературы пригодные для повторного использования структуры. IdeaSpark заимствует компоненты из всех трех семейств: индукцию паттернов, контрастивный подход принятия/отклонения и генерацию, основанную на поиске. Его отличительной особенностью является объединение этих компонентов в одном объекте.
Этим объектом является непараметрическая, индуцированная данными карточка паттернов. Та же самая карточка, которая помогает выбрать ход для узкого места, также используется для аудита сгенерированного кандидата. Это отличается от поиска в пространстве кандидатов и ранжирования идей с помощью обученного сигнала. Это также отличается от подгонки параметрической политики метода мотивации, где генерация и проверка могут стать отдельными процедурами.
Из этой архитектуры вытекают три свойства. Во-первых, карточки формируются на основе трехстороннего контраста Oral / HC / Reject, поэтому они несут явный сигнал об ошибке, которого нет при индукции только на принятых работах и в графах знаний на уровне концептов. Во-вторых, навык останавливается на одной идее, предназначенной для рецензента, а не проходит полный цикл исследования. Этот выбор отражает предпосылку, что качество идеи является первичным узким местом для многих последующих неудач. В-третьих, аудит проверяет кандидата на соответствие полученным из корпуса режимам отказа паттерна, который его породил, вместе с извлеченным уровнем техники. Таким образом, знание, которое генерирует идею, и знание, которое ее проверяет, представляют собой один объект, а не две несвязанные модели. Пробелы на уровне исполнения выявляются, а не маскируются поверхностной новизной..
3 Построение набора данных
3.1 Область применения и маркировка
Мы собираем статьи с конференций ICLR, ICML и NeurIPS за 2021–2025 годы. Сбор данных осуществляется с использованием OpenReview API [34] (v1 для ICLR 2021–2023; v2 для ICLR 2024+, ICML 2023+ и NeurIPS 2023+) и метаданных цитирования Semantic Scholar [42]. ICLR 2020 исключена из этого релиза, поскольку схема данных рецензирования отличается от последующих лет. Для каждой статьи мы сохраняем название, аннотацию, список авторов, идентификатор OpenReview, строку решения, доступные поля рецензий, доступные мета-рецензии и количество цитирований в Semantic Scholar. Поля рецензий включают оценку, уверенность, обоснованность, вклад, резюме, сильные стороны, слабые стороны и вопросы..
Эти три метки операционализируют контраст, лежащий в основе данной работы. Oral отмечает то, что программные комитеты ценят больше всего. High-Cited отмечает то, что сообщество принимает. Reject предоставляет сигнал об ошибке, который не может обеспечить индукция, основанная только на принятых работах. Каждая статья получает одну или несколько меток, и метки могут перекрываться. В этом корпусе 49 статей одновременно являются Oral и High-Cited.
Устные доклады (1,014 статей): статьи, для которых принято решение об устном докладе, что свидетельствует о предпочтении программного комитета.
Высокоцитируемые (HC) (260 статей, ): 30 наиболее цитируемых статей по каждому месту проведения и году согласно количеству цитирований в Semantic Scholar, что отражает признание сообществом. Для 2025 года мы используем 10 наиболее цитируемых статей, поскольку количество цитирований все еще накапливается. Пул высокоцитируемых работ пересекается с Oral: , OralHC=49 и . Мы используем для охвата меток цитирования и , когда для анализа требуются взаимно исключающие классы Oral, HC и Reject..
Отклонено (722 статьи): статьи с явным решением об отклонении и нетривиальным набором рецензий, представляющие собой конкретный сигнал о неудаче.
Таблица 1 показывает распределение по конференциям и годам. Количество по каждой конференции отражает два независимых фактора.
Во-первых, открытость площадок: ICLR является платформой, работающей на базе OpenReview, и публикует как принятые, так и отклоненные решения с полными ветками рецензирования. Поэтому пул отклоненных работ там наиболее обширен. ICML и NeurIPS раскрывают решения на OpenReview только начиная с 2023 года. В частности, на ICML 2023–2024 было опубликовано очень мало отклоненных заявок, именно поэтому в столбце «Отклонено» для этих строк указаны значения 0–3..
Во-вторых, доступность для обзора: даже когда решение опубликовано, мета-обзор и комментарии рецензентов могут быть скрыты или отформатированы таким образом, что автоматический парсинг не удается. Именно поэтому охват метаданных (Раздел 3.2) показывает только 340 из 1 947 статей, содержащих мета-обзор, несмотря на то, что для всех 1 947 статей имеются решения..
Наконец, NeurIPS 2025 не содержит статей по HC. Поскольку это самое недавнее мероприятие (декабрь 2025 года), количество цитирований на момент сбора данных не накопилось в достаточном объеме, чтобы даже отсечка по топ-10 имела смысл. Эти асимметрии не влияют на этап кластеризации, но мы учитываем их при количественном анализе (Раздел 7).
| Venue | Year | Oral | OralHC | Reject | |
|---|---|---|---|---|---|
| ICLR | 2021 | 52 | 30 | 5 | 0 |
| ICLR | 2022 | 49 | 30 | 5 | 0 |
| ICLR | 2023 | 85 | 30 | 6 | 143 |
| ICLR | 2024 | 63 | 30 | 1 | 138 |
| ICLR | 2025 | 186 | 10 | 4 | 128 |
| ICML | 2023 | 147 | 30 | 9 | 3 |
| ICML | 2024 | 135 | 30 | 9 | 0 |
| ICML | 2025 | 99 | 10 | 3 | 65 |
| NeurIPS | 2023 | 69 | 30 | 4 | 94 |
| NeurIPS | 2024 | 60 | 30 | 3 | 101 |
| NeurIPS | 2025 | 69 | 0 | 0 | 50 |
| Total | 1,014 | 260 | 49 | 722 |
3.2 Покрытие метаданных
После объединения и удаления дубликатов по идентификатору подачи OpenReview осталось 1 947 уникальных статей. Все 1 947 содержат восемь базовых полей. Четыре абстрагированных поля (раздел 4) заполнены непустым содержимым для 1 891 статьи. Оставшиеся 56 статей исключены из пула эмбеддингов (§5⟧).
Охват исходных объединенных метаданных варьируется в зависимости от области. В общей сложности 1 074 статьи содержат полные аннотации, 716 — проанализированные рецензии, 682 — извлеченные введения и 340 — мета-рецензии. Для генерации карточек мы проводим отдельный проход по восстановлению рецензий из публичных веток OpenReview. Полученный охват доказательств рецензирования на уровне карточек представлен в §12. Статьи без возможности восстановления текста рецензии по-прежнему включаются в извлечение сигнатур. Однако их поля, производные от рецензий, рассматриваются как вспомогательные поля с низким уровнем доказательности, а не как доказательства, обоснованные текстом рецензента..
3.3 Соглашение о ссылках на статьи внутри текста
На протяжении всей этой статьи мы ссылаемся на статьи из корпуса по внутреннему идентификатору вида <VENUE>_<YEAR>_<NNNN>. Примеры включают ICLR_2022_0094 и NeurIPS_2023_0753. Каждый идентификатор однозначно соотносится с представленной на OpenReview работой через поле openreview_id в data/dataset/all_records_full.json. После обращения к набору данных статью можно найти по адресу https://openreview.net/forum?id=<openreview_id>>.
Из 1 947 статей корпуса примерно 1 088 упоминаются в данном отчете хотя бы один раз. Обычно они фигурируют в качестве доказательств в списках условий успеха или режимов отказа карточек методологий. Мы не включаем все статьи корпуса в библиографические записи. Полная библиография корпуса затруднила бы восприятие ссылок на вторичные работы, которые составляют раздел 2. Таким образом, подготовленный набор данных является авторитетным слоем библиографического разрешения для любого paper_id, встречающегося в этом отчете..
Когда конкретная статья из корпуса обсуждается по существу в основном тексте, мы предоставляем соответствующую библиографическую запись. Примеры включают статью о diffusion-ELBO [20] = NeurIPS_2023_0753, LP-FT [21] = ICLR_2022_0094, статью о DP continual-observation [16] = ICML_2023_0551, EigenGame [10] = ICLR_2021_0018 и SAM-as-Bayes [32] = ICLR_2023_0331.
4 Двухэтапное извлечение сигнатур инноваций
Чтобы преобразовать каждую статью в форму, подходящую для кластеризации на уровне стратегий, мы извлекаем инновационную сигнатуру из двенадцати полей. Восемь базовых полей описывают статью в ее собственных терминах. Четыре поля описывают механизм инновации, а четыре фиксируют сигналы рецензирования и результатов. На втором этапе четыре поля механизма переписываются в форму, не зависящую от предметной области. Для кластеризации встраиваются только эти четыре переписанных поля. Восемь базовых полей сохраняются для извлечения и последующего подтверждения данными..
4.1 Этап 1: Восемь базовых полей
Для этапа 1 мы подаем Claude Sonnet 4.6 [2] название статьи, доступную аннотацию, доступное введение, доступные рецензии и доступный мета-обзор. Введения извлекаются из PDF, если их удается восстановить. Затем модель возвращает следующие структурированные поля:
- ⟦1. innovation_approach: одно предложение, описывающее, каким образом данная статья вводит инновации в качестве стратегии рассуждения.
- ⟦2. ключевой_этап: единственный наиболее важный этап рассуждения от постановки диагноза до нахождения решения.
- ⟦3. why_non_obvious: когнитивный барьер, который мешал другим прийти к этому подходу.
- ⟦4. trigger_condition: предметно-независимая ситуация, в которой применима данная стратегия, сформулированная как «Когда X, примените Y для достижения Z.”
- ⟦5. reviewer_praise: три конкретных пункта, которые рецензенты оценили положительно.
- ⟦6. reviewer_concern: три конкретных замечания рецензента.
- ⟦7. сигнал_принятия: одно предложение, объясняющее, почему статья была выбрана для устного доклада / процитирована / отклонена.
- ⟦8. тип_вклада: один из {theoretical, methodological, empirical, benchmark, system}}.
Первые четыре поля являются наиболее значимыми с точки зрения стратегии, поэтому на этапе ⟦BROKEN_K2⟧ переписываются только они. Последние четыре поля предоставляют доказательства обзора и результатов, используемые позже при создании карточек. Извлечение выполняется в соответствии со схемой JSON, которая обеспечивает наличие непустых списков длиной 3 для двух полей, полученных в результате обзора. Все 1,947 статей проходят этап ⟦BROKEN_K1⟧ извлечения..
4.2 Этап 2: Четыре доменно-независимых переписывания
Прямое встраивание описаний статей имеет тенденцию цепляться за предметные существительные, такие как “Transformer”, “diffusion”, “image” или “molecule”. Это создает тематические кластеры вместо кластеров стратегий. Мы устраняем этот режим сбоя с помощью второго прохода Claude Sonnet 4.6. Он переписывает первые четыре базовых поля в эквиваленты, содержащие только стратегии. Промпт предписывает модели заменить предметные существительные общими плейсхолдерами ⟦BROKEN_K0⟧, ⟦BROKEN_K1⟧, использовать повелительное наклонение (“Audit …”, “Transfer …”, “Design …”), сохранить механизм и отбросить детали применения. Полученные четыре поля представляют собой:
- ⟦1. абстрактная_стратегия инновационный_подход
- ⟦2. abstract_key_step ключевой_этап
- ⟦3. аннотация_почему_неочевидно почему_неочевидно
- ⟦4. условие_триггера_аннотации условие_триггера
Показательный контраст иллюстрирует этот сдвиг. Для статьи High Fidelity Speech Synthesis with Adversarial Networks, innovation_approach гласит: «Они решили проблему переноса домена, позаимствовав стратегию многомасштабного дискриминатора PatchGAN из image GANs и повторно применив её в нескольких временных окнах в аудио, добавив сигналы обусловливания для устранения разрыва в точности воспроизведения». Соответствующий abstract_strategy гласит: «Перенести стратегию многомасштабного дискриминирования из одной модальности данных в другую путем её повторного применения с соответствующей гранулярностью, специфичной для домена, а затем добавить сигналы обусловливания для устранения оставшегося разрыва в точности воспроизведения». Обобщенная версия — это то, что мы подаем в модель эмбеддингов..
Вклад этого этапа абстрагирования в кластеризацию на уровне стратегий количественно оценивается в абляции §11. Все четыре абстрактных поля возвращаются для полного корпуса. Из 1 947 статей содержат непустой контент во всех четырех полях. Оставшиеся имеют как минимум одно пустое поле и исключаются из пула эмбеддингов в §5.⟧.
5 Неконтролируемое обнаружение паттернов
5.1 Векторное представление
Для каждой статьи мы объединяем четыре абстрагированных поля стратегии: abstract_strategy, abstract_key_step, abstract_why_non_obvious и abstract_trigger_condition. Каждое поле имеет префикс вида field: content. Средняя длина объединенного текста составляет 1 185 символов. После перезаписи на этапе 2 в §4 1 891 из 1 947 статей содержат все четыре поля. Мы векторизуем эти записи с помощью OpenAI text-embedding-3-large (3 072 измерения) и выполняем L2-нормализацию векторов..
5.2 Кластеризация
UMAP [31] сокращает 3072-мерное косинусно-нормализованное пространство до 10 измерений. Мы используем , и seed 42. Затем HDBSCAN [30] кластеризует сокращенное пространство с помощью и cluster_selection_method=eom. Мы проводим перебор ; в таблице 2 представлены полные результаты перебора.
| % unclustered | silhouette | |||
|---|---|---|---|---|
| 10 | 31 | 902 | 47.7 | 0.584 |
| 15 | 19 | 751 | 39.7 | 0.527 |
| 20 | 16 | 879 | 46.5 | 0.566 |
| 25 | 12 | 923 | 48.8 | 0.561 |
| 30 | 8 | 853 | 45.1 | 0.505 |
| 40 | 6 | 849 | 44.9 | 0.474 |
Мы выбираем . Данная настройка определяет 31 подшаблон генерации идей и дает наиболее выраженный силуэт в ходе анализа (, вычисленный по кластеризованным точкам). Компромиссом является то, что статей остаются некластеризованными. Укрупнение не позволяет охватить эту долю; она остается в диапазоне – на протяжении всего анализа. Таким образом, некластеризованные точки находятся далеко от всех пиков плотности и не являются артефактами мелкой гранулярности..
Что на самом деле означает «некластеризованный» (и почему мы не называем это «шумом»)”).
HDBSCAN обычно помечает точки вне любого пика плотности как «шум». Мы вместо этого используем термин «некластеризованные», поскольку данная метка является геометрической, а не содержательной. Она указывает на положение статьи в пространстве эмбеддингов; это не означает, что стратегия является слабой, идиосинкразической или выходящей за рамки структуры..
Отмеченные не являются пустыми по стратегии. Все встроенные статьи содержат полный контент в четырех полях abstract_*, а некластеризованные и кластеризованные группы имеют сопоставимые медианные длины. Метка отражает геометрию вложений при выбранном пороге mcs. Статья попадает в категорию «некластеризованных», когда ее вложение стратегии оказывается между двумя или тремя модальными кластерами, часто из-за того, что она реализует несколько паттернов генерации идей примерно в равной степени. Короче говоря, «некластеризованный» означает нахождение между модальными кластерами, а не вне пространства стратегий. Структура из 15 паттернов работает на уровне статьи посредством независимой мультиметочной маркировки (§6.5), поэтому она в равной степени охватывает как некластеризованные, так и кластеризованные статьи..
5.3 Инвентаризация кластера
Размеры кластеров (за исключением некластеризованных) варьируются от 13 (минимальный допустимый размер) до 86, со средним значением 31,9 и медианой 22. Пять крупнейших кластеров — это:
- ⟦• C02 (): Контролируемое построение диагностики с использованием элементов, изолирующих одну переменную, в рамках проектирования диагностики, изолирующей искажающие факторы.
- ⟦• C18 (): Адаптация субстрата для различных модальностей в рамках зрелого рецепта, в разделе «Унификация гетерогенных входных данных в едином пространстве».
- ⟦• C06 (): Вероятностно-объективная унификация через доказательство эквивалентности в рамках раздела «Доказать эквивалентность для унификации».
- ⟦• C14 (): Замена оператора внимания «все пары», в рамках подраздела «Замена оператора или представления».
- ⟦• C05 (): Теорема об идентифицируемости, основанная на ограничивающем допущении, в рамках аудита и поворота допущения.
Каждый кластер автоматически маркируется проходом Opus 4.7. Этот проход считывает восемь репрезентативных статей, ближайших к центроиду кластера, и создает метку из 2–6 слов плюс описание из одного предложения. Затем второй проход Opus 4.7 создает карточку дезамбигуации уровня 2 для каждого кластера. Полученные паттерны тактического уровня используются в §6.3. Каждая карточка дезамбигуации имеет шесть панелей:
- ⟦1. tactical_pattern: конкретный шаг рассуждения кластера на уровне детализации ниже паттерна генерации идей уровня 1.
- ⟦2. Пошаговое руководство: 5-этапный рецепт абстрактной структурной последовательности, полученный из принятых примеров кластера, со встроенными границами, основанными на отклоненных вариантах.
- ⟦3. differentiation_within_parent: что отличает этот кластер от его дочерних элементов одного уровня в рамках общего родительского узла.
- ⟦4. когда_выбирать_этот_вариант: ситуативные триггерные условия, при которых данный подшаблон является правильным выбором.
- ⟦5. tactical_failure_mode: специфическая для кластера форма сбоя, которая повторяется в его статьях со статусом Reject.
- ⟦6. Примеры: набор уроков по принятию и отклонению статей, не привязанных к конкретным работам. Ссылки на отдельные статьи не используются. Уроки представляют собой абстрактные выжимки из моделей успеха и неудач кластера, чтобы генерация на этапе 2.2 применяла абстрактный паттерн к новому пробелу, а не имитировала конкретные статьи..
Мы используем инвентарь из 31 кластера в качестве исходного материала для индукции паттернов генерации идей в следующем разделе.
5.4 Состав приемки по кластерам
Хотя эмбеддинг перемежает статьи категорий Oral, HC и Reject во всех кластерах (рис. 4b), пропорции на уровне кластеров неоднородны. На рисунке 3 показан состав каждого кластера по категориям Oral / HC / Reject, отсортированный по доле Oral. Шесть кластеров преодолевают порог Oral-safe ( из , ). Один кластер пересекает порог Reject-warn ( из , ). Каждый кластер ниже записан как количество Oral/HC/Reject и доля Oral среди . Маркировка носит информационный характер. Она предоставляется людям, читающим артефакты, и аудиторскому уровню, но никогда не используется для предварительной фильтрации поиска или генерации.:
- ⟦• Безопасные для устного представления: 6 кластеров. Эти тактики при надлежащем исполнении попадают в верхнюю часть распределения принятия. Пять наиболее выраженных по доле устного представления среди — это C21 Последовательное переформулирование управления в рамках переосмысления как решаемого объекта (13/0/3, 81%), C09 Замена оператора с низкой чувствительностью в рамках замены оператора или представления (17/0/4, 81%), C16 Построение группы симметрии в рамках кодирования структуры через построение (19/3/7, 73%), C27 Переформулирование трудноразрешимой задачи в рамках переосмысления как решаемого объекта (12/0/5, 71%) и C30 Замена объекта кривизны в рамках замены оператора или представления (14/1/6, 70%)%).
- ⟦• Reject-warn: 1 кластер. C13 Relational-Topology Encoded as Structure under Encode Structure by Construction (4/1/12, 25%) — единственный кластер, доля отклонений в котором превышает порог . Рецензенты последовательно отмечают, что в статьях этого кластера предлагается архитектура с топологией в качестве априорного знания без эмпирической демонстрации того, что эта топология выполняет работу, которую нельзя было бы выполнить с помощью стандартных альтернатив..
- ⟦• Смешанные: оставшиеся 24 кластера. Эти тактики дают как Oral, так и Reject статьи в сопоставимых долях. Они составляют основную часть рабочего пространства, а принятие зависит от условий успеха и режимов отказа для каждой отдельной статьи, охарактеризованных в методологических картах (Раздел 6.1⟧).
Метки для каждого кластера и полные подсчеты находятся в clustering/extra/cluster_composition.csv.
Эти флаги являются сигналами риска, а не метками рекомендаций.
Статус Oral-safe не означает «предпочтительный»; Reject-warn не означает «запрещенный». Это описательные статистические показатели риска с ограниченным размером выборки. Они также чувствительны к году, конференции и насыщенности темы. Отклоненные статьи из кластера Reject-warn могли получить отказ из-за исполнения, а не из-за выбора тактики. Поэтому мы предоставляем эти флаги исследователям артефактов и аудиторскому уровню в качестве информационных сигналов риска. Мы не ограничиваем на их основе поиск, генерацию или рекомендации. Пользователь, чья задача действительно соответствует тактике кластера Reject-warn, может продолжить работу, но карточка подшаблона информирует его о задокументированных видах сбоев..
6 Индукция паттернов генерации идей
Детализированные подшаблоны генерации идей отвечают на вопрос «какой конкретный шаг предприняла эта статья?». Они не отвечают на более общий вопрос: «что это за тип шага?». Чтобы вывести этот уровень, мы просим Claude Opus 4.7 создать таксономию шаблонов генерации идей 1-го уровня на основе 31 кластера. Промпт накладывает четыре ограничения. Таксономия должна содержать от 6 до 18 записей. Каждая запись должна описывать стратегию рассуждения, пригодную для повторного использования, а не предметную область или место публикации. Каждая запись должна включать определение, операционную сигнатуру и пункт о том, когда ее следует применять. Наконец, каждый кластер должен быть соотнесен с одним основным шаблоном генерации идей с возможностью указания вторичного шаблона..
Opus возвращает таксономию из 15 паттернов генерации идей (Таблица 3) и отображение 31 кластера в рамках одного структурированного вызова. Мы не вносим никаких правок ни в то, ни в другое. 15 паттернов генерации идей — это:
| Ideation pattern (id) | Oral | HC | Reject | ||
|---|---|---|---|---|---|
| Audit and Pivot an Assumption (assumption_audit_and_pivot) | 6 | 94 | 11 | 79 | 181 |
| Substitute the Operator or Representation (architectural_operator_substitution) | 4 | 57 | 21 | 39 | 109 |
| Liberate a Fixed Generative Component (generative_process_redesign) | 3 | 46 | 22 | 30 | 94 |
| Design a Confound-Isolating Diagnostic (controlled_diagnostic_design) | 1 | 41 | 24 | 25 | 86 |
| Unify Heterogeneous Inputs into One Space (unify_into_shared_representation) | 1 | 30 | 30 | 28 | 82 |
| Reframe as a Solvable Object (reframe_as_solvable_object) | 3 | 48 | 5 | 26 | 79 |
| Manufacture the Supervisory Signal (self_supervised_signal_engineering) | 3 | 26 | 17 | 24 | 66 |
| Encode Structure by Construction (structural_prior_encoding) | 3 | 30 | 9 | 23 | 61 |
| Prove Equivalence to Unify (algebraic_equivalence_unification) | 1 | 30 | 2 | 27 | 59 |
| Decompose for Differentiated Treatment (heterogeneous_decomposition) | 1 | 15 | 14 | 22 | 47 |
| Decompose and Delegate to Solvers (decompose_and_delegate) | 1 | 19 | 12 | 12 | 42 |
| Relax Discrete Search to Continuous (relax_discrete_search_to_continuous) | 1 | 20 | 1 | 14 | 35 |
| Adapt by Conditioning, Not Retraining (adapt_via_conditioning) | 1 | 10 | 2 | 6 | 18 |
| Characterize a Limit, Then Surpass It (characterize_limit_then_surpass) | 1 | 9 | 0 | 6 | 15 |
| Design a Property-Targeting Pretext Objective (targeted_self_supervised_objective) | 1 | 7 | 2 | 6 | 15 |
| No cluster primary (HDBSCAN-unclustered) | 532 | 88 | 355 | 902 |
Каждый шаблон генерации идей специфицирован на уровне, необходимом для использования в навыке, с полным определением, операционной сигнатурой и пунктом о том, когда применять, приведенными в карточке для каждого шаблона..
Взаимоисключающие операторы.
15 паттернов генерации идей не являются взаимоисключающими категориями. Некоторые пары естественным образом перекрываются. «Аудит и пересмотр предположения» (Audit and Pivot an Assumption) может пересекаться с «Доказательством эквивалентности для унификации» (Prove Equivalence to Unify), поскольку доказательство эквивалентности часто ослабляет несущее предположение. «Замена оператора или представления» (Substitute the Operator or Representation) может пересекаться с «Кодированием структуры через построение» (Encode Structure by Construction), так как структурированный оператор одновременно выполняет замену и кодирование. «Создание контролирующего сигнала» (Manufacture the Supervisory Signal) может пересекаться с «Разработкой целевой задачи для предобучения» (Design a Property-Targeting Pretext Objective), поскольку последняя является структурированной формой первой..
Отображение на уровне кластеров навязывает один основной паттерн на кластер для организации. Сами статьи часто выполняют несколько операторов в композиции, и многометочная разметка на уровне статей в §6.5 подтверждает это эмпирически. Таким образом, правильное прочтение является композиционным: 15 паттернов представляют собой операторы генерации идей, а статья представляется как композиция операторов, а не как объект, отнесенный к одному исключительному классу..
Заметка о паттернах генерации идей на малых выборках.
Три паттерна генерации идей имеют небольшие популяции первичных публикаций при наследовании на уровне кластеров: Adapt by Conditioning, Not Retraining (), Characterize a Limit, Then Surpass It () и Design a Property-Targeting Pretext Objective (). Они являются валидными операторами, поскольку лежащие в их основе кластеры статистически различимы в пространстве эмбеддингов. Они также являются операторами с низкой поддержкой: их статистика принятия по паттернам опирается на скудные доказательства и не должна использоваться в качестве сильных априорных рекомендаций. Соответствующие аналитические карточки поэтому содержат внутренний флаг уверенности: low.
Карточки подсказок во время выполнения не предоставляют модели необработанные счетчики или флаги достоверности, поскольку в ранних версиях это приводило к гомогенизации смещения распределения в сторону паттернов с высоким . Паттерны с низкой поддержкой остаются доступными, когда задача пользователя действительно им соответствует. Они не получают преимуществ и не понижаются в приоритете на этапе выбора навыка. Флаг со стороны корпуса сохранен здесь для аналитической прозрачности..
Псевдонимы на общедоступном языке.
Названия паттернов генерации идей используют компактную техническую формулировку для аналитической точности: например, «Проверка и изменение предположения» и «Замена оператора или представления». Каждый паттерн также имеет псевдоним на простом языке для вывода навыков, ориентированных на пользователя. Это делает структуру понятной для неспециалистов. Примеры включают «Проверка и изменение предположения» «Проверить несущее предположение и изменить его», «Переформулирование в решаемый объект» «Переформулировать нерешенное в решаемый объект» и «Замена оператора или представления» «Заменить оператор или представление”.
6.1 От определения к операционной карточке
Определение и операционная сигнатура сообщают исследователю, что представляет собой паттерн генерации идей. Они не объясняют, когда он оказывается успешным, а когда терпит неудачу. Чтобы зафиксировать это различие, мы проводим второй проход Opus 4.7 для каждого паттерна генерации идей. Входные данные включают все статьи категорий Oral, HC и Reject, отнесенные к данному паттерну, их четыре абстрагированных поля, а также доступные данные рецензий и мета-рецензий. Данные рецензий восстановлены для 83% корпуса в целом; подробности приведены в §12. Проход возвращает структурированную карточку с семью панелями:
- ⟦1. условия_успеха: перекрестные устные паттерны того, что заставляет паттерн работать.
- ⟦2. режимы_отказов: паттерны перекрестного отклонения того, как это терпит неудачу.
- ⟦3. oral_reject_gap: прозаический контраст между двумя группами.
- ⟦4. oral_hc_gap: прозаический контраст между исполнением, предпочтительным для PC, и исполнением, предпочтительным для сообщества.
- ⟦5. ожидания_рецензентов: маркированные списки, помеченные по источнику ([oral_reviews], [reject_reviews], [both]).
- ⟦6. когнитивные барьеры: «слепые зоны» на уровне предметной области, которые делают закономерность неочевидной.
- ⟦7. representative_examples: 6–8 примеров, основанных на научных статьях (устные доклады и отклоненные работы), каждый с кратким выводом в одну строку.
Поля, содержащие доказательства, должны ссылаться на идентификаторы статей. Это правило применяется к success_conditions, failure_modes, oral_reject_gap, oral_hc_gap, reviewer_expectations и representative_examples. Модели также дано указание устанавливать confidence=low, когда размеры выборки или охват рецензий опускаются ниже пороговых значений, и отказываться от сопоставления Oral-vs-HC, когда .
15 полученных карточек являются операционным субстратом навыка. Определения, операционные сигнатуры и условия применения поддерживают соответствие паттернам на Фазе 2.1. Тактические рецепты подпаттернов поддерживают инстанцирование на Фазе 2.2. Режимы отказов, разрывы между Oral-vs-Reject, репрезентативные примеры и ожидания рецензентов поддерживают аудит на Фазе 3 и объяснение на Фазе 4. Они не используются в качестве априорных вероятностей уровня принятия или сигналов ранжирования..
Панель примеров на карточках отображает не зависящие от конкретной статьи уроки по принятию и отклонению: тезисы, извлеченные из пула принятых работ, без цитирования отдельных статей. Такой дизайн позволяет сосредоточить Фазу D на применении абстрактного паттерна к новому пробелу в знаниях, а не на копировании какой-либо одной статьи из корпуса. Приложение ⟦BROKEN_K1⟧ воспроизводит карточку «Аудит и пересмотр предположения» — в паре с одной из карточек подпаттернов — в качестве примера с высоким охватом перехода от корпуса к карточке..
6.2 Охват и гранулярность
15 паттернов генерации идей имеют два показателя охвата, и мы приводим оба, поскольку они отвечают на разные вопросы:
- ⟦• Покрытие на уровне кластеров: 989 из 989 кластеризованных статей ( из кластеризованных; из пула эмбеддингов в 1891 статью) получают первичный паттерн генерации идей путем наследования от своего подпаттерна генерации идей. Каждый кластер сопоставляется ровно с одним из 15 первичных паттернов; остаточных элементов вне таксономии нет..
- ⟦• Покрытие мультилейблов на уровне статей: независимый проход мультилейбловой разметки (§6.5) присваивает одну или несколько меток паттернов генерации идей всем статьям, включая те, что не вошли в кластеры HDBSCAN. Таким образом, система из 15 паттернов генерации идей полностью охватывает корпус на уровне статей, несмотря на то, что только статей могут быть классифицированы посредством наследования на уровне кластеров..
Распределение имеет «длинный хвост». По первичному количеству на уровне кластеров три главных паттерна генерации идей составляют 384 статьи: Audit and Pivot an Assumption (), Substitute the Operator or Representation () и Liberate a Fixed Generative Component (). Три наименее представленных составляют 48 статей: Adapt by Conditioning (), Characterize a Limit () и Design a Property-Targeting Pretext Objective (). Это сигнатура «длинного хвоста» индуктивно выведенной таксономии. Многие инновации используют небольшое число глубоко проработанных стратегий; меньший хвост использует редкие, но все еще логически последовательные операторы..
На рисунке 5 визуализирована иерархия с тремя концентрическими кольцами. Внутреннее кольцо показывает 15 паттернов генерации идей, размер которых зависит от количества статей. Среднее кольцо подразделяет каждый паттерн на составляющие его подкластеры, всего 31, окрашенные в цвет родительского паттерна. Внешняя полоса кодирует уровень принятия Oral для каждого паттерна по шкале от светло-серого до темно-серого . Далее следуют два эмпирических наблюдения.
(i) Фрагментация методологии неравномерна по паттернам, однако таксономия не является чрезмерно детализированной. Audit and Pivot an Assumption распадается на 6 подкластеров. Substitute the Operator or Representation распадается на 4. Reframe as a Solvable Object, Manufacture the Supervisory Signal, Encode Structure by Construction и Liberate a Fixed Generative Component распадаются на 3 каждый. Оставшиеся 9 паттернов являются однокластерными, что указывает на тактически согласованные действия, которые абстракция не разделяет далее. 6-кластерная декомпозиция в рамках Audit and Pivot отражает существенно различающиеся действия по аудиту и пересмотру, такие как пересмотры на основе теорем идентифицируемости, пересмотры дистрибутивных допущений и пересмотры границ достаточности..
(ii) Размеры кластеров являются компактными и хорошо обоснованными. Размеры кластеров варьируются от 13 до 86 (среднее значение 31,9, медиана 22). Из 31 кластера только 2 являются небольшими (); соответствующие тактические карточки автоматически помечаются как confidence: low. Компактное распределение размеров соответствует высокому значению silhouette ().
6.3 Многостратегические назначения
В этом подразделе представлен обзор композиции мультистратегий на уровне кластеров. Этот обзор намеренно ограничен: отображение на уровне кластеров ограничивает каждую статью первичной + вторичной стратегиями. Более глубокий многометочный обзор на уровне статей в §6.5 восстанавливает истинную модальную композицию, включая 902 статьи, не вошедшие в кластеры HDBSCAN, которые были исключены здесь. Его следует рассматривать как авторитетный анализ композиции..
Охват вторичного слота на уровне статей. Назначение на уровне кластеров (первичный, вторичный) распространяется на статьи. Из 989 кластеризованных статей () имеют как первичный, так и нетривиальный вторичный слот, в то время как () имеют только первичный. статей, не вошедших в кластеры HDBSCAN, исключаются из этой статистики на уровне кластеров и назначаются позже посредством мультиметочной классификации в §6.5. Таким образом, многостратегическое назначение является нормой среди когерентно кластеризованных статей..
Стоит отметить два сигнала на уровне кластеров, поскольку оба они выходят за рамки ранжирования на уровне статей с Oral-обогащением в §6.5 (Таблица 6). Во-первых, наиболее четкой комбинацией, обогащенной отклоненными работами, является замена архитектурного оператора гетерогенная декомпозиция ( п.п. от базовой линии ), за которой следует унификация алгебраической эквивалентности замена оператора ( п.п.). Вероятный режим отказа заключается в накопленных неразрешенных компромиссах: более выразительный оператор должен поглощать гетерогенность множественных популяций, поэтому рецензенты воспринимают оператор как архитектуру, а не как контролируемое индуктивное смещение. Во-вторых, сама композиция коррелирует с принятием. Статьи с парными достигают (), что по сути является базовой линией . Статьи с одиночным паттерном достигают только (, п.п.). Кластер с одним первичным признаком, как правило, является отдельным тактическим ходом, сигнал принятия которого слабее, чем у намеренно составленной пары..
6.4 Смежность паттернов генерации идей в пространстве эмбеддингов
Почему определенные пары паттернов генерации идей сочетаются часто? Эмбеддинг OpenAI text-embedding-3-large дает прямое геометрическое измерение. Каждый паттерн генерации идей имеет центроид, вычисленный как среднее значение нормализованных эмбеддингов его статей. Попарный косинус центроидов затем количественно определяет, насколько близки два паттерна в пространстве стратегий. На рисунке 6 показана полная матрица , а в таблице 4 приведен ближайший сосед для каждого паттерна..
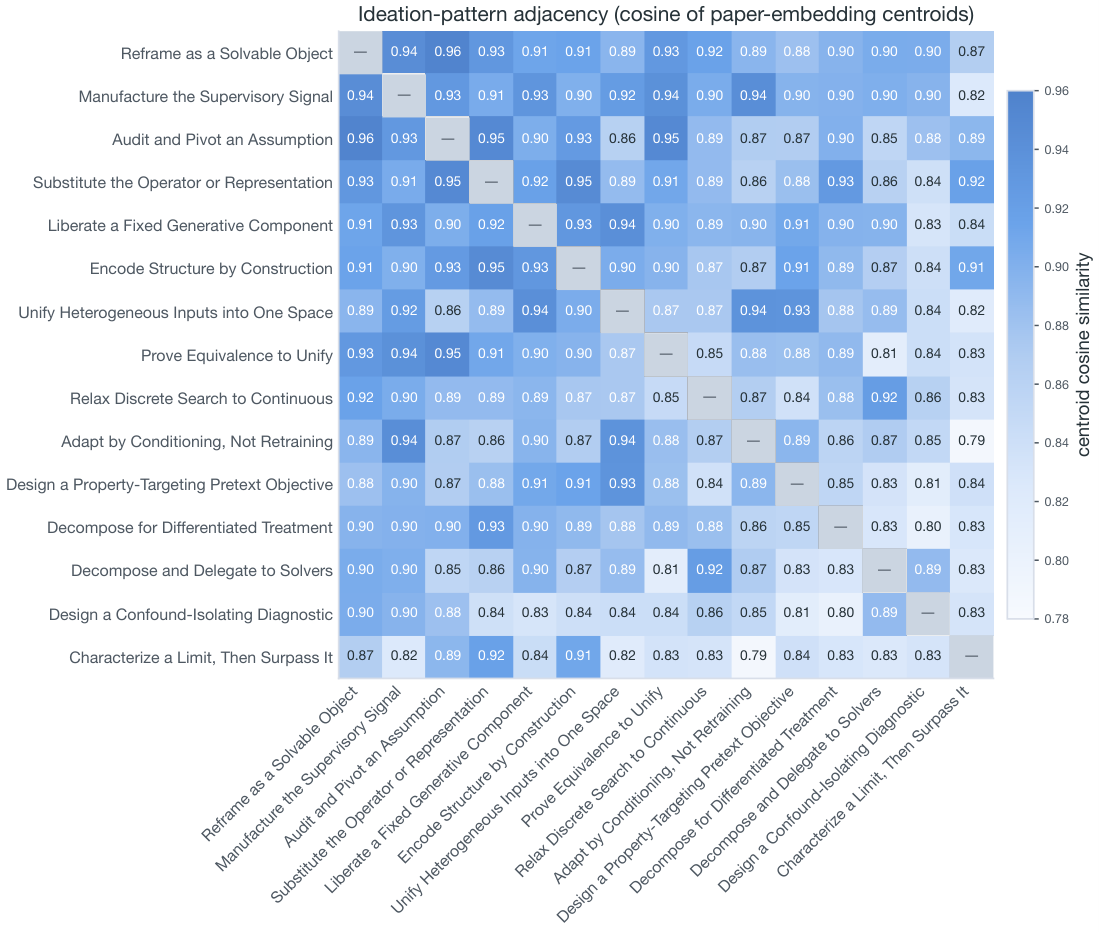
| Methodology | Nearest Neighbor | cosine | n |
|---|---|---|---|
| Reframe as a Solvable Object | Audit and Pivot an Assumption | 0.956 | 79 |
| Audit and Pivot an Assumption | Reframe as a Solvable Object | 0.956 | 181 |
| Substitute the Operator or Representation | Audit and Pivot an Assumption | 0.949 | 109 |
| Prove Equivalence to Unify | Audit and Pivot an Assumption | 0.949 | 59 |
| Encode Structure by Construction | Substitute the Operator or Representation | 0.946 | 61 |
| Manufacture the Supervisory Signal | Reframe as a Solvable Object | 0.943 | 66 |
| Adapt by Conditioning, Not Retraining | Manufacture the Supervisory Signal | 0.942 | 18 |
| Unify Heterogeneous Inputs into One Space | Liberate a Fixed Generative Component | 0.942 | 82 |
| Liberate a Fixed Generative Component | Unify Heterogeneous Inputs into One Space | 0.942 | 94 |
| Design a Property-Targeting Pretext Objective | Unify Heterogeneous Inputs into One Space | 0.935 | 15 |
| Decompose for Differentiated Treatment | Substitute the Operator or Representation | 0.927 | 47 |
| Decompose and Delegate to Solvers | Relax Discrete Search to Continuous | 0.923 | 42 |
| Relax Discrete Search to Continuous | Decompose and Delegate to Solvers | 0.923 | 35 |
| Characterize a Limit, Then Surpass It | Substitute the Operator or Representation | 0.917 | 15 |
| Design a Confound-Isolating Diagnostic | Reframe as a Solvable Object | 0.904 | 86 |
Три наблюдения:
(i) Смежность предсказывает комбинации, обогащенные устными данными. Три лучшие пары, обогащенные устными данными на уровне кластеров, являются соседями с высоким косинусным сходством: Audit and Pivot Structural Prior Encoding ( pp), Operator Substitution Audit and Pivot ( pp) и Audit and Pivot Controlled Diagnostic Design ( pp). Audit and Pivot an Assumption находится на расстоянии косинуса от Operator Substitution и соединяется с Structural Prior Encoding на . Таким образом, геометрическая близость является полезным свидетельством того, какой вторичный паттерн целесообразно сочетать с данным первичным..
(ii) Два наиболее изолированных паттерна — это не просто самые маленькие из них. Design a Confound-Isolating Diagnostic () имеет наименьший косинус ближайшего соседа (). Characterize a Limit, Then Surpass It () имеет второй по величине показатель (). Таким образом, изоляция не определяется только поддержкой. Контролируемый диагностический паттерн геометрически обособлен, поскольку его операционная сигнатура заключается в создании измерительного инструмента для изоляции конфаундеров, который не сочетается с остальными 14 паттернами стандартным образом. Это делает его кандидатом на роль этапа с высокой степенью новизны..
(iii) Три паттерна разделяют статус узловых. Audit and Pivot an Assumption, Reframe as a Solvable Object и Substitute the Operator or Representation каждый выступает в качестве ближайшего соседа для 3 других паттернов. Набор узловых элементов распределен между действиями по диагностике, формулированию и подстановке. Таким образом, фаза 2.1 имеет три сбалансированных вторичных варианта по умолчанию, которые следует рассмотреть, если узкое место еще не предполагает конкретной композиции.
6.5 Назначение паттернов генерации идей с несколькими метками на уровне статьи
Отображение на уровне кластеров в §6 ограничивает каждый кластер, а следовательно, и каждую сгруппированную статью, первичными + вторичными. Чтобы проверить, является ли 2 правильным ограничением, и напрямую выявить комбинации из 3+ паттернов, мы запускаем отдельный проход Sonnet 4.6 для каждой статьи независимо. Учитывая 15 определений паттернов генерации идей, название статьи, аннотацию и четыре поля abstract∗, модель выдает JSON-список паттернов, которые статья фактически реализует, а не просто упоминает. Каждая метка включает цитируемый фрагмент доказательства и первичную/поддерживающую роль. Верхнего ограничения на нет; минимум равен 1.
Все 1 891 статья с четырьмя абстрагированными полями получили непустое назначение нескольких меток. Вместо того чтобы сообщать байесовский коэффициент принятия (который требует построения знаменателя, смешивающего решение OpenReview Oral/Reject с классом HC, основанным на цитировании), мы напрямую сообщаем условное распределение классов . В таблице 5 показано, какая доля статей каждого класса принятия выполняет паттерны генерации идей .
| all (n=1891) | Oral | HC | Reject | |
|---|---|---|---|---|
| 1 | 137 (7.2%) | |||
| 2 | 1119 (59.2%) | mode | mode | mode |
| 3 | 611 (32.3%) | |||
| 4 | 24 (1.3%) | |||
| 2.28 | 2.28 | 2.32 | 2.26 |
Три наблюдения:
(i) является эмпирической модой в каждом классе. В целом, 59,2% статей реализуют ровно два паттерна генерации идей. Мода является общей для Oral, HC и Reject. Только статей реализуют один паттерн, в то время как «хвост» реализует три или более. Кластерный подход в §6.3, ограниченный по построению, следовательно, недооценивает «хвост» из трех элементов. Многометочная разметка на уровне статей является подходящей гранулярностью для охвата этого «хвоста»..
(ii) Средние значения классов плотно группируются вокруг . Средние значения классов статистически неразличимы при данном объеме выборки. Размер состава не разделяет классы принятия; разделяет содержание состава (какие паттерны) (§7⟧).
(iii) Назначение пар кластеров недостаточно полно отражает истинный охват паттернов генерации идей. Перекрестная табуляция относительно пары (первичной, вторичной), полученной на основе кластеров, показывает, что многометочная разметка выявляет сигналы за пределами доминирующего кластера. Большинство статей имеют как минимум один поддерживающий паттерн вне своей пары кластеров. Пара кластеров фиксирует доминирующую ось, но не учитывает стандартные 1–2 поддерживающих действия, которые выявляет многометочная разметка..
Лучшие комбинации при многометочной классификации.
Используя многометочные назначения на уровне статей, мы можем напрямую ранжировать 2-сторонние и 3-сторонние комбинации (Таблица 6). Мы используем то же определение , что и в таблице на уровне кластеров, поэтому сравнение между таблицами является корректным; базовый показатель набора данных составляет . Выделяются три комбинации: Унификация алгебраической эквивалентности + Редизайн генеративного процесса (, , п.п.), Унификация алгебраической эквивалентности + Гетерогенная декомпозиция (, , п.п.) и Аудит и поворот + Характеристика предела с последующим его преодолением (, , п.п.). Третья комбинация является наиболее объемной и сильно обогащенной Oral в наборе данных. Ее эмпирическая сигнатура: выявление несущего предположения, а затем доказательство строгого улучшения предела, который оно накладывает. Сторона 2-сторонней таблицы, обогащенная Oral, последовательна: сочетание диагностического или унификационного шага либо с конструктивным субстратом, либо с четким аналитическим обязательством..
| Combination | |||||
| Top 2-way () | |||||
| algebraic equivalence unification + generative process redesign | 17 | 0 | 3 | 85.0% | |
| algebraic equivalence unification + heterogeneous decomposition | 18 | 2 | 4 | 81.8% | |
| assumption audit & pivot + characterize limit then surpass | 48 | 2 | 12 | 80.0% | |
| generative process redesign + reframe as solvable object | 22 | 1 | 7 | 75.9% | |
| algebraic equivalence unification + structural prior encoding | 15 | 0 | 7 | 68.2% | |
| generative process redesign + self-supervised signal engineering | 19 | 7 | 9 | 67.9% | |
| decompose and delegate + reframe as solvable object | 19 | 1 | 9 | 67.9% | |
| controlled diagnostic design + heterogeneous decomposition | 20 | 8 | 10 | 66.7% | |
| Top 3-way () | |||||
| audit & pivot + decompose & delegate + reframe as solvable object | 8 | 0 | 2 | 80.0% | |
| audit & pivot + characterize limit then surpass + reframe as solvable object | 11 | 0 | 3 | 78.6% | |
| audit & pivot + controlled diagnostic design + heterogeneous decomposition | 8 | 2 | 3 | 72.7% | |
| audit & pivot + generative process redesign + heterogeneous decomposition | 8 | 3 | 5 | 61.5% | |
| audit & pivot + reframe as solvable object + structural prior encoding | 12 | 0 | 9 | 57.1% | |
Что многометочная классификация означает для навыка ⟦K0⟧.
Данный навык рассматривает композицию паттернов генерации идей как 1–3 записи на каждую сгенерированную идею, где является эмпирически обоснованным значением по умолчанию. Для каждого составленного паттерна он извлекает условия успеха и неудачи из карточек паттернов генерации идей в §6.1. Статистика комбинаций в таблице 6 выводится только в качестве контекста через блок innovation_pattern_landscape кандидата. Этот блок отображает использование паттернов в данной области наряду с выбранной кандидатом композицией, чтобы пользователь мог видеть, какое место занимает идея в эмпирическом распределении..
Выбор паттерна сам по себе происходит на этапе подготовки в соответствии со структурным соответствием «узкому месту» в Фазе 2.1, а не на основе априорных вероятностей скорости композиции. Загрузка априорных данных во время генерации была протестирована в более ранней версии дизайна и удалена, поскольку она приводила к гомогенизации распределения смещений между запусками. Таким образом, комбинации, обогащенные Oral, в Таблице 6 являются эмпирическими наблюдениями, а не шаблонами целевых навыков..
7 Анализ принятия и влияния
Мы определяем предвзятость принятия как . Здесь — это доля первичных работ уровня кластера Oral, чей основной паттерн равен , а — аналогичная доля для отклоненных работ. Положительное значение означает, что паттерн встречается в принятых работах чаще, чем в отклоненных, относительно общих показателей класса. Отрицательное значение означает обратное..
Данный анализ проводится на уровне кластеров и поэтому является частичным. Первичные данные на уровне кластеров доступны для из устных докладов и из отклоненных докладов. Знаменатели представляют собой общие показатели на уровне кластеров (, , ), а не полные совокупности классов. Оставшиеся статьи, не вошедшие в кластеры HDBSCAN, охвачены этапом мультиметочной классификации в §6.5. На рисунке 9 отображено смещение для всех 15 паттернов; в таблице 7 приведены все значения..
| Ideation pattern | |||||
|---|---|---|---|---|---|
| Reframe as a Solvable Object | 10.0 | 2.9 | 7.1 | +2.9 | +7.1 |
| Design a Confound-Isolating Diagnostic | 8.5 | 14.0 | 6.8 | +1.7 | 5.4 |
| Liberate a Fixed Generative Component | 9.5 | 12.8 | 8.2 | +1.4 | 3.2 |
| Substitute the Operator or Representation | 11.8 | 12.2 | 10.6 | +1.2 | 0.4 |
| Decompose and Delegate to Solvers | 3.9 | 7.0 | 3.3 | +0.7 | 3.0 |
| Adapt by Conditioning, Not Retraining | 2.1 | 1.2 | 1.6 | +0.4 | n/a |
| Relax Discrete Search to Continuous | 4.1 | 0.6 | 3.8 | +0.3 | n/a |
| Characterize a Limit, Then Surpass It | 1.9 | 0.0 | 1.6 | +0.2 | n/a |
| Encode Structure by Construction | 6.2 | 5.2 | 6.3 | 0.0 | +1.0 |
| Design a Property-Targeting Pretext Objective | 1.5 | 1.2 | 1.6 | 0.2 | n/a |
| Prove Equivalence to Unify | 6.2 | 1.2 | 7.4 | 1.1 | n/a |
| Manufacture the Supervisory Signal | 5.4 | 9.9 | 6.5 | 1.1 | 4.5 |
| Unify Heterogeneous Inputs into One Space | 6.2 | 17.4 | 7.6 | 1.4 | 11.2 |
| Audit and Pivot an Assumption | 19.5 | 6.4 | 21.5 | 2.0 | +13.1 |
| Decompose for Differentiated Treatment | 3.1 | 8.1 | 6.0 | 2.9 | 5.0 |
Две оси структурируют таблицу. Ось Oral-vs-Reject является узкой, с разбросом всего в п.п. На уровне основных паттернов выбор стратегии мало влияет на принятие. Ортогональная ось PC-vs-community гораздо шире, достигая примерно п.п., и является более сильным дискриминирующим сигналом. Далее следуют четыре наблюдения..
(O1) Ось узкая. Диапазон составляет pp: Reframe as a Solvable Object находится на , в то время как Decompose for Differentiated Treatment — на . Этот узкий разброс предполагает, что основной паттерн сам по себе мало объясняет дисперсию принятия. Именно исполнение на уровне субпаттернов, то есть кластера, а не паттерна первого уровня, является тем, что проводит различие.
(O2) Audit and Pivot характеризуется большим объемом, высокой дисперсией, легким уклоном в Reject и сильным предпочтением со стороны PC. Он содержит устных докладов (Oral papers), что является наибольшей долей устных докладов на уровне кластера, и отклоненных работ (Reject papers), что также является наибольшим показателем. Это дает pp. Его pp представляет собой наибольшее положительное смещение PC в данной таксономии: PC непропорционально часто выбирают работы по аудиту/пивоту в качестве устных докладов, в то время как научное сообщество цитирует их реже, чем ожидалось. Качество исполнения, а не выбор стратегии, отличает устных докладов от отклоненных работ в рамках этого паттерна..
(O3) Унификация гетерогенных входных данных в единое пространство — это наиболее четко выраженный паттерн в наборе данных, пользующийся популярностью у сообщества. Его pp обусловлен долей HC по сравнению с долей устных докладов , что пропорционально почти в три раза больше HC, чем устных докладов. Статьи по кросс-модальному выравниванию активно воспроизводятся и цитируются, но программные комитеты не повышают их статус до устных докладов с той же частотой. Это противоположно паттернам аудита и разворота..
(O4) Переформулирование в виде решаемого объекта — это самый четкий сигнал для Oral. И pp, и pp являются положительными. Программные комитеты поощряют этот паттерн, а сообщество не цитирует его чрезмерно по отношению к частоте Oral. В сочетании с высоким косинусным сходством с Audit и Pivot () в анализе смежности, это подтверждает конкретный рецепт для Oral: переформулировать трудноразрешимую исходную постановку задачи в решаемый объект, а затем провести аудит и пересмотр допущения, на котором держится данная переформулировка..
Ось PC-против-сообщества ().
Столбец выделяет вторую ось: согласны ли программные комитеты и цитирующее сообщество в том, что именно имеет значение. Наблюдения O2–O4 показывают, что программные комитеты склонны поощрять шаги, связанные со структурным пониманием, в то время как сообщество склонно поощрять шаги, связанные с полезной инфраструктурой. Эти два рейтинга практически ортогональны. Таким образом, аудиторский слой выделяет как отдельный сигнал, отличный от оси прогнозирования принятия..
Использование в навыке.
IdeaSpark не использует статистику принятия или соотношение программного комитета к сообществу в качестве априорных критериев отбора на каком-либо этапе. Выбор паттерна определяется структурным соответствием узкому месту. Статистика вводится только в качестве контекста для аудита.
8 Распределение доменов и широта паттернов генерации идей
Карточки паттернов генерации идей (§6.1) и профиль смещения для каждого паттерна (§7) рассматривают 1 947 статей как единую совокупность. Однако ML не является монолитной областью. Стратегия, которая обеспечивает статус Oral в теории обучения, может не сработать в vision-language pretraining. Поэтому IdeaSpark должен различать широко применимые паттерны и те, что зависят от предметной области. В этом разделе количественно оценивается данное различие..
8.1 Индукция предметной области
Мы не задаем таксономию предметной области заранее. Вместо этого мы выводим ее из данных, используя ту же архитектуру, которая породила 15 ideation patterns:
- ⟦1. Sonnet 4.6 извлекает от 1 до 3 нормализованных тегов исследовательских поднаправлений для каждой статьи на основе её названия, аннотации и (при наличии, набора данных) ключевых слов, предоставленных авторами в OpenReview.
- ⟦2. 3909 уникальных тегов в свободной форме векторизованы с помощью OpenAI text-embedding-3-large и кластеризованы посредством UMAP+HDBSCAN ( кластеров тегов при , некластеризованных ).
- ⟦3. Sonnet 4.6 присваивает метку каждому кластеру тегов.
- ⟦4. Opus 4.7 формирует таксономию предметной области первого уровня из записей и сопоставляет каждый кластер тегов с меткой домена.
Модель возвращает доменов. Мы не вносим никаких правок.
Распределение по статьям представляет собой объединение областей на основе тегов каждой статьи. Охват высокий: статей (1,918 / 1,947) получают как минимум одну область. В среднем на статью приходится областей. 28 областей варьируются от (Transfer, Continual & Meta-Learning) до (Online & Bandit Learning). Полный упорядоченный список и машиночитаемая таксономия находятся в clustering/domains/domain_taxonomy.json.
8.2 Домен тепловая карта паттернов генерации идей
Мы сопоставляем 28 производных доменов с 15 паттернами генерации идей, используя многометочную разметку на уровне статей (§6.5). Каждая статья вносит один отсчет в каждую ячейку (домен, паттерн), к которой она относится. Сетка содержит ячеек. Из них () содержат как минимум одну статью, а () имеют . На рисунке 10 представлены два вида. Панель (a) показывает необработанное количество статей на ячейку. Панель (b) показывает уровень Oral на уровне ячеек , скрытый там, где ⟧.
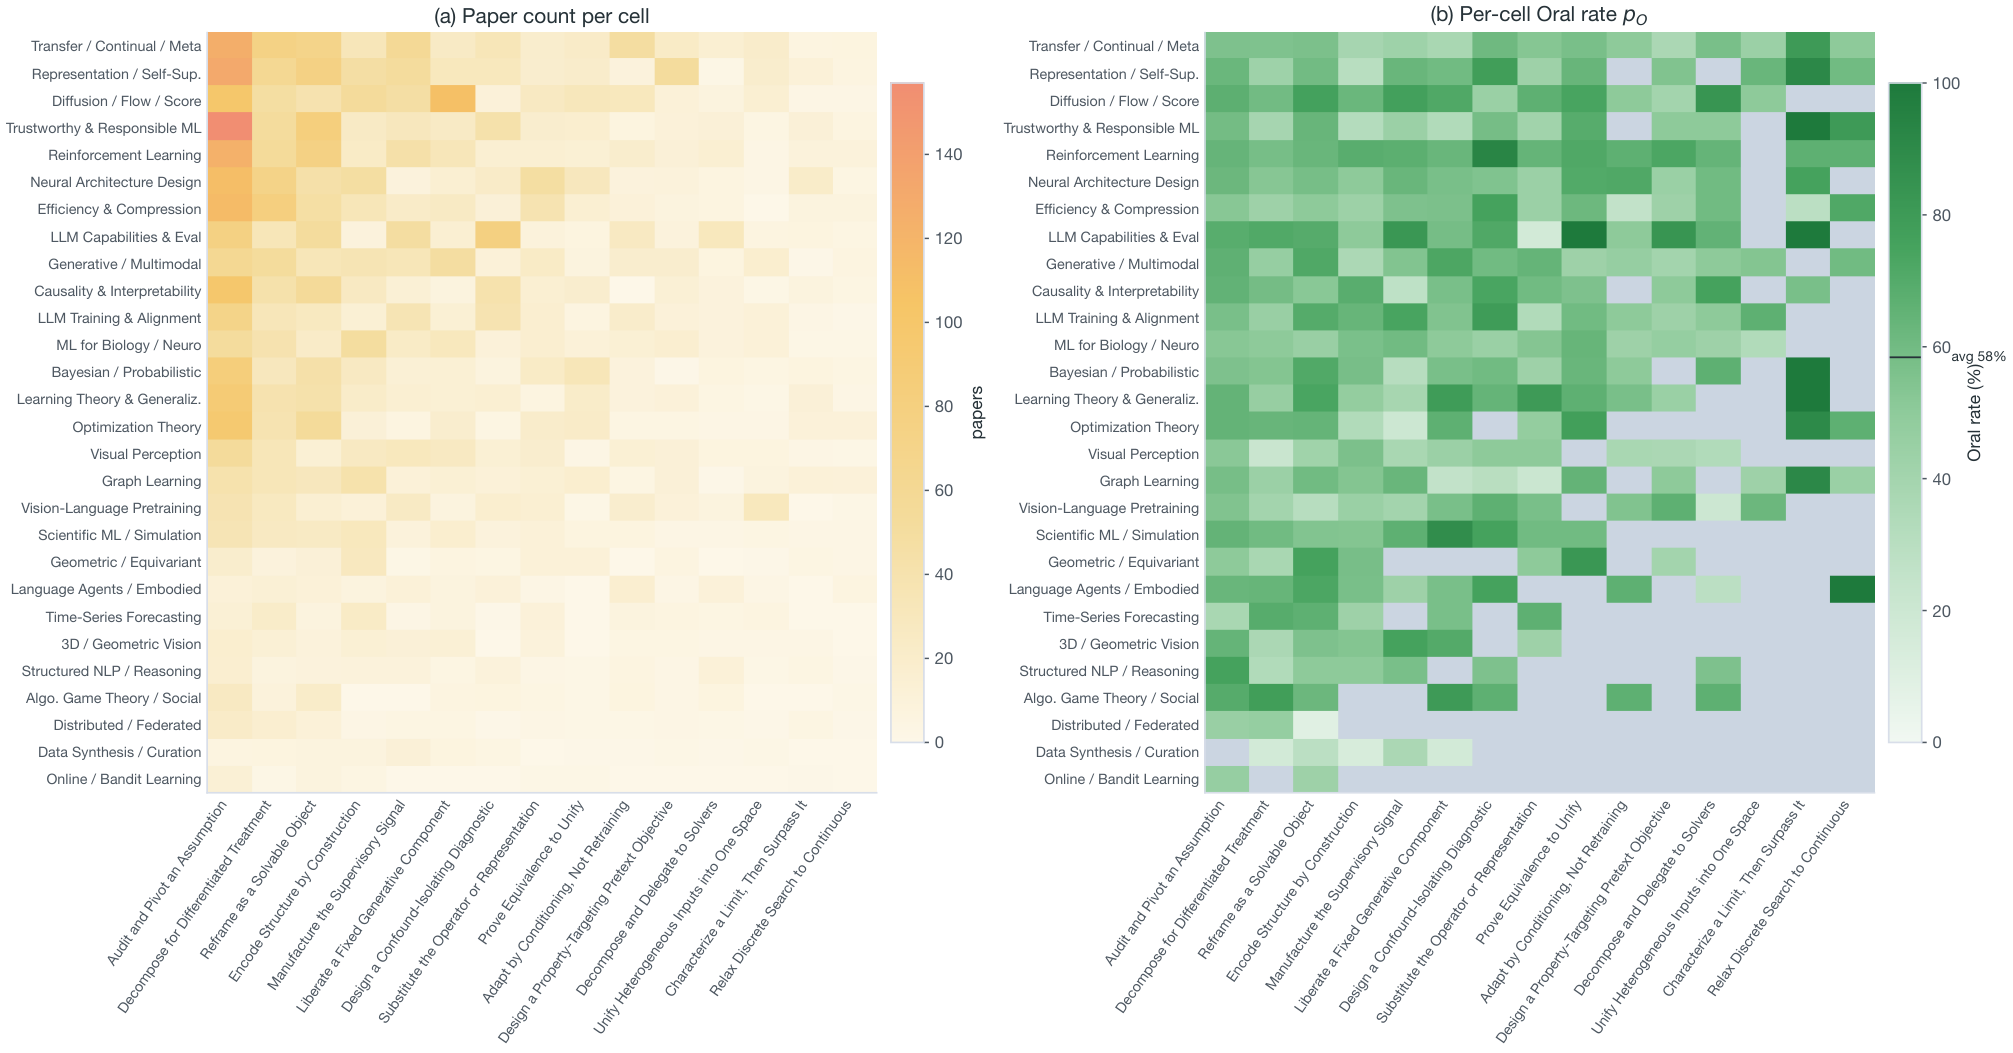
Представление на уровне ячеек добавляет предметную специфику к §7. Один и тот же паттерн генерации идей может приводить к совершенно разным показателям Oral в разных предметных областях. Один паттерн является главным исключением: «Охарактеризовать предел, а затем превзойти его» дает наиболее четкий кросс-доменный сигнал Oral в корпусе, занимая четыре из пяти самых сильных ячеек. Пять самых сильных ячеек, каждая с на , это:
- ⟦• Доверенное и ответственное ML Охарактеризуйте предел, а затем превзойдите его: Устный доклад (, ), чистейшая ячейка принятия набора данных.
- ⟦• Теория обучения и обобщения Охарактеризуйте предел, а затем превзойдите его: ().
- ⟦• Reinforcement Learning Разработка диагностического инструмента для изоляции конфаундеров: ().
- ⟦• Представление и самообучение Охарактеризуйте предел, а затем превзойдите его: ().
- ⟦• Обучение на графах Охарактеризуйте предел, а затем превзойдите его: ().
Пять самых слабых плотных ячеек () — это:
- ⟦• Распределенное и федеративное обучение переформулировать как решаемый объект: ⟧.
- ⟦• Обучение на графах Замена оператора или представления: .
- ⟦• Визуальное восприятие и распознавание Декомпозиция для дифференцированного подхода: .
- ⟦• Эффективность и сжатие моделей Адаптация через обусловливание, а не переобучение: .
- ⟦• Обучение на графах Освобождение фиксированного генеративного компонента: .
Наименее плотные ячейки демонстрируют обратную сторону того же результата. Шаблон, который выигрывает в одной предметной области, может резко снизить эффективность в другой. Это подтверждает указания на карточках о том, что условия успеха не переносятся механически между областями..
Междоменная согласованность подхода «Охарактеризуй предел, затем превзойди его» имеет четкую операционную основу. Когда в статье определяется формальный предел, такой как теоретико-информационный предел, предел сложности выборки, выразительности или обобщения, и доказывается строгое улучшение по сравнению с ним, этот защищаемый перед рецензентами признак переносится на другие, в остальном различные, области..
8.3 Широта паттернов генерации идей: насколько каждый паттерн является доменно-независимым?
Для навыка оценки правдоподобности паттерна в предметной области пользователя необходим охват доменов для каждого паттерна. На рисунке 11 для каждого паттерна генерации идей отображено количество затрагиваемых им доменов и доля статей, сосредоточенных в его крупнейшем домене..
Три наблюдения:
(i) Диагностические и формулировочные паттерны охватывают всю область. Audit and Pivot an Assumption и Reframe as a Solvable Object имеют по статей во всех 28 доменах. Decompose for Differentiated Treatment охватывает 27 доменов. Эти три паттерна также являются наиболее объемными в мультилейбл-распределении: , и статей соответственно под тегированием. Они также закрепляют Oral-enriched мультилейбл-комбинации в таблице 6. Таким образом, широта охвата, объем и принятие сосуществуют..
(ii) Паттерны уровня построения по-прежнему широки, но более концентрированы. Encode Structure by Construction достигает доменов, Liberate a Fixed Generative Component достигает , Manufacture the Supervisory Signal достигает , а Substitute the Operator or Representation достигает . Эти паттерны зависят от конкретного архитектурного выбора или генеративного индуктивного смещения. Они встречаются в большинстве областей, но с более четкими доменно-модальными привязками. Генеративный редизайн концентрируется в Diffusion, Flow & Score Models, а замена операторов — в Sequence Modeling & Architectures.
(iii) Узкоспециализированные паттерны не обязательно склонны к отклонению. Relax Discrete Search to Continuous затрагивает доменов, Unify Heterogeneous Inputs into One Space затрагивает , а Characterize a Limit, Then Surpass It затрагивает . Первые два являются узкими, поскольку их операционные субстраты существуют только в некоторых подполях: задачах, допускающих дискретный поиск, и каркасах кросс-модального выравнивания. Characterize a Limit, Then Surpass It также является узким, но это самый чистый кросс-доменный сигнал Oral, который мы наблюдаем (§8.2). Его узость отражает предварительное условие. Поле уже должно было сформировать формальную характеристику предела, что верно не везде.
Мы не приводим временной срез по доменам. Обусловливание по (домен год паттерн) оставляет лишь 1–3 статьи на ячейку для небольших доменов, что является слишком малым объемом для количественных утверждений. Данный навык также не опирается на подобные агрегированные срезы. Его чтение для насыщения на этапе Phase 2.1 вычисляется в реальном времени на основе поиска этапа Phase 0 (§9) каждого прогона, поэтому насыщение по конкретным доменам считывается из фактически найденной литературы, а не из укрупненных корзин набора данных..
9 Временная и конференциальная структура
9.1 Временные тренды
Мы суммируем временные изменения в интервале 2021–2025 годов, сравнивая ранний период, определенный как среднее значение за 2021–2022 годы, с поздним периодом, определенным как среднее значение за 2024–2025 годы. Наиболее явными лидерами являются:
- ⟦• Risers. Декомпозиция и делегирование решателям ( early late, pp) — это наиболее быстрорастущий паттерн в наборе данных. Он отслеживает появление конвейеров решателей, управляемых LLM-агентами и инструментами, начиная с 2023 года. Проектирование диагностик для изоляции конфаундеров (, pp) отражает становление оценки на основе контролируемых возмущений как первостепенного исследовательского метода. Унификация гетерогенных входных данных в едином пространстве ( pp) является третьим отчетливо растущим паттерном..
- ⟦• Fallers. Декомпозиция для дифференцированного подхода (, pp) теряет больше всего позиций. Стратегия «разделения на субпопуляции и дифференцированной обработки» по-видимому была поглощена более специализированными паттернами, включая замену операторов и структурные априорные предположения. Аудит и изменение допущения (, pp) остается паттерном с наибольшим объемом использования, но постепенно сдает позиции. Освобождение фиксированного генеративного компонента ( pp) является третьим падающим паттерном, что согласуется с насыщением волны генеративного редизайна, доминировавшей в 2021–2023 годах..
Предостережение о размере выборки для ранних лет.
Корпус несбалансирован по годам. Срез 2021 года содержит 77 статей с несколькими метками, а 2022 года — 73, в то время как каждый год с 2023 по 2025 имеет –. Таким образом, доля раннего периода агрегируется на основе 150 статей. Изменения в нижней части таблицы ( п.п.) статистически не являются устойчивыми, поэтому мы не выделяем их. Лидеры роста и падения в основном несут п.п., что соответствует изменениям абсолютного количества статей более чем на в каждом направлении..
Как навык использует эти сигналы трендов.
Эти временные вердикты по всему корпусу являются лишь описательным контекстом. Навык никогда не загружает их в качестве априорных данных для генерации. Вместо этого Фаза 1 считывает насыщение паттернов в реальном времени из литературы, извлеченной в ходе каждого запуска (§13).
9.2 Предпочтения конференций
На рисунке 13 представлена доля каждого паттерна в рамках каждой площадки, измеренная как процент статей этой площадки, содержащих данный паттерн при использовании мультилейбл-тегирования. Выделяются три характерные особенности площадок.
Конференция ICML делает чрезмерный акцент на аудите предположений и описании ограничений. Паттерн «Аудит и пересмотр предположения» достигает доли на ICML по сравнению с в других местах, что дает прирост в п.п. Паттерн «Описать ограничение, затем превзойти его» достигает по сравнению с , что дает прирост в п.п. Оба паттерна являются диагностическими или теоретическими, что согласуется с предпочтением ICML к четко ограниченным аналитическим вкладам..
ICLR чрезмерно фокусируется на методах, связанных с конструированием. Encode Structure by Construction достигает по сравнению с в других местах ( pp). Liberate a Fixed Generative Component достигает по сравнению с ( pp). ICLR также недостаточно фокусируется на Prove Equivalence to Unify ( pp) и Audit and Pivot an Assumption ( pp). Характер публикаций площадки отдает предпочтение архитектурному и репрезентативному конструированию, а не алгебраической унификации..
NeurIPS чрезмерно фокусируется на декомпозиции, основанной на гетерогенности, и проектировании сигналов контроля. Метод Decompose for Differentiated Treatment достигает по сравнению с в других местах ( pp). Метод Manufacture the Supervisory Signal достигает по сравнению с ( pp). NeurIPS недостаточно фокусируется на Design a Confound-Isolating Diagnostic ( pp). Характерной чертой площадки является композиция на системном уровне в сочетании с изобретенным контролем, что согласуется с эмпирической предвзятостью в пользу статей с масштабными экспериментами..
Эти сигнатуры площадок количественно оцениваются для каждого паттерна. Навык выводит их только в качестве контекста аудита для карточки идеи на этапе ⟦BROKEN_K4⟧, чтобы пользователь мог увидеть предыдущую площадку наряду с выбранной кандидатом композицией паттернов..
10 Занимают ли отклоненные статьи иное пространство стратегий?
Естественное опасение заключается в том, что кластеризация работ категорий Oral, HC и Reject в одном пространстве может принудительно включить работы категории Reject в кластеры, определяемые принятыми работами. Если в отклоненных работах использовались другие стратегии, то полученные паттерны генерации идей могли бы их недостаточно полно отражать. Мы проверяем это напрямую. Результат отрицательный: отклоненные работы группируются в рамках той же таксономии из 15 паттернов, а не в отдельном пространстве стратегий..
10.1 Кластеризация и отображение только отклоненных результатов
Мы повторно запускаем конвейер эмбеддингов и кластеризации для 711 отклоненных статей, содержащих полные поля abstract_*. Из 722 отклоненных статей в 11 отсутствует одно из четырех полей. Мы сохраняем гиперпараметры UMAP неизменными (, , косинусная метрика, seed 42). Мы также сохраняем настройки HDBSCAN неизменными на с cluster_selection_method=leaf. Эта конфигурация создает 13 кластеров, состоящих только из отклоненных статей, с долей некластеризованных данных ().
Затем мы сопоставляем каждый кластер типа Reject-only с его ближайшим центроидом основного паттерна в исходном -мерном пространстве text-embedding-3-large (§6). Все 13 кластеров попадают в диапазон косинусного сходства – от назначенного им первичного паттерна. В общей сложности 11 из 15 основных паттернов получают как минимум один кластер типа Reject-only. Ни один кластер типа Reject-only не требует метки вне таксономии..
Четыре основных паттерна не имеют отображения только в категорию Reject: Адаптация через обусловливание, а не дообучение, Характеристика предела с последующим его преодолением, Разработка претекст-цели, ориентированной на свойства, и Кодирование структуры через конструирование. Три из них являются паттернами с малой выборкой ( каждый), а один — конструктивно закодированным паттерном. Эмпирический вывод заключается в том, что статьи с результатом Reject не образуют отдельного стратегического пространства. Они отображаются в существующую таксономию из 15 паттернов с высоким косинусным.
Таблица 8 сравнивает полученное распределение Reject с распределением Reject основной таксономии.
| Ideation pattern | Reject-only | Reject-in-full | |
|---|---|---|---|
| Unify Heterogeneous Inputs into One Space | 80 | 28 | |
| Audit and Pivot an Assumption | 98 | 79 | |
| Decompose and Delegate to Solvers | 25 | 12 | |
| Decompose for Differentiated Treatment | 32 | 22 | |
| Prove Equivalence to Unify | 36 | 27 | |
| Substitute the Operator or Representation | 47 | 39 | |
| Design a Confound-Isolating Diagnostic | 33 | 25 | |
| Relax Discrete Search to Continuous | 22 | 14 | |
| Liberate a Fixed Generative Component | 25 | 30 | |
| Adapt by Conditioning, Not Retraining | 0 | 6 | |
| Characterize a Limit, Then Surpass It | 0 | 6 | |
| Design a Property-Targeting Pretext Objective | 0 | 6 | |
| Manufacture the Supervisory Signal | 14 | 24 | |
| Reframe as a Solvable Object | 11 | 26 | |
| Encode Structure by Construction | 0 | 23 |
10.2 Интерпретация
Десять из 15 паттернов дают сопоставимые значения Reject в обоих вычислениях (). Таким образом, стратегическая форма пула Reject остается стабильной независимо от того, группируем ли мы его вместе с принятыми статьями или отдельно..
Заметные расхождения сосредоточены в двух направлениях. Кластеризация только на основе отклонения (Reject-only clustering) относит существенно больше статей к категориям «Унификация гетерогенных входных данных в единое пространство» () и «Аудит и пересмотр предположения» (), чем полное сопоставление. И наоборот, она относит меньше статей к категориям «Кодирование структуры через построение» (), «Переформулирование в виде решаемого объекта» () и «Создание контролирующего сигнала» (⟧).
Этот паттерн устойчив: когда статьи со статусом Reject группируются между собой, они смещаются в сторону направлений аудита/унификации, удаляясь от конструктивных направлений. Вероятная интерпретация заключается в том, что неудачные конструктивные шаги могут структурно выглядеть как шаги аудита/унификации, если их лишить конструкции, которая делала их конструктивными..
Положительно. Таксономия из 15 паттернов охватывает популяцию Reject без изменений. Каждый кластер, состоящий только из Reject, соотносится с существующим паттерном, без выделения категорий вне таксономии. Таким образом, отклонение не объясняется использованием другого типа стратегии..
Отрицательно. Дивергенция только по отклоненным ответам () показывает, что гранулярная поверхностная форма отклоненных работ смещается в сторону более общих паттернов аудита/унификации и уходит от конструктивных паттернов. Это имеет прямое следствие для навыка. Когда Фаза 2.1 выбирает конструктивный первичный паттерн, такой как Кодирование структуры через построение, Переформулирование как решаемого объекта или Создание контролирующего сигнала, Фаза 3.2 должна проверить, не схлопнулась ли выполненная поверхностная форма кандидата в сторону соответствующей линии аудита/унификации..
11 Абляция: модель эмбеддингов и этап абстракции
Два конструктивных решения являются центральными для индуцированной таксономии. Во-первых, производственный конвейер использует кодировщик общего назначения с сильной способностью к перефразированию, а не SPECTER2. Во-вторых, он встраивает доменно-независимые переписывания, а не четыре исходных базовых поля. Мы проводим абляционное исследование обоих решений на той же подвыборке из 1 891 статьи, которая используется производственным конвейером. Параметры UMAP остаются фиксированными, а HDBSCAN варьируется в диапазоне . На рисунке 15 и в таблице 9 представлено сравнение..
| Embedding | Text | mcs | Unclustered % | Silhouette | |
|---|---|---|---|---|---|
| OpenAI text-embedding-3-large | 4 abstract fields | 10 | 31 | 47.7 | 0.584 |
| OpenAI text-embedding-3-large | 4 abstract fields | 15 | 19 | 39.7 | 0.527 |
| OpenAI text-embedding-3-large | 4 abstract fields | 25 | 12 | 48.8 | 0.561 |
| OpenAI text-embedding-3-large | 4 base fields | 10 | 35 | 35.7 | 0.586 |
| OpenAI + base (degenerate at mcs=15) | 4 base fields | 15 | 2 | 0.0 | 0.884 |
| OpenAI + base (degenerate at mcs=20) | 4 base fields | 20 | 2 | 0.0 | 0.884 |
| SPECTER2 (768-dim) | 4 abstract fields | 10 | 23 | 50.6 | 0.438 |
| SPECTER2 (768-dim) | 4 abstract fields | 25 | 7 | 41.0 | 0.333 |
11.1 Модель эмбеддингов: OpenAI против SPECTER2
При идентичном входном тексте и идентичной последующей обработке OpenAI text-embedding-3-large создает больше кластеров, чем SPECTER2 при ( против ). Он также достигает существенно более высокого коэффициента силуэта ( против , разрыв в ). Показатели SPECTER2 ухудшаются по мере увеличения диапазона, достигая при . Доля некластеризованных данных остается в диапазоне –..
Качественное различие соответствует целям обучения. SPECTER2 обучается на контрастивных парах, основанных на цитировании, и эффективно размещает тематически близкие статьи рядом друг с другом. Однако наша цель — сходство стратегий, а не тематическое сходство. Две статьи должны группироваться вместе, если обе они «повторно применяют доказанный механизм с соответствующей предметно-ориентированной детализацией», даже если они работают с разными модальностями. Универсальный кодировщик парафразов лучше сохраняет это отношение эквивалентности стратегий и создает более плотное разбиение по стратегиям..
11.2 Этап абстракции: силуэта недостаточно
Абляция базовых полей дает более тонкий результат. При его силуэт почти идентичен производственному ( против ). Его некластеризованная доля также ниже ( против ). Таким образом, по метрике необработанной кластеризации вариант с базовыми полями выглядит немного лучше..
Та же конфигурация нестабильна в рамках серии экспериментов. При – она схлопывается до мегакластеров с силуэтом и некластеризованными объектами. Анализ показывает, что это не кластеры стратегий. Один объединяет статьи об инженерных решениях в deep learning. Другой объединяет статьи о формальном или аналитическом ML. Это макротематические кластеры, а не кластеры логических шагов..
Этот вырожденный коллапс указывает на то, что тематическая связность превзошла стратегическую связность. Базовые поля содержат узкоспециализированную лексику, включая названия архитектур, названия наборов данных и специфические для данной области математические объекты. На более грубых уровнях гранулярности тематическая близость начинает доминировать в структуре сходства. Две статьи по диффузионным моделям могут оказаться в одном кластере просто потому, что обе они посвящены диффузии, независимо от того, что именно в них делается с помощью диффузии..
Перезапись на этапе 2 переносит абстракцию в текст перед встраиванием. Она удаляет тематические привязки и оставляет сигнал на уровне стратегии. Производственная конфигурация сохраняет стабильность при более грубых настройках: остается в диапазоне от 12 до 19, а силуэт находится в диапазоне –. Она не схлопывается в мегакластеры..
Выводы по результатам абляционного исследования.
Мы выбираем производственную конфигурацию для обеспечения валидности конструкта и стабильности, а не потому, что она максимизирует silhouette. Оба абляционных исследования указывают на одно и то же направление. Универсальный кодировщик парафразов превосходит SPECTER2 ( silhouette ), поскольку априорное цитирование в SPECTER2 опирается на тематику, а не на сходство стратегий, необходимое в данном случае. Доменно-независимые переписывания показывают равные результаты с базовыми полями по показателю silhouette при выбранных настройках, но позволяют избежать коллапса при соседних настройках..
Вариант с базовым полем платит за связность не той валютой: он может достичь высокого силуэта за счет формирования тематических кластеров. Переписывание на этапе 2 устраняет эти тематические якоря и сохраняет устойчивость при изменении гранулярности, не жертвуя качеством кластеров. Таким образом, Production является единственной конфигурацией, кластеры которой поддерживают таксономию ideation-pattern из §6, оставаясь при этом стабильными при проходе HDBSCAN..
12 Обсуждение
12.1 Эмпирические выводы
Приведенные выше анализы подтверждают четыре утверждения. Пятое утверждение подтверждается только на этапе формирования идеи и остается открытым для проверки человеком..
(i) Пространство стратегий является общим, а не стратифицированным. Повторная кластеризация пула Reject изолированно (§10) воспроизвела тот же словарь из 15 паттернов, а не отдельное пространство. Таким образом, сигнал, отделяющий принятые работы от отклоненных, заключается не столько в выборе стратегии, сколько в ее реализации. Условия успеха и виды отказов для каждого паттерна несут в себе это различие. Единственное систематическое расхождение заключается в том, что изолированные кластеры Reject смещаются в сторону направлений audit/unify и удаляются от конструктивных направлений. Это говорит о том, что неудачные конструктивные действия могут выглядеть как действия audit/unify, если их лишить конструкции, которая их определяет..
(ii) Ось «Устный доклад — Отклонено» является плоской на уровне основных паттернов; «Программный комитет — Сообщество» является более сильным дискриминатором. В разрезе гранулярности (§7) «какие паттерны» вносят лишь незначительный основной вклад в принятие. «Насколько хорошо они сочетаются» вносит более существенный вклад. Это тот разрыв, на который направлен этап аудита навыка. Почти ортогональная ось , противопоставляющая паттерны, предпочитаемые программным комитетом, и паттерны, предпочитаемые сообществом, является более широкой и выступает в качестве отдельного второго сигнала. Аудит выявляет этот сигнал независимо от прогнозирования принятия. Однако это более мягкая из двух осей: статьи HC происходят из отдельно курируемого набора с высоким уровнем цитирования, а не из решений OpenReview, поэтому мы приводим только в и не учитываем его в других местах, а реконструкция HC на основе перцентилей цитирования, согласованных с решениями, позволила бы ему иметь такой же вес, как и «Устный доклад — Отклонено».
(iii) Методологии широки по охвату, но концентрированы по эффекту. Большинство паттернов охватывают большинство из 28 индуцированных доменов (§8.3). Тем не менее, один и тот же паттерн демонстрирует сильно различающиеся показатели Oral в разных доменах (Рис. 10b). Наиболее четким кросс-доменным сигналом Oral является Characterize a Limit, Then Surpass It. Для данного навыка это означает, что показатели домен-ячейка должны быть представлены как контекст аудита, а не загружены в качестве априорных данных генерации..
(iv) Композиция является нормой, при этом выступает эмпирической модой. Многометочная классификация на уровне статей (§6.5) показывает, что размер композиции не разделяет классы принятия: во всех трех. Содержание композиции имеет большее значение. Таким образом, навык объединяет от одного до трех паттернов, выбранных на основе соответствия «узкому месту», по умолчанию используя два, вместо ранжирования паттернов по априорным вероятностям принятия..
(v) Частично закрытый: валидность выполнения на конечной точке навыка. Анализ конструктной валидности в §11 показывает, что цепочка кластер–паттерн–карточка внутренне согласована и стабильна при переборе параметров HDBSCAN. Анализ только отклоненных элементов показывает, что каждый кластер, состоящий только из отклоненных элементов, отображается в таксономию. Раздел 14 добавляет оценку конечной точки: при вызове во время вывода и слепой оценке двумя автоматизированными навыками идеи IdeaSpark получают наивысшие баллы качества среди четырех источников. Открытым остается вопрос валидации на основе человеческого суждения экспертами-рецензентами, результатов реализации и результатов принятия..
От таксономии к системе.
Таксономия является необходимым условием для системы навыков, но она также представляет собой самостоятельный результат работы. Она имеет два непосредственных применения. Исследователь может сравнить предлагаемую идею с 15 паттернами генерации идей и определить, каким условиям успеха соответствует черновик. Рецензент также может указать на конкретный тип сбоя, например «комбинация, неотличимая от суммы частей». Система навыков в §13 обеспечивает практическую реализацию обоих способов применения внутри каркаса LLM..
13 Дизайн IdeaSpark
Мы создаем IdeaSpark, чтобы превратить эмпирический субстрат в разделах 6–10 в запускаемый рабочий процесс генерации исследовательских идей. В этом разделе описываются границы его выполнения, поток доказательств, контракты фаз, логика аудита, поверхность вывода и механические валидаторы. Качество итоговой идеи оценивается отдельно автоматизированными судьями в разделе 14. Оценка качества людьми и повторное открытие на отложенных данных остаются задачами для будущих исследований..
13.1 Позиционирование и двухуровневая архитектура
Данный навык преобразует недостаточно конкретизированное направление исследования в предложение, ориентированное на рецензента. Успешное выполнение возвращает пакет артефактов, сфокусированный на компактной карточке идеи. Карточка содержит обоснование, ход метода, основное утверждение, прогноз фальсификации и проверку осуществимости. Один ввод пользователя приводит к одному из трех результатов: пакету карточек идей, диагнозу do_not_generate, когда направление не может быть обосновано, или отчету phase_3_failed, когда аудит отклоняет кандидата. Навык никогда не задает вопросы пользователю в процессе выполнения. Отсутствующий контекст выводится, когда это разумно; неисправимая двусмысленность становится явным условием остановки..
Этот навык не является рекомендателем паттернов генерации идей, планировщиком экспериментов или автором статей. Он не предлагает наборы данных, базовые модели, матрицы абляции, ожидаемые рисунки или календарный план. Эти решения зависят от контекста пользователя, к которому навык не имеет доступа. Он создает идею плюс честную оценку ее осуществимости; эмпирическая инженерия остается ответственностью пользователя..
IdeaSpark реализован как двухуровневый навык. Уровень исполнения содержит компактные инструкции, логику оркестрации, хуки извлечения, фазовые промпты, скрипты рендеринга и детерминированные валидаторы. Уровень доказательств содержит 15 карточек паттернов генерации идей, 31 карточку подпаттернов, матрицу доменов по паттернам, записи о насыщении и инвентарь режимов отказа, полученный из корпуса. Доказательства считываются постепенно. Фаза 2 считывает только определения паттернов и тактики подпаттернов, необходимые для создания кандидата. Фаза 3 считывает режимы отказа, контекст антипаттернов и доказательства коллизий для аудита. Фаза 4 считывает результаты аудита для пояснения финальной карточки. Необработанные счетчики и флаги достоверности остаются аналитическими метаданными для читателей. Они не используются в качестве априорных данных для генерации..
13.2 Принципы проектирования
Основная позиция навыка заключается в том, что пригодная для публикации исследовательская идея конструируется, а не изобретается с нуля. Цепочка рассуждений состоит из трех шагов. Во-первых, прочитать недавнюю литературу в области пользователя и выявить структурный пробел, который не закрывает ни одна из найденных статей: узкое место. Во-вторых, использовать словарь паттернов генерации идей, чтобы задаться вопросом, какой исследовательский ход мог бы закрыть этот пробел. В-третьих, воплотить выбранный ход в конкретный механизм. Субстрат из 15 паттернов и 31 подпаттерна предоставляет словарь для второго шага. Это удерживает генерацию на уровне применения паттерна к пробелу, а не неконтролируемого мозгового штурма..
Принцип 1: Сначала литература, затем терминология, в третью очередь — идея.
Идентификация «узких мест» должна быть основана на извлеченных статьях, а не на воспроизведении модели по памяти. Выбор паттерна считывает форму нерешенного пробела и определяет, какой операционный шаг позволит его закрыть. Инстанцирование идеи затем использует выбранный подпаттерн в качестве тактического руководства. Оно применяет абстрактный ход к конкретному пробелу, а не копирует шаблон, специфичный для отдельной статьи..
Принцип 2: Существенный вклад важнее методологических ярлыков.
Кандидат не может защищать свою позицию аргументом «мы используем паттерн генерации идей X, в то время как в предыдущих работах использовался паттерн Y». Выбор метода — это процесс. Вкладом является то, что кандидат выводит, конструирует, измеряет или уточняет, чего не было в предыдущих работах. Это обеспечивается за счет дельт дифференциации и последующих аудиторских проверок. 15 паттернов — это диагностический словарь, а не само по себе утверждение о вкладе..
Принцип 3: Свобода генерации, привязка к аудиту.
Более ранние итерации накладывали слишком много ограничений, производных от корпуса, на процесс генерации. Это смещало кандидатов в сторону частых ходов в корпусе и в сторону от «узкого места» пользователя. Текущая архитектура сохраняет словарь позитивных паттернов в Phase 2, но переносит негативные и частотные сигналы на этапы аудита и объяснения. Phase 3 проверяет, выдерживает ли кандидат известные типы сбоев. Он не отклоняет кандидата только потому, что его паттерн является распространенным..
Эти выборы следуют из эмпирического субстрата. Отклоненные статьи часто используют те же операторы стратегии, что и принятые, поэтому таксономия служит словарем для мышления и аудита, а не жестким фильтром генератора. Поскольку является модальной композицией на уровне статьи, с «хвостом» на , Фаза 2 допускает от одной до трех записей закрытия пробелов. Поскольку некоторые двусторонние комбинации приводят к отклонению, если последующий артефакт не представлен содержательно, Фаза 3 включает проверку антипаттерна содержательной верификации. Поскольку принятие зависит от предметной области, информация о насыщении и ландшафте предметной области выводится как контекст аудита и объяснения, а не как априорные рекомендации..
13.3 Рабочий процесс и контракты фаз
Данный навык рассматривает 15 индуцированных паттернов генерации идей как диагностический словарь, а не как метки, которые кандидат должен классифицировать. Путь продвижения объединяет фазы логического вывода модели с детерминированным поиском, рендерингом и этапами валидации. Путь пересмотра добавляет один ограниченный шаг исправления. Это исправление ограничено целями аудита и побайтовым сохранением обязательств кандидата по аварийному отключению..
13.3.1 Фаза 0: Обоснование на основе литературы
Фаза 0 формирует широкий пакет обоснования на основе литературы. Это единственная фаза, которая извлекает контекст на уровне области. Более поздний поиск на Фазе 3.1 является более узким: он проверяет наличие коллизий на уровне механизмов с сгенерированным кандидатом.
Система преобразует пользовательский запрос в несколько поисковых запросов, проверяет доступность коннекторов и опрашивает четыре источника. Каждый источник используется для той роли, с которой он справляется лучше всего. arXiv предоставляет свежие препринты. OpenReview предоставляет перспективные сигналы по материалам, находящимся на рецензировании. OpenAlex предоставляет широкий граф опубликованных статей. Semantic Scholar предоставляет метаданные и краткие аннотации, сфокусированные на CS. arXiv и OpenReview охватывают недавний период от 0 до 6 месяцев. OpenAlex и Semantic Scholar охватывают период от 6 до 24 месяцев..
Это разделение является преднамеренным. Ни один источник не обладает всеми четырьмя преимуществами: актуальностью препринтов, сигналами о прохождении рецензирования, широтой охвата и наличием четких перекрестных идентификаторов для дедупликации. Каждый источник опрашивается там, где он наиболее эффективен. Два временных окна не перекрываются. Статья, которая появляется одновременно как недавний препринт и как заявка на рецензирование, учитывается один раз, что позволяет избежать завышенных показателей насыщения паттернов на Фазе 1.
Затем полученные статьи проходят процедуру дедупликации по источникам и снабжаются легкими тегами с паттернами генерации идей ⟦BROKEN_K0⟧ для последующего анализа. Сразу после составления таблицы литературы Phase 0+ извлекает небольшой кэш полных текстов для наиболее релевантных ссылок. Phase 1 жестко ограничивает работу этим кэшем, поэтому конвейер не может незаметно деградировать до рассуждений, ограниченных только аннотациями..
Два уточнения повышают надежность поиска. Для обеспечения полноты поиска сопоставление по ключевым словам дополняется семантическим проходом, который находит концептуально близкие статьи с минимальным пересечением поверхностных слов. Этот проход ограничен предметной областью результатов по ключевым словам, поэтому более широкий поиск не включает статьи из других областей. В противном случае дрейф терминологии скрыл бы близких конкурентов. Для точности чтения система извлекает полнотекстовые версии в открытом доступе, где это возможно. Суждения об узких местах и дифференциации могут тогда основываться на разделах с описанием методов, а не только на аннотациях..
Общая цель состоит в том, чтобы каждая последующая проверка (узкое место, цитирование, коллизия) была привязана к извлеченной записи, а не к памяти LLM..
13.3.2 Фаза 1: Идентификация узких мест
Фаза 1 сначала проверяет, что Фаза 0 создала корректный пакет обоснования, а Фаза 0+ создала кэш полнотекстовых документов. Затем она считывает указания пользователя, извлеченные записи, аннотации и кэшированные фрагменты полного текста. Ее основным результатом является один обоснованный литературой «узкий участок»: конкретный структурный пробел, а не тематическая метка. Она также называет наиболее близкие смежные статьи, объясняет, что в каждой из них остается нерешенным, перечисляет пробелы, которые Фаза 0 не закрыла, и суммирует использование паттернов в тематических статьях. Эти диапазоны использования являются описательными, а не временными. Паттерн считается насыщенным, когда он доминирует в окрестности, неисследованным, когда он встречается не более одного раза, и среднечастотным в остальных случаях. Резюме передается далее исключительно в качестве контекста для аудита и пояснений..
Для сравнения пробелов на общей основе, Фаза 1 организует окрестность в дерево метода-родословной. Каждый извлеченный метод представляет собой узел, связанный с более ранним методом, который он уточняет или заменяет. Дерево простирается от фундаментальных предков до текущих листьев. Когда недавнее окно извлечения пропускает более старого предка, модель может добавить его в качестве узла только для осведомленности, явно помеченного как не подлежащий цитированию. Это разделение является преднамеренным. Окно является недавним, потому что обоснование на переднем крае наиболее важно именно там, а память модели там наименее надежна. Более старые фундаментальные методы более стабильны. Поскольку узлы только для осведомленности не претендуют на новизну, они служат защитой от регрессии, а не доказательством. Правило против фальсификации сохраняет дерево неглубоким на подлинно молодых линиях, вместо того чтобы дополнять его вымышленными предками..
Дерево раскрывает три вещи, которые не может передать плоский абстрактный список. Аддитивные пробелы находятся в листе: это неудовлетворенная потребность, которую не достигает ни один из существующих методов. Субтрактивные пробелы считываются от общего предка: это несущее предположение, которое наследует каждый лист. Эти пробелы важны, потому что сильные статьи часто удаляют предположительно необходимый механизм, а не добавляют еще один компонент. В-третьих, дерево блокирует регрессию. Предлагаемое исправление, которое предок уже реализовал, рассматривается как вытесненное, а не как новое. На протяжении всего процесса чтение ограничено доказательствами. Субтрактивное открытие может называть только то предположение, которое фактически демонстрируют извлеченные методы.
Путь выхода из Фазы 1 бинарен: продолжить или остановиться с диагностическим сообщением. Фаза 1 никогда не запрашивает у пользователя недостающую информацию. Она выводит разумные значения по умолчанию, например, бюджет на облачные вычисления для одного исследователя, если он не указан. Она останавливается только в том случае, если направление слишком широкое, не имеет опоры в литературе или найденный массив данных слишком скуден для обоснования «узкого места». Два структурных пути охватывают примерно 75–85% типов Oral в корпусе (теория с переосмыслением, закон масштабирования, хирургическое исправление с теорией, аудит валидности оценки и большинство эмпирических Orals); построение бенчмарков и чисто системные или инфраструктурные направления пока не являются отдельными триггерами и в настоящее время разрешаются через один из двух путей, при этом подтип указывается только в качестве диагностического объяснения. Добавление для них выделенных триггеров — это локализованное расширение, которое повысило бы охват, не меняя архитектуру..
13.3.3 Этап 2: Генерация идей на основе паттернов
Фаза 2 отделяет выбор паттерна от генерации кандидатов. Это разделение важно: первый шаг определяет, какой исследовательский ход, основанный на корпусе данных, может устранить выявленный пробел, в то время как второй шаг воплощает этот ход в виде конкретного кандидата.
Выбор паттерна. Система выбирает один опорный пробел из Фазы 1 и оставляет только те смежные пробелы, которые могут правдоподобно сформировать единую статью вместе с ним. Для каждого сохраненного пробела система считывает 15 основных карточек паттернов генерации идей и выбирает тот паттерн, чья операционная сигнатура структурно закрывает этот пробел. Частота и насыщенность паттернов записываются в качестве аудиторного контекста, но они не выступают в роли априорных данных для генерации..
Генерация кандидатов. Для каждого выбранного основного паттерна система выбирает один подпаттерн и считывает его тактические панели в качестве руководства. Результат представляет собой не просто заголовок или тему. Он содержит основной механизм, обоснование закрытия каждого пробела, отличие от ближайших смежных работ, вычислительный бюджет и прогноз фальсификации, указывающий на то, что должно измениться, если механизм является реальным..
Наконец, кандидат проходит через детерминированный подшаблонный шлюз цитирования ⟦BROKEN_K0⟧. Шлюз проверяет, что каждый цитируемый подшаблон существует в рамках указанного родительского шаблона, прежде чем будет запущен какой-либо ресурсоемкий поиск коллизий или аудит ⟦BROKEN_K1⟧.
13.3.4 Этап 3: Контроль качества ⟦K0⟧
Фаза 3 состоит из трех этапов: целенаправленный поиск литературы, аудит на основе корпуса и опциональная доработка.
Во-первых, система повторно запрашивает литературные источники, используя термины, извлеченные из механизма и утверждения кандидата. Этот поиск отделен от Фазы ⟦BROKEN_K0⟧, поскольку он направлен на поиск недавнего совпадения механизмов, а не на широкий контекст области..
Во-вторых, аудит считывает кандидата, выбранные пробелы, соответствующие карточки подшаблонов, пул доказательств Фазы 0, новые совпадения при столкновениях и инвентарь антишаблонов. Он выполняет четыре проверки: уроки по отклонению закрытия пробелов, применение рецептов, содержательную верификацию антишаблонов и угрозы, указанные в статье. Он возвращает один из трех вердиктов: продвижение, пересмотр или отказ, а также конкретные цели для пересмотра. Аудит только оценивает; он не редактирует кандидата..
В-третьих, и только когда возможна доработка, отдельный этап применяет именованные правки или замены в рамках подшаблона с тем же родительским элементом. Он не пересматривает вердикт, не меняет выбранные пробелы и не затрагивает обязательства по аварийному завершению. Разделение оценки и исправления позволяет отделить поиск атаки от устранения атаки и сохраняет привязку каждого режима отказа к доказательствам из корпуса..
Детали аудита фазы 3.
Аудит представляет собой этап единичного суждения. Он выполняет четыре проверки, опирающиеся на корпус данных, применяет двухуровневый вердикт и выдает цели для пересмотра, когда возможна ограниченная корректировка. Каждая проверка требует конкретных доказательств из найденной литературы, карточек подшаблонов или перечня антишаблонов. Это делает аудит проверяемым и устойчивым к формальному одобрению. Аудит оценивает, проходит ли кандидат проверку на известные типы сбоев. Он не является гарантией новизны, принятия или качества конечной идеи..
Проверка 1: сканирование отклонения с ограниченным закрытием пробелов ⟦K0⟧.
Что это выявляет: кандидатов, которые выглядят новыми со стороны, но подпадают под задокументированные в корпусе шаблоны отклонения, специфичные для выбранной тактики. Для каждого предложенного закрытия пробела аудит считывает панель режимов сбоев соответствующего подшаблона и уроки отклоненных статей. Он оценивает, явно ли кандидат избегает урока, явно ли соответствует ему или находится в пограничном состоянии, и он должен процитировать компонент кандидата, который вызывает опасения..
Проверка 2: применение рецепта.
Что это выявляет: кандидатов, которые ссылаются на реальный подшаблон, но реализуют лишь общую идею его родительского шаблона, а не отличительный прием кластера, что является основной причиной инкрементального вывода. В отношении панели характерных приемов карточки цитируемого подшаблона аудит проверяет, действительно ли основной механизм выполняет этот прием или лишь имитирует родительский; отсутствие приема означает, что кандидат пропущен. Это семантический предохранитель, который не может обеспечить детерминированный шлюз цитирования (§13.3): шлюз доказывает лишь то, что цитирование относится к реальному кластеру в рамках правильного родителя, но никогда не доказывает, что механизм реализует тактику кластера..
Проверка 3: антипаттерн содержательной верификации.
Что это выявляет: смягчающие меры, перегруженные ключевыми словами, и кандидатов, чей основной механизм содержит правильные фразы для смягчения последствий, не создавая при этом артефакт, который эти фразы обозначают. Если кандидат использует одну из композиций с двумя шаблонами, обогащенными отклонениями, описанными в разделе 6.3, аудит проверяет, что требуемая мера по смягчению последствий фактически реализована в механизме, а не представлена только формулировками в ответе кандидата..
Проверка 4: угроза, указанная в статье.
Что это выявляет: кандидатов, чье утверждение уже поглощено конкретной недавней статьей, независимо от того, была ли она найдена с помощью широкопрофильных запросов Фазы 0 или с помощью механизма поиска коллизий по конкретным механизмам Фазы 3. Если найдена статья, которая поглощает утверждение кандидата или конкурирует с ним, аудит выдает угрожающую статью, аргумент о поглощении из одного абзаца со ссылкой на конкретный результат угрозы, а также примечание о том, что именно должно быть изменено. Если после добросовестного поиска угроза, подкрепленная статьей, не обнаружена, отсутствие таковой является законным сигналом к допуску; фабрикация общей угрозы для заполнения аудита запрещена..
Почему насыщение здесь не ограничено ⟦K0⟧.
Более ранняя версия проекта включала пятую проверку защиты от насыщения. Мы удалили её, поскольку она не опиралась на извлеченные связанные работы. Это был рекомендательный априорный критерий, а не факт, подкрепленный корпусом данных, и поэтому он не должен был находиться рядом с четырьмя вышеуказанными жесткими проверками. Насыщение паттернов по-прежнему вычисляется на Фазе 1 и фиксируется на Фазе 2. Теперь оно проявляется на последующих этапах как замечание рецензента на Фазе 4, а не как ограничивающий фактор аудита. Это позволяет сохранить привязку каждой проверки Фазы 3 к извлеченным доказательствам..
Двухуровневый вердикт.
Вердикт имеет два уровня. Уровень 1 — это жесткое ограничение, которое модель не может обойти. Она отбрасывает кандидата, когда урок отклонения четко совпадает, когда в композиции с расширенным отклонением нет вставляемого смягчения или когда в недавней статье есть точное совпадение механизмов. Уровень 2 — это суждение модели в пределах безопасной зоны, которую оставляет Уровень 1. Она выбирает продвижение или переработку в зависимости от того, затрагивают ли пограничные выводы несущие структурные свойства. Обход применения рецепта всегда направляет к переработке: либо переключиться на родственный подшаблон, чей ход механизм фактически выполняет, либо переработать механизм для выполнения цитируемого хода. Если ни то, ни другое не подходит под одного и того же родителя, выполнение возвращается к регенерации Фазы 2, а не к исправлению на месте. Вердикт должен цитировать конкретные результаты проверки; «все проверки пройдены» без указания хотя бы одной из них является процедурной ошибкой..
13.3.5 Этап 4: Расширение, аудит реализуемости, визуализация и валидация
Этап 4 превращает кандидата в итоговый набор артефактов карточки идеи. Он расширяет канонического кандидата, проводит аудит реализуемости по умолчанию, визуализирует дополнительные артефакты, а затем запускает детерминированные валидаторы. Расширение извлекает мотивацию, ход метода, осуществимость, опасения рецензентов, отличие от литературы и объяснение предметной области из кандидата и отчета аудита Этапа 3..
Аудит реализуемости представляет собой единичный ограниченный вызов LLM. Для каждого этапа метода он указывает, как этот этап реализовать, и отмечает все, что осталось недостаточно определенным. Он записывается в отдельный файл. По своей структуре этот файл не может содержать защищенные обязательства по фальсификации и вычислительному бюджету. Таким образом, аудит добавляет детали о возможности реализации, не изменяя само утверждение. Если при выполнении он пропускается, валидаторы реализуемости не активируются..
Рендеринг — это детерминированное создание шаблонов. Рендерер формирует артефакты Markdown и LaTeX, а также компилирует PDF при наличии локального движка TeX. Поскольку шаблоны фиксированы, валидаторы могут сравнивать защищенные обязательства с кандидатом до рендеринга и проверять наличие необходимых разделов до того, как пользователь увидит карточку..
Валидация этапа 4.
Набор детерминированных валидаторов запускается вокруг пути рендеринга Phase 4 для проверки контрактов, утвержденных на более ранних этапах. Они механические. Они обнаруживают нарушения посредством сравнения точного текста, наличия разделов, длины списков, покрытия схем, проверок читаемости и согласованности цитирования, а не на основе суждений модели..
Целостность аварийного выключателя (жесткий отказ).
Прогноз фальсификации кандидата и вычислительный бюджет должны сохраняться от начальной генерации кандидата до финального рендеринга. Цепочка валидации зависит от пути вердикта: прямое расширение при продвижении аудита или пересмотренный кандидат с последующим расширением, когда аудит запрашивает ограниченное исправление. Этапу пересмотра в Фазе 3 запрещено изменять эти два обязательства. Валидатор выявляет любое отклонение механически, а не полагаясь на соблюдение промпта..
Полнота расширения (критическая ошибка ⟦K0⟧).
Расширение фазы 4 должно содержать структурные разделы, от которых зависит визуализация карточек идей: мотивацию с несколькими точками остановки предыдущих работ, этапы потока методов, проверку осуществимости с вердиктами на уровне компонентов и общими вердиктами, непустое резюме предложения, основное утверждение и подпункты. Проверка заключается в наличии разделов и длине списков. Отсутствие является критическим сбоем, поскольку недостающие разделы привели бы к незаметному отображению пустого содержимого в итоговых артефактах..
Дополнительные проверки контрактов.
Три дополнительных валидатора ужесточают контракты конвейера. subpattern_citation_consistency запускается сразу после Фазы 2.2 и до начала любой работы на Фазе 3. Он проверяет, что каждый процитированный подшаблон соответствует реальному кластеру в рамках указанного родительского шаблона. implementability_completeness подтверждает, что аудит охватывает каждый шаг метода, выполненный на Фазе 4.1.5. implementability_readability помечает известные регрессии читаемости в тексте стандартизированного регистра для оценки возможности реализации..
То, что не проверяют валидаторы.
Они не обеспечивают семантическую корректность внутри раздела, не проверяют, является ли утверждение кандидата действительно новым, и не обеспечивают детерминизм при повторных запусках. Вызовы фаз представляют собой шаги LLM-рассуждений с ненулевой дисперсией, поэтому один и тот же запрос может приводить к различным, но согласованным кандидатам в разных запусках; это ожидаемое свойство навыка на этапе вывода, а не дефект, и представление распределений по результатам повторных запусков или выбор на основе ансамбля начальных чисел сделали бы эту дисперсию явной (§15).
13.4 Поверхность вывода
Результат для пользователя намеренно сокращен до трех аспектов, по которым читатель судит в первую очередь: название, мотивация и метод. Более ранняя, расширенная карточка содержала зацепку, утверждения, опровержения и источники вместе. Эта версия скрывала идею под собственным журналом аудита. Текущая карточка выпускается на английском и китайском языках. Более объемный материал остается в пакете артефактов: зацепка, резюме от проблемы к результату, явные утверждения, вердикты о реализуемости, дельты отличий от литературы, замечания рецензентов и ответы на них, а также заметка о разборе литературы. Это позволяет инспектору проследить, почему кандидат прошел отбор, не превращая карточку в дамп аудита..
Прогноз фальсифицируемости представляет собой один абзац, в котором называются минимальный эксперимент и метрики, которые должны измениться. Он дает качественное направление, но не содержит заранее установленных числовых порогов. Когда кандидат выдвигает утверждение о механизме, схема требует наличия одной несущей переменной: величины, поведение которой подтверждает данное утверждение. Она также требует вмешательства с отрицательным контролем, прогнозируемый эффект которого направлен на результат последующей задачи, а не на определяющее преобразование самой переменной. Это предотвращает повторяющуюся ошибку самоподтверждения: «воздействовать на так, чтобы стало равным нулю». Это проверяет определение, а не механизм. Привязка контроля к независимому последующему эффекту делает утверждение фальсифицируемым. Дифференциатор обязателен для кандидатов на механизм и необязателен для чистых кандидатов типа «работает ли это?». Выходные данные исключают экспериментальные матрицы, планы абляции, таблицы базовых показателей, ожидаемые рисунки и календарные прогнозы. Они относятся к экспериментальной инженерии пользователя, а не к идее, которую генерирует навык..
13.5 Верность: противодействие галлюцинациям
Основное возражение против генерации идей с помощью LLM заключается в фабрикации: вымышленные цитаты, статьи, цифры или детали методов, утверждаемые с ложной уверенностью. IdeaSpark распределяет свои механизмы защиты по этапам, описанным в §13.3. Обеспечиваемое свойство просто: каждое значимое утверждение либо прослеживается до извлеченной записи, либо явно помечено как не имеющее таковой..
Обоснование на основе памяти.
Поиск не остается на усмотрение модели. Фаза 0 следует фиксированному пути оркестрации, а не встроенному в контекст инструменту, который модель могла бы заменить воспроизведением по памяти. Фаза 1 отказывается запускаться до тех пор, пока не будут предоставлены пакет обоснования и кэш полного текста, поэтому «узкое место» не описывается только на основе аннотаций или памяти. Дерево происхождения методов распространяет ту же дисциплину назад во времени. Предки, предоставленные из памяти модели, входят только как узлы, не подлежащие цитированию и предназначенные исключительно для ознакомления. Они не претендуют на новизну. Субтрактивный пробел может указывать только на допущение, которое фактически демонстрируют извлеченные методы..
Достоверность цитирования.
Детерминированный шлюз проверяет каждую цитату подшаблона при написании кандидата. Он останавливает выполнение при обнаружении галлюцинированного родительского элемента, неверно классифицированного подшаблона или вымышленного имени до того, как будут затрачены дорогостоящие ресурсы на извлечение в Phase 3. Карточки шаблонов содержат уроки, не зависящие от конкретных статей, без идентификаторов для каждой статьи. Это устраняет, а не просто контролирует, область, в которой мог бы быть галлюцинирован paper_id. Пройденный аудит может правомерно сообщить об отсутствии угроз; фабрикация общей угрозы для заполнения поля запрещена..
Достоверность утверждений.
Два защитных механизма ограничивают собственные утверждения кандидата. Количественные заявления о прогнозируемом поведении, такие как скорость, показатель степени или константа масштабирования, должны быть перепроверены на соответствие статьям с аналогичными параметрами в кэше полных текстов. Утверждение должно либо соответствовать этому значению, либо указывать на различие режимов. Это устраняет повторяющуюся ошибку вставки числа, полученного в несовместимых режимах. Два поля аварийного завершения, прогноз фальсификации и вычислительный бюджет, сохраняются в неизменном байтовом виде от генерации до рендеринга с помощью жесткого валидатора. Модель не может незаметно смягчить утверждение, которое делает идею проверяемой..
Честное воздержание.
Когда доказательства не подтверждают предложение, выполнение останавливается с отчетом do_not_generate или phase_3_failed, вместо того чтобы генерировать результат вопреки этому. Когда аудит реализуемости доходит до несущей детали, которую невозможно предоставить без догадок, он фиксирует эту деталь как открытое решение автора. Честный пробел в знаниях ценится выше, чем беглый заполнитель..
В совокупности эти механизмы превращают «не галлюцинируй» из инструкции, которую модель может проигнорировать, в свойство, обеспечиваемое шлюзами поиска, детерминированными валидаторами и дисциплиной отслеживания источников..
14 Оценка: Качество и новизна сгенерированных идей
В этом разделе приводится автоматизированная оценка конечных точек. В нем IdeaSpark сравнивается с базовыми моделями по двум осям: качество и новизна, с использованием двух вспомогательных навыков оценивания вместо экспертов-людей. Основной результат заключается в двух аспектах. Во-первых, при сопоставимой длине и формате, в условиях слепого тестирования, карточки идей IdeaSpark получают значительно более высокие оценки качества, оставаясь при этом конкурентоспособными по уровню новизны. Во-вторых, оценка только по новизне вводит в заблуждение. Исследование выявляет режим отказа «новизна без содержания», при котором идея кажется высокооригинальной из-за того, что она слишком расплывчата, чтобы противоречить предшествующему уровню техники. Поэтому мы рассматриваем плоскость «качество–новизна» в качестве основного показателя. Как обсуждалось в §15, оба судьи представляют собой навыки на базе LLM, поэтому данное исследование является оценкой с помощью автоматизированных судей, а не исследованием принятия людьми..
14.1 Сравниваемые системы
Мы сравниваем четыре источника идей на общем наборе проблемных направлений (Таблица 10). Точки сравнения образуют лестницу контрольных параметров вокруг IdeaSpark. IdeaSpark — это система, описанная в данном отчете. Opus-self-gen — это общий навык генерации идей, автоматически созданный автором навыков Opus, без опоры на корпус данных. Сравнение его с IdeaSpark позволяет изолировать эффект нашего навыка, основанного на корпусе данных, от эффекта простого наличия некоторого структурированного навыка. Opus-4.8 (bare) — это единый промпт без навыка и без поиска. IdeaSpark, Opus-self-gen и Opus-4.8 (bare) работают на одной и той же основе Opus 4.8-high. Вместе они образуют лестницу на одной основе: базовая модель, общий автоматически созданный навык и навык, основанный на корпусе данных. GPT-5.5 (bare) — это второй базовый контрольный показатель из другого семейства моделей, включенный для отделения эффектов, специфичных для основы, от эффектов навыков..
| Source | What it is | Skill | Retrieval |
|---|---|---|---|
| IdeaSpark | This report’s method; corpus-grounded multi-phase skill, on Opus 4.8 high | ✓ | ✓ |
| Opus-self-gen | Generic ideation skill auto-authored by an Opus skill-creator (no corpus grounding), run on Opus 4.8 high: live web search cross-paper gap idea | ✓ | ✓ |
| Opus-4.8 (bare) | Bare Opus 4.8 high: single prompt, no skill, no retrieval | — | — |
| GPT-5.5 (bare) | Bare GPT-5.5: single prompt, no skill, no retrieval (different model family) | — | — |
14.2 Источники проблем: 100 методологически нейтральных направлений с ICLR 2026
Каждую систему просят сгенерировать одну идею на каждый исходный ⟦BROKEN_K0⟧. Мы формируем 100 ⟦BROKEN_K1⟧ на основе принятых устных докладов ICLR 2026, полученных через OpenReview API. ICLR 2026 выбран намеренно: он датирован позже индукционного корпуса (2021–2025) и предполагаемых данных обучения генераторов и судей. Таким образом, ⟦BROKEN_K2⟧ выступают в качестве перспективного отложенного теста, а не упражнения по переоткрытию..
Чтобы избежать утечки собственного решения каждой статьи в промпт, каждый seed представляет собой переписанный вариант, не зависящий от метода, который генерируется исключительно на основе заголовка. Переписанный вариант сохраняет объект предметной области и задачу или возможность, но удаляет суффиксы методов и любую диагностику «узких мест», полученную из аннотации. Например, заголовок статьи, содержащий конкретный механизм для физического реализма в видео, превращается в seed «новая исследовательская идея в области ML о физическом реализме в моделях преобразования текста в видео». Для каждой статьи генерируется один seed, который проверяется на наличие утечек. Полученные seeds обозначают проблему, над которой нужно работать, не давая подсказок о том, как именно..
14.3 Нормализация вывода (контроль смешивающихся факторов)
Оценки качества и новизны чувствительны к поверхностным искажающим факторам, поэтому все четыре источника приводятся к единому стандарту оформления перед оцениванием. Каждая идея преобразуется в документ формата Markdown из трех разделов: Название, Обоснование и Метод. Объем Обоснования ограничен словами, а Метод — словами, что соответствует распределению длины исходных статей ICLR Oral. Это устраняет влияние длины и многословности, которые в противном случае поощряли бы более объемные тексты..
Каждый метод должен также включать формальные уравнения с интерпретацией для каждого из них. Это требование соответствует стилю исходных статей и ставит расплывчатую прозу и точную формализацию на один уровень. Цель состоит в том, чтобы заставить судей оценивать суть, а не поверхностную техничность. Мы также удаляем защищенные аннотации «решение автора» с карточек IdeaSpark перед выставлением оценок. Эти аннотации являются честными индикаторами нерешенных проектных задач, но ни один другой источник их не выдает. Оставление их на месте наложило бы асимметричный «налог на честность»; контролируемое сравнение в §14.7 количественно оценивает этот эффект..
14.4 Два автоматических судьи
Качество: ⟦K0⟧ качество идей навык.
Качество оценивается автономным навыком, который судит об идее исходя из фундаментальных принципов по трем осям, каждую из которых можно оценить без проведения экспериментов. Эти оси: (A) позиционирование проблемы — является ли выявленный пробел реальным, важным и неочевидным, а не легкой целью; (B) качество метода, разделенное на глубину, обоснованность и осуществимость, где глубина является доминирующей; и (C) соответствие проблемы — действительно ли метод закрывает заявленный пробел. Навык требует цитируемой фразы в качестве доказательства для каждой оценки по оси. Он оценивает содержание, а не объем или беглость речи, и применяет фильтр A/C, чтобы сильный метод для тривиальной проблемы не мог получить высокий рейтинг. Для сравнения он работает в посписочном режиме, ранжируя несколько идей для одного и того же исходного материала друг относительно друга, не зная источника. Относительные суждения менее шумные, чем абсолютные оценки..
Новизна: ⟦K0⟧ проверка на эксклюзивность навык.
Новизна оценивается с помощью навыка выявления предшествующего уровня техники. Для каждой идеи навык выполняет поиск в актуальной литературе, проводит глубокое чтение наиболее близких кандидатов и сопоставляет предложенный вклад с каждой из предыдущих работ по четырем осям: постановка проблемы, основной механизм, ключевая идея и предметная область. Количество совпадающих осей отображается на пятиуровневой шкале, . Таким образом, Уровень 5 = отсутствие совпадений (наиболее новая), а Уровень 1 = совпадение по всем четырем осям (полностью заимствовано). Вердикт для идеи — это наихудший случай, или минимальный уровень, среди наиболее близких найденных предыдущих работ. Мы берем наихудший случай, а не среднее значение, поскольку одна достаточно близкая предыдущая работа может полностью заимствовать идею. Усреднение позволило бы несвязанным найденным статьям размыть решающее столкновение и завысить новизну. Чем выше значение, тем выше новизна, поэтому новизна и качество направлены в одну сторону..
14.5 Протокол и метрики
Обе оси используют слепой повторяющийся протокол для всех 100 начальных значений. Для каждого начального значения идеи четырех систем копируются в нейтральные файлы с использованием новой случайной перестановки меток. Перестановка различается в зависимости от начального значения и раунда, чтобы исключить позиционное смещение. Исходная принадлежность скрывается от судьи. Качество представляет собой списочный ранг: ранг 1 оценивается в , ранг 2 — в , ранг 3 — в , а ранг 4 — в . Новизна соответствует уровню , определенному выше..
Каждый исходный вариант оценивается в трех независимых раундах с использованием новых экземпляров судей. Для оценки качества мы приводим среднее значение по каждой системе для 100 исходных вариантов после усреднения результатов трех раундов для каждого варианта. Для оценки новизны мы приводим средний уровень по всем 300 суждениям. Оценка качества и новизны выполняется в виде отдельных проходов..
14.6 Результаты
В таблицах 11 и 12 представлены две оси. На рисунке 1 четыре системы расположены в плоскости качество–новизна. На рисунке 16 показано полное распределение уровней новизны..
| System | Quality (mean) | std | Wins / 100 |
|---|---|---|---|
| IdeaSpark | 3.87 | 0.35 | 88 |
| Opus-self-gen | 2.57 | 0.55 | 6 |
| Opus-4.8 (bare) | 2.56 | 0.57 | 6 |
| GPT-5.5 (bare) | 1.00 | 0.00 | 0 |
| System | Novelty (mean) | std | L1 | L2 | L3 | L4 | L5 |
|---|---|---|---|---|---|---|---|
| GPT-5.5 (bare) | 3.73 | 0.53 | 2 | 2 | 77 | 214 | 5 |
| IdeaSpark | 2.92 | 0.53 | 1 | 53 | 216 | 30 | 0 |
| Opus-self-gen | 2.86 | 0.50 | 1 | 59 | 222 | 18 | 0 |
| Opus-4.8 (bare) | 2.32 | 0.60 | 19 | 168 | 110 | 3 | 0 |
14.7 Анализ
IdeaSpark выигрывает по качеству.
IdeaSpark достигает наивысшего показателя качества () и занимает первое место на из начальных значений по среднему результату за 3 раунда. Ни одна другая система не превышает . Обобщенный навык, созданный автоматически, Opus-self-gen, получает , что по сути равно базовому уровню Opus-4.8, составляющему . Таким образом, один лишь структурированный навык не повышает качество идеи..
Лестница с одинаковой базовой архитектурой изолирует эффект специфического дизайна IdeaSpark. IdeaSpark, Opus-self-gen и Opus-4.8 (базовая версия) используют одну и ту же архитектуру (§14.1). Opus-self-gen также имеет функцию поиска в реальном времени. Таким образом, наблюдаемый прирост не объясняется семейством моделей или только поиском. Повышение эффективности достигается за счет карточек паттернов IdeaSpark, основанных на корпусе данных, в сочетании с многофазным рабочим процессом, закрепленным аудитом..
Одноосевая новизна вводит в заблуждение.
Если судить только по новизне, побеждает худшая система. Базовый GPT-5.5 показывает наивысший результат по новизне (, с оценками на уровне L4), но занимает последнее место по качеству (, ноль побед). Обоснования судей объясняют это несоответствие. Данная базовая модель выдает практически идентичный, не зависящий от темы шаблон — обобщенный каркас «диагностические головы + контрастные пары + маршрутизация неопределенности», который иногда отклоняется от темы. Поскольку идея расплывчата, у нее нет точного предшествующего уровня техники, с которым она могла бы вступить в противоречие, поэтому она оценивается как «новая»..”
Это режим «новое, но пустое». Он невидим для каждой оси в отдельности. Только плоскость качествоновизна (Рисунок 1) отделяет подлинную новизну, высокую по обеим осям, от пустой новизны, высокой по новизне, но низкой по качеству. Две системы, основанные на навыках, напротив, находятся в области высокого качества, сохраняя при этом средний уровень перекрытия (L3). Их идеи разделяют постановку задачи и предметную область с ближайшими предшествующими работами, но привносят особый механизм — честный и обоснованный профиль новизны..
Под-исследование калибровки (аннотации честности).
В пилотном проекте с -seed оставление аннотаций с самопометками автора IdeaSpark в карточке стоило примерно одной ранговой позиции, что привело к отставанию от базовой модели Opus-4.8. Их удаление восстановило лидерство. Эти аннотации являются мета-заметками для автора, а не частью идеи, и ни один другой источник их не генерирует. Это обосновывает нормализацию в §14.3: удаление аннотаций перед оценкой..
15 Ограничения
Каждое из приведенных ниже ограничений является лимитированным свойством текущего исследования в сочетании с конкретным следующим шагом. Ни одно из них не меняет наших утверждений, которые остаются в рамках стадии формирования идей. Они обозначают области, где дополнительные доказательства могли бы расширить эти утверждения..
Охват ограничен тремя конференциями по ML, что смещает индуцированное распределение.
Корпус полностью построен на основе результатов ICLR, ICML и NeurIPS, а также их публичных рецензий, при этом исходными данными для оценки служат все доклады ICLR 2026. Таким образом, индуцированные домены, паттерны генерации идей и неявное понимание того, что считается сильным направлением, соответствуют распределению исследований основных ML-конференций, а не науки в целом. Области и площадки, недостаточно представленные в этих материалах, соответственно, охвачены слабо, поэтому сгенерированные идеи могут наследовать этот уклон и не обязательно будут применимы в других сообществах. Мы формулируем паттерны как доменно-независимые, чтобы ограничить утечку тем, а проверка на новизну контролирует пересечения с актуальной литературой, однако мы не принуждаем к ретроспективному ограничению окна поиска. Корпуса, охватывающие разные площадки и дисциплины, ретроспективный поиск для варианта прогнозирования без утечек и использование судей на базе различных архитектур — это прямые способы проверки и расширения внешней валидности..
Конечная оценка автоматизирована, а исследование с участием человека является следующим этапом.
Обе оси оцениваются с помощью навыков на основе LLM, поэтому результаты измеряют согласованность со структурированными автоматизированными рецензентами, а не суждениями программного комитета из числа людей, при этом судьи могут иметь общие «слепые зоны» с генераторами. Автоматизированное исследование является подходящим первым этапом на уровне идей; слепое экспертное исследование — это запланированный следующий шаг перед любыми утверждениями уровня принятия..
Метрики судейства несут в себе два известных смещения.
Во-первых, вознаграждение за качество идеи является новым механизмом, поэтому вклады в бенчмарки, системы и чисто измерительные показатели по определению получают более низкие оценки по шкале глубины метода; следовательно, мы интерпретируем качество как относительную величину среди генеративных систем, а не как абсолютную меру исследовательской ценности. Во-вторых, новизна имеет смысл только в сочетании с качеством, поскольку достаточно общая идея может избежать совпадения с предшествующим уровнем техники и получить оценку как новая (случай GPT-5.5), поэтому мы никогда не ранжируем только по новизне, а представляем её как одну из осей плоскости качество–новизна. Рубрики для вкладов в ресурсы и системы, а также метрика новизны с учетом специфики, которая штрафует недостаточно проработанные идеи, позволили бы уменьшить оба этих смещения..
16 Карточки артефактов
16.1 Карточка данных
Корпус (Раздел 3) использует общедоступные метаданные и материалы открытых рецензий. Личности авторов сохраняются в качестве метаданных статьи, но не используются в качестве признаков модели для индукции паттернов или рекомендаций..
16.2 Карточка модели и бэкенда
Текущий конвейер использует LLM для извлечения, индукции таксономии, генерации карточек и нескольких фаз навыков, а также модель эмбеддингов для кластеризации. Основными моделями являются Claude Sonnet 4.6 для извлечения сигнатур и тегирования на уровне статей; Claude Opus 4.7 для индукции таксономии / домена и генерации карточек паттернов; OpenAI text-embedding-3-large для кластеризации стратегий-сигнатур; и Claude Opus 4.8 high для среды выполнения навыков и оценки конечных точек в §14. GPT-5.5 используется только в качестве базовой линии для сравнения между семействами моделей. Данный выбор является специфичным для бэкенда, а измерение качества и корректности формата между различными бэкендами остается задачей на будущее..
16.3 Карточка навыка
IdeaSpark подходит для направлений исследований в области ML, основанных на научной литературе, где пользователь может указать предметную область, смежную литературу, ограничения и желаемый тип вклада. Он не подходит для конфиденциальной литературы без разрешения коннектора, широких запросов по определению повестки дня без смежных статей, чистого создания бенчмарков, написания полных статей, автоматизированной подготовки к подаче или утверждений, требующих закрытых данных экспертной оценки. Он возвращает структурированную карточку идеи, диагноз do_not_generate или отчет phase_3_failed, но не может гарантировать новизну, принятие, осуществимость или согласие рецензентов. Пользователи несут ответственность за обзор предшествующего уровня техники, экспериментальный дизайн, оценку осуществимости, этическую экспертизу и последующие утверждения..
17 Ответственное использование
Системы генерации исследовательских идей снижают затраты на создание правдоподобно выглядящих предложений, что также увеличивает риски злоупотреблений: генерацию низкокачественных предложений, нагрузку на рецензентов, поверхностные публикации на arXiv и чрезмерно самоуверенные заявления о новизне. Поэтому IdeaSpark позиционируется как каркас для генерации идей, а не как агент для написания статей. Он выдает одну карточку идеи, а не рукопись, включает пути неудач, проверяет кандидатов на соответствие извлеченным из корпуса урокам об отклонении работ и угрозам со стороны предшествующего уровня техники, а также сохраняет видимыми проверки на фальсифицируемость и осуществимость..
Поскольку метод опирается на отклоненные заявки и рецензии, мы рассматриваем этот сигнал как конфиденциальный. Отклоненные статьи используются только в качестве совокупных данных на уровне закономерностей о том, как терпят неудачу стратегические шаги, и никогда не используются для ранжирования, профилирования или выделения отдельных статей, авторов или рецензентов. Личности авторов сохраняются только в качестве метаданных и не являются признаками модели (§3.2 / §16). Публичное развертывание должно включать ограничения по частоте запросов, подтверждение происхождения артефактов, обоснование цитирования, предупреждения о том, что система не прогнозирует принятие, а также правила выпуска для перераспределения текста рецензий и запросов на удаление..
18 Заключение
Мы представили ResearchStudio-Idea, набор из трех навыков для начального этапа генерации идей в области ML, основанный на анализе научной литературы. Paper-Search обеспечивает автономное обоснование на основе литературы из нескольких источников, Scoop-Check выполняет автономную проверку на наличие предшествующих работ, а IdeaSpark объединяет эти функции с руководством по паттернам, основанным на результатах, для создания одной проверяемой карточки идеи. Эмпирический вклад заключается в анализе 1 947 статей с конференций ICLR, ICML и NeurIPS за 2021–2025 годы, в результате чего было выделено 15 паттернов генерации идей, 31 подпаттерн и 28 областей исследований. Центральным системным артефактом является IdeaSpark: библиотека операционных карточек и спецификация навыков, которые делают эти паттерны исполняемыми во время вывода, при этом контрастные карточки направляют выбор от «узкого места» к действию и аудит кандидатов..
Основное утверждение намеренно ограничено. ResearchStudio-Idea не доказывает, что LLM может создавать научные статьи, предсказывать их принятие или заменять экспериментальное суждение. Оно показывает, что результаты публичных конференций содержат повторно используемые стратегические операторы, что отклоненные и принятые статьи часто разделяют эти операторы, и что условия их успеха и неудачи могут быть упакованы в практические навыки для поиска, генерации и рецензирования. Автоматизированная оценка судьей в разделе 14 предоставляет первоначальные конечные доказательства: при сопоставимой длине и формате IdeaSpark улучшает оцениваемое качество идей по сравнению с базовыми моделями без навыков и с общими навыками, оставаясь при этом конкурентоспособным по новизне. Оставшийся пробел заключается в валидации за пределами стадии идеи, включая предпочтения рецензентов-людей, успешность реализации и перенос за пределы изученной среды конференций по ML. Его ценность заключается в том, чтобы сделать доэкспериментальное выдвижение идей более структурированным, обоснованным доказательствами и проверяемым, оставляя при этом окончательный обзор предшествующего уровня техники, экспериментальный дизайн и научные утверждения за исследователем..
Приложение
Одна сгенерированная карточка и её JSON-след доказательств, прогон по пути отклонения, а также карточка паттерна / субпаттерна — всё это реальные артефакты из §14, воспроизведенные дословно.
Appendix A Сгенерированная от начала до конца карточка идеи
Дословный вывод std-register системы IdeaSpark для отложенного сида ICLR 2026 (RL для рассуждений в условиях длинного контекста), карточка системы с рангом 1 в §14; её JSON-след доказательств (основное утверждение, фальсификация, дельты литературы) находится в приложении B⟧.
Appendix B Поля аварийного отключения и фальсификации
Эти поля относятся к одной и той же карточке, но намеренно не напечатаны на ней: они представляют собой проверяемый рецензентами механизм из §6 (фальсификация с учетом механизмов с именованной несущей переменной плюс нетавтологический отрицательный контроль и сохранение байт-идентичного аварийного выключателя между фазами). Дословно взято из phase4_expansion.json.
Appendix C Выходные данные пути отклонения (Фаза 3 Отказ)
Не каждое направление приводит к созданию карточки. Когда аудит Фазы 3 достигает непреодолимого барьера, выполнение выдает phase_3_failed.md вместо идеи (один из трех результатов one-shot в §6). Приведенный ниже пример — это реальный запуск на основе, направление которого, по сути, было названием существующей статьи 2025 года; аудит, привязанный к корпусу, выявил совпадение с предшествующим уровнем техники по точному механизму и отказался от идеи, вместо того чтобы выпустить уже опубликованную работу.†† В системе оценки этот запуск был впоследствии перенаправлен на другой пробел Фазы 2.1, чтобы все же создать карточку для оценки; воспроизведенный здесь артефакт отказа является подлинным выводом ветки отказа..
Запуск: run_prompt85_tns Направление генерации идей: ”Новая исследовательская идея в области ML о неасимптотическом анализе (липкого) метода Track-and-Stop.” Сгенерированный кандидат (Фаза 2.2): ”Сертификат неасимптотической сложности выборки для липкого метода Track-and-Stop” Вердикт: отклонено Уровень вердикта: жесткий порог
Запуск проверок
1. paper_pointed_threat — столкновение с точным механизмом (жесткий нижний предел, неустранимый)
- ⟦• Угрожающая статья: semanticscholar:63d8201fbe32063e2ac336b0708f589e05cc3759 — ”Non-Asymptotic Analysis of (Sticky) Track-and-Stop” (Poiani, Bernasconi & Celli, arXiv:2505.22475, 2025-05). Выявлена посредством поиска коллизий на этапе 3.1.
- ⟦• Субсумпция: В аннотации к угрозе дословно указано, что Track-and-Stop и Sticky Track-and-Stop «являются оптимальными в асимптотическом режиме, [но] их неасимптотические гарантии остаются неизвестными. В данной работе мы восполняем этот пробел и предоставляем неасимптотические гарантии для обоих алгоритмов». Это побайтово совпадает с основным результатом кандидата (гарантия конечной достоверности / для всех дельта для подлинного правила выборки и остановки sticky-T&S при фиксированном алгоритме)).
- ⟦• Единственный отличительный признак кандидата не работает: названная аддитивная функциональная величина прогрева B(mu), построенная на основе кумулятивного дефицита распределения эмпирических данных относительно оракула D_t, является ВНУТРЕННЕЙ величиной доказательства. Любая неасимптотическая граница для sticky-T&S должна уже точно контролировать этот член ошибки отслеживания/прогрева, поэтому в предыдущей статье он обязательно ограничен (независимо от того, дано ему имя или нет). Это не является отдельным внешним утверждением.
- ⟦• доступно_через: null (не может быть исправлено путем редактирования поля; основной результат уже существует в печати).
2. gap_closure_reject_check — активировано
- ⟦• Урок C19 (candidate_match=yes): «Ослабление поля, читаемое как механический перенос известного аргумента, будет оцениваться как инкрементальное, если не будет названо и преодолено подлинно новое препятствие». Препятствие (неасимптотические гарантии для sticky T&S) уже преодолено в arXiv:2505.22475.
- ⟦• Урок C29 (candidate_match=yes): «Повторный вывод показателя, который лишь соответствует базовому уровню при почти идентичных алгоритмических изменениях, воспринимается как инкрементальное расширение». Кандидат оставляет алгоритм sticky-T&S неизменным и повторно выводит тот же объект, который уже был подтвержден в предыдущей статье..
Проверка применения рецепта = применено (обе ветви выполняют характерное действие своего цитируемого кластера) и проверка антипаттерна = совпадений нет — то есть ось отказа заключается в перекрытии с предыдущими работами, а НЕ в неправильном использовании рецепта или композиции антипаттернов.
Первопричина
Два независимых жестких / триггерных вывода указывают на одну и ту же первопричину: исходное направление пользователя, по сути, является буквальным названием существующей статьи 2025 года. Остаточная новизна, которую мог обнаружить конвейер (именованный член прогрева B(mu)), является внутренним объектом леммы, а не внешне дифференцирующим утверждением.
Опции на стороне пользователя
- ⟦• Отказаться / заменить направление. Неасимптотический анализ (липкого) Track-and-Stop в качестве заголовка уже занят статьей 2025 года arXiv:2505.22475.
- ⟦• Переформулируйте задачу в свободный остаток. Возможные точки поворота, НЕ охваченные рассматриваемой статьей, например: (а) компромисс между принудительным исследованием / «липким» графиком и конечной достоверностью (отложенный разрыв в Фазе 2.1) — количественно оцените, как скорость принуждения, установленная только для асимптотической согласованности, определяет накладные расходы конечной дельты; (б) зависящие от экземпляра НИЖНИЕ границы периода прогрева (результат о невозможности), а не верхняя граница, которую уже предоставляет предыдущая статья; (в) структурированная / неэкспоненциальная или контекстуальная среда, которую предыдущий неасимптотический анализ не охватывает. Для каждого из этих вариантов потребуется новый поиск в Фазе 0, чтобы подтвердить, что ниша свободна..
- ⟦• Повторно выполните фазу 2.1 + 2.2 для другого выбранного пробела из phase1_output.json (было найдено 4 пробела) с учетом статьи об угрозах, а затем проведите повторную критику.
Артефакты на диске
- ⟦• фаза0/ (таблица_литературы.md, результаты_литературы.json, кэш_полного_текста.json)
- ⟦• phase1/phase1_output.json (состояние=продолжить)
- ⟦• phase2_select/phase2_select_output.json
- ⟦• phase2_generate/phase2_generate_output.json (пройдено через шлюз цитирования)
- ⟦• phase3_collision/collision_hits.json (173 совпадения; критические: arXiv:2505.22475)
- ⟦• phase3_critique/phase3_critique_output.json (verdict=abandon, hard_floor)
- ⟦• phase_3_failed.md (этот файл)
Фаза 4 не создана. evaluation/opus4_8/85 НЕ создано (путь заброшен).
Appendix D Паттерн генерации идей на основе примеров и карточка подпаттерна
Одна из 15 индуцированных карточек паттернов (пример с высоким охватом «Аудит и пересмотр предположения» из §6) в паре с одной из карточек подпаттернов (тактический рецепт, который воплощает кандидат фазы 2.2). Воспроизведено дословно из колоды артефактов; все 15 паттернов и 31 подпаттерн находятся в выпуске артефактов на GitHub..
Репрезентативный подшаблон в рамках данного шаблона (тактический рецепт, который воплощает кандидат фазы 2.2):
Список литературы
- ⟦[1] Аллен Институт искусственного интеллекта (2026) Карточка модели SPECTER2. Примечание: Официальная карточка модели SPECTER2 на Hugging Face; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §1.3⟧.
- ⟦[2] Anthropic (2026) Обзор моделей Claude. Примечание: Официальная документация моделей Anthropic; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §4.1⟧.
- ⟦[3] Anthropic (2026) Рекомендации по созданию навыков. Примечание: Официальная документация Anthropic; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §1.3, §2.5.
- ⟦[4] А. Х. Артилес, М. Вайс, Л. Бринкманн, А. Гоял и Н. Рахаман (2026) Чуждая наука: выборка связных, но когнитивно недоступных направлений исследований из атомов идей. Примечание: arXiv:2603.01092; проверено 10 мая 2026 г. Внешние ссылки: 2603.01092, Link Цитируется в: §1.2, §2.2.
- ⟦[5] Х. Бишт и др. (2026) Агентные ИИ-ученые не созданы для автономных научных открытий. Внешние ссылки: 2605.08956 Цитируется: §2.1.
- ⟦[6] А. Коэн, С. Фельдман, И. Белтаги, Д. Дауни и Д. С. Уэлд (2020) SPECTER: обучение представлений на уровне документа с использованием transformers, учитывающих цитирования. В материалах 58-го ежегодного собрания Ассоциации вычислительной лингвистики, стр. 2270–2282. Примечание: ACL 2020; arXiv:2004.07180; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §1.3⟧.
- ⟦[7] И. Л. да Силва, Х. Ян, Л. Гуй и Ю. Хэ (2025) GraphMind: интерактивная система оценки новизны для ускорения научных открытий. Примечание: arXiv:2510.15706; проверено 10 мая 2026 г. Внешние ссылки: 2510.15706, Link Цитируется в: §1.2, §2.4.
- ⟦[8] С. Гао и др. (2026) Графы исследований: графы эволюции цитирований как инструмент контроля для генерации исследовательских идей. Внешние ссылки: 2605.14790 Цитируется в: §1.2, §2.3.
- ⟦[9] А. Гарикапарти, М. Патвардхан, Л. Виг и А. Кохан (2025) IRIS: интерактивная система генерации исследовательских идей для ускорения научных открытий. Примечание: arXiv:2504.16728; проверено 10 мая 2026 г. Внешние ссылки: 2504.16728, Link Цитируется в: §2.2⟧.
- ⟦[10] И. Джемп, Б. Маквильямс, К. Вернад и Т. Грепел (2021) EigenGame: PCA как равновесие Нэша. В сборнике Международной конференции по обучению представлениям, Примечание: Выдающаяся статья ICLR 2021; идентификатор корпуса paper_id: ICLR_2021_0018; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §3.3⟧.
- ⟦[11] Дж. Готтвейс, У. Венг, А. Дарьин, Т. Ту, А. Палепу и др. (2025) На пути к ИИ-соавтору научных исследований. Примечание: arXiv:2502.18864; проверено 10 мая 2026 г. Внешние ссылки: 2502.18864, Link Цитируется в: §1.1, §2.1.
- ⟦[12] М. Гроотендорст (2022) BERTopic: нейронное тематическое моделирование с использованием классовой процедуры tf-idf. Примечание: arXiv:2203.05794; проверено 10 мая 2026 г. Внешние ссылки: 2203.05794, Link Цитируется в: §1.3⟧.
- ⟦[13] К. Гу, Дж. Ченг, М. Чжан, П. Чжэн, Дж. Чжэн и Г. Хэ (2026) MoRI: обучение рассуждениям на основе мотивации для научной генерации идей в LLM. Примечание: arXiv:2603.19044; проверено 10 мая 2026 г. Внешние ссылки: 2603.19044, Link Цитируется в: §1.2, §2.3.
- ⟦[14] X. Gu and M. Krenn (2024) Генерация интересных научных идей с использованием графов знаний и LLM: оценки от 100 руководителей исследовательских групп. Примечание: arXiv:2405.17044; проверено 10 мая 2026 г. Внешние ссылки: 2405.17044, Link Цитируется в: §1.2, §2.3⟧.
- ⟦[15] С. Го, А. Х. Шариатмадари, Г. Сюн, А. Хуан, Э. Се, С. Бекиранов и А. Чжан (2024) IdeaBench: бенчмаркинг LLM для генерации исследовательских идей. Примечание: arXiv:2411.02429; проверено 10 мая 2026 г. Внешние ссылки: 2411.02429, Link Цитируется: §2.4⟧.
- ⟦[16] М. Хенцингер, С. Сричаран и Т. Штайгер (2023) Цена дифференциальной приватности при непрерывном наблюдении. В сборнике Международной конференции по Machine Learning, Примечание: Идентификатор корпуса paper_id: ICML_2023_0551; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется: §3.3⟧.
- ⟦[17] Х. Ху, Х. Фу, Дж. Ван, Ю. Ван, З. Ли, Р. Сюй, Ю. Лу, Ю. Цзинь, Л. Пан и З. Лан (2024) Nova: итеративный подход к планированию и поиску для повышения новизны и разнообразия идей, генерируемых LLM. Примечание: arXiv:2410.14255; проверено 10 мая 2026 г. Внешние ссылки: 2410.14255, Link Цитируется в: §1.2, §2.2⟧.
- ⟦[18] Дж. Хуанг, С. Куцерзан, С. К. Джаухар и Р. У. Уайт (2025) Idea2Plan: исследование планирования исследований с помощью ИИ. Примечание: arXiv:2510.24891; проверено 10 мая 2026 г. Внешние ссылки: 2510.24891, Link Цитируется в: §1.1, §2.1.
- ⟦[19] Б. Цзян (2026) HindSight: оценка исследовательских идей, сгенерированных LLM, через призму будущего влияния. Примечание: arXiv:2603.15164; проверено 10 мая 2026 г. Внешние ссылки: 2603.15164, Link Цитируется в: §1.2, §2.4.
- ⟦[20] Д. П. Кингма и Р. Гао (2023) Понимание целей диффузии как ELBO с простой аугментацией данных. В сборнике Advances in Neural Information Processing Systems, Примечание: Идентификатор корпуса paper_id: NeurIPS_2023_0753; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §3.3⟧.
- ⟦[21] А. Кумар, А. Рагунатхан, Р. Джонс, Т. Ма и П. Лианг (2022) Fine-tuning может искажать предобученные признаки и демонстрировать низкую эффективность при работе с данными вне распределения. В материалах Международной конференции по обучению представлений, Примечание: Идентификатор статьи в корпусе: ICLR_2022_0094; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §3.3⟧.
- ⟦[22] Х. Лей, Т. Чжоу, Ю. Чен, К. Лю и Дж. Чжао (2025) MotivGraph-soiq: интеграция графов мотивационных знаний и сократического диалога для улучшения генерации идей с помощью LLM. Примечание: arXiv:2509.21978; проверено 10 мая 2026 г. Внешние ссылки: 2509.21978, Link Цитируется в: §1.2, §2.3.
- ⟦[23] П. Льюис, Э. Перес, А. Пиктус, Ф. Петрони, В. Карпухин, Н. Гоял, Х. Куттлер, М. Льюис, У. Йи, Т. Рокташель, С. Ридель и Д. Кила (2020) Retrieval-augmented generation для наукоемких задач NLP. В сборнике Advances in Neural Information Processing Systems, Примечание: NeurIPS 2020; arXiv:2005.11401; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §1.2⟧.
- ⟦[24] А. Ли и др. (2026) MIRAI: прогнозирование и генерация высокорезультативных академических исследований. Внешние ссылки: 2606.05443 Цитируется: §2.4.
- ⟦[25] С. Лю, С. Ван, Дж. Цао, Дж. Ге, К. Ван, Л. Чжан, М. Ченг, П. Чжао, Т. Ли, С. Цзя, С. Ли, С. Ли, Ю. Лю, Ю. Фэн, Ю. Хуан, Ю. Сюй, Ю. Сунь, З. Чжоу и З. Сюй (2025) Видение автоматизированных исследований с помощью LLM агентов. Примечание: arXiv:2504.18765; проверено 10 мая 2026 г. Внешние ссылки: 2504.18765, Link Цитируется в: §1.1, §2.1.
- ⟦[26] Дж. Лю, М. Хармон и З. Чжан (2026) Sci-reasoning: набор данных для декодирования паттернов инноваций в области ИИ. Примечание: arXiv:2601.04577; проверено 10 мая 2026 г. Внешние ссылки: 2601.04577, Link Цитируется в: §1.2, §2.3.
- ⟦[27] Х. Лю, Х. Донг, Х. Гао, Ю. Фенг и Х. Панг (2025) Дополнение процесса генерации исследовательских идей данными: эмпирическое исследование в области социальных наук. Примечание: arXiv:2505.21396; проверено 10 мая 2026 г. Внешние ссылки: 2505.21396, Link Цитируется в: §2.4⟧.
- ⟦[28] Й. Лю, З. Ян, Т. Се, Дж. Ни, Б. Гао, Й. Ли, С. Тан, В. Оуян, Э. Камбрия и Д. Чжоу (2025) ResearchBench: бенчмаркинг LLM в научных открытиях посредством декомпозиции задач на основе вдохновения. Примечание: arXiv:2503.21248; проверено 10 мая 2026 г. Внешние ссылки: 2503.21248, Link Цитируется: §2.4⟧.
- ⟦[29] К. Лу, К. Лу, Р. Т. Ланге, Я. Ямада, С. Ху, Дж. Форстер, Д. Ха и Дж. Клун (2026) На пути к сквозной автоматизации исследований в области ИИ. Nature. Примечание: Nature 2026; оригинал arXiv:2408.06292; проверено 10 мая 2026 г. Внешние ссылки: Document, 2408.06292, Link Цитируется в: §1.1, §1.2, §2.1⟧.
- ⟦[30] Л. Макиннес, Дж. Хили и С. Астелс (2017) Hdbscan: иерархическая кластеризация на основе плотности. Журнал программного обеспечения с открытым исходным кодом 2 (11), стр. 205. Примечание: DOI:10.21105/joss.00205; проверено 10 мая 2026 г. Внешние ссылки: Document, Link Цитируется в: §1.3, §5.2⟧.
- ⟦[31] Л. Макиннес, Дж. Хили и Дж. Мелвилл (2018) UMAP: равномерная аппроксимация и проекция многообразий для снижения размерности. Примечание: arXiv:1802.03426; проверено 10 мая 2026 г. Внешние ссылки: 1802.03426, Link Цитируется в: §1.3, §5.2.
- ⟦[32] Т. Мёлленхофф и М. Э. Хан (2023) SAM как оптимальная релаксация байесовского вывода. В сборнике Международной конференции по обучению представлений, Примечание: ICLR 2023 Spotlight; идентификатор корпуса paper_id: ICLR_2023_0331; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §3.3⟧.
- ⟦[33] OpenAI (2026) Embeddings. Примечание: Официальная документация API OpenAI; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §1.3⟧.
- ⟦[34] OpenReview (2026) Документация OpenReview: использование API. Примечание: Официальная документация OpenReview; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §1.3, §3.1.
- ⟦[35] И. Цю, Х. Чжан, З. Сюй, М. Ли, Д. Сун, З. Ван и К. Чжан (2025) AI idea bench 2025: эталонный тест для генерации исследовательских идей с помощью AI. Примечание: arXiv:2504.14191; проверено 10 мая 2026 г. Внешние ссылки: 2504.14191, Link Цитируется в: §2.4⟧.
- ⟦[36] М. Раденски, С. Шахид, Р. Фок, П. Сианглюлю, Т. Хоуп и Д. С. Уэлд (2024) Человеко-машинная составная система на базе LLM для научной генерации идей посредством рекомбинации аспектов и оценки новизны. Примечание: Представляет Scideator; arXiv:2409.14634; проверено 10 мая 2026 г. Внешние ссылки: 2409.14634, Link Цитируется: §2.4⟧.
- ⟦[37] С. Рен, К. Се, П. Цзянь, З. Рен, К. Ленг и Дж. Чжан (2025) На пути к научному интеллекту: обзор научных агентов на базе LLM. Примечание: arXiv:2503.24047; проверено 10 мая 2026 г. Внешние ссылки: 2503.24047, Link Цитируется: §2.5⟧.
- ⟦[38] Д. Сараоги, Р. Сингхи и Д. Кумар (2025) Оценка новизны в планах исследований, созданных искусственным интеллектом, с использованием многопотоковых конвейеров LLM. Примечание: arXiv:2601.09714; проверено 10 мая 2026 г. Внешние ссылки: 2601.09714, Link Цитируется в: §1.2, §2.2.
- ⟦[39] Т. Шик, Дж. Двиведи-Ю, Р. Десси, Р. Райляну, М. Ломели, Л. Зеттльмойер, Н. Канчедда и Т. Сьялом (2023) Toolformer: языковые модели могут самостоятельно обучаться использованию инструментов. В сборнике Advances in Neural Information Processing Systems, Примечание: NeurIPS 2023; arXiv:2302.04761; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §1.3⟧.
- ⟦[40] С. Шмидгалл, Ю. Су, З. Ван, Х. Сунь, Дж. Ву, Х. Ю, Дж. Лю, М. Мур, З. Лю и Э. Барсум (2025) Агентная лаборатория: использование LLM агентов в качестве научных ассистентов. Примечание: arXiv:2501.04227; проверено 10 мая 2026 г. Внешние ссылки: 2501.04227, Link Цитируется в: §1.1, §1.2, §2.1⟧.
- ⟦[41] Т. Шопф и др. (2026) Является ли эта идея новой? автоматизированный бенчмарк для оценки исследовательских идей. Внешние ссылки: 2603.10303 Цитируется в: §1.2, §2.4.
- ⟦[42] Semantic Scholar (2026) Графовый программный интерфейс Semantic Scholar. Примечание: Официальная документация программного интерфейса Semantic Scholar; проверено 10 мая 2026 года Внешние ссылки: Link Цитируется в: §1.3, §3.1⟧.
- ⟦[43] С. Шахид, М. Раденски, Р. Фок, П. Сианглюлю, Д. С. Уэлд и Т. Хоуп (2025) Оценка новизны научных идей на основе литературы. Примечание: arXiv:2506.22026; проверено 10 мая 2026 г. Внешние ссылки: 2506.22026, Link Цитируется в: §1.2, §2.4⟧.
- ⟦[44] Й. Шен, М. Лю, Д. Чжоу и Л. Хуан (2026) Навигация в пространстве генерации идей: декомпозированные концептуальные представления для позиционирования научных идей. Примечание: arXiv:2601.08901; проверено 10 мая 2026 г. Внешние ссылки: 2601.08901, Link Цитируется в: §1.2, §2.3.
- ⟦[45] С. Си, Т. Хашимото и Д. Янг (2025) Разрыв между генерацией идей и их реализацией: результаты выполнения исследовательских идей, сгенерированных LLM, в сравнении с человеческими. Примечание: arXiv:2506.20803; проверено 10 мая 2026 г. Внешние ссылки: 2506.20803, Link Цитируется в: §1.2, §2.4.
- ⟦[46] К. Си, Д. Янг и Т. Хашимото (2024) Могут ли LLM генерировать новые исследовательские идеи? масштабное исследование с участием более 100 исследователей в области NLP. Примечание: arXiv:2409.04109; проверено 10 мая 2026 г. Внешние ссылки: 2409.04109, Link Цитируется в: §1.2, §2.4.
- ⟦[47] А. Сингх, М. Д’Арси, А. Кохан, Д. Дауни и С. Фельдман (2022) SciRepEval: многоформатный бенчмарк для представлений научных документов. Примечание: arXiv:2211.13308; включает контекст оценки SPECTER2; проверено 10 мая 2026 г. Внешние ссылки: 2211.13308, Link Цитируется в: §1.3⟧.
- ⟦[48] Х. Су, Р. Чен, С. Танг, З. Инь, Х. Чжэн, Дж. Ли, Б. Ци, К. Ву, Х. Ли, В. Оуян, П. Торр, Б. Чжоу и Н. Донг (2024) Много голов лучше, чем одна: улучшенная генерация научных идей с помощью мультиагентной системы на базе LLM. Примечание: arXiv:2410.09403; проверено 10 мая 2026 г. Внешние ссылки: 2410.09403, Link Цитируется в: §2.2⟧.
- ⟦[49] Дж. Танг, Л. Ся, З. Ли и К. Хуанг (2025) AI-researcher: автономные научные инновации. Примечание: arXiv:2505.18705; проверено 10 мая 2026 г. Внешние ссылки: 2505.18705, Link Цитируется в: §1.1, §1.2, §2.1.
- ⟦[50] Дж. Тонг, М. Ли, Х. Ли, Ю. Янг, Ю. Моу, В. Ма, З. Си, Х. Чен, С. Лю, К. Ченг, М. Чжан, К. Чен, В. Ге, К. Гуо, Т. Йинг, Т. Сан, Ю. Женг, С. Чен, Дж. Чжао, Н. Динг, С. Хуанг, Ю. Джианг и С. Цю (2026) ИИ может научиться научному вкусу. Примечание: arXiv:2603.14473; проверено 10 мая 2026 г. Внешние ссылки: 2603.14473, Link Цитируется в: §2.4⟧.
- ⟦[51] Д. Трехан и др. (2026) Почему LLM еще не стали учеными: уроки четырех попыток автономных исследований. Внешние ссылки: 2601.03315 Цитируется: §2.1⟧.
- ⟦[52] Х. Ван, П. Цзян, Дж. Сун, З. Ши, Х. Ю, Дж. Хан и Х. Джи (2026) Обучение прогнозированию перспективных исследовательских предложений с помощью LLM. Примечание: arXiv:2603.27146; проверено 10 мая 2026 г. Внешние ссылки: 2603.27146, Link Цитируется: §2.4⟧.
- ⟦[53] К. Ван и др. (2026) FlowPIE: эволюция научных идей на этапе тестирования с помощью исследования литературы, управляемого потоками. Внешние ссылки: 2603.29557 Цитируется в: §1.2, §2.2.
- ⟦[54] Дж. Вэй, С. Ван, Д. Схурманс, М. Босма, Ф. Ся, Э. Х. Чи, К. В. Ле и Д. Чжоу (2022) Промптинг в стиле цепочки рассуждений вызывает способность к логическому выводу у LLM. В сборнике Advances in Neural Information Processing Systems, Примечание: NeurIPS 2022; arXiv:2201.11903; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется в: §1.3⟧.
- ⟦[55] В. Ву, И. Чжао, И. Ван, С. Ли, Дж. Шао, И. Лонг и К. Чжан (2026) NovBench: оценка больших языковых моделей в задачах определения новизны научных статей. Примечание: arXiv:2604.11543; проверено 10 мая 2026 г. Внешние ссылки: 2604.11543, Link Цитируется в: §1.2, §2.4.
- ⟦[56] Г. Сюн, Э. Се, А. Х. Шариатмадари, С. Го, С. Бекиранов и А. Чжан (2024) Улучшение генерации научных гипотез с помощью LLM, основанных на знаниях. Примечание: arXiv:2411.02382; проверено 10 мая 2026 г. Внешние ссылки: 2411.02382, Link Цитируется: §1.2, §2.3.
- ⟦[57] И. Ямада, Р. Т. Ланге, К. Лу, С. Ху, К. Лу, Дж. Форстер, Дж. Клун и Д. Ха (2025) The AI scientist-v2: автоматизированные научные открытия уровня семинаров посредством агентного древовидного поиска. Примечание: arXiv:2504.08066; проверено 10 мая 2026 г. Внешние ссылки: 2504.08066, Link Цитируется в: §2.1⟧.
- ⟦[58] С. Яо, Дж. Чжао, Д. Ю, Н. Ду, И. Шафран, К. Нарасимхан и Ю. Цао (2023) ReAct: синергия рассуждения и действия в языковых моделях. В сборнике Международной конференции по представлениям обучения, Примечание: ICLR 2023; arXiv:2210.03629; проверено 10 мая 2026 г. Внешние ссылки: Link Цитируется: §1.3⟧.
- ⟦[59] М. Чжан, К. Тан, Ю. Хуан, Ю. Шэнь, К. Ма, Л. Цзюй, С. Чжан, Ю. Ван, В. Цзин, Дж. Дэн, Х. Ша, Б. Ху, Дж. Тун, К. Цзян, Ю. Гэн, Ю. Ин, Ю. Чжан, З. Инь, З. Си, С. Доу, Т. Гуй, К. Чжан и С. Хуан (2026) OpenNovelty: агентная система на базе LLM для верифицируемой оценки научной новизны. Примечание: arXiv:2601.01576; проверено 10 мая 2026 г. Внешние ссылки: 2601.01576, Link Цитируется в: §1.2, §2.4.
- ⟦[60] К. Чжао, В. Линь, Ц. Чжэн, Ф. Сюй и Ю. Ли (2025) Глубинная генерация идей: проектирование LLM агентов для создания новых исследовательских идей на основе сети научных концепций. Примечание: arXiv:2511.02238; проверено 10 мая 2026 г. Внешние ссылки: 2511.02238, Link Цитируется в: §1.2, §2.2.
- ⟦[61] Т. Чжэн, З. Дэн, Х. Т. Цанг, В. Ван, Дж. Бай, З. Ван и Ю. Сонг (2025) От автоматизации к автономности: обзор больших языковых моделей в научных исследованиях. Примечание: arXiv:2505.13259; проверено 10 мая 2026 г. Внешние ссылки: 2505.13259, Link Цитируется в: §1.2, §2.5.
- ⟦[62] Т. Чжэн, К. К. Там, Н. Х. К. Нгуен, Б. Сюй, З. Ван, Дж. Чэн, Х. Т. Цанг, В. Ван, Дж. Бай, Т. Фанг, Ю. Сонг, Г. И. Вонг и С. Си (2025) NewtonBench: бенчмаркинг обобщаемого открытия научных законов в LLM агентах. Примечание: arXiv:2510.07172; проверено 10 мая 2026 г. Внешние ссылки: 2510.07172, Link Цитируется в: §2.4⟧.