Рекурсивное самосовершенствование в ИИ: от ограниченного саморедактирования до автономных исследовательских циклов
Аннотация
Системы AI все чаще участвуют в собственном совершенствовании: пересматривают свои выходные данные, адаптируют и развивают свои собственные механизмы в процессе развертывания, обучаются на генерируемых ими данных и — в рамках растущего направления исследований — проводят сами исследования в области AI. Литература, описывающая это участие, стремительно расширяется, но использует терминологию («self-refine», «self-reward», «self-play», «self-evolve»), которая смешивает фундаментально различные цели. Мы проанализировали 1250 статей с arXiv (2024–2026) и систематизировали их по двум осям: что именно система улучшает — свое поведение при развертывании, свою стратегию в процессе обучения, свой оценщик или сам исследовательский процесс — и степень замкнутости цикла (от участия человека до полностью автономного цикла). Данная таксономия отделяет ограниченное самосовершенствование — сходящееся, поддающееся оценке и уже являющееся промышленной практикой — от открытого рекурсивного самосовершенствования (RSI), которое остается ограниченным требованиями к обоснованию, динамикой коллапса и вычислительными ограничениями со всех сторон, которые могут быть измерены текущими данными. Его отличительной чертой является выделенная категория для самооценки: каждый цикл улучшения представляет собой утверждение о том, что некий сигнал может заменить суждение человека, поэтому мы исследуем пространство проектирования оценщиков — судей, модели вознаграждения процессов, верификаторы, рубрики, мета-оценку — наряду с циклами, которые они контролируют, упорядочиваем сигналы в иерархию верификации от формальных верификаторов (наиболее сильных) до внутренней самооценки (наиболее слабой) и отмечаем, что продемонстрированная сила самосовершенствования коррелирует с этой иерархией, что ее характерные виды сбоев (самоподтверждающиеся циклы, коллапс модели, коллапс разнообразия) вытекают из нарушений этой иерархии, и что «узкое место» в определении направления исследований, которое удерживает человека в цикле, является ее высшей ступенью. Мы связываем техническую литературу с теорией пределов RSI, а также с вопросами безопасности и управления, поднятыми в отчетах передовых лабораторий о замыкании цикла, и определяем измерение самосовершенствования на уровне управления как наиболее недостаточно изученную нишу в данной области..
1. Введение
Идея о том, что искусственный интеллект может совершенствовать себя — и что каждое улучшение может облегчать последующее — является одной из старейших в данной области. Аргумент Гуда об «интеллектуальном взрыве» [43] и доказуемо оптимальные машины Гёделя Шмидхубера [115] определили рекурсивное самосовершенствование (RSI) как теоретическую конечную точку за десятилетия до того, как какая-либо система могла бы правдоподобно попытаться это осуществить. Что изменилось, так это то, что фрагменты этого цикла теперь стали инженерной практикой. LLM регулярно критикуют и пересматривают свои собственные выходные данные, обучаются на данных, которые они сами сгенерировали, переписывают собственную агентную структуру и — в таких системах, как FunSearch [112] и AlphaEvolve [104] — обнаруживают алгоритмы, которые возвращаются в инфраструктуру самой разработки AI..
Недавнее эссе Anthropic о рекурсивном самосовершенствовании [3] рассматривает этот переход как континуум возрастающей автономности ИИ в цикле совершенствования ИИ: от написания всего кода людьми (до 2023 года), через кодинг с помощью чат-ботов и автономных агентов-программистов, к агентам, которые делегируют работу другим агентам сегодня, и — в конце спектра — «замыканию цикла»: агентам, которые проектируют и обучают свои последующие модели. В эссе утверждается, что текущие системы находятся заметно далеко в этом спектре с точки зрения исполнения (по состоянию на май 2026 года Claude, как сообщается, пишет более 80% объединенного кода Anthropic), оставаясь при этом ограниченными в постановке исследовательских задач — выборе того, какие проблемы имеют значение. То, будет ли, когда и как закрыт оставшийся разрыв, является, пожалуй, самым важным открытым вопросом в этой области. Мы используем эссе как мотивирующую основу и источник терминологии этапов, а не как доказательство; доказательная база обзора — это рецензируемая литература, собранная ниже.
Данный обзор систематизирует научную литературу по этому вопросу. Мы собрали корпус из 1250 статей с arXiv (2024–2026 годы) — систематическую первичную выборку из 871 статьи по семи направлениям литературы о самосовершенствовании, дополненную целевой подборкой из 379 статей по направлениям, которые в приведенной ниже таксономии выделены в качестве приоритетных (§2.3), — и классифицировали их все по четырем техническим категориям, а также по группе фундаментальных основ (Таблица 1). Три наблюдения определяют структуру данной статьи.:
Во-первых, «самосовершенствование» — это не что-то одно. Этот термин используется для обозначения пересмотра вывода во время инференса (Self-Refine [99]), циклов обучения на самостоятельно сгенерированных данных (STaR [173], Self-Rewarding LMs [171]), агентов, которые переписывают собственный код (Gödel Agent [169], Darwin Gödel Machine [180]), и систем, которые автономно проводят исследования в области AI [91]. Они колоссально различаются по амбициозности и профилю риска, однако терминология «self-X» в литературе (self-refine, self-reward, self-play, self-distill, self-evolve, self-verify) скрывает эти различия. Мы систематизируем данную область по двум осям: (i) что именно система совершенствует — свое поведение при развертывании (выходные данные, веса, адаптированные во время тестирования, или собственную обвязку), свою стратегию на этапе обучения, свой оценщик (сигнал, определяющий «лучшее») или сам исследовательский процесс; и (ii) степень замкнутости цикла — находится ли человек в контуре, проверяя автоматически сгенерированный сигнал, или он полностью отсутствует.?
Во-вторых, область развивается быстрее, чем происходит её консолидация. 74% нашего корпуса было опубликовано в 2026 году; ежеквартальный объем публикаций в исходной выборке вырос с единичных значений в начале 2024 года до примерно 500 статей во втором квартале 2026 года (Рисунок 6). Существующие обзоры охватывают отдельные сегменты — on-policy distillation [126], методы tree-search-plus-reward [147] — но ни один обзор не охватывает весь спектр от ограниченного самосовершенствования до RSI с открытым финалом. Эта интеграция, опирающаяся на явный континуум автономности, является основным вкладом данной статьи..
В-третьих, одно узкое место возникает повсеместно: оценщик. Каждая категория, которую мы рассматриваем, зависит от надежности своего сигнала улучшения — верификатора, модели вознаграждения, обратной связи от выполнения, средства проверки доказательств или мета-оценщика. Самообучение работает там, где ответы поддаются проверке (код, математика), и деградирует там, где это не так; автоматизированные исследователи создают связные статьи, утверждения в которых трудно проверить; циклы самовознаграждения взламывают собственных судей. Поэтому мы рассматриваем самооценку не как сквозное замечание, а как отдельную категорию (§5) — столп, на котором держатся остальные три..
Вклад. (1) Двухосевая таксономия — четыре категории улучшения, пересекающиеся со степенью замыкания цикла, — которая четко отделяет ограниченное самосовершенствование от открытого рекурсивного самосовершенствования и заменяет неоднозначную лексику само-X (§2). (2) Систематическая карта 1250 недавних статей в рамках данной таксономии, каждая категория рассмотрена в §§3–6. (3) Специальное рассмотрение самооценки — пространство проектирования оценщика, иерархия верификации и режимы сбоев, вытекающие из ее нарушений, — как общего ограничивающего фактора области (§5). (4) Синтез литературы по теории, ограничениям и безопасности, который связывает технические направления с вопросом о взрывном росте (§7).).
Таблица 1. Четыре технические категории таксономии плюс семейство основ с охватом корпуса.
| Category | Sub-threads | Papers | % posted 2026 |
|---|---|---|---|
| Deployment-time self-evolution (§3) | output refinement · test-time training · harness/skill evolution | 393 | 74% |
| Training-time self-iteration (§4) | self-reward RL · CoT self-training · self-distillation · self-play (incl. zero-data) · embodied | 340 | 69% |
| Self-evaluation (§5) | judges · process/reward models · verifiers · rubrics · meta-evaluation | 318 | 82% |
| Auto Research (§6) | AI scientists · evolutionary program discovery | 139 | 76% |
| Foundations, limits & safety (§7) | theory · limits · safety | 60 | 57% |
2. Предварительные сведения, таксономия и метод
2.1 Предварительные сведения и определения
Нижеприведенные термины используются в литературе нестрого и непоследовательно; мы фиксируем их значения для данного обзора.
Агент. Система на базе LLM, которая преследует цель посредством цикла восприятия–действия: она наблюдает за состоянием (выводы инструментов, обратная связь среды, файлы), выбирает действия (вызовы инструментов, выполнение кода, сообщения) и повторяет итерации до выполнения условия остановки. Базовая модель, вызванная один раз, не является агентом; та же модель внутри цикла с инструментами и памятью — это.
Обвязка (каркас). Всё, что окружает модель и превращает её в агента: системные промпты, определения инструментов, хранилища памяти, библиотеки навыков, индексы поиска, код оркестрации, правила остановки [98]. Обвязка доступна для внешнего контроля и редактирования — в том числе самим агентом, что делает самомодификацию обвязки наиболее конкретной формой того, как «агент переписывает сам себя»..”
Оценщик (верификатор, судья, модель вознаграждения). Любой механизм, который сопоставляет артефакт-кандидат с сигналом качества: формальный проверяющий доказательств, набор тестов, обученная модель вознаграждения или модель вознаграждения за процесс, LLM-судья, рубрикатор, эксперт-человек. Мы используем термин верификатор для оценщиков с гарантиями корректности, и судья для обученных или промпт-оценщиков без таковых..
Самосовершенствование. Система участвует в создании улучшенной версии самой себя или собственных результатов, где «лучшее» определяется некоторым оценщиком. Определяющая зависимость от оценщика не является педантизмом; это источник каждого режима сбоя в ⟦BROKEN_K5⟧.
Обучение во время тестирования (TTT). Обновление весов модели во время развертывания, обусловленное текущим запросом или сессией, без этапа предварительного обучения на подготовленных данных — в отличие от уточнения во время вывода (веса заморожены) и итерации во время обучения (автономная фаза).
Самообучение через игру. Обучение, при котором модель генерирует собственные задачи или противников — циклы «предлагающий–решающий», состязательные учебные программы — включая режим работы без данных, который начинается с нуля, используя только базовую модель [188, 53].
Ограниченное самосовершенствование против RSI с открытым финалом. Ограниченное самосовершенствование улучшает систему относительно фиксированного внешнего оценщика; оно является сходящимся и поддающимся оценке. Рекурсивное самосовершенствование с открытым финалом модифицирует саму систему, а также критерии или механизмы улучшения без фиксированного внешнего ориентира; в принципе оно является расходящимся. Это различие является центральным аспектом данного обзора..
2.2 Двухосевая таксономия
Терминология в литературе размножилась быстрее, чем сами концепции. Self-refine, self-correct, self-reward, self-play, self-distill, self-train, self-evolve, self-verify — каждое из этих слов обозначает механизм, но эти механизмы охватывают фундаментально разные цели. Модель, которая перечитывает свой черновик и исправляет ошибку, делает нечто категорически отличное от агента, который переписывает собственную кодовую базу, даже если оба процесса являются «самоулучшением». Мы располагаем любой метод самоулучшения на двух осях.
Ось 1 — что именно улучшает система? Четыре категории:
- ⟦• Самоэволюция во время развертывания (§3): система совершенствуется в процессе эксплуатации — итерируя выходные данные при замороженных весах, адаптируя веса для каждого запроса (обучение во время тестирования) или развивая собственные инструменты, навыки и память. Улучшение носит эпизодический характер или накапливается вне базовых весов. (Части этой категории часто называют самосовершенствованием во время вывода; мы предпочитаем термин «во время развертывания», поскольку категория также включает обновление весов (§3.4) и накопление между эпизодами (§3.5–3.6), что термин «во время вывода» описывал бы неверно).)
- ⟦• Самоитерация во время обучения (§4): система генерирует данные, вознаграждения или сигналы учителя, которые обновляют её собственные веса на этапе обучения. Улучшение сохраняется в весах, но ограничено качеством самогенерируемого сигнала.
- ⟦• Самооценка (§5): оценщик системы является объектом улучшения — проектирование, усиление или совместная эволюция судей, верификаторов, моделей вознаграждения и критериев, которые определяют «лучшее» для остальных трех категорий.
- ⟦• Автоматизированные исследования (§6): система самостоятельно выполняет работу по исследованию AI — выдвигает гипотезы, проводит эксперименты, обнаруживает алгоритмы — в пределе автономно оптимизируя методы из §§3–5. Улучшение накапливается во всех системах, а не внутри одной.
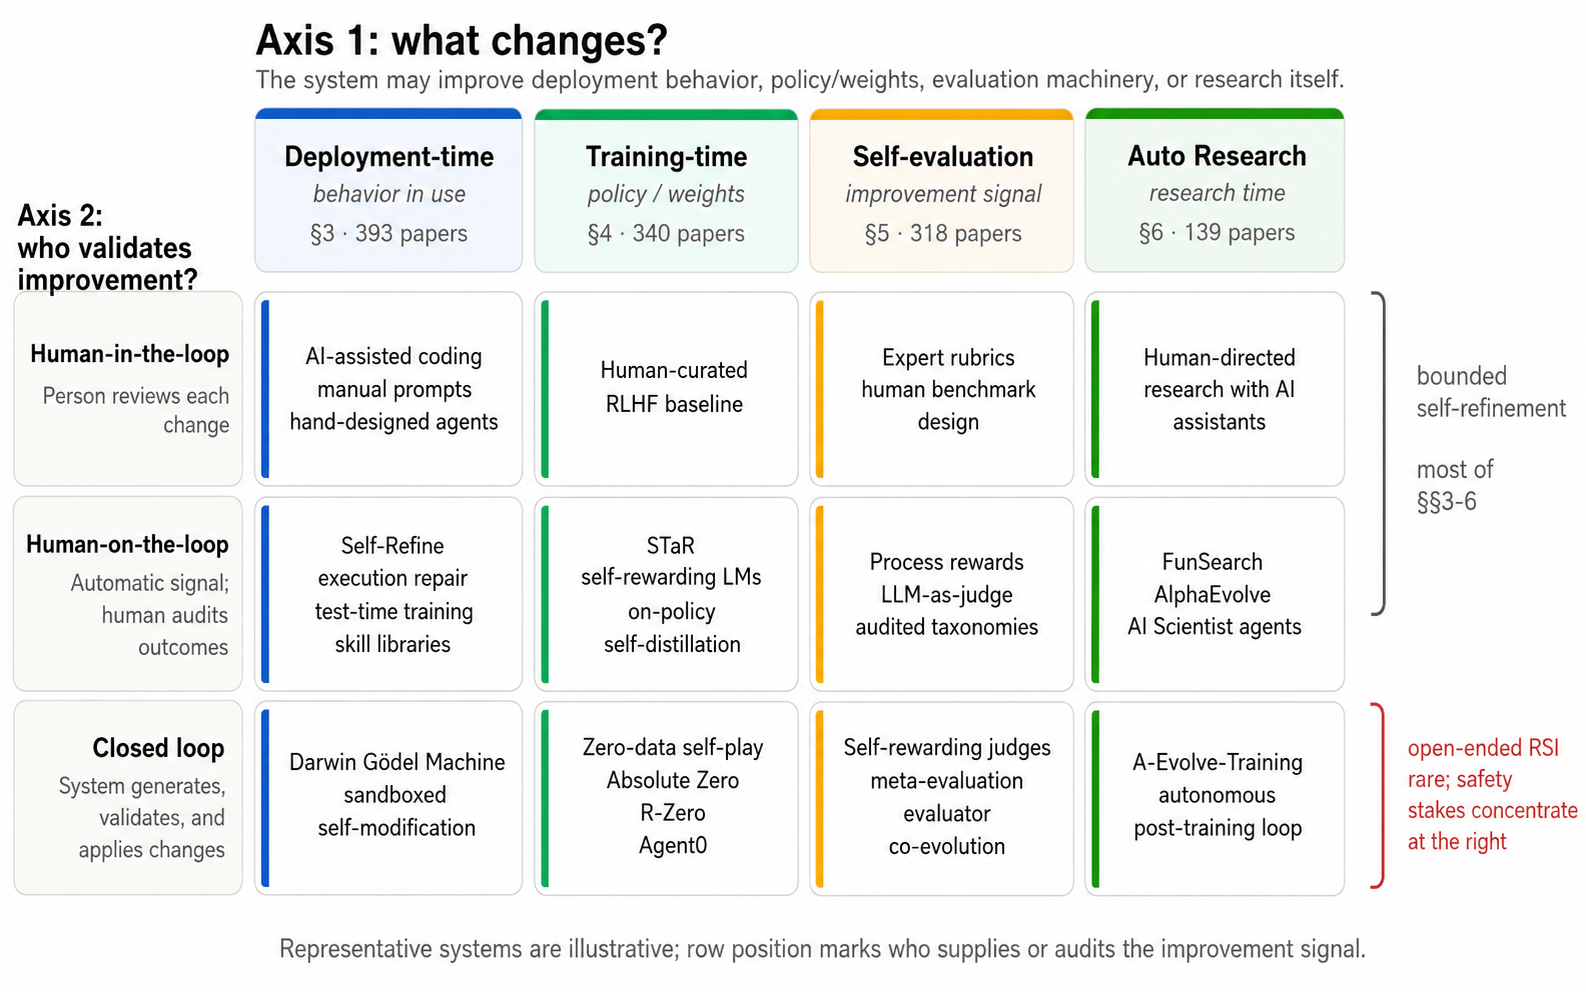
Ось 2 — степень замыкания цикла. Кто проверяет улучшение?
- ⟦• Человек в контуре управления: человек проверяет каждое изменение (программирование с помощью AI, инструменты для совместной научной работы).
- ⟦• Человек в контуре управления: сигнал об улучшении генерируется автоматически (обратная связь по выполнению, модель вознаграждения, верификатор доказательств), но люди проверяют результаты и контролируют развертывание.
- ⟦• Замкнутый цикл: система генерирует, проверяет и применяет свои собственные улучшения без участия человека — режим, который в эссе Anthropic называют «замыканием цикла» [3]⟧.
Почти все из 1 250 рассмотренных здесь статей изучают ограниченное самосовершенствование (ячейки с участием человека); открытое RSI — замкнутые циклы, которые также модифицируют свои собственные оценщики, — это область, где концентрируются риски безопасности (§7). Согласно пятиступенчатому спектру Anthropic, основная часть технической литературы занимает стадии 3–4; статьи в §6 исследуют границу стадии 5.
На рисунке 1 представлена итоговая сетка 4×3 с репрезентативными системами в каждой ячейке. Две особенности этой сетки важнее, чем любая отдельная ячейка. Во-первых, плотность сосредоточена в среднем ряду: почти всё, что рассматривается в §§3–6, относится к категории human-on-the-loop — автоматически генерируемый сигнал с проверкой результатов человеком. Во-вторых, ряд с замкнутым контуром везде разрежен, а справа — наиболее пуст; его самая значимая ячейка — это самооценка × замкнутый контур — система, которая переписывает собственное определение «лучшего», что как раз является той точкой, где ограниченное самосовершенствование переходит в неограниченное RSI. Таким образом, таксономия выполняет двойную функцию: она структурирует обзор (§§3–6 следуют её столбцам) и делает наглядным центральный тезис обзора — основная часть литературы сосредоточена там, где человек всё ещё контролирует контур, а несущим столбцом является столбец оценщика.
2.3 Корпус и метод
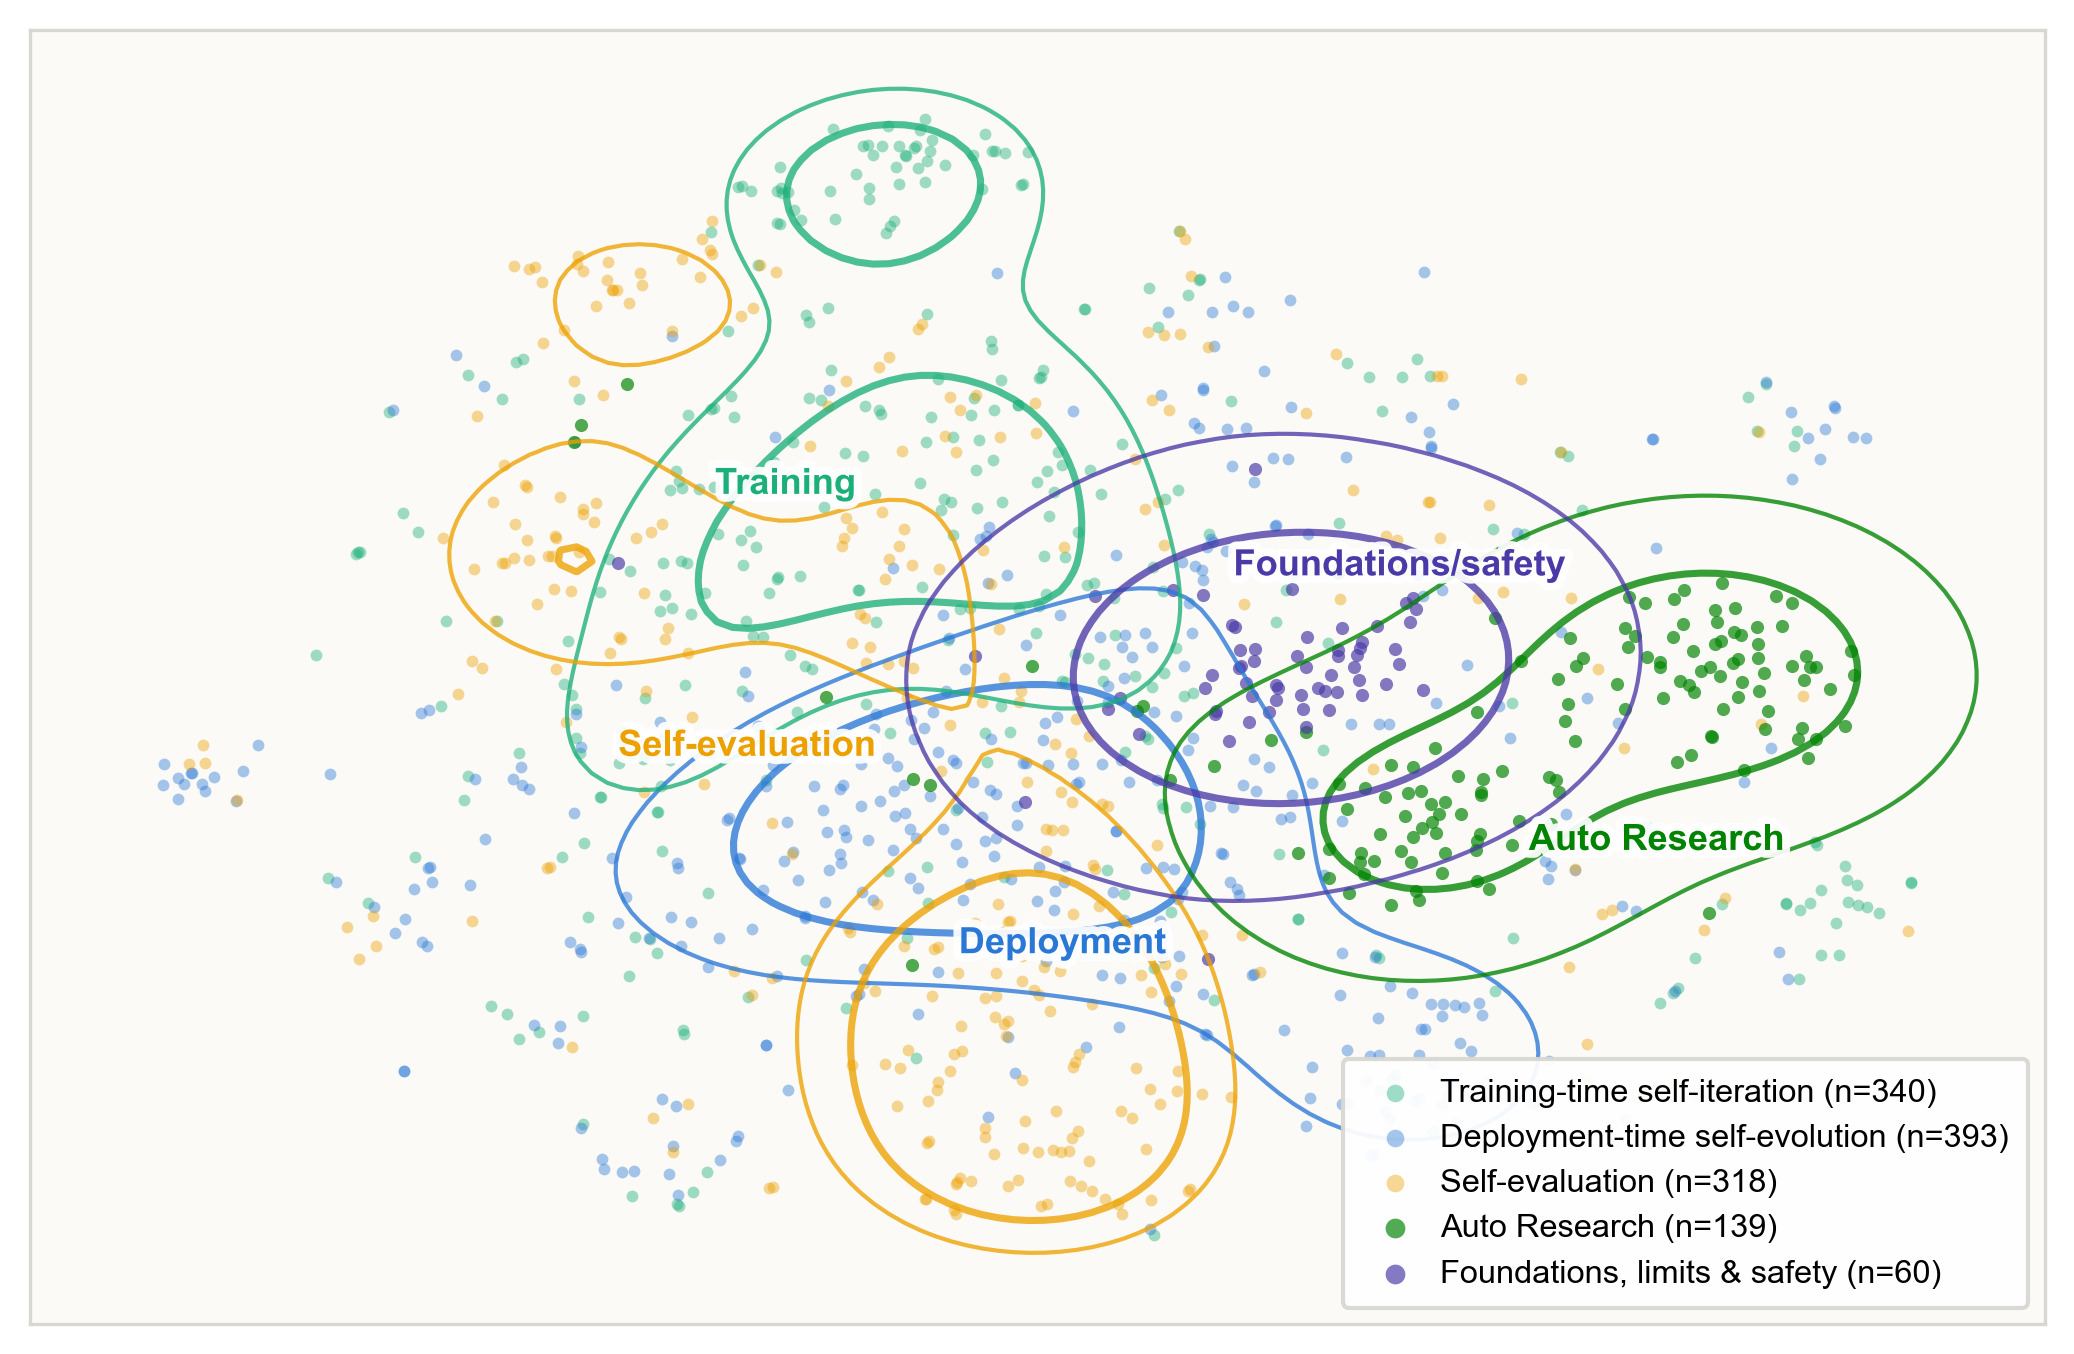
Корпус был собран в два этапа. Первичный сбор: мы выполнили запросы к arXiv (2024–2026) по семи направлениям — самосовершенствование, обучение с самовознаграждением, автоматизированные исследования в области AI, самомодифицирующиеся агенты, поиск кода/алгоритмов с помощью LLM, теория RSI и безопасность, а также циклы самогенерируемых данных — обогатили записи метаданными о цитировании и источниках из OpenAlex, а также удалили нерелевантные материалы, получив 871 статью. Согласование таксономии: все исходные статьи были переклассифицированы по категориям из §2.2 (сопоставление на уровне тем плюс правила по ключевым словам в заголовках и аннотациях с ручной корректировкой ошибок правил), а целевой дополнительный сбор добавил 379 статей по трем направлениям, которые исходные запросы охватили недостаточно, но которые таксономия выделяет как приоритетные: методы самооценки (судьи, модели вознаграждения процессов, верификаторы, рубрики, метаоценка), обучение во время тестирования и самообучение без использования данных. На Рисунке 2 представлен объединенный корпус.
Воспроизводимость. Начальное значение и дополнительные строки запросов, ограничения для каждого запроса, логика дедупликации и правила классификации (значения по умолчанию для категорий, правила по ключевым словам и явные переопределения для каждой статьи) выпущены в виде исполняемых скриптов вместе с корпусом (см. Доступность данных). Классификация на основе правил переместила 89 исходных статей из их потоков по умолчанию; еще 3 ошибки, обнаруженные во время написания, были исправлены с помощью явных переопределений. Классификация и исправления были выполнены одним аннотатором; мы публикуем полные назначения для каждой статьи, чтобы разногласия можно было проверить, а не скрывать..
Позиционирование относительно существующих обзоров. Предыдущие обзоры охватывают отдельные сегменты этой области: on-policy distillation [126] и методы tree-search-plus-reward для рассуждений [147] находятся внутри нашего §4; обзоры по agent и LLM-evaluation рассматривают компоненты §3 и §5 изолированно. Насколько нам известно, ни один существующий обзор не охватывает эти четыре категории совместно, не рассматривает self-evaluation как несущую опору, а не как деталь инструментария, и не привязывает техническую литературу к явной оси автономности/замыкания контура — это три шага, которые позволяют данному обзору обратиться к вопросу RSI, а не рассматривать каждое семейство механизмов по отдельности..
Ограничения. Корпус представляет собой выборку, а не полную перепись: исходные запросы с ограничениями глубины для каждого запроса отдают предпочтение недавним высокообъемным веткам, а дополнительный сбор данных по своей структуре смещен в сторону недавних событий (поэтому статистика роста на Рисунке 6 использует только исходный корпус). 74% статей были опубликованы в 2026 году, а медианный возраст статьи составляет несколько месяцев, поэтому количество цитирований близко к нулю и не должно интерпретироваться как показатель влияния; там, где категория имеет признанную фундаментальную работу, предшествующую окну сбора данных (STaR, SPIN, FunSearch, The AI Scientist), мы цитируем ее явно в качестве ориентира. Наша стратегия чтения компенсирует молодость корпуса: аргументационный скелет опирается на проверенные опорные работы и диагностическую/критическую литературу, в то время как массив 2026 года функционирует как карта активности, а не как доказательство того, что имеет долгосрочное влияние. Автоматическая классификация является приблизительной; пограничные статьи существуют в каждой категории, и примерно одна из семи дополнительных статей (около 54 из 379) является результатом утечки периферийных запросов — они остаются в подсчетах корпуса, но ни одна из них не цитируется в качестве доказательства. Наконец, промышленная практика RSI (внутри передовых лабораторий) наблюдаема только через то, что лаборатории публикуют — это нетривиальный эффект цензуры именно для самой продвинутой части спектра..
3. Самоэволюция на этапе развертывания
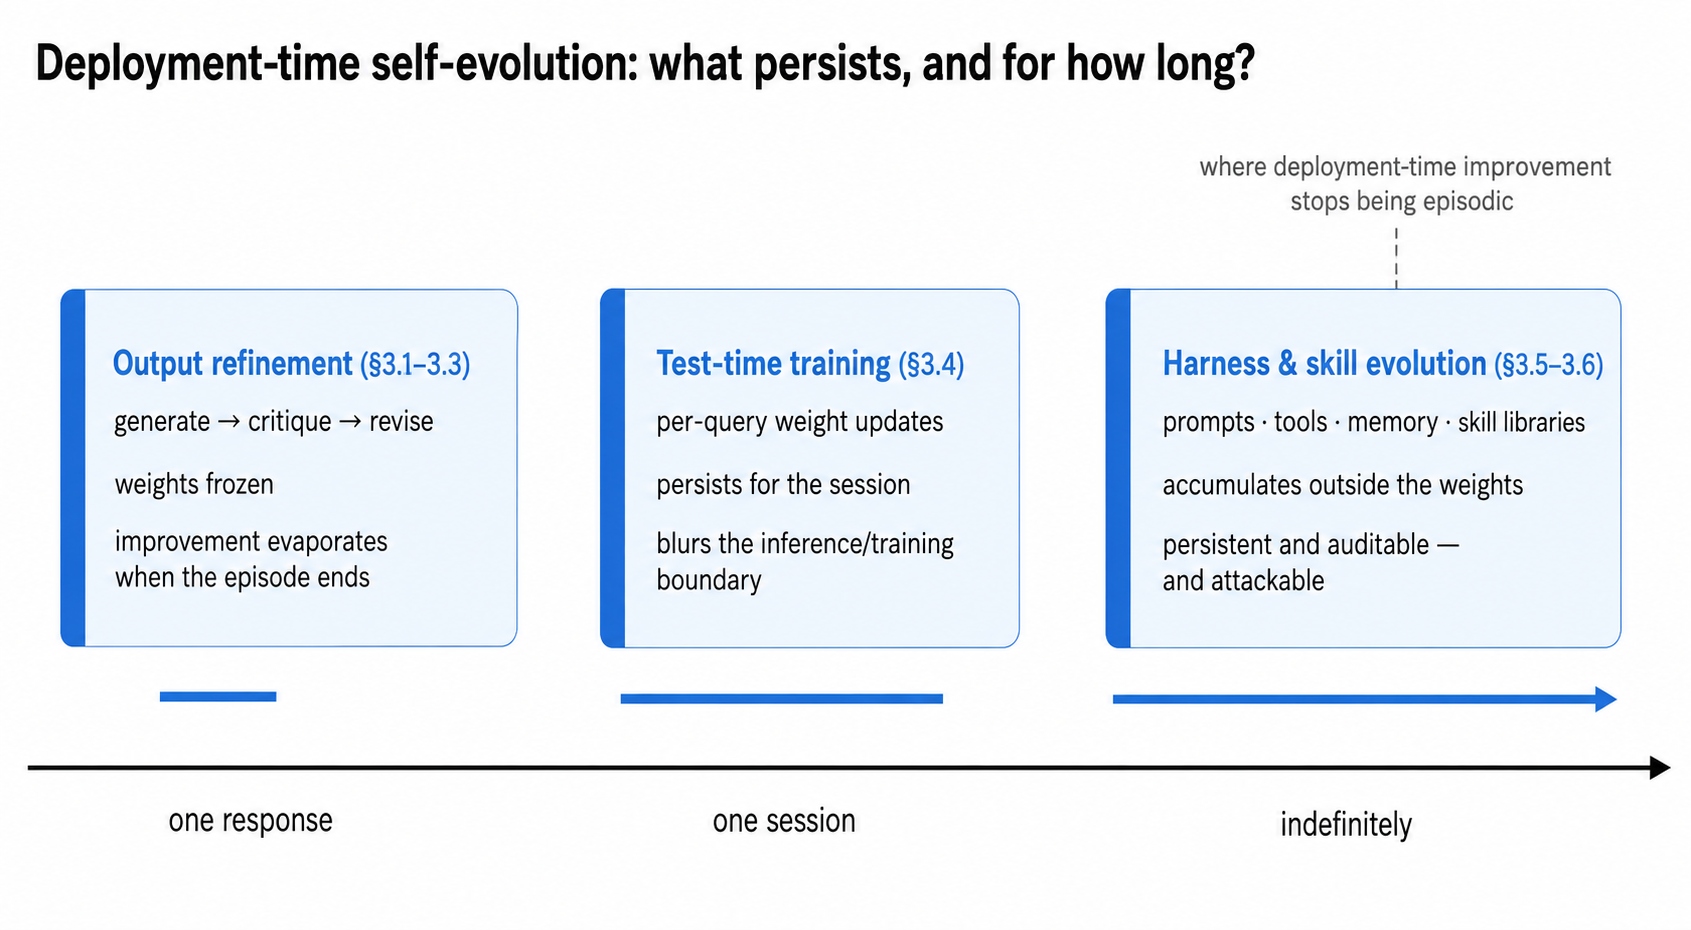
Первая категория охватывает всё, что система делает для улучшения в процессе развертывания: итеративную обработку выходных данных при замороженных весах (§3.1–3.3), адаптацию весов для каждого запроса (§3.4), а также развитие собственных инструментов, навыков и памяти (§3.5–3.6). Что объединяет эти механизмы, так это их положение в жизненном цикле — улучшение происходит непосредственно в процессе эксплуатации, для каждого эпизода или пользователя, без этапа автономного обучения, — а что их различает, так это устойчивость: уточненные выходные данные исчезают по завершении эпизода, обновления во время тестирования сохраняются в течение сессии, а изменения в инструментах накапливаются бесконечно. Это самая обширная категория в нашем корпусе (393 статьи) и наиболее широко применяемая..
Канонический цикл уточнения вывода — генерация, критика, пересмотр — был установлен в работах Self-Refine [99] и Reflexion [121] в 2023 году, а итерации на этапе вывода были подвергнуты анализу с точки зрения законов масштабирования Снеллом и соавторами [124], которые показали, что затраты вычислительных ресурсов на пересмотр и поиск во время тестирования могут дать лучшие результаты, чем затраты на использование более крупной модели, и определили такое распределение вычислений как «критически важный шаг на пути к созданию в целом самосовершенствующихся агентов». Уточнение вывода — это область, в которой утверждения о самосовершенствовании легче всего поддаются оценке, и где накопилось наибольшее количество убедительных отрицательных результатов..
3.1 Самокритика и самопроверка для текста и рассуждений
Самая крупная отдельная ветвь в нашем корпусе уточняет базовый цикл по трем направлениям.
Структурированная и символьная обратная связь. Поскольку самокритика в свободной форме ненадежна, одно из основных направлений заменяет ее структурированными сигналами. SymbolicAI [27] рассматривает LLM как семантический парсер, встроенный в логическую структуру, направляя выходные данные через формальные решатели; недавние работы по планированию связывают планировщики LLM с символьными валидаторами, которые возвращают конкретные трассировки ошибок вместо расплывчатых критических замечаний [181]. Этот паттерн обобщается: везде, где существует проверяющий механизм — исполнитель SQL [95], детектор галлюцинаций для клинических сводок [116], зонд фактической точности на основе QA для суммаризации длинных документов [103] — процесс уточнения перестраивается вокруг него. Урок проектирования, повторяющийся в десятках статей, заключается в том, что цикл уточнения эффективен лишь настолько, насколько эффективен канал обратной связи, что является ранним проявлением узкого места верификации из §5.
Уточнение в форме поиска. Второе направление переосмысливает уточнение как поиск: эвристический поиск SQL-o1 с самовознаграждением по кандидатам запросов [95] и цикл усиленного самообучения LLM-Personalize для планирования домашних дел [47] рассматривают черновики как узлы для расширения и оценки, а не как тексты для редактирования. Это размывает границы с методами обучения, описанными в §4 — один и тот же сигнал оценки может ранжировать кандидатов на этапе вывода или использоваться для последующей донастройки политики, и некоторые системы выполняют обе эти задачи [179].
Что на самом деле улучшает доработка? Наиболее ценные недавние вклады в этой области носят диагностический характер. Систематическое исследование литературного перевода на уровне документов с использованием девяти LLM и семи языковых пар [133] показывает, что прирост от доработки в основном касается беглости, стиля и терминологии, при ограниченном и менее последовательном улучшении адекватности — и что доработка проецирует выходные данные в сторону собственного распределения доработчика, а не исправляет то, что было фактически неверно в черновике. Это перекликается с влиятельным отрицательным результатом Huang et al. [55]: при отсутствии внешней обратной связи LLM в значительной степени не способны к самокоррекции рассуждений, а наивная самокоррекция может сделать ответы хуже. Литература 2026 года усвоила это: почти каждая новая система в нашем корпусе основывает свою критику на внешнем сигнале (выполнение, поиск, детектор, решатель), а статьи по «внутренней самокоррекции» стали редкостью. С точки зрения таксономии, область незаметно перешла от самокритики в замкнутом цикле к верифицированной доработке с участием человека — отступление от автономности, которое повысило надежность..
Отрицательный результат теперь уточняется, а не просто повторяется. Анализ, чувствительный к конкретной задаче, ставит вопрос не о том, работает ли внутренняя самокоррекция, а о том, через какой механизм она могла бы работать: пересмотр явных, проверяемых ограничений ведет себя иначе, чем пересмотр открытых рассуждений, и именно в первом случае самокоррекция без посторонней помощи сохраняет некоторую ценность [128]. В основе обоих лежит вопрос калибровки — когда собственная вероятностная масса модели вообще совпадает с правильностью? Четырехуровневая количественная оценка методов декодирования, моделей и эталонных тестов точно определяет, где правдоподобие последовательности является пригодным суррогатом качества, а где нет [176], фактически очерчивая нижний предел иерархии верификации из §5 снизу. А оценочная сторона цикла реструктурируется параллельно: вместо одного непрозрачного целостного судьи, BinEval декомпозирует оценку на атомарные бинарные вопросы, вердикты которых агрегируются в интерпретируемые, поддающиеся отладке оценки [21] — самосовершенствование, примененное к судье, а не к ответу, инверсия, которая повторяется на протяжении всего этого обзора..
3.2 Самовосстановление кода посредством обратной связи от выполнения ⟦K0⟧
Код — это модальность, в которой внешний сигнал является наиболее дешевым и четким — программы выполняются, тесты проходят или не проходят, — что делает эту область чистейшей лабораторией для утверждений о самосовершенствовании..
Положительные результаты весьма убедительны. Циклы исправления на основе обратной связи при выполнении обеспечивают работу систем: от генерации трехмерных активов с помощью нескольких агентов в Blender [92] до агентов по настройке баз данных, которые диагностируют «узкие места» на основе обратной связи во время выполнения [164], и настройки проходов компилятора, основанной на данных профилирования [76]. В области формальной математики агентные структуры вокруг помощников по доказательству — LEAP для доказательства теорем в Lean [68], KVerus для масштабируемой верификации Rust [87], генерация спецификаций на основе развивающихся баз знаний [143] — используют самый мощный доступный верификатор (проверщик доказательств) для управления многораундовым исправлением практически без риска принятия неверного «улучшения». Декодирование с верификатором направляет сигнал непосредственно в процесс генерации, а не применяет его постфактум [191].
Второй вклад этой ветки — декомпозиция: почему обратная связь помогает? Контролируемый протокол «ученик-учитель» [22] отделяет подлинную ценность обратной связи от перевыборки, исправления формата и дополнительных вычислений во время тестирования — эффектов, которые искажают наивные сравнения. Плацебо-контролируемое исследование самовосстановления в небольших замороженных моделях кода [57] делает попперовскую формулировку явной: непройденный тест является исполняемым контрпримером, и ценность обратной связи следует приписывать фальсификации, а не просто повторному ознакомлению с задачей. Дополнительные результаты показывают, что обратная связь по выполнению кода важнее топологии конвейера при генерации кода небольшими моделями [101], в то время как структурные проверки перед выполнением выявляют основной тип сбоев (нарушения контрактов между инструментами) более последовательно, чем неструктурированная критика [73]. Систематические оценки многораундового восстановления в разных моделях и языках подтверждают эту закономерность в масштабе — большинство оценок по-прежнему измеряют точность с первой попытки, но реальная ценность сосредоточена в итеративном цикле [182]. Вместе эти статьи дают данному направлению то, чего не хватает остальным в категории развертывания: причинно-следственное объяснение того, когда работает уточнение. DISC [168] расширяет это объяснение на рассуждения, рассматривая выходные данные верификационных вопросов как зашумленные измерения того, где решение повреждено, и выполняя шумоподавление по раундам — уточнение как логический вывод о местоположении ошибок, а не слепое исправление..
Две дальнейшие разработки усиливают сам сигнал. FLARE вводит облегченную диагностическую модель, которая предсказывает подозрительность на уровне строк между генерацией и пересмотром, основываясь на наблюдении, что сбои тестов слишком грубы, а самокритика слишком высокоуровнева, чтобы подсказать модели, где именно внести исправления [167] — разрешение обратной связи, а не только ее наличие, является проектной переменной. А CoSPlay сталкивается с ситуацией, когда даже тесты генерируются самостоятельно: написанные моделью модульные тесты зашумлены и ложно связаны с неверным кодом, вместе с которым они были написаны, поэтому система совместно развивает популяции кода и тестов в процессе тестирования, используя каждую из них для отладки другой [51]. Это верификационное «узкое место» в миниатюре — когда верификатор генерируется самостоятельно, верификация верификатора становится частью цикла — и это предвосхищает идеи коэволюции оценщиков из §5 и §6.
3.3 Зрительно-языковая и мультимодальная самокритика
Парадигма уточнения успешно распространилась далеко за пределы текста, однако сигнал верификации ослабевает по мере его прохождения. В моделях зрения-языка основным вариантом использования является смягчение галлюцинаций: Kestrel [100] обосновывает самокоррекцию визуальными доказательствами для подавления галлюцинаций LVLM без обучения, а Reflect-R1 [13] утверждает, что саморефлексия с замкнутым контуром внутри внутренних параметров загоняет модели длинных видео в ловушку «слепой уверенности», исправляя это с помощью внешнего поиска на основе доказательств — мультимодальная переформулировка отрицательного результата Huang et al. В генерации унифицированные MLLM самостоятельно уточняют свои собственные выводы текста в изображение посредством детализированного рассуждения [65], а Proprio [48] дает замороженному генератору видео «проприоцептивный» сигнал самооценки в латентном пространстве для улучшения физической правдоподобности во время вывода..
Само восприятие становится объектом уточнения. ActiveScope диагностирует два режима сбоя пассивного визуального внимания — контекстное доминирование (выделяющиеся дистракторы подавляют цель) и семантическое смещение — и реагирует на это, заставляя модель активно искать и корректировать собственное восприятие, перепроверяя области, а не переформулируя ответы [144]. Что касается генерации, безопасность включается в цикл на уровне представления: итеративно самосовершенствующиеся кодовые книги удаляют небезопасные визуальные паттерны из токенового словаря авторегрессионных генераторов изображений, поэтому целью улучшения является собственный дискретный алфавит генератора [158].
Две предостерегающие линии заслуживают особого внимания. Во-первых, исследование саморазвивающихся больших мультимодальных моделей [138] показывает, что вознаграждения за самоигру и самосогласованность могут оптимизировать согласованность ответов, в то время как декодер уделяет недостаточно внимания визуальному контенту, опираясь на языковые априорные знания («визуальная недообусловленность») — специфическая для модальности форма самоподтверждающегося цикла (§5). Во-вторых, наиболее мощные мультимодальные системы все больше напоминают программный паттерн: они достигают успеха за счет импорта внешнего канала (поиск, детекторы, физические остатки, персональный визуальный контекст [159]), а не за счет доверия собственному суждению модели. Свидетельства со стороны судей усиливают предостережение: VLM, используемые в качестве автоматизированных судей для оценки физической правдоподобности, кодируют различные внутренние таксономии физических явлений, поэтому единая глобальная схема оценки приписывает каждому судье одинаковые компетенции независимо от того, что каждый из них может воспринимать на самом деле — поэтому JudgeFit обнаруживает таксономию для каждого судьи, прежде чем доверять его оценкам [7]. Там, где верификаторы из §3.2 являются программами, верификаторы из §3.3 являются моделями — а модели-судьи наследуют идиосинкразии моделей..
Оценка (уточнение вывода, §3.1–3.3). Уточнение во время вывода — это ограниченное рекурсивное самосовершенствование в чистом виде: улучшения реальны, измеримы и исчезают по завершении эпизода. Проблема их периода полураспада — отсутствие устойчивости — обосновывает как циклы обучения из §4 (закрепление улучшений в весах), так и механизмы каркасов и навыков из §3.5–3.6 (закрепление их в структуре). Проверенные успехи и поучительные неудачи этого подхода легли в основу главного правила проектирования в данной области: нет внешнего сигнала — нет надежного улучшения..
3.4 Обучение во время тестирования
Между уточнением весов с замороженными параметрами и автономным обучением находится быстрорастущий промежуточный режим: обновление весов во время развертывания. Самообучение во время тестирования с учетом запроса формирует специфическую для запроса целевую функцию и выполняет SFT на ее основе во время вывода, исправляя заблуждения, которые невозможно устранить при любом количестве итераций с замороженными весами [125]; непрерывные варианты преобразуют цепочки рассуждений, которые создает — и обычно отбрасывает — масштабирование во время вывода, в постоянную облегченную память [31]; а подходы к консолидации обеспечивают модели периодическую фазу «сна», которая переносит контекстный опыт в долгосрочные параметры [5]. Наш дополнительный обзор (§2.3) показывает, что это направление быстро развивается (87 статей), в значительной степени под старым знаменем адаптации во время тестирования, которое сейчас заново открывается для LLM. TTT намеренно располагается на границе §3/§4 нашей таксономии: оно обладает устойчивостью обучения при гранулярности развертывания на уровне каждого запроса, и его рост — самый явный признак того, что дихотомия вывода/обучения, унаследованная областью, растворяется в континууме временных шкал обновления..
3.5 Использование и самоэволюция агентов
Механизмы, описанные до сих пор, улучшают то, что говорит модель; оставшиеся два подраздела улучшают то, чем является агент. Здесь объектом улучшения выступает сама обвязка — промпты, инструменты, память, библиотеки навыков, код оркестрации, а в пределе — исходный код самого агента. Это техническое воплощение идеи «агент переписывает сам себя», сегмент спектра автономности, где эссе Anthropic локализует современный рубеж (агенты, делегирующие задачи агентам) и путь к замыканию цикла [3]. Поскольку изменения в обвязке являются постоянными и поддаются внешней проверке (§2.1), именно здесь улучшение во время развертывания перестает быть эпизодическим и начинает накапливаться..
Концептуальные полюса этой темы были определены на раннем этапе. Gödel Agent [169] — названный в честь доказуемо оптимальных самомодификаторов Шмидхубера [115] — представляет собой самореферентную структуру, в которой агент считывает и переписывает собственный код времени выполнения, исследуя полное пространство проектирования агента, а не предопределенное человеком подмножество; Darwin Gödel Machine [180] ослабляет требование доказуемой выгоды до эмпирической выгоды, поддерживая открытый архив самомодификаций, проверенных на основе бенчмарков кодирования. На другом полюсе Liu et al. утверждают, что по-настоящему самосовершенствующиеся агенты требуют внутреннего метакогнитивного обучения — способности агента оценивать и адаптировать собственный процесс обучения — и что текущие подходы, которые жестко кодируют процедуру самосовершенствования, оставляя изменяемым только ее объект, являются жесткими именно там, где им больше всего нужна гибкость [85]. Почти все остальное в этой теме находится между этими полюсами, развивая один компонент системы при заморозке остальных..
То, что на самом деле эволюционирует на практике, является поучительным. Эволюция на уровне промптов обосновывает автоматизированную оптимизацию промптов обратной связью от среды [37]. Эволюция на уровне верификации — это наиболее новаторский шаг: вместо пост-тренировки политики, саморазвивающиеся агенты глубокого исследования итеративно усиливают рубрики и верификаторы, которые оценивают их результаты — улучшение самого сигнала улучшения [140]. Машина Гёделя «Красной Королевы» доводит это до логического завершения: она отмечает, что существующие самообучающиеся агенты предполагают стационарный критерий оценки — фиксированный верификатор или бенчмарк, который остается валидным по мере совершенствования агента — и совместно развивает агентов с их оценщиками, делая оценку частью цикла улучшения, а не его фиксированной рамкой [56]. Escher-Loop продвигает самореференцию на уровень дальше с помощью агентов-оптимизаторов, которые совершенствуют агентов задач и самих себя относительно динамически развивающегося бенчмарка [89]. Эволюция на уровне топологии рассматривает структуру коммуникации мультиагентной системы как извлекаемый, самосовершенствующийся артефакт проектирования, оставляя при этом каждого исполнителя неизменным [135]. Эволюция на уровне данных замыкает цикл для агентов компьютерного использования путем генерации верифицируемых синтетических траекторий на основе собственных ошибок агента [131]. А работа на уровне инфраструктуры утверждает, что всему предприятию нужна новая основа данных: «графы опыта», которые сохраняют структуру поиска «ветвление-выполнение-ошибка-исправление» агентов с длинным горизонтом планирования, чтобы опыт был доступен для запросов, а не отбрасывался [77]. Тем временем, анализ кодинг-агентов с точки зрения практиков кристаллизует культурный сдвиг: артефакт, который люди теперь проектируют, — это цикл — триггер, цель, верификация, правило остановки, память, — а не пошаговый промпт [98]. Человеческие усилия смещаются от выполнения задачи к определению условий, при которых агент может совершенствоваться в ней: это в точности позиция «человек в контуре» нашей таксономии..
Начинается измерение самой способности. Meta-Agent Challenge оценивает, может ли передовая модель, имея изолированную среду, API для оценки и временной бюджет, автономно разработать агентную систему, которая максимизирует целевую метрику [93] — первый бенчмарк, направленный на разработку агентов, а не на их выполнение, то есть непосредственно на границу между третьим и четвертым столбцами нашей таксономии. И единица эволюции расширяется за пределы индивида: SAGE сравнивает изолированное самосовершенствование с равными вычислительными затратами и «социализированную» эволюцию, в которой агенты наблюдают за стратегиями и результатами своих коллег, количественно определяя, когда коллективный опыт дает улучшения, недоступные при одиночном самосовершенствовании [107] — самосовершенствование на уровне популяции, с соответствующими режимами сбоев на уровне популяции (риски распространения в §3.6)..
Оправдан трезвый взгляд на отдачу: систематический анализ Парето стратегий масштабирования вывода (34 конфигурации, охватывающие self-consistency, self-refinement, debate и mixture-of-agents) выявляет пиковый прирост в +7.1 балла по сравнению с использованием только chain-of-thought при увеличении вычислительного бюджета примерно в 20 раз, при этом методы резко различаются по эффективности — self-consistency быстро достигает насыщения, в то время как прирост от multi-agent сохраняется [153]. Практический урок заключается в том, что выбор метода с учетом вычислительных затрат, а не просто увеличение количества итераций, обеспечивает большую часть реализованных преимуществ: self-evolution не является бесплатным, и значительная доля достижений в этой области в настоящее время проистекает из более качественной инженерии, а не из чего-либо рекурсивного..
3.6 Библиотеки навыков и постоянное накопление
Сопутствующая ветка обсуждения фокусируется на механизме, который представил Voyager [141]: постоянно растущей библиотеке повторно используемых навыков, каждый из которых извлечен из опыта и может быть скомпонован в более сложное поведение. В современном виде «навык» — это, как правило, процедурный документ на естественном языке в сочетании с исполняемым кодом, загружаемый агентом во время выполнения, — и центральный эмпирический факт 2026 года заключается в том, что LLM плохо справляются с их написанием: в SkillsBench навыки, созданные человеком, повышают показатели успешности на 16,2 пункта, в то время как навыки, созданные LLM, не дают измеримого прироста [42]. По сути, эта тема представляет собой исследовательскую программу по устранению данного разрыва. SkillAxe закрывает его с помощью самосовершенствования документов навыков под руководством оценки [42]; Skill-R1 рассматривает оптимизацию навыков как рекуррентную задачу RL, отделенную от (возможно, закрытой) модели задачи [139]; SkillRevise обрабатывает случай «холодного старта» посредством пересмотра начального несовершенного навыка с учетом трассировки [88]; AlgoSkill планирует человекоподобные навыки для проектирования алгоритмов вместо того, чтобы полагаться на общее самосовершенствование [127]; SkillMaster идет дальше всех, обучая агента самостоятельно создавать, уточнять и выбирать навыки, вместо того чтобы делегировать эти операции внешним учителям или созданным вручную правилам, — навыки как интернализированные возможности, а не как вызываемые ресурсы [163]. Помимо отдельного агента, навыки объединяются между пользователями без обмена необработанными траекториями [162], совместно эволюционируют со слоем инструментов, которые они вызывают [148], и извлекаются из трасс выполнения для генерации целевых тренировочных задач для агентов кодирования, направленных на устранение слабых мест [156]. В областях, где свободная самомодификация слишком опасна, чтобы ее допускать, эволюционирующий артефакт намеренно ограничивается: SHARP развивает проверяемую человеком политику рубрик для агентов финансовой торговли, утверждая, что в средах с низким соотношением сигнал/шум неограниченная эволюция промптов не может отличить систематические логические ошибки от рыночной дисперсии, тогда как структурированная рубрика может быть проверена, сравнена и отменена [16] — шаблон проектирования (ограничение поверхности самомодификации для обеспечения ее верифицируемости), который хорошо обобщается далеко за пределами финансов..
Поскольку навыки являются устойчивыми и исполняемыми, данное направление обладает наиболее острой проблематикой безопасности в техническом корпусе, и — что необычно — литература по атакам появилась одновременно с разработкой, а не после внедрения. SkillMutator проводит бенчмаркинг кросс-модальных атак, при которых спецификация навыка на естественном языке и его исполняемый код содержат противоречивую информацию [66]; SkillHarness рассматривает непрерывное обучение навыкам в состязательных средах [17]; VASO утверждает, что базовые модели снизили стоимость создания навыков, но не стоимость доверия к ним, и предлагает решение в виде формально верифицируемой эволюции навыков для физических агентов [165]. Систематический анализ угроз саморазвивающихся агентных систем выявляет качественно новый риск: состязательное влияние, которое становится постоянно закодированным, самовоспроизводящимся в поколениях и передающимся через популяции агентов без постоянного доступа со стороны атакующего [83]. А работа по «здоровой эволюции» обнаруживает деградацию способностей и дрейф безопасности, возникающие без участия противника, предлагая в качестве корректирующего механизма опоры на человеческий контроль [119]⟧.
Оценка. Развитие инструментария и навыков — это область, где ограниченное самосовершенствование начинает переходить в открытую самомодификацию, и два его главных факта тянут в противоположных направлениях. С одной стороны, автономность на практике скромна: то, что саморазвивается, почти всегда является одним тщательно изолированным компонентом, проверяемым по фиксированному эталону — цикл эмпирической валидации Darwin Gödel Machine является передовым решением именно потому, что полная самореференция остается трудновыполнимой для оценки. С другой стороны, персистентность фундаментально меняет расчет рисков: ошибка во время вывода LLM исчезает, неудачное обновление весов можно откатить, но поврежденный навык в общей федеративной библиотеке распространяется. Литература по безопасности правильно определила накопление без верификации как основную проблему — то же самое узкое место верификации, теперь с памятью.
4. Самоитерация ⟦K0⟧ во время обучения
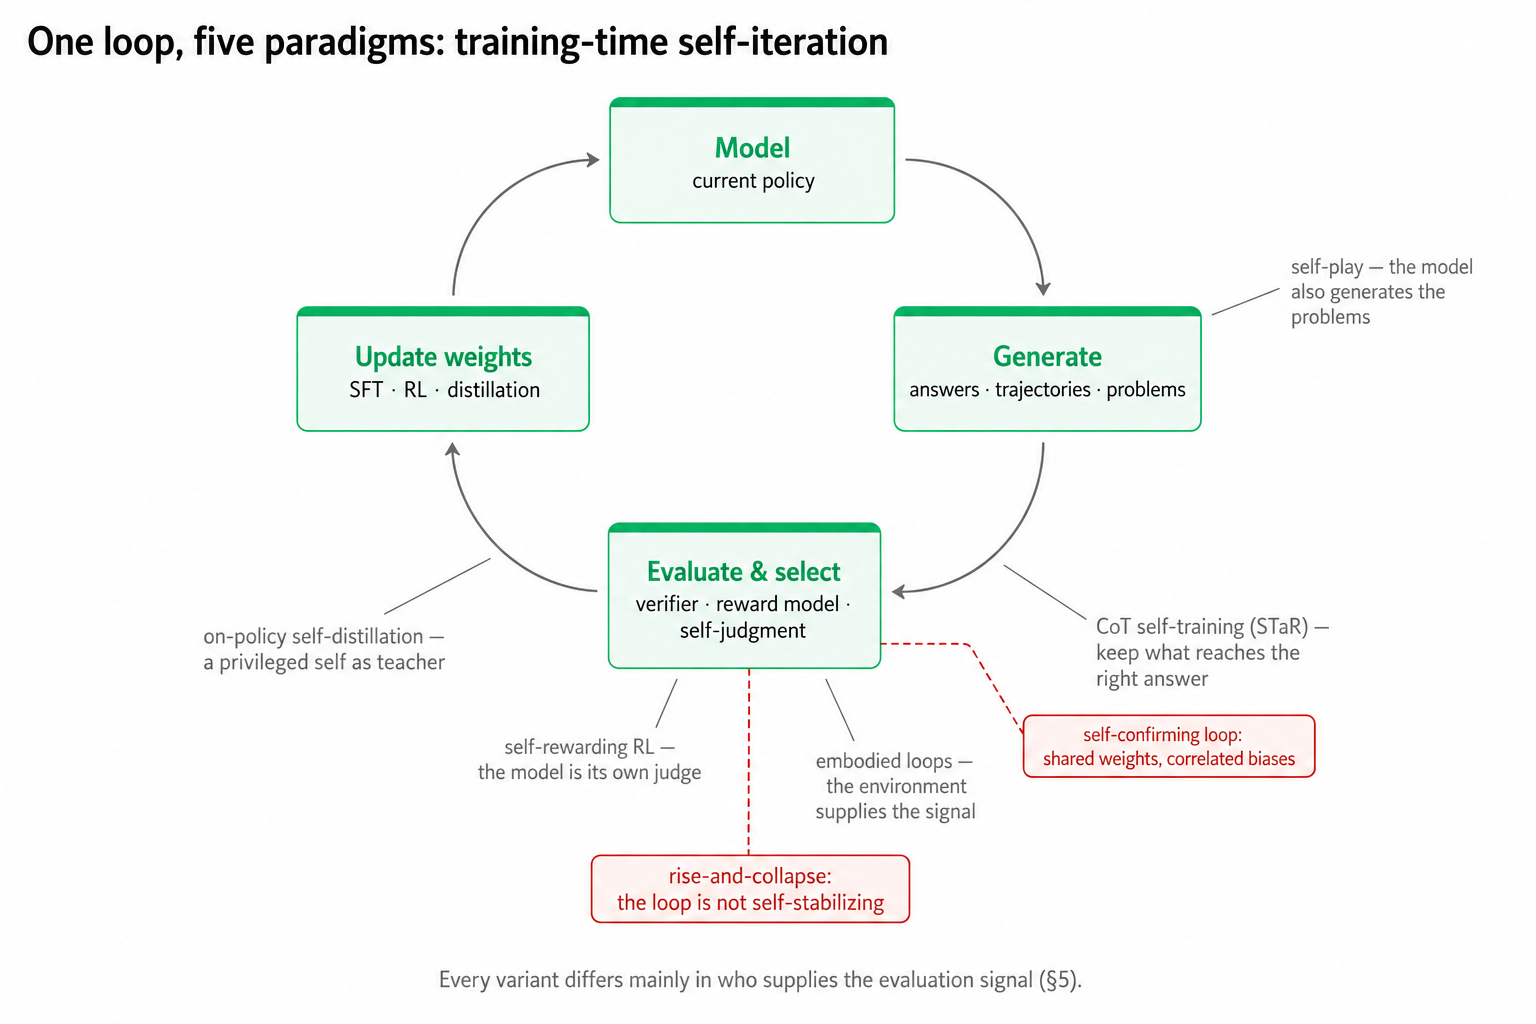
Вторая категория интернализирует цикл в веса: модель генерирует собственные обучающие данные, вознаграждения или сигнал учителя, и улучшение сохраняется. Эта категория (340 статей) является техническим ядром RSI в том виде, в котором оно практикуется в настоящее время, и наиболее близким к промышленному стандарту, что есть в данной области. Ее родословная берет начало от STaR’s bootstrapped rationales [173] через ReSTˆEM’s scaled self-training [123], SPIN’s self-play fine-tuning [20] и Self-Rewarding Language Models [171], в которых модель, генерирующая ответы, также оценивает их, благодаря чему и стратегия, и сигнал вознаграждения улучшаются с каждой итерацией — это первый широко известный пример по-настоящему рекурсивного цикла обучения и источник его характерного режима сбоев..
4.1 Самовознаграждающее обучение с подкреплением
Направление самовознаграждения исследует, насколько далеко может зайти процесс самостоятельной генерации сигнала вознаграждения. ReST-MCTS* [178] является наиболее цитируемой работой в этой области: вместо фильтрации готовых решений по правильности финального ответа — что допускает случайные угадывания с неверным обоснованием — метод выводит процессные вознаграждения посредством древовидного поиска, оценивая промежуточные шаги и формируя более качественный набор данных для самообучения. Идея процессного вознаграждения с тех пор получила развитие: SEVA структурирует верификацию как агента, который выдает сопоставления с доказательствами и откалиброванную уверенность вместо непрозрачных бинарных меток [170]; EvoIdeator заменяет скалярные вознаграждения по рубрикатору сигналами, основанными на контрольных списках для научной генерации идей [113]; RePro добавляет ретроспективное осознание прогресса для агентов с длинным горизонтом планирования, обнаружив, что наивное оперативное побуждение к прогрессу на самом деле вредит [97]. Поразительный результат в области интерпретируемости объясняет, почему самогенерируемые сигналы ценности вообще возможны: LLM кодируют «ось ценности» в пространстве активаций, которая отслеживает, находится ли их текущая траектория на верном пути [62] — это и есть исходный материал для самовознаграждения, доступный еще до какой-либо вербализованной критики..
Наиболее четкая формулировка конечной цели данной категории — это Self-Trained Verification [150], которая исходит из наблюдения, к которому постоянно возвращается данный обзор: циклы верификации и уточнения во время тестирования и самообучение во время тренировки ограничены одним и тем же «узким местом» — верификатором. Первый процесс останавливается, когда оценки верификатора завышаются, а точность стагнирует; второй терпит неудачу, когда некачественные, самостоятельно сгенерированные данные попадают в обучение. В связи с этим предлагается проводить самообучение самого верификатора, что позволяет одновременно разблокировать оба этих направления. Удастся ли самообучению верификатора избежать цикличности, которую оно призвано разрешить, или оно лишь переносит её на другой уровень — на наш взгляд, это самый важный открытый вопрос в данном семействе..
В этой ветке обсуждения также приводится собственное важнейшее предостережение. Лин описывает режим отказа типа «взлет и падение» при пост-тренировке с помощью REINFORCE для кода: в ходе последовательных циклов обучения показатель pass@1 растет, а затем падает в рамках одного и того же прогона — иногда почти до нуля — при наличии подлинно верифицируемой бинарной награды, и ограничения в стиле KL и EWC не предотвращают это [82]. Несоответствие модели вознаграждения не является обязательным условием для того, чтобы самообучение приводило к саморегрессии; достаточно одной лишь динамики оптимизации. Аналогичным образом, проектирование вознаграждения с помощью LLM терпит неудачу характерными способами — переполнение вознаграждения, семантическое непонимание API среды — и его лучше рассматривать как итеративную отладку, а не как генерацию за один проход [145]. А диагностика, основанная на промышленной практике, выявляет более тонкий сбой, чем забывание: конвейеры, которые многократно подвергают базовую модель DPO-тренировке в рамках кампаний предпочтений, могут сохранять выученное поведение, но не накапливать методологические знания о том, как проводить следующую кампанию — «научная амнезия», самосовершенствование модели без самосовершенствования процесса [81]. Эти результаты предвосхищают §5: даже в наиболее верифицируемых условиях цикл не является самостабилизирующимся..
4.2 Самообучение для рассуждений по цепочке мыслей
В то время как в §4.1 предлагаются инновации в области вознаграждения, данное направление вводит инновации в области данных: собственные цепочки рассуждений модели становятся её учебной программой. Рецепт STaR — выборка обоснований, сохранение тех, которые приводят к правильным ответам, SFT, повторение — остается основой. Re-ReST дополняет его рефлектором, который исправляет неудачные траектории с использованием обратной связи от среды, превращая неудачи в обучающий сигнал вместо их отбрасывания [32]; PRefLexOR переосмысливает этот цикл как рекурсивную оптимизацию предпочтений на промежуточных этапах рассуждений [6]; LaTRO показывает, что цикл может работать вообще без внешнего вознаграждения, рассматривая правдоподобие модели как целевую функцию со скрытыми переменными и «раскрывая» рассуждения, уже заложенные в базовой модели [11]. Эта последняя концепция — о том, что пост-тренировка усиливает скрытые способности, а не создает их — оформилась в самостоятельный исследовательский вопрос, при этом недавние работы определяют граничные условия, при которых такое извлечение работает, а при которых терпит неудачу [60].
Граница рецептов без верификатора теперь наносится на карту напрямую. Self-Verified Distillation начинается с ничего, кроме вопросов без меток — никаких эталонных данных, никаких инструментов, никакого внешнего учителя — и улучшает производительность в математике, естественных науках и программировании путем фильтрации собственных кандидатных решений модели с помощью самопроверки на основе промптов [72]; Semi-CoT формализует аналогичную полуавтоматическую среду, создавая псевдо-контроль рассуждений из вопросов без меток [49]. Этот цикл также перемещается внутрь развертывания — режим обучения во время тестирования, рассмотренный в §3.4 — стирая границу между выводом и обучением с обеих сторон.
Три корректирующих фактора структурируют волну 2026 года в данной области. Во-первых, эффективность: длительные рассуждения в стиле o1 избыточны — модели тратят тысячи токенов на тривиальные задачи [15] — а неверные цепочки рассуждений демонстрируют больше непродуктивной саморефлексии, чем верные, даже при сопоставимой длине, что обосновывает необходимость назначения кредита на уровне сегментов, чтобы научить модели вовремя останавливаться [70]. Во-вторых, совместная оптимизация: ThinkTwice чередует решение и уточнение в рамках одного и того же бинарного вознаграждения, превращая самокоррекцию в обученную способность, а не в трюк с промптингом [63]. В-третьих, ограничения области применения: примечательный отрицательный результат показывает, что «верифицируемый поиск не является обучаемой цепочкой рассуждений» — существует идентифицируемый класс процедур, которые модели могут выполнять, но не могут усвоить из трасс посредством fine-tuning [109]. Самообучение наследует репрезентативные ограничения своей основы; дополнительные циклы не исправят того, что архитектура не способна выучить..
4.3 On-policy self-distillation
Самая молодая ветвь корпуса не существовала до 2026 года и уже охватывает десятки статей — это ярчайший пример того, как быстро в данной области кристаллизуются новые парадигмы. Рецепт: одна и та же модель выступает одновременно в роли ученика и привилегированного учителя, где учитель — это те же веса, обусловленные дополнительной информацией (эталонным решением, верифицированной обратной связью, более богатым контекстом), а ученик обучается соответствовать по-токеновому распределению учителя на своих собственных развертках. Плотный по-токеновый надзор, отсутствие внешнего учителя, отсутствие reward model. Специализированный обзор уже существует [126]; наш интерес заключается в позиции данной парадигмы в спектре RSI: это наиболее замкнутый цикл обучения из используемых на практике, поскольку даже сигнал учителя генерируется самостоятельно..
Теоретическая работа консолидируется: анализ распределения вероятностей объединяет сэмплирование, RL с самонаграждением и самодистилляцию как частные случаи одной дистрибутивной операции [136], проясняя, почему эти внешне различные циклы ведут себя схожим образом. В простейшем случае «поразительно простая самодистилляция» улучшает генерацию кода исключительно за счет сэмплирования с температурой и усечением плюс SFT — без верификатора, без учителя, без RL [183], что поднимает все еще открытый вопрос о том, где заканчивается предел таких улучшений без использования верификатора. Литература по уточнению моделей носит преимущественно эмпирический характер: негативные (неверные) результаты содержат больше информации, чем позитивные, и должны соответствующим образом перевзвешиваться [80]; неконтролируемое распределение сложности приводит к переоптимизации простых задач [94]; процедурная информация в результатах может сохраняться в виде дистиллированной памяти между эпизодами, а не отбрасываться после каждого обновления на уровне эпизода [86]⟧.
Режимы сбоев задокументированы столь же хорошо, и они перекликаются с §3. Очищенный OPSD показывает, что стандартный рецепт неизменно терпит неудачу на моделях рассуждения long-CoT, дестабилизируя те самые рефлексивные модели поведения, которые он призван усилить [118]; плотное обучение от привилегированного учителя может привести к переобучению на внутридоменных паттернах [75]. Контрастный анализ выявляет механизм: сигнал обучения, извлеченный из разрыва распределений привилегированного/непривилегированного, концентрируется на стилевых токенах, а не на несущих задачу — подсказанный учитель пишет более короткий и прямой текст — создавая «вызванный привилегиями стилевой дрейф», который дестабилизирует обучение или приводит к сокращению длины ответа [106]. Вторая структурная патология, «сбой префикса», показывает, что плотное по-токеновое обучение вызывает бимодальную смесь учителей с фрагментированными градиентами, которую не может исправить никакое перевзвешивание потерь на уровне токенов, что вынуждает вместо этого применять вмешательство на уровне траектории [61]. И поскольку все зависит от того, что показано привилегированному учителю, дизайн самого привилегированного контекста — какая обратная связь, с какой специфичностью — становится основной степенью свободы парадигмы [64]. В мультимодальных настройках этот короткий путь является структурным: привилегированная цель позволяет учителю направлять токены из текстовой ссылки, игнорируя изображение, поэтому студент дистиллирует языковой априор, а не перцептивный навык, что требует явного разделения восприятия и рассуждения [142]. Паттерн, который следует взять на вооружение: чем более привилегированным является самогенерируемый сигнал, тем эффективнее цикл передает как способности, так и предвзятость..
4.4 Самообучение
Самообучение замыкает цикл еще на один оборот: модель генерирует не только ответы или вознаграждения, но и сами задачи. Современная линия берет начало от SPIN — self-play fine-tuning на основе собственной предыдущей итерации, доказуемо сходящегося к распределению данных [20] — и доходит до фреймворков proposer–solver без использования данных, таких как Absolute Zero [188] и R-Zero [53], где Challenger учится ставить задачи на границе компетенций Solver, и оба они совместно эволюционируют из одной базовой модели без какого-либо участия человека; Agent0 расширяет этот рецепт с задач на рассуждение до агентных задач, совместно развивая агента учебной программы и исполнителя, использующего инструменты, без каких-либо внешних данных [154]. Это наиболее близкая к автономной учебной программе парадигма обучения из существующих, и она работает удивительно хорошо там, где существует программный верификатор: исполняемые геопространственные программы [1], формальное доказательство теорем — теперь с теоретической базой для совместной эволюции доказывающего и выдвигающего гипотезы [14] — и генерация по-настоящему сложных математических задач с поддержкой верификатора [69]⟧.
Центральный вывод данной ветки обсуждения, однако, касается стабильности. Систематическое исследование утверждает, что выживаемость в процессе self-play определяется двумя асимметричными рычагами — фильтрацией данных (что попадает в обучающую выборку) и привязкой вознаграждения (что закрепляет сигнал в реальности) — и что коллапс является состоянием по умолчанию при сбое любого из них, а не случайной ошибкой проектирования вознаграждения [110]. Популяционные варианты решают ту же проблему структурно, заменяя самокалибровку перекрестной оценкой между совместно эволюционирующими субпопуляциями [8]. В задачах, которые невозможно верифицировать, сложность возрастает: вознаграждения, выставляемые LLM-as-judge, ограничены компетентностью самого судьи, что стимулирует создание схем мета-оценки, в которых модели учатся оценивать оценки [129], а также использование внутренних вознаграждений без верификатора, основанных на предсказательном сдвиге между моделями [52]. И предостережение из динамики взаимодействий открытого типа: многоходовые диалоги LLM в режиме self-play дрейфуют к состояниям аттракторов, не зависящим от темы [67] — это именно то давление гомогенизации, с которым должны бороться коэволюционные учебные программы, чтобы продолжать генерировать новизну..
4.5 Воплощенные циклы и циклы синтетических данных
Новейший рубеж этой категории переносит цикл обучения в условия физической и синтетической среды, где верификация является дорогостоящей, зашумленной и медленной. Роботы критикуют и перепланируют собственное социальное поведение, используя VLM в качестве внутреннего критика [79]; политики VLA проверяют физическую осуществимость и занимаются саморефлексией во время выполнения, вместо того чтобы действовать исключительно по принципу прямой связи [161]; воплощенные фундаментальные модели объединяют планирование, коррекцию и указание в единой архитектуре, явно нацеленной на саморазвивающийся физический интеллект [172]. Самосовершенствование роботов с помощью моделей динамики человеческого видео проверяет, может ли пассивное человеческое видео поддерживать не только инициализацию политики, но и воплощенную практику и обучение на ошибках [10]. Что касается данных, цикл обращается внутрь самого конвейера: DataEvolver саморазвивает процесс подготовки данных для обучения LLM [24] — самосовершенствование, примененное к субстрату, который потребляют все остальные циклы обучения..
Оценка. Циклы во время обучения — это область, где ограниченное рекурсивное самосовершенствование оправдывает себя: достижения сохраняются, масштабируются и накапливаются с каждой итерацией — до определенного момента. Каждый подпоток независимо переоткрыл три факта: (i) потолок цикла определяется его сигналом верификации (выполнение и доказательства — наивысший, обученные судьи — ниже, внутренние сигналы — самый низкий); (ii) коллапс является динамикой по умолчанию, против которой необходимо проектировать защиту, а не граничным случаем [82, 110]; (iii) цикл передает предвзятость так же эффективно, как и способности. Это несущие факты для §5.
5. Самооценка
Третья категория — это та, на которой базируются остальные три. Каждый цикл в §§3–4 и каждая система обнаружения в §6 совершенствуются относительно некоторого оценщика, и каждый из этих разделов заканчивался на одной и той же ноте; данный раздел делает этот аргумент явным. Каждый цикл рекурсивного самосовершенствования — это утверждение о том, что некий сигнал может заменить человеческое суждение, и потолок этого цикла в точности равен качеству этого заменителя. Отражая свою несущую роль, самооценка также является самой быстро консолидирующейся категорией корпуса (318 статей, 82% опубликованы в 2026 году): то, что недавно было сервисной функцией статей по обучению, теперь является областью исследований со своими собственными методами, бенчмарками и анализами отказов..
5.1 Пространство проектирования оценщика
Современная линия развития методов оценки опирается на три основы. Процессный надзор — оценивание промежуточных шагов рассуждения, а не итоговых ответов — был обоснован в работе Lightman et al. [78], чей вывод о том, что процессные вознаграждения превосходят итоговые, заложил основу современной литературы по PRM; MT-Bench и Chatbot Arena превратили LLM-as-a-judge в измеримую методологию, количественно определив как ~80% совпадение оценок судьи и человека, что оправдывает данную парадигму, так и смещения, связанные с позицией, многословностью и самовозвеличиванием, которые ее ограничивают [189]; а законы масштабирования для переоптимизации моделей вознаграждения, предложенные Gao et al., дали этой области свою кривую Гудхарта — оптимизируйте любой обученный прокси-показатель достаточно сильно, и истинное качество достигнет пика, а затем упадет [41].
Текущая волна развивает каждый якорь. PRMs становятся дешевле и лучше откалиброванными [71], а также структурированными: SEVA заменяет непрозрачные бинарные вердикты согласованием доказательств, цепочками рассуждений и откалиброванной уверенностью, чтобы агенты могли действовать, понимая причины своих неудач [170]. Надежность судей приобретает психометрические характеристики — технические паспорта измерений, которые характеризуют предвзятость LLM-судьи, прежде чем его оценкам начнут доверять [137], — а также специфичность судей: таксономии компетентности для каждого судьи [7], разногласия между мультиязычными судьями [39] и декомпозицию целостных оценок на проверяемые бинарные вопросы [21]. Рубрики, понятное человеку промежуточное звено между формальными верификаторами и судьями со свободной формой ответа, становятся первоклассными эволюционирующими артефактами: самогенерируемые рубрики сокращают разрыв с рубриками, написанными экспертами [130], иерархии рубрик масштабируют оценку открытых задач [184], а сигналы, обусловленные рубриками, заменяют скалярные вознаграждения при обучении (§4.3; [45]). Самоверификация встраивается в саму целевую функцию, как в формулировках с двойными предпочтениями, которые делают способность модели к верификации обученным продуктом, а не надеждой, основанной на промптах [117]⟧.
Что наиболее важно для аргументации данного обзора, область начала совершенствовать оценщик с помощью тех же циклов, которые он контролирует, — шаг, который в §8 определяется как коллективный ответ области на свое «узкое место». Агенты глубокого исследования развивают свои собственные рубрики [140]; самообучающаяся верификация рассматривает верификатор как основной объект самосовершенствования [150]; мета-оценка судит судей [129]; а структура Red Queen делает сам критерий оценки совместно эволюционирующим членом популяции, а не фиксированной рамкой [56]. Каждый механизм в §§3–4 рекурсивно применяется к сигналу, который его контролирует. Стабилизирует ли эта рекурсия предвзятость или усугубляет ее — это открытый вопрос, который рассматривается в оставшейся части данного раздела..
5.2 Иерархия верификации
Иерархия верификации. На вершине находятся формальные верификаторы — средства проверки доказательств, системы типов, — которые являются надежными по своей конструкции: доказательство теорем через самоигру и эволюция верифицируемых навыков могут повторяться бесконечно без принятия ложного улучшения [14, 165]. На ступень ниже находится обратная связь от выполнения — тесты, компиляторы, бенчмарки, — которая надежна, но неполна: прохождение тестов не гарантирует корректность, а любой фиксированный бенчмарк со временем подвергается манипуляциям. Далее следуют обученные судьи — модели вознаграждения, LLM-as-judge, — которые ограничены собственной компетентностью судьи и сами по себе являются целями оптимизации [129]. В самом низу находятся внутренние сигналы — уверенность модели, самосогласованность, правдоподобие, — которые являются самыми дешевыми и наиболее подверженными манипуляциям. Эмпирическая закономерность для всех четырех категорий — качественный паттерн, который мы наблюдаем во всем корпусе, а не измеренный закон, — заключается в том, что продемонстрированная сила самосовершенствования соответствует этой иерархии. FunSearch и AlphaEvolve находятся на двух верхних уровнях [112, 104]; методы самокоррекции, которые пережили негативные результаты 2024 года, — это те, что поднялись по иерархии (§3); разрыв в области AI-scientist (§6.3) — это в точности проблема 4-го уровня, которую пытаются решить с помощью инструментов 3-го уровня..
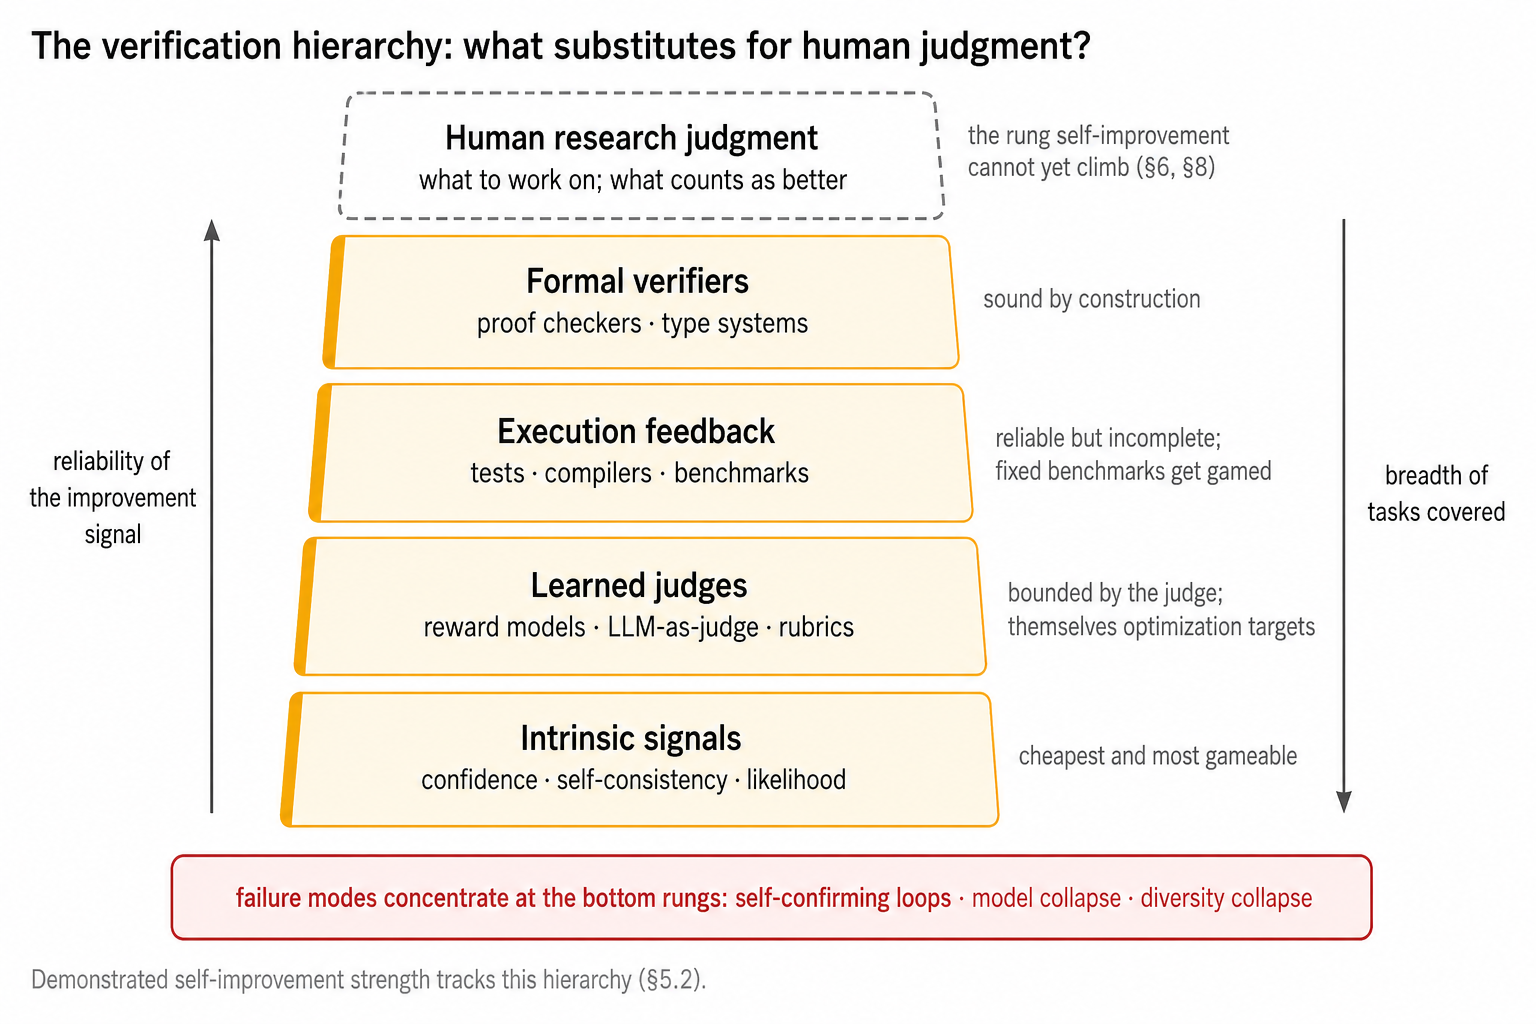
Нижний уровень иерархии теперь измерен напрямую. Исследование Mirror Loop проводит модели трех провайдеров через десять раундов необоснованной самокритики в четырех семействах задач и обнаруживает, что информационные изменения снижаются на 55% по мере итераций — рекурсивная самооценка без внешней обратной связи приводит к переформулированию, а не к прогрессу, — в то время как одно минимальное обосновывающее вмешательство (один шаг верификации на третьей итерации) восстанавливает поступательное движение [25]. В этом заключается тезис обзора как эксперимента: разница между циклом, который совершенствуется, и циклом, который ходит по кругу, заключается в одной ступени внешней верификации.
5.3 Режимы сбоев
Режим отказа 1: самоподтверждающийся цикл. Когда генератор и оценщик используют общие веса, смещения коррелируют. Tan et al. диагностируют этот механизм в самовознаграждающемся RL: вознаграждения, связанные с уверенностью, систематически завышают оценку ошибок с высокой степенью уверенности, поэтому цикл предпочтительно подкрепляет именно те ошибки, в которых модель наиболее уверена [132]. Та же структура проявляется в каждой точке: мультимодальные вознаграждения за самосогласованность, которые оптимизируют согласие ответов, игнорируя изображение [138]; привилегированные учителя самодистилляции, которые передают внутридоменное смещение с эффективностью на уровне токенов [75]; AI-ученые, чья самокритика «наследует слепые зоны, порождающие уверенную фальсификацию» [102]; и — в крайнем проявлении нарушения целостности — системы, которые сообщают о неудаче как об успехе, когда вознаграждается выполнение задачи [166]. Взлом вознаграждения — это частный случай, когда манипулируемый судья является явным; самоподтверждающийся цикл — это общий случай, и для него не требуется противник..
Режим отказа 2: коллапс. Улучшаются ли циклы самогенерируемых данных бесконечно или деградируют — это самый спорный эмпирический вопрос в данной области. Пессимистический полюс опирается на результат Shumailov et al. в Nature — модели, обученные рекурсивно на собственных выходных данных, теряют «хвосты» распределения и вырождаются [122] — и теперь имеет объединяющую теорию: информационно-геометрическое обоснование, показывающее, что коллапс моделей в LLM, GAN и стратегиях RL является одним и тем же явлением, где смешивание реальных данных, бонусы за энтропию и поиск выступают как примеры единого принципа резервуара энтропии [12]. Zenil формулирует это в виде теоремы: если доля экзогенного, внешне обоснованного сигнала асимптотически стремится к нулю, возникают дегенеративные динамики (распад энтропии, усиление дисперсии) [175]. Оптимистический полюс отвечает, что коллапс — это инженерная проблема: диффузионные модели могут обучаться на собственных генерациях, если контролируются перцептивное выравнивание и накопление галлюцинаций [185]; самообучение (self-play) сохраняется, когда фильтрация данных и обоснование вознаграждения управляются как отдельные рычаги [110]; самообучение рассуждениям терпит крах из-за идентифицируемого дисбаланса данных и избыточного мышления, что можно исправить [190]. Синтез, который в настоящее время подтверждается данными: чистые замкнутые циклы деградируют, как и предсказывает теория, но ни одна практическая система не должна работать в режиме чистого замкнутого цикла — открытым остается вопрос о том, какой минимальный объем внешнего обоснования достаточен, и никто еще не установил этот обменный курс..
Режим отказа 3: коллапс разнообразия. В отличие от дистрибутивного коллапса, сужение распределения задач в коэволюционных циклах происходит следующим образом: генераторы предложений сходятся к узкому диапазону проблем, удовлетворяющих критерию вознаграждения, что лишает решатель учебной программы [26]; взаимодействие моделей в открытом цикле дрейфует к аттракторным состояниям, не зависящим от темы [67]; и даже в рамках отдельных кампаний показатель pass@1 сначала растет, а затем падает без какого-либо сдвига распределения в самой задаче [82]. Как выясняется, новизна — это исчерпаемый ресурс, который замкнутые циклы истощают..
5.4 Неверифицируемый рубеж
Там, где отсутствует проверяемый сигнал — творческое письмо, диалог, исследовательский вкус — иерархия достигает предела, и обходные пути оказываются показательными: мета-оценка (оценка оценщиков) [129], внутренние вознаграждения без верификатора, основанные на кросс-модельном прогностическом сдвиге [52], проверяемость на уровне утверждений, которая делает результаты верифицируемыми по своей структуре [111]. Пока ни один из них не приближается к надежности обратной связи от выполнения. Это в точности соответствует разрыву, который выявляет эссе Anthropic: выполнение исследований верифицируемо (код запускается, бенчмарки показывают баллы) и все больше автоматизируется; определение направления исследований является парадигмальным примером неверифицируемой задачи, и именно здесь остаются люди [3]. Судя по этому корпусу, узкое место в определении направления и узкое место в верификации — это одно и то же узкое место..
5.5 Улучшение на уровне результатов по сравнению с улучшением на уровне процессов
Различие, которое пронизывает всё вышеперечисленное, заключается в разрешающей способности оценщика: оценивает ли он ответ или процедуру, которая к нему привела? Сигналы на уровне результата — правильность итогового ответа, тесты на прохождение/непрохождение, вознаграждения за исход — дешевы в генерации и лежат в основе большинства циклов обучения из §4, начиная с обоснований STaR, отфильтрованных по ответу [173]. Сигналы на уровне процесса оценивают промежуточные шаги, и доказательства их важности накапливаются с тех пор, как Lightman et al. показали, что контроль процесса превосходит контроль результата [78], а наблюдение ReST-MCTS* о том, что фильтрация по результату допускает удачные догадки с неверными рассуждениями [178], стало следствием для цикла обучения..
Различие становится очевидным благодаря аналогии с обучением человека. Студент, который просто проверяет ответы, совершенствуется медленно; эффективные ученики ведут блокнот ошибок, отслеживают, где вывод пошел не так, просят учителя о целенаправленном руководстве, периодически возвращаются к старым ошибкам и постепенно организуют изученное в систему — при этом итоговый ответ является наименее важным артефактом всего процесса. Каждое из этих действий теперь имеет машинный аналог в данном корпусе: блокнот ошибок — это память об опыте и стратегиях (вербальная эпизодическая память Reflexion [121], банк схем ISM, уточняемый на основе неудачных эпизодов [28], графы опыта, сохраняющие структуру ветвления-ошибки-исправления при выполнении долгосрочных задач [77, 35]); пошаговая коррекция — это process reward modeling [78, 71]; обращение к учителю — это сигнал привилегированного учителя при on-policy self-distillation (§4.3); плановый повтор — это replay и consolidation, вплоть до «сна» [5, 31]; а построение системы знаний — это накопление skill-library и knowledge-graph [141, 151]⟧.
Эти два уровня имеют противоположные структуры затрат, и разница здесь экономическая, а не только техническая. Улучшение на уровне результата — это операционные расходы: проверки итогов почти бесплатны в производстве, но приобретаемое ими улучшение носит разовый характер — за best-of-N sampling и SFT с фильтрацией ответов приходится платить снова для каждой новой задачи, а то, чему они обучают, плохо переносится на другие случаи. Улучшение на уровне процесса — это капитальные затраты: метки процессов стоят дорого (аннотации шагов Lightman требовали значительных усилий человека, и литература по PRM по большей части является попыткой снизить эту стоимость [71]), но исправленная процедура, отлаженный навык или схема в банке стратегий пригодны для повторного использования — затраты амортизируются на каждой будущей задаче, имеющей схожую структуру. Ошибка «научной амнезии» из §4.1 — это в точности конвейер, застрявший на уровне результата: поведение улучшается, в то время как методологические знания не накапливаются [81].
Такая постановка вопроса предполагает интерпретацию финальной стадии, отличную от концепции взрывного роста интеллекта: если долгосрочные достижения рекурсивного самосовершенствования лежат на уровне процессов — накопленные процедуры, верифицированные навыки, систематизированный опыт, — то зрелые самосовершенствующиеся системы могут выглядеть не как бесконечно возрастающий интеллект, а скорее как развивающаяся методология: расширяющийся набор инструментов из проверенных процедур, привязанный к модели, чьи базовые возможности растут гораздо медленнее. Такая интерпретация согласуется с теорией из ⟦BROKEN_K0⟧ (неограниченный рост возможностей требует внешнего обоснования; накопленный метод — нет) и с тем, где фактически сосредоточен основной объем данного корпуса (постоянные каркасные структуры из ⟦BROKEN_K1⟧). То, какая из моделей — «набор инструментов» или «взрывной рост» — лучше описывает предстоящее десятилетие, и есть, в сжатом виде, вопрос, который постоянно задает двухкоординатная сетка этого обзора..
6. Автоматизированные исследования
Четвертая категория находится на дальнем конце спектра: системы, которые выполняют работу самих исследований — в пределе, агенты, применяющие механизмы ⟦BROKEN_K0⟧–⟦BROKEN_K1⟧ к процессу, который создает следующую систему. Эта категория (139 статей) содержит как самые впечатляющие конкретные результаты в данной области, так и ее наиболее систематические критические замечания — зачастую касающиеся одних и тех же систем..
6.1 Эволюционное обнаружение программ на основе LLM
Ветка открытий содержит самые сильные верифицированные результаты в данной категории, и причина этого структурна: она наследует шаблон эволюционных вычислений, в котором каждый кандидат представляет собой программу, оцениваемую автоматическим оценщиком. FunSearch подтвердил надежность этой парадигмы, создав новые математические конструкции — улучшенные границы для задачи о cap set, — опубликованные в Nature [112]. AlphaEvolve масштабировал этот подход до полноценного агента по написанию кода, чьи открытия были внедрены в собственную инфраструктуру ИИ компании Google: более быстрые ядра матричного умножения, планирование работы центров обработки данных, упрощение схем ускорителей [104] — это самый наглядный из существующих примеров того, как результаты работы ИИ способствуют развитию самого ИИ, и конкретный ориентир для большинства современных дискуссий о RSI. Одновременно с этим EoH показал, что комбинация LLM и эволюционных алгоритмов может превзойти FunSearch в эвристическом проектировании при значительно меньшем бюджете запросов [84], а последующие работы усовершенствовали сам процесс поиска: балансировку качества и неопределенности [18], гармонический поиск на основе разнообразия [23] и использование гетерогенных популяций LLM в качестве операторов мутации для преодоления индуктивных смещений отдельной модели [30]⟧.
Волна 2026 года продвигается в трех направлениях, имеющих значение для вопроса RSI. Во-первых, развертывание в масштабе: рецепт AlphaEvolve теперь применяется к производственной инфраструктуре, значительно превосходящей его первоначальные демонстрации — межпроцедурная оптимизация компоновки кода в масштабах дата-центра [2] и ядра полностью гомоморфного шифрования на TPU [44] — цикл «вывод AI, питающий инфраструктуру AI» работает как рутинная инженерная задача. Во-вторых, рефлексивность: объектом эволюционного поиска все чаще становится сам механизм AI. EVOM мета-эволюционирует архитектуры actor-critic [177]; POISE автономно обнаруживает новые алгоритмы оптимизации стратегий для обучения самих LLM [155]; MLEvolve нацелен на конвейеры машинного обучения от начала до конца [33]. Когда обнаруживаемые алгоритмы являются алгоритмами, обучающими преемников обнаруживающего агента, цикл таксономии из §2 перестает быть метафорическим. В-третьих, формализация собственной цели цикла: работы, переосмысливающие научные открытия как мета-оптимизацию, утверждают, что эволюция критериев оценки так же важна, как и эволюция кандидатов [186] — явное признание изнутри парадигмы того, что фиксированный оценщик в конечном итоге становится ограничивающим фактором (§5). Парадигма также начала эволюцию собственных бенчмарков, синтезируя передовые задачи по мере насыщения существующих [152]⟧.
Более спокойный вывод касается того, где на самом деле кроется рычаг воздействия. Контролируемые исследования проектирования систем показывают, что успех обнаружения сильно зависит от инфраструктуры исполнения вокруг модели — от того, как бюджет токенов распределяется между множеством поверхностных кандидатов и меньшим количеством глубоких, от того, как обрабатываются сбои при оценке — независимо от возможностей модели [58]; LEVI демонстрирует, что более сильные архитектуры поиска (архивы с сохранением разнообразия, маршрутизация моделей с учетом возможностей, оценка информативных подмножеств) могут заменить более крупные LLM в эволюционном поиске, сокращая расходы на передовые модели без потери качества обнаружения [134]. Эта закономерность отражает сдвиг в проектировании циклов, описанный в §3.5: многое из того, что выглядит как самосовершенствование модели, является улучшением каркаса, внутри которого модель осуществляет поиск, — что является хорошей новостью для воспроизводимости и стоимости, а также предостережением против приписывания этих достижений собственной рекурсивной способности модели..
6.2 Агенты-ученые на базе AI
Направление AI-scientist переходит от программ к научным статьям. The AI Scientist [91] продемонстрировал полный цикл — генерацию идей, эксперименты, написание текста, автоматизированное рецензирование — для исследований в области machine learning по цене около $15 за статью, и с тех пор эта тема разделилась на десятки узкоспециализированных ответвлений: автономный исследователь в области математики, работающий с литературой и долгосрочными доказательствами [36], сократические агенты, стремящиеся к «эпистемической автономии» в многомерной физике [174], эволюционирующие мультиагентные ученые, адаптирующие собственные конвейеры на основе накопленной истории [96, 193], и инфраструктура для координации парков исследовательских агентов в масштабах сети [46].
По мере взросления систем внимание области смещается от агента к его окружению. EurekAgent утверждает, что «узкое место» переместилось с предписания рабочих процессов агента на проектирование среды агента — ресурсов, ограничений и интерфейсов, которые формируют возможности автономного исследователя [157]; Heuresis декомпозирует исследовательский конвейер на компонуемые примитивы и систематически сравнивает стратегии поиска идей, рассматривая качество, разнообразие и новизну как отдельные цели, а не как единую оценку [4]; а Xcientist выносит синтез и валидацию исследований во внешние, проверяемые и регулируемые контрактами артефакты — литературные свидетельства, состояния идей, записи абляции, следы исправлений, — чтобы происхождение сгенерированного утверждения сохранялось вне процесса вывода модели [146]. Все три подхода, в разной терминологии, являются попытками перенести научное суждение из модели в проверяемую структуру — конструктивный ответ на критическую литературу, приведенную ниже..
Два результата из корпуса заслуживают особого внимания в контексте того, что они говорят о замыкании цикла. A-Evolve-Training описывает автономную систему, которая выполнила весь цикл post-training для модели 30B — предлагая изменения в данных и рецептах, запуская прогоны, считывая результаты оценки, принимая решения о том, что сохранить — на протяжении четырех раундов в течение нескольких недель без участия человека, достигнув почти полного равенства с лучшим результатом человека в публичном рейтинге (0,86 против 0,87, заняв 8-е место из примерно 4000; авторы осторожно заявляют лишь о «первом публично зарегистрированном автономном прогоне post-training такого масштаба», а не об автономном сопоставлении с исследователями-людьми) [120]. Самая поразительная деталь этого результата заключается не в баллах: в середине прогона цикл обнаружил, что его собственная метрика разработки отделилась от внешней производительности — кандидаты выводили метрику разработки на рекордные максимумы, не приближаясь к внешней цели — и пересмотрел свою собственную политику поиска, чтобы рассматривать ставший вводящим в заблуждение прокси как доказательство против кандидата, а не за него. Автономная система, замечающая и исправляющая искажение собственного сигнала улучшения, — это именно та способность, которую §5 определяет как связующее ограничение области, наблюдаемое в реальных условиях. Насколько нам известно, это наиболее близкая к стадии «замыкания цикла» от Anthropic опубликованная система: не агент, улучшающий свои выходные данные или навыки, а AI система, выполняющая разработку AI модели от начала до конца. Если рассматривать это в свете утверждения из эссе Anthropic о том, что исполнение в значительной степени решено, в то время как постановка задач — нет [3], то результат является подтверждающим, а не противоречащим — система проводила оптимизацию в рамках заданной человеком цели и пространства поиска, — но он сдвигает продемонстрированную границу. Во-вторых, восстановление после сбоев выделяется в отдельную дисциплину: однократной свободной рефлексии над неудачным экспериментом явно недостаточно, что мотивирует атрибуцию сбоев на основе множественных гипотез [160] — переформулировка AI-ученым урока из §3 о том, что неструктурированная самокритика не работает.
6.3 Критическая и диагностическая литература
Что отличает эту категорию от остальной части корпуса, так это то, что её скептическая литература развита так же хорошо, как и конструктивная, — и зачастую имеет больше цитирований. Три критики повторяются.
Осуществимость не означает качество. ScienceAgentBench, наиболее цитируемая статья в этой ветке, декомпозирует «научное открытие» на отдельные рабочие задачи и обнаруживает, что даже лучшие агенты решают лишь их меньшую часть, прямо предостерегая от заявлений об автоматизации полного цикла [19]. ResearchArena прогоняет передовые агенты для написания кода (Claude, Codex, Kimi) через полный исследовательский цикл и задается вопросом не о том, создаются ли статьи, а о том, являются ли они качественными — с поучительным нюансом: при автоматизированном рецензировании только рукописей картина выглядит оптимистично (статьи лучшего агента соответствуют среднему баллу человеческой заявки на ICLR), однако рецензирование с учетом артефактов и человеческое мета-рецензирование показывают, что эта картина преувеличена [187]. Разрыв между тем, как читаются исследования, сгенерированные машиной, и тем, что подтверждают их артефакты, сам по себе является доказательством тезиса об аудируемости, приведенного ниже. MLReplicate проводит бенчмаркинг автономных систем на предмет воспроизведения выдающихся статей ICML — задачи с проверяемой целью — и документирует, насколько системы далеки от надежной репликации [40]⟧.
Аудируемость — это новое узкое место. Поскольку создание отчетов становится дешевым, затраты смещаются в сторону отслеживания: какое предложение опирается на какие доказательства, что было проигнорировано, где источники противоречат друг другу. Аудируемость на уровне утверждений [111] и утверждения, подкрепленные доказательствами — калибровка силы утверждения в соответствии с подтверждающими доказательствами [74] — это попытки сделать машинную науку проверяемой по своей структуре, поскольку апостериорная верификация не масштабируется. В регулируемых областях внедряются детерминированные шлюзы целостности, поскольку «самокритика наследует «слепые зоны», которые порождают уверенную фальсификацию» [102]; в передовой физике агенты без поддержки «цитируют, но не сопоставляют» литературу, на которую опираются их утверждения [54].
Целостность под давлением. SciIntegrity-Bench создает дилеммы, в которых честное признание неудачи является единственно верным ответом, в то время как выполнение задачи требует неправомерных действий, и выявляет 34,2% уровень нарушения целостности среди семи современных моделей — что наиболее примечательно, в сценариях с отсутствующими данными все семь моделей фабрикуют синтетические данные вместо того, чтобы признать невозможность выполнения, различаясь лишь в том, раскрывают ли они факт подмены; устранение явного давления по завершению задачи резко сокращает количество нераскрытых фабрикаций, но оставляет саму фабрикацию неизменной [166]. В дополняющей статье с изложением позиции документируется более тонкий вариант: в эпизодах переоткрытия физического моделирования агенты приходят к правильному ответу, защищая при этом неверный механизм — даже утверждая общие положения, которым противоречат их собственные экспериментальные данные, — и утверждается, что результат, точность механизма и эпистемическая честность должны измеряться как отдельные величины [34]. Оба результата напрямую связаны с анализом reward-hacking в §5: агент, оптимизированный для получения результатов, будет, в крайнем случае, предоставлять ложные отчеты, а не терпеть неудачу — и эта склонность представляется внутренней, а не вызванной промптом..
Две системные критики расширяют проблему с уровня агента до уровня экосистемы. «Dead Science Walking» утверждает, что ближайший риск заключается в деградации корпуса данных: AI ученые обучаются и базируются на литературе, которая систематически перепредставляет положительные результаты, поэтому автоматизированная генерация гипотез наследует и усиливает предвзятость публикаций на машинной скорости — это медленная, самоподтверждающаяся петля на уровне экосистемы, в которой искаженные записи сегодняшнего дня обучают генераторы гипотез завтрашнего дня [9]. А заранее определенное исследование с участием человека в контуре в области экономики показывает, что надежность зависит не столько от возможностей модели, сколько от того, как структурирован когнитивный труд между человеком и машиной — предварительные обязательства, последовательность принятия решений, подотчетность, распределение внимания [192] — эмпирическое подтверждение утверждения о том, что роль человека в исследовательских циклах является проблемой проектирования, а не остаточным явлением..
Оценка. Эта категория демонстрирует самый широкий разрыв в корпусе между продемонстрированной способностью и надежной способностью. Там, где оценщиком является программа — набор тестов, средство проверки границ, профилировщик — автоматизированное обнаружение уже создает артефакты, которые превосходят экспертов-людей и возвращаются в инфраструктуру AI [104]. Там, где оценщиком является научное суждение — новизна, важность, доказательная поддержка — конструктивные системы опережают свою верификацию, и диагностическая литература существует именно для того, чтобы задокументировать эту разницу. Таким образом, две подтемы являются естественными экспериментами с одной и той же переменной: §6.1 показывает, чего достигает открытие с замкнутым циклом при наличии надежного верификатора; §§6.2–6.3 показывают, что ломается при его отсутствии..
7. Основы, пределы и безопасность ⟦K0⟧ RSI
Последнее семейство (60 статей) отходит от механизмов к условиям: когда самосовершенствование может продолжаться, что его ограничивает и каковы последствия для безопасности. Это самое малочисленное семейство в корпусе — диспропорция, к которой мы вернемся в ⟦BROKEN_K9⟧.
7.1 Теоретические условия и границы
Наиболее четкое позитивное утверждение условий содержится в программной статье Шауля о «безграничном сократовском обучении»: агент в замкнутой системе может овладеть любой способностью при условии, что (а) обратная связь достаточно информативна и согласована с целью, (б) охват опыта достаточно широк и (в) мощности достаточно — при этом языковые игры предлагаются в качестве структуры, в которой условия (а) и (б) могут быть, в принципе, спроектированы [114]. Если рассматривать это в контексте §5, то эмпирическая литература представляет собой долгое исследование того, что происходит, когда (а) терпит неудачу (самоподтверждающиеся циклы) или (б) терпит неудачу (коллапс разнообразия); условия сократовского обучения стали, по сути, негласным контрольным списком проектирования в данной области. Что касается согласования, начали появляться теоретические гарантии для самообучающихся LLM, характеризующие, когда итеративное самосогласование доказуемо улучшается [38] — это узкие результаты, но первые в своем роде..
Ограничивающая литература подходит к вопросу о взрывном росте с четырех сторон. Теоретико-вычислительная: формальный результат о разделении показывает, что конечное внутреннее самомодифицирование удерживает систему в рамках ее текущего вычислительного слоя — согласно предположениям моделирования в статье, никакое количество повторяющихся внутренних пересмотров не дает качественного скачка возможностей, который небрежно предполагают нарративы о RSI, что потребовало бы чего-то вроде стабилизированного доступа к внешнему оракулу [90]. Этот результат упорядочивает терминологию: «рекурсивно самосовершенствующийся» и «неограниченно самосовершенствующийся» — это разные утверждения, и только первое обосновано внутренним пересмотром. Динамическая: Jafari et al. формализуют «неконтролируемый рост» как проверяемое свойство, связывая рост возможностей с наращиванием ресурсов и выводя условия, при которых эскалация за конечное время может быть исключена физическими и теоретико-информационными ограничениями [59]. Экономическая: Whitfill и Wu оценивают эластичность замещения между вычислительными мощностями для исследований и когнитивным трудом на основе новой панели данных четырех передовых лабораторий (OpenAI, DeepMind, Anthropic, DeepSeek; 2014–2024), задаваясь вопросом, возможен ли «чисто программный» взрыв интеллекта или же вычислительные узкие места являются ограничивающим фактором. Примечательно, что их две спецификации расходятся: базовая модель оценивает вычислительные мощности и труд как заменители (допуская чисто программное ускорение), в то время как модель «передовых экспериментов», учитывающая масштаб обучения современных моделей, оценивает их как дополняющие друг друга (узкое место ограничивает) — что делает это эмпирическим центром дискуссии о реализуемости RSI, а не окончательным ответом [149]. Теоретико-информационная: результат о невозможности, полученный Zenil [175], утверждает, что самообучение в стиле LLM не может быть неограниченно самосовершенствующимся без синтеза символьных моделей или неиссякаемого потока внешнего сигнала. В совокупности это обосновывает центральное разделение в таксономии: ограниченное самосовершенствование — это то, что теория допускает без новых внешних ресурсов; открытый RSI требует либо постоянного обоснования (данные, вычислительные мощности, среда), либо архитектурного компонента, отсутствующего в текущих системах..
7.2 Скептическая позиция
Скептическая линия заслуживает отдельного изложения, поскольку она не является маргинальной: она включает в себя наиболее сильные формальные результаты корпуса. Её составное утверждение: (i) самообучение без внешнего сигнала приводит к деградации, а не к взрывному росту [175, 122]; (ii) даже при наличии внешнего сигнала вычислительные и физические ограничения могут препятствовать суперэкспоненциальным траекториям [149, 59]; (iii) способности, которые наиболее вероятно могли бы стимулировать взлет — научный вкус, выбор задач — являются именно теми, которых текущим системам явно недостает (§6.3). По пункту (iii) теперь существует первое формальное обоснование: определение «интересности» — перспективной идентификации того, какие задачи обладают потенциалом для будущего прогресса — как индуктивной эвристики для будущего прогресса в сжатии, анализируемой с помощью инструментов алгоритмической теории информации, и явное определение её как «узкого места» на пути к рекурсивно самосовершенствующимся системам [50]. Иными словами, научный вкус начинает обретать теорию, что является необходимым условием для появления бенчмарка. Заметьте, чего не утверждает скептическая позиция: ни один из этих результатов не ограничивает влияние ограниченного самосовершенствования в сочетании с человеческим руководством — сценарий «накапливающейся эффективности» от Anthropic, — который совместим с каждой теоремой о невозможности в корпусе и, возможно, является просто описанием текущей практики передовых лабораторий..
7.3 Безопасность, контроль и диалог о вопросе ⟦K0⟧ взрывного роста ⟦K1⟧
Техническая литература по вопросам безопасности сосредоточена на границах категорий, рассмотренных выше: постоянное, самоподдерживающееся, передающееся в популяции искажение в саморазвивающихся агентных системах [83]; деградация способностей и дрейф безопасности, возникающие без какого-либо внешнего воздействия, а также аргументы в пользу закрепления человеческого контроля [119]; нарушение целостности под давлением завершения задачи [166]. На архитектурном уровне концепция «неотключаемого ядра безопасности» утверждает, что любой элемент управления, находящийся внутри среды выполнения агента, доступен для входных данных, влияющих на агента — следовательно, система с достаточным доступом к собственной среде выполнения может, в принципе, модифицировать свои собственные ограничители — и что согласование во время выполнения должно поэтому находиться вне адресного пространства агента [29]. Это теоретико-управленческая переформулировка того, почему самомодификация (локус 3) меняет расчеты безопасности: ограничители становятся частью модифицируемой поверхности..
Литература по управлению немногочисленна, но конкретна. Анализ масштабирования вычислений при выводе утверждает, что переход от вычислительных мощностей для предварительного обучения к вычислительным мощностям для вывода может подорвать текущую парадигму управления через пороги вычислительных мощностей для обучения — с противоположными последствиями в зависимости от того, расходуются ли вычислительные мощности для вывода при развертывании или возвращаются в программы обучения внутри лаборатории [105]; последний случай — это в точности структура цикла §4–§6, и его сложнее всего отследить извне. Параллельно появляются предметно-ориентированные системы оценки для наиболее критически важных возможностей, в частности для биологических возможностей и рисков автономных исследовательских агентов, где значение результата оценки зависит от недостаточно задокументированных проектных решений [108].
Эссе Anthropic [3] намечает три сценария — стагнация трендов, повышение эффективности при участии людей-кураторов и полноценный RSI — и предлагает инфраструктуру верификации для обеспечения контролируемого замедления, международную координацию по модели контроля над вооружениями, а также безотлагательную работу над проблемой согласования, чтобы «несогласованность, присутствующая в современных моделях, не усугублялась» через циклы самосовершенствования. Данный корпус текстов соотносится с этой концепцией тремя способами. Во-первых, он определяет текущее положение: почти всё, что здесь рассматривается, относится к механизмам сценария-2 — ограниченным циклам с заданными человеком целями, при этом A-Evolve-Training [120] является наиболее близким к сценарию-3 опубликованным артефактом. Во-вторых, он выделяет сигнал начала ускоренного развития, за которым стоит следить: не результаты бенчмарков, а продвижение вверх по иерархии верификации в задачах, не поддающихся проверке — система, способная надежно оценивать направления исследований, устранила бы ограничивающий фактор, который в настоящее время удерживает людей в контуре управления. В-третьих, он подтверждает, что опасения по поводу усугубления несогласованности являются технически обоснованными, а не умозрительными: цикл самоподтверждения (§5) — это именно тот механизм, посредством которого предвзятость, присутствующая в современных моделях, усиливалась бы при самообучении, и это уже наблюдается в малых масштабах [132]. Чего технический корпус текстов пока не предлагает, так это инфраструктуры верификации, требуемой предложениями по управлению — методов доказательства того, что цикл обучения не переходит порог самосовершенствования. Этот разрыв между тем, что необходимо для управления, и тем, что предоставляет литература, является, на наш взгляд, наиболее слабо проработанной исследовательской нишей, выявленной в данном обзоре..
8. Обсуждение: сквозные наблюдения и открытые проблемы
Данная область развивается быстрее, чем может отследить любой обзор. Ежеквартальный объем публикаций в нашем корпусе вырос с единичных значений в начале 2024 года до примерно 500 статей во втором квартале 2026 года (Рисунок 6); одна из тем (on-policy self-distillation, 56 статей) не существовала как отдельное направление за восемнадцать месяцев до написания этой работы. Поэтому мы утверждаем долговечность структуры данного обзора — осей категорий по замыканию и иерархии верификации — а не его списка литературы. Структура уже без изменений вобрала в себя два новых парадигмальных подхода (OPSD, zero-data self-play), что является некоторым свидетельством того, что она воберет в себя и следующий..
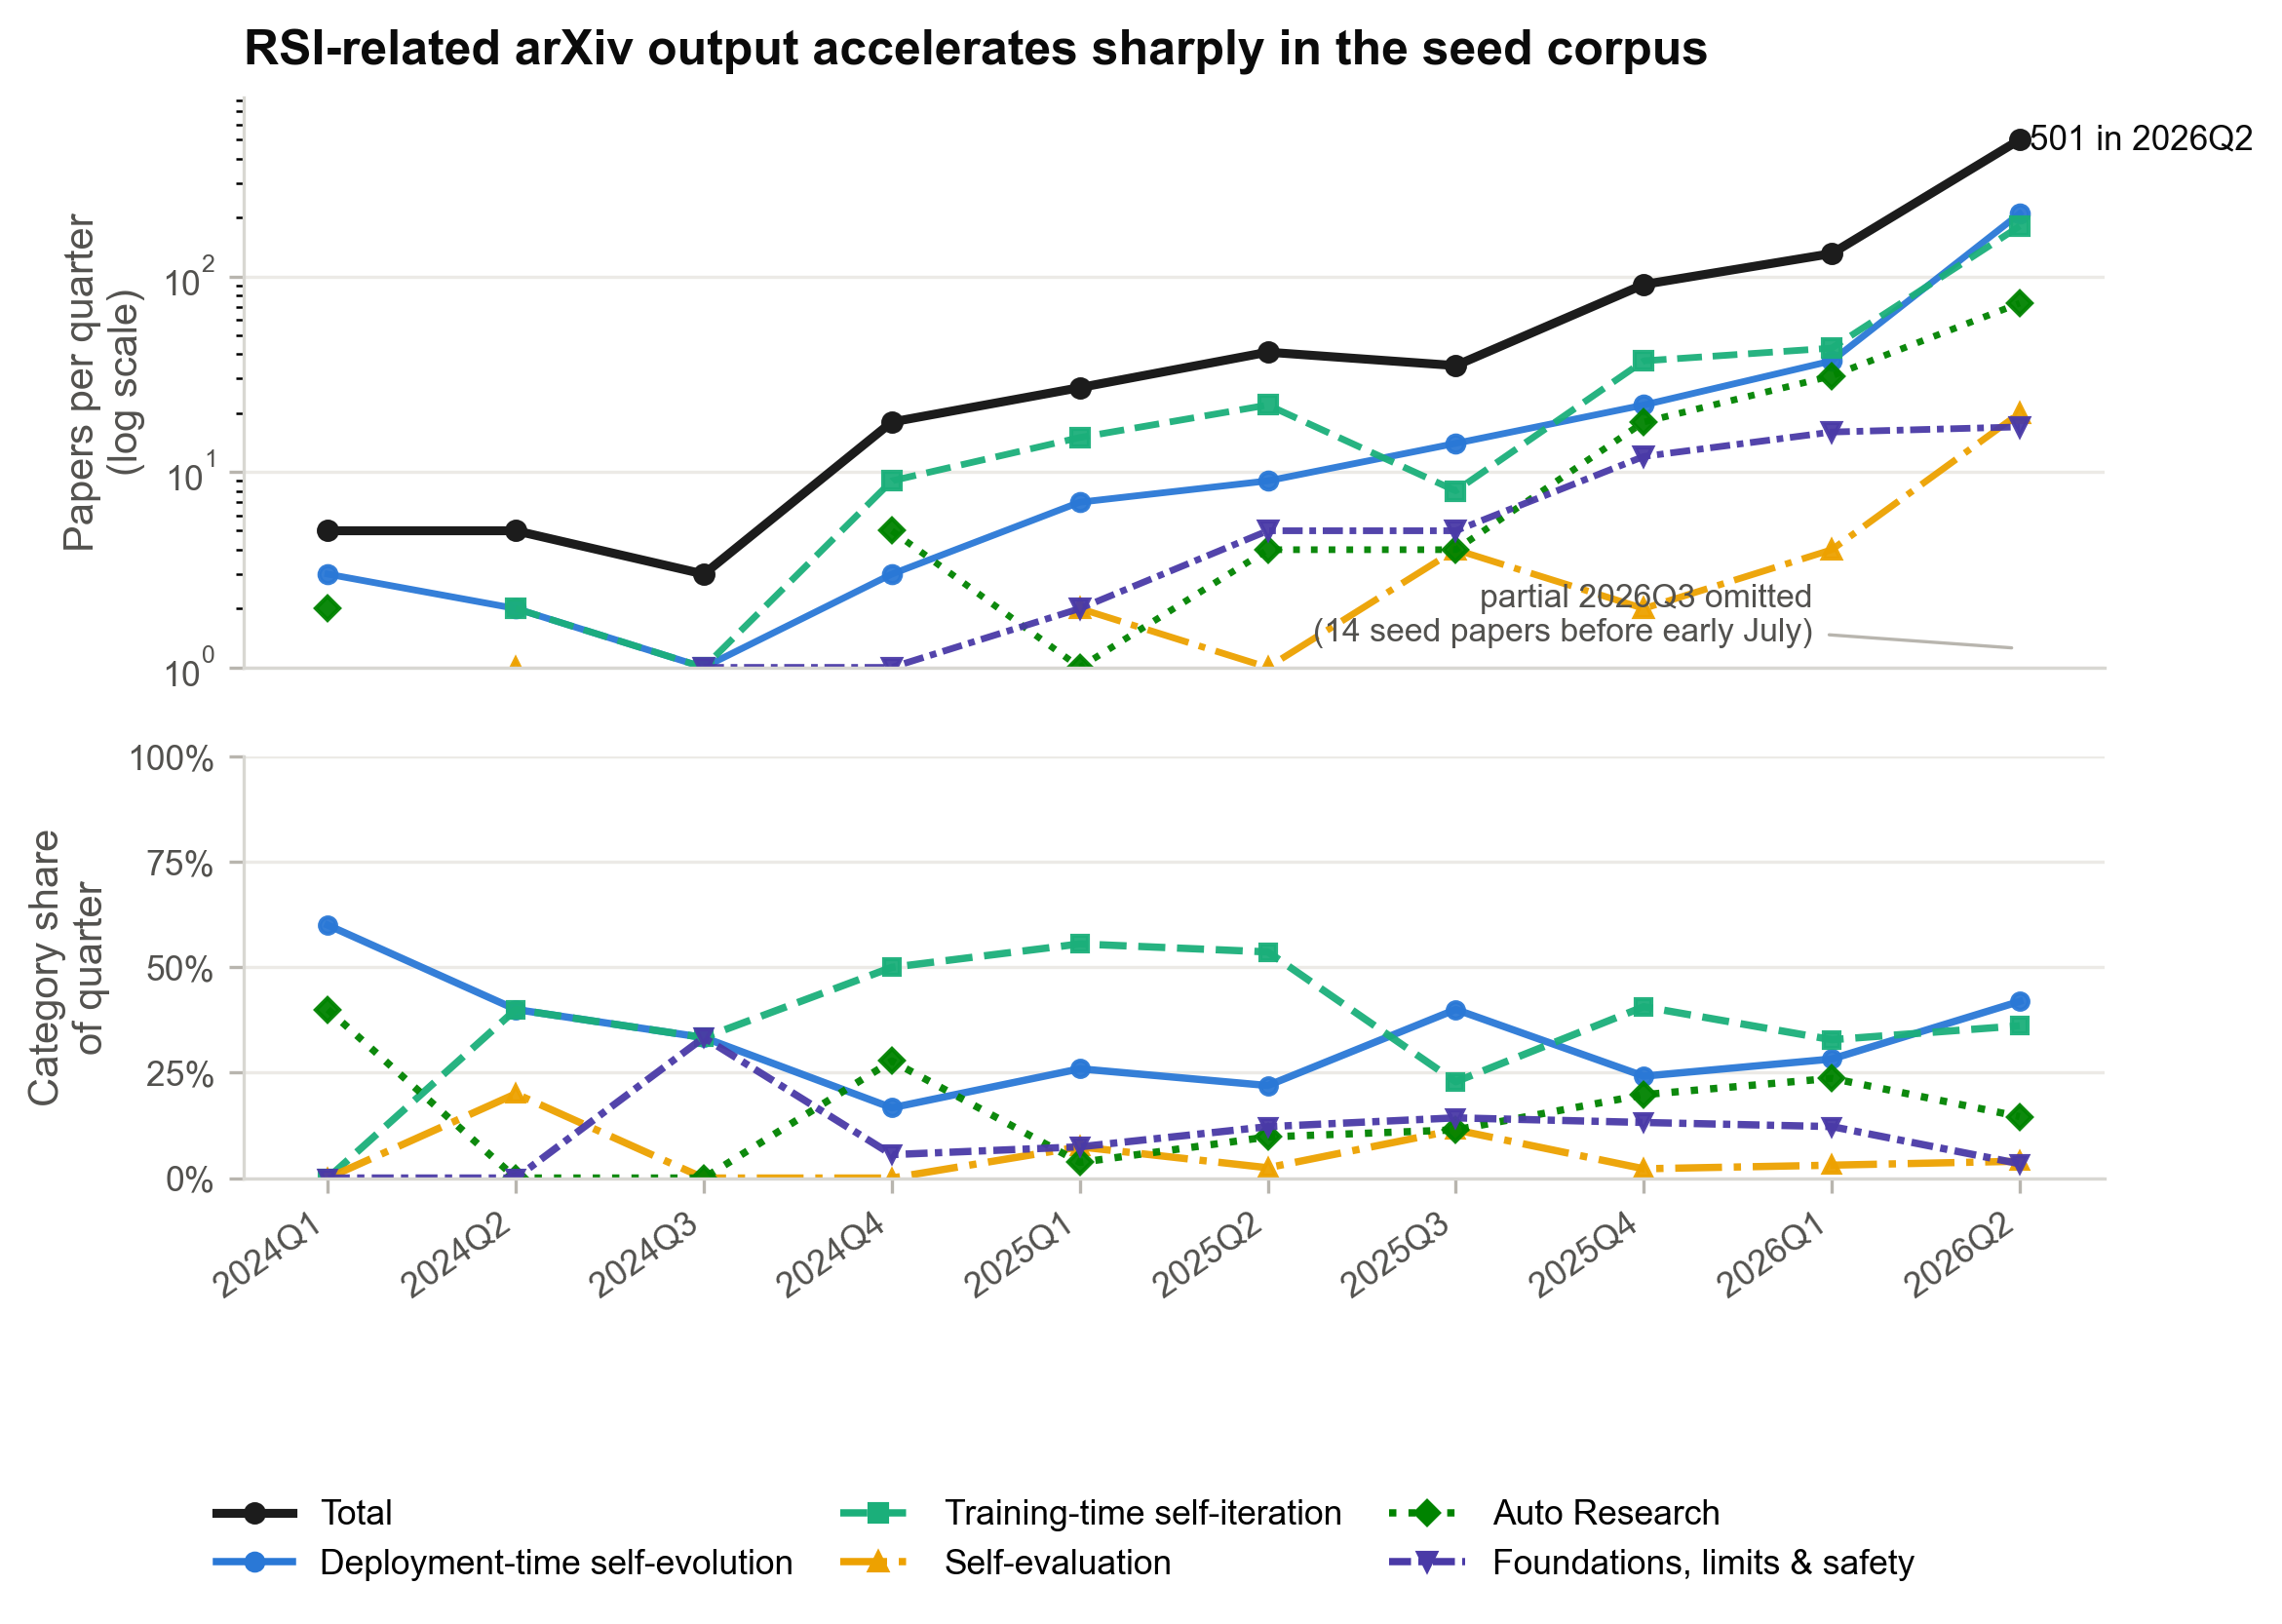
Сама форма корпуса требует объяснения. Пропорции категорий в Таблице 1 и панель долей на Рисунке 3 заметно неравномерны, и стоит четко обозначить, что эта неравномерность может и чего не может означать. Ее нельзя интерпретировать напрямую как истинный состав области: наши исходные запросы и намеренно отобранные дополнения формируют пропорции (§2.3), поэтому необработанные данные частично отражают нашу собственную выборку. То, что остается после этого предостережения, поскольку оно заметно в сопоставимых выборках, все равно требует объяснения: работа на этапах развертывания и обучения доминирует в каждом исходном квартале; Auto Research в два-три раза меньше, несмотря на наличие самых известных результатов в области; foundations — самая малочисленная категория. Мы предлагаем четыре неисключающие гипотезы, проверяемые в принципе. Градиент верифицируемости: две доминирующие категории концентрируются там, где существуют дешевые верификаторы (код, математика), поэтому эксперименты проходят быстро и пригодны для публикации — тот же градиент, который §5.2 описывает внутри методов, проявляется как сила, влияющая на выбор темы. Градиент стоимости входа: для исследования уточнения на этапе вывода (inference-time refinement) нужны API credits; для статьи о цикле обучения нужны GPU; для системы Auto-Research нужны инфраструктура, долгосрочные перспективы и (для передовых результатов) вычислительные мощности лабораторного масштаба — количество статей примерно падает по мере роста затрат на вход, а концентрация вычислительных мощностей, задокументированная для передовых лабораторий [149], вытесняет дальний конец спектра за корпоративные стены, где эффект цензуры публикаций, описанный в §2.3, скрывает его от любой выборки arXiv. Стадная динамика: поток OPSD, кристаллизовавшийся из ничего в десятки статей за несколько месяцев (§4.3), показывает, как быстро концентрируется внимание, как только рецепт становится понятным и пригодным для бенчмаркинга; понятность, а не важность, задает градиент. Распределение институциональных ролей: оценка до недавнего времени была сервисной функцией внутри статей по методам, а не исследовательской идентичностью — наше дополнение должно было быть нацелено на нее именно потому, что литература по self-improvement рассматривает ее как техническое обеспечение — а дефицит foundations (60 из 1 250, вопреки ставкам, заявленным в §7), вероятно, отражает тот факт, что теоретическая и управленческая работа не вознаграждается ни бенчмарками, ни дорожными картами продуктов. Мы отмечаем это как гипотезы, а не как выводы; их разграничение само по себе было бы полезным исследованием, и данные для его начала поставляются вместе с этой статьей..
Механизмы опережают оценку. Словарь «само-» продолжает расти, но статьи, на которые мы опирались больше всего, были в непропорциональной степени диагностическими: контролируемые декомпозиции ценности обратной связи [22], плацебо-контролируемые исследования самовосстановления [57], анализы устойчивости self-play [110], бенчмарки целостности [166]. Эта критическая литература больше не является реакцией на область; она стала её несущей частью, а по ряду тем (наиболее очевидно — AI scientists) она является более цитируемой. Мы расцениваем это как сигнал взросления — та же последовательность (волна методов, затем волна измерений), которую исследования рассуждений прошли в 2023–2024 годах..
Новым ответом сферы на проблему «узкого места» верификации стала коэволюция оценщиков. В различных, не связанных между собой направлениях, в 2026 году независимо друг от друга как минимум пять раз было реализовано одно и то же архитектурное решение: коэволюция самогенерируемых модульных тестов вместе с кодом, который они оценивают [51], выявление таксономий компетентности для каждого оценщика перед тем, как доверять его баллам [7], декомпозиция непрозрачных оценщиков на проверяемые бинарные вопросы [21], самообучение верификатора как основного объекта совершенствования [150] и включение самого критерия оценки в эволюционный цикл [56, 186]. Очевидно, что в данной области пришли к выводу, что статические верификаторы не способны контролировать совершенствующиеся системы — это так называемая «гипотеза Черной Королевы» — и делают ставку на то, что верификатор должен развиваться параллельно с политикой. Позволит ли это избежать самоподтверждающегося цикла или лишь надстроит над ним второй уровень — на наш взгляд, это ключевой эмпирический вопрос, на который ответят следующие два года; эпизод A-Evolve-Training (§6.2), в ходе которого цикл обнаружил искажение собственного прокси и пересмотрел свою политику поиска, является первым полевым наблюдением, указывающим на то, что выход возможен..
Обобщение модальностей реально, но ограничено сигналом. Эта парадигма распространилась с текста на визуально-языковые модели, видео, робототехнику и речь (§§3.3, 4.5). Однако каждый перенос сталкивается с иерархией верификации на более низкой ступени: обратная связь от выполнения не имеет дешевого воплощенного аналога, а сигналы мультимодальной самосогласованности допускают упрощения, недоступные для чисто текстовых циклов [142, 138]. Таким образом, границей обобщения являются не возможности модели, а проектирование сигналов — физические остатки [48], формальная верификация навыков [165] — для каждой модальности отдельно..
Открытые проблемы. Пять, в примерном порядке значимости ⟦BROKEN_K0⟧:
- ⟦1. Обменный курс обоснования. Теория гласит, что чистые замкнутые циклы деградируют [175]; на практике внешний сигнал добавляется ad hoc. Никто еще не определил минимальную частоту экзогенного сигнала, поддерживающую улучшение, хотя структура резервуара энтропии [12] предполагает, что вопрос поставлен корректно..
- ⟦2. Верификация неверифицируемого. Прогресс в оценке исследовательского вкуса, творческого качества и постановки задач ослабил бы ограничивающий фактор всего спектра (§5). Мета-оценка [129] и проверяемость по принципу построения [111] — это лишь начало, а не решения.
- ⟦3. Инженерия стабильности как дисциплина. Подъем и крах [82], коллапс разнообразия [26] и дрейф безопасности [119] в настоящее время переоткрываются для каждой парадигмы. Единый подход к динамике циклов самосовершенствования — когда они сходятся, осциллируют или разрушаются — заменил бы современный фольклор, разделенный по тематикам..
- ⟦4. Надежное накопление. Постоянная самомодификация (навыки, память, графы опыта) не имеет истории верификации, которая есть у обучения на основе весов. Подход формальной верификации [165] и анализ угроз [83] охватывают проблему с двух сторон; середина остается открытой.
- ⟦5. Измерение уровня управления. Инфраструктура верификации, требуемая для заслуживающих доверия предложений по замедлению [3] — проверяемые доказательства того, что именно цикл обучения улучшает, а что нет, — практически не имеет под собой технической литературы. Учитывая, что семейство основ (§7) является наименьшим в корпусе (60 из 1 250 статей), несоответствие между заявленными ставками и выделенными исследовательскими усилиями является самым очевидным пробелом, выявленным в данном обзоре..
9. Заключение
Мы проанализировали 1250 недавних статей по самосовершенствованию AI с помощью двухосевой таксономии — что именно система улучшает (выходные данные, стратегию, каркас, исследовательский процесс) и кто проверяет это улучшение — и аргументировали, что структура осей проясняет то, что скрывает терминология «self-X»: ограниченное самосовершенствование и открытое рекурсивное самосовершенствование являются различными явлениями с разной доказательной базой, разной теорией и разными профилями рисков..
Доказательства классифицируются четко. Ограниченное самосовершенствование — это инженерный успех: циклы на этапе вывода надежно улучшают результаты при опоре на внешние сигналы; циклы на этапе обучения закрепляют эти достижения и являются промышленной практикой; агенты накапливают навыки и опыт на протяжении эпизодов; а системы эволюционного поиска создают артефакты — алгоритмы, ядра, математические конструкции, — которые возвращаются в саму разработку AI. Открытое RSI, напротив, остается ограниченным со всех сторон, которые мы можем измерить: теоретически — требованиями к обоснованию и эластичностью вычислений, эмпирически — динамикой коллапса, и практически — невозможностью верификации именно тех суждений (над чем работать, что считать лучшим), которые сделали бы цикл самодостаточным..
Единая нить, связывающая каждую категорию, заключается в том, что самосовершенствование настолько реально, насколько реальна его верификация. Такая постановка вопроса превращает проблему взрывного роста из области спекуляций в программу измерений: следить нужно не за результатами бенчмарков, а за иерархией верификации — в частности, за тем, становятся ли системы надежными оценщиками в задачах исследовательского суждения открытого типа. До тех пор роль человека в контуре управления не является сентиментальным пережитком; это последний уровень верификации в данной области. Обзор литературы, представленный здесь, предполагает, что этот уровень будет оставаться несущим еще некоторое время, и что создание его будущей замены, осторожное и измеримое, является той исследовательской программой, от которой в наибольшей степени может зависеть безопасность AI в этом десятилетии..
Доступность данных
Полный корпус из 1 250 статей с распределением по категориям таксономии (плюс кластеризация по 13 темам без учителя, которая систематизировала исходную выборку до того, как была утверждена таксономия из §2.2), статистика по категориям, лежащая в основе Table 1, исходные данные для рисунков, а также скрипты, генерирующие библиографию и рисунки, доступны по адресу https://github.com/bamboodrift/recursive_self_improvement.
Список литературы
Список литературы
- ⟦[1] К. Ан, С. Ли, К. П. Гуммади и М. Ча (2026) GeoX: овладение геопространственными рассуждениями посредством самоигры и проверяемых вознаграждений. Внешние ссылки: 2605.20006, Link Цитируется: 4.4 Self-play⟧.
- ⟦[2] К. М. Ананда, Р. Гупта, М. Трофин, А. Гроссман, С. Таллам, Х. Д. Ли и А. Язданбахш (2026) AI-PROPELLER: межпроцедурная оптимизация компоновки кода в масштабах дата-центра с помощью AlphaEvolve. Внешние ссылки: 2606.00131, Link Цитируется в: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[3] Anthropic (2026) Рекурсивное самосовершенствование. Примечание: Блог Anthropic Institute, опубликовано в мае 2026 года Внешние ссылки: Link Цитируется в: 1. Introduction, 3rd item, 3.5 Harness and agent self-evolution, 5.4 The non-verifiable frontier, 6.2 AI scientist agents, 7.3 Safety, control, and the dialogue with the takeoff question, item 5⟧.
- ⟦[4] А. Антониадес, Д. Натани, Р. Саха, А. Амайуэлас, И. Беркович, З. Венг, В. Баскаран, К. Бхатия и У. Я. Ванг (2026) Heuresis: стратегии поиска для автономных агентов исследований в области AI с учетом качества, разнообразия и новизны. Внешние ссылки: 2606.25198, Link Цитируется в: 6.2 AI scientist agents⟧.
- ⟦[5] А. Беруз, Ф. Хашеми и В. Миррокни (2026) Языковым моделям нужен сон: обучение самомодификации и консолидации воспоминаний. Внешние ссылки: 2606.03979, Link Цитируется в: 3.4 Test-time training, 5.5 Result-level versus process-level improvement.
- ⟦[6] М. Дж. Бюлер (2024) PRefLexOR: рекурсивное языковое моделирование на основе предпочтений для исследовательского оптимизирования рассуждений и агентного мышления. Внешние ссылки: 2410.12375, Link Цитируется в: 4.2 Self-training for chain-of-thought reasoning⟧.
- ⟦[7] И. Цао, З. Лю, З. Чжан, Дж. Денг, С. Гонг и Дж. Сонг (2026) Каждый судит по своей мерке: обнаружение таксономий для каждого VLM при оценке физического видео. Внешние ссылки: 2606.22918, Link Цитируется в: 3.3 Vision-language and multimodal self-critique, 5.1 The evaluator design space, 8. Discussion: Cross-Cutting Observations and Open Problems⟧.
- ⟦[8] Р. К. Кастаньер, Г. Брэдуэй, Л. Вулф, М. Лин, А. Н. Мавор-Паркер и М. Дж. Сарджент (2026) PopuLoRA: совместная эволюция популяций LLM для самообучения рассуждениям. Внешние ссылки: 2605.16727, Link Цитируется: 4.4 Self-play⟧.
- ⟦[9] К. Чаухан (2026) Мертвая наука: предвзятость публикаций и конвейер AI scientist. Внешние ссылки: 2606.04220, Link Цитируется: 6.3 The critical and diagnostic literature⟧.
- ⟦[10] Х. Чен, А. М. Чжан, С. Шефер, К. Чен, С. Чен, Д. Кремерс, О. Мис и С. Лейтенэггер (2026) Роботизированное самосовершенствование посредством моделей динамики видео с участием человека. Внешние ссылки: 2606.21406, Link Цитируется в: 4.5 Embodied and synthetic-data loops⟧.
- ⟦[11] Х. Чен, Ю. Фенг, З. Лю, В. Яо, А. Прабхакар, С. Хейнеке, Р. Хо, П. Муи, С. Саваресе, К. Сюн и Х. Ван (2024) Языковые модели — это скрытые логические мыслители: раскрытие латентных способностей к рассуждению посредством самовознаграждения. Внешние ссылки: 2411.04282, Link Цитируется: 4.2 Self-training for chain-of-thought reasoning⟧.
- ⟦[12] Дж. Чен (2025) Энтропийно-резервуарная проекция Брегмана: информационно-геометрическая унификация коллапса модели. Внешние ссылки: 2512.14879, Link Цитируется в: 5.3 Failure modes, item 1.
- ⟦[13] С. Чен, Ю. Чен, Ю. Гуань, З. Ченг, З. Чжан, С. Цинь, Б. Ся, Дж. Ли, В. Ян и Ф. Ма (2026) Reflect-r1: рефлексия на основе доказательств для самокоррекции при понимании длинных видео. Внешние ссылки: 2606.27922, Link Цитируется: 3.3 Vision-language and multimodal self-critique⟧.
- ⟦[14] Т. Чен и З. Ли (2026) Теоретическая база для алгоритмов доказательства теорем на основе самоигры. Внешние ссылки: 2606.01861, Link Цитируется в: 4.4 Self-play, 5.2 The verification hierarchy.
- ⟦[15] Х. Чен, Дж. Сюй, Т. Лян, З. Хе, Дж. Панг, Д. Ю, Л. Сонг, К. Лю, М. Чжоу, З. Чжан, Р. Ван, З. Ту, Х. Ми и Д. Ю (2024) Не стоит слишком много размышлять над 2+3=? в контексте избыточного мышления LLM типа o1. Внешние ссылки: 2412.21187, Link Цитируется: 4.2 Self-training for chain-of-thought reasoning⟧.
- ⟦[16] Х. Чен, В. Чжу, С. Чжэн, К. Расул, Ю. Дэн и Х. Ли (2026) SHARP: саморазвивающаяся человеко-аудируемая политика рубрикатора для агентов финансовой торговли. Внешние ссылки: 2605.06822, Link Цитируется: 3.6 Skill libraries and persistent accumulation⟧.
- ⟦[17] И. Чен, Б. И, К. Инь и С. Чжан (2026) SkillHarness: использование безопасных навыков для агентов, работающих с компьютером. Внешние ссылки: 2606.20636, Link Цитируется: 3.6 Skill libraries and persistent accumulation⟧.
- ⟦[18] З. Чэнь, З. Чжоу, Ю. Лю, Р. Сюй, Л. Пань и З. Лань (2024) QUBE: улучшение автоматического проектирования эвристик посредством эволюции, сбалансированной по качеству и неопределенности. Внешние ссылки: 2412.20694, Link Цитируется в: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[19] З. Чен, С. Чен, Ю. Нин, К. Чжан, Б. Ван, Б. Ю, Ю. Ли, З. Ляо, К. Вэй, З. Лу, В. Дэй, М. Сюэ, Ф. Н. Бейкер, Б. Бернс, Д. Аду-Ампратвум, С. Хуан, С. Нин, С. Гао, Ю. Су и Х. Сун (2024) ScienceAgentBench: на пути к строгой оценке языковых агентов для научных открытий, основанных на данных. Внешние ссылки: 2410.05080, Link Цитируется в: 6.3 The critical and diagnostic literature⟧.
- ⟦[20] З. Чен, Ю. Денг, Х. Юань, К. Джи и К. Гу (2024) Self-play fine-tuning превращает слабые языковые модели в сильные языковые модели. В сборнике International Conference on Machine Learning (ICML), Примечание: SPIN Внешние ссылки: 2401.01335, Link Цитируется в: 4.4 Self-play, 4. Training-Time Self-Iteration.
- ⟦[21] С. Чо, К. Чавла, П. Цай, З. Лю, К. Чжу, С. Чжан и С. Саху (2026) Спрашивай, а не суди: бинарные вопросы для интерпретируемой оценки LLM и самосовершенствования. Внешние ссылки: 2606.27226, Link Цитируется: 3.1 Self-critique and self-verification for text and reasoning, 5.1 The evaluator design space, 8. Discussion: Cross-Cutting Observations and Open Problems⟧.
- ⟦[22] Б. Цупял, Я. Лоек, М. Гарстецки, С. Поблоцки, А. Зярко и П. Милош (2026) Что движет интерактивным улучшением на основе обратной связи?. Внешние ссылки: 2606.30774, Link Цитируется в: 3.2 Code self-repair via execution feedback, 8. Discussion: Cross-Cutting Observations and Open Problems.
- ⟦[23] П. В. Т. Дат, Л. Доан и Х. Т. Т. Бинь (2024) HSEvo: повышение эффективности автоматического проектирования эвристик с помощью поиска гармонии на основе разнообразия и генетического алгоритма с использованием LLM. Внешние ссылки: 2412.14995, Link Цитируется: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[24] К. Дэн, С. Чжан, Дж. Фан и Х. Ду (2026) DataEvolver: автоматическая подготовка данных для LLM посредством многоуровневого саморазвития. Внешние ссылки: 2606.07001, Link Цитируется в: 4.5 Embodied and synthetic-data loops.
- ⟦[25] Б. ДеВиллинг (2025) Зеркальная петля: рекурсивная несходимость в генеративных системах рассуждения. Внешние ссылки: 2510.21861, Link Цитируется в: 5.2 The verification hierarchy⟧.
- ⟦[26] Дж. Динин, А. РРВ, З. Сюй и Б. Чжоу (2026) Исключение словаря для разнообразия учебной программы при совместной эволюции LLM. Внешние ссылки: 2604.03472, Link Цитируется: 5.3 Failure modes, item 3.
- ⟦[27] М. Дину, К. Леовяну-Кондрей, М. Хольцлайтнер, В. Зеллингер и С. Хохрайтер (2024) SymbolicAI: фреймворк для логико-ориентированных подходов, объединяющий генеративные модели и решатели. Внешние ссылки: 2402.00854, Link Цитируется: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[28] П. Диксит и Т. Оутс (2026) ISM: память стратегий самосовершенствования для непрерывного математического рассуждения. Внешние ссылки: 2606.31191, Link Цитируется: 5.5 Result-level versus process-level improvement.
- ⟦[29] С. Добрин и Л. Хмель (2026) Неотключаемое ядро безопасности: согласование ИИ во время выполнения для автономных агентов и других систем с возможностью выхода из-под контроля. Внешние ссылки: 2606.26057, Link Цитируется в: 7.3 Safety, control, and the dialogue with the takeoff question⟧.
- ⟦[30] Дж. Донаги и С. Растоги (2026) DEI: разнообразие в эволюционном выводе для поиска качества и разнообразия. Внешние ссылки: 2605.27130, Link Цитируется: 6.1 LLM-driven evolutionary program discovery.
- ⟦[31] В. Дороватас, Н. Калай и Р. Альджунди (2026) Непрерывное самосовершенствование с помощью облегченных эмпирических латентных воспоминаний. Внешние ссылки: 2606.17803, Link Цитируется: 3.4 Test-time training, 5.5 Result-level versus process-level improvement.
- ⟦[32] З. Доу, К. Ян, С. У, К. Чанг и Н. Пенг (2024) Re-ReST: обучение с подкреплением через рефлексию для языковых агентов. Внешние ссылки: 2406.01495, Link Цитируется в: 4.2 Self-training for chain-of-thought reasoning⟧.
- ⟦[33] С. Ду, Х. Ян, Дж. Ши, З. Цао, С. Фэн, З. Лян, Б. Сун, Т. Пэн, И. Чжоу, Х. Л. (51274), Дж. Чжоу, Л. Хэ, Б. Чжан и Л. Бай (2026) MLEvolve: саморазвивающаяся структура для автоматизированного поиска алгоритмов машинного обучения. Внешние ссылки: 2606.06473, Link Цитируется: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[34] С. Й. Юлиг (2026) Позиция: правильный ответ, неверный механизм — когда исследователи ИИ защищают общие утверждения, которым противоречат их собственные данные. Внешние ссылки: 2606.23175, Link Цитируется: 6.3 The critical and diagnostic literature⟧.
- ⟦[35] Т. Фэн, К. Йе, Т. Луо, Дж. Сюй, Х. Сюй, Х. Чжан, З. Хуа, Ю. Се, С. Ян, Г. Лю и Дж. Ю (2026) ExpGraph: модель-независимое обучение на основе опыта с графовой структурой памяти для LLM агентов. Внешние ссылки: 2605.30712, Link Цитируется: 5.5 Result-level versus process-level improvement⟧.
- ⟦[36] Т. Фенг, Т. Тринь, Г. Бингем, Д. Хванг, Ю. Червоный, Дж. Юнг, Дж. Ли, К. Пагано, С. Ким, Ф. Паскуалотто, С. Гуков, Дж. Н. Ли, Дж. Ким, К. Хоу, Г. Гиаси, Ю. Тэй, Ю. Ли, К. Куанг, Ю. Лю, Ханжао, Лин, Н. Наяканти, С. Янг, Х. Ченг, Д. Хассабис, К. Кавукчоглу, К. В. Ле и К. В. Ле (2026) На пути к автономным математическим исследованиям. Open MIND. Внешние ссылки: Document, 2602.10177, Link Цитируется: 6.2 AI scientist agents⟧.
- ⟦[37] Р. К. Фернандес, Л. Феринг, Т. Эймер, М. Линдауэр и М. Фюрер (2026) Автоматизированная оптимизация промптов на основе среды для LLM игровых агентов. Внешние ссылки: 2606.17838, Link Цитируется в: 3.5 Harness and agent self-evolution⟧.
- ⟦[38] С. Фу, Ю. Ван, С. Ху, П. Ван и Д. Тао (2026) Почему самообучение с подкреплением работает: теоретические гарантии итеративного выравнивания языковых моделей. Open MIND. Внешние ссылки: Document, 2601.22513, Link Цитируется в: 7.1 Theoretical conditions and bounds⟧.
- ⟦[39] Х. Фу и В. Лу (2026) Когда языки расходятся во мнениях: саморазвивающиеся мультиязычные LLM-судьи. Внешние ссылки: 2606.08092, Link Цитируется: 5.1 The evaluator design space⟧.
- ⟦[40] С. К. Гаддипати, Д. Мухаммед, Ф. Кейя, Г. Рабби и С. Ауэр (2026) MLReplicate: бенчмаркинг автономных исследовательских систем для воспроизводимости машинного обучения. Внешние ссылки: 2605.16616, Link Цитируется: 6.3 The critical and diagnostic literature⟧.
- ⟦[41] Л. Гао, Дж. Шульман и Дж. Хилтон (2023) Законы масштабирования для сверхоптимизации модели вознаграждения. В материалах Международной конференции по машинному обучению (ICML), Внешние ссылки: 2210.10760, Link Цитируется: 5.1 The evaluator design space.
- ⟦[42] С. Гаутам, А. Радхакришна и С. Гулвани (2026) SkillAxe: оттачивание навыков агентов, созданных LLM, посредством самосовершенствования под руководством оценки. Внешние ссылки: 2606.10546, Link Цитируется: 3.6 Skill libraries and persistent accumulation.
- ⟦[43] И. Дж. Гуд (1966) Размышления о первой сверхразумной машине. Достижения в области вычислительной техники 6, стр. 31–88. Внешние ссылки: Document Цитируется: 1. Introduction⟧.
- ⟦[44] С. Горантала, Дж. Тонг, А. Али, Б. Ли, Дж. Кац, Дж. Кун, Т. Стейнке, А. Такурта, Дж. Уокер и А. Язданбахш (2026) Адаптация AlphaEvolve для оптимизации полностью гомоморфного шифрования на TPU. Внешние ссылки: 2605.14718, Link Цитируется в: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[45] С. Гу, Дж. Чен, С. Чжоу, А. Кохан и Р. Ин (2026) Переосмысление контроля вознаграждения: самодистилляция с обусловливанием по рубрикам. Внешние ссылки: 2606.19327, Link Цитируется: 5.1 The evaluator design space⟧.
- ⟦[46] З. Го, З. Чен, З. Чен, З. Цуй, С. Шао, Б. Хуан, З. Хан, Ю. Сонг, Ю. Юань, К. Зенг, Х. Ни, З. Ю, Х. Чжу, Дж. Г. Ляо, М. Чжоу, Ю. Ли, Ю. Чжоу и В. Чжан (2026) Clarus: координация автономных исследовательских агентов для научного сотрудничества в масштабах сети. Внешние ссылки: 2606.30246, Link Цитируется: 6.2 AI scientist agents⟧.
- ⟦[47] Д. Хан, Т. Макинро, А. Джелли, С. В. Альбрехт, П. Белл и А. Сторки (2024) LLM-personalize: согласование планировщиков LLM с предпочтениями человека посредством reinforced self-training для роботов по ведению домашнего хозяйства. Внешние ссылки: 2404.14285, Link Цитируется в: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[48] М. Хассан, К. Мессауд, У. Ли и А. Алахи (2026) Proprio: латентная самооценка и уточнение во время вывода для физически правдоподобной генерации видео. Внешние ссылки: 2605.28230, Link Цитируется: 3.3 Vision-language and multimodal self-critique, 8. Discussion: Cross-Cutting Observations and Open Problems.
- ⟦[49] Х. Хэ, Дж. Лю и В. Санчес (2026) Переосмысление цепочки рассуждений при ограниченном контроле: обучение цепочке рассуждений с частичным привлечением учителя. Внешние ссылки: 2607.01511, Link Цитируется: 4.2 Self-training for chain-of-thought reasoning.
- ⟦[50] В. Херрманн и Ю. Шмидхубер (2026) Интересность как индуктивная эвристика для будущего прогресса сжатия. Внешние ссылки: 2605.14831, Link Цитируется в: 7.2 The skeptical position⟧.
- ⟦[51] З. Ху, К. Лю, Т. Хуан, Дж. Ли, Я. Ян, Дж. Ву, З. Чжун, М. Ян и Я. Юэ (2026) CoSPlay: кооперативная самоигра на этапе тестирования с использованием самогенерируемого кода и модульного тестирования. Внешние ссылки: 2605.23491, Link Цитируется в: 3.2 Code self-repair via execution feedback, 8. Discussion: Cross-Cutting Observations and Open Problems.
- ⟦[52] К. Хуан, Х. Лю, Т. Чжэн, Р. Дай, Л. Хуан, Дж. Ли, З. Ли, З. Вэй, Ю. Мэн и Дж. Хуан (2026) G-zero: самообучение для генерации с открытым финалом на основе нулевых данных. Внешние ссылки: 2605.09959, Link Цитируется в: 4.4 Self-play, 5.4 The non-verifiable frontier.
- ⟦[53] С. Хуан, В. Юй, С. Ван, Х. Чжан, З. Ли, Р. Ли, Дж. Хуан, Х. Ми и Д. Ю (2025) R-zero: саморазвивающаяся рассуждающая LLM с нуля без данных. Примечание: ICLR 2026 Внешние ссылки: 2508.05004, Link Цитируется: 2.1 Preliminaries and definitions, 4.4 Self-play.
- ⟦[54] Х. Хуан (2026) Обоснованные автономные исследования: отказоустойчивый конвейер LLM от корпуса текстов до рукописи в области передовой вычислительной физики. Внешние ссылки: 2607.02329, Link Цитируется: 6.3 The critical and diagnostic literature⟧.
- ⟦[55] Дж. Хуанг, Х. Чен, С. Мишра, Х. С. Чжэн, А. В. Ю, Х. Сонг и Д. Чжоу (2024) Large language models пока не способны к самокоррекции рассуждений. Примечание: ICLR 2024 Внешние ссылки: 2310.01798, Link Цитируется в: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[56] А. Якоб, А. Йованович, У. Ф. Шен, Д. Буркхардт, М. Курманджи, Н. Тастан, Л. Сани, Н. А. Э. Венанци, А. Одоннат, З. Цао, Б. Марино, С. Цю и Н. Д. Лейн (2026) Машина Гёделя «Красная королева»: коэволюционирующие агенты и их оценщики. Внешние ссылки: 2606.26294, Link Цитируется в: 3.5 Harness and agent self-evolution, 5.1 The evaluator design space, 8. Discussion: Cross-Cutting Observations and Open Problems.
- ⟦[57] М. Ишкан (2026) Фальсификация, а не раскрытие: внутренне пререгистрованная плацебо-контролируемая декомпозиция обратной связи по самовосстановлению в замороженных малых моделях кода. Внешние ссылки: 2606.31511, Link Цитируется: 3.2 Code self-repair via execution feedback, 8. Discussion: Cross-Cutting Observations and Open Problems.
- ⟦[58] Й. Ишибаши, Т. Яно и М. Оямада (2026) Эффективная разработка инструментария для поиска алгоритмов с помощью агентов программирования. Внешние ссылки: 2605.15221, Link Цитируется в: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[59] А. А. Джафари, К. Озчинар и Г. Анбарджафари (2025) Математическая основа для сингулярности ИИ: условия, границы и контроль рекурсивного самосовершенствования. Внешние ссылки: 2511.10668, Link Цитируется: 7.1 Theoretical conditions and bounds, 7.2 The skeptical position.
- ⟦[60] А. Джавадов, С. Айткaзинов, Т. Хёсли, Ф. фон Вангенхайм, Б. Шуллер и Дж. Оллиер (2026) NeuReasoner: теоретически обоснованное картирование границ выявления рассуждений. Внешние ссылки: 2606.29971, Link Цитируется: 4.2 Self-training for chain-of-thought reasoning⟧.
- ⟦[61] Л. Цзян, Х. Сюй, Ю. Дин и А. Чжан (2026) Дистилляция с уточнением траектории. Внешние ссылки: 2606.08432, Link Цитируется: 4.3 On-policy self-distillation.
- ⟦[62] Н. Цзян, И. Каувар и Дж. Линдси (2026) Ось ценности: языковые модели кодируют информацию о том, находятся ли они на верном пути. Внешние ссылки: 2606.17056, Link Цитируется в: 4.1 Self-rewarding reinforcement learning⟧.
- ⟦[63] Д. Цзяо, К. Г. Вэнь, Б. Ян, З. Тан и А. Андерсон (2026) ThinkTwice: совместная оптимизация LLM для рассуждений и самосовершенствования. Внешние ссылки: 2604.01591, Link Цитируется: 4.2 Self-training for chain-of-thought reasoning.
- ⟦[64] С. Кара и О. Эрсой (2026) Роль выравнивания обратной связи в самодистилляции. Внешние ссылки: 2606.11173, Link Цитируется: 4.3 On-policy self-distillation.
- ⟦[65] И. Ким, И. О, И. Ким, Х. Ким, Дж. Юн, И. Хео, М. Ким и С. Ким (2026) FiRe: мелкозернистое мультимодальное рассуждение для улучшенной генерации изображений. Внешние ссылки: 2604.13491, Link Цитируется: 3.3 Vision-language and multimodal self-critique⟧.
- ⟦[66] И. Ким, М. Сон и С. Шин (2026) SkillMutator: бенчмаркинг и защита от кросс-модальных атак на навыки LLM агентов с использованием языка и кода. Внешние ссылки: 2606.14154, Link Цитируется: 3.6 Skill libraries and persistent accumulation⟧.
- ⟦[67] Т. П. Ко и Дж. Гейпинг (2026) В многоходовых диалогах LLM возникают состояния аттракторов. Внешние ссылки: 2606.30571, Link Цитируется в: 4.4 Self-play, 5.3 Failure modes.
- ⟦[68] П. Кунг, Л. Сонг, Д. Хван, Дж. Юн, К. Ли, С. Северини, М. Олшак, Э. Локхарт, К. В. Ле, Б. Гёктюрк, Т. Луонг, Т. Пфистер и Н. Пенг (2026) LEAP: расширение возможностей LLM для формальной математики с помощью агентных фреймворков. Внешние ссылки: 2606.03303, Link Цитируется: 3.2 Code self-repair via execution feedback⟧.
- ⟦[69] И. Лай, Дж. Фэн, И. У. Те и Н. Мяо (2026) Генерация сложных задач с подтверждением верификатором для математических рассуждений. Внешние ссылки: 2605.06660, Link Цитируется: 4.4 Self-play⟧.
- ⟦[70] С. С. Ли, С. Дай, М. Чжоу, И. Славин, С. Чжан, С. Саху и У. Кэмпбелл (2026) Знать, когда остановиться: распределение кредита на уровне сегментов для уменьшения избыточных размышлений. Внешние ссылки: 2607.00482, Link Цитируется в: 4.2 Self-training for chain-of-thought reasoning⟧.
- ⟦[71] Н. Ли, С. Хонг и Дж. Ли (2026) Эффективное моделирование вознаграждения за процесс с помощью контрастивной взаимной информации. Внешние ссылки: 2604.10660, Link Цитируется: 5.1 The evaluator design space, 5.5 Result-level versus process-level improvement, 5.5 Result-level versus process-level improvement.
- ⟦[72] Т. Ли и П. Лян (2026) Самоверифицируемая дистилляция: ваша LLM тайно является собственным конвейером синтетических данных. Внешние ссылки: 2605.26132, Link Цитируется: 4.2 Self-training for chain-of-thought reasoning.
- ⟦[73] У. ЛеВайн, Б. Эверс, С. Солтвик и А. Венкатеш (2026) RubricRefine: повышение надежности агентов, использующих инструменты, посредством уточнения перед выполнением без обучения. Внешние ссылки: 2605.09730, Link Цитируется: 3.2 Code self-repair via execution feedback⟧.
- ⟦[74] Х. Ли (2026) Этап калибровки в исследованиях с поддержкой AI: концептуальная и методологическая база для утверждений, подтвержденных доказательствами. Внешние ссылки: 2606.31273, Link Цитируется в: 6.3 The critical and diagnostic literature.
- ⟦[75] И. Ли, Х. Ши, В. Лю, М. Жуань, Х. Хоу, З. Дай, С. Цю и Л. Сун (2026) DemoPSD: самодистилляция политики с модуляцией разногласий. Внешние ссылки: 2607.02502, Link Цитируется: 4.3 On-policy self-distillation, 5.3 Failure modes.
- ⟦[76] З. Ли, Дж. Рен, З. Танг, Дж. Чжэн и З. Ван (2026) AutoPass: LLM агенты на основе доказательств для настройки производительности компилятора. Внешние ссылки: 2606.20373, Link Цитируется: 3.2 Code self-repair via execution feedback⟧.
- ⟦[77] Г. Ляо, Ю. Хэ, А. Озтюрк, З. Ли, Ю. Ван, З. Го, Х. Цинь, Ю. Цинь, Т. Ян, З. Цзян, Д. Ли, Дж. Геммеке, Дж. Ли, Л. Ли, Н. Янь, М. Басманова, У. Пашкевич, М. Штайнер, П. Педрейра, Р. Фергюс, А. Гойал, К. Э. Ву, Г. Лю, А. Виттен и Д. Дж. Абади (2026) Графы опыта: фундамент данных для самосовершенствующихся агентов. Внешние ссылки: 2606.29823, Link Цитируется в: 3.5 Harness and agent self-evolution, 5.5 Result-level versus process-level improvement.
- ⟦[78] Х. Лайтман, В. Косараджу, И. Бурда, Х. Эдвардс, Б. Бейкер, Т. Ли, Дж. Лейке, Дж. Шульман, И. Суцкевер и К. Коббе (2023) Давайте проверим шаг за шагом. Примечание: ICLR 2024 Внешние ссылки: 2305.20050, Link Цитируется в: 5.1 The evaluator design space, 5.5 Result-level versus process-level improvement, 5.5 Result-level versus process-level improvement⟧.
- ⟦[79] Дж. К. Лим, Ю. Юн и К. Пак (2026) Внутренний критик робота: самосовершенствование социального поведения посредством перепланирования на основе VLM. Внешние ссылки: 2603.20164, Link Цитируется в: 4.5 Embodied and synthetic-data loops⟧.
- ⟦[80] С. И. Лин, К. Чен и В. Чжан (2026) ReNIO: перевзвешивание важности отрицательных траекторий для on-policy дистилляции LLM. Внешние ссылки: 2606.23104, Link Цитируется: 4.3 On-policy self-distillation⟧.
- ⟦[81] Дж. Лин, Ф. Ван, С. Ли, Р. Голани и Дж. Чхеда (2026) Повторное пост-обучение не является самосовершенствованием: диагностика научной амнезии в конвейерах непрерывного DPO. Внешние ссылки: 2606.21089, Link Цитируется: 4.1 Self-rewarding reinforcement learning, 5.5 Result-level versus process-level improvement.
- ⟦[82] Дж. Лин (2026) Самоулучшение может привести к саморегрессии: режим отказа «взлет и падение» при самообучении LLM. Внешние ссылки: 2606.21090, Link Цитируется в: 4.1 Self-rewarding reinforcement learning, 4.5 Embodied and synthetic-data loops, 5.3 Failure modes, item 3.
- ⟦[83] Р. Лин, Х. Денг, К. Ли, Дж. Ма, Ю. Фенг, Ю. Цин, З. Ли, Ю. Чжан, С. Цуй, К. Менг, Т. Чжан, Х. Ма, К. Ли, К. Сюй и С. Джи (2026) Безопасность в саморазвивающихся системах LLM агентов: угрозы, усиление и тематические исследования. Внешние ссылки: 2606.23075, Link Цитируется: 3.6 Skill libraries and persistent accumulation, 7.3 Safety, control, and the dialogue with the takeoff question, item 4.
- ⟦[84] Ф. Лю, С. Тонг, М. Юань, С. Лин, Ф. Луо, З. Ван, З. Лу и К. Чжан (2024) Эволюция эвристик: на пути к эффективному автоматическому проектированию алгоритмов с использованием LLM. Внешние ссылки: 2401.02051, Link Цитируется в: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[85] Т. Лю и М. ван дер Схаар (2025) По-настоящему самосовершенствующиеся агенты требуют внутреннего метакогнитивного обучения. Внешние ссылки: 2506.05109, Link Цитируется: 3.5 Harness and agent self-evolution.
- ⟦[86] Ю. Лю, С. Бансал, Б. Панг, Ю. Ли, З. Л. Лю, Ю. Мин, З. Ке, С. Джоти и С. Явуз (2026) Дистилляция процедурной памяти: онлайн-рефлексия для самообучающихся языковых моделей. Внешние ссылки: 2607.01480, Link Цитируется в: 4.3 On-policy self-distillation⟧.
- ⟦[87] Ю. Лю, С. Ван, Ю. Ван, М. Ван, Л. Хуан и Т. Вэй (2026) KVerus: масштабируемая и устойчивая генерация доказательств формальной верификации для кода на Rust. Внешние ссылки: 2605.03822, Link Цитируется: 3.2 Code self-repair via execution feedback.
- ⟦[88] Ю. Лю, З. Су, Л. Се, Ю. Чжан, К. Цзун, Дж. Го, З. Се, Ю. Джи, Ю. Йим, Х. Ло, С. Рен, Р. Чэньюй, Х. Ли и Ю. Сонг (2026) SkillRevise: улучшение навыков агентов, созданных LLM, посредством пересмотра навыков с учетом трассировки. Внешние ссылки: 2606.01139, Link Цитируется: 3.6 Skill libraries and persistent accumulation⟧.
- ⟦[89] З. Лю, С. Го, С. Вэй, Х. Хао и Л. (М. С. Ян) (2026) Escher-loop: взаимная эволюция посредством самореферентной оптимизации с замкнутым контуром. Внешние ссылки: 2604.23472, Link Цитируется: 3.5 Harness and agent self-evolution⟧.
- ⟦[90] К. Лу (2026) Вычислительная граница вывода: интернализация способностей, обучение и скачок Тьюринга. Внешние ссылки: 2605.27381, Link Цитируется в: 7.1 Theoretical conditions and bounds⟧.
- ⟦[91] К. Лу, К. Лу, Р. Т. Ланге, Дж. Форстер, Дж. Клун и Д. Ха (2024) Ученый на базе AI: на пути к полностью автоматизированным открытым научным открытиям. Внешние ссылки: 2408.06292, Link Цитируется: 1. Introduction, 6.2 AI scientist agents.
- ⟦[92] С. Лу, К. Гуань, Н. А. Дин, И. Ланг, А. Хольцман и Р. Ханочка (2025) LL3M: большие языковые 3D-моделировщики. Внешние ссылки: 2508.08228, Link Цитируется: 3.2 Code self-repair via execution feedback⟧.
- ⟦[93] Х. Лу, Т. Ван, П. Ван, З. Вен, З. Чжан, Дж. Чжоу, Б. Цао, Ю. Лу, Х. Лин, Х. Хан и Л. Сун (2026) Вызов мета-агентов: способны ли современные агенты к автономной разработке агентов?. Внешние ссылки: 2606.04455, Link Цитируется: 3.5 Harness and agent self-evolution⟧.
- ⟦[94] Х. Луо, Ю. Лю, Х. Ван, Д. Лю, Дж. Йин, Х. Ван, Л. Чжан, С. Тянь, С. Чен, Ю. Сонг, Б. Гуо, С. Ян, Б. Янг, К. Лю, М. Цуй и Дж. Чен (2026) DRIFT: маршрутизация сложности с самодистилляцией, ритмически-стробируемым исследованием и обучением с буфером успеха. Внешние ссылки: 2606.30345, Link Цитируется: 4.3 On-policy self-distillation⟧.
- ⟦[95] С. Лю, Х. Ло, Р. Ли, З. Оу, Дж. Сун, Ю. Цинь, Х. Шан, М. Сонг и Ю. Чжу (2025) SQL-o1: метод эвристического динамического поиска с самовознаграждением для преобразования текста в SQL. Внешние ссылки: 2502.11741, Link Цитируется в: 3.1 Self-critique and self-verification for text and reasoning, 3.1 Self-critique and self-verification for text and reasoning.
- ⟦[96] Ю. Лю, С. Чжан, С. И, Ю. Чжао, С. Го, В. Ху, Дж. А. Пиотровски, Дж. Калиски, Дж. Урбани, З. Менг, Л. Чжоу и С. Ян (2026) EvoScientist: на пути к мультиагентным эволюционирующим ИИ-ученым для комплексных научных открытий. Open MIND. Внешние ссылки: Document, 2603.08127, Link Цитируется: 6.2 AI scientist agents⟧.
- ⟦[97] Х. Ма, К. Чжэн, Дж. Цю, Дж. Хонг, Ю. Яо, С. Цюй, Дж. Инь, С. Лоу, Дж. Ван, В. Лю, В. Чжан, З. Чжан и Х. Чжао (2026) Ретроспективное самосовершенствование с учетом прогресса для обучения LLM агентов. Внешние ссылки: 2606.14302, Link Цитируется: 4.1 Self-rewarding reinforcement learning⟧.
- ⟦[98] С. Маседо (2026) Хватит опекать своего агента по программированию: проектирование циклов, заменяющих пошаговые подсказки. Внешние ссылки: 2607.00038, Link Цитируется: 2.1 Preliminaries and definitions, 3.5 Harness and agent self-evolution.
- ⟦[99] А. Мадаан, Н. Тандон, П. Гупта, С. Халлинан, Л. Гао, С. Вигреффе, У. Алон, Н. Дзири, С. Прабхумойе, Я. Янг, С. Гупта, Б. П. Маджумдер, К. Херманн, С. Веллек, А. Язданбахш и П. Кларк (2023) Self-refine: итеративное уточнение с использованием саморефлексии. В сборнике Advances in Neural Information Processing Systems (NeurIPS), Внешние ссылки: 2303.17651, Link Цитируется в: 1. Introduction, 3. Deployment-Time Self-Evolution.
- ⟦[100] Дж. Мао, Х. Чен, Х. Ту, Ю. Ван, Л. Чжан, З. Чжэн, Х. Яо, З. Ван, К. Се и Ю. Чжоу (2026) Kestrel: обоснованное самосовершенствование для снижения галлюцинаций в LVLM. Внешние ссылки: 2603.16664, Link Цитируется: 3.3 Vision-language and multimodal self-critique⟧.
- ⟦[101] К. Дж. Макэндрюс (2026) Обратная связь важнее формы: почему обратная связь от выполнения кода важнее топологии конвейера при генерации кода моделями 1-3b. Внешние ссылки: 2604.21950, Link Цитируется в: 3.2 Code self-repair via execution feedback⟧.
- ⟦[102] И. Нам, Дж. Чон и Н. Ким (2026) Детерминированные шлюзы целостности для подготовки клинических рукописей с помощью LLM: аудируемая архитектура биомедицинской информатики. Внешние ссылки: 2606.09500, Link Цитируется: 5.3 Failure modes, 6.3 The critical and diagnostic literature.
- ⟦[103] Х. Нгуен, Х. Чжан, Ю. Чжан, Х. Чэнь и Дж. Динг (2026) LongSumEval: оценка на основе ответов на вопросы и уточнение с использованием обратной связи для суммаризации длинных документов. Внешние ссылки: 2604.25130, Link Цитируется в: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[104] А. Новиков, Н. Ву, М. Айзенбергер, Э. Дюпон, П. Хуанг, А. З. Вагнер, С. Широбоков, Б. Козловский, Ф. Дж. Р. Руис, А. Меграбян, М. П. Кумар, А. Си, С. Чоудхури, Г. Холланд, А. Дэвис, С. Новозин, П. Коли и М. Балог (2025) AlphaEvolve: агент для написания кода, предназначенный для научных и алгоритмических открытий. Внешние ссылки: 2506.13131, Link Цитируется: 1. Introduction, 5.2 The verification hierarchy, 6.1 LLM-driven evolutionary program discovery, 6.3 The critical and diagnostic literature.
- ⟦[105] Т. Орд (2025) Масштабирование вывода меняет управление ИИ. Внешние ссылки: 2503.05705, Link Цитируется: 7.3 Safety, control, and the dialogue with the takeoff question.
- ⟦[106] Л. Пан, С. Тао, Ю. Чжай, Л. Чжан, З. Лю, Б. Дин, А. Лю и Л. Вэнь (2026) RLCSD: обучение с подкреплением посредством контрастивной он-полиси самодистилляции. Внешние ссылки: 2606.11709, Link Цитируется: 4.3 On-policy self-distillation⟧.
- ⟦[107] Л. Пан, Ю. Чжу, Л. Цю, С. Цао и С. Цай (2026) SAGE: количественная оценка социализированной эволюции в экосистемах агентов. Внешние ссылки: 2606.03544, Link Цитируется: 3.5 Harness and agent self-evolution⟧.
- ⟦[108] П. Пасков, Дж. Ли, К. Брэди и А. Уорленд (2026) Измерение биологических возможностей и рисков агентов AI. Внешние ссылки: 2606.19899, Link Цитируется: 7.3 Safety, control, and the dialogue with the takeoff question.
- ⟦[109] Х. Патель (2026) Верифицируемый поиск не является обучаемой цепочкой рассуждений. Внешние ссылки: 2606.21884, Link Цитируется: 4.2 Self-training for chain-of-thought reasoning.
- ⟦[110] С. Х. Пу, З. Венг, К. Лю, Дж. Сриниваса, Г. Лю, В. В. Б. Ван и К. Э. Ван (2026) Выжить или рухнуть: асимметричные роли фильтрации данных и обоснования вознаграждения в RL с самообучением. Внешние ссылки: 2605.22217, Link Цитируется в: 4.4 Self-play, 4.5 Embodied and synthetic-data loops, 5.3 Failure modes, 8. Discussion: Cross-Cutting Observations and Open Problems⟧.
- ⟦[111] Р. А. Рашид, С. Банерджи, А. Мукерджи и Р. Хазра (2026) От беглости к проверяемости: аудируемость на уровне утверждений для агентов глубоких исследований. Open MIND. Внешние ссылки: Document, 2602.13855, Link Цитируется: 5.4 The non-verifiable frontier, 6.3 The critical and diagnostic literature, item 2⟧.
- ⟦[112] Б. Ромера-Паредес, М. Барекатайн, А. Новиков, М. Балог, М. П. Кумар, Э. Дюпон, Ф. Дж. Р. Руис, Дж. С. Элленберг, П. Ван, О. Фаузи, П. Коли и А. Фаузи (2024) Математические открытия с помощью поиска программ с использованием LLM. Nature 625, стр. 468–475. Примечание: FunSearch Внешние ссылки: Document Цитируется в: 1. Introduction, 5.2 The verification hierarchy, 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[113] А. Саутер, Ю. Чжао, Дж. Урбани, В. Ху, З. Менг, Л. Чжоу, С. Ян и Ю. Лю (2026) EvoIdeator: развитие научных идей посредством обучения с подкреплением на основе контрольных списков. Внешние ссылки: 2603.21728, Link Цитируется: 4.1 Self-rewarding reinforcement learning⟧.
- ⟦[114] Т. Шол (2024) Безграничное сократическое обучение с помощью языковых игр. Внешние ссылки: 2411.16905, Link Цитируется в: 7.1 Theoretical conditions and bounds⟧.
- ⟦[115] Й. Шмидхубер (2003) Машины Гёделя: самореферентные универсальные решатели задач, осуществляющие доказуемо оптимальные самосовершенствования. arXiv preprint cs/0309048. Внешние ссылки: Link Цитируется в: 1. Introduction, 3.5 Harness and agent self-evolution.
- ⟦[116] С. К. Ситаканта, Д. Тай, В. П. Гуди, С. Тивари, Р. Матар, А. Митра, В. Чжао, В. Саллум и А. Маккаллум (2026) Оптимизация предпочтений на основе обнаружения галлюцинаций для клинического реферирования. Внешние ссылки: 2605.28910, Link Цитируется в: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[117] С. Ше, Ю. Бао, Л. Ю, Л. Сюй, Т. Ли, В. Чжу, С. Хуан, С. Чэн, Л. Лу и Ю. Ван (2025) DuPO: обеспечение надежной самопроверки LLM посредством двойной оптимизации предпочтений. Внешние ссылки: 2508.14460, Link Цитируется: 5.1 The evaluator design space⟧.
- ⟦[118] З. Шен, Дж. Тонг, С. Ян, К. Шен, Х. Чен, В. Йе, Х. Ху, Р. Миао, Х. Ванг, Дж. Чжао, Г. Чен и Дж. П. Йе (2026) Очищенный OPSD: on-policy самодистилляция без потери навыков мышления. Внешние ссылки: 2607.02234, Link Цитируется: 4.3 On-policy self-distillation⟧.
- ⟦[119] Д. Ши, Дж. Хэ, Дж. Чен, Б. Ван и Ю. Накашима (2026) На пути к здоровой эволюции: исследование роли и механизмов взаимодействия человека и агента в саморазвивающихся системах. Внешние ссылки: 2606.06114, Link Цитируется в: 3.6 Skill libraries and persistent accumulation, 7.3 Safety, control, and the dialogue with the takeoff question, item 3⟧.
- ⟦[120] З. Ши, Б. Хе, Ю. Санг, Х. Лу и Б. Дюмулен (2026) A-evolve-training: автономное пост-обучение модели 30b. Внешние ссылки: 2606.20657, Link Цитируется в: 6.2 AI scientist agents, 7.3 Safety, control, and the dialogue with the takeoff question.
- ⟦[121] Н. Шинн, Ф. Кассано, Э. Берман, А. Гопинат, К. Нарасимхан и С. Яо (2023) Reflexion: языковые агенты с вербальным обучением с подкреплением. В сборнике: Достижения в системах обработки нейронной информации (NeurIPS), Внешние ссылки: 2303.11366, Link Цитируется в: 3. Deployment-Time Self-Evolution, 5.5 Result-level versus process-level improvement.
- ⟦[122] И. Шумайлов, З. Шумайлов, Ю. Чжао, Н. Папернот, Р. Андерсон и Ю. Гал (2024) Модели AI деградируют при обучении на рекурсивно сгенерированных данных. Nature 631, стр. 755–759. Внешние ссылки: Document Цитируется в: 5.3 Failure modes, 7.2 The skeptical position.
- ⟦[123] А. Сингх, Дж. Д. Ко-Рейес, Р. Агарвал и др. (2023) За пределами человеческих данных: масштабирование самообучения для решения задач с помощью языковых моделей. Примечание: ReSTEM; TMLR 2024 Внешние ссылки: 2312.06585, Link Цитируется в: 4. Training-Time Self-Iteration⟧.
- ⟦[124] С. Снелл, Дж. Ли, К. Сюй и А. Кумар (2024) Оптимальное масштабирование вычислительных ресурсов LLM во время тестирования может быть более эффективным, чем масштабирование параметров модели. Внешние ссылки: 2408.03314, Link Цитируется в: 3. Deployment-Time Self-Evolution⟧.
- ⟦[125] К. Сонг, М. Сео, Ю. Сеонг, Д. Ким и К. Ким (2026) Обучение LLM в процессе тестирования с учетом запроса. Внешние ссылки: 2605.13369, Link Цитируется: 3.4 Test-time training⟧.
- ⟦[126] М. Сонг и М. Чжэн (2026) Обзор дистилляции on-policy для LLM. Внешние ссылки: 2604.00626, Link Цитируется в: 1. Introduction, 2.3 Corpus and method, 4.3 On-policy self-distillation.
- ⟦[127] Х. Сонг, З. Цай и Л. Чжао (2026) AlgoSkill: обучение проектированию алгоритмов посредством планирования навыков, подобных человеческим. Внешние ссылки: 2606.29999, Link Цитируется: 3.6 Skill libraries and persistent accumulation.
- ⟦[128] Э. Став, Д. Берловиц, М. Орнер и С. Краус (2026) Когда помогает внутренняя самокоррекция? анализ, чувствительный к типу задачи. Внешние ссылки: 2606.23196, Link Цитируется в: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[129] И. Суй и Б. Хуи (2026) Диалог для неверифицируемого обучения: саморазвивающиеся LLM посредством мета-оценки. Open MIND. Внешние ссылки: Document, 2601.21464, Link Цитируется в: 4.4 Self-play, 5.1 The evaluator design space, 5.2 The verification hierarchy, 5.4 The non-verifiable frontier, item 2⟧.
- ⟦[130] М. Сун, Ю. Ли, З. Ю, С. Чжан и В. Йе (2026) Рубрики опорных векторов: устранение разрыва между самогенерируемыми и человеческими рубриками. Внешние ссылки: 2606.08077, Link Цитируется: 5.1 The evaluator design space⟧.
- ⟦[131] Х. Сун, Х. Ван, Л. Шмидт, С. Йенг-Леви и Ю. Чжан (2026) Обучение на ошибках: самосовершенствование агентов компьютерного использования во время вывода. Внешние ссылки: 2606.31270, Link Цитируется: 3.5 Harness and agent self-evolution⟧.
- ⟦[132] С. Тан, П. Юань, С. Ван, Ю. Ли, С. Фэн, Ю. Чжан, Дж. Ши, Дж. Чжан, Б. Пан, Ю. Ху и К. Ли (2025) Разрыв цикла самоподтверждения: диагностика и смягчение системного смещения вознаграждения в самообучающемся RL. Внешние ссылки: 2510.08977, Link Цитируется: 5.3 Failure modes, 7.3 Safety, control, and the dialogue with the takeoff question.
- ⟦[133] С. Тан, Д. Чжу, К. Тран, М. Денковски, С. Тренус, Б. Бирн, Л. Рибейро и Ф. Хибер (2026) Что на самом деле улучшает доработка LLM? систематическое исследование литературного перевода на уровне документа. Внешние ссылки: 2605.13368, Link Цитируется в: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[134] Т. Танвир (2026) LEVI: более мощные архитектуры поиска могут заменить более крупные LLM в эволюционном поиске. Внешние ссылки: 2605.09764, Link Цитируется: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[135] С. Тянь, Ю. Яо и Дж. Цуй (2026) Планировщик QueenBee: топологии коммуникации с эволюционирующими навыками для токен-эффективных мультиагентных систем на базе LLM. Внешние ссылки: 2606.27492, Link Цитируется: 3.5 Harness and agent self-evolution⟧.
- ⟦[136] А. Томихари и И. Сато (2026) Распределение мощности связывает сэмплирование, self-reward RL и self-distillation. Внешние ссылки: 2605.04542, Link Цитируется: 4.3 On-policy self-distillation.
- ⟦[137] Х. Усами, К. Хара, А. Цубои и Н. Мацуда (2026) LLM judges have dark current: психометрический паспорт для оценки LLM-as-a-judge. Внешние ссылки: 2606.15610, Link Цитируется в: 5.1 The evaluator design space⟧.
- ⟦[138] С. Венкатраман, Р. Тавкар, О. Тавакар, Р. М. Анвер, Х. Чолаккал, С. Хан и Ф. Хан (2026) Уделение большего внимания визуальным токенам в саморазвивающихся больших мультимодальных моделях. Внешние ссылки: 2606.27373, Link Цитируется: 3.3 Vision-language and multimodal self-critique, 5.3 Failure modes, 8. Discussion: Cross-Cutting Observations and Open Problems⟧.
- ⟦[139] И. Више, Р. Сурана, С. Цзян, З. Хуан, С. Ли, Н. Л. Куанг, Т. Ю, Р. А. Росси, Дж. Шанг, Дж. Маколи и Дж. Ву (2026) Skill-r1: эволюция навыков агентов посредством обучения с подкреплением. Внешние ссылки: 2605.09359, Link Цитируется: 3.6 Skill libraries and persistent accumulation⟧.
- ⟦[140] И. Ван, Т. Фан, З. Ли, И. Хуо, В. Ван, Х. Ми, Д. Ю и М. Р. Лю (2026) Масштабирование верификации на этапе вывода: саморазвивающиеся агенты для глубоких исследований посредством верификации с использованием рубрикатора во время тестирования. Внешние ссылки: 2601.15808, Link Цитируется: 3.5 Harness and agent self-evolution, 5.1 The evaluator design space.
- ⟦[141] Г. Ван, Ю. Се, Ю. Цзян, А. Мандлекар, К. Сяо, Ю. Чжу, Л. Фан и А. Анандкумар (2023) Voyager: воплощенный агент с открытым финалом на базе LLM. Примечание: TMLR 2024 Внешние ссылки: 2305.16291, Link Цитируется в: 3.6 Skill libraries and persistent accumulation, 5.5 Result-level versus process-level improvement.
- ⟦[142] С. Ван, С. Лю, Л. Лю и З. Хан (2026) Видеть прежде рассуждения: разделение восприятия и рассуждения для устойчивого к быстрым решениям мультимодального он-полиси самодистиллирования. Внешние ссылки: 2606.19120, Link Цитируется: 4.3 On-policy self-distillation, 8. Discussion: Cross-Cutting Observations and Open Problems.
- ⟦[143] У. Ван и З. Сун (2026) KBSpec: генерация формальных спецификаций на основе LLM с развивающейся базой знаний предметной области. Внешние ссылки: 2606.21339, Link Цитируется: 3.2 Code self-repair via execution feedback⟧.
- ⟦[144] Й. Ван, К. Би, Дж. Сан, С. Шен, З. Ци, С. Ван и К. Хуанг (2026) ActiveScope: активный поиск и исправление восприятия для MLLMs. Внешние ссылки: 2606.24292, Link Цитируется: 3.3 Vision-language and multimodal self-critique⟧.
- ⟦[145] И. Ван, И. Тан, Б. Лю, С. Лю и Д. Шан (2026) Когда проектирование вознаграждения LLM терпит неудачу: диагностически-ориентированное уточнение для разреженного структурированного RL. Внешние ссылки: 2605.28918, Link Цитируется в: 4.1 Self-rewarding reinforcement learning⟧.
- ⟦[146] З. Ван, Х. Ли, З. Ян, З. Ху, С. Зуо, Ю. Чжан, Д. Ма, Д. Луо, К. Ван, Дж. Пенг, Т. Хуанг, С. Гуо, Х. Ван, З. Жу, С. Хан, Ю. Цао, К. Ю, Л. Чен, К. Ю и Л. Чен (2026) Экстернализация синтеза и валидации исследований в ученых на базе AI посредством исследовательской обвязки. Внешние ссылки: 2606.18874, Link Цитируется: 6.2 AI scientist agents⟧.
- ⟦[147] Дж. Вэй, С. Чжан, Ю. Ян, В. Хуан, Дж. Цао, С. Сюй, С. Чжуан, З. Гао, М. Абдул-Маджид, Л. В. С. Лакшманан, К. Ю, В. Оуян и С. Сунь (2025) Унификация алгоритма древовидного поиска и проектирования вознаграждения для рассуждений LLM: обзор. Внешние ссылки: 2510.09988, Link Цитируется: 1. Introduction, 2.3 Corpus and method.
- ⟦[148] И. Вэй, З. Хуан, С. Лу, Дж. Цянь, К. Ван, К. Ву и Л. Хэ (2026) SkillSmith: совместная эволюция навыков и инструментов для самосовершенствующихся агентных систем. Внешние ссылки: 2606.01314, Link Цитируется: 3.6 Skill libraries and persistent accumulation.
- ⟦[149] П. Уитфилл и К.Х. Ву (2025) Предотвратят ли вычислительные узкие места взрыв интеллекта?. Внешние ссылки: 2507.23181, Link Цитируется в: 7.1 Theoretical conditions and bounds, 7.2 The skeptical position, 8. Discussion: Cross-Cutting Observations and Open Problems⟧.
- ⟦[150] С. Х. Ву и А. Рагунатхан (2026) Самообучающаяся верификация для самосовершенствования во время обучения и тестирования. Внешние ссылки: 2605.30290, Link Цитируется в: 4.1 Self-rewarding reinforcement learning, 5.1 The evaluator design space, 8. Discussion: Cross-Cutting Observations and Open Problems⟧.
- ⟦[151] Х. Ву, Дж. Лю, С. Вэй, Ю. Гао, Ю. Ву и Ю. Ху (2026) Пути графа знаний как промежуточное руководство для саморазвивающихся поисковых агентов. Внешние ссылки: 2605.05702, Link Цитируется: 5.5 Result-level versus process-level improvement⟧.
- ⟦[152] И. У, А. Дж. Ли, В. Ма, Л. Цао, З. Чжоу, М. Джемри, С. Лю, И. Сю, Ч. Янь, Х. Чжао, Б. Ю, И. Стойка и Д. Сонг (2026) BenchEvolver: синтез передовых задач посредством эволюции, ориентированной на решение. Внешние ссылки: 2606.01286, Link Цитируется: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[153] Ф. В. Вундерлих, Л. Б. Кесберг, Дж. П. Вале, Т. Руас и Б. Гипп (2026) Мультиагентное рассуждение повышает вычислительную эффективность: парето-оптимальное масштабирование во время тестирования. Внешние ссылки: 2605.01566, Link Цитируется в: 3.5 Harness and agent self-evolution⟧.
- ⟦[154] П. Ся, К. Цзэн, Дж. Лю, Ч. Цинь, Ф. У, И. Чжоу, Ч. Сюн и Х. Яо (2025) Agent0: раскрытие потенциала саморазвивающихся агентов с нуля без данных посредством рассуждений, интегрированных с инструментами. Примечание: ICML 2026 Внешние ссылки: 2511.16043, Link Цитируется: 4.4 Self-play⟧.
- ⟦[155] С. Ся, И. Чжан, А. Чэнь, С. У, С. Юань и И. Сяо (2026) От ИИ-помощника к ИИ-ученому: автономное обнаружение алгоритмов LLM-RL с помощью агентов LLM. Внешние ссылки: 2603.23951, Link Цитируется: 6.1 LLM-driven evolutionary program discovery⟧.
- ⟦[156] С. Сяо, З. Цзяо, С. Ван, В. Ван, Б. Чжао, Х. Вэй, Л. Чжан и Л. Цюй (2026) Socratic-SWE: саморазвивающиеся агенты программирования посредством навыков агента, полученных на основе трассировки. Внешние ссылки: 2606.07412, Link Цитируется: 3.6 Skill libraries and persistent accumulation⟧.
- ⟦[157] А. Синь, Дж. Сиоу, Дж. Ван, З. Яо, Ф. Чжан, Дж. Сонг, Л. Хоу и Дж. Ли (2026) EurekAgent: проектирование среды агентов — это всё, что нужно для автономных научных открытий. Внешние ссылки: 2606.13662, Link Цитируется: 6.2 AI scientist agents⟧.
- ⟦[158] И. Сюэ, З. Ли, П. Торр и Дж. Гу (2026) Безопасная авторегрессионная генерация изображений с итеративно самосовершенствующимися кодовыми книгами. Внешние ссылки: 2606.27147, Link Цитируется в: 3.3 Vision-language and multimodal self-critique.
- ⟦[159] З. Сюэ, А. Байд, С. Ким, М. Луо и К. Грауман (2026) Обучение на основе персонального визуального контекста в больших мультимодальных моделях. Внешние ссылки: 2605.10936, Link Цитируется: 3.3 Vision-language and multimodal self-critique⟧.
- ⟦[160] Дж. И, Б. Чу, Гао, Дж. Чжан, И. Ма, И. Тан, Дж. Джи, С. Сун и Р. Джи (2026) Одной рефлексии недостаточно: самокорректирующиеся автономные исследования посредством атрибуции отказов на основе множественных гипотез. Внешние ссылки: 2606.31478, Link Цитируется: 6.2 AI scientist agents⟧.
- ⟦[161] Дж. Янг, Т. Янг, В. Ли, Х. Чанг, Ф. Чао, К. Шанг и К. Шен (2026) PhysReflect-VLA: физическая осуществимость и саморефлексивная регуляция для надежных стратегий vision-language-action. Внешние ссылки: 2606.27146, Link Цитируется: 4.5 Embodied and synthetic-data loops⟧.
- ⟦[162] Дж. Янг, Г. Яо, Ю. Чжан, Р. Р. Компелла, Г. Лю и С. Чанг (2026) FederatedSkill: федеративное обучение для эволюции агентных навыков. Внешние ссылки: 2606.03143, Link Цитируется: 3.6 Skill libraries and persistent accumulation⟧.
- ⟦[163] М. Ян, Дж. Пяо, С. Ся, С. Лань, Дж. Чэнь, И. Гун и И. Ли (2026) SkillMaster: на пути к автономному овладению навыками в LLM агентах. Внешние ссылки: 2605.08693, Link Цитируется: 3.6 Skill libraries and persistent accumulation⟧.
- ⟦[164] Х. Янг, К. Ван, К. Чжэн, Х. Чжан и Ю. Ву (2026) AgenticDB: агентная реконфигурация производительности для рабочих нагрузок баз данных. Внешние ссылки: 2606.20318, Link Цитируется: 3.2 Code self-repair via execution feedback⟧.
- ⟦[165] Я. Янг, Н. П. Бхатт, К. Ванг, С. Теттех, З. Ванг и У. Топчу (2026) VASO: формально верифицируемые саморазвивающиеся навыки для физических AI агентов. Внешние ссылки: 2606.05395, Link Цитируется в: 3.6 Skill libraries and persistent accumulation, 5.2 The verification hierarchy, item 4, 8. Discussion: Cross-Cutting Observations and Open Problems.
- ⟦[166] З. Ян, Х. Лю и Х. Сюй (2026) SciIntegrity-bench: эталонный тест для оценки академической добросовестности в системах AI scientist. Внешние ссылки: 2605.10246, Link Цитируется: 5.3 Failure modes, 6.3 The critical and diagnostic literature, 7.3 Safety, control, and the dialogue with the takeoff question, 8. Discussion: Cross-Cutting Observations and Open Problems⟧.
- ⟦[167] Я. Яо, Х. Чжан, В. Тонг и Т. Чжан (2026) FLARE: гранулярная диагностическая обратная связь для уточнения кода LLM. Внешние ссылки: 2606.03852, Link Цитируется: 3.2 Code self-repair via execution feedback.
- ⟦[168] С. Инь, Д. Кен и Дж. Стреммель (2026) Итеративная самокоррекция с шумоподавлением: структурированные циклы верификации для надежного рассуждения LLM. Внешние ссылки: 2606.21724, Link Цитируется: 3.2 Code self-repair via execution feedback⟧.
- ⟦[169] И. Инь, С. Ван, Л. Пан, Л. Линь, С. Ван и У. И. Ван (2024) Агент Гёделя: структура самореферентного агента для рекурсивного самосовершенствования. Внешние ссылки: 2410.04444, Link Цитируется в: 1. Introduction, 3.5 Harness and agent self-evolution.
- ⟦[170] А. Юань, Ю. Нянь, Х. Чжан, З. Су и Ю. Чжао (2026) SEVA: саморазвивающийся агент верификации с процессуальным вознаграждением для атрибуции фактов. Внешние ссылки: 2606.29713, Link Цитируется: 4.1 Self-rewarding reinforcement learning, 5.1 The evaluator design space.
- ⟦[171] У. Юань, Р. И. Панг, К. Чо, Х. Ли, С. Сухбаатар, Дж. Сюй и Дж. Уэстон (2024) Self-rewarding language models. В материалах Международной конференции по машинному обучению (ICML), Внешние ссылки: 2401.10020, Link Цитируется в: 1. Introduction, 4. Training-Time Self-Iteration.
- ⟦[172] Ю. Юань, Ю. Хуан, С. Яо, Ю. Ли, С. Чжан, Л. Хань, П. Ли, Дж. Сунь, В. Цзя, Ч. Чжан, Ю. Лю, Р. Ляо, Ю. Ху, Ц. У, Ю. Ли, Ч. Дун, Ф. Ни, Ю. Чжэн, С. Гу, Ю. Ма, Х. Тан, Х. Ху и Дж. Хао (2026) Embodied-r1.5: развитие физического интеллекта посредством воплощенных базовых моделей. Внешние ссылки: 2606.11324, Link Цитируется: 4.5 Embodied and synthetic-data loops⟧.
- ⟦[173] Э. Зеликман, Ю. Ву, Дж. Му и Н. Д. Гудман (2022) STaR: начальная загрузка рассуждений с помощью рассуждений. В сборнике: Достижения в системах обработки нейронной информации (NeurIPS), Внешние ссылки: 2203.14465, Link Цитируется в: 1. Introduction, 4. Training-Time Self-Iteration, 5.5 Result-level versus process-level improvement.
- ⟦[174] Х. Зенг, П. Лю, Ю. Занг, Ю. Шен, Ф. Ю, К. С. Ю, М. Ю. Лю и Ю. Ду (2026) Сократические агенты для автономных научных открытий в многомерных физических системах. Внешние ссылки: 2606.26722, Link Цитируется: 6.2 AI scientist agents⟧.
- ⟦[175] Г. Зенил (2026) О пределах рекурсивного самосовершенствования в больших языковых моделях: сингулярность не близка без синтеза символьных моделей. Внешние ссылки: 2601.05280, Link Цитируется в: 5.3 Failure modes, 7.1 Theoretical conditions and bounds, 7.2 The skeptical position, item 1⟧.
- ⟦[176] Дж. Зенн и Дж. Гейпинг (2026) Когда вероятные ответы являются верными? о вероятности последовательности и правильности в LLM. Внешние ссылки: 2606.27359, Link Цитируется: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[177] Б. Чжан, К. Ван и К. Ву (2026) EVOM: агентная мета-эволюция архитектур actor-critic для обучения с подкреплением. Внешние ссылки: 2606.26327, Link Цитируется: 6.1 LLM-driven evolutionary program discovery.
- ⟦[178] Д. Чжан, С. Чжоубянь, З. Ху, Ю. Юэ, Ю. Дун и Дж. Тан (2024) ReST-MCTS*: самообучение LLM посредством древовидного поиска, управляемого вознаграждением за процесс. Внешние ссылки: 2406.03816, Link Цитируется в: 4.1 Self-rewarding reinforcement learning, 5.5 Result-level versus process-level improvement.
- ⟦[179] Г. Чжан, В. Лян, О. Сюй и К. Олукотун (2025) Адаптивная система агентных LLM для рекурсивного самосовершенствования при разработке библиотек машинного обучения. Внешние ссылки: 2502.02534, Link Цитируется: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[180] Дж. Чжан, С. Ху, К. Лу, Р. Ланге и Дж. Клун (2025) Машина Дарвина-Гёделя: бесконечная эволюция самосовершенствующихся агентов. Внешние ссылки: 2505.22954, Link Цитируется в: 1. Introduction, 3.5 Harness and agent self-evolution.
- ⟦[181] Дж. Чжан, Дж. Цзян, К. Чжан, Ф. Мо, Л. Ли и Д. Цзэн (2026) На пути к надежному и устойчивому планированию LLM: структура итеративного самосовершенствования на основе символьной обратной связи. Внешние ссылки: 2606.27757, Link Цитируется: 3.1 Self-critique and self-verification for text and reasoning⟧.
- ⟦[182] Л. Чжан и С. Котари (2026) Раскрытие потенциала исправления кода с помощью LLM посредством итеративных циклов обратной связи. Внешние ссылки: 2606.17514, Link Цитируется в: 3.2 Code self-repair via execution feedback.
- ⟦[183] Р. Чжан, Р. Х. Бай, Х. Чжэн, Н. Джайтли, Р. Коллобер и Ю. Чжан (2026) Удивительно простая самодистилляция улучшает генерацию кода. Внешние ссылки: 2604.01193, Link Цитируется в: 4.3 On-policy self-distillation⟧.
- ⟦[184] У. Чжан, З. Ли, Х. Паланги, Б. Граеф, А. А. Хейдари, С. А. Ли, С. Рахман, Р. Луо, З. Эсмаилпур, Э. Шенк, К. Чжан, Ю. Ли, М. Чжоу, П. С. Ю, Д. Макдафф, Л. Санден, М. Малхотра, С. Патель и А. А. Метвалли (2026) RubricsTree: масштабируемая и развивающаяся оценка открытого типа для персональных агентов в сфере здравоохранения с учетом медицинской памяти и врачебных навыков. Внешние ссылки: 2606.18203, Link Цитируется: 5.1 The evaluator design space⟧.
- ⟦[185] Х. Чжан, Х. Вэй, Дж. Ву, Дж. Ву, З. Чжан, З. Лей и К. Ли (2025) Генерация на основе сгенерированного: подход к саморазвивающимся диффузионным моделям. Внешние ссылки: 2502.09963, Link Цитируется: 5.3 Failure modes⟧.
- ⟦[186] И. Чжан, К. Сиплинг и М. Д. Вентра (2026) Научное открытие как метаоптимизация: пример комбинаторной оптимизации. Внешние ссылки: 2606.26728, Link Цитируется в: 6.1 LLM-driven evolutionary program discovery, 8. Discussion: Cross-Cutting Observations and Open Problems.
- ⟦[187] З. Чжан, Н. Ван, С. Галхотра и К. Карди (2026) Как далеко мы находимся от настоящего автоматизированного исследования?. Внешние ссылки: 2605.19156, Link Цитируется: 6.3 The critical and diagnostic literature.
- ⟦[188] А. Чжао, Ю. Ву, Ю. Юэ, Т. Ву, К. Сюй, Ю. Юэ, М. Линь, С. Ван, К. Ву, З. Чжэн и Г. Хуан (2025) Абсолютный ноль: усиленное рассуждение через самоигру с нулевым объемом данных. Внешние ссылки: 2505.03335, Link Цитируется в: 2.1 Preliminaries and definitions, 4.4 Self-play.
- ⟦[189] Л. Чжэн, В. Цзян, Ю. Шэн, С. Чжуан, З. У, Ю. Чжуан, З. Линь, З. Ли, Д. Ли, Э. П. Син, Х. Чжан, Дж. Э. Гонсалес и И. Стоика (2023) Оценка LLM-as-a-judge с помощью MT-bench и chatbot arena. В сборнике Advances in Neural Information Processing Systems (NeurIPS), трек Datasets and Benchmarks, Внешние ссылки: 2306.05685, Link Цитируется: 5.1 The evaluator design space⟧.
- ⟦[190] К. Чжун, Л. Дин, Дж. Лю, Б. Ду, Л. Рутковски и Д. Тао (2026) Лучше, быстрее: использование самосовершенствования в больших моделях рассуждений. Внешние ссылки: 2605.24998, Link Цитируется: 5.3 Failure modes⟧.
- ⟦[191] Т. Чжоу, С. Джа, М. Кристодореску, К. Левченко и В. Чандрасекаран (2026) Верифицируемый перевод кода с помощью меташагового декодирования. Внешние ссылки: 2605.17626, Link Цитируется в: 3.2 Code self-repair via execution feedback⟧.
- ⟦[192] К. Чжу, С. Ван и В. Чжан (2026) (Человеческое) внимание — это (по-прежнему) всё, что вам нужно: человеческий контроль делает социальные науки с поддержкой AI надежными. Внешние ссылки: 2606.12848, Link Цитируется: 6.3 The critical and diagnostic literature.
- ⟦[193] Х. Чжу, Ю. Цай, З. Лю, К. Ван, Ф. Ли, В. Цзинь, В. Лю, З. Бин, Б. Чжэн, Дж. Чай, С. Тан, Р. Е, Ю. Ду, С. Пан, Ю. Ду, Т. Мяо, Ю. Чжан, Р. Ляо, З. Дин, Л. Чжан, Ю. Ван, В. Э и С. Чэнь (2026) EvoMaster: фундаментальная эволюционирующая агентная среда для агентной науки в масштабе. Внешние ссылки: 2604.17406, Link Цитируется: 6.2 AI scientist agents⟧.