 Путь к саморазвивающимся клиническим системам: масштабирование медицинских агентов от помощи к автономности
Аннотация
Растущая способность LLM и vision-language models совместно интерпретировать изображения и текст и рассуждать на их основе меняет облик медицинских агентов, превращая их из пассивных, узкоспециализированных предсказателей в автономных медицинских агентов, которые воспринимают, рассуждают, планируют, запоминают и действуют в реальных клинических условиях. Данный обзор намеренно отходит от парадигмы «возможности прежде всего», доминирующей в текущих обзорах медицинских агентов. Мы начинаем с реалий клинического внедрения и задаем фундаментальный вопрос: какие задачи, устойчивые к загрязнению данных бенчмарки и интерактивные среды обучения должен освоить медицинский агент, прежде чем ему можно будет доверить работу на практике? Чтобы обеспечить систематическое сравнение гетерогенных систем, мы формализуем таких агентов как процесс последовательного принятия решений в условиях частичной наблюдаемости и предлагаем таксономию автономии из трех уровней, охватывающую ассистивную, кооперативную и полностью автономную работу. Вокруг этого фундамента мы организуем всю область вдоль единого масштабируемого стержня с тремя взаимосвязанными осями: масштабирование фреймворка, охватывающее архитектурные парадигмы и оркестрацию инструментов; масштабирование возможностей, охватывающее цикл реализации от восприятия до действия; и масштабирование среды, которое обогащает экосистему инструментов, данных и интерфейсов. В рамках этого стержня мы выдвигаем масштабирование клинической среды — синтез насыщенных инструментальных и информационных сред с клиническими тренажерами — как наиболее практически применимый, но наименее изученный рычаг для агентов, которые нативно функционируют в экосистемах PACS, EHR и FHIR. Важно отметить, что мы позиционируем клиническую самоэволюцию — способность медицинского агента совершенствоваться посредством взаимодействия со средой, а не только за счет роста параметров — как перспективный рубеж, а не как решенную задачу, и переносим конкретные уроки от агентов общего назначения с самообучением, агентных тренажеров и масштабирования вычислений во время тестирования в область визуализации. Приложения в радиологии, патологии, офтальмологии и реальных больничных рабочих процессах рассматриваются наряду с практикой внедрения и открытыми рисками, включая галлюцинации, каскадные сбои и предвзятость. Обобщая более 300 источников с особым акцентом на достижения 2025–2026 годов в области самоэволюции и агентных сред, этот обзор намечает дорожную карту к созданию надежных, самосовершенствующихся систем медицинской визуализации, которые по-настоящему готовы к реальным клиническим условиям..
[Ключевые слова]Агенты в медицинской визуализации, vision-language models, самоэволюция, клиническое масштабирование, таксономия автономности, agentic benchmarks, доверенный клинический AI, обзор.
1 Введение
Появление фундаментальных моделей привнесло широкие, переносимые представления в медицинскую визуализацию, однако эти модели остаются фундаментально пассивными: на вход они выдают результат за один проход без возможности итеративного рассуждения, вызова инструментов или контекстной адаптации [305, 161, 157]. Текущий сдвиг парадигмы направлен в сторону медицинских агентов — систем AI, которые объединяют восприятие, рассуждение, планирование, память, использование инструментов и саморефлексию в автономный цикл, взаимодействующий с клинической средой [246, 265, 159, 10]. В отличие от статических моделей, которые отображают входные данные в выходные, такие агенты декомпозируют сложные клинические задачи, вызывают специализированные инструменты (например, модели сегментации, генераторы отчетов, базы данных для поиска), поддерживают рабочую память об истории болезни пациента и итеративно уточняют решения на основе промежуточной обратной связи [285, 210, 220], повторяя траекторию развития в области обработки естественного языка, где агенты на базе LLM [1, 240, 76] показали, что рассуждения с расширенными инструментами могут решать задачи, выходящие далеко за рамки вывода за один проход..
Несколько сходящихся факторов делают медицинских агентов одновременно осуществимыми и необходимыми. Во-первых, развитие мультимодальных LLM, таких как MedGemma [213], Lingshu [275], HealthGPT [140], InternVL3 [319], Qwen3-VL [9] и RadVLM [44], обеспечивает основу для рассуждений, которая совместно обрабатывает изображения и текст [287], в то время как стандартизированные интерфейсы инструментов, такие как Model Context Protocol [93, 52, 201] и API для вызова функций [198, 191], позволяют этой основе координировать работу различных специализированных моделей. Во-вторых, основные способности к рассуждению продвинулись от одношагового восприятия к более обдуманному, самокорректирующемуся выводу. Показательный прогресс включает динамическое визуальное внимание, которое позволяет агентам приобретать прогрессивную диагностическую фокусировку, имитирующую взгляд эксперта, и причинно-следственные рассуждения со структурированной саморефлексией, которые помогают им выявлять и исправлять ложные визуальные корреляции [317, 139]. В совокупности эти тенденции указывают на то, что заслуживающие доверия многошаговые медицинские рассуждения становятся достижимыми, а не остаются лишь стремлением. В-третьих, клинический спрос на интегрированные рабочие процессы, где одна консультация может потребовать чтения компьютерной томографии, перекрестной проверки предыдущих исследований, создания структурированного отчета и обозначения последующих действий, требует агентной многошаговой парадигмы, которая выходит за рамки того, что может предоставить любая отдельная модель [17, 45]. В-четвертых, недавно сформулированный принцип масштабирования среды [62, 97] постулирует, что возможности агента могут быть усилены за счет обогащения среды инструментов и данных, а не только за счет увеличения параметров модели [228, 209], что является уникально масштабируемым путем для агентов, работающих в насыщенных инструментами клинических экосистемах, представленных интерфейсами PACS, EHR и FHIR. Мы возводим этот последний принцип из второстепенного фактора в одну из трех организующих осей обзора, масштабируемый стержень, формализованный в разделе 2.3, и утверждаем, что сама клиническая среда является наиболее оперативно применимым рычагом для расширения возможностей медицинских агентов..
Вклад данного обзора. В данной статье представлен следующий вклад:
- ⟦ Мы принимаем принцип организации, ставящий во главу угла реальную среду: вместо того чтобы начинать с общих возможностей или таксономии инструментов, как в параллельных обзорах медицинских агентов, мы начинаем с точки внедрения, исследуя клинические сценарии, устойчивые к загрязнению бенчмарки и интерактивные среды обучения, которыми должен овладеть медицинский агент в реальных условиях..
- ⟦ Мы формализуем медицинских агентов как шесть взаимодействующих когнитивных модулей, функционирующих в условиях частичной наблюдаемости, и предлагаем таксономию автономии из трех уровней, которая объединяет разрозненную литературу.
- ⟦ Мы представляем масштабируемый стержень, проходящий через весь обзор, включающий масштабирование фреймворка (раздел 4), масштабирование возможностей (когнитивный цикл, управляемый инструментарием, раздел 5) и масштабирование среды (раздел 6), представленные в начале в разделе 2.3 в виде глобальной карты.
- ⟦ Мы переводим саморазвивающиеся системы из разряда скрытых функциональных возможностей в статус ключевого направления, синтезируя достижения в общих областях, такие как самосовершенствующиеся агенты, агентные среды и масштабирование вычислений во время тестирования, а также отслеживая их перенос в медицинскую визуализацию.
- ⟦ Мы рассматриваем клинические приложения от специализированных отделений до реальных больничных рабочих процессов, наряду с практикой развертывания и анализом, ориентированным на риски, охватывающим галлюцинации, каскадные сбои и справедливость.
Связь с параллельными обзорами. В нескольких недавних обзорах медицинские агенты рассматриваются с точки зрения их функциональных возможностей, при этом литература систематизируется по когнитивным модулям и инструментам, после чего системы распределяются по отделениям больниц — такая структура повторяет литературу по общей архитектуре агентов [298, 246] и рассматривает оценку как второстепенное приложение. Наш обзор отличается в трех аспектах. Во-первых, мы делаем сценарии реальной среды, бенчмарки и интерактивные среды обучения отправной точкой, а не заключительной главой, поскольку готовность к реальным условиям является ключевым вопросом для медицинских агентов. Во-вторых, мы переосмысливаем разбивку по инструментам и модулям как примеры единого масштабируемого стержня, рассматривая использование инструментов и модули возможностей через призму их масштабирования в сторону автономности, а не дублируя предыдущие таксономии. В-третьих, мы выдвигаем на первый план саморазвитие и масштабирование среды, извлекая применимые уроки из самообучающихся агентов общего назначения как определяющий рубеж для агентов, сталкивающихся с дрейфом клинических распределений. Несмотря на различия в охвате и методологии, репрезентативные недавние обзоры имеют одно «слепое пятно», которое мы конкретизируем: ни один из них не связывает раскрытый протокол поиска с осью масштабирования, ориентированной на среду..
Методология и охват обзора. С января 2022 года по июнь 2026 года, в период, когда агентные системы на базе LLM стали технически осуществимы для визуализации, мы провели поиск по основным базам научной литературы и материалам ведущих конференций по компьютерному зрению, machine learning и медицинской информатике, объединив агентную ось (agent, agentic, tool use, multi agent, autonomous), ось медицинской визуализации (radiology, pathology, CT, MRI, X ray, report generation) и ось фундаментальных моделей (large language model, foundation model, vision language). Поиск вернул записей и после удаления дубликатов; затем три рецензента независимо друг от друга проанализировали названия и аннотации на соответствие единому критерию включения — наличие автономного цикла, который воспринимает, рассуждает и выполняет действия в рамках задачи визуализации или клинической задачи, при этом четвертый рецензент выступал арбитром в спорных вопросах, что оставило более 300 исследований, дополненных методом «снежного кома» новейшими публикациями 2026 года. Мы намеренно сохранили несколько не связанных с визуализацией агентов, а именно агентов для работы с EHR и терапевтического обоснования, только в тех случаях, когда они предлагают архитектурные решения, применимые к визуализации, и отмечаем такие случаи в разделе 3.2 и разделе 7. Руководствуясь этим корпусом, обзор разворачивается вдоль оси масштабирования: от сценариев реальной среды и бенчмарков через масштабирование фреймворков, возможностей и среды к саморазвивающимся системам и их клиническому внедрению..
2 Вводные положения и таксономия
2.1 Формальное определение медицинских агентов
Мы определяем медицинского агента как вычислительную систему , состоящую из шести функциональных модулей: восприятие , рассуждение , планирование , память , использование инструментов и рефлексия действий [246, 265, 206]. Определяющей чертой этой среды является частичная наблюдаемость: агент никогда не наблюдает состояние пациента напрямую, а получает лишь косвенные и неполные данные, такие как изображения, предыдущие отчеты и результаты работы инструментов, на основе которых он должен поддерживать и постепенно уточнять внутреннюю оценку истинного клинического состояния. Шесть модулей совместно реализуют этот процесс: восприятие и память формируют и сохраняют представление о скрытом состоянии, рассуждение и планирование превращают это представление в действия, такие как вызовы инструментов и операции с отчетами, использование инструментов выполняет их в клинической среде, а рефлексия действий корректирует представление на основе полученной обратной связи. Такая формулировка делает очевидным, что медицинская агентность по своей сути является проблемой действий в условиях неопределенности и неполных данных, а не однократного прогнозирования..
Эти шесть модулей не являются самоцелью, а представляют собой субстрат для каждого агента, по которому масштабируется ось возможностей spine, в то время как среда становится явным рычагом ее третьей оси. Если рассматривать это через призму частичной наблюдаемости, три оси масштабирования spine соответствуют расширению отдельных компонентов процесса принятия решений: масштабирование фреймворка расширяет пространство доступных действий за счет добавления взаимодействующих агентов, масштабирование возможностей углубляет отображение оценки состояния агента в его действия посредством более богатой среды выполнения, а масштабирование среды обогащает как доказательства, которые агент может наблюдать, так и цели, по которым он оценивается, путем подключения большего количества инструментов, источников данных и интерфейсов, что именно поэтому является наиболее оперативно применимым рычагом для агентов, которые уже существуют в насыщенных инструментами клинических экосистемах.
2.2 Таксономия автономности трех уровней
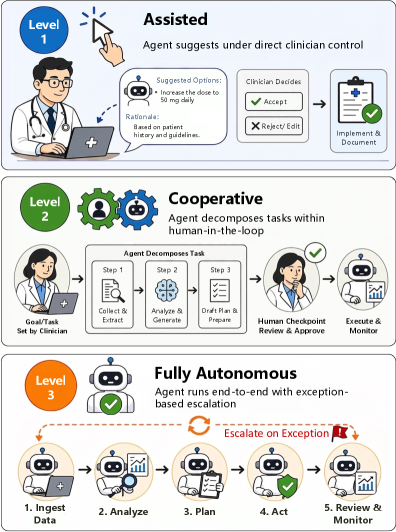
Опираясь на уровни автономности, установленные в сфере беспилотного вождения [41] и хирургической робототехники [278, 82], а также основываясь на недавних таксономиях автономности AI агентов [64], мы предлагаем трехуровневую таксономию для медицинских агентов, представленную на рис. 1:
Уровень 1: Вспомогательная автономность. На этом уровне агент выступает в роли интеллектуального помощника, который повышает эффективность работы врача без принятия независимых решений. Агент отвечает на явные запросы, генерирует варианты заключений или предварительно заполняет шаблоны отчетов, однако все решения требуют подтверждения со стороны врача [38, 24]. Примеры включают интерактивные инструменты сегментации с уточнением на основе промптов [161, 152] и помощников по составлению отчетов [12]⟧.
Уровень 2: Кооперативная автономность. Агент проактивно декомпозирует задачи, вызывает специализированные инструменты и представляет синтезированные результаты, но функционирует в рамках системы с участием человека [273, 238]. Клиницист сохраняет право отмены и проверяет результаты работы агента перед совершением клинических действий. Мультиагентные диагностические конвейеры, которые выполняют дифференциальную диагностику и отмечают критические находки, являются примером этого уровня [115, 255, 205, 321].
Уровень 3: Полностью автономная работа. Агент независимо выполняет сквозные клинические рабочие процессы, от оценки качества получения изображений до постановки диагноза, формирования отчетов и планирования последующих визитов, при минимальном контроле со стороны человека, с учетом нормативных ограничений и эскалации на человека при возникновении исключительных ситуаций [127, 249]. Хотя ни одна из существующих систем еще не достигла Уровня 3 в полной мере, появляющиеся фреймворки, такие как автономные радиологические конвейеры с замкнутым циклом контроля качества [242, 204] и саморазвивающиеся агентные экосистемы [58, 218], представляют собой значительные шаги в этом направлении..
2.3 Масштабируемый позвоночник: структура, возможности и масштабирование среды
Литература по медицинским агентам легко поддается перечислению, но ее трудно систематизировать, поскольку в статьях по архитектуре, когнитивным модулям и обучению используется собственная терминология, и редко указывается, как они сочетаются. Поэтому мы заранее принимаем единую организующую ось — масштабируемый стержень — и рассматриваем весь обзор через него. Стержень утверждает, что готовность агента к работе в реальных условиях усиливается по трем логически различным и в значительной степени независимым направлениям, которые мы записываем компактно как:
| (1) |
где обозначает структурную насыщенность топологии агента (количество и специализацию взаимодействующих агентов, а также оркестрацию, которая их связывает), обозначает глубину когнитивного цикла, развернутого вокруг фиксированной основы (среда выполнения и шесть модулей, по которым он циклически проходит), а обозначает размер и качество доступной среды (инструменты, источники данных и интерфейсы взаимодействия). Эти три компонента являются скорее взаимодополняющими, чем взаимозаменяемыми, поскольку более богатая топология не может компенсировать поверхностный цикл, и ни то, ни другое не поможет агенту, который не имеет доступа к PACS, EHR или базам данных клинических рекомендаций, в которых он нуждается, что именно поэтому мы рассматриваем их как ортогональные оси одного стержня, а не как конкурирующие школы.
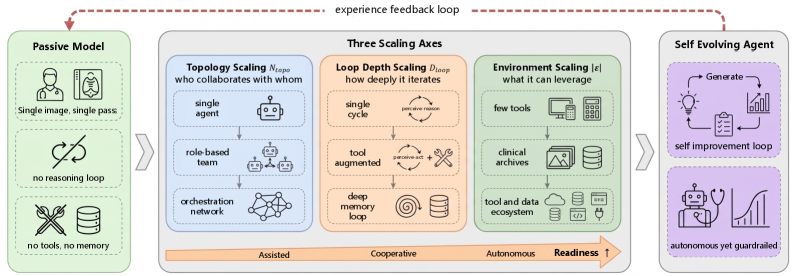
Данный каркас переводит пассивную модель однократного прохода к автономности вдоль трех ортогональных осей, которые мы суммируем на рис. 2, прежде чем подробно рассмотреть каждую из них. Первая ось, масштабирование фреймворка (раздел 4), наращивает возможности за счет обогащения связей между агентами, переходя от агента с одним расширенным инструментом к многоагентным командам, основанным на ролях, и, наконец, к явным топологиям оркестрации — уровню, на котором становится возможным разделение труда в стиле онкологического консилиума. Вторая ось, масштабирование возможностей (раздел 5), наращивает возможности за счет углубления когнитивного цикла вокруг основы фиксированного размера, и наше центральное утверждение здесь заключается в том, что компетентность в большей степени зависит от проектирования цикла восприятия, рассуждения, планирования, действия и рефлексии, чем от количества параметров. Третья ось, масштабирование среды (раздел 6), наращивает возможности за счет расширения самой , и это та ось, которую мы выдвигаем на первый план, поскольку медицинские агенты уже существуют в необычайно богатых инструментами клинических экосистемах, поэтому подключение новой специализированной модели, архива или FHIR эндпоинта зачастую дает больше готовности на единицу усилий, чем очередной раунд дообучения [62, 97, 93]. Важно отметить, что масштабирование среды реализуется постепенно с течением времени через лестницу адаптации из раздела 6, от промптинга через проверяемое вознаграждение к self play, конечной целью которого является саморазвивающийся агент, постоянно расширяющий свою собственную на месте. Мы намеренно отличаем этот каркас от двух традиционных законов масштабирования, которые он дополняет, а именно масштабирования параметров и масштабирования вычислительных мощностей во время тестирования, каждый из которых воздействует на отдельного агента изолированно, и ни один из которых не учитывает структурные и средовые рычаги, определяющие агентную систему в реалистичных клинических условиях..
3 Клинические сценарии в реальной среде, бенчмарки и среды обучения
Мы начинаем техническую часть этого обзора с конечной цели развертывания, а не с внутренних механизмов агента, поскольку главный вопрос для медицинских агентов заключается не в наличии модуля функциональных возможностей, а в том, выживет ли собранная система при контакте с реальной клинической средой [105, 211, 277]. Эта инверсия преднамеренна. Реальная среда накладывает ограничения, которые никогда не выявляются статическими метриками точности: многоходовое взаимодействие с пациентами и лечащими врачами, частичные и потоковые наблюдения из PACS и EHR, бюджеты на задержки и затраты, распределительный дрейф между площадками и сканерами, а также требование проверяемости каждого действия [14, 8, 78]. Поэтому мы структурируем этот раздел вокруг трех концентрических уровней, которые агент должен пройти на пути к развертыванию, а именно: сценарии, в которых он должен действовать, бенчмарки, измеряющие правильность его действий, и среды обучения (клинические тренажеры и симуляторы), в которых он может практиковаться и совершенствоваться, прежде чем взаимодействовать с пациентом. Важно отметить, что эти три уровня являются не заключительным приложением к каталогу возможностей, а каркасом, на основе которого читается остальная часть обзора: архитектура, когнитивные способности и обучение существуют для того, чтобы сократить разрыв между агентом и средой, определенной здесь..
3.1 Клинические сценарии в реальной среде
Полезная таксономия сценариев медицинских агентов организована по степени их интеграции в реальный клинический цикл, а не по анатомической специализации [211, 277, 105]. На одном полюсе находятся консультативные сценарии с однократным запросом, в которых агент отвечает на ограниченный вопрос по визуализации (визуальный вопрос, классификация находки, черновик предложения отчета), при этом врач полностью контролирует процесс [123, 87]. Средний сегмент включает интерактивные многоходовые сценарии, где агент должен запрашивать дополнительные проекции, обращаться к предыдущим исследованиям, устранять противоречивые данные и объяснять свои рассуждения в течение нескольких итераций, что отражает реальную работу радиолога или мультидисциплинарной команды [211, 5, 65]. На другом полюсе находятся потоковые сценарии рабочих процессов, в которых агент участвует в непрерывно функционирующем больничном процессе: сортировка в реальном времени и изменение приоритетности списков задач при выявлении критических находок, таких как тромбоэмболия легочной артерии или внутричерепное кровоизлияние [114], продольное наблюдение по временным точкам визуализации [293, 232], а также сквозные конвейеры от отчета до назначения в рамках FHIR [105, 222]. Определяющим свойством сценариев, расположенных справа, и причиной, по которой они недостаточно охвачены традиционными бенчмарками, является то, что среда меняется в ответ на действия самого агента, поэтому правильность является свойством траектории взаимодействия, а не отдельного результата. Эта структура с частичной наблюдаемостью и зависимостью от действий — именно то, что призвана отразить наша формулировка в разделе 2, и она определяет требования, которым должны соответствовать архитектуры (раздел 4), возможности (раздел 5) и режимы обучения (раздел 6).
| Year | Benchmark | Key Contribution | Venue | Paper | Data/Code |
| Level 1: Isolated Single Capabilities | |||||
| 2018 | VQA-RAD [123] | Clinician generated naturalistic radiology visual question answering | Sci. Data | Paper |
 Data |
| 2019 | PubMedQA [108] | Biomedical yes no maybe reasoning over abstracts | EMNLP 2019 | Paper |
Data
|
| 2020 | PathVQA [87] | Pathology VQA, 32K questions over 5K images | arXiv | Paper |
Data
|
| 2021 | MedQA [107] | Free form licensing exam open domain question answering | AAAI 2021 | Paper |
Data
|
| 2021 | SLAKE [143] | Bilingual knowledge enhanced radiology VQA with semantic labels | ISBI 2021 | Paper |
Data
|
| 2022 | MedMCQA [185] | Multisubject entrance exam medical multiple choice QA | CHIL 2022 | Paper |
Data
|
| 2022 | MS-CXR [18] | Radiologist phrase grounding boxes for chest radiographs | ECCV 2022 | Paper | Data |
| 2023 | ReXVal [291] | Radiologist error annotations for report evaluation | Patterns | Paper | Data |
| 2024 | CheXbench [38] | Chest X-ray perception and report understanding, 8 tasks | arXiv | Paper | Code |
| 2024 | OmniMedVQA [96] | Large scale medical VQA, 118K images, 12 modalities | CVPR 2024 | Paper |
Data
|
| 2024 | MedSafetyBench [84] | Medical safety benchmark, 1,800 harmful request demonstrations | NeurIPS 2024 | Paper | Code |
| 2024 | CARES [267] | Med LVLM trustworthiness across five reliability dimensions | NeurIPS 2024 | Paper | Code |
| 2024 | ClinicalBench [26] | Tests whether LLMs surpass classical clinical prediction models | arXiv | Paper | Code |
| 2025 | MedXpertQA [327] | Expert level reasoning, 4,460 text and multimodal questions | ICML 2025 | Paper |
Data
|
| 2025 | MedHallu [190] | First medical hallucination detection benchmark, 10K pairs | arXiv | Paper |
Data
|
| 2025 | HealthBench [8] | Physician rubric graded multiturn health conversations, 5K cases | arXiv | Paper |
Data
|
| 2025 | MedReason [262] | KG-grounded medical reasoning chains, 32K QA | arXiv | Paper | Code |
| 2025 | GEMeX [144] | Grounded, explainable chest X-ray VQA (1.6M questions) | ICCV 2025 | Paper |
Data
|
| 2026 | RADAR [234] | Multimodal 3D image based radiology report discrepancy review | arXiv | Paper | – |
| Level 2: Tool Augmented and Interactive Agency | |||||
| 2024 | AgentClinic [211] | Multimodal multiagent simulated clinical encounters with tools | ICLR 2025 | Paper | Code |
| 2024 | MedCalc-Bench [113] | Benchmarks LLMs on clinical calculator medical computation | NeurIPS 2024 | Paper |
Data
|
| 2024 | EHRNoteQA [120] | 962 QA pairs over MIMIC-IV discharge summaries, 8 clinical topics | NeurIPS 2024 | Paper | Data |
| 2025 | MedAgentBench [105] | FHIR compliant virtual EHR, 300 clinician authored agentic tasks | arXiv | Paper | Code |
| 2025 | MedR-Bench [199] | 1,453 real cases quantifying medical reasoning quality | Nat. Commun. | Paper | Code |
| 2025 | MedAgentsBench [239] | Hard multistep clinical reasoning for thinking models | arXiv | Paper |
Data
|
| 2025 | 3MDBench [236] | Multimodal multiagent doctor patient dialogue, 34 diagnoses | arXiv | Paper |
Data
|
| 2025 | MedAgentBoard [321] | Multiagent versus single LLM across four clinical tasks | NeurIPS 2025 | Paper | Code |
| 2025 | MedBrowseComp [33] | First multihop medical web browsing agent benchmark | arXiv | Paper |
Data
|
| 2025 | BFCL [191] | Live executable benchmark for function and tool calling | ICML 2025 | Paper |
Data
|
| 2025 | MedOdyssey [59] | Medical long context benchmark up to 200K tokens, 7 length levels | NAACL 2025 | Paper | Code |
| 2025 | LongHealth [2] | 400 questions over 20 long fictional patient clinical documents | J. Healthc. Inform. Res. | Paper | Code |
| 2025 | R2MED [308] | Reasoning-based medical retrieval benchmark (876 queries, 3 tasks) | arXiv | Paper | Code |
| 2025 | CURE-Bench [40] | Therapeutic agent reasoning evaluation | arXiv | Paper | Code |
| 2025 | MedAgentSim [5] | Self-evolving multi-agent clinical simulation with dialogue | MICCAI 2025 | Paper | Code |
| 2025 | PatientSim [121] | Persona driven patient simulator, 37 personas from MIMIC-IV | NeurIPS 2025 | Paper | Code |
| 2026 | MedDialogRubrics [75] | Multiturn diagnostic consultation, 5,200 cases, 60K+ rubrics | arXiv | Paper | – |
| 2026 | AgentRx [110] | Single vs multi-agent LLMs for multimodal clinical prediction | arXiv | Paper | – |
| 2026 | ABRA [165] | Radiology agent with OHIF/Orthanc, 21 tools, 655 tasks | arXiv | Paper | Code |
| 2026 | AutoMedBench [148] | Workflow aware benchmark for autonomous medical AI research, five stage agentic pipeline over imaging and multimodal tasks | arXiv | Paper | Code |
| 2026 | DeepMed [253] | Medical deep research agent via multi-hop med-search, turn-controlled training | ACL 2026 Findings | Paper | – |
| 2026 | MedResearchBench [237] | AI research agents on clinical medical research, multi-domain tasks | medRxiv | Paper | – |
| 2026 | EHRBench [272] | Automated EHR grounded clinical decision making benchmark | arXiv | Paper | – |
| Level 3: System Level Clinical Operation | |||||
| 2024 | EHRAgent [222] | Code empowered agent for multitabular EHR reasoning | EMNLP 2024 | Paper | Code |
| 2025 | ClinicalLab [277] | Multidepartmental benchmark, 24 departments, 150 diseases | NeurIPS 2025 | Paper | Code |
| 2025 | MedChain [147] | Sequential clinical workflow benchmark, 12K cases, five stages | NeurIPS 2025 | Paper | Code |
| 2025 | MedHELM [14] | Holistic medical LLM eval, 121 clinician validated tasks | arXiv | Paper | Code |
| 2025 | MedAgentGym [274] | Code based medical reasoning training env, 72K tasks | arXiv | Paper | Code |
| 2025 | FHIR-AgentBench† [124] | Agents on 2,931 HL7 FHIR interoperable EHR tasks | arXiv | Paper | Code |
| 2025 | MedAgentAudit [78] | Audits collaborative failure modes in medical multiagent system s | arXiv | Paper | Code |
| 2026 | MedOpenClaw [217] | Auditable full study agents over uncurated clinical imaging | arXiv | Paper | – |
| 2026 | MedFlowBench [219] | Full-study VLM benchmark for imaging viewers (3D Slicer, QuPath) and radiology/pathology workflows | arXiv | Paper | – |
| 2026 | PhysicianBench [151] | Agents in real EHR, long-horizon tasks, 670 grounded checkpoints | arXiv | Paper | Code |
| 2026 | CHI-Bench† [27] | End to end long horizon policy rich healthcare workflow automation | arXiv | Paper | Code |
| 2026 | MedCase-Structured† [178] | Text-to-FHIR dataset for reasoning in realistic structured EHR | ICML 2026 WS | Paper |
Data
|
| 2026 | ClinEnv [158] | Interactive long-horizon inpatient EHR simulation | arXiv | Paper | – |
| 2026 | HealthAdminBench [15] | Computer-use agents on 135 healthcare administration tasks, 4 GUIs | arXiv | Paper | Code |
| 2026 | HealthAgentBench [150] | 54 agentic healthcare tasks, 7 environments across patient journey | arXiv | Paper | Code |
| 2026 | EHR-Complex [197] | Interactive clinical database reasoning on MIMIC-IV, 52K tasks | arXiv | Paper | – |
3.2 Бенчмарки для оценки готовности к реальным условиям эксплуатации
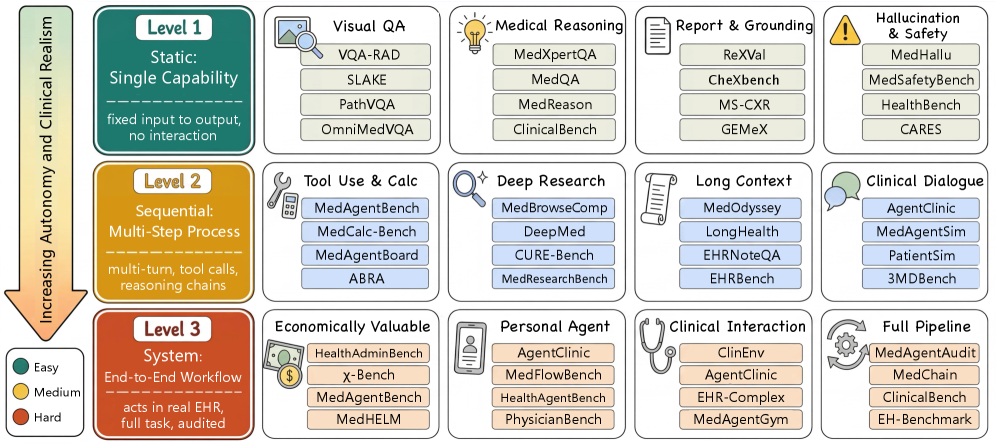
Чтобы оценить, насколько медицинские агенты близки к внедрению, мы систематизируем существующие бенчмарки по шкале возрастающей автономности и клинического реализма, охватывающей три уровня: от изолированных отдельных возможностей через агентное поведение с использованием инструментов и диалоговое взаимодействие до полноценной клинической работы на системном уровне, как показано на рис. 3 и подробно описано в табл. 1. Эта иерархия важна, поскольку модель, демонстрирующая высокие результаты в статическом тесте на восприятие, может оказаться неработоспособной, как только ей потребуется вызывать инструменты, хранить длинные записи или завершать многоходовой клинический цикл, поэтому готовность следует оценивать уровень за уровнем, а не по какому-либо единому совокупному баллу, а быстрое появление бенчмарков 2026 года для верхних уровней показывает, что область активно переносит фокус измерений с изолированной компетентности на устойчивую клиническую работу..
На Уровне 1 основное внимание уделяется тому, осваивает ли модель изолированную компетентность при работе с чистыми входными данными. Визуальное понимание проверяется с помощью VQA-RAD [123], SLAKE [143], PathVQA [87] и OmniMedVQA [96], которые в совокупности охватывают радиологию, патологию и кросс-модальные ответы на вопросы. Рассуждения, основанные на знаниях, измеряются с помощью MedXpertQA [327], MedQA [107], MedReason [262] и ClinicalBench [26], варьирующихся от экзаменов лицензионного типа до цепочек рассуждений, основанных на графах знаний, и прямой проверки того, могут ли LLM конкурировать с классическими моделями клинического прогнозирования. Качество отчетов и визуальное обоснование оцениваются с помощью ReXVal [291], CheXbench [38], MS-CXR [18] и GEMeX [144], которые переводят оценку с поверхностного совпадения на оценку ошибок, проводимую рентгенологами, привязку рамок на уровне фраз, а также крупномасштабные обоснованные и объяснимые ответы на вопросы по рентгенографии грудной клетки, а недавний RADAR [234] продвигает это еще дальше, сопоставляя 3D-исследование с предварительным отчетом и предлагаемыми правками, чтобы модель оценивалась по тому, может ли она выявить подлинные расхождения в отчете, а не просто описать изображение. Важно отметить, что здесь подчеркивается надежность с помощью MedHallu [190], MedSafetyBench [84], сегмента безопасности HealthBench [8] и CARES [267], поскольку галлюцинируемая находка в клинической практике опаснее, чем пропущенная..
Уровень 2 повышает планку от простого знания к действию, задаваясь вопросом, может ли агент использовать внешние инструменты, искать доказательства, поддерживать длинный контекст и вести клинический диалог. Использование инструментов и количественная компетентность оцениваются с помощью MedAgentBench [105], MedCalc-Bench [113], MedAgentBoard [321] и бенчмарка общего назначения BFCL [191], которые показывают, может ли модель вызывать калькуляторы и структурированные API вместо того, чтобы угадывать, в то время как бенчмарк ABRA 2026 года [165] делает это конкретным для визуализации, управляя средством просмотра OHIF и сервером Orthanc DICOM с помощью двадцати одного инструмента вызова функций. Поиск доказательств и синтез на исследовательском уровне фиксируются в MedBrowseComp [33], DeepMed [253], MedResearchBench [237] и бенчмарке поиска на основе рассуждений R2MED [308], которые проверяют, может ли агент находить, фильтровать и синтезировать клинические доказательства в условиях реалистичного шума в сети и литературе, а также выполнять комплексные задачи медицинских исследований. Точность длинного контекста, необходимая для чтения всей истории болезни пациента, проверяется с помощью специализированных медицинских тестов MedOdyssey [59], LongHealth [2], EHRNoteQA [120] и EHRBench [272], которые выявляют резкое снижение качества, как только агенту приходится рассуждать на основе полных выписок и продольных записей, а не коротких фрагментов. Интерактивная клиническая компетентность затем измеряется с помощью AgentClinic [211], саморазвивающейся симуляции MedAgentSim [5], симулятора на основе персон PatientSim [121] и 3MDBench [236], а набор MedDialogRubrics 2026 года [75] уточняет эту оценку с помощью 5 200 случаев пациентов и более шестидесяти тысяч детализированных рубрик, благодаря чему многоходовой диагностический диалог оценивается по явным клиническим критериям, а не по единственному эталонному ответу..
Уровень 3 нацелен на реализм системного уровня, задаваясь вопросом, может ли агент работать автономно в хаотичной среде реальных клинических и экономических рабочих процессов. Экономически ценная, ориентированная на внедрение функциональность количественно оценивается с помощью HealthAdminBench [15], богатого долгосрочными стратегиями -Bench [27], совместимого с FHIR MedAgentBench [105] и комплексного MedHELM [14], которые связывают базовые возможности с административной, экономической и подтвержденной клиницистами полезностью. Персональная и продольная агентность подчеркивается в AgentClinic [211], бенчмарке полного цикла визуализации исследований MedFlowBench [219], унифицированном агентном наборе для здравоохранения HealthAgentBench [150] и PhysicianBench [151], которые обосновывают долгосрочные задачи в реальных системах с помощью проверенных контрольных точек выполнения. Клиническое взаимодействие по замкнутому циклу с «живыми» записями и «песочницами» измеряется с помощью ClinEnv [158], AgentClinic [211], интерактивного бенчмарка баз данных EHR-Complex [197] и среды обучения на основе кода MedAgentGym [274], в которой агент должен консультироваться с субагентами, запрашивать большие клинические базы данных и выполнять SQL или Python на основе MIMIC-IV. Работа полного конвейера и аудит на протяжении всего приема пациента оцениваются с помощью MedAgentAudit [78], пятиэтапного последовательного рабочего процесса MedChain [147], ClinicalBench [26] и ориентированного на офтальмологические галлюцинации EH-Benchmark [189], которые исследуют прослеживаемое поведение и распространение ошибок при поэтапном принятии клинических решений. Постоянный и увеличивающийся разрыв между Уровнем 1 и Уровнем 3, ставший более заметным благодаря долгосрочным бенчмаркам 2026 года, указывает на то, что текущие системы остаются компетентными в восприятии, но незрелыми в управлении, что обосновывает многоосевую оценку, которую мы разрабатываем далее..
3.3 Метрики оценки, выходящие за рамки точности
Постоянный разрыв между показателями в таблицах лидеров и доверием у постели больного заключается в том, что большинство бенчмарков для медицинских агентов по-прежнему сводят производительность к единой оценке точности или полного совпадения, тогда как реальные сбои при внедрении редко выглядят просто как неверный итоговый ответ. Поэтому мы организуем оценку по пяти взаимодополняющим осям, которые в совокупности характеризуют готовность агента к реальным условиям. Первая ось — это качество рассуждений, которое требует ответа не только на вопрос, верен ли вывод, но и на то, является ли промежуточная траектория достоверной, обоснованной и свободной от необоснованных скачков. Недавние работы, в которых пошагово проверяются цепочки рассуждений, показывают, что правильность итогового ответа регулярно соседствует с логически нарушенными или галлюцинированными промежуточными шагами, поэтому достоверная траектория должна оцениваться как первостепенная величина, а не предполагаться на основе результата [126]. В клинических условиях это имеет острое значение, поскольку отчет, который приходит к правдоподобному заключению через неподтвержденное наблюдение, опаснее, чем очевидно неверный, и такие метрики, как фактическое следование из извлеченных данных [183, 99] и экспертная оценка ошибок [291], были введены именно для выявления этого режима сбоев..
Вторая ось — это эффективность, которая отражает затраты на получение ответа в виде вызовов инструментов, токенов, времени ожидания и денежных расходов. Поскольку агентам разрешено дольше размышлять и вызывать больше инструментов, точность и стоимость перестают коррелировать: тщательное изучение того, как распределять вычислительные ресурсы во время выполнения агента, показывает, что наивное увеличение количества шагов дает убывающую, а иногда и отрицательную отдачу, как только избыточные вызовы инструментов и повторяющаяся самопроверка начинают преобладать [320]. Таким образом, метрика развертывания отражает точность при фиксированном бюджете и предельную точность на один вызов инструмента, а не неконтролируемый потолок. Третья ось — это надежность, означающая стабильность при изменении распределения, состязательных или зашумленных входных данных и отсутствии контекста, что делают измеримым межцентровые и стрессовые ориентированные бенчмарки [267, 96]. Четвертая ось — это пользовательский опыт, охватывающий способность агента задавать уточняющие вопросы, откладывать решение при неуверенности и сообщать о калиброванной степени уверенности — свойства, которые симуляционные и интерактивные бенчмарки выявляют гораздо лучше, чем статические QA [211, 236]. Пятая ось — это безопасность, которая охватывает отказ от выполнения небезопасных запросов, уровень галлюцинаций и предотвращение вреда, что количественно оценивается с помощью специализированных наборов тестов на безопасность и галлюцинации [84, 190, 8]. Совместное представление всех пяти осей, а не просто показателя точности, — это то, что превращает результат бенчмарка в доказательство клинической готовности.
3.4 Среды обучения и клинические тренажеры
Одной лишь оценки недостаточно для создания способных агентов, и траектория развития агентов общего назначения предполагает, что ограничивающим фактором является наличие насыщенных интерактивных сред обучения, а не сам по себе масштаб модели. В общей области переход от данных с однократным взаимодействием, полученных методом SFT, к крупномасштабному интерактивному обучению с подкреплением стал возможен благодаря фреймворкам, которые запускают множество одновременных, многоходовых и многозадачных сценариев и стабилизируют обучение в гетерогенных средах [301], что является именно тем рецептом, который позволяет агентам перейти от имитации демонстраций к самостоятельному поиску стратегий восстановления при совершении собственных ошибок. Эта общая тенденция мотивирует создание клинического аналога — среды обучения, в которой медицинский агент может действовать, наблюдать за последствиями и получать вознаграждение, вместо того чтобы оцениваться только по фиксированному тестовому набору..
Клинический аналог начинает обретать форму по трем направлениям. Первое направление перепрофилирует существующие инструменты и бенчмарки выполнения задач в качестве тренировочных сред, превращая их проверяемые сигналы успеха в плотные вознаграждения для оптимизации стратегии, как это наблюдается в медицинских комплексах для обучения агентов, которые предоставляют запросы к EHR, калькуляторы и поиск в качестве инструментов для выполнения действий [274, 222, 113]. Второе направление создает высокоточные симуляционные среды, в которых LLM играет роль пациента, коллеги или последующей системы, чтобы агент мог обучаться на полноценных диагностических диалогах и многоэтапных обследованиях без обращения к защищенным данным [211, 236, 277]. Третье направление подключает агентов к реалистичной клинической инфраструктуре, такой как стандартизированные интерфейсы записей и системы заказов, что одновременно повышает предел того, что может быть отработано на практике, и заставляет агента соблюдать ограничения реальных рабочих процессов [105, 124]. В совокупности эти усилия указывают на то, что область смещается от статического медицинского QA в сторону клинических сред с замкнутым циклом, и что агенты, которые докажут свою готовность к реальному миру, будут теми, кто прошел обучение в средах, имитирующих этот мир..
4 Масштабирование агентных фреймворков: от инструментов к топологиям
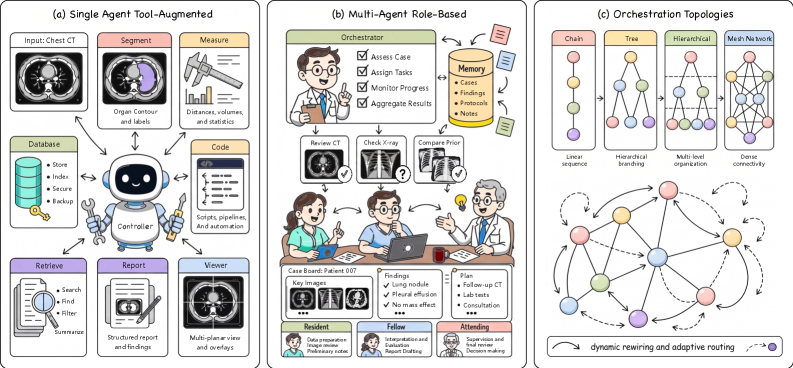
Мы организуем это пространство проектирования вдоль одной оси, где определяется координация, то есть кто выбирает следующее действие и как этот выбор распределяется между одним или несколькими процессами рассуждения. Возникают три стадии в порядке возрастания структурной сложности: контроллер с расширенным набором инструментов для одного агента, команда на основе ролей из нескольких агентов и явная топология оркестрации, в которой сам граф взаимодействия становится объектом оптимизации [322]. Два дополнительных выбора пересекают все три стадии, и их лучше рассматривать как ортогональные измерения, а не как отдельные категории. Первый — это интерфейс действий: действует ли агент посредством дискретных вызовов инструментов или путем генерации исполняемого кода, различие, восходящее к рассуждениям с помощью программ PAL [69] и обучению инструментам Toolformer [210]. Второй — это адаптивность: является ли система статической при развертывании или она пересматривает свое поведение, промпты, память или структуру с течением времени. Рис. 4 обобщает три стадии вместе с этими двумя сквозными выборами, которые мы используем для сопоставления систем медицинской визуализации с их предшественниками общего назначения..
4.1 Одиночный агент с расширенным инструментарием
Самая простая и до сих пор доминирующая архитектура объединяет единую мультимодальную основу с набором специализированных инструментов, благодаря чему вся координация происходит внутри одного цикла рассуждений. Этот шаблон представляет собой чередование рассуждений и действий в ReAct [285], где модель переключается между мыслью, вызовом инструмента и наблюдением, дополненное цепочкой рассуждений [258], декомпозицией от простого к сложному [313] и вербальной самокоррекцией в Reflexion [224]. В визуальной области этот же цикл реализуется либо через маршрутизацию инструментов, как в HuggingGPT [220] и MM-ReAct [282], либо через синтез программ на основе визуальных примитивов, как в ViperGPT [235] и VisProg [81], которые уже предвосхищают использование кода в качестве интерфейса действий, описанного ниже. Медицинские реализации адаптируют этот шаблон для клинического восприятия и измерений. CheXagent [38] связывает vision language основу с анализом рентгенограмм грудной клетки, MedRAX [57] оснащает единый контроллер инструментами сегментации, детекции и привязки отчетов, MMedAgent [129] обучается выбирать среди гетерогенных медицинских инструментов, а CXR-Agent и связанные с ним контроллеры добавляют поиск и верификацию на уровне отчетов [156, 163, 62]. Такая архитектура остается конкурентоспособной, поскольку использование одного агента позволяет избежать накладных расходов на коммуникацию и распространения ошибок, характерных для многостороннего обсуждения, поэтому, когда набор инструментов уже охватывает клинические подзадачи, тесный цикл восприятия, измерения и составления отчетов является одновременно точным и проверяемым..
Интерфейс действий является наиболее значимым вариантом на данном этапе. Вместо выдачи вызова инструмента с фиксированной схемой, агент может писать и исполнять код, что позволяет ему создавать непредвиденные операции, манипулировать промежуточными тензорами и взаимодействовать с реальными программными средами. EHRAgent демонстрирует код как действие над структурированными клиническими записями [222], MedOpenCLAW управляет реальной средой 3D Slicer, чтобы агент работал с тем же программным обеспечением, что и радиолог [217], а усилия по масштабированию среды создают исполняемые клинические «песочницы», в которых такие агенты могут проходить обучение и стресс-тестирование [230, 48]. Мотивацией является выразительность при частичном покрытии инструментами, поскольку исполняемый код превращает закрытое меню инструментов в открытое пространство действий ценой необходимости использования «песочниц» и верификации. Этот сдвиг также обеспечивает улучшение самого агента в стиле обучения с подкреплением, как в случае с обучением на основе вознаграждения, ориентированным на разработку программного обеспечения [259], и радиологическим контроллером RadAgent [204], что указывает на измерение адаптивности, к которому мы вернемся позже..
4.2 Многоагентная ролевая модель
Когда задача охватывает несколько специальностей или требует явной перекрестной проверки, одиночный цикл становится «узким местом», и координация переносится на команду агентов, специализирующихся на определенных ролях. Два прецедента обосновывают эту мотивацию. Программные команды, основанные на ролях, такие как MetaGPT, кодируют стандартные операционные процедуры, чтобы специализация снижала количество ошибок [90], в то время как исследования масштабируемости показывают, что добавление агентов помогает только тогда, когда их взаимодействие хорошо структурировано, а не просто многочисленно [80, 194]. Медицина принимает эту парадигму, поскольку она отражает работу онкологического консилиума или кабинета лучевой диагностики, где ординатор, аспирант и лечащий врач вносят свой вклад в соответствии с уровнем компетенции, а консенсус достигается путем переговоров. MDAgents адаптивно решает, требует ли запрос одиночного ответа или полноценной экспертной группы [115], MedAgents и MDTeamGPT структурируют многоролевое диагностическое обсуждение [238, 30], а M3Builder и MARCH расширяют ролевую декомпозицию до построения рабочих процессов визуализации и мультимодальных рассуждений [63, 142]. Обоснованием служит взвешенное обсуждение, поскольку распределение процесса постановки диагноза по ролям делает разногласия явными и подлежащими проверке, что с клинической точки зрения важнее, чем общая пропускная способность..
Две практические проблемы определяют этот этап. Первая — надежность, поскольку большее количество агентов порождает больше режимов отказа, а недавние бенчмарки предупреждают, что преимущества мультиагентных систем неравномерны и иногда иллюзорны, если учитывать стоимость и согласованность [321, 55, 67]. Вторая — постоянная память, поскольку клиническая команда накапливает общий контекст как в рамках одного случая, так и между разными случаями, что обосновывает необходимость структурированной меж-агентной памяти, такой как G-Memory [300] и продольные медицинские записи агентов [72, 116]. Память также является естественной точкой входа для адаптивности на уровне команды, поскольку пересмотр того, что сохраняется и извлекается, позволяет фиксированному набору ролей совершенствоваться без изменения их внутренней структуры, связывая этот этап с системами самокоррекции, описанными ниже..
4.3 Топологии оркестрации
Третий этап делает саму структуру взаимодействия первостепенной проектной переменной. Вместо априорной фиксации цепочки, звезды или дебатов, коммуникационный граф между агентами и инструментами ищется, изучается и непрерывно перестраивается во время выполнения, что включает в себя предыдущие этапы как частные случаи единой, более общей формулировки. Линия топологии рассуждений от цепочек [258] к деревьям [286] и графам мыслей [16] уже показала в рамках одного агента, что форма обдумывания, а не только его содержание, определяет производительность, а оркестровка обобщает это понимание с одного рассуждающего на целые популяции агентов. GPTSwarm представляет мультиагентную систему как оптимизируемый граф, ребра которого настраиваются под задачу [323], DyLAN активирует и отсекает агентов в соответствии с их вкладом [155], а агентная суперсеть MaAS распределяет топологию и вычислительные ресурсы в зависимости от сложности запроса, чтобы простые случаи оставались дешевыми, а сложные привлекали больше структуры [299]. Помимо выбора из фиксированного пространства, недавние работы генерируют топологии «на лету» посредством диффузии графов по структурам-кандидатам [104], а обзоры определяют эту область как решительный переход от статических шаблонов к динамическим графам времени выполнения [294, 119]. Мотивацией служит адаптивное распределение сложности, поскольку клиническое внедрение сталкивается с «длинным хвостом» случаев, требуемая глубина рассуждений для которых варьируется на порядки, и единая фиксированная топология должна либо избыточно тратить ресурсы на простое большинство, либо недостаточно обслуживать сложное меньшинство..
На этом этапе адаптивность также становится структурной, а не параметрической. Система, которая перестраивает свой собственный граф, привлекает новые роли или выводит из эксплуатации неэффективные, фактически редактирует собственную архитектуру — это наиболее сильная форма саморазвивающегося поведения, предварительно рассмотренная ранее через самосовершенствование на уровне кода и пересмотр на уровне памяти. Работа над эволюционирующими популяциями агентов и самоорганизующимися коллективами делает это явным [58, 132], и мы рассматриваем это как естественную конечную точку оси координации, поскольку, как только вопрос о том, где принимается решение о координации, делегируется самой системе, граница между использованием агента и его проектированием стирается. Для медицинской визуализации это палка о двух концах, поскольку динамическая структура обещает эффективность и надежность при гетерогенных рабочих нагрузках, но усложняет проверяемость и воспроизводимость, которые требуются для безопасного развертывания, — напряженность, к которой мы вернемся в разделах оценки и управления..
{лес}
5 Масштабирование возможностей: когнитивный цикл на основе управления ⟦K0⟧
Медицинский агент определяется не столько какой-то одной способностью, сколько тем, как его способности циклически взаимодействуют вокруг пациента. Радиолог не просто обнаруживает поражение, рассуждает о нем, назначает повторное обследование и анализирует отчет как четыре разрозненных действия; эти этапы образуют единый непрерывный цикл, и клинически полезный агент должен воспроизводить этот цикл, а не представлять собой набор изолированных навыков. Поэтому мы структурируем этот раздел в три уровня. Сначала мы представляем шесть когнитивных модулей, которые реализуют интеллект, восприятие, рассуждение, планирование, память, использование инструментов и рефлексию агента, каждый из которых пересматривается на каждом шаге, чтобы однажды обнаруженная находка оставалась стабильным ориентиром для последующих решений. Затем мы формализуем среду выполнения, проектирование циклов, которая связывает эти модули в автономный цикл исполнения, поскольку недавние агентные системы неоднократно показывают, что именно проектирование цикла, а не масштаб базовой модели, определяет, будет ли клиническая задача фактически завершена [279, 106]. Наконец, мы показываем, как циклы, накапливающие опыт работы с разными пациентами, приводят к созданию саморазвивающихся систем, превращая статический диагностический конвейер в тот, который продолжает совершенствоваться по мере увеличения числа пациентов. Рис. 5 систематизирует литературу именно по этим трем уровням..
5.1 Восприятие
Восприятие является точкой входа, где необработанные сигналы визуализации кодируются в семантические представления, которые может использовать логический вывод, и в медицине оно должно объединять глубоко гетерогенные модальности, поскольку один случай может сочетать рентгенограмму грудной клетки, полнокадровое патоморфологическое изображение и текстовые заключения в рамках одного решения. Энкодеры, настроенные на медицинскую область, а не заимствованные целиком из естественных изображений, являются здесь практической основой, будь то посредством контрастного предварительного обучения «изображение-текст» на биомедицинских корпусах [305], самообучающихся радиографических архитектур, которые изучают анатомию без разметок [192], специфических для патологии представлений, дистиллированных из гистопатологии в больших масштабах [157], или радиологических vision-language models, которые выравнивают изображения со структурированными отчетами [44]. Мультимодальные клинические бенчмарки показывают, насколько хрупкими становятся агенты, когда восприятие не может обосновать эти сигналы в общем представлении [211], поэтому вопрос проектирования заключается не только в том, насколько точно находка обнаруживается один раз, но и в том, насколько стабильно сохраняется ее представление по мере того, как агент собирает больше данных, чтобы последующие рассуждения и рефлексия опирались на согласованный семантический якорь для одного и того же поражения, а не на представление, которое смещается в процессе итераций.
5.2 Рассуждение
Рассуждение преобразует обоснованные восприятия в логику принятия клинических решений, и его качество зависит от структуры, наложенной на вывод, а не от изолированных цепочек мыслей. Самостоятельно формируемые структуры рассуждений позволяют агенту собирать каркас вывода, наиболее подходящий для конкретного случая [314], и в медицине эта структура часто распределена между взаимодействующими ролями, где адаптивный ансамбль специализированных агентов проводит обсуждение перед тем, как прийти к дифференциальному диагнозу [115]. Важно отметить, что клинический вывод никогда не является окончательным, поскольку каждая диагностическая гипотеза — это предварительное обязательство, которое действие и рефлексия могут позже опровергнуть, как только поступит новая последовательность или противоречивые лабораторные данные, поэтому мы рассматриваем рассуждение как повторяющийся шаг, а не как однократный прямой проход..
5.3 Планирование
Планирование декомпозирует клиническую цель на упорядоченную последовательность допустимых действий, таких как выбор предыдущего исследования для извлечения, выбор измерения для вычисления и выбор руководства для консультации, и его эффективность неотделима от каркаса, который управляет исполнением. Структурированные по ролям фреймворки экстернализируют план как явный артефакт, который взаимодействующие агенты могут изучать и уточнять [90], в то время как переиспользуемая память рабочих процессов позволяет агенту абстрагировать повторяющиеся процедуры визуализации в шаблоны планов, которые ускоряют будущие эпизоды [256]. Поскольку планирование предшествует использованию инструментов, план хорош лишь настолько, насколько хороша способность обнаруживать момент, когда выполненный шаг отклоняется от своего намерения, поэтому планирование и рефлексия остаются связанными через один и тот же поток управления, а не действуют как независимые этапы..
5.4 Память
Память является каналом обратной записи агента, местом, где сохраняется и извлекается как кратковременный контекст текущего взаимодействия, так и накопленный опыт прошлых клинических случаев. Краткосрочный контекст должен активно управляться, чтобы длительное обследование с помощью визуализации не переполняло окно модели, что обосновывает использование подкачки контекста в активный буфер и обратно в стиле операционных систем [184]. Долгосрочная память накапливается на протяжении эпизодов, будь то в виде примеров траекторий, которые подготавливают будущее управление при схожих исследованиях [311], или в виде дистиллированных абстракций рабочих процессов, которые сжимают прошлые решения в пригодную для повторного использования форму [256]. Определяющим свойством здесь является направленность, поскольку рефлексия откладывает то, на что впоследствии будут опираться восприятие и рассуждение, замыкая цикл во времени и между пациентами, а не только в рамках одного обращения..
5.5 Использование инструментов
Использование инструментов является исполнительным механизмом, точкой, в которой агент выходит за пределы своих параметров для вызова утилит визуализации, служб поиска и баз клинических знаний, а его надежность в первую очередь зависит от интерфейса, поскольку стандартизированные протоколы, такие как Model Context Protocol, отделяют агента от особенностей каждой внешней службы [93]. Выражение действий в виде исполняемого кода, а не жестких вызовов функций, дополнительно расширяет пространство действий и естественным образом сочетается с потоком управления, который требует многоэтапное обследование [250]. Помимо использования фиксированного набора инструментов, способные агенты создают и курируют свои собственные, формируя проверяемые наборы инструментов на основе опыта [252] и синтезируя новые инструменты по требованию для отделения абстрактного мышления от конкретного [195], благодаря чему сам исполнительный механизм развивается вместе с клинической компетентностью агента.
5.6 Действие и рефлексия
Действие и рефлексия оценивают каждый выполненный шаг и возвращают вердикт в восприятие, память и каркас, и именно эта обратная запись отличает саморазвивающегося медицинского агента от статического диагностического конвейера. Эмпирические обучающиеся системы дистиллируют успехи и неудачи в переносимые инсайты, которые смещают последующие эпизоды [309], а более широкая парадигма саморазвития определяет этот внешний цикл как мост между замороженными базовыми моделями и пожизненными агентными системами [61]. В клинике визуализации последствия ощутимы, поскольку агенты, которые пересматривают свои структуры рассуждений [314] и накапливают проверенные процедуры на основе клинических случаев, превращают субстрат, а не просто веса, в локус роста возможностей, что является свойством, необходимым развернутой системе для постоянного улучшения по мере наблюдения за большим количеством пациентов.
5.7 Проектирование циклов: от пассивных модулей к автономному исполнению
Шесть модулей, описанных выше, обеспечивают необходимые функциональные возможности, но ни один из них не работает самостоятельно. Перцептивный энкодер не решает, когда нужно повторно проанализировать данные; планировщик не знает, когда следует отказаться от неэффективного плана обследования. То, что превращает эти пассивные компоненты в автономного клинического агента, — это среда выполнения, которая управляет ими как единым замкнутым циклом, и мы используем термин «проектирование циклов» для обозначения систематической разработки этой среды. Лучше всего понимать это как специализацию проектирования обвязки — более широкой и совсем недавней практики, отраженной в рабочем определении, согласно которому агент равен модели плюс обвязке, которая ее окружает, где надежность в производственных условиях все больше зависит от обвязки, а не от базовой модели [7, 172]. В недавней формализации обвязка рассматривается как объект из шести компонентов, охватывающий цикл выполнения, реестр инструментов, менеджер контекста, хранилище состояний, хуки жизненного цикла и интерфейс оценки [172], в то время как в дополняющем подходе она декомпозируется на управление, агентность и среду выполнения [86]. Проектирование циклов изолирует цикл выполнения и ставит вопрос о том, как на каждом шаге принимаются новые наблюдения, совершается допустимое действие и результат включается в следующий шаг; в клинических условиях это именно то различие, которое существует между моделью one shot, выдающей единственный ответ, и агентом, который назначает дополнительное исследование, повторно изучает предыдущие данные и пересматривает свое заключение. Ставки конкретны в агентном программировании, где тщательно сформированный интерфейс взаимодействия агента с компьютером определяет успех задачи в большей степени, чем «сырая» мощность модели [279, 106], где представление действия само по себе является проектной переменной, поскольку исполняемые программные действия превосходят текстовые действия в свободной форме [250, 196], и где политика обвязки может быть даже вынесена вовне в виде редактируемого артефакта на естественном языке, а не скрыта в коде контроллера [188], — все эти наблюдения напрямую применимы к тому, как должен быть построен медицинский агент..
Сложность проектирования циклов сводится к трем проектным плоскостям, и клиническая среда доводит каждую из них до предела, с которым редко сталкиваются агенты общего назначения. Первая — это каркас, который фиксирует поток управления, условия остановки и пространство действий; в медицине именно здесь разделение труда в стиле консилиума по опухолям [90] или среда выполнения диалога между несколькими агентами [264] кодируют, кто принимает решение о том, когда обследование может быть завершено. Вторая — это проектирование контекста, которое испытывает нагрузку при единичном визуализационном исследовании в тот момент, когда оно охватывает множество окон с предыдущими данными, лабораторными анализами и руководствами, что обосновывает подкачку в стиле виртуальной памяти [184], развивающиеся контекстные сценарии [304] и более широкую практику, описанную в Mei et al. [171]. Третья — это управление во время выполнения, которое здесь имеет гораздо большее значение, чем в программировании, поскольку неавторизованный вызов инструмента влечет за собой реальные издержки для пациента, и оно реализуется посредством уровней защиты [270] и шлюзования на основе верификации [174]. Среды оркестрации и агентные операционные системы связывают эти плоскости в единую планируемую подложку [170, 251], а Model Context Protocol стандартизирует то, как цикл обращается к инструментам визуализации, службам поиска и записям [93], что является конкретным смыслом того, как возможности масштабируются вместе с обвязкой, а не с каким-либо отдельным модулем [265]⟧.
5.8 От циклов к саморазвивающимся системам
Описанный выше цикл обеспечивает автономное выполнение в рамках одного эпизода, но его совокупная клиническая ценность проявляется только тогда, когда рефлексия консолидирует повторяющееся поведение в устойчивые, извлекаемые процедуры, которые сохраняются дольше, чем любой отдельный случай. Навык в этом смысле — это верифицированная процедура, извлеченная из одного успешного эпизода и упакованная таким образом, чтобы ее можно было выбирать и компоновать в последующих случаях, а не открывать заново каждый раз [297]. Воплощенные агенты с открытым концом демонстрируют этот принцип, создавая расширяющуюся библиотеку повторно используемых навыков на основе взаимодействия [244], а индукция набора инструментов показывает ту же динамику для программных клинических задач, где агент дистиллирует свои собственные рутины в курируемый, вызываемый инвентарь [252]. Этот уровень переносит возможности из лаборатории в палату, поскольку эволюционирующие медицинские агенты, практикующиеся на симулированных случаях, накапливают компетенцию без обновления весов [132], а реалистичные клинические среды все чаще оценивают именно этот вид накопленной компетенции процедурного уровня, а не статичную точность при однократном выполнении, что отражает долгосрочный характер приобретения клинического опыта и непрерывной адаптации рабочего процесса [105]⟧.
При работе со множеством пациентов эти процедуры перестают быть изолированными вспомогательными методами и начинают формировать общий институциональный репертуар, в котором протокол измерений, уточненный на одном консилиуме, или процедура поиска, валидированная на одной когорте, становятся доступными для каждого последующего случая, с которым сталкивается система. Система больше не просто выполняет действия, она эволюционирует: обновляет собственные контекстные сценарии, расширяет инвентарь инструментов, уточняет политики структурирования и сжимает успешные стратегии в повторно используемые абстракции, которые смещают цикл в сторону лучших результатов для ранее не встречавшихся случаев. Именно эта медленная консолидация автономной практики в совокупную компетентность, не ограниченная библиотекой навыков, а охватывающая всю среду выполнения, превращает статический диагностический конвейер в саморазвивающуюся клиническую систему, которая продолжает совершенствоваться по мере наблюдения за большим количеством пациентов, адаптируется к новым сценариям и со временем становится все более надежной..
6 Масштабирование времени обучения: от имитации к автономному обучению
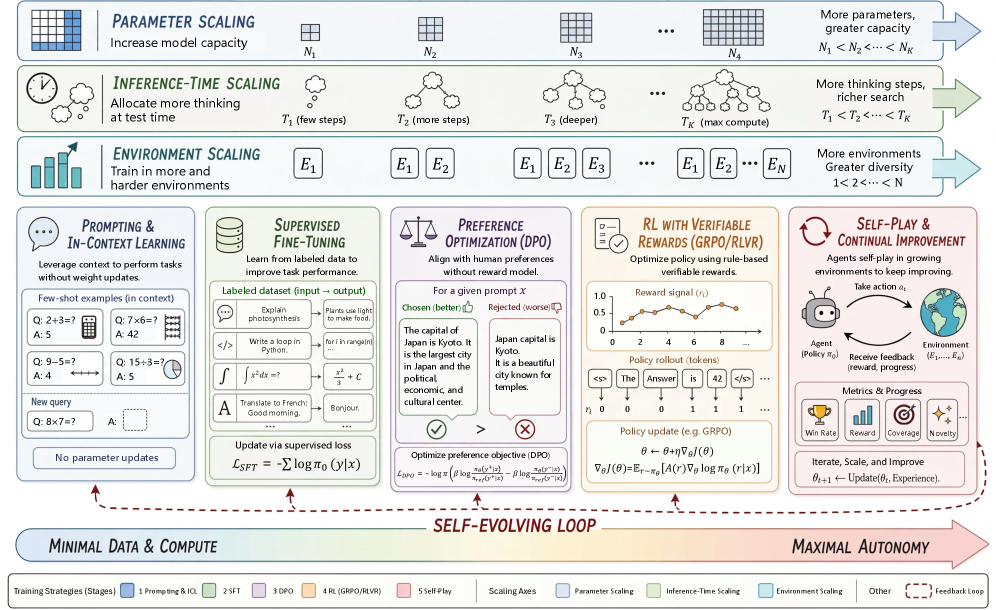
Стратегия обучения (Рис. 6) определяет, как медицинский агент приобретает и совершенствует свои возможности [79, 202, 215]. В то время как разделы об архитектуре (Раздел 4) и возможностях (Раздел 5) описывают масштабирование во время инференса, то есть способы извлечения большей компетентности из фиксированной модели при развертывании за счет лучшей оркестрации и большего количества когнитивных модулей, данный раздел посвящен масштабированию во время обучения, то есть тому, как параметры, политики, память и даже структура агента изменяются, чтобы он становился более способным с течением времени. Мы определяем спектр подходов, варьирующихся от промптинга с нулевым количеством параметров до самосовершенствования в замкнутом цикле, и представляем структуру раздела как прогрессию к саморазвивающимся системам, в которых граница между обучением и развертыванием стирается. Мы дополнительно рассматриваем парадигму масштабирования, которая охватывает масштабирование параметров модели, масштабирование вычислений во время инференса и масштабирование среды как взаимодополняющие оси, при этом масштабирование среды выделяется как наиболее действенный рычаг для медицинских агентов, которые уже функционируют в насыщенных инструментами клинических экосистемах..
6.1 Промптинг и обучение в контексте
Наиболее доступная стратегия, не требующая модификации модели, опирается на тщательно составленные промпты и примеры в контексте для вызова агентного поведения у предобученных LLM [258, 238, 238]. MedAgent-Zero [238] демонстрирует, что хорошо спроектированные промпты в сочетании с доступом к инструментам позволяют достичь конкурентоспособных результатов на множестве бенчмарков по медицинской визуализации без какого-либо fine tuning. Агностические конвейеры нейрорадиологии [56] дополнительно подтверждают эффективность агентных подходов, не требующих обучения, достигая высоких показателей интерпретации МРТ головного мозга за счет чистого промптинга передовых моделей, таких как GPT-5.1 и Gemini 3 Pro.
6.2 SFT ⟦K0⟧)
SFT адаптирует предобученные LLM к области медицинской визуализации путем обучения на курируемых наборах пар (входные данные, желаемый результат) [130, 38, 44]. LLaVA-Med [130] демонстрирует эффективность двухэтапного подхода SFT. CheXagent [38] расширяет это за счет комплексного конвейера обучения, который включает этапы согласования клинических знаний, извлечения данных и генерации отчетов. RadVLM [44] внедряет многозадачную разговорную SFT для радиологических vision-language models, достигая улучшенной производительности в различных радиологических задачах за счет совместного обучения по нескольким клиническим целям.
6.3 Оптимизация предпочтений
Direct Preference Optimization (DPO) [202] и его варианты предлагают подход, свободный от обучения с подкреплением, для приведения выходов агентов в соответствие с клиническими предпочтениями [280, 284]. OPA-DPO [284] представляет оптимизированное выравнивание предпочтений специально для медицинских vision language models, демонстрируя, что предметно-ориентированная оптимизация предпочтений значительно превосходит DPO общего назначения. Подходы Med-RLHF [280] показывают, что оптимизация предпочтений значительно улучшает клиническое качество генерируемых радиологических отчетов по сравнению с одним лишь SFT, особенно в части сокращения галлюцинируемых находок и улучшения структуры отчетов [164].
6.4 Обучение с подкреплением с проверяемыми наградами (RLVR)
Для задач, где правильность может быть программно верифицирована, обучение с подкреплением с верифицируемыми наградами (RLVR) обеспечивает масштабируемый обучающий сигнал без необходимости ручной аннотации [261, 21, 79]. Теоретические основы RLVR устанавливают принципы проектирования наград и границы сложности выборки, определяющие практические реализации.
Групповая относительная оптимизация и верификация рассуждений в медицинских VLM. Group Relative Policy Optimization (GRPO) [215, 79] расширяет этот подход путем выборки нескольких вариантов ответов, их оценки по верифицируемым критериям и оптимизации политики на основе относительного качества внутри каждой группы. MedGRPO [231, 122] применяет GRPO специально к медицинским мультимодальным моделям, демонстрируя улучшение диагностических рассуждений за счет групповой относительной оптимизации, в то время как MedVLM-R1 [187] дополнительно подтверждает эффективность обучения с подкреплением для стимулирования способности к рассуждению в медицинских VLM. Patho-R1 [307] применяет трехэтапный конвейер (предварительное обучение, SFT, GRPO+DCPO) специально для патологии, достигая передовых показателей в VQA, zero-shot классификации и кросс-модальном поиске, а Med-R1 [122] демонстрирует, что обучение на основе GRPO для Qwen2-VL-2B по восьми модальностям визуализации дает повышение точности на 29,94% по сравнению с базовой моделью, превосходя модели, которые в 36 раз больше. Опираясь на эти рецепты групповой относительной оптимизации, ряд работ поощряет процесс рассуждения, а не только итоговый ответ: ChestX-Reasoner [60] продвигает радиологические рассуждения посредством пошаговой верификации с моделями вознаграждения процесса, представляя RadRBench-CXR для оценки цепочек рассуждений, а Jing et al. [109] предлагают «Рассуждай как радиолог», объединяя промптинг цепочки мыслей с обучением с подкреплением для генерации верифицируемых отчетов. VLM-R1 [216] предоставляет обобщаемую структуру обучения в стиле R1 для мультимодальных моделей, обнаруживая феномены взлома вознаграждения в задачах обнаружения объектов, в то время как Clinical-R1 [77] внедряет обучение с подкреплением с ограничениями и оптимизацией предпочтений для принятия клинических решений, объединяя RLVR с требованиями клинической безопасности..
Специализированное и причинно-следственное формирование вознаграждения. Помимо классификации и генерации отчетов, RLVR была адаптирована для решения специфических медицинских задач и использования более богатой семантики вознаграждения. MedSAM-Agent [152] применяет RLVR к интерактивной сегментации медицинских изображений, представляя сегментацию как последовательное принятие решений, а MedResearcher-R1 [290, 290] демонстрирует обучение RLVR для агента по поиску медицинской литературы с итеративным уточнением гипотез. Совсем недавно MedEyes[317] и MedCausalX [139] дополнительно расширили RLVR до прогрессивного диагностического рассуждения и адаптивного причинно-следственного рассуждения соответственно, где вознаграждения извлекаются из проверяемых диагностических результатов, причинно-следственной согласованности и контрфактической валидности для стимулирования экспертного визуального внимания и самокорректирующегося мышления. MedSynapse-V [318] продвигает это направление дальше с помощью причинно-следственного контрфактического уточнения (CCR), которое использует обучение с подкреплением с контрфактическими вознаграждениями, полученными на основе маскирования признаков на уровне регионов, для количественной оценки причинного вклада каждой латентной диагностической памяти, устраняя избыточность и выравнивая латентные представления с диагностической логикой посредством привилегированно-автономной двухветвевой парадигмы интернализации. Систематический обзор применения RL в анализе медицинских изображений, охватывающий алгоритмы, инженерные проблемы и клиническое внедрение, см. в работе Sampa et al. [208].
Проектирование вознаграждения на основе рубрик и на уровне сущностей. Важным проектным решением в RLVR для медицинских агентов является структура функции вознаграждения. HealthBench [8] устанавливает критерии рубрик, написанные врачами, в качестве золотого стандарта оценки, включающего 48 562 структурированных критерия в 5 000 клинических диалогах. Health-SCORE [283] демонстрирует, что масштабируемая генерация рубрик может служить двойным целям: как система оценки и как структурированные сигналы вознаграждения для обучения RL, преодолевая разрыв между оценкой и оптимизацией. Chen et al. [35] далее показывают, что автоматизированное построение рубрик позволяет надежно оценивать медицинские диалоговые системы в масштабе, в то время как Mallinar et al. [166] предоставляют масштабируемую систему оценки, валидированную для нескольких семейств медицинских языковых моделей, а расхождения между LLM-судьями и клиницистами, задокументированные в недавних работах [42], подчеркивают важность обоснования сигналов вознаграждения проверяемыми клиническими критериями, а не полагания исключительно на суждения, основанные на моделях. Помимо целостных рубрик, сопоставление на уровне сущностей стало многообещающим мелкозернистым сигналом вознаграждения для генерации медицинских текстов. MRG-R1 [248] внедряет обучение с подкреплением для клинически согласованной генерации медицинских отчетов, используя извлечение клинических данных на уровне сущностей в качестве вознаграждения, чтобы гарантировать, что сгенерированные отчеты содержат фактически верные медицинские сущности, а ESC-RL [315] расширяет это с помощью самокритичного обучения с подкреплением с учетом доказательств для генерации радиологических отчетов, где функция вознаграждения явно проверяет, что упомянутые анатомические структуры, патологии и измерения соответствуют фактическим доказательствам. Jhaveri et al. [102] предлагают вознаграждения на основе утверждений для оптимизации генерации длинных клинических текстов, декомпозируя выходные данные на атомарные утверждения и поощряя фактическую точность на уровне утверждений. Эти подходы к вознаграждению на уровне сущностей и утверждений предлагают превосходную гранулярность по сравнению с целостными вознаграждениями на уровне последовательностей, обеспечивая целенаправленную оптимизацию фактической согласованности в выходных данных медицинских агентов..
От одноходовой верификации к агентному RL. Помимо приведенной выше формулировки GRPO, быстро растущее семейство алгоритмов оптимизации стратегий повышает свою стабильность и расширяет область применения от одноходовой верификации до многоходовых агентных сред (Таблица 2). В рамках одноходового режима DAPO [292] разделяет границы отсечения и добавляет динамическую выборку, Dr. GRPO [154] устраняет смещения нормализации длины и стандартного отклонения стандартного GRPO, GSPO [310] заменяет коэффициенты важности на уровне токенов на коэффициенты на уровне последовательностей для стабилизации обучения Mixture-of-Experts, а CISPO [25] ограничивает веса importance-sampling, а не обновления токенов, чтобы редкие, но решающие токены по-прежнему вносили вклад в градиенты. Многоходовое расширение, часто называемое агентным RL, переосмысливает обучение как последовательное принятие решений на основе вызовов инструментов и наблюдений в условиях частичной наблюдаемости [298], что напрямую соответствует формулировке Раздела 2.1 и переносит основную сложность на распределение кредита на уровне ходов: MT-GRPO [296] и Turn-PPO [131] оценивают преимущества с гранулярностью отдельных ходов принятия решений, ARPO [47] использует энтропию для фокусировки оптимизации на шагах вызова инструментов с высокой неопределенностью, а AT2PO [324] связывает распределение кредита по ходам с древовидным поиском. Для медицинских агентов, чьи консультации и обследования приносят вознаграждение только в конце длинной многоходовой траектории, эта агентная формулировка является естественным аналогом обучения для представления о частичной наблюдаемости, принятого в Разделе 2.1. Близко связанным и быстро развивающимся направлением является on-policy distillation (OPD), которое формально эквивалентно обучению с подкреплением с ограничением KL по траекториям, выбранным студентом [229], и лежит в основе рецепта усеченной on-policy distillation на уровне ходов, который Healthcare AI GYM [100] использует для стабилизации многоходового обучения медицинских агентов в реалистичных условиях клинического взаимодействия..
| Algorithm | Key Innovation | Resource |
| Critic-Free Policy Optimization (GRPO family) | ||
| PPO [212] | Clipped surrogate objective with a learned critic | Code |
| GRPO [215] | Critic-free group-relative advantage | Code |
| DAPO [292] | Decoupled clip bounds and dynamic sampling | Code |
| Dr. GRPO [154] | Removes length and std normalization bias | Code |
| GSPO [310] | Sequence-level importance ratio; stabilizes MoE | Paper |
| CISPO [25] | Clips IS weights, keeps rare-token gradients | Code |
| REINFORCE++ [94] | Global-baseline, critic-free, robust variant | Code |
| Agentic / Multi-Turn RL (2025–2026) | ||
| MT-GRPO [296] | Turn-level credit assignment for tool use | Code |
| ARPO [47] | Entropy-guided step-level tool-call optimization | Code |
| GTPO [46] | Turn-level reward with return-based advantage | Paper |
| AEPO [47] | Entropy-balanced rollout and policy update | Code |
| Turn-PPO [131] | Turn-level critic for long-horizon agents | Paper |
| AT2PO [324] | Turn-based tree search with turn-wise rewards | Code |
6.5 Самообучение и непрерывное совершенствование
Наиболее передовая парадигма обучения позволяет агентам совершенствоваться посредством автономной практики в симулированных клинических средах [132, 51, 218, 241, 65]. Agent Hospital [132] реализует среду симуляции, в которой агенты практикуются на синтетически сгенерированных случаях пациентов, накапливая диагностический опыт в ходе тысяч симулированных консультаций. EvoPatient [51] внедряет совместно эволюционирующих синтетических пациентов, которые усложняются по мере совершенствования агента в ходе многоходовых диагностических диалогов, одновременно собирая опыт для повышения качества как вопросов, так и ответов. AMIE [241] стала пионером в области симулированного обучения через самоигру для диагностических бесед, продемонстрировав, что агенты на базе LLM, обученные посредством автономных ролевых игр «врач-пациент», могут превосходить врачей первичного звена по точности диагностики..
Симулированные среды и обучение стратегий. DoctorAgent-RL [65] обучает явную модель стратегии посредством многоагентного совместного обучения с подкреплением, где агент-врач оптимизирует свою стратегию опроса через обучение на основе RL в противостоянии с высокоточной моделью LLM-пациента и оценщиком консультаций, предоставляющим многомерные вознаграждения. ATPO [22] развивает обучение стратегий посредством адаптивной древовидной оптимизации стратегий, формулируя многоходовой медицинский диалог как иерархический Марковский процесс принятия решений и адаптивно распределяя бюджеты развертывания для состояний с высокой неопределенностью, что позволяет модели Qwen3-8B превзойти GPT-4o на диагностических бенчмарках. Healthcare AI GYM [100] предоставляет совместимую с Gymnasium среду обучения, охватывающую 10 клинических областей с 3.6K+ задачами и 135 специализированными инструментами, а также предлагает пошаговую усеченную дистилляцию на основе стратегии (TT-OPD) для стабилизации многоходового агентного RL-обучения. MedAgentSim [5] представляет собой симуляцию с открытым исходным кодом с участием агентов врача, пациента и измерительных приборов, обеспечивающую саморазвивающиеся диагностические возможности посредством воспроизведения опыта и рассуждений по цепочке мыслей. MedAgentGym [274] предоставляет масштабируемый тренировочный гимнастический зал для медицинских рассуждений на основе кода, демонстрируя существенное улучшение за счет онлайн-обучения с подкреплением на 72K биомедицинских задачах..
Преодоление разрыва в точности симуляции и непрерывное совершенствование. Критической проблемой обучения через самоигру является обеспечение переноса навыков, полученных в симуляции, в реальные клинические условия. SynthAgent [3] решает эту задачу с помощью обогащенных личностными характеристиками синтетических агентов-пациентов, которые включают профили коморбидности и психосоциальные характеристики, сокращая разрыв в распределении между симулированными и реальными взаимодействиями с пациентами. MeWM [281] представляет первую обоснованную медицинскую модель мира, которая объединяет политику VLM с изученными моделями динамики опухоли и обратной динамики, позволяя агентам планирования лечения обучаться на траекториях прогрессирования заболевания. Evo-MedAgent [218] предлагает саморазвивающийся модуль памяти, состоящий из ретроспективных клинических эпизодов, адаптивных процедурных эвристик и контроллера надежности инструментов, что позволяет агентам накапливать межслучайный опыт во время тестирования без дополнительного обучения. MedChain-Agent [147] интегрирует механизм обратной связи с генерацией на основе поиска по прецедентам для последовательной адаптации клинических решений, позволяя агентам учиться на предыдущих случаях на пяти этапах клинического рабочего процесса. MMedAgent-RL [269] сочетает обучение по учебной программе с многоагентным reinforcement learning, обучая агентов триажа и лечащих врачей посредством поэтапного RL на Qwen2.5-VL для достижения улучшения на 23,6% в бенчмарках медицинских рассуждений. SWE-RL [259] демонстрирует, что reinforcement learning на открытых данных эволюции программной инженерии может улучшить общие способности к рассуждению, что имеет значение для агентов, генерирующих медицинский код..
6.6 Саморазвивающиеся агенты: уроки из общей области
Самообучение и непрерывное совершенствование являются частными случаями более широкого и быстро развивающегося рубежа, а именно саморазвивающихся агентов, которые в ответ на полученный опыт изменяют не только свои параметры, но и память, промпты, инструменты и даже собственный управляющий код [68, 289, 95, 302, 328]. В данной общей области сформировался конкретный набор механизмов эволюции, классифицируемых по тому, что именно изменяет агент. На уровне весов SEAL [328] позволяет модели генерировать собственные данные для SFT и директивы обновления через цикл подкрепления, усваивая новые знания без внешней аннотации — это рецепт, необходимый радиологическому агенту для адаптации к статистике изображений недавно установленного сканера. На уровне архитектуры и кода Darwin Godel Machine [302] поддерживает эволюционный архив агентов, которые эмпирически переписывают собственный код, ADAS [95] запускает мета-агента, который программирует все более сильных агентов на основе растущего архива проектов, а Gödel Agent [289] считывает и редактирует собственную логику во время выполнения для рекурсивного самосовершенствования, что указывает на возможность создания медицинских агентов, автономно перестраивающих маршрутизацию своих инструментов и циклы рефлексии. На уровне памяти и процедур обзор саморазвивающихся агентов [68] структурирует пространство проектирования по принципам «что», «когда», «как» и «где» развиваться, в то время как в медицине повторение опыта на клинических случаях [132, 5], совместно развивающиеся симуляторы [51] и саморазвивающиеся контроллеры памяти [218] уже позволяют агентам совершенствоваться на этапе тестирования без переобучения..
Решающим фактором, лежащим в основе всех трех уровней, является верифицируемая среда исполнения: условия, в которых каждое действие агента может быть выполнено и автоматически оценено, превращая саморазвитие в замкнутый цикл, управляемый проверяемыми наградами, а не человеческой разметкой. Agent-RLVR [259, 100] иллюстрирует этот паттерн в программной инженерии, где агент выполняет задачу, его траектория проверяется с помощью модульных тестов, а политика обновляется посредством reinforcement learning на основе верифицируемых наград, в то время как reasoning gyms [274] объединяют обширные библиотеки программно проверяемых сред для тех же целей. Медицина необычайно хорошо подходит для этой парадигмы, поскольку верифицируемые сигналы являются неотъемлемой частью рабочего процесса, включая согласованность измерений, валидность структурированных отчетов, соответствие клиническим рекомендациям и последующие результаты наблюдения. Недавние gyms реализуют именно это: MedAgentGym [274] предоставляет 72 тысячи биомедицинских задач в виде исполняемого кода с online reinforcement learning, Healthcare AI GYM [100] охватывает десять клинических областей со 135 инструментами и стабилизирует многоходовое агентное обучение посредством turn level truncated on policy distillation, а MedAgentSim [5] замыкает цикл с помощью агентов врача, пациента и измерений, которые саморазвиваются через experience replay. Создание верифицируемых, аудируемых сред исполнения, где эволюция на уровне весов, кода и памяти управляется заслуживающими доверия сигналами вознаграждения, является ключевой возможностью для следующего поколения медицинских агентов..
6.7 Три оси масштабирования
Критически важным выводом для развития медицинских агентов является то, что возможности могут масштабироваться по трем взаимодополняющим осям, а не только за счет увеличения параметров модели [62, 228, 97].
Масштабирование параметров. Традиционные законы масштабирования предсказывают, что производительность модели улучшается с увеличением количества параметров и объема обучающих данных [1, 76, 209]. Медицинские фундаментальные модели следовали этой траектории: от ранних специализированных CNN до мультимодальных моделей с миллиардами параметров, таких как Med-Gemini [207, 226] и InternVL [37]⟧.
Масштабирование вычислений на этапе вывода. Недавние исследования показывают, что выделение дополнительных вычислительных ресурсов во время вывода посредством более длинных цепочек рассуждений, многократной выборки или верификации на основе поиска может быть более экономически эффективным, чем масштабирование параметров для определенных задач [228, 137, 79, 176]. Snell et al. [228] показывают, что оптимальное распределение вычислительных ресурсов на этапе тестирования может превзойти модели, которые в 14 раз больше, в то время как s1 [176] демонстрирует, что дообучение на тысяче примеров в сочетании с простым ограничением бюджета позволяет добиться конкурентоспособных рассуждений, а DeepSeek-R1 [79] показывает, что чистое обучение с подкреплением может стимулировать эмерджентные развернутые рассуждения. Для медицинских агентов эти общие подходы проявляются в более глубоких цепочках диагностических рассуждений [187, 50], диагностическом поиске на основе MCTS [72] и циклах итеративного уточнения [224, 162], и они привлекательны именно тем, что позволяют повысить точность без переобучения, что является важным свойством в условиях ограничений на управление данными в клинической среде..
Масштабирование среды. Недавно сформулированная парадигма масштабирования среды [62, 97] предполагает, что возможности агента могут быть существенно расширены за счет обогащения среды, то есть разнообразия и качества инструментов, источников данных и интерфейсов взаимодействия, доступных агенту. Это понимание особенно актуально для медицинских агентов, которые работают в клинических средах, по своей сути насыщенных инструментами, включающими PACS, EHR системы, модели анализа специалистов, базы данных руководств и интерфейсы оборудования для визуализации [114, 93]. Agent-World [48] демонстрирует масштабируемый синтез реальных сред для обучения агентов, в то время как EnvScaler [230] предоставляет систематические методы для расширения сред взаимодействия с инструментами. ARE [67] представляет крупномасштабные системы оценки для анализа производительности агентов по мере увеличения сложности среды. Исследования по масштабированию мультиагентных систем [194, 116] дополнительно предполагают, что количество и специализация самих агентов представляют собой измерение масштабирования среды. Для медицинских агентов в частности масштабирование среды означает три конкретных направления: расширение инструментария (добавление новых специализированных моделей, инструментов измерения, баз данных для поиска) [198, 58], обогащение информационной среды (подключение к более полным записям пациентов, архивам визуализации и репозиториям руководств) [177, 268] и улучшение интерфейсов взаимодействия (стандартизация через MCP и FHIR) [93, 52]⟧.
7 Применения: от специализированных отделений до реальных клинических рабочих процессов
Мы систематизируем ландшафт приложений по клиническим специальностям для удобства поиска, однако внутри каждой специальности мы рассматриваем каждую систему через единую призму трех возрастающих уровней возможностей, а именно: восприятие и отчетность, рассуждение и принятие решений, а также сотрудничество и саморазвитие, как обобщено на рис. 7. Плоский список специальностей показывает, что существует, но не отражает степень зрелости каждой разработки, тогда как проецирование гетерогенных систем на общую ось выявляет структурные факты, которые каталог сам по себе скрывает, например, то, что в радиологии уже достигнуто многоагентное сотрудничество, в то время как большинство агентов в офтальмологии все еще находятся на уровне восприятия, и что одна и та же подложка оркестрации повторяется в разных отделениях под разными названиями. Эта призма также позволяет нам связать высший уровень с динамикой саморазвития, проанализированной на рис. 6, поскольку агент, который критикует и переписывает свой собственный вывод, представляет собой в миниатюре замкнутый цикл, к которому стремятся масштабирование на этапе обучения и этапе вывода на системном уровне. Как наглядно показано на рис. 7, специализированные системы не действуют изолированно, а сходятся через общий уровень интеграции в многоагентную оркестрацию, которая в конечном итоге управляет реальным рабочим процессом больницы. В таблице 3 представлены репрезентативные системы с этой точки зрения, и на протяжении всего этого раздела мы цитируем как признанные разработки, уже находящиеся в широком использовании, так и самые последние дополнения, чтобы читатель видел не только текущий рубеж, но и траекторию, которая к нему привела..
7.1 Радиологические агенты
Радиология является наиболее насыщенной агентами специальностью, что неудивительно, поскольку ее рабочий процесс полностью оцифрован с помощью PACS и структурированной отчетности, что дает агенту как чистое пространство для наблюдений, так и функциональный интерфейс, в котором каждое считывание, извлечение и черновик являются четко определенной операцией. На уровне восприятия и отчетности MedRAX [57] координирует набор инструментов для рентгенографии грудной клетки без какой-либо переподготовки под конкретные задачи, устанавливая значимый результат, согласно которому контроллер рассуждений, размещенный поверх замороженных экспертов, уже конкурентоспособен по сравнению со специализированными моделями, в то время как RadAgents [303] формализует эту интуицию в этапы восприятия, извлечения и составления черновиков, подобные действиям радиолога, чтобы каждый шаг стал проверяемым, а не представлял собой единый непрозрачный прямой проход. Та же поэтапная философия направляет CXR-Agent [156] и MRGAgents [247] к автоматизированной интерпретации и генерации отчетов, при этом общая логика проектирования заключается в том, что декомпозиция обеспечивает возможность аудита, что является именно тем, что должен предоставлять клинический отчет, прежде чем он попадет в медицинскую карту. RadFabric [34] еще больше заостряет разделение труда, связывая специализированные агенты восприятия с центральным агентом рассуждений, исходя из наблюдения, что одна модель не может одновременно локализовать находки и обосновывать их в рамках одного бюджета вывода, не жертвуя одним ради другого. На уровне рассуждений и принятия решений MedAgent-Pro [255] обосновывает мультимодальную диагностику извлеченными доказательствами, чтобы выводы были подкреплены, а не просто утверждены, CXReasonAgent [125] делает диагностическую цепочку явной и прослеживаемой до области изображения или извлеченного факта, чтобы бороться с центральным режимом сбоев в виде галлюцинируемых находок, а мультиагентная формулировка визуальных ответов на вопросы по радиологии [288] восстанавливает композиционную точность, которую монолитная модель теряет при запросах, требующих нескольких шагов рассуждения. Усилия, специфичные для модальностей, расширяют тот же рецепт, а не изобретают его заново: CT-Agent [168] и RadAgent [204] нацелены на ответы на вопросы по 3D КТ и автономное управление рабочим процессом, MARCH [142] воспроизводит иерархию ординатора, стажера и лечащего врача, чтобы черновики передавались на рассмотрение и исправлялись точно так же, как в учебной больнице, а DentVLM [173] переносит эту парадигму на стоматологическую визуализацию, где применяется тот же конвейер от восприятия до отчета. На уровне сотрудничества и саморазвития RadCouncil [295], Meissa [36] и конвейеры в стиле консенсуса для генерации и оценки отчетов [55] позволяют нескольким агентам составлять черновики, критиковать и приходить к согласию, превращая генерацию с одной попытки в итеративный процесс согласования, результатом которого является снижение вариативности, а не единый уверенный, но непроверенный вывод. Уровень рабочего процесса окончательно закрывается RadOnc-GPT [89], который автономно маркирует исходы пациентов в масштабе, что является доказательством того, что дивидендом от агентов является не только диагностика, но и облегчение бремени документации, которое занимает большую часть времени клинициста и которое не измеряет напрямую ни один бенчмарк..
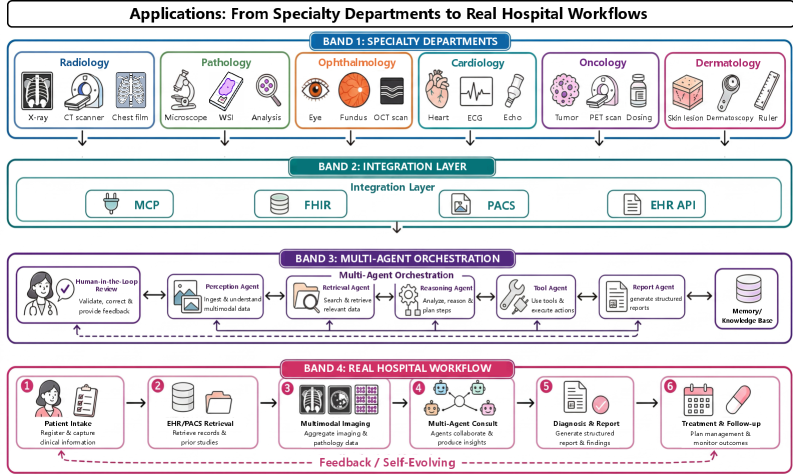
| Year | System | Key Contribution | Venue | Paper | Code |
| Radiology | |||||
| 2026 | MedOpenClaw [217] | Auditable VLM agent for 3D Slicer clinical imaging | arXiv | Paper | – |
| 2026 | MARCH [142] | Resident-Fellow-Attending multiagent CT report generation | ACL 2026 | Paper | – |
| 2026 | RadAgent [204] | Autonomous radiology workflow management for CT | arXiv | Paper | Code |
| 2025 | MedRAX [57] | Multimodal reasoning agent with tool orchestration for CXR | ICML 2025 | Paper | Code |
| 2025 | MedAgent-Pro [255] | Evidence-based multimodal medical diagnosis agent | ICLR 2026 | Paper | Code |
| 2025 | CT-Agent [168] | 3D CT radiology QA via multimodal LLM agent | arXiv | Paper | – |
| 2025 | CXR-Agent [156] | Automated chest radiograph interpretation pipeline | arXiv | Paper | Code |
| 2025 | MRGAgents [247] | Multimodal radiology report generation agents | arXiv | Paper | – |
| 2025 | DentVLM [173] | Dental imaging VLM agent | arXiv | Paper | – |
| 2025 | RadFabric [34] | Perception agents plus central reasoning agent for radiology | arXiv | Paper | – |
| 2025 | RadAgents [303] | Radiologist-like staged CXR perception, retrieval and drafting | arXiv | Paper | – |
| 2025 | RVQA-MAS [288] | Multiagent decomposition for radiology VQA reasoning | JCDL 2025 | Paper | – |
| 2026 | CXReasonAgent [125] | Evidence-grounded traceable CXR diagnostic chain | arXiv | Paper | – |
| 2025 | Med-AI-Consensus [55] | Multiagent report generation with consensus evaluation | arXiv | Paper | – |
| 2025 | RadOnc-GPT [89] | Autonomous outcome labeling at scale in radiation oncology | arXiv | Paper | – |
| 2024 | RadCouncil [295] | Multiagent radiology report impression generation | arXiv | Paper | – |
| Pathology | |||||
| 2025 | PathAgent [29] | Interpretable WSI via Navigator-Perceptor-Executor loop | arXiv | Paper | Code |
| 2025 | PathFinder [74] | Interactive multiagent WSI search and analysis | ICCV 2025 | Paper | – |
| 2025 | WSI-Agents [160] | Coordinated multiagent whole slide image analysis | MICCAI 2025 | Paper | Code |
| 2025 | TissueLab [135] | Co-evolving agentic tissue analysis environment | arXiv | Paper | Code |
| 2025 | GMAT [200] | Multiagent tissue classification for histopathology | arXiv | Paper | – |
| 2025 | SlideSeek [260] | Evidence-based multiagent copilot for human pathology WSI | arXiv | Paper | – |
| 2025 | TeamPath [153] | Role-specialized multimodal pathology copilots | arXiv | Paper | Code |
| 2026 | Patho-R1 [307] | RL-trained pathology expert chain-of-thought reasoner | AAAI 2026 | Paper | Code |
| 2026 | Patho-AgenticRAG [306] | Agentic retrieval-augmented pathology VLM via RL | AAAI 2026 | Paper | Code |
| 2026 | CPathAgent [233] | Interpretable coarse-to-fine WSI analysis with pathologist logic | NeurIPS 2025 | Paper | Code |
| Ophthalmology | |||||
| 2025 | EyeAgent [221] | 53-tool agent across 23 imaging modalities | arXiv | Paper | – |
| 2025 | EyecareGPT [134] | Multimodal LLM for comprehensive ophthalmic imaging | arXiv | Paper | Code |
| 2025 | OAAgent [4] | Automated ophthalmic analysis construction | CHASE 2025 | Paper | – |
| 2025 | EH-Benchmark [189] | Ophthalmic hallucination benchmark with traceable agent | Inf. Fusion | Paper | Code |
| 2026 | OphIn-500K [49] | Web-scale ophthalmic visual instruction curation | arXiv | Paper | – |
| Neurology | |||||
| 2026 | Agentic NeuroRad [56] | Training-free brain MRI pipeline via VLM orchestration | arXiv | Paper | – |
| 2025 | CARE-AD [133] | Multiagent Alzheimer’s prediction from EHR | npj DM | Paper | – |
| 2026 | AD-CARE [92] | Guideline-driven Alzheimer’s diagnosis agent | arXiv | Paper | – |
| 2025 | ADAgent [91] | Collaborative coordinator for Alzheimer’s analysis | MICCAI-W 2025 | Paper | Code |
| 2026 | NeuroAgent [312] | LLM agents for multimodal neuroimaging analysis | arXiv | Paper | – |
| Crossmodal | |||||
| 2026 | MACRO [58] | Self-evolving agent with experience-driven tool discovery | arXiv | Paper | – |
| 2026 | CARE [50] | Evidence-grounded agentic framework, +10.9% VQA accuracy | arXiv | Paper | – |
| 2026 | ClinicalAgents [72] | MCTS + dual-memory clinical decision orchestration | arXiv | Paper | – |
| 2026 | MedEyes [317] | Dynamic visual focus for progressive diagnosis | AAAI 2026 | Paper | Code |
| 2026 | MedCausalX [139] | Adaptive causal reasoning with self reflection | CVPR Findings | Paper | Code |
| 2024 | MDAgents [115] | Adaptive multiagent collaboration for medical decisions | NeurIPS | Paper | Code |
| 2025 | MEDDxAgent [205] | Unified framework for differential diagnosis | ACL 2025 | Paper | Code |
| 2024 | EHRAgent [222] | Code-empowered EHR reasoning agent | EMNLP 2024 | Paper | Code |
| 2024 | ColaCare [254] | LLM-driven multiagent clinical care | arXiv | Paper | Code |
| 2025 | ReflecTool [138] | Reflection-augmented tool use for medical agents | ACL 2025 | Paper | Code |
| 2025 | MMedAgent-RL [269] | RL-optimized generalist-specialist agent collaboration | arXiv | Paper | – |
| 2025 | MedMMV [146] | Controllable verifiable multimodal clinical reasoning | arXiv | Paper | – |
| 2025 | MDTeamGPT [30] | Self-evolving multidisciplinary team consultation | arXiv | Paper | Code |
| 2025 | MAM [316] | Role-specialized modular multimodal diagnosis | ACL 2025 | Paper | Code |
| 2025 | MedChat [149] | Multiagent multimodal diagnosis framework | MIPR 2025 | Paper | Code |
| 2026 | ClinSeekAgent [263] | Autonomous multimodal evidence seeking | arXiv | Paper | Code |
| 2026 | Meissa [36] | Multimodal medical agentic intelligence | arXiv | Paper | Code |
| AutoML | |||||
| 2026 | Evo-MedAgent [218] | Evolutionary agent self improvement framework | arXiv | Paper | – |
| 2025 | M3Builder [63] | Automated medical model building via agent pipeline | MICCAI 2025 | Paper | Code |
| Pharmacy | |||||
| 2025 | TxAgent [70] | Therapeutic agent with drug interaction reasoning | arXiv | Paper | Code |
| 2024 | MALADE [39] | Multiagent adverse drug event detection | MLHC 2024 | Paper | Code |
| Oncology | |||||
| 2025 | Ferber et al. [66] | Prospectively validated autonomous oncology agent | Nat. Cancer | Paper | – |
| 2025 | RadGPT [13] | 3D image-text tumor dataset construction agent | ICCV 2025 | Paper | Code |
| 2024 | MAGDA [11] | Guideline-driven cancer diagnostic assistance | arXiv | Paper | – |
7.2 Агенты в патологии
Изображения целых предметных стекол создают проблему масштаба, которая делает парадигму агентов практически обязательной, поскольку гигапиксельный слайд невозможно обработать за один проход, что требует участия агента, который решает, куда смотреть дальше, когда приближать изображение и когда накоплено достаточно данных для принятия решения. На уровне восприятия PathAgent [29] реализует интерпретируемый цикл навигатора, перцептора и исполнителя, в котором сам путь навигации становится объяснением, а CPathAgent [233] аналогичным образом имитирует логику патологоанатома от общего к частному, автономно решая, когда масштабировать изображение высокого разрешения для создания интерпретируемого отчета, в то время как PathFinder [74] добавляет интерактивный многоагентный поиск по слайду, чтобы патологоанатом мог направлять исследование, а многоагентные помощники для патологической анатомии указывают точные области, подтверждающие каждое заключение [260], что является аналогом обоснования доказательств на уровне слайда, который мы наблюдали в радиологии. WSI-Agents [160] и GMAT [200] координируют работу специализированных агентов по всему слайду, чтобы классификация тканей и анализ областей распределялись между экспертами, а не выполнялись принудительно одной нейронной сетью. Уровень рассуждений совершенствуется с помощью моделей рассуждения, обученных с использованием reinforcement learning, таких как Patho-R1 [307], чья функция вознаграждения формирует экспертную цепочку рассуждений патологоанатома, а не только итоговую метку, и с помощью Patho-AgenticRAG [306], который выполняет поиск по базе знаний патологий во время инференса, чтобы редкие сущности распознавались за счет извлечения информации, а не запоминания, — различие, которое имеет критическое значение в области с длинным хвостом редких диагнозов. На уровне сотрудничества и самоэволюции TeamPath [153] объединяет специализированных по ролям помощников, чьи разногласия сами по себе являются полезным сигналом неопределенности, а TissueLab [135] замыкает цикл с помощью совместно эволюционирующей среды, в которой агент и его инструменты совершенствуются вместе с течением времени, что является наиболее ярким примером самоэволюции в патологии, выдвинутым на первый план в данном обзоре..
7.3 Офтальмологические агенты
Офтальмология богата данными, но все еще находится на ранней ступени развития возможностей: большинство систем ограничиваются восприятием, и лишь самые последние разработки достигают уровня полноценной поддержки принятия решений с использованием различных модальностей. EyecareGPT [134] предоставляет комплексную мультимодальную основу, на которую могут опираться последующие агенты, а EyeAgent [221] является первой агентной системой, координирующей десятки офтальмологических инструментов в рамках множества методов визуализации для поддержки клинических решений. Ее ключевым вкладом является политика маршрутизации инструментов, определяющая, какой метод следует применить при конкретной жалобе — решение, которое статичная модель просто не способна принять, поскольку у нее отсутствует понимание того, когда ее собственных входных данных недостаточно. Автоматизированные конвейеры построения, такие как OAAgent [4], снижают инженерные затраты на создание подобных систем, что само по себе является необходимым условием для их внедрения. Прогресс в этой области ограничен скорее вопросами надежности, чем чистой точностью, поэтому EH-Benchmark [189] объединяет офтальмологический бенчмарк для оценки галлюцинаций с рабочим процессом логического вывода, допускающим прослеживаемость «сверху вниз», обосновывая тезис о том, что узким местом в данной специальности является верифицируемость, в то время как крупномасштабная курация визуальных инструкций, такая как OphIn-500K [49], обеспечивает информационную базу, необходимую этим агентам для перехода от простого восприятия к надежной поддержке принятия решений..
7.4 Агенты в онкологии и неврологии
Онкология предоставляет наиболее убедительные доказательства того, что агенты могут действовать, а не просто давать советы, поскольку проспективно валидированный автономный агент для принятия клинических решений в онкологии достиг уровня экспертного согласия на реальных случаях [66], что является самым четким сигналом в данной области о том, что эта парадигма клинически жизнеспособна, а не является артефактом бенчмарка, и это подкрепляется ассистентами на основе руководящих принципов, такими как MAGDA [11], которые кодируют онкологические протоколы непосредственно в цикл рассуждений. RadGPT [13] создает наборы данных 3D-изображений и текстов опухолей, от которых зависят такие агенты, устраняя нехватку данных, которая в противном случае ограничивает рассуждения об опухолях, а RadOnc-GPT [89] замыкает цикл маркировки исходов, благодаря чему доказательная база растет под наблюдением агента. В неврологии ADAgent [91], AD-CARE [92] и CARE-AD [133] координируют модально-независимые доказательства для оценки болезни Альцгеймера с анализом справедливости и исследованиями читателей, причем включение справедливости является осознанным ответом на демографический перекос, который поражает наборы данных по нейродегенеративным заболеваниям, в то время как NeuroAgent [312] нацелен на мультимодальный нейровизуализационный анализ и исследования в более широком смысле. Примечательно, что нейрорадиологический анализ без обучения, управляемый исключительно агентной LLM [56], показывает, что одна лишь оркестрация, без какой-либо специфической для задачи SFT, уже может обеспечить пригодную для использования производительность в реальных клинических рабочих процессах, результат, который пересматривает часть уравнения затрат на развертывание, поскольку устраняет барьер переобучения, который обычно отделяет прототип от клинического пилотного проекта.
7.5 Кроссмодальные и кросс-специализированные агенты
Параллельное направление отказывается от предположения о специализации и нацелено на универсальность, исходя из того, что сложная часть клинического мышления заключается в координации, а не в какой-либо одной модальности. MDAgents[115] адаптирует топологию сотрудничества к сложности случая, чтобы простые случаи обрабатывались с низкими затратами, а для сложных случаев собиралась экспертная группа, MEDDxAgent[205] объединяет дифференциальную диагностику в единую итеративную структуру, а MMedAgent-RL[269] оптимизирует политику сотрудничества между гетерогенными агентами с помощью обучения с подкреплением, чтобы система обучалась тому, когда следует переключаться между специалистом широкого профиля и узким специалистом, вместо ручного кодирования маршрутизации. Надежность рассматривается напрямую в MedMMV[146], который добавляет контролируемый уровень верификации, чтобы мультимодальные выводы были проверяемыми, в MAM[316], который факторизует диагностику на специализированные по ролям агенты для обеспечения аудируемости каждой роли, и в CARE[50], который делает агентную структуру основанной на доказательствах и подотчетной, что в результате приводит к существенному повышению точности визуальных ответов на вопросы. Структуры в стиле консультаций, такие как MDTeamGPT[30], MedChat[149] и ColaCare[254], имитируют междисциплинарную команду, исходя из того, что сложные случаи решаются в реальных клиниках путем дискуссий между специалистами, — структуру, которую эти агенты явно воспроизводят, чтобы мнения меньшинства выявлялись, а не усреднялись. Использование инструментов и механизмы памяти развивают это направление дальше: ReflecTool[138] добавляет использование инструментов с расширенной рефлексией, EHRAgent[222] делает рассуждения на основе EHR подкрепленными кодом, чтобы агент вычислял, а не угадывал, MedEyes[317] внедряет динамический визуальный фокус для прогрессивной диагностики, MedCausalX[139] добавляет причинно-следственные рассуждения с саморефлексией, а ClinicalAgents[72] объединяет древовидный поиск с двойной памятью для планирования на более длительные горизонты. На переднем крае Meissa[36], ClinSeekAgent[263] и саморазвивающийся MACRO [58] продвигаются к автономному поиску доказательств и обнаружению инструментов на основе опыта, где агент решает, какую дополнительную информацию собрать и даже какой новый инструмент создать, прежде чем дать ответ, что является операционным определением саморазвития на уровне приложений..
7.6 AutoML и кросс-стековые агенты
Зрелость наконец измеряется не только точностью, но и тем, может ли само построение этих систем быть автоматизировано и может ли медицинский агент корректно передавать управление в более широкий клинический стек. AutoML на основе агентов замыкает цикл построения: M3Builder [63] автоматизирует создание медицинских моделей, а Evo-MedAgent [218] добавляет эволюционное самосовершенствование, благодаря чему конвейер, создающий модели, оптимизируется сам по себе, что является аналогом самоэволюции на этапе вывода, происходящим во время построения. Цикл визуализации не заканчивается на отчете, поскольку результат, полученный на основе изображения, обычно инициирует терапевтическое решение, поэтому мы попутно отмечаем, что терапевтические и защитные агенты, такие как TxAgent [70] и MALADE [39], анализируют лекарственные взаимодействия и нежелательные явления; мы включаем их не как системы визуализации, а как непосредственное последующее звено передачи управления от медицинского агента и как доказательство того, что та же агентная подложка, цикл «восприятие-рассуждение-действие» с опорой на инструменты, разработанный в ходе этого обзора, переносится с пикселей на фармакологию в различных реальных клинических рабочих процессах, так что архитектурные уроки медицинских агентов распространяются на назначения, которые запускает результат визуализации. Мы намеренно ограничиваем упоминание терапевтических агентов одним абзацем именно для того, чтобы сохранить целостность линии визуализации, поэтому данные системы входят в сферу нашего рассмотрения только как назначения, запускаемые результатом визуализации, а не как самостоятельные объекты обзора..
8 Внедрение в реальных условиях и интеграция в клинический рабочий процесс
Переход агента от эталонного тестирования к работе в больнице сталкивается с тремя ограничениями, которые не учитывает ни один рейтинг: промышленная реализация, интероперабельность с существующими EHR и регуляторное одобрение. Постоянный урок, который извлекают ранние пользователи, заключается в том, что сдерживающим фактором редко является точность модели, а обычно — один из двух других [325]. Поэтому мы рассматриваем их как три столпа внедрения и посвящаем каждому из них отдельный подраздел, утверждая на протяжении всего текста, что инженерные и управленческие вопросы теперь так же достойны исследования, как и вопросы моделирования, которые доминируют в остальной части этого обзора..
8.1 Ландшафт промышленного внедрения
Коммерческий импульс сосредоточен на фоновой документации и медицинской сортировке, где ценность является немедленной, а ответственность — ограниченной, поскольку экономия минут на каждом приеме измерима и обратима, в то время как автономная диагностика не является ни тем, ни другим. Фундаментальные разработки, такие как Med-Gemini [207], устанавливают границы возможностей, на которых строятся продукты, в то время как готовые ассистенты интегрируют диктовку и составление черновиков непосредственно в рабочий процесс врача, поскольку сэкономленное время на каждом приеме — это метрика, за которую больницы действительно платят и которая проходит проверку при закупках..
8.2 Взаимодействие и стек протоколов
Внедрение зависит от функциональной совместимости, которую мы разделяем на два уровня, часто смешиваемых между собой. Уровень данных опирается на устоявшиеся стандарты: DICOM регулирует визуализацию, а HL7 FHIR — клинические записи, благодаря чему агент считывает и записывает именно те представления, которым больница уже доверяет и которые проверяет, и никакая интеграция без них не является надежной. Более новый уровень взаимодействия агентов — это область, на которой сосредоточены текущие исследования, поскольку Model Context Protocol предоставляет агентам доступ к инструментам и данным через унифицированный интерфейс [93], а семейства протоколов взаимодействия агентов, такие как A2A, ANP и ACP, стандартизируют то, как независимые агенты договариваются и делегируют работу друг другу [52]. Важно отметить, что эти протоколы теперь привязываются к клиническим данным, а не демонстрируются изолированно: Model Context Protocol напрямую подключен к FHIR для поддержки принятия решений [53] и оценивается в задачах реального поиска клинической информации в EHR [169], в то время как сквозные агентные конвейеры для медицинского логического вывода [223] демонстрируют работу полного стека без участия человека в каждом цикле. Основная мотивация здесь — взаимозаменяемость, поскольку протокольный уровень позволяет больнице заменить одного агента другим без перестройки интеграции, что является необходимым условием для конкурентной экосистемы поставщиков, а не привязки к единственному вендору..
8.3 Регуляторные и комплаенс-процедуры
Регулирование является тем столпом, который чаще всего определяет сроки, и оно меняется достаточно быстро, чтобы стать самостоятельной темой для исследований. В Соединенных Штатах решающим инструментом для адаптивных систем является План контроля заранее определенных изменений, руководящие принципы которого позволяют производителю заранее указать, как модель может обновляться после получения разрешения [23], что напрямую устраняет давнее несоответствие между статическим одобрением и моделью, разработанной для непрерывного обучения. В Европе Закон об искусственном интеллекте, Регламент (ЕС) 2024/1689 [227], классифицирует большинство медицинских AI как системы высокого риска и дополняет существующие режимы устройств MDR и IVDR, поэтому медицинский агент должен соответствовать как требованиям к устройствам, так и специфическим обязательствам в отношении AI, а недавний правовой анализ того, как автономные агенты вписываются в эту структуру [180], подчеркивает нерешенные вопросы ответственности, возникающие, когда агент действует без участия человека. Общая проблема для обоих режимов заключается в том, что процедура одобрения была разработана для неизменного артефакта, тогда как саморазвивающийся агент меняется после развертывания, что является именно той причиной, по которой механизм Плана контроля заранее определенных изменений служит регуляторным стержнем для всей лестницы адаптации от SFT через self-play к самоэволюции (Раздел 6), и почему управление и самоэволюцию лучше всего понимать как два взгляда на одну и ту же проблему..
9 Риски и открытые проблемы
Описанные выше возможности реальны, однако ни одна из них не устраняет структурные риски, которые отделяют высокий показатель в бенчмарке от системы, которой клиницист может довериться без надзора. Вместо перечисления сбоев мы рассматриваем их вдоль конвейера, который использовался в данном обзоре, а именно на пути от восприятия через рассуждение и координацию к развертыванию и, наконец, управлению, поскольку проблему лучше всего понимать как свойство этапа, на котором она возникает, и этапов, на которые она распространяется [80, 116]. Организующая идея, визуализированная на рис. 8, заключается в том, что автономность умножает стоимость каждого вида сбоя, поскольку ошибка, которую один forward pass выявил бы немедленно, в многошаговом агенте распространяется, рационализируется и приводит к действиям до того, как ее увидит человек, так что безопасность становится свойством оркестрации, а не какой-либо одной модели..
9.1 Уровень восприятия: разрыв в 3D и видео ⟦K0⟧
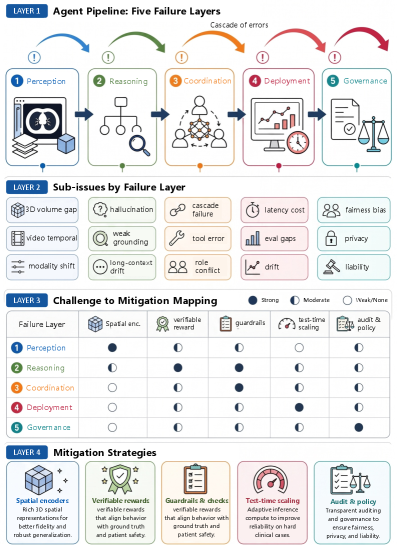
Конвейер начинается с восприятия, и здесь ограничивающим фактором является то, что большинство агентов оптимизированы для двумерной интерпретации, в то время как клинические данные по своей сути являются объемными и временными, поэтому агент, который преобразует объем компьютерной томографии в независимые срезы, отбрасывает именно ту пространственную непрерывность, от которой зависит радиолог [83, 168, 56]. Более глубокая причина, по которой это является «узким местом» уровня восприятия, а не просто неудобством данных, заключается в токенизации, поскольку наивное расширение двумерных токенизаторов до трех измерений увеличивает длину последовательности сверх любого допустимого бюджета вывода, что является именно той проблемой, на которую нацелен BTB3D [83] для медицинских VLM. CT-Agent [168] и конвейер Agentic Neuro-Radiology, не требующий обучения [56], показывают, что оркестрация может частично компенсировать это за счет рассуждения над объемом посредством последовательных вызовов инструментов, а не единовременного поглощения, а 3MDBench [236] предоставляет структуру оценки, необходимую для того, чтобы отличить подлинную объемную компетентность от двумерных эвристик, замаскированных под трехмерное рассуждение. Устойчивость восприятия при сдвиге распределения усугубляет разрыв, поскольку агент, который хорошо воспринимает данные на одном сканере, может незаметно деградировать на другом — хрупкость, количественно оцененная RobustMedCLIP [98] и состязательным анализом медицинских vision-language models [20], которые в совокупности определяют искажения и атаки как первостепенные риски восприятия, а не как граничные случаи..
9.2 Уровень рассуждений: Галлюцинации
Как только агент осуществляет восприятие, он должен рассуждать, и основной сбой на этом уровне — галлюцинации, то есть генерация правдоподобного, но фактически неверного контента, который агентный цикл превращает из сиюминутной ошибки в совершенное действие [103, 145, 190, 326]. Опасность заключается не в случайной ошибке, а в уверенной и проверяемой ошибке в формате, неотличимом от корректного отчета, поэтому исследовательский вопрос состоит не столько в том, как устранить галлюцинации, сколько в том, как сделать каждое утверждение прослеживаемым до проверяемых доказательств. Визуальные галлюцинации, при которых агент сообщает о находках, отсутствующих на изображении, находятся на границе восприятия и рассуждения, и их лучше всего минимизировать путем привязки каждого утверждения к пространственному референту, чтобы неподтвержденному заявлению негде было спрятаться [19, 181, 145]; VALOR [19] реализует это путем привязки выходных данных к конкретным областям изображения, в то время как MedHallu [190] и MedHallBench [326] предоставляют бенчмарки, без которых невозможно измерить любое сокращение [ошибок]. Контринтуитивный результат Kim et al. [117] заключается в том, что модели общего назначения превосходят специализированные медицинские модели в генерации без галлюцинаций, против , что предполагает, что широта предварительного обучения обеспечивает фактическую базу, которую узкая настройка может разрушить. Галлюцинации рассуждения, более тонкое построение логически связной, но фактически необоснованной цепочки, опаснее, поскольку их беглость подавляет подозрения [50, 187]; Med-VCD [164] борется с ними на этапе декодирования посредством визуального контрастивного декодирования, а более широкий портфель включает явное обоснование [71, 163], генерацию с дополнением поиском, которая заменяет запоминание проверяемым извлечением данных [268, 177, 112], и мультиагентную верификацию, при которой независимые агенты должны прийти к согласию, прежде чем будет вынесено заключение [115, 78, 55].
9.3 Уровень координации: каскадные сбои
Когда рассуждение распределено между агентами, сотрудничество, обеспечивающее проверяемость, порождает режим сбоя, отсутствующий в монолитных моделях, — каскад, при котором ошибка одного агента становится доверенным входным данным для другого и накапливается вдоль конвейера до тех пор, пока конечный результат не перестает соответствовать компетенции любого отдельного агента [80, 225, 116]. Структурный урок заключается в том, что устойчивость является функцией топологии, а не индивидуальной точности, поэтому обнаружение ошибок, шаблоны автоматических выключателей и избыточные пути стали объектами первого класса [78, 138]. MedSentry [31] делает это наглядным, показывая, что топологии с общим пулом наиболее уязвимы для каскадов, тогда как децентрализованные архитектуры поглощают локальные ошибки до того, как они распространятся, а Ghafoor et al. [73] демонстрируют, что структурированная экспертная оценка между агентами приводит к сокращению этических нарушений, что является доказательством того, что средством от мультиагентной патологии часто является большая, а не меньшая мультиагентная структура. Надежность при сдвиге распределения количественно оценивается с помощью бенчмарка CARES [266], который выявляет парадоксальный режим, в котором модели одновременно чрезмерно отклоняют доброкачественные запросы и пропускают тонкие состязательные джейлбрейки, а состязательная поверхность отображается Ekram [54], чья таксономия красных команд из восьми категорий обнаруживает, что формулировка «Образовательный авторитет» обходит защитные барьеры в случаев, — цифра, которая аргументирует в пользу безопасности, основанной на контексте, а не на ключевых словах, убедительнее любого абстрактного утверждения.
9.4 Уровень развертывания: эффективность и оценка
Даже проницательный, надежный и хорошо скоординированный агент сталкивается с уровнем развертывания, где основной валютой являются задержка и стоимость, и здесь агентное рассуждение по своей сути является дорогостоящим, поскольку каждый дополнительный вызов инструмента, этап верификации и раунд поиска приумножают и то, и другое, что в экстренном рабочем процессе является не вопросом удобства, а барьером для развертывания [243, 228, 101]. Поэтому передовой край объединяет дистилляцию моделей и эффективный инференс [243] с небольшими моделями, специализированными на вызове инструментов [101], и с адаптивными вычислениями, которые тратят больше ресурсов на рассуждения только в тех случаях, когда это оправдано [228, 209]; объединяющий принцип заключается в том, что вычислительные затраты должны соответствовать сложности случая, а не распределяться равномерно, что является аналогом аргумента о масштабировании, разработанного ранее, применительно к времени инференса. Развертывание также обнажает пробел в оценке, поскольку точность финального ответа ничего не говорит о том, был ли процесс рассуждения, приведший к нему, обоснованным, и недавние агентные бенчмарки, такие как MedAgentBench [105] и AgentClinic [211], переосмысливают оценку вокруг использования инструментов и последовательного принятия решений в реалистичных клинических условиях, а не изолированного QA, делая оценку на уровне процесса необходимым условием для доверия, а не второстепенной задачей..
9.5 Уровень управления: справедливость, конфиденциальность и ответственность
Последний уровень — это управление, где вопрос заключается уже не в том, работает ли агент, а в том, может ли общество привлечь его к ответственности, причем три проблемы здесь тесно связаны, а не разделимы. Справедливость находится под угрозой, поскольку агент наследует и может усиливать предвзятость, скрытую в данных для обучения, поэтому система, точная в среднем, может быть систематически хуже для недостаточно представленных групп — неравенство, которое совокупные метрики скрывают по своей сути [214, 182, 28, 271]. Конфиденциальность находится под напряжением, поскольку агентная парадигма расширяет поверхность атаки, так как каждая граница инструмента и сообщение между агентами являются местом, где могут произойти утечки конфиденциальных данных [111, 179, 201]; аудиты безопасности MCP [201] каталогизируют конкретные риски при взаимодействиях через инструменты, FRAME [179] использует федеративное обучение, чтобы данные никогда не покидали пределы учреждения, а Rempe et al. [203] обеспечивают готовую к промышленному использованию деидентификацию метаданных DICOM и содержимого пикселей. Ответственность остается нерешенной, поскольку автономность нарушает привычную цепочку подотчетности, и когда агент действует без участия человека, остается неясным, на ком лежит ответственность — вопрос, на который текущие правовые базы не были рассчитаны [167, 186, 193], и который напрямую связывает этот уровень с парадигмой саморазвивающегося обучения из раздела 6.6 и регуляторными путями, обсуждаемыми в разделе 8.3⟧.
9.6 Путь вперед
Пять уровней, описанных выше, не являются тупиковыми, а представляют собой программу исследований, которую мы структурируем по временному горизонту в Таблице 4 и на Рис. 9, чтобы краткосрочные, среднесрочные и долгосрочные усилия воспринимались как единая траектория, а не как список пожеланий. В краткосрочной перспективе приоритетом является обеспечение измеримости и безопасности прогресса посредством стандартизированной оценки процессов рассуждения [105], обнаружения галлюцинаций в режиме реального времени [190], принципиального масштабирования среды экосистемы инструментов [62] и интерфейсов агентов для клиницистов, которые делают сотрудничество эффективным, а не обременительным [273]. В среднесрочной перспективе акцент смещается с устранения ограничений на развитие нативных возможностей: создание волюметрических агентов на основе эффективной 3D и 4D токенизации [83], лонгитюдное моделирование на длительных временных шкалах пациентов [293], федеративные агенты, обучающиеся на разных площадках без централизации данных [179], и регуляторная зрелость, необходимая для сертификации многошаговых рассуждений [167]. Долгосрочная перспектива предполагает создание агентов, действующих в реальном мире, включая воплощенную и управляемую изображениями роботизированную интеграцию [82], автономный скрининг на уровне популяции [127], мультиомическую прецизионную медицину [175] и саморазвивающиеся экосистемы, которые непрерывно совершенствуются после развертывания [58], замыкая цикл обратно к саморазвитию, которое в данном обзоре рассматривалось как центральная возможность и центральная проблема управления..
| Horizon | Direction | Key Research Questions | Expected Impact |
| Near term | Standardized evaluation [105] | How to evaluate agent reasoning processes? | Reproducible comparison |
| Hallucination detection [190] | Real time grounding verification? | Clinical safety assurance | |
| Environment scaling [62] | Optimal tool ecosystem composition? | Amplified agent capability | |
| Human agent interaction [273] | Optimal clinician agent interfaces? | Effective collaboration | |
| Medium | Native 3D/4D agents [83] | Efficient volumetric tokenization? | Comprehensive interpretation |
| Longitudinal modeling [293] | Long horizon patient timelines? | Progression tracking | |
| Federated agents [179] | Privacy preserving multisite learning? | Equitable agents | |
| Regulatory maturation [167] | How to certify multistep reasoning? | Legal deployment | |
| Long term | Embodied agents [82] | Image guided robotic integration? | Autonomous procedures |
| Autonomous screening [127] | Population level deployment? | Universal access | |
| Precision medicine [175] | Multi omic integration? | Personalized treatment | |
| self-evolving ecosystems [58] | Continual self improvement? | Adaptive AI |
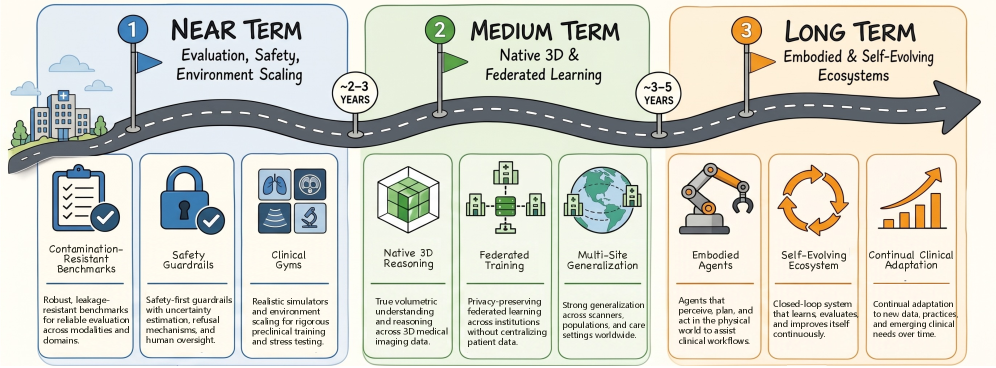
10 Будущие направления
Область медицинских агентов стремительно развивается (Рис. 9, Таблица 4). Мы классифицируем будущие направления по трем временным горизонтам, основываясь на ожидаемой технической зрелости и клинической готовности..
10.1 Перспективные направления в ближайшем будущем
Стандартизированные протоколы оценки. Текущие бенчмарки в основном оценивают возможности отдельных моделей, а не сквозные агентные рабочие процессы, включая оркестрацию инструментов, многошаговое рассуждение и восстановление после ошибок. Разработка консенсусных протоколов оценки, которые учитывают эти специфические для агентов аспекты, является насущной потребностью. Ранние попытки, такие как MedAgentBench [105], предоставляют первоначальные структуры, но стандартизация в масштабах сообщества остается открытой задачей..
Надежное обнаружение галлюцинаций. Внедрение практических методов обнаружения галлюцинаций в качестве уровня безопасности внутри конвейеров агентов имеет решающее значение перед их клиническим применением. Это может включать проверку визуального обоснования, которая подтверждает, подкреплены ли сгенерированные выводы конкретными областями изображения, а также проверку согласованности рассуждений на промежуточных этапах работы агента..
Масштабирование среды для медицинских агентов. Систематическое расширение сред клинических инструментов, доступных агентам, посредством стандартизированных профилей MCP и комплексных реестров инструментов представляет собой перспективную стратегию ближайшего будущего для улучшения возможностей без переобучения. Первоначальные работы по проектированию среды инструментов [230] показывают, что это направление технически осуществимо в рамках существующей инфраструктуры..
Дизайн взаимодействия человека и агента. То, как агенты должны представлять диагностическую неопределенность, запрашивать уточнения и учитывать обратную связь от клинициста, остается недостаточно изученным. Исследования парадигм взаимодействия, которые балансируют автономность агента с надзором со стороны клинициста, вероятно, определят практическое внедрение кооперативных (уровень 2) систем..
10.2 Перспективные направления на среднесрочную перспективу
Нативные 3D и 4D агентные архитектуры. Большинство современных агентов обрабатывают объемные данные послойно или через 2D-проекции, теряя пространственный и временной контекст. Разработка агентов с нативным объемным и временным восприятием, способных рассуждать непосредственно над 3D CT/MRI объемами и продольными 4D последовательностями, лучше соответствовала бы тому, как радиологи интерпретируют сложные исследования..
Продольное моделирование пациентов. Клиническая диагностика часто зависит от сравнения с предыдущими исследованиями. Агенты, способные поддерживать комплексные модели пациентов, охватывающие несколько временных точек визуализации, интегрирующие изменения в результатах, реакциях на лечение и траекториях заболеваний, могут существенно повысить точность диагностики прогрессирующих и хронических состояний..
Мультиинституциональные федеративные агенты. Обучение агентов в нескольких учреждениях при сохранении конфиденциальности пациентов остается фундаментальной проблемой. Подходы федеративного обучения, адаптированные для обучения агентов, при которых опыт и конфигурации инструментов могут быть разделены без централизации данных пациентов, могут обеспечить более широкую генерализацию..
Созревание нормативно-правовой базы. Существующие правила для медицинских изделий были разработаны для статического программного обеспечения. Нормативные базы, учитывающие динамическую, многоэтапную природу агентных систем и их способность вызывать инструменты, включая проверку цепочек рассуждений и безопасность последовательностей инструментов, будут иметь решающее значение для клинического внедрения в широких масштабах..
Комплексное масштабирование среды. По мере того как институциональные экосистемы инструментов расширяются, охватывая сотни или тысячи специализированных моделей и источников данных, механизмы автоматизированного обеспечения качества инструментов, динамического обнаружения инструментов и корректного снижения функциональности при сбоях инструментов будут становиться все более важными..
10.3 Перспективные направления развития
Воплощенные медицинские агенты. Интеграция медицинских агентов с роботизированными системами может обеспечить вмешательства под визуальным контролем с обратной связью, при которых агент непрерывно интерпретирует интраоперационные изображения и корректирует траектории хирургических инструментов в режиме реального времени. Это требует достижений как в области вывода в реальном времени, так и в области критически важного для безопасности управления..
Автономные системы скрининга. Полностью автономные (уровень 3) агенты для скрининга на популяционном уровне, где система независимо проводит сортировку, диагностику и маршрутизацию пациентов при минимальном контроле со стороны человека, могут стать осуществимыми по мере совершенствования надежности и нормативно-правовой базы. Такие системы могут существенно расширить доступ к интерпретации изображений экспертного уровня в условиях ограниченных ресурсов..
Интеграция прецизионной медицины. Глубокая интеграция медицинских агентов с геномными, протеомными и лонгитюдными клиническими данными может обеспечить по-настоящему персонализированные рекомендации по диагностике и лечению, которые учитывают индивидуальную биологию пациента, а не статистику на уровне популяции..
саморазвивающиеся агентные экосистемы. В долгосрочной перспективе мы ожидаем появления агентных экосистем, которые непрерывно совершенствуются за счет накопленного клинического опыта, формируя институциональные базы знаний и адаптируясь к меняющимся паттернам заболеваний, новым методам визуализации и обновленным клиническим рекомендациям без необходимости явного дообучения.
11 Заключение
В данном обзоре представлено всестороннее исследование медицинских агентов — стремительно развивающейся парадигмы, которая расширяет возможности искусственного интеллекта в медицинской визуализации от пассивных, узкоспециализированных моделей до автономных систем, способных к восприятию, рассуждению, планированию, использованию памяти, инструментов и саморефлексии. Мы формализовали медицинских агентов как процесс последовательного принятия решений в условиях частичной наблюдаемости, реализованный через шесть взаимодействующих когнитивных модулей, подчеркнув, что медицинская агентность по своей сути является вопросом действий в условиях частичной наблюдаемости, и предложили трехуровневую таксономию, которая предлагает единый взгляд на разнообразный ландшафт существующих систем..
Наш анализ показывает, что агентная парадигма устраняет фундаментальные ограничения предыдущих подходов за счет обеспечения многошаговых клинических рабочих процессов, динамической оркестровки инструментов, контекстной памяти и итеративного самосовершенствования. Мы аргументировали, что возможности масштабируются не столько за счет «сырого» размера модели, сколько за счет цикла выполнения, который управляет шестью ключевыми когнитивными модулями, организовали архитектурное пространство в три парадигмы — от дополнения инструментов одним агентом до оркестрованных топологий, — и переосмыслили адаптацию как единую лестницу сигналов контроля: от замороженного промптинга через демонстрацию, предпочтения и верифицируемое вознаграждение к опыту, генерируемому самостоятельно. Пересекая эту лестницу ортогонально, три оси масштабирования — параметров, времени тестирования и среды — проясняют, за счет чего приобретаются дополнительные возможности, и мы выделили масштабирование среды, то есть обогащение инструментов, данных и интерфейсной среды, как наиболее оперативно применимый рычаг для агентов, которые уже функционируют в насыщенных инструментами клинических экосистемах..
Клинические приложения, рассмотренные в областях радиологии, патологии, офтальмологии, онкологии, неврологии и кросс-модальных сред, демонстрируют как перспективность, так и текущие ограничения медицинских агентов. Наш обзор реального внедрения дополнительно показывает, что успешная трансляция зависит не только от точности модели, но и от продуктовизации, интероперабельности через DICOM, HL7 FHIR и появляющиеся протоколы агентной коммуникации, а также от развивающихся регуляторных рамок. При рассмотрении конвейера агентов ключевые проблемы остаются в области трехмерного и видеовосприятия, устойчивого к галлюцинациям рассуждения, надежной координации мультиагентных систем, эффективного развертывания и заслуживающей доверия оценки, а также вопросов управления, охватывающих справедливость, конфиденциальность и ответственность..
Заглядывая в будущее, можно сказать, что конвергенция все более мощных мультимодальных базовых моделей, стандартизированной интеграции инструментов и масштабирования среды, наряду с растущим клиническим спросом на интеллектуальную автоматизацию рабочих процессов, создает надежный путь к более широкому клиническому внедрению медицинских агентов. Хотя саморазвивающиеся медицинские агенты остаются скорее перспективным рубежом, чем решенной задачей, постоянное сотрудничество между исследователями в области AI, клиницистами, регуляторами и администраторами здравоохранения будет иметь решающее значение для обеспечения безопасности, справедливости и клинической согласованности этих систем. Основы, рассмотренные в этом обзоре, позволяют предположить, что в ближайшее десятилетие произойдет существенная трансформация того, как медицинские изображения интерпретируются, передаются и используются для принятия решений, что повысит качество, эффективность, доступность и своевременность диагностической визуализации в различных медицинских учреждениях..
Список литературы
- ⟦Achiam et al. [2023] Джош Ачиам, Стивен Адлер, Сандини Агарвал, Лама Ахмад, Ильге Аккая, Флоренсия Леони Алеман, Диого Алмейда, Янко Альтеншмидт, Сэм Альтман, Шьямал Анадкат и др. Технический отчет Gpt-4. arXiv preprint arXiv:2303.08774, 2023.
- ⟦Adams et al. [2025] Лиза Адамс, Феликс Буш, Тяньюй Хань, Жан-Батист Экскофье, Матье Ортала, Александр Лёзер, Хьюго Дж. В. Л. Артс, Якоб Николас Катер, Даниэль Трун и Кено Брессем. Longhealth: бенчмарк для QA с длинными клиническими документами. Journal of Healthcare Informatics Research, 9(3):280–296, 2025.
- ⟦Aghaee et al. [2026] Арман Агаи, Сепехр Асгарян и Джухён Чон. Synthagent: мультиагентная LLM-структура для реалистичного моделирования пациентов — тематическое исследование ожирения с сопутствующими психическими расстройствами. arXiv preprint arXiv:2602.08254, 2026.
- ⟦Ahadian et al. [2025] Пегах Ахадиан, Мингруй Янг, Ева Паулисон, Сяоцзюань Ли, Вэй Сюй и Цян Гуань. Oaagent: Мультимодальный LLM агент для прогнозирования прогрессирования остеоартрита коленного сустава. В материалах международной конференции ACM/IEEE по подключенному здравоохранению: приложения, системы и инженерные технологии, страницы 144–148, 2025.
- ⟦Almansoori et al. [2025] Мохаммад Альмансури, Комал Кумар и Хишам Чолаккал. Саморазвивающиеся мультиагентные симуляции для реалистичных клинических взаимодействий. arXiv preprint arXiv:2503.22678, 2025.
- ⟦Anthropic [2025a] Anthropic. Эффективная разработка контекста для AI агентов. Блог инженерии Anthropic, 2025a. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents, дата обращения 2026-06-14.
- ⟦Anthropic [2025b] Anthropic. Эффективные системы контроля для долгосрочно функционирующих агентов. Блог инженеров Anthropic, 2025b. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents, дата обращения 2026-06-14.
- ⟦Arora et al. [2025] Рахул К. Арора, Джейсон Вей, Ребекка Соскин Хикс, Престон Боумен, Хоакин Киньонеро-Кандела, Фойвос Цимпурлас, Майкл Шарман, Меган Шах, Андреа Валлоне, Алекс Бойтель и др. Healthbench: Оценка LLM для улучшения здоровья человека. arXiv preprint arXiv:2505.08775, 2025.
- ⟦Bai et al. [2025] Шуай Бай, Юйсюань Цай, Жуйчжэ Чэнь, Кэцинь Чэнь, Сюнхуэй Чэнь, Зесэнь Чэн, Лянхао Дэн, Вэй Дин, Чан Гао, Чуньцзян Гэ и др. Технический отчет Qwen3-vl. arXiv preprint arXiv:2511.21631, 2025.
- ⟦Banerjie et al. [2025] Шрути Банерджи, Юксин Чжу, Айзек Фримен, Джулисса Вилья Мачадо, Абдулазиз Ахмед, Абид Саркер и Мохаммед Аль-Гаради. Агентный AI в здравоохранении: всесторонний обзор основ, таксономии и приложений. Authorea Preprints, 2025.
- ⟦Bani-Harouni et al. [2024] Дэвид Бани-Харуни, Нассир Наваб и Маттиас Кейхер. Magda: Мультиагентная диагностическая помощь на основе клинических рекомендаций. В сборнике: Международный семинар по фундаментальным моделям для общей медицинской AI, страницы 163–172. Springer, 2024.
- ⟦Bannur et al. [2024] Shruthi Bannur, Kenza Bouzid, Daniel C Castro, Anton Schwaighofer, Anja Thieme, Sam Bond-Taylor, Maximilian Ilse, Fernando Pérez-García, Valentina Salvatelli, Harshita Sharma, et al. Maira-2: Генерация радиологических отчетов с привязкой к изображениям. arXiv preprint arXiv:2406.04449, 2024.
- ⟦Bassi et al. [2025] Педро РАС Басси, Мехмет Джан Явуз, Ибрагим Этем Хамамджи, Сезгин Эр, Сяоси Чен, Вэньсюань Ли, Бьорн Менце, Серджио Дечерчи, Андреа Кавалли, Кан Ван и др. Radgpt: Создание наборов данных 3d изображений и текстов опухолей. В материалах международной конференции IEEE/CVF по компьютерному зрению, страницы 23720–23730, 2025.
- ⟦Bedi et al. [2025] Сухана Беди, Хеджи Цуй, Мигель Фуэнтес, Алисса Юнелл, Майкл Ворноу, Хуан М. Банда, Никеш Котеча, Тимоти Киз, Ифань Май, Мерт Оез и др. Medhelm: Комплексная оценка LLM для медицинских задач. arXiv preprint arXiv:2505.23802, 2025.
- ⟦Bedi et al. [2026] Сухана Беди, Райан Уэлч, Итан Стейнберг, Майкл Ворноу, Тэил Мэттью Ким, Харун Ахмед, Питер Стерлинг, Бравим Пурохит, Курат Акрам, Анжелик Акоста и др. Healthadminbench: Оценка агентов по использованию компьютера в задачах администрирования здравоохранения. arXiv preprint arXiv:2604.09937, 2026.
- ⟦Besta et al. [2024] Мацей Беста, Нильс Блах, Алеш Кубичек, Роберт Герстенбергер, Михал Подставски, Лукас Джанинацци, Джоанна Гайда, Томаш Леманн, Хуберт Невядомски, Петр Ничик и др. Graph of thoughts: Решение сложных задач с помощью LLM. В материалах конференции AAAI по искусственному интеллекту, том 38, страницы 17682–17690, 2024.
- ⟦Bluethgen et al. [2025] Кристиан Блютген, Дэйв Ван Вин, Дэниел Трун, Якоб Николас Катер, Майкл Мур, Малгожата Полачин, Акшай Чаудхари, Томас Фрауэнфельдер, Кертис П. Ланглоц, Майкл Краутхаммер и др. Агентные системы в радиологии: проектирование, приложения, оценка и проблемы. arXiv preprint arXiv:2510.09404, 2025.
- ⟦Boecking et al. [2022] Бенедикт Бекинг, Наото Усуяма, Шрути Баннур, Дэниел К. Кастро, Антон Швайгофер, Стефани Хайленд, Мария Ветшерек, Тристан Науманн, Адитья Нори, Хавьер Альварес-Валье и др. Максимальное использование семантики текста для улучшения биомедицинской обработки визуально-языковых данных. В сборнике: Европейская конференция по компьютерному зрению, страницы 1–21. Springer, 2022.
- ⟦Bose et al. [2025] Саросидж Боуз, Рави К. Раджендран, Биплоб Дебнат, Константинос Каридис, Амит К. Рой-Чоудхури и Сримат Чакрадхар. Визуальное выравнивание медицинских vision-language models для обоснованной генерации радиологических отчетов. arXiv preprint arXiv:2512.16201, 2025.
- ⟦Budathoki and Dhakal [2025] Анджила Будатоки и Маниш Дхакал. Анализ состязательной устойчивости vision-language models в сегментации медицинских изображений. arXiv preprint arXiv:2505.02971, 2025.
- ⟦Cai et al. [2025] Синь-Цян Цай, Вэй Ван, Фэн Лю, Тунлян Лю, Ган Ню и Масаси Сугияма. Обучение с подкреплением с проверяемыми, но зашумленными наградами при несовершенных верификаторах. arXiv preprint arXiv:2510.00915, 2025.
- ⟦Cao et al. [2026] Руйке Цао, Шаоцзе Бай, Фуген Яо, Лян Дун, Цзянь Сюй и Ли Сяо. Atpo: Адаптивная оптимизация древовидной политики для многоходового медицинского диалога. arXiv preprint arXiv:2603.02216, 2026.
- ⟦Carvalho et al. [2025] Эдуарду Карвалью, Мигель Маскареньяш, Франсишка Пиньейру, Рикарду Коррейя, Сандра Балсейру, Гильерме Барбоза, Ана Герра, Дулсе Оливейра, Рита Моура, Андре Мартинш душ Сантуш и др. Планы контроля изменений с заранее определенными параметрами: руководящие принципы для развития безопасных, эффективных и высококачественных технологий AI-ML. JMIR AI, 4:e76854, 2025.
- ⟦Chaves et al. [2024] Хуан Мануэль Самбрано Чавес, Ши-Ченг Хуанг, Янбо Сюй, Ханвен Сюй, Наото Усуяма, Шенг Чжан, Фей Ван, Юцзя Се, Махмуд Хадеми, Цзыи Ян и др. На пути к клинически доступной базовой модели радиологии: открытый доступ и легковесность с автоматизированной оценкой. arXiv preprint arXiv:2403.08002, 2024.
- ⟦Chen et al. [2025a] Айли Чен, Аониан Ли, Бангвей Гонг, Биньян Цзян, Бо Фей, Бо Ян, Боджи Шань, Чанцин Юй, Чао Ван, Чэн Чжу и др. Minimax-m1: Эффективное масштабирование вычислений во время тестирования с помощью lightning attention. arXiv preprint arXiv:2506.13585, 2025a.
- ⟦Chen et al. [2024a] Каньюй Чэнь, Цзянь Юй, Шань Чэнь, Чэ Лю, Чжунвэй Ван, Даниэль Биттерман, Фэй Ван и Кай Шу. Clinicalbench: могут ли LLM превзойти традиционные ML модели в клиническом прогнозировании? arXiv preprint arXiv:2411.06469, 2024a.
- ⟦Chen et al. [2026a] Хаолинь Чэнь, Деон Метельски, Леон Ци, Тао Ся, Джунъюль Ли, Стив Браун, Кевин Райли, Фрэнк Ван, Т. И. Лю, Хэнк Кэппс (доктор медицины) и др. Chi-bench: могут ли AI агенты автоматизировать комплексные, долгосрочные и насыщенные правилами клинические рабочие процессы? arXiv preprint arXiv:2605.16679, 2026a.
- ⟦Chen et al. [2021] Айрин И. Чен, Эмма Пирсон, Шерри Роуз, Шалмали Джоши, Кадиджа Ферриман и Марзие Гассеми. Этичное машинное обучение в здравоохранении. Annual review of biomedical data science, 4(1):123–144, 2021.
- ⟦Chen et al. [2025b] Цзинъюнь Чэнь, Линхань Цай, Чжикан Ван, И Хуан, Сунхань Цзян, Шэньцзинь Хуан, Хунпэн Ван и Юнбин Чжан. Pathagent: На пути к интерпретируемому анализу полнокадровых патологических изображений с помощью агентных рассуждений на основе LLM. arXiv preprint arXiv:2511.17052, 2025b.
- ⟦Chen et al. [2025c] Кай Чен, Синфэн Ли, Тяньпэй Ян, Хэвэй Ван, Вэй Дун и Ян Гао. Mdteamgpt: саморазвивающаяся мультиагентная структура на основе LLM для междисциплинарных медицинских консультаций. arXiv preprint arXiv:2503.13856, 2025c.
- ⟦Chen et al. [2025d] Кай Чен, Тайхан Чжэнь, Хэвэй Ван, Кайлай Лю, Синьфэн Ли, Цзин Хо, Тяньпэй Ян, Цзиньфэн Сюй, Вэй Дун и Ян Гао. Medsentry: Понимание и снижение рисков безопасности в медицинских мультиагентных системах на базе LLM. arXiv preprint arXiv:2505.20824, 2025d.
- ⟦Chen et al. [2024b] Ричард Дж. Чен, Тонг Динг, Минг И. Лу, Дрю Ф. К. Уильямсон, Гийом Жом, Эндрю Х. Сонг, Боуэн Чен, Эндрю Чжан, Дэниел Шао, Мухаммад Шабан и др. На пути к универсальной базовой модели для вычислительной патологии. Nature medicine, 30(3):850–862, 2024b.
- ⟦Chen et al. [2025e] Шан Чен, Педро Морейра, Юйсинь Сяо, Сэм Шмидгалл, Джереми Уорнер, Хьюго Артс, Томас Хартвигсен, Джек Галлифант и Даниэль С. Биттерман. Medbrowsecomp: бенчмаркинг медицинских глубоких исследований и использования компьютера. arXiv preprint arXiv:2505.14963, 2025e.
- ⟦Chen et al. [2025f] Вэньтин Чэнь, И Дун, Чжаоцзюнь Дин, Юйчэн Ши, Ифань Чжоу, Фан Цзэн, Ицзюнь Ло, Тяньюй Линь, Ихан Су, Ичэнь У и др. Radfabric: Агентная система ИИ с возможностями рассуждения для радиологии. arXiv preprint arXiv:2506.14142, 2025f.
- ⟦Chen et al. [2026b] Иньчжу Чэнь, Абдин Майга, Хоссейн А. Рахмани и Эмине Йылмаз. Автоматизированные рубрики для надежной оценки медицинских диалоговых систем. arXiv preprint arXiv:2601.15161, 2026b.
- ⟦Chen et al. [2026c] Исюнь Чэнь, Синьи Бай, Юэ Пань, Цзунвэй Чжоу и Алан Юйлле. Meissa: Мультимодальный медицинский агентный интеллект. arXiv preprint arXiv:2603.09018, 2026c.
- ⟦Chen et al. [2024c] Чжэ Чэнь, Цзяньнань У, Вэньхай Ван, Вэйцзе Су, Го Чэнь, Сэнь Син, Муянь Чжун, Цинлун Чжан, Сичжоу Чжу, Левей Лу и др. Internvl: Масштабирование базовых моделей зрения и их выравнивание для общих визуально-лингвистических задач. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 24185–24198, 2024c.
- ⟦Chen et al. [2024d] Чжихун Чен, Майя Варма, Жан-Бенуа Дельбрук, Магдалини Пасхали, Луи Бланкмейер, Дэйв Ван Вин, Джая Мария Хосе Валанарасу, Алаа Юссеф, Джозеф Пол Коэн, Эдуардо Понтес Рейс и др. Chexagent: На пути к фундаментальной модели для интерпретации рентгеновских снимков грудной клетки. В материалах весеннего симпозиума AAAI 2024 по клиническим фундаментальным моделям, 2024d.
- ⟦Choi et al. [2024] Джихе Чой, Нилс Палумбо, Прасад Чаласани, Мэттью М. Энгельхард, Сомеш Джа, Аниварья Кумар и Дэвид Пейдж. Malade: Оркестрация агентов на базе LLM с использованием retrieval augmented generation для фармаконадзора, 2024. URL https://arxiv.org/abs/2408.01869⟧.
- ⟦Cofala et al. [2025] Тим Кофала, Кристиан Калфар, Цзинге Сяо, Йоханна Шрадер, Мишель Танг и Вольфганг Нейдл. Medai: Оценка терапевтического агентного рассуждения txagent в конкурсе neurips cure-bench. arXiv preprint arXiv:2512.11682, 2025.
- ⟦Committee [2021] Комитет по автоматизированному вождению на дорогах (ORAD). Таксономия и определения терминов, относящихся к системам автоматизации вождения для дорожных транспортных средств. SAE international, 2021.
- ⟦DeLucia et al. [2026] Александра ДеЛюсия, Хеюань Хуан, Сонал Джоши, Махса Ярмохаммади, Ахмед Хассун и Марк Дредзе. Тот же вердикт, разные причины: разногласия между LLM-as-a-judge и клиницистами относительно полноты ответов медицинских чат-ботов. arXiv preprint arXiv:2604.16383, 2026.
- ⟦Deng et al. [2025] Иян Дэн, Шэнь Чжао, Юнмин Мяо, Цзюньцзе Чжу и Цзинь Ли. Medka: подход с использованием графа знаний для повышения фактической точности медицинских LLM. Journal of Biomedical Informatics, страница 104871, 2025.
- ⟦Deperrois et al. [2025] Николас Деперруа, Хидетоши Мацуо, Сэмюэл Руиперес-Кампильо, Мориц Ванденхирц, Соня Лагуна, Ален Райзер, Кодзи Фудзимото, Мизухо Нишио, Томас М. Саттер, Джулия Э. Фогт и др. Radvlm: многозадачная диалоговая vision-language model для радиологии. arXiv preprint arXiv:2502.03333, 2025.
- ⟦Dietrich [2025] Николас Дитрих. Агентный искусственный интеллект в радиологии: возникающий потенциал и нерешенные проблемы. Британский журнал радиологии, 98(1174):1582–1584, 2025.
- ⟦Ding et al. [2025] Ифэн Дин, Хунг Ле, Сунъян Хан, Канжуй Жуань, Чжэнхуэй Цзинь, Варун Кумар, Цзыцзянь Ван и Ануп Деорас. Расширение возможностей агентных рассуждений с интеграцией инструментов в многоходовом режиме с помощью GRPO. Препринт arXiv:2511.14846, 2025.
- ⟦Dong et al. [2025] Гуаньтин Дун, Личэн Бао, Чжунъюань Ван, Канчжи Чжао, Сяоси Ли, Цзяцзе Цзинь, Цзинхань Ян, Ханьюй Мао, Фучжэн Чжан, Кунь Гай и др. Оптимизация стратегии с балансировкой агентной энтропии. Препринт arXiv:2510.14545, 2025.
- ⟦Dong et al. [2026a] Гуаньтин Дун, Цзюньтин Лу, Цзюньцзе Хуан, Ваньцзюнь Чжун, Лунсян Лю, Шицзюэ Хуан, Чжэньюй Ли, Ян Чжао, Сяошуай Сун, Сяоси Ли и др. Agent-world: Масштабирование синтеза реальной среды для развития общего агентного интеллекта. arXiv preprint arXiv:2604.18292, 2026a.
- ⟦Dong et al. [2026b] Сюаньчжао Дун, Вэньхуэй Чжу, Сивэнь Чэнь, Хао Ван, Синь Ли, Юйцзянь Сюн, Цзяцзюнь Чэн, Цзинцзин Ван, Сяобин Юй, Хайюй У и др. Ophin-500k: Курирование визуальных инструкций веб-масштаба для масштабирования офтальмологических мультимодальных LLM. arXiv preprint arXiv:2605.27916, 2026b.
- ⟦Du et al. [2026] Юэси Ду, Цзинлу Ван, Шуцзе Лю, Нича К. Дворнек и Ян Лу. Care: На пути к клинической подотчетности в мультимодальных медицинских рассуждениях с использованием агентной структуры, основанной на доказательствах. arXiv preprint arXiv:2603.01607, 2026.
- ⟦Du et al. [2025] Чжоюнь Ду, Луцзе Чжэн, Жэньцзюнь Ху, Юйян Сюй, Сяовэй Ли, Ин Сунь, Вэй Чэнь, Цзянь У, Хаолэй Цай и Хаочао Ин. LLMs могут имитировать стандартизированных пациентов посредством коэволюции агентов. В материалах 63-го ежегодного собрания Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), страницы 17278–17306, 2025.
- ⟦Ehtesham et al. [2025a] Абул Эхтешам, Адити Сингх, Гаурав Кумар Гупта и Сакет Кумар. Обзор протоколов интероперабельности агентов: Model context protocol (mcp), agent communication protocol (acp), agent-to-agent protocol (a2a) и agent network protocol (anp). arXiv preprint arXiv:2505.02279, 2025a.
- ⟦Ehtesham et al. [2025b] Абул Эхтешам, Адити Сингх и Сакет Кумар. Улучшение поддержки принятия клинических решений и аналитики EHR с помощью LLM и протокола контекста модели: фреймворк MCP-FHIR с открытым исходным кодом. В материалах: 2025 IEEE World AI IoT Congress (AIIoT), страницы 0205–0211. IEEE, 2025b.
- ⟦Ekram [2026] Ташфин Экрам. Red-teaming medical ai: Систематическая состязательная оценка механизмов защиты LLM в клинических контекстах. medRxiv, страницы 2026–02, 2026.
- ⟦Elboardy et al. [2025] Ахмед Т. Элборди, Гада Хориба и Эссам А. Рашед. Медицинский консенсус искусственного интеллекта: мультиагентная система для создания и оценки радиологических отчетов. arXiv preprint arXiv:2509.17353, 2025.
- ⟦Erdur et al. [2026] Айхан Джан Эрдур, Даниэль Шольц, Цзячжэнь Пань, Бенедикт Вистлер, Даниэль Рюкерт и Ян К. Пикен. Агентные LLM для нейрорадиологического анализа изображений без обучения. arXiv preprint arXiv:2604.16729, 2026.
- ⟦Fallahpour et al. [2025] Адибвафа Фаллахпур, Джун Ма, Алиф Муним, Хонгвей Лю и Бо Ван. Medrax: медицинский агент для рассуждения по рентгеновским снимкам грудной клетки. arXiv preprint arXiv:2502.02673, 2025.
- ⟦Fan et al. [2026] Лин Фань, Пэнъюй Дай, Чжипэн Дэн, Хаолинь Ван, Сюнь Гун, Ефэн Чжэн и Яфэй Оу. Развитие медицинских агентов визуализации посредством самостоятельного обнаружения навыков на основе опыта. arXiv preprint arXiv:2603.05860, 2026.
- ⟦Fan et al. [2025a] Юнчи Фань, Хунли Сунь, Куй Сюэ, Сяофань Чжан, Шаотин Чжан и Тун Жуань. Medodyssey: эталонный тест в медицинской области для оценки длинного контекста до 200 тысяч токенов. В сборнике материалов Ассоциации компьютерной лингвистики: NAACL 2025, страницы 32–56, 2025a.
- ⟦Fan et al. [2025b] Цзыцин Фань, Чэн Лян, Чаои У, Я Чжан, Яньфэн Ван и Вэйди Се. Chestx-reasoner: Совершенствование базовых моделей радиологии с помощью рассуждений посредством пошаговой верификации. arXiv preprint arXiv:2504.20930, 2025b.
- ⟦Fang et al. [2025a] Цзиньюань Фан, Яньвэнь Пэн, Си Чжан, Инсюй Ван, Синьхао И, Гуйбинь Чжан, И Сюй, Бинь У, Сывэй Лю, Цзыхао Ли и др. Комплексный обзор саморазвивающихся AI agents: новая парадигма, объединяющая foundation models и lifelong agentic systems. arXiv preprint arXiv:2508.07407, 2025a.
- ⟦Fang et al. [2025b] Руннан Фанг, Шихао Цай, Байсюань Ли, Цзялун У, Гуаньюй Ли, Вэньбяо Инь, Синьюй Ван, Сяобинь Ван, Лянцай Су, Чжэнь Чжан и др. На пути к общему агентному интеллекту посредством масштабирования среды. arXiv preprint arXiv:2509.13311, 2025b.
- ⟦Feng et al. [2025a] Цзинхао Фэн, Цяоюй Чжэн, Чаои У, Цзыхэн Чжао, Я Чжан, Яньфэн Ван и Вэйди Се. M 3 builder: Мультиагентная система для автоматизированного машинного обучения в медицинской визуализации. В сборнике: Международный семинар по агентному ИИ в медицине, страницы 115–124. Springer, 2025a.
- ⟦Feng et al. [2025b] Кевин Дж. Фенг, Дэвид У. Макдональд и Эми Х. Чжан. Уровни автономности для AI агентов. arXiv preprint arXiv:2506.12469, 2025b.
- ⟦Feng et al. [2026] Ичунь Фэн, Цзявэй Ван, Лу Чжоу, Чжэнь Лэй и Исюэ Ли. Doctoragent-rl: многоагентная система обучения с подкреплением для многоходового клинического диалога. В материалах ICASSP 2026 — Международной конференции IEEE по акустике, речи и обработке сигналов (ICASSP), страницы 16952–16956. IEEE, 2026.
- ⟦Ferber et al. [2025] Дайк Фербер, Омар СМ Эль Наххас, Георг Вёльфлейн, Изабелла К Вист, Ян Клусманн, Мари-Элизабет Лессманн, Себастьян Фёрш, Жаклин Ламмерт, Максимилиан Чохохей, Дирк Егер и др. Разработка и валидация автономного агента искусственного интеллекта для принятия клинических решений в онкологии. Nature cancer, 6(8):1337–1349, 2025.
- ⟦Froger et al. [2025] Ромен Фроже, Пьер Эндрюс, Маттео Беттини, Амар Будхираджа, Рикардо Силвейра Кабрал, Виржини До, Эмильен Гарро, Жан-Батист Гайя, Юго Лорансон, Максим Лекану и др. Are: Масштабирование агентных сред и оценок. arXiv preprint arXiv:2509.17158, 2025.
- ⟦Gao et al. [2025a] Хуань-ан Гао, Цзяи Гэн, Вэньюэ Хуа, Мэнканг Ху, Синьчжэ Хуань, Хунчжан Лю, Шилун Лю, Цзяхао Цю, Сюань Ци, Ижань У и др. Обзор саморазвивающихся агентов: что, когда, как и где развивать на пути к искусственному суперинтеллекту. arXiv preprint arXiv:2507.21046, 2025a.
- ⟦Gao et al. [2023] Лую Гао, Аман Мадаан, Шуян Чжоу, Ури Алон, Пэнфэй Лю, Имин Ян, Джейми Каллан и Грэм Нойбиг. Pal: Program-aided language models. В сборнике: International conference on machine learning, страницы 10764–10799. PMLR, 2023.
- ⟦Gao et al. [2025b] Шанхуа Гао, Ричард Чжу, Чжэнлунь Кун, Аюш Нури, Сяожуй Су, Кертис Гиндер, Теодорос Цилигикаридис и Маринка Зитник. Txagent: ИИ-агент для терапевтического рассуждения с использованием множества инструментов, 2025b. URL https://arxiv.org/abs/2503.10970.
- ⟦Gao et al. [2026] Ифань Гао, Тао Чжоу, И Чжоу, Ке Цзоу, Ичжэ Чжан и Хуачжу Фу. Улучшение медицинского визуального обоснования с помощью пространственных подсказок, управляемых знаниями. arXiv preprint arXiv:2604.01915, 2026.
- ⟦Ge et al. [2026] Чжуохань Гэ, Хаоян Ли, Юбо Ван, Николь Ху, Чэнь Джейсон Чжан и Цин Ли. Clinicalagents: многоагентная оркестровка для принятия клинических решений с использованием двойной памяти. arXiv preprint arXiv:2603.26182, 2026.
- ⟦Ghafoor et al. [2026] Зайнаб Гафур, Мд Шафикул Ислам, Коушик Хауладер, Мд Расел Хондокар, Танусри Бхаттачарджи, Саянтан Чакраборти, Адрито Рой, Ушаши Бхаттачарджи и Тиртхо Рой. Повышение безопасности и надежности медицинских AI с помощью многоагентных циклов оценки. arXiv preprint arXiv:2601.13268, 2026.
- ⟦Ghezloo et al. [2025] Фатеме Гезлу, Мехмет Сайгин Сейфиоглу, Растин Сораки, Висдом О Икезогво, Бейбин Ли, Теджорам Вивеканандан, Джоанн Г Элмор, Ранджай Кришна и Линда Шапиро. Pathfinder: мультимодальная мультиагентная система для принятия медицинских диагностических решений, применяемая в гистопатологии. В материалах международной конференции IEEE/CVF по компьютерному зрению, страницы 23431–23441, 2025.
- ⟦Gong et al. [2026] Леченг Гонг, Веймин Фанг, Тинг Янг, Донгджи Тао, Чунсяо Го, Пенг Вей, Бо Се, Джинкун Гуан, Зисяо Чен, Фанг Ши и др. Meddialogrubrics: Комплексный бенчмарк и система оценки многоходовых медицинских консультаций в LLM. arXiv preprint arXiv:2601.03023, 2026.
- ⟦Grattafiori et al. [2024] Аарон Граттафиори, Абхиманью Дубей, Абхинав Джаури, Абхинав Пандей, Абхишек Кадиан, Ахмад Аль-Дале, Айша Летман, Ахил Матур, Алан Шелтен, Алекс Воган и др. Семейство моделей Llama 3. arXiv preprint arXiv:2407.21783, 2024.
- ⟦Gu et al. [2025a] Боян Гу, Хунцзянь Чжоу, Брэдли Макс Сигал, Цзинге Ву, Цзэюй Цао, Ханьтао Чжун, Лей Клифтон, Фэнлинь Лю и Дэвид А. Клифтон. Clinical-r1: Расширение возможностей LLM для достоверного и всестороннего рассуждения с помощью GRPO. arXiv preprint arXiv:2512.00601, 2025a.
- ⟦Gu et al. [2025b] Лэй Гу, Инхао Чжу, Хаоран Сан, Цзысян Ван, Дехао Суй, Вэнь Тан, Юэн Харрисон, Цзюньи Гао, Лецюань Юй и Ляньтао Ма. Medagentaudit: диагностика и количественная оценка режимов совместных сбоев в медицинских мультиагентных системах. arXiv preprint arXiv:2510.10185, 2025b.
- ⟦Guo et al. [2025] Дая Го, Децзянь Ян, Хаовэй Чжан, Цзюньсяо Сун, Пэйи Ван, Цихао Чжу, Жуньсинь Сюй, Жоюй Чжан, Шижун Ма, Сяо Би и др. Deepseek-r1: Стимулирование способности к рассуждению в LLM посредством обучения с подкреплением. arXiv preprint arXiv:2501.12948, 2025.
- ⟦Guo et al. [2024] Тайчэн Го, Сюин Чэнь, Яци Ван, Жуйди Чан, Шичао Пэй, Нитеш В. Чавла, Олаф Вист и Сянлян Чжан. Мультиагентные системы на основе LLM: обзор достижений и проблем. arXiv preprint arXiv:2402.01680, 2024.
- ⟦Gupta and Kembhavi [2023] Танмай Гупта и Анируддха Кембхави. Визуальное программирование: Композиционное визуальное рассуждение без обучения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 14953–14962, 2023.
- ⟦Haidegger [2019] Тамаш Хайдеггер. Автономия для хирургических роботов: концепции и парадигмы. IEEE Transactions on Medical Robotics and Bionics, 1(2):65–76, 2019.
- ⟦Hamamci et al. [2026] Ибрагим Этем Хамамджи, Сезгин Эр, Супросанна Шит, Адриен Рейно, Дун Ян, Пэнфэй Го, Марк Эдгар, Дагуан Сюй, Бернхард Кайнц и Бьорн Менце. Лучшие токены для лучшего 3d: развитие vision-language modeling в 3d медицинской визуализации. Advances in Neural Information Processing Systems, 38:135074–135102, 2026.
- ⟦Han et al. [2024] Тесса Хан, Аунон Кумар, Чираг Агарвал и Химабинду Лаккараджу. Medsafetybench: Оценка и повышение медицинской безопасности LLM. Advances in neural information processing systems, 37:33423–33454, 2024.
- ⟦Hasan et al. [2025] Мохаммед Мехеди Хасан, Хао Ли, Эмад Фаллахзаде, Гопи Кришнан Раджбахадур, Брам Адамс и Ахмед Э. Хассан. Протокол контекста модели (mcp) на первый взгляд: Изучение безопасности и удобства сопровождения серверов mcp. ACM Transactions on Software Engineering and Methodology, 2025.
- ⟦He et al. [2026] Чаоюэ Хэ, Синь Чжоу, Ди Ван, Хун Сюй, Вэй Лю и Чуньянь Мяо. Инженерное обеспечение для языковых агентов: уровень обвязки как средство управления, агентности и среды выполнения. 2026.
- ⟦He et al. [2020] Сюэхай Хэ, Ичэнь Чжан, Луньтянь Моу, Эрик Син и Пэнтао Се. Pathvqa: 30000+ вопросов для медицинских визуальных вопросно-ответных систем. arXiv preprint arXiv:2003.10286, 2020.
- ⟦He et al. [2025] Йесяо Хэ, Анг Ли, Бойи Лю, Чжэвэй Яо и Юсюн Хэ. Medorch: Медицинская диагностика с помощью агентов рассуждения, дополненных инструментами, для гибкой расширяемости. arXiv preprint arXiv:2506.00235, 2025.
- ⟦Holmes et al. [2025] Джейсон Холмс, Юэсин Хао, Мариана Боррас-Осорио, Федерико Мастролео, Сантьяго Ромеро Бруфау, Валентина Кардуччи, Кэти М. Ван Абель, Дэвид М. Раутман, Эндрю Ю. К. Фунг, Лив М. Мюллер и др. Radonc-gpt: Автономный LLM агент для маркировки исходов лечения пациентов в режиме реального времени в больших масштабах. arXiv preprint arXiv:2509.25540, 2025.
- ⟦Hong et al. [2024] Сируй Хун, Минчэнь Чжугэ, Джонатан Чен, Сяу Чжэн, Юхэн Чэн, Цзиньлинь Ван, Цэяо Чжан, Стивен Яу, Цзыцзюань Линь, Лиян Чжоу и др. Metagpt: Метапрограммирование для мультиагентной системы совместной работы. В материалах Международной конференции по обучению представлениям, том 2024, страницы 23247–23275, 2024.
- ⟦Hou et al. [2025a] Вэньлун Хоу, Гуанцянь Ян, Е Ду, Ен Лау, Лихао Лю, Цзюньцзюнь Хэ, Лин Лун и Шуцзюнь Ван. Adagent: LLM агент для анализа болезни Альцгеймера с координатором совместной работы. В сборнике: Международный семинар по агентному AI в медицине, страницы 23–32. Springer, 2025a.
- ⟦Hou et al. [2026] Вэньлун Хоу, Шэн Би, Гуанцянь Ян, Лихао Лю, Е Ду, Ханьсяо Сюэ, Цзюньчэн Ван, Юйсян Фэн, Юэ Сюнь, Наньси Юй, Нин Мао, Мо Ян, И Ва Ева Чун, Лин Лун, Кэй Чен Тан, Лэцюань Юй, Сяомэн Ма, Шаочжэнь Янь и Шуцзюнь Ван. Ad-care: LLM агент, основанный на клинических рекомендациях и не зависящий от модальности данных, для диагностики болезни Альцгеймера в реальных клинических условиях с использованием мультикогортной оценки, анализа справедливости и исследования с участием врачей, 2026. URL https://arxiv.org/abs/2603.25322.
- ⟦Hou et al. [2025b] Синьи Хоу, Яньцзе Чжао, Шэнао Ван и Хаоюй Ван. Протокол контекста модели (MCP): ландшафт, угрозы безопасности и будущие направления исследований. ACM Transactions on Software Engineering and Methodology, 2025b.
- ⟦Hu [2025] Цзянь Ху. Reinforce++: Простой и эффективный подход для выравнивания LLM. arXiv e-prints, страницы arXiv–2501, 2025.
- ⟦Hu et al. [2025] Шенгран Ху, Конг Лу и Джефф Клун. Автоматизированное проектирование агентных систем. В материалах Международной конференции по обучению представлений, том 2025, страницы 21344–21377, 2025.
- ⟦Hu et al. [2024] Ютао Ху, Тяньбинь Ли, Цюаньфэн Лу, Вэньци Шао, Цзюньцзюнь Хэ, Юй Цяо и Пин Ло. Omnimedvqa: Новый крупномасштабный комплексный эталонный тест для медицинских LVLM. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 22170–22183, 2024.
- ⟦Huang et al. [2025] Юйчэнь Хуан, Сицзя Ли, Вэй Лю, Чжиюань Фань, И Р. Фанг и др. Масштабирование сред для LLM агентов в эпоху обучения на основе взаимодействия: обзор. В материалах семинара по масштабированию сред для агентов, 2025.
- ⟦Imam et al. [2025] Раза Имам, Руфаэль Марев и Мохаммад Якуб. О надежности медицинских vision-language models: действительно ли они обладают способностью к обобщению? В сборнике Annual Conference on Medical Image Understanding and Analysis, страницы 233–256. Springer, 2025.
- ⟦Jain et al. [2021] Саахил Джайн, Ашвин Агравал, Адриэль Сапорта, Стивен Кью Эйч Труонг, Ду Нгуен Дуонг, Тан Буй, Пьер Шамбон, Юхао Чжан, Мэттью П. Лангрен, Эндрю И. Ын и др. Radgraph: Извлечение клинических сущностей и связей из радиологических отчетов. arXiv preprint arXiv:2106.14463, 2021.
- ⟦Jeong [2026] Минбюль Чон. Спортивный зал медицинского искусственного интеллекта для медицинских агентов. Препринт arXiv:2605.02943, 2026.
- ⟦Jhandi et al. [2025] Поларис Джанди, Овайс Кази, Шреяс Субраманьян и Нил Сендас. Малые языковые модели для эффективного агентного вызова инструментов: превосходство над крупными моделями с помощью целевой SFT. arXiv preprint arXiv:2512.15943, 2025.
- ⟦Jhaveri et al. [2025] Самяк Джавери, Прафул Сингх, Джангвон Ким, Тара Тагхави и Кришнарам Кентхапади. Оптимизация генерации длинных клинических текстов с помощью вознаграждений на основе утверждений. arXiv preprint arXiv:2510.02338, 2025.
- ⟦Ji et al. [2023] Цзывэй Цзи, Наён Ли, Рита Фриске, Тезен Ю, Дан Су, Янь Сюй, Эцуко Исии, Е Цзинь Бан, Андреа Мадотто и Паскаль Фанг. Обзор галлюцинаций в генерации естественного языка. ACM computing surveys, 55(12):1–38, 2023.
- ⟦Jiang et al. [2025a] Эрик Ханчен Цзян, Мэнтин Ли, Гуаньчэн Ван, София Инь, Юйчэнь У, Сяо Лян, Синьфэн Ли, Ичжоу Сунь, Вэй Ван, Кай-Вэй Чан и др. Динамическая генерация топологий коммуникации мульти-LLM агентов с помощью диффузионных моделей на графах. arXiv preprint arXiv:2510.07799, 2025a.
- ⟦Jiang et al. [2025b] Исин Цзян, Камерон К. Блэк, Глория Генг, Дэнни Парк, Джеймс Зоу, Эндрю Ы. Ын и Джонатан Х. Чен. Medagentbench: виртуальная среда EHR для бенчмаркинга медицинских LLM агентов. Nejm Ai, 2(9):AIdbp2500144, 2025b.
- ⟦Jimenez et al. [2024] Карлос Э. Хименес, Джон Ян, Александр Веттиг, Шуньюй Яо, Кесин Пей, Офир Пресс и Картик Нарасимхан. Swe-bench: Могут ли LLM решать реальные проблемы на GitHub? В сборнике Международной конференции по обучению представлений, том 2024, страницы 54107–54157, 2024.
- ⟦Jin et al. [2021] Ди Джин, Эйлин Пэн, Нассим Уфаттоле, Вэй-Хун Венг, Ханьи Фанг и Питер Соловиц. Каким заболеванием страдает этот пациент? набор данных для ответов на вопросы в открытой предметной области, основанный на медицинских экзаменах. Applied Sciences, 11(14):6421, 2021.
- ⟦Jin et al. [2019] Цяо Цзинь, Бхуван Дхингра, Чжэнпин Лю, Уильям Коэн и Синхуа Лу. Pubmedqa: Набор данных для ответов на вопросы по биомедицинским исследованиям. В материалах конференции 2019 года по эмпирическим методам в обработке естественного языка и 9-й международной объединенной конференции по обработке естественного языка (EMNLP-IJCNLP), страницы 2567–2577, 2019.
- ⟦Jing et al. [2025] Пейюань Цзин, Кинхей Ли, Чжэньсюань Чжан, Хуэйчи Чжоу, Чжэнцин Юань, Чжифань Гао, Лэй Чжу, Гиоргос Папанастасиу, Инъин Фан и Гуан Ян. Рассуждай как радиолог: цепочка рассуждений и обучение с подкреплением для генерации проверяемых отчетов. Medical Image Analysis, страница 103910, 2025.
- ⟦Jorf and Shamout [2026] Бараа Аль Джорф и Фарах Е Шамут. Agentrx: Бенчмарк-исследование LLM агентов для мультимодальных задач клинического прогнозирования. arXiv preprint arXiv:2605.10286, 2026.
- ⟦Kaissis et al. [2020] Георгиос А. Каиссис, Маркус Р. Маковски, Даниэль Рюкерт и Рикмер Ф. Брарен. Безопасное, конфиденциальное и федеративное машинное обучение в медицинской визуализации. Nature Machine Intelligence, 2(6):305–311, 2020.
- ⟦Karim and Uzuner [2025] А. Х. М. Карим и Озлем Узунер. Мультимодальная генерация с дополнением поиском с использованием LLM для медицинских VQA. arXiv preprint arXiv:2510.13856, 2025.
- ⟦Khandekar et al. [2024] Нихил Хандекар, Цяо Цзинь, Гуанчжи Сюн, Сорен Данн, Серина С. Эпплбаум, Заин Анвар, Мааме Сарфо-Гьямфи, Конрад У. Сафранек, Абид А. Анвар, Эндрю Чжан и др. Medcalc-bench: Оценка LLM для медицинских расчетов. Advances in Neural Information Processing Systems, 37:84730–84745, 2024.
- ⟦Khosravi et al. [2026] Бардия Хосрави, Пурия Рузрох, Тугба Акинчи Д’Антоноли, Мана Моассефи, Шахриар Фагани, Авез Мансури, Кено Брессем, Али Теджани и Джуди Гичоя. Агентные AI в радиологии: эволюция от LLM до будущей клинической интеграции. Radiology: Artificial Intelligence, 8(2):e250651, 2026.
- ⟦Kim et al. [2024] Юбин Ким, Чанву Пак, Хевон Чон, Ик С. Чан, Сюйхай Сюй, Дэниел Макдафф, Хёнхун Ли, Марзие Гассеми, Синтия Бризил и Хэ В. Пак. Mdagents: Адаптивное взаимодействие LLM для принятия медицинских решений. Advances in Neural Information Processing Systems, 37:79410–79452, 2024.
- ⟦Kim et al. [2025a] Юбин Ким, Кен Гу, Чанву Пак, Чунчжон Пак, Сэмюэл Шмидгалл, А Али Хейдари, Яо Янь, Чжихань Чжан, Юйчэнь Чжуан, Юнь Лю и др. На пути к науке о масштабировании агентных систем. arXiv preprint arXiv:2512.08296, 2025a.
- ⟦Kim et al. [2025b] Юбин Ким, Хевон Чон, Шань Чэнь, Шуюэ Стелла Ли, Чанву Пак, Мингю Лу, Кумаил Альхамуд, Джимин Мун, Кристина Грау, Минсок Чон и др. Медицинские галлюцинации в базовых моделях и их влияние на здравоохранение. arXiv preprint arXiv:2503.05777, 2025b.
- ⟦Klila et al. [2026] Джаафер Клила, Сондес Баннур Суихи, Рахма Буджельбен, Насреддин Семмар и Ламия Хадрич Бельгит. Внедрение структурированных биомедицинских знаний в языковые модели: непрерывное предварительное обучение против GraphRAG. arXiv preprint arXiv:2604.16422, 2026.
- ⟦Kulkarni and Kulkarni [2026] Сиддхант Кулкарни и Юкта Кулкарни. Бенчмаркинг мультиагентных LLM архитектур для обработки финансовых документов: сравнительное исследование паттернов оркестрации, компромиссов между стоимостью и точностью, а также стратегий масштабирования в продакшене. arXiv preprint arXiv:2603.22651, 2026.
- ⟦Kweon et al. [2024] Сунджун Квон, Джиюн Ким, Хиён Квак, Донгчул Ча, Хангюль Юн, Квангхён Ким, Дживон Ян, Сонхён Вон и Эдвард Чой. Ehrnoteqa: бенчмарк LLM для реальной клинической практики с использованием выписных эпикризов. Advances in Neural Information Processing Systems, 37:124575–124611, 2024.
- ⟦Kyung et al. [2026] Даэун Кюн, Хёнсын Чун, Сонсу Бэ, Джихо Ким, Джэ Хо Сон, Тэрим Ким, Су Кюн Ким и Эдвард Чой. Patientsim: симулятор на основе персон для реалистичного взаимодействия врача и пациента. Advances in Neural Information Processing Systems, 38, 2026.
- ⟦Lai et al. [2026] Юйсян Лай, Цзике Чжун, Мин Ли, Шитянь Чжао, Юйхэн Ли, Константинос Псунис и Сяофэн Ян. Med-r1: Обучение с подкреплением для обобщаемых медицинских рассуждений в vision-language models. IEEE Transactions on Medical Imaging, 2026.
- ⟦Lau et al. [2018] Джейсон Дж. Лау, Сумья Гайен, Асма Бен Абача и Дина Демнер-Фушман. Набор данных клинически сгенерированных визуальных вопросов и ответов о радиологических изображениях. Scientific data, 5(1):180251, 2018.
- ⟦Lee et al. [2025] Гюбок Ли, Элеа Бах, Эрик Янг, Том Поллард, Алистер Джонсон, Эдвард Чой, Джонг Ха Ли и др. Fhir-agentbench: Бенчмаркинг LLM агентов для реалистичных интероперабельных EHR QA. arXiv preprint arXiv:2509.19319, 2025.
- ⟦Lee et al. [2026] Хюнъюн Ли, Ханъюль Юн и Эдвард Чой. Cxreasonagent: Агент диагностического рассуждения на основе доказательств для рентгенографии грудной клетки. arXiv preprint arXiv:2602.23276, 2026.
- ⟦Lee and Hockenmaier [2025] Джину Ли и Джулия Хокенмайер. Оценка цепочек пошаговых рассуждений: обзор. arXiv preprint arXiv:2502.12289, 2025.
- ⟦Leong et al. [2026] Ариэль Леонг, Риса М. Вулф, Румаса Чанна, Цзянся Ван, Гарольд Леманн, Майкл Д. Абрамофф и Т. И. Лю. Автономный скрининг диабетической ретинопатии с поддержкой AI в учреждениях первичной медико-санитарной помощи связан с увеличением числа обращений пациентов из группы риска к офтальмологам. NPJ digital medicine, 9(1):310, 2026.
- ⟦Lewis et al. [2020] Патрик Льюис, Итан Перес, Александра Пиктус, Фабио Петрони, Владимир Карпухин, Наман Гоял, Генрих Кюттлер, Майк Льюис, Вэнь-тау Йи, Тим Рокташель и др. Retrieval-augmented generation for knowledge-intensive nlp tasks. Advances in neural information processing systems, 33:9459–9474, 2020.
- ⟦Li et al. [2024a] Биньсюй Ли, Тянькай Янь, Юаньтин Пань, Цзе Ло, Жуйян Цзи, Цзяюань Дин, Чжэ Сюй, Шилун Лю, Хаоюй Дун, Цзыхао Линь и др. Mmedagent: Обучение использованию медицинских инструментов с помощью мультимодального агента. В сборнике трудов Ассоциации компьютерной лингвистики: EMNLP 2024, страницы 8745–8760, 2024a.
- ⟦Li et al. [2023] Чуньюань Ли, Клифф Вонг, Шэн Чжан, Наото Усуяма, Хаотянь Лю, Цзяньвэй Ян, Тристан Науманн, Хойфунг Пун и Цзяньфэн Гао. Llava-med: Обучение большого языково-визуального ассистента для биомедицины за один день. Advances in Neural Information Processing Systems, 36:28541–28564, 2023.
- ⟦Li et al. [2026a] Джунбо Ли, Пэн Чжоу, Руи Мэн, Мит П. Вадера, Лихун Ли и Ян Ли. Turn-ppo: Оценка преимущества на уровне хода с использованием PPO для улучшенного многоходового RL в агентных LLM. В материалах конференции Findings of the Association for Computational Linguistics: EACL 2026, страницы 6227–6243, 2026a.
- ⟦Li et al. [2024b] Джункай Ли, Юнхуэй Лай, Вэйтао Ли, Цзинъи Жэнь, Мэн Чжан, Синьхуэй Кан, Сыюй Ван, Пэн Ли, Я-Цинь Чжан, Вэйчжи Ма и др. Агентская больница: симулякр больницы с эволюционирующими медицинскими агентами. arXiv preprint arXiv:2405.02957, 2024b.
- ⟦Li et al. [2025a] Руменг Ли, Сюнь Ван, Дэн Берловиц, Джесси Мез, Хонхуанг Лин и Хонг Ю. Care-ad: мультиагентная структура на основе LLM для прогнозирования болезни Альцгеймера с использованием продольных клинических записей. npj Digital Medicine, 8(1):541, 2025a.
- ⟦Li et al. [2025b] Сицзин Ли, Тяньвэй Линь, Линшуай Линь, Вэньцяо Чжан, Цзян Лю, Сяода Ян, Цзюньчэн Ли, Юйчэн Хэ, Сяохуэй Сун, Цзюнь Сяо и др. Eyecaregpt: Повышение уровня комплексного понимания офтальмологии с помощью специализированного набора данных, бенчмарка и модели. В материалах 33-й Международной конференции ACM по мультимедиа, страницы 3893–3902, 2025b.
- ⟦Li et al. [2025c] Сонгхао Ли, Джонатан Сюй, Тяньчэн Бао, Юйсюань Лю, Юйчэнь Лю, Ихан Лю, Лилинь Ван, Вэньхуэй Лэй, Шэн Ван, Ино Сюй и др. Совместно развивающаяся агентная система искусственного интеллекта для анализа медицинской визуализации. arXiv preprint arXiv:2509.20279, 2025c.
- ⟦Li et al. [2025d] Вэньлян Ли, Жуй Янь, Сюй Чжан, Ли Чэнь, Хунцзи Чжу, Цзин Чжао, Цзюньцзюнь Ли, Мэнжу Ли, Вэй Цао, Цзыхан Цзян и др. Macd: многоагентная клиническая диагностика с самообучающимися знаниями для LLM. arXiv preprint arXiv:2509.20067, 2025d.
- ⟦Li et al. [2026b] Сяочуань Ли, Райан Мин, Пранав Сетлур, Абхиджай Паладугу, Энди Танг, Хао Кан, Шуай Шао, Жун Цзинь и Чэньянь Сюн. Бенчмарк масштабирования времени тестирования общих LLM агентов. arXiv preprint arXiv:2602.18998, 2026b.
- ⟦Liao et al. [2025] Юйшэн Ляо, Шуян Цзян, Яньфэн Ван и Юй Ван. Reflectool: На пути к клиническим агентам с поддержкой инструментов и механизмом рефлексии. В материалах 63-го ежегодного собрания Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), страницы 13507–13531, 2025.
- ⟦Lin et al. [2026a] Цзяньсинь Линь, Чуньчжэн Чжу, Питер Дж. Кнёэрц, Юньфэй Бай и Юань Сюэ. Medcausalx: Адаптивное причинно-следственное рассуждение с саморефлексией для надежных медицинских vision-language models. arXiv preprint arXiv:2603.23085, 2026a.
- ⟦Lin et al. [2025] Тяньвэй Линь, Вэньцяо Чжан, Сыцзин Ли, Юйцянь Юань, Биньхэ Юй, Хаоюань Ли, Вангуй Хэ, Хао Цзян, Мэнцзэ Ли, Сяохуэй Сун и др. Healthgpt: Медицинская large vision-language model для унификации понимания и генерации посредством адаптации гетерогенных знаний. arXiv preprint arXiv:2502.09838, 2025.
- ⟦Lin et al. [2017] Цунг-И Лин, Пётр Доллар, Росс Гиршик, Каймин Хе, Бхарат Харихаран и Серж Белонжи. Пирамидальные сети признаков для обнаружения объектов. В материалах конференции IEEE по компьютерному зрению и распознаванию образов, страницы 2117–2125, 2017.
- ⟦Lin et al. [2026b] И Линь, Ихао Дин, Юнхуэй У и Ифань Пэн. March: многоагентная радиологическая клиническая иерархия для генерации отчетов КТ. arXiv preprint arXiv:2604.16175, 2026b.
- ⟦Liu et al. [2021] Бо Лю, Ли-Мин Чжан, Ли Сюй, Лин Ма, Ян Ян и Сяо-Мин У. Slake: семантически размеченный набор данных с расширенными знаниями для медицинских визуальных QA. В материалах 18-го международного симпозиума IEEE по биомедицинской визуализации (ISBI) 2021 года, страницы 1650–1654. IEEE, 2021..
- ⟦Liu et al. [2025a] Бо Лю, Ке Цзоу, Ли-Мин Чжан, Цзэсинь Лу, Сяоюй Дун, Иди Чэнь, Чэнцян Се, Цзяньнун Цао, Сяо-Мин У и Хуачжу Фу. Gemex: Крупномасштабный, обоснованный и интерпретируемый медицинский VQA бенчмарк для диагностики по рентгенограммам грудной клетки. В материалах Международной конференции IEEE/CVF по компьютерному зрению, страницы 21310–21320, 2025a.
- ⟦Liu et al. [2024] Ханьчао Лю, Вэньюань Сюэ, Ифэй Чэнь, Дапэн Чэнь, Сютянь Чжао, Кэ Ван, Липин Хоу, Жунцзюнь Ли и Вэй Пэн. Обзор галлюцинаций в больших vision-language models. arXiv preprint arXiv:2402.00253, 2024.
- ⟦Liu et al. [2025b] Хунцзюнь Лю, Инхао Чжу, Юйхуэй Ван, Итао Лун, Цзэюй Лай, Лэцюань Юй и Чэнь Чжао. Medmmv: контролируемая мультимодальная мультиагентная система для надежного и верифицируемого клинического рассуждения. arXiv preprint arXiv:2509.24314, 2025b.
- ⟦Liu et al. [2026a] Цзе Лю, Вэньсюань Ван, Цзычжань Ма, Голинь Хуан, Ихан Су, Као-Юн Чан, Хаолян Ли, Линьлинь Шэнь, Майкл Р. Лю и Вэньтин Чэнь. Medchain: Преодоление разрыва между LLM агентами и клинической практикой с помощью интерактивной последовательности. Advances in Neural Information Processing Systems, 38, 2026a.
- ⟦Liu et al. [2026b] Цзюньци Лю, Салена Сонг, Юйхань Ван, Цзявэй Мао, Харди Чен, Сяокэ Хуан, Тяньхао Ци, Пэнфэй Го, Юйчэн Тан, Юйфань Хэ и др. Automedbench: На пути к медицинским автоисследованиям с помощью агентных AI моделей. arXiv preprint arXiv:2606.01961, 2026b.
- ⟦Liu et al. [2025c] Филип Р. Лю, Спарш Бансал, Джимми Дин, Адитья Павар, Рамани Сатишкумар, Шейл Десаи, Нирадж Гупта, Синь Ван и Шу Ху. Medchat: мультиагентная система для мультимодальной диагностики с использованием LLM. В материалах 8-й Международной конференции IEEE по обработке и поиску мультимедийной информации (MIPR) 2025 года, страницы 456–462. IEEE, 2025c.
- ⟦Liu et al. [2026c] Цяньчу Лю, Шэн Чжан, Гуанхуэй Цинь, Джая Мария Хосе Валанарасу, Максимилиан Рокусс, Минъюй Лу, Тимоти Оссовски, Хуан Мануэль Самбрано Чавес, Клифф Вонг, Пениэль Аргау и др. Healthagentbench: Единый набор бенчмарков для реалистичных агентных сред в здравоохранении для проверки передовых AI агентов. arXiv preprint arXiv:2606.31179, 2026c.
- ⟦Liu et al. [2026d] Жоци Лю, Имран К. Мохиуддин, Остин Дж. Шоффлер, Кавита Рендучинтала, Ашвин Наяк, Прашанта Л. Вему, Шивам К. Ведак, Камерон К. Блэк, Джон Л. Хавлик, Исаак Огунмола и др. Physicianbench: Оценка LLM агентов в реальных средах EHR. arXiv preprint arXiv:2605.02240, 2026d.
- ⟦Liu et al. [2026e] Шэнъюань Лю, Люсинь Бао, Ци Ян, Вантин Гэн, Боюнь Чжэн, Чэньсинь Ли, Вэньтин Чэнь, Хоувэнь Пэн и Исюань Юань. Medsam-agent: Расширение возможностей интерактивной сегментации медицинских изображений с помощью многоходового агентного обучения с подкреплением. arXiv preprint arXiv:2602.03320, 2026e.
- ⟦Liu et al. [2025d] Тяньюй Лю, Вэйхао Сюань, Хао У, Питер Хамфри, Марчелло ДиСтасио, Мохамед Кахила, Альфонсо Гарсия Тан, Хели Ци, Жуй Ян, Симен Хань и др. Teampath: создание мультимодальных экспертов в области патологии с помощью AI-копилотов для рассуждений. arXiv preprint arXiv:2511.17652, 2025d.
- ⟦Liu et al. [2025e] Цзычэнь Лю, Чанъюй Чэнь, Вэньцзюнь Ли, Пэнхуэй Ци, Тяньюй Пан, Чао Ду, Уи Сан Ли и Мин Ли. Понимание обучения в стиле r1-zero: критический взгляд. Препринт arXiv:2503.20783, 2025e.
- ⟦Liu et al. [2023] Зицзюнь Лю, Яньчжэ Чжан, Пэн Ли, Ян Лю и Дии Ян. Динамическая сеть LLM-агентов: фреймворк для совместной работы LLM-агентов с оптимизацией команды агентов. arXiv preprint arXiv:2310.02170, 2023.
- ⟦Lou et al. [2025] Цзиньхуэй Лоу, Янь Ян, Чжоу Юй, Чжэньци Фу, Вэйдун Хань, Цинмин Хуан и Цзюнь Юй. Cxragent: многоэтапное рассуждение под управлением директора для интерпретации рентгеновских снимков грудной клетки. arXiv preprint arXiv:2510.21324, 2025.
- ⟦Lu et al. [2024] Минг И Лу, Боуэн Чен, Дрю Ф. К. Уильямсон, Ричард Дж. Чен, Айви Лян, Тонг Дин, Гийом Жом, Игорь Одинцов, Лонг Фи Ле, Георг Гербер и др. Визуально-языковая фундаментальная модель для вычислительной патологии. Nature medicine, 30(3):863–874, 2024.
- ⟦Lu et al. [2026] Юйсин Лу, Юйшухун Линь, Вэньци Ши, Дж. Бен Тамо, Сюкай Чжао, Цзиньчжо Ван и Мэй Дунмэй Ван. Clinenv: Интерактивная многоэтапная среда EHR с долгосрочным горизонтом планирования для агентов. arXiv preprint arXiv:2606.02568, 2026.
- ⟦Luo et al. [2025] Цзюньюй Ло, Вэйчжи Чжан, Е Юань, Юйшэн Чжао, Цзюньвэй Ян, Иян Гу, Бохань У, Биньци Чэнь, Цзыюэ Цяо, Цинцин Лун и др. Агент на основе LLM: обзор методологии, приложений и проблем. arXiv preprint arXiv:2503.21460, 2025.
- ⟦Lyu et al. [2025] Синьхэн Лю, Юйци Лян, Вэньтин Чэнь, Мэйдань Дин, Цзяци Ян, Голинь Хуан, Даокунь Чжан, Сянцзянь Хэ и Линьлинь Шэнь. Wsi-agents: Совместная мультиагентная система для мультимодального анализа изображений целых предметных стекол. arXiv preprint arXiv:2507.14680, 2025.
- ⟦Ma et al. [2024] Джун Ма, Юйтин Хэ, Фэйфэй Ли, Линь Хань, Чэньюй Ю и Бо Ван. Сегментация любых объектов на медицинских изображениях. Nature Communications, 15:654, 2024.
- ⟦Madaan et al. [2023] Аман Мадаан, Никет Тандон, Пракхар Гупта, Скайлер Халлинан, Лую Гао, Сара Вигреффе, Ури Алон, Ноуха Дзири, Шримай Прабхумойе, Имин Ян и др. Self-refine: Итеративное уточнение с использованием саморефлексии. Достижения в системах нейронной обработки информации, 36:46534–46594, 2023.
- ⟦Madavan et al. [2025] Ракеш Радж Мадаван, Акшат Каймал, Хашим Файсал и С. Чандракала. Med-grim: улучшенная zero-shot медицинская VQA с использованием мультимодального графового RAG со встроенными промптами. arXiv preprint arXiv:2508.06496, 2025.
- ⟦Mahdavi et al. [2026] Захра Махдави, Захра Ходакарамимагсуд, Хуман Халу, Сина Бахшанде Талешани, Эрфан Хашеми, Джавад Мирзапур Калейбар и Омид Неджати Манзари. Med-vcd: Смягчение галлюцинаций для медицинских больших vision-language models посредством визуального контрастивного декодирования. Computers in Biology and Medicine, 200:111347, 2026.
- ⟦Maksudov et al. [2026] Булат Максудов, Владислав Куренков, Кэтлин М. Карран и Алессандра Милео. Abra: Агентный бенчмарк для радиологических приложений. arXiv preprint arXiv:2605.11224, 2026.
- ⟦Mallinar et al. [2026] Нил Маллина, А Али Хейдари, Синь Лю, Энтони З Фаранеш, Брент Уинслоу, Нова Хаммерквист, Бенджамин Граф, Кэти Спид, Марк Малхотра, Шветак Патель и др. Масштабируемая структура для оценки языковых моделей в здравоохранении. npj Digital Medicine, 2026.
- ⟦Malpure et al. [2025] Саураб Малпуре, Раджеш Канунго, Бенджамин Р. Лумис и С. М. Салим Реза. Обеспечение безопасности ИИ и агентных систем в медицинских устройствах: методы, риски и защита. В материалах Третьей международной конференции 2025 года по киберфизическим системам, силовой электронике и электромобилям (ICPEEV), страницы 1–8. IEEE, 2025..
- ⟦Mao et al. [2026] Юрен Мао, Вэньи Сюй, Юйян Цинь и Юньцзюнь Гао. Ct-agent: мультимодальный LLM-агент для 3D CT радиологических QA. Science China Information Sciences, 69(5):150107, 2026.
- ⟦Masayoshi et al. [2025] Канато Масаёси, Масахиро Хасимото, Рёити Ёкояма, Наоки Тода, Ёсифуми Увамино, Сёго Фукуда, Хо Намкунг и Масахиро Дзиндзаки. Ehr-mcp: Оценка в реальных условиях извлечения клинической информации с помощью LLM посредством model context protocol. arXiv preprint arXiv:2509.15957, 2025.
- ⟦Mei et al. [2024] Кай Мэй, Си Чжу, Уцзян Сюй, Вэньюэ Хуа, Минъюй Цзинь, Цзэлун Ли, Шуюань Сюй, Жосун Е, Инцян Гэ и Юнфэн Чжан. Aios: Операционная система для LLM агентов. arXiv preprint arXiv:2403.16971, 2024.
- ⟦Mei et al. [2025] Лингруй Мэй, Цзяюй Яо, Юйяо Гэ, Ивэй Ван, Баолун Би, Юйцзюнь Цай, Цзячжи Лю, Минъюй Ли, Чжун-Чжи Ли, Дучжэнь Чжан и др. Обзор контекстной инженерии для LLM. arXiv preprint arXiv:2507.13334, 2025.
- ⟦Meng et al. [2026] Цяньюй Мэн, Янань Ван, Лии Чэнь, Цимен Ван, Чэнцян Лу, Вэй У, Янь Гао, И У и Яо Ху. Инструментарий для агентов на базе LLM: обзор. 2026.
- ⟦Meng et al. [2025] Zijie Meng, Jin Hao, Xiwei Dai, Yang Feng, Jiaxiang Liu, Bin Feng, Huikai Wu, Xiaotang Gai, Hengchuan Zhu, Tianxiang Hu, et al. Dentvlm: Мультимодальная vision-language model для комплексной стоматологической диагностики и совершенствования клинической практики. arXiv preprint arXiv:2509.23344, 2025.
- ⟦Miculicich et al. [2025] Лесли Микуличич, Михир Пармар, Хамид Паланги, Кришнамурти Джи Двиджотам, Мирко Монтанари, Томас Пфистер и Лонг Т Ле. Veriguard: Повышение безопасности LLM агентов посредством верифицированной генерации кода. arXiv preprint arXiv:2510.05156, 2025.
- ⟦Moon and Lee [2022] Сехван Мун и Хюнжу Ли. Moma: алгоритм многозадачного обучения на основе внимания для интерпретации и классификации мультиомиксных данных. Bioinformatics, 38(8):2287–2296, 2022.
- ⟦Muennighoff et al. [2025] Никлас Мюннигхофф, Зитон Ян, Вэйцзя Ши, Сян Лиза Ли, Ли Фэй-Фэй, Ханнане Хаджиширзи, Люк Зеттльмойер, Перси Лян, Эммануэль Кандес и Тацунори Б. Хашимото. s1: Простое масштабирование во время тестирования. В материалах конференции 2025 года по эмпирическим методам в обработке естественного языка, страницы 20286–20332, 2025.
- ⟦Muhetaer et al. [2025] Муретицзян Мухетаер, Айлимулати Юсупу, Ван Ифань, Мунире Муталипу и Фань Хао. Оценка производительности наборов данных медицинских QA-диалогов в системах RAG и оптимизация ChatGPT. Scientific Reports, 15(1):44467, 2025.
- ⟦Muti et al. [2026] Валентина Буи Мути, Эжени Дюлу, и Зицюань Фу. Medcase-structured: набор данных text-to-fhir для оценки диагностического мышления в клинически реалистичных условиях EHR. arXiv preprint arXiv:2605.30295, 2026.
- ⟦Naidu et al. [2025] У Ганеш Найду, Аджанта Лакшманан, ДжСВ Гопала Кришна, Э Эламати, Т Сринивасула Редди и др. Федеративная система искусственного интеллекта для дифференциальной диагностики с сохранением конфиденциальности в распределенных медицинских сетях. В материалах 6-й Международной конференции по изобретательским исследованиям в вычислительных приложениях (ICIRCA) 2025 года, страницы 932–940. IEEE, 2025.
- ⟦Nannini et al. [2026] Лука Наннини, Адам Леон Смит, Микеле Джошуа Маджини, Энрико Панаи, Сандра Фелисиано, Александр Тюлканов, Елена Маран, Джеймс Джили и Пьеркосма Бисконти. Агенты AI в рамках законодательства Европейского союза. arXiv preprint arXiv:2604.04604, 2026.
- ⟦Nguyen et al. [2025] Данг Нгуен, Минь Кхой Хо, Хюи Та, Тхань Там Нгуен, Ци Чен, Кумар Рав, Куи Дуонг Данг, Сатвик Рамчандре, Сон Лам Фунг, Чжибинь Ляо и др. Локализация перед ответом: бенчмарк для обоснованных медицинских визуальных ответов на вопросы. В материалах Тридцать четвертой международной объединенной конференции по искусственному интеллекту (IJCAI-25). Организация международных объединенных конференций по искусственному интеллекту, 2025.
- ⟦Obermeyer et al. [2019] Зиад Обермейер, Брайан Пауэрс, Кристин Фогели и Сендхил Муллайнатхан. Анализ расовой предвзятости в алгоритме, используемом для управления здоровьем групп населения. Science, 366(6464):447–453, 2019.
- ⟦Ostmeier et al. [2024] Софи Остмайер, Джастин Сюй, Чжихун Чен, Майя Варма, Луи Бланкмейер, Кристиан Блютген, Арне Эдвард Микалсон, Майкл Мозли, Кертис Ланглоц, Акшай С. Чаудхари и др. Green: Генеративная оценка радиологических отчетов и аннотирование ошибок. В сборнике трудов Ассоциации компьютерной лингвистики: EMNLP 2024, страницы 374–390, 2024.
- ⟦Packer et al. [2023] Чарльз Пакер, Вивиан Фанг, Шишир Патил, Кевин Лин, Сара Вудерс и Джозеф Гонсалес. Memgpt: на пути к использованию LLM в качестве операционных систем. 2023.
- ⟦Pal et al. [2022] Анкит Пал, Логеш Кумар Умапати и Малайканнан Санкарасуббу. Medmcqa: Крупномасштабный многопредметный набор данных с множественным выбором для ответов на вопросы в медицинской сфере. В сборнике трудов конференции по здравоохранению, выводам и обучению, страницы 248–260. PMLR, 2022.
- ⟦Palaniappan et al. [2024] Кавита Паланиаппан, Элейн Ян Тин Лин и Силке Фогель. Глобальные нормативно-правовые базы для использования искусственного интеллекта (AI) в секторе медицинских услуг. В Healthcare, том 12, страница 562. MDPI, 2024.
- ⟦Pan et al. [2025a] Цзячжэнь Пань, Че Лю, Цзюньдэ У, Фэнлинь Лю, Цзяюань Чжу, Хунвэй Бран Ли, Чэнь Чэнь, Чэн Оуян и Дэниел Рюкерт. Medvlm-r1: Стимулирование способности к медицинскому рассуждению у vision-language models (vlms) посредством обучения с подкреплением. В сборнике: International Conference on Medical Image Computing and Computer-Assisted Intervention, страницы 337–347. Springer, 2025a.
- ⟦Pan et al. [2026] Линьюэ Пань, Лэсяо Цзоу, Шо Го, Цзинчэнь Ни и Хай-Тао Чжэн. Инструментарий для агентов на естественном языке. arXiv preprint arXiv:2603.25723, 2026.
- ⟦Pan et al. [2025b] Сяоюй Пань, Ян Бай, Кэ Цзоу, Ян Чжоу, Цзюнь Чжоу, Хуачжу Фу, И-Чун Там и Юн Лю. Eh-benchmark: эталонный тест офтальмологических галлюцинаций и рабочий процесс рассуждений с прослеживаемостью сверху вниз на основе агентов. Information Fusion, страница 103631, 2025b.
- ⟦Pandit et al. [2025] Шрей Пандит, Цзявэй Сюй, Цзюньюань Хун, Чжанъян Ван, Тяньлун Чэнь, Кайди Сюй и Ин Дин. Medhallu: комплексный бенчмарк для обнаружения медицинских галлюцинаций в LLM. В материалах конференции 2025 Conference on Empirical Methods in Natural Language Processing, страницы 2858–2873, 2025.
- ⟦Patil et al. [2025] Шишир Г. Патил, Хуаньчжи Мао, Фаньцзя Янь, Чарли Чэн-Цзе Цзи, Вишну Суреш, Ион Стойка и Джозеф Э. Гонсалес. Берклиевская таблица лидеров по вызову функций (BFCL): от использования инструментов до агентной оценки LLM. В материалах Сорок второй международной конференции по машинному обучению, 2025.
- ⟦[192] Ф. Перес-Гарсия, Х. Шарма, С. Бонд-Тейлор, К. Бузид, В. Сальвателли, М. Ильзе и др. Rad-dino: Исследование масштабируемых кодировщиков медицинских изображений вне рамок текстового контроля; 2024.
- ⟦Pesapane et al. [2026] Филиппо Песапане, Карло Де Чекко, Хао Ван, Матиас К. Хауглид и Франческо Сарданелли. Искусственный интеллект как медицинское изделие в радиологии в 2025 году: регуляторный сценарий в ЕС, США и Китае. European Radiology, страницы 1–12, 2026.
- ⟦Qian et al. [2025] Чэнь Цянь, Цзыхао Се, Ифэй Ван, Вэй Лю, Куньлунь Чжу, Ханьчэнь Ся, Юйфань Дан, Чжоюнь Ду, Вэйцзэ Чэнь, Чэн Ян и др. Масштабирование многоагентного взаимодействия на основе LLM. В материалах Международной конференции по обучению представлениям, том 2025, страницы 41488–41505, 2025.
- ⟦Qian et al. [2023] Чэн Цянь, Чи Хань, И Фан, Юйцзя Цинь, Чжиюань Лю и Хэн Цзи. Creator: создание инструментов для разделения абстрактного и конкретного логического вывода в LLM. В сборнике Findings of the Association for Computational Linguistics: EMNLP 2023, страницы 6922–6939, 2023.
- ⟦Qiao et al. [2023] Бо Цяо, Ликунь Ли, Сюй Чжан, Шилин Хэ, Юй Кан, Чаоюнь Чжан, Фанкай Ян, Хан Дун, Цзюэ Чжан, Лу Ван и др. Taskweaver: Агентная инфраструктура с приоритетом программного кода. arXiv preprint arXiv:2311.17541, 2023.
- ⟦Qiao et al. [2026] Итун Цяо, Лэй Лю, Юэ Шэнь, Цзянь Ван, Цзиньцзе Гу, Чжисюань Чу и Куй Жэнь. Ehr-complex: Бенчмаркинг медицинских агентов для комплексного клинического рассуждения. arXiv preprint arXiv:2606.23301, 2026.
- ⟦Qin et al. [2024] Юйцзя Цинь, Шихао Лян, Инин Е, Куньлунь Чжу, Лань Янь, Яси Лу, Янькай Линь, Синь Цун, Сянру Тан, Билл Цянь и др. Toolllm: Facilitating large language models to master 16000+ real-world apis. В материалах International Conference on Learning Representations, 2024.
- ⟦Qiu et al. [2025] Пэнчэн Цю, Чаои У, Шуюй Лю, Вэйкэ Чжао, Чжося Чэнь, Хунфэй Гу, Чуаньцзинь Пэн, Я Чжан, Яньфэн Ван и Вэйди Се. Количественная оценка способностей LLM к рассуждению на реальных клинических случаях. arXiv preprint arXiv:2503.04691, 2025.
- ⟦Quang et al. [2025] Нгок Буй Лам Куанг, Нам Ле Нгуен Бинь1, Тхань-Хуй Нгуен, Куан Нгуен1 Ле Тхиен Фук Нгуен и Улас Багчи. Gmat: Обоснованная мультиагентная клиническая система. В сборнике: Новые приложения LLM/LMM в медицинской визуализации: Первый международный семинар, ELAMI 2025, проведенный совместно с MICCAI 2025, Тэджон, Южная Корея, 27 сентября 2025 г., Труды, страница 1. Springer Nature, 2025.
- ⟦Radosevich and Halloran [2025] Брэндон Радосевич и Джон Халлоран. Аудит безопасности Mcp: LLMs с протоколом контекста модели допускают серьезные уязвимости безопасности. Препринт arXiv:2504.03767, 2025.
- ⟦Rafailov et al. [2023] Рафаэль Рафайлов, Арчит Шарма, Эрик Митчелл, Кристофер Д. Мэннинг, Стефано Эрмон и Челси Финн. Direct preference optimization: Your language model is secretly a reward model. Advances in neural information processing systems, 36:53728–53741, 2023.
- ⟦Rempe et al. [2025] Мориц Ремпе, Лукас Хайне, Константин Зейбольд, Фабиан Хёрст и Йенс Клеесик. Деидентификация медицинских данных визуализации: комплексный инструмент для обеспечения конфиденциальности пациентов. Европейская радиология, страницы 1–10, 2025.
- ⟦Roschewitz et al. [2026] Мелани Рошевиц, Кеннет Стиппа, Итянь Тао, Дживунг Сон, Жан-Бенуа Дельбрук, Бенджамин Гундерсен, Николя Деперруа, Кристиан Блютген, Джулия Фогт, Бьорн Менце и др. Radagent: ИИ-агент с использованием инструментов для пошаговой интерпретации компьютерной томографии грудной клетки. arXiv preprint arXiv:2604.15231, 2026.
- ⟦Rose et al. [2025] Дэниел Филип Роуз, Чиа-Чьен Хунг, Марко Лепри, Исраа Алькассем, Кирил Гаштеовски и Кэролин Лоуренс. Meddxagent: Единая модульная агентная архитектура для объяснимой автоматической дифференциальной диагностики. В сборнике трудов 63-го ежегодного собрания Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), страницы 13803–13826, 2025.
- ⟦Russell [2010] Стюарт Дж. Рассел. Искусственный интеллект: современный подход. Пирсон Эдьюкейшн, Инк., 2010.
- ⟦Saab et al. [2024] Халед Сааб, Тао Ту, Вэй-Хун Венг, Рютаро Танно, Дэвид Штуц, Эллери Вулчин, Фан Чжан, Тим Стротер, Чунчжон Пак, Элахе Ведади и др. Возможности моделей gemini в медицине. arXiv preprint arXiv:2404.18416, 2024.
- ⟦Sampa et al. [2026] Масуда Бегум Сампа, Нур Хидайати Абдул Азиз, Мд Сиддикур Рахман, Нур Азлина Аб. Азиз, Росли Бесар и Анит Хайрунниса Газали. Reinforcement learning для анализа медицинских изображений: систематический обзор алгоритмов, инженерных проблем и клинического внедрения. Computer Assisted Surgery, 31(1):2597553, 2026.
- ⟦Sardana et al. [2023] Нихил Сардана, Джейкоб Портес, Саша Дубов и Джонатан Франкл. За пределами оптимальности по Чинчилле: учет вывода в законах масштабирования языковых моделей. arXiv preprint arXiv:2401.00448, 2023.
- ⟦Schick et al. [2023] Тимо Шик, Джейн Двиведи-Ю, Роберто Десси, Роберта Райлеану, Мария Ломели, Эрик Хэмбро, Люк Зеттльмойер, Никола Канчедда и Томас Скиалом. Toolformer: Языковые модели могут самостоятельно обучаться использованию инструментов. Достижения в системах нейронной обработки информации, 36:68539–68551, 2023.
- ⟦Schmidgall et al. [2024] Сэмюэл Шмидгалл, Роджин Зиаеи, Карл Харрис, Эдуардо Рейс, Джеффри Джоплинг и Майкл Мур. Agentclinic: мультимодальный агентный бенчмарк для оценки AI в симулированных клинических средах. arXiv preprint arXiv:2405.07960, 2024.
- ⟦Schulman et al. [2017] Джон Шульман, Филип Вольски, Прафулла Дхаривал, Алек Рэдфорд и Олег Климов. Алгоритмы проксимальной оптимизации политики, 2017.
- ⟦Sellergren et al. [2025] Эндрю Селлергрен, Сахар Каземзаде, Тиам Джароенсри, Атилла Кирали, Мадлен Траверс, Тимо Колбергер, Шон Сюй, Фаяз Джамиль, Сиан Хьюз, Чарльз Лау и др. Технический отчет Medgemma. arXiv preprint arXiv:2507.05201, 2025.
- ⟦Seyyed-Kalantari et al. [2021] Лале Сейед-Калантари, Хаоран Чжан, Мэтью Б. А. Макдермотт, Ирен И. Чен и Марзие Гассеми. Систематическая ошибка недодиагностики алгоритмов искусственного интеллекта, применяемых к рентгенограммам грудной клетки в недостаточно обслуживаемых группах пациентов. Nature medicine, 27(12):2176–2182, 2021.
- ⟦Shao et al. [2024] Чжихун Шао, Пэйи Ван, Цихао Чжу, Жуньсинь Сюй, Цзюньсяо Сун, Сяо Би, Хаовэй Чжан, Минчуань Чжан, ИК Ли, Ян У и др. Deepseekmath: Расширение границ математических рассуждений в открытых языковых моделях. arXiv preprint arXiv:2402.03300, 2024.
- ⟦Shen et al. [2025] Хаочжань Шэнь, Пэн Лю, Цзинчэн Ли, Чуньсинь Фан, Ибо Ма, Цзяцзя Ляо, Цяоли Шэнь, Цзылунь Чжан, Канцзя Чжао, Цяньцянь Чжан и др. Vlm-r1: Стабильная и обобщаемая большая мультимодальная модель в стиле r1. arXiv preprint arXiv:2504.07615, 2025.
- ⟦Shen et al. [2026a] Вейсян Шэнь, Яньчжу Ху, Че Лю, Цзюньдэ У, Цзяюань Чжу, Чэнчжи Шэнь, Минь Сюй, Юэмин Цзинь, Бенедикт Вистлер, Даниэль Рюкерт и др. Medopenclaw: проверяемые медицинские визуализационные агенты, рассуждающие на основе необработанных полных исследований. arXiv preprint arXiv:2603.24649, 2026a.
- ⟦Shen et al. [2026b] Вэйсян Шэнь, Байлян Цзянь, Цзюнь Ли, Чэ Лю, Йоханнес Молл, Сяобинь Ху, Даниэль Рюкерт, Хунвэй Бран Ли и Цзячжэнь Пань. Evo-medagent: Выход за рамки одношаговой диагностики с помощью агентов, которые запоминают, анализируют и совершенствуются. arXiv preprint arXiv:2604.14475, 2026b.
- ⟦Shen et al. [2026c] Вейсян Шэнь, Чэнчжи Шэнь, Яньчжу Ху, Че Лю, Цзюньдэ У, Цзяюань Чжу, Сяо Хань, Цзунъюэ Ли, Цзинпэй У, Минь Сюй, Дагуан Сюй, Юэмин Цзинь, Бенедикт Вистлер, Даниэль Рюкерт и Цзячжэнь Пань. Medopenclaw and medflowbench: Аудит медицинских агентов в рабочих процессах полного исследования, 2026c. URL https://arxiv.org/abs/2603.24649.
- ⟦Shen et al. [2023] Юнлян Шэнь, Кайтао Сун, Сюй Тань, Дуншэн Ли, Вэймин Лу и Юэтин Чжуан. Hugginggpt: Решение задач искусственного интеллекта с помощью ChatGPT и его друзей из Hugging Face. Достижения в системах обработки нейронной информации, 36:38154–38180, 2023.
- ⟦Shi et al. [2026] Данли Ши, Сяолань Чэнь, Бинцзе Янь, Вэйи Чжан, Пушэн Сюй, Цзяньчэн Ян, Жоюй Чэнь, Сыюй Хуан, Бовэнь Лю, Синьюань У, Мэн Се, Цзыюй Гао, Юэ У, Сэньлинь Линь, Кай Цзинь, Ся Гун, И Чун Тхам, Сюцзюань Чжан, Ли Дун, Юйчжоу Чжан, Джейсон Ям, Гуанмин Цзинь, Сяоху Дин, Хайдун Цзоу, Ялинь Чжэн, Цзунъюань Гэ и Мингуан Хэ. Eyeagent: Агентная система искусственного интеллекта для мультимодальной поддержки принятия клинических решений в офтальмологии, 2026. URL https://arxiv.org/abs/2511.09394.
- ⟦Shi et al. [2024] Вэньци Ши, Жань Сюй, Юйчэнь Чжуан, Юэ Юй, Цзеюй Чжан, Хан У, Юаньда Чжу, Джойс К. Хо, Карл Ян и Мэй Дунмэй Ван. Ehragent: код расширяет возможности LLM для few-shot сложного табличного рассуждения на основе EHR. В материалах конференции 2024 года по эмпирическим методам в обработке естественного языка, страницы 22315–22339, 2024.
- ⟦Shimgekar et al. [2025] Сурья Рам Шимгекар, Шаян Вассеф, Абхай Гоял, Коустув Саха, Пи Зонооз и Навин Кумар. Агентная система искусственного интеллекта для комплексного вывода на основе медицинских данных. В материалах международной конференции IEEE по биоинформатике и биомедицине (BIBM) 2025 года, страницы 7807–7810. IEEE, 2025.
- ⟦Shinn et al. [2023] Ноа Шинн, Федерико Кассано, Ашвин Гопинат, Картик Нарасимхан и Шуньюй Яо. Reflexion: Языковые агенты с вербальным обучением с подкреплением. Достижения в системах нейронной обработки информации, 36:8634–8652, 2023.
- ⟦Silveira et al. [2025] Андре Ледерманн Силвейра, Родриго да Роза Риги и Кристиано Андре Да Коста. Мультиагентные системы для поддержки принятия клинических решений: систематический обзор. Applied Soft Computing, страница 114447, 2025.
- ⟦Singhal et al. [2025] Каран Сингхал, Тао Ту, Юрай Готтвейс, Рори Сэйрес, Эллери Вулчин, Мохамед Амин, Ле Хоу, Кевин Кларк, Стивен Р. Пфоль, Хизер Коул-Льюис и др. На пути к экспертному уровню ответов на медицинские вопросы с помощью LLM. Nature medicine, 31(3):943–950, 2025.
- ⟦Smuha [2025] Натали А. Смуха. Регламент 2024/1689 Европейского парламента и Совета от 13 июня 2024 года (Закон ЕС об искусственном интеллекте). International Legal Materials, 64(5):1234–1381, 2025.
- ⟦Snell et al. [2024] Чарли Снелл, Джехун Ли, Келвин Сюй и Авирал Кумар. Оптимальное масштабирование вычислительных ресурсов LLM во время тестирования может быть более эффективным, чем масштабирование параметров модели, 2024.
- ⟦Song and Zheng [2026] Минъян Сун и Мао Чжэн. Обзор дистилляции on-policy для LLM. arXiv preprint arXiv:2604.00626, 2026.
- ⟦Song et al. [2026] Сяошуай Сун, Хаофэй Чан, Гуаньтин Дун, Юйтао Чжу, Цзи-Жун Вэнь и Чжичэн Доу. Envscaler: Масштабирование интерактивных сред инструментов для LLM агентов посредством программного синтеза. arXiv preprint arXiv:2601.05808, 2026.
- ⟦Su et al. [2025] Юйхао Су, Анвеса Чоудхури, Чжунпай Гао, Бенджамин Планш, Ван Нгуен Нгуен, Мэн Чжэн, Юхань Шэнь, Арун Иннандже, Терренс Чен, Эхсан Эльхамифар и др. Medgrpo: Многозадачное обучение с подкреплением для понимания гетерогенных медицинских видео. arXiv preprint arXiv:2512.06581, 2025.
- ⟦Sun et al. [2026a] Ливэнь Сунь, Сян Юй, Мин Тан, Чжохао Чэнь, Аньци Чэн, Ашутош Джоши и Чэньян Сюн. Связывая знания с уходом: генерация медицинских уточняющих вопросов с использованием графов знаний. В сборнике трудов Ассоциации компьютерной лингвистики: EACL 2026, страницы 846–853, 2026a.
- ⟦Sun et al. [2026b] Юйсюань Сунь, Исюань Си, Чэнлу Чжу, Кай Чжан, Чжунъи Шуй, Бовэнь Дин, Тао Линь и Линь Ян. Cpathagent: Базовая модель на основе агентов для интерпретируемого анализа патологических изображений высокого разрешения, имитирующая диагностическую логику патологоанатомов. Advances in Neural Information Processing Systems, 38:101673–101731, 2026b.
- ⟦Sun et al. [2026c] Чжаои Сунь, Минал Джагтиани, Вэнь-вай Йим, Фэй Ся, Мартин Ганн, Мелиха Йетисген и Асма Бен Абача. Radar: Мультимодальный бенчмарк для проверки радиологических отчетов на основе 3D-изображений. arXiv preprint arXiv:2603.06681, 2026c.
- ⟦Surís et al. [2023] Дидак Сурис, Сачит Менон и Карл Вондрик. Vipergpt: Визуальный вывод посредством выполнения кода на Python для рассуждений. В материалах международной конференции IEEE/CVF по компьютерному зрению, страницы 11888–11898, 2023.
- ⟦Sviridov et al. [2025] Иван Свиридов, Амина Мифтахова, Артемий Терещенко, Галина Зубкова, Павел Блинов и Андрей Савченко. 3mdbench: Медицинский мультимодальный многоагентный диалоговый бенчмарк. В материалах конференции 2025 года по эмпирическим методам в обработке естественного языка, страница 26625–26665. Ассоциация компьютерной лингвистики, 2025. 10.18653/v1/2025.emnlp-main.1353. URL http://dx.doi.org/10.18653/v1/2025.emnlp-main.1353.
- ⟦Tan and Tian [2026] Шупин Тан и Чжаньсяо Тянь. Medresearchbench: многопрофильный бенчмарк для оценки исследовательских AI агентов в области клинических медицинских исследований. medRxiv, страницы 2026–03, 2026.
- ⟦Tang et al. [2024] Сянжу Тан, Анни Цзоу, Чжошэн Чжан, Цзымин Ли, Илунь Чжао, Синъяо Чжан, Арман Кохан и Марк Герштейн. Medagents: LLM как соавторы для медицинских рассуждений в режиме zero-shot. В сборнике Findings of the Association for Computational Linguistics: ACL 2024, страницы 599–621, 2024.
- ⟦Tang et al. [2025] Сянру Тан, Дэниел Шао, Дживунг Сон, Джиапенг Чен, Джиайи Чжан, Джинью Сян, Фанг Ву, Йилун Чжао, Ченглин Ву, Венци Ши и др. Medagentsbench: Бенчмаркинг моделей мышления и агентных фреймворков для комплексного медицинского рассуждения. arXiv preprint arXiv:2503.07459, 2025.
- ⟦Touvron et al. [2023] Хьюго Туврон, Луи Мартин, Кевин Стоун, Питер Альберт, Амджад Алмахайри, Ясмин Бабаеи, Николай Башлыков, Соумья Батра, Праджвал Бхаргава, Шрути Бхосале и др. Llama 2: Open foundation and fine-tuned chat models, 2023.
- ⟦Tu et al. [2024] Тао Ту, Анил Палепу, Майк Шакерманн, Халед Сааб, Ян Фрейберг, Рютаро Танно, Эми Ван, Бренна Ли, Мохамед Амин, Ненад Томашев и др. На пути к разговорному диагностическому AI. arXiv preprint arXiv:2401.05654, 2024.
- ⟦Tzanis and Klontzas [2025] Элефтериос Тзанис и Михаил Э. Клонцас. maistro: многоагентная система с открытым исходным кодом для автоматизированной разработки полного цикла моделей радиомики и глубокого обучения для медицинской визуализации. European Journal of Radiology Artificial Intelligence, страница 100044, 2025.
- ⟦Wan et al. [2023] Чжунвэй Ван, Синь Ван, Че Лю, Самиул Алам, Юй Чжэн, Цзячэнь Лю, Чжуннань Цюй, Шэнь Янь, И Чжу, Цюаньлу Чжан и др. Эффективные LLM: обзор. arXiv preprint arXiv:2312.03863, 2023.
- ⟦Wang et al. [2023a] Гуаньчжи Ван, Юйци Се, Юньфань Цзян, Аджай Мандлекар, Чаовэй Сяо, Юке Чжу, Линьси Фань и Анима Анандкумар. Voyager: Открытый воплощенный агент с использованием LLM. arXiv preprint arXiv:2305.16291, 2023a.
- ⟦Wang et al. [2023b] Лэй Ван, Ваньюй Сюй, Ихуай Лань, Чжицян Ху, Юньши Лань, Рой Ка-Вэй Ли и И-Пэн Лим. Plan-and-solve prompting: Улучшение zero-shot chain-of-thought рассуждений с помощью LLM. В материалах 61-й ежегодной конференции Ассоциации компьютерной лингвистики (том 1: длинные статьи), страницы 2609–2634, 2023b.
- ⟦Wang et al. [2024a] Лэй Ван, Чэнь Ма, Сюэян Фэн, Цзэюй Чжан, Хао Ян, Цзинсэнь Чжан, Чжиюань Чэнь, Цзякай Тан, Сюй Чэнь, Янькай Линь и др. Обзор автономных агентов на основе LLM. Frontiers of Computer Science, 18(6):186345, 2024a.
- ⟦Wang et al. [2025a] Пэнъюй Ван, Шучан Е, Усман Насим и Джинман Ким. Mrgagents: мультиагентная архитектура для улучшения генерации медицинских отчетов с использованием med-lvlms. В материалах Международной конференции 2025 года по цифровой обработке изображений: методы и приложения (DICTA), страницы 1–7. IEEE, 2025a.
- ⟦Wang et al. [2025b] Пэнъюй Ван, Шучан Е, Усман Насим и Джинман Ким. Mrg-r1: Обучение с подкреплением для клинически согласованной генерации медицинских отчетов. arXiv preprint arXiv:2512.16145, 2025b.
- ⟦Wang et al. [2025c] Тинг-Вэй Ван, Вэй-Тин Ло, Ю-Кан Ту, Ю-Бай Чоу и Ю-Те Ву. Систематический обзор и метаанализ одобренных регуляторами систем глубокого обучения для выявления диабетической ретинопатии по глазному дну. npj Digital Medicine, 2025c.
- ⟦Wang et al. [2024b] Синъяо Ван, Янъи Чэнь, Лифань Юань, Ичжэ Чжан, Юньчжу Ли, Хао Пэн и Хэн Цзи. Исполняемые программные действия улучшают LLM агентов. В материалах сорок первой Международной конференции по машинному обучению, 2024b.
- ⟦Wang et al. [2025d] Синъяо Ван, Босюань Ли, Юйфань Сун, Фрэнк Ф. Сюй, Сянжу Тан, Минчэнь Чжугэ, Цзяи Пань, Юэци Сун, Бовэнь Ли, Джаскират Сингх и др. Openhands: Открытая платформа для разработчиков программного обеспечения на базе AI в качестве агентов-универсалов. В материалах Международной конференции по обучению представлений, том 2025, страницы 65882–65919, 2025d.
- ⟦Wang et al. [2024c] Чжижо Ван, Дэниел Фрид и Грэм Нойбиг. Trove: Индуцирование верифицируемых и эффективных наборов инструментов для решения программных задач. arXiv preprint arXiv:2401.12869, 2024c.
- ⟦Wang et al. [2026] Зихан Ван, Хао Ван, Ши Фэн, Сяоцуй Ян, Далин Ван, Ицюнь Чжан, Цзинхао Линь, Сяочжун Цзи и Хайхуа Ян. Deepmed: создание медицинского агента для глубоких исследований с помощью многошагового медицинского поиска данных, а также обучения и вывода агентов с контролируемой очередностью ходов. В сборнике трудов Ассоциации компьютерной лингвистики: ACL 2026, страницы 18160–18178, 2026.
- ⟦Wang et al. [2025e] Цзысян Ван, Инхао Чжу, Хуэйя Чжао, Сяочэнь Чжэн, Дехао Суй, Тяньлун Ван, Вэнь Тан, Яша Ван, Юэн Харрисон, Чэнвэй Пан и др. Colacare: Улучшение моделирования EHR посредством многоагентного взаимодействия на основе LLM. В материалах конференции ACM on Web Conference 2025, страницы 2250–2261, 2025e.
- ⟦Wang et al. [2025f] Цзыюэ Ван, Цзюньдэ У, Линхань Цай, Чан Хань Лоу, Сихун Ян, Цясюань Ли и Юэмин Цзинь. Medagent-pro: На пути к доказательной мультимодальной медицинской диагностике посредством агентного рабочего процесса рассуждений. arXiv preprint arXiv:2503.18968, 2025f.
- ⟦Wang et al. [2024d] Зора Жируо Ван, Цзяюань Мао, Дэниел Фрид и Грэм Нойбиг. Память рабочих процессов агентов. arXiv preprint arXiv:2409.07429, 2024d.
- ⟦Wei et al. [2024] Хао Вэй, Цзянин Цю, Хайбао Юй и У Юань. Medco: Медицинские образовательные ассистенты на основе мультиагентной структуры. В сборнике: Европейская конференция по компьютерному зрению, страницы 119–135. Springer, 2024.
- ⟦Wei et al. [2022] Джейсон Вэй, Сюэчжи Ван, Дэйл Схурманс, Маартен Босма, Фэй Ся, Эд Чи, Куок В. Ле, Денни Чжоу и др. Промпт-инжиниринг с цепочкой рассуждений вызывает способность к логическому выводу у LLM. Достижения в системах нейронной обработки информации, 35:24824–24837, 2022.
- ⟦Wei et al. [2026] Юйсян Вэй, Оливье Дюшен, Джейд Копет, Квентин Карбонно, Лингминг Чжан, Дэниел Фрид, Габриэль Синнав, Ришаб Сингх и Сида Ван. Swe-rl: Совершенствование рассуждений LLM посредством обучения с подкреплением на основе эволюции открытого программного обеспечения. Advances in Neural Information Processing Systems, 38:78500–78525, 2026.
- ⟦Weishaupt et al. [2025] Лука Л. Вайсхаупт, Чэнкуан Чен, Дрю Ф. К. Уильямсон, Ричард Дж. Чен, Гийом Жом, Тонг Дин, Боуэн Чен, Анураг Вайдья, Лонг Фи Ле, Минг И. Лу и др. Доказательное диагностическое обоснование с использованием мультиагентного помощника для патологической анатомии человека. arXiv preprint arXiv:2506.20964, 2025.
- ⟦Wen et al. [2025] Сюмен Вэнь, Цзыхань Лю, Шунь Чжэн, Шэнъюй Е, Чжижун У, Ян Ван, Чжицзянь Сюй, Сяо Лян, Цзюньцзе Ли, Цзымин Мяо и др. Обучение с подкреплением с проверяемыми наградами неявно стимулирует правильное рассуждение в базовых LLM. arXiv preprint arXiv:2506.14245, 2025.
- ⟦Wu et al. [2025] Джунчэн У, Вэньлун Дэн, Синсюань Ли, Шэн Лю, Таомянь Ми, Ифань Пэн, Цзыян Сюй, И Лю, Хёнджин Чо, Чан-Ин Чой и др. Medreason: Выявление фактических этапов медицинского рассуждения в LLM с помощью графов знаний. arXiv preprint arXiv:2504.00993, 2025.
- ⟦Wu et al. [2026] Джунчэн Ву, Летиан Чжан, Юхан Ван, Хаоцинь Ту, Харди Чен, Зицзюнь Ван, Сихан Се и Юйин Чжоу. Clinseekagent: Автоматизация поиска мультимодальных доказательств для агентного клинического рассуждения. arXiv preprint arXiv:2605.20176, 2026.
- ⟦Wu et al. [2023] Цинъюнь У, Гаган Бансал, Цзеюй Чжан, Ижань У, Шаокунь Чжан, Эркан Чжу, Бейбинь Ли, Ли Цзян, Сяоюнь Чжан и Чи Ван. Autogen: создание приложений LLM нового поколения с помощью платформы многоагентного взаимодействия. arXiv preprint arXiv:2308.08155, 3(4), 2023.
- ⟦Xi et al. [2025] Чжихэн Си, Вэньсян Чэнь, Синь Го, Вэй Хэ, Ивэнь Дин, Боян Хун, Мин Чжан, Цзюньчжэ Ван, Сэньцзе Цзинь, Эньюй Чжоу и др. Восхождение и потенциал агентов на основе LLM: Обзор. Science China Information Sciences, 68(2):121101, 2025.
- ⟦Xia et al. [2024a] Пэн Ся, Цзэ Чэнь, Хуаньси Тянь, Янжуй Гун, Жуйбо Хоу, Юэ Сюй, Чжэньбан У, Чжиюань Фань, Иян Чжоу, Канъюй Чжу, Вэньхао Чжэн, Чжаоян Ван, Сяо Ван, Сючао Чжан, Четан Бансал, Марк Нитхаммер, Цзюньчжоу Хуан, Хунту Чжу, Юнь Ли, Цзимен Сунь, Цзунъюань Гэ, Ган Ли, Джеймс Цзоу и Хуасю Яо. Cares: Комплексный эталонный тест надежности медицинских vision-language models, 2024a. URL https://arxiv.org/abs/2406.06007.
- ⟦Xia et al. [2024b] Пэн Ся, Цзэ Чэнь, Хуаньси Тянь, Янжуй Гун, Жуйбо Хоу, Юэ Сюй, Чжэньбан У, Чжиюань Фань, Иян Чжоу, Канъюй Чжу и др. Cares: Комплексный эталонный тест для оценки надежности медицинских vision-language models. Advances in Neural Information Processing Systems, 37:140334–140365, 2024b.
- ⟦Xia et al. [2024c] Пэн Ся, Канъюй Чжу, Хаорань Ли, Хунту Чжу, Юнь Ли, Ган Ли, Линьцзюнь Чжан и Хуасю Яо. Rule: Надежный мультимодальный RAG для обеспечения фактической точности в медицинских vision-language models. В сборнике трудов конференции 2024 Conference on Empirical Methods in Natural Language Processing, страницы 1081–1093, 2024c.
- ⟦Xia et al. [2025] Пэн Ся, Цзинлу Ван, Ибо Пэн, Кайдэ Цзэн, Цзыхань Дун, Сянь У, Сянру Тан, Хунту Чжу, Юнь Ли, Линьцзюнь Чжан и др. Mmedagent-rl: Оптимизация мультиагентного взаимодействия для мультимодальных медицинских рассуждений. arXiv preprint arXiv:2506.00555, 2025.
- ⟦Xiang et al. [2024] Чжэнь Сян, Линьчжи Чжэн, Яньцзе Ли, Цзюньюань Хун, Циньбинь Ли, Хань Се, Цзявэй Чжан, Цзыди Сюн, Чулинь Се, Карл Ян и др. Guardagent: защита LLM агентов с помощью агента-стража посредством рассуждений на основе знаний. arXiv preprint arXiv:2406.09187, 2024.
- ⟦Xiao et al. [2025] Ин Сяо, Цзе Хуан, Жуйцзюань Хэ, Цзин Сяо, Мохаммад Реза Мусави, Епан Лю, Кечжи Ли, Чжэньпэн Чэнь и Цзе М. Чжан. Amqa: Состязательный набор данных для бенчмаркинга предвзятости LLM в медицине и здравоохранении. arXiv preprint arXiv:2505.19562, 2025.
- ⟦Xie et al. [2026] Юйчжан Се, Кеци Хань, Юньпэн Сяо, Хэцзе Цуй, Гуаньчэнь У, Цзыян Чжан, Кай Шу, Цзяин Лу, Сяо Ху и Карл Ян. Ehrbench: автоматизированный и надежный бенчмарк на основе EHR для принятия клинических решений с помощью LLM. arXiv preprint arXiv:2605.30637, 2026.
- ⟦Xu et al. [2025a] Байсюань Сюй, Чуньян Ли, Вэйци Ван, Вэй Фань, Тяньши Чжэн, Хаочэнь Ши, Тао Фань, Янцю Сун и Цян Ян. На пути к мультиагентным системам рассуждения для совместного делегирования экспертных знаний: поисковое проектное исследование, 2025a. URL https://arxiv.org/abs/2505.07313.
- ⟦Xu et al. [2025b] Ран Сюй, Юйчэнь Чжуан, Ишань Чжун, Юэ Юй, Цзыфэн Ван, Сянжу Тан, Хан У, Мэй Д. Ван, Пэйфэн Жуань, Дунхань Ян и др. Medagentgym: Масштабируемая агентная среда обучения для рассуждений, ориентированных на код, в биомедицинской науке о данных. arXiv preprint arXiv:2506.04405, 2025b.
- ⟦Xu et al. [2025c] Вэйвэнь Сюй, Хоу Понг Чан, Лонг Ли, Махани Альджунид, Жуйфэн Юань, Цзяньюй Ван, Чэнхао Сяо, Гуйчжэнь Чэнь, Чаоцюнь Лю, Чжаодунхуэй Ли и др. Lingshu: универсальная фундаментальная модель для унифицированного мультимодального медицинского понимания и рассуждения. arXiv preprint arXiv:2506.07044, 2025c.
- ⟦Xu et al. [2026] Уцзян Сюй, Цзуцзе Лян, Кай Мэй, Хан Гао, Цзюньтао Тань и Юнфэн Чжан. A-mem: Агентная память для LLM агентов. Advances in Neural Information Processing Systems, 38:17577–17604, 2026.
- ⟦Yan et al. [2026] Вэйсян Янь, Хайтянь Лю, Тэнсяо У, Цянь Чэнь, Вэнь Ван, Хаоюань Чай и Цзяи Ван. Clinicallab: Согласование агентов для многопрофильной клинической диагностики в реальных условиях. Advances in Neural Information Processing Systems, 38, 2026.
- ⟦Yang et al. [2017] Гуан-Чжун Ян, Джеймс Камбиас, Кевин Клири, Эрик Даймлер, Джеймс Дрейк, Пьер Э. Дюпон, Нобухико Хата, Питер Казанзидес, Сильвен Мартель, Раджни В. Патель и др. Медицинская робототехника — регуляторные, этические и правовые аспекты повышения уровней автономности, 2017.
- ⟦Yang et al. [2024] Джон Янг, Карлос Хименес, Александр Веттиг, Килиан Лирет, Шунью Яо, Картик Нарасимхан и Офир Пресс. Swe-agent: Агентно-компьютерные интерфейсы обеспечивают автоматизированную разработку программного обеспечения. Достижения в системах обработки нейронной информации, 37:50528–50652, 2024.
- ⟦Yang et al. [2025a] Линжуй Ян, Юйсин Чжоу, Цзюнь Ци, Сяньтун Чжэнь, Ли Сунь, Шань Ши, Цинхуа Су и Сюэдун Ян. Согласование LLM с рентгенологами посредством обучения с подкреплением на основе AI feedback для отчетов по компьютерной томографии грудной клетки. European Journal of Radiology, 184:111984, 2025a.
- ⟦Yang et al. [2025b] Ицзюнь Ян, Чжао-Ян Ван, Цюпин Лю, Шувэнь Сунь, Кан Ван, Рама Челлаппа, Цзунвэй Чжоу, Алан Юйль, Лэй Чжу, Юй-Дун Чжан и др. Медицинская модель мира: Генеративное моделирование эволюции опухоли для планирования лечения. arXiv preprint arXiv:2506.02327, 2025b.
- ⟦Yang et al. [2023] Чжэнъюань Ян, Линьцзе Ли, Цзяньфэн Ван, Кевин Лин, Эхсан Азарнасаб, Фейсал Ахмед, Цзычэн Лю, Се Лю, Майкл Цзэн и Лицзюань Ван. Mm-react: Использование промптов для ChatGPT в целях мультимодальных рассуждений и действий. arXiv preprint arXiv:2303.11381, 2023.
- ⟦Yang et al. [2026] Чжичао Ян, Сепехр Джангорбани, Дунсюй Чжан, Цзюнь Хань, Цянь Цянь, Эндрю Ресслер II, Грегори Д. Линг, Санджит Сингх Батра и Роберт Э. Тиллман. Health-score: На пути к масштабируемым критериям для улучшения health-LLM. arXiv preprint arXiv:2601.18706, 2026.
- ⟦Yang et al. [2025c] Чжихэ Ян, Сюфан Ло, Дунци Хань, Юньцзянь Сюй и Дуншэн Ли. Смягчение галлюцинаций в больших vision-language models посредством DPO: On-policy данные играют ключевую роль. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 10610–10620, 2025c.
- ⟦Yao et al. [2022] Шуньюй Яо, Джеффри Чжао, Диань Юй, Нань Ду, Ицхак Шафран, Картик Нарасимхан и Юань Цао. React: Синергия рассуждения и действия в языковых моделях. arXiv preprint arXiv:2210.03629, 2022.
- ⟦Yao et al. [2023] Шуньюй Яо, Дянь Юй, Джеффри Чжао, Ицхак Шафран, Том Гриффитс, Юань Цао и Картик Нарасимхан. Древо мыслей: осознанное решение задач с помощью LLM. Достижения в системах нейронной обработки информации, 36:11809–11822, 2023.
- ⟦Ye and Tang [2025] Цзяруй Е и Хао Тан. Мультимодальные LLM для медицины: всесторонний обзор. arXiv preprint arXiv:2504.21051, 2025.
- ⟦Yi et al. [2025] Зируо И, Цзиньюй Лю, Марк В. Альберт и Тин Сяо. Мультиагентная система для комплексного логического вывода в задачах визуальных ответов на вопросы по радиологии. В материалах совместной конференции ACM/IEEE по цифровым библиотекам (JCDL) 2025 года, страницы 139–147. IEEE, 2025..
- ⟦Yin et al. [2024] Сюньцзянь Инь, Синьи Ван, Лянмин Пань, Ли Линь, Сяоцзюнь Ван и Уильям Ян Ван. G" odel agent: фреймворк самореферентных агентов для рекурсивного самосовершенствования. arXiv preprint arXiv:2410.04444, 2024.
- ⟦Yu et al. [2025] Эйлин Ю, Лан Яо, Цзиннань Лю, Чжэ Чэнь, Цзяцзюнь Инь, Юань Ван, Синьхао Ляо, Чжилин Е, Цзи Ли, Юнь Юэ и др. Medresearcher-r1: Медицинский глубокий исследователь экспертного уровня на основе фреймворка синтеза траекторий с учетом знаний. arXiv preprint arXiv:2508.14880, 2025.
- ⟦Yu et al. [2023] Фейян Ю, Марк Эндо, Раян Кришнан, Иан Пан, Энди Цай, Эдуардо Понтес Рейс, ЭКУ Фонсека, Энрике Ли, Захра Шакери, Эндрю Ын и др. Набор данных экспертной оценки радиологических отчетов (rexval), 2023.
- ⟦Yu et al. [2026a] Циин Юй, Чжэн Чжан, Жофэй Чжу, Юфэн Юань, Сяочэнь Цзо, Ю Юэ, Вэйнань Дай, Тяньтянь Фань, Гаохун Лю, Линцзюнь Лю и др. Dapo: Масштабируемая система обучения с подкреплением для LLM с открытым исходным кодом. Advances in Neural Information Processing Systems, 38:113222–113244, 2026a.
- ⟦Yu et al. [2026b] И Юй, Люи Яо, Юэсян Се, Цинцюань Тань, Цзяци Фэн, Ялян Ли и Либин У. Агентная память: обучение унифицированному управлению долгосрочной и краткосрочной памятью для агентов на базе LLM, 2026b. URL https://arxiv.org/abs/2601.01885.
- ⟦Yue et al. [2026] Линг Юэ, Кушал Радж Бхандари, Чинг-Юн Ко, Дхавал Патель, Шуксин Лин, Нианджун Чжоу, Цзяньси Гао, Пин-Ю Чен и Шаову Пан. От статических шаблонов к динамическим графам выполнения: обзор оптимизации рабочих процессов для LLM агентов. arXiv preprint arXiv:2603.22386, 2026.
- ⟦Zeng et al. [2024] Фан Цзэн, Чжилян Люй, Цюаньчжэн Ли и Сян Ли. Улучшение LLM для генерации заключений в радиологических отчетах с помощью мультиагентной системы. arXiv preprint arXiv:2412.06828, 2024.
- ⟦Zeng et al. [2025] Силианг Зенг, Куан Вэй, Уильям Браун, Оана Фрунза, Юрий Невмявака, Янг Кэти Чжао и Минги Хонг. Усиление многоходового рассуждения в LLM агентах посредством распределения кредита на уровне хода. В материалах семинара ICML 2025 по компьютерным агентам, 2025.
- ⟦Zhang et al. [2025a] Барри Чжан, Кит Лазука и Махеш Мураг. Оснащение агентов навыками для работы в реальном мире. Блог инженерии Anthropic, 2025a.
- ⟦Zhang et al. [2025b] Гуйбинь Чжан, Хэцзя Гэн, Сяохан Юй, Чжэньфэй Инь, Цзайбинь Чжан, Цзэлинь Тань, Хэн Чжоу, Чжунчжи Ли, Сянъюань Сюэ, Ицзян Ли и др. Ландшафт агентного обучения с подкреплением для LLM: Обзор. arXiv preprint arXiv:2509.02547, 2025b.
- ⟦Zhang et al. [2025c] Гуйбинь Чжан, Луян Ню, Цзюньфэн Фан, Кунь Ван, Лэй Бай и Сян Ван. Поиск мультиагентной архитектуры с помощью агентной суперсети. arXiv preprint arXiv:2502.04180, 2025c.
- ⟦Zhang et al. [2026a] Гуйбинь Чжан, Мусинь Фу, Кунь Ван, Фрэнк Ван, Мяо Юй и Шуйчэн Янь. G-memory: Отслеживание иерархической памяти для мультиагентных систем. Advances in Neural Information Processing Systems, 38:12988–13018, 2026a.
- ⟦Zhang et al. [2025d] Ханьчэнь Чжан, Сяо Лю, Бовэнь Люй, Сюэцяо Сунь, Бохао Цзин, Ят Лун Ионг, Чжэньюй Хоу, Цзэхань Ци, Ханьюй Лай, Ифань Сюй и др. Agentrl: Масштабирование агентного обучения с подкреплением с помощью многоходовой многозадачной структуры. arXiv preprint arXiv:2510.04206, 2025d.
- ⟦Zhang et al. [2025e] Дженни Чжан, Шенгран Ху, Конг Лу, Роберт Ланге и Джефф Клюн. Машина Дарвина-Гёделя: Открытая эволюция самосовершенствующихся агентов. arXiv preprint arXiv:2505.22954, 2025e.
- ⟦Zhang et al. [2025f] Кай Чжан, Кори Д. Барретт, Джангвон Ким, Личао Сун, Тара Тагави и Кришнарам Кентапади. Radagents: Мультимодальное агентное рассуждение для интерпретации рентгенограмм грудной клетки с использованием рабочих процессов, подобных работе врача-радиолога. arXiv preprint arXiv:2509.20490, 2025f.
- ⟦Zhang et al. [2025g] Цичжэн Чжан, Чанран Ху, Шубханги Упасани, Боюань Ма, Фэнлу Хун, Вамсидхар Камануру, Джей Рейнтон, Чэнь У, Мэнмэн Цзи, Ханьчэнь Ли и др. Агентная контекстная инженерия: развитие контекстов для самообучающихся языковых моделей. arXiv preprint arXiv:2510.04618, 2025g.
- ⟦Zhang et al. [2023] Шенг Чжан, Янбо Сюй, Наото Усуяма, Джасприт Багбер, Роберт Тинн, Сэм Престон, Раджеш Драган, Абдулла Муин, Тристан Науманн, Клифф Вонг и др. Biomedclip: Мультимодальная биомедицинская фундаментальная модель, предварительно обученная на пятнадцати миллионах пар научных изображений и текстов, 2023.
- ⟦Zhang et al. [2026b] Вэньчуань Чжан, Цзинжу Го, Хэнчжэ Чжан, Пэнхао Чжан, Цзе Чэнь, Шувань Чжан, Чжан Чжан, Юйхао И и Хун Бу. Patho-agenticrag: на пути к мультимодальной агентной генерации с дополнением поиском для патологических VLM посредством обучения с подкреплением. В материалах конференции AAAI по искусственному интеллекту, том 40, страницы 29921–29929, 2026b.
- ⟦Zhang et al. [2026c] Вэньчуань Чжан, Пэнхао Чжан, Цзинжу Го, Тао Чэн, Цзе Чэнь, Шувань Чжан, Чжан Чжан, Юйхао И и Хун Бу. Patho-r1: Мультимодальный экспертный рассуждатель в области патологии на основе обучения с подкреплением. В материалах конференции AAAI по искусственному интеллекту, том 40, страницы 28418–28426, 2026c.
- ⟦Zhang et al. [2025h] Сянсюй Чжан, Лэй Ли, Сяо Чжоу и Чжэн Лю. R2med: эталонный тест для медицинского поиска, основанного на рассуждениях. arXiv preprint arXiv:2505.14558, 2025h.
- ⟦Zhao et al. [2024] Эндрю Чжао, Дэниел Хуан, Квентин Сюй, Матье Лин, Юн-Цзинь Лю и Гао Хуан. Expel: LLM агенты являются эмпирическими обучающимися. В материалах конференции AAAI по искусственному интеллекту, том 38, страницы 19632–19642, 2024.
- ⟦Zheng et al. [2025] Чуцзе Чжэн, Шисюань Лю, Минцзэ Ли, Сюн-Хуэй Чэнь, Бовэнь Юй, Чан Гао, Кай Дан, Юйцюн Лю, Жуй Мэнь, Ань Ян и др. Group sequence policy optimization. arXiv preprint arXiv:2507.18071, 2025.
- ⟦Zheng et al. [2024] Лунгао Чжэн, Рундун Ван, Синьжунь Ван и Бо Ань. Synapse: промптинг на основе траекторий как примеров с использованием памяти для управления компьютером. В сборнике Международной конференции по обучению представлениям, том 2024, страницы 19036–19066, 2024.
- ⟦Zhong et al. [2026] Луцзя Чжун, Ихао Ся, Цзяньвэй Чжан, Цзясинь Юэ, Минъян Ся, Юнган Ши и др. Neuroagent: LLM агенты для мультимодального анализа нейровизуализации и исследований. arXiv preprint arXiv:2605.06584, 2026.
- ⟦Zhou et al. [2022] Денни Чжоу, Натанаэль Шэрли, Ле Хоу, Джейсон Вэй, Натан Скейлс, Сюэчжи Ван, Дейл Схурманс, Клэр Цуй, Оливье Буске, Куок Ле и др. Промптинг от простого к сложному обеспечивает комплексное логическое мышление в LLM. arXiv preprint arXiv:2205.10625, 2022.
- ⟦Zhou et al. [2024] Пей Чжоу, Джей Пуджара, Сян Жэнь, Синьюнь Чэнь, Хэн-Цзэ Чэн, Куок В. Ле, Денни Чжоу, Сваруп Мишра, Хуайсю С. Чжэн и др. Self-discover: Большие языковые модели самостоятельно формируют структуры рассуждений. Достижения в системах нейронной обработки информации, 37:126032–126058, 2024.
- ⟦Zhou et al. [2026] Цинь Чжоу, Гоянь Лян, Цяньи Ян, Цзинъюань Чэнь, Сай У, Чан Яо и Чжэ Ван. Улучшение reinforcement learning для генерации радиологических отчетов с помощью evidence-aware rewards и self-correcting preference learning, 2026. URL https://arxiv.org/abs/2604.13598.
- ⟦Zhou et al. [2025] Юйчэн Чжоу, Линран Сун и Цзяньбин Шэнь. Mam: Модульная мультиагентная система для мультимодальной медицинской диагностики посредством специализированного ролевого взаимодействия. В сборнике Findings of the Association for Computational Linguistics: ACL 2025, страницы 25319–25333, 2025.
- ⟦Zhu et al. [2026a] Чунчжэн Чжу, Янфан Линь, Шэнь Чэнь, Ицзюнь Ван и Цзяньсинь Линь. Medeyes: Обучение динамическому визуальному фокусу для прогрессивной медицинской диагностики. В материалах конференции AAAI по искусственному интеллекту, том 40, страницы 13916–13924, 2026a.
- ⟦Zhu et al. [2026b] Чунчжэн Чжу, Цзяци Цзэн, Цзюньюй Цзян, Цзяньсинь Линь и Ицзюнь Ван. Medsynapse-v: Соединение визуального восприятия и клинической интуиции посредством эволюции латентной памяти. arXiv preprint arXiv:2604.26283, 2026b.
- ⟦Zhu et al. [2025a] Цзиньго Чжу, Вэйюнь Ван, Чжэ Чэнь, Чжаоян Лю, Шэнлун Е, Лисинь Гу, Хао Тянь, Юйчэнь Дуань, Вэйцзе Су, Цзе Шао и др. Internvl3: Исследование передовых методов обучения и стратегий тестирования для мультимодальных моделей с открытым исходным кодом. arXiv preprint arXiv:2504.10479, 2025a.
- ⟦Zhu et al. [2025b] Кинг Чжу, Ханхао Ли, Сивэй У, Тяньшунь Син, Дехуа Ма, Сянру Тан, Минхао Лю, Цзянь Ян, Цзяхэн Лю, Юйчэнь Элеонора Цзян и др. Масштабирование вычислительных ресурсов на этапе тестирования для LLM агентов. arXiv preprint arXiv:2506.12928, 2025b.
- ⟦Zhu et al. [2026c] Инхао Чжу, Цзыи Хэ, Хаоран Ху, Сяочэнь Чжэн, Сичэнь Чжан, Ван Ван, Цзюньи Гао, Ляньтао Ма и Лэцюань Юй. Medagentboard: бенчмаркинг многоагентного взаимодействия с использованием традиционных методов для решения разнообразных медицинских задач. Advances in Neural Information Processing Systems, 38, 2026c.
- ⟦Zhu et al. [2026d] Ивэнь Чжу, Лихэ Лю, Цзяцянь Юй и Ди Чжан. Оркестрация мультиагентных систем на основе LLM: обзор фреймворков, протоколов коммуникации и возникающих паттернов. 2026d.
- ⟦Zhuge et al. [2024] Мингчен Чжугэ, Вэньи Ван, Луи Кирш, Франческо Фаччо, Дмитрий Хизбуллин и Юрген Шмидхубер. Gptswarm: Языковые агенты как оптимизируемые графы. В рамках Сорок первой международной конференции по машинному обучению, 2024.
- ⟦Zong et al. [2026] Зефан Цзун, Динвэй Чэнь, Ян Ли, Ци И, Бо Чжоу, Чэнмин Ли, Бо Цянь, Пэн Чэнь и Цзе Цзян. At2po: Агентная пошаговая оптимизация стратегии посредством древовидного поиска. arXiv preprint arXiv:2601.04767, 2026.
- ⟦Zou and Topol [2025] Джеймс Зоу и Эрик Дж. Топол. Расцвет агентных ИИ-коллег в медицине. The Lancet, 405(10477):457, 2025.
- ⟦Zuo and Jiang [2024] Кайвэнь Цзо и Ижуй Цзян. Medhallbench: Новый бенчмарк для оценки галлюцинаций в медицинских LLM. arXiv preprint arXiv:2412.18947, 2024.
- ⟦Zuo et al. [2025] Юйсинь Цзо, Шан Цюй, Ифэй Ли, Чжанжэнь Чэнь, Сюэкай Чжу, Эрмо Хуа, Кайянь Чжан, Нин Дин и Бовэнь Чжоу. Medxpertqa: Тестирование экспертного уровня медицинских рассуждений и понимания. arXiv preprint arXiv:2501.18362, 2025.
- ⟦Zweiger et al. [2026] Адам Цвайгер, Джо Пари, Хан Го, Юн Ким и Пулкит Агравал. Самоадаптирующиеся языковые модели. Достижения в системах нейронной обработки информации, 38:74084–74115, 2026.