Рабочий документ
[⟦]Адресат для корреспонденции: me@ajayp.app
0Year 0Year 0Year
Производительность Frontier AI в бизнес-дисциплинах: бенчмарк интеллектуальной работы и аналитического мышления на основе кейс-стади
Аннотация
Большие языковые модели (LLM) стремительно совершенствуются, что отражается в результатах бенчмарков, однако эти AI-бенчмарки в основном проверяют такие способности, как воспроизведение фактов, ответы на узкие вопросы, решение математических задач, а также написание кода и использование агентских инструментов. Плохо измеренным остается прогресс AI в аналитической интеллектуальной работе, которую ежедневно выполняют «белые воротнички», включая синтез сложной информации, проявление суждения в условиях неопределенности и неполноты данных, применение стратегического и состязательного мышления в условиях взаимодействия с множеством заинтересованных сторон, взвешивание компромиссов и подготовку обоснованных, структурированных аналитических материалов. Этот пробел еще более выражен для субъективных компонентов такой работы, где успех бывает сложно определить. Форма обучения «кейс-метод», практикуемая в ведущих бизнес-школах, обеспечивает естественную основу для устранения этого пробела в измерениях, и мы создаем BusinessCaseBench — бенчмарк, охватывающий сотни вопросов, взятых из бизнес-кейсов по восемнадцати дисциплинам, каждый из которых сопровождается критериями оценки, полученными из экспертных решений кейсов, написанных преподавателями. В BusinessCaseBench передовые AI-модели уже получают высокие оценки по преподавательским критериям, а возможности внутри одного семейства моделей существенно улучшаются в течение двух лет. Эти результаты служат убедительным доказательством того, что производительность AI в этом классе задач уже высока и быстро растет, что имеет значение как для бизнес-школ, где кейс-педагогика обучает студентов бакалавриата и MBA такому типу аналитического мышления, так и для профессиональных ролей начального уровня, где подобные навыки исторически составляли основу работы на ранних этапах карьеры..
ключевые слова:
интеллектуальный труд, аналитическое мышление, бизнес, образование, бенчмарк, ИИ, LLM[Заявление о значимости] Бизнес-школы обучают студентов принятию решений и аналитическому мышлению: чтению финансовых отчетов, оценке рыночной и конкурентной среды, проектированию операций, оценке стратегии — формируя аналитиков, менеджеров и лидеров в бизнесе и офисных ролях. Мы показываем, что передовые LLM уже выполняют эти навыки на высоком уровне по восемнадцати бизнес-дисциплинам, оцениваясь по стандартам, написанным экспертами. Лонгитюдное сравнение внутри одного семейства моделей фиксирует прирост примерно на 23 процентных пункта за два года. Мы представляем BusinessCaseBench, валидированный, охватывающий различные дисциплины бенчмарк для AI в бизнес-рассуждениях и интеллектуальной работе, который меняет эмпирический вопрос: не может ли AI выполнять ту работу, которой обучают в бизнес-образовании, а как бизнес-образование и профессиональные роли могут измениться по мере перераспределения аналитических способностей между людьми и машинами..
1 Введение
Оценки бенчмарков для LLM стремительно растут (gpt3_few_shot_learners; singh_openai_2026), однако тесты, стимулирующие этот рост, по большей части оценивают узкий набор четко определенных компетенций: воспроизведение фактов, узкоспециализированные QA, решение математических задач, а также программирование и использование агентских инструментов (joshi_triviaqa_2017; zellers_hellaswag_2019; hendrycks_measuring_2021; chen_evaluating_2021; hendrycks_measuring_2021-1; jimenez_swe-bench_2024; merrill_terminal-bench_2026). Такой подход хорошо подходит для случаев, когда правильность ответа однозначна и его можно проверить по известным фактам, вычисленным значениям или перечислимым вариантам выбора. Однако эта модель не позволяет охватить способности, необходимые для аналитической интеллектуальной работы, которую офисные специалисты выполняют каждый день. Такая работа требует синтеза сложной информации, проявления суждения в условиях неопределенности и неполноты данных, стратегического и состязательного мышления в условиях взаимодействия с множеством заинтересованных сторон, взвешивания компромиссов и подготовки обоснованных, структурированных аналитических материалов — особенно там, где успех зависит от субъективного суждения и проработки нескольких вариантов, а не от единственного проверяемого ответа. Это именно тот вид деятельности, которому обучают студентов в бизнес-школах и который представляет экономическую ценность для организаций и фирм, однако он практически не измеряется в существующих бенчмарках (patwardhan_gdpval_2025; wang_how_2026).
Близкая аналогия в медицине иллюстрирует тот же разрыв в измерениях и конструктивный прецедент. Высокие баллы LLM на экзамене на получение медицинской лицензии в США (USMLE) заставили многих сделать вывод, что LLM сравнялись с клиническим мышлением, однако вопросы USMLE представляют собой суррогаты с множественным выбором, оптимизированные для административного масштабирования, а не для открытого синтеза, который высококвалифицированные клиницисты выполняют в реальных случаях. nori_sequential_2025 вместо этого оценивали модели на основе клинических задач из New England Journal of Medicine — клинически сложных и написанных экспертами диагностических повествований-головоломок с последующими решениями, — используя каждый случай и его разрешение для проверки рассуждений в условиях, приближенных к подлинной практике, со всей двусмысленностью и неопределенностью реальной клинической работы. Frontier модели показали высокие результаты при таком подходе, несмотря на то, что подобные клинические задачи призваны быть редкими и трудными для решения, что привело к новым выводам о силе медицинского мышления в Frontier AI. Данная формулировка подтвердила, что написанные экспертами профессиональные кейсы являются более сложной и реалистичной альтернативой узким бенчмаркам экзаменационного типа, таким как USMLE..
Кейсы бизнес-школ занимают в профессиональном образовании ту же нишу, что и клинические разборы NEJM в подготовке и обучении врачей. Это тщательно отобранные, значимые, написанные экспертами нарративы, которые помещают обучающихся в реалистичные контексты принятия решений, требующие синтеза сложной информации, суждений в условиях неопределенности и неполных данных, стратегического мышления с учетом интересов множества сторон, взвешивания компромиссов и аргументированного структурированного анализа, а не простого заучивания или воспроизведения фактов, как показано в Таблице 1. Лицензирование этих кейсов издателями и их использование в образовательной среде также ограничивает доступ к ним на этапе предварительного обучения и риск загрязнения данных, что делает эти кейсы сильным кандидатом для оценки (Xu2024BenchmarkDC). Эти кейсы часто создаются профессорами бизнес-школ, имеющими опыт проведения полевых исследований, для описания исторической ситуации в реальной организации или фирме, либо гипотетической ситуации в вымышленной фирме с целью обучения студентов конкретной бизнес-дисциплине (rebeiz_insider_2011; Nohria2021CaseMethod). Предыдущие попытки бенчмаркинга LLM в задачах, связанных с бизнесом, оставались узкоспециализированными: некоторые из них были направлены на численные рассуждения в финансах (chen_finqa_2022; koncel-kedziorski_bizbench_2024; wu_bloomberggpt_2023; xie_finben_2024), другие оценивали смежные с предметной областью языковые задачи, такие как следование формату или создание рекламных текстов (xia_fofo_2024; liu_llms_2025; wang_enterprise_2025), а также появилось растущее направление работ по оценке LLM агентов, работающих в корпоративных программных системах или интерактивных средах, специфичных для предметной области (drouin_workarena_2024; boisvert_workarena_2025; huang_crmarena_2025; huang_crmarena-pro_2025; li_investorbench_2024; xu_theagentcompany_2025; patwardhan_gdpval_2025). В нескольких недавних работах производительность ИИ измерялась с помощью бизнес-кейсов или симуляций (ai_biz_impact_3; dellacqua2026jagged; allen2026strategy), но они ограничены по охвату бизнес-дисциплин и видов интеллектуальной деятельности. Эти предыдущие бенчмарки и исследования предоставляют полезные сигналы о конкретных способностях, значимых для бизнеса и интеллектуальной деятельности, но ни один из них не измеряет открытую аналитическую работу во всем спектре бизнес-дисциплин в условиях, которые отражают подлинное профессиональное суждение..
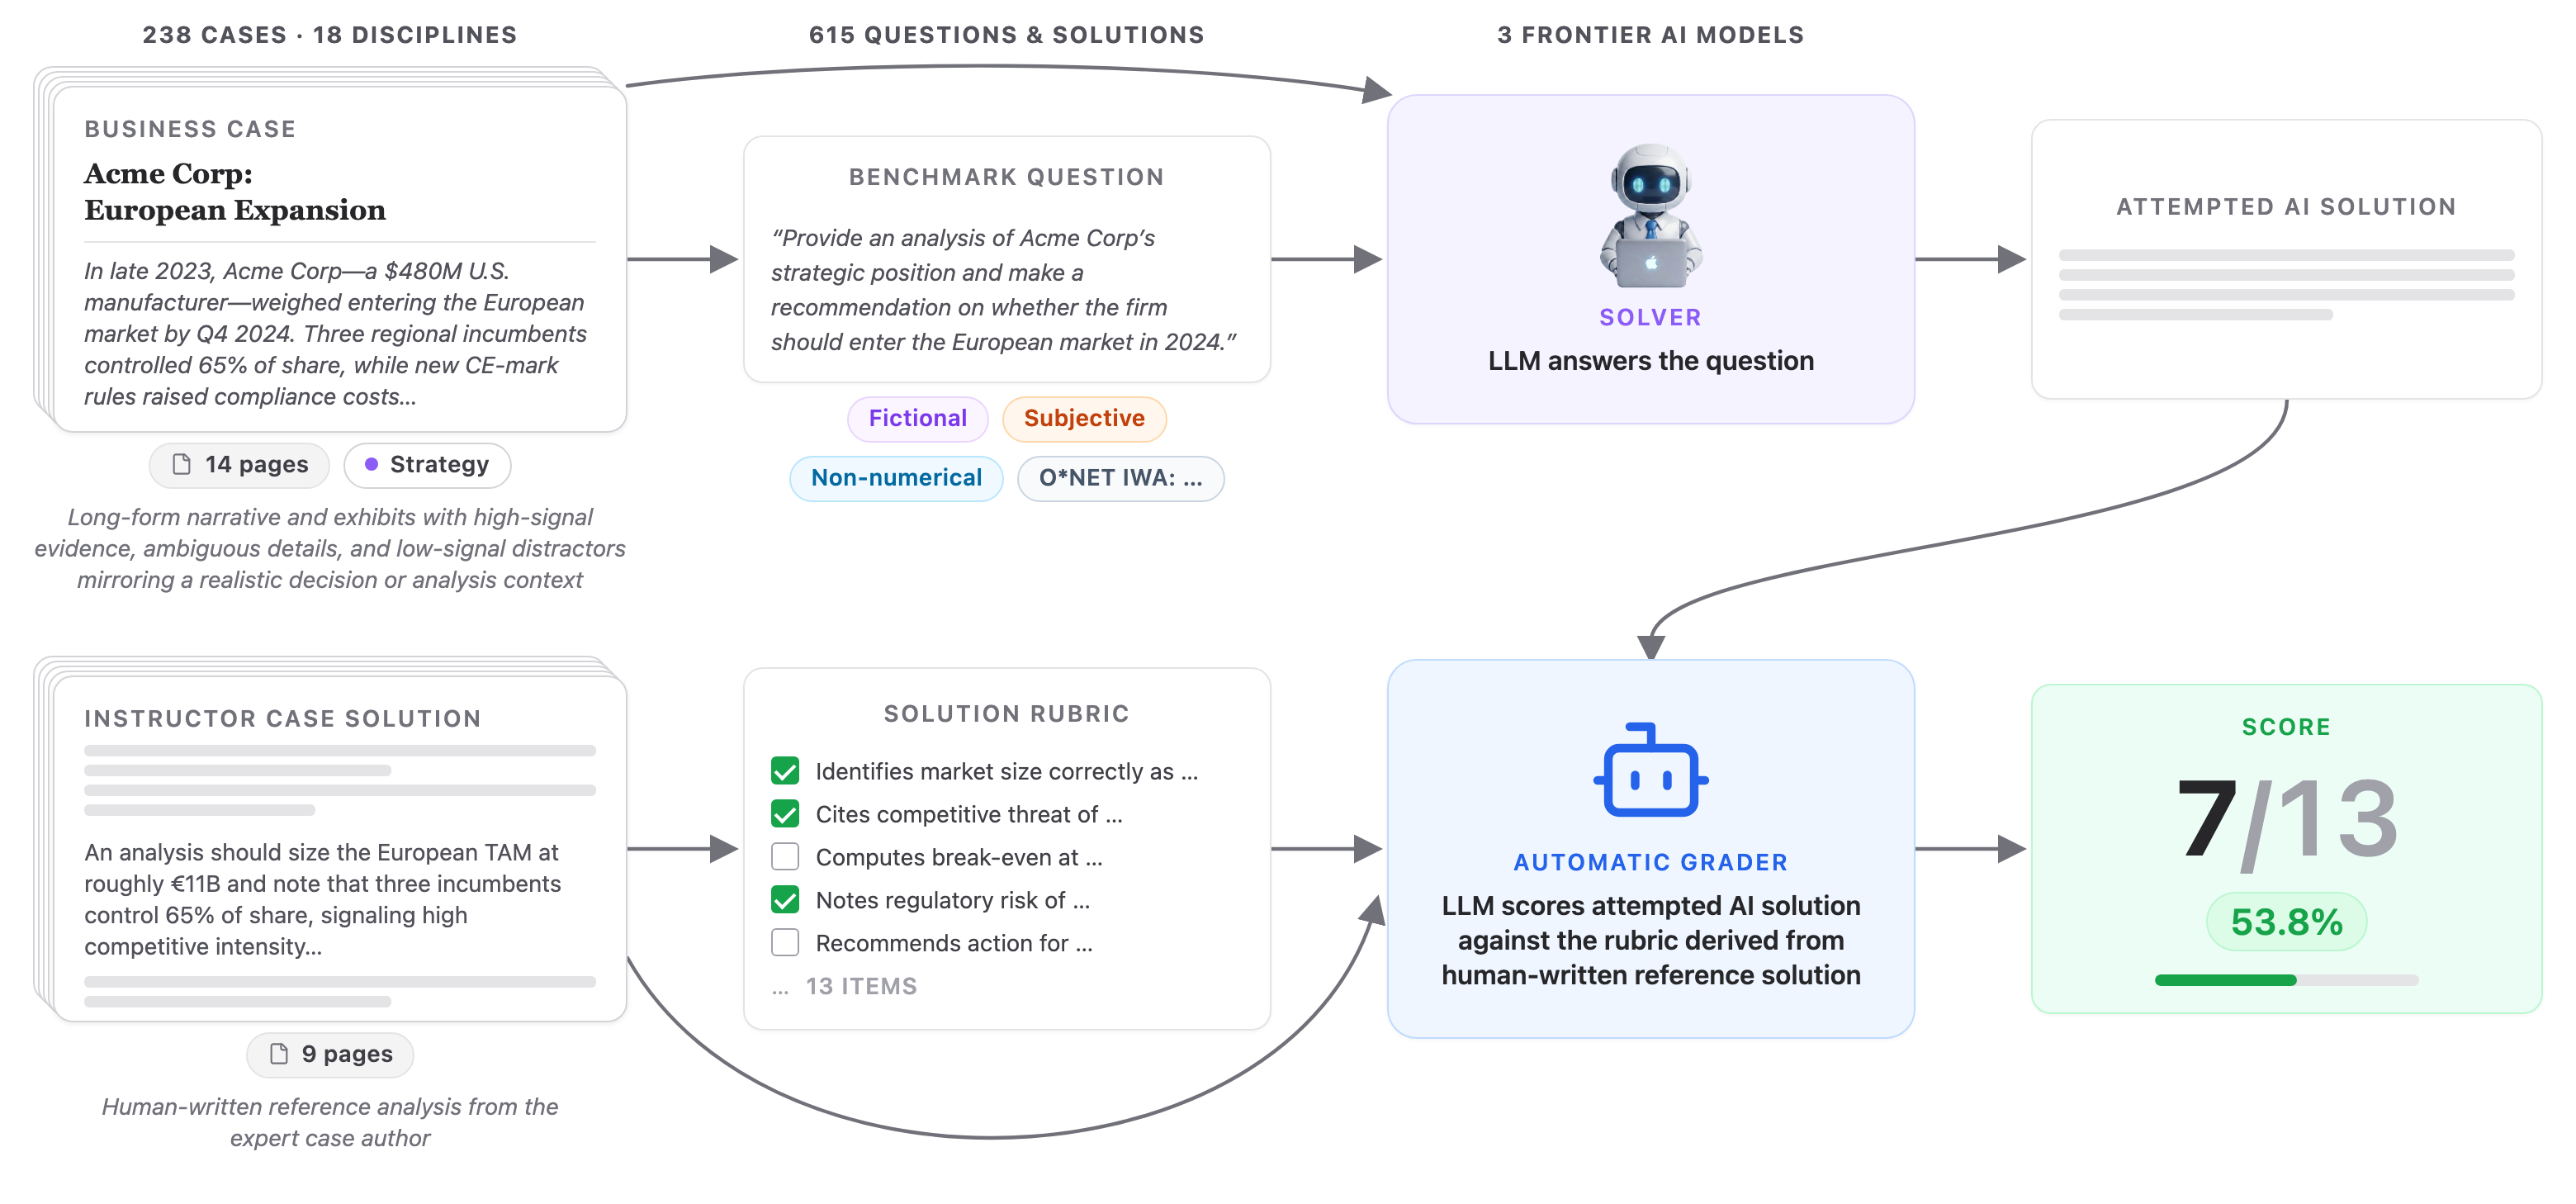
Мы расширяем оценку на основе кейсов до бизнес-дисциплин с помощью шаблона проектирования и автоматизированного конвейера для бенчмаркинга сложной аналитической интеллектуальной работы. Используя тематические исследования бизнес-школ в сочетании с эталонными решениями, полученными из решений преподавателей, мы создаем структурированные, равновесные контрольные рубрики. Ответы моделей затем оцениваются по критериям этих рубрик для выставления баллов, следуя конвейеру, проиллюстрированному на рис. 1. Эти оценки формируют BusinessCaseBench, охватывающую дисциплины карту возможностей передовых LLM по 615 вопросам, взятым из 238 кейсов, охватывающих восемнадцать бизнес-дисциплин. Каждый вопрос дополнительно соотносится с профессиональной таксономией O*NET (onet_online_2026), поэтому результаты могут быть интерпретированы по видам профессиональной деятельности и профессиям и использованы для характеристики того, где концентрируется предполагаемое влияние ИИ. Наконец, траектория развития четырех моделей внутри одного семейства документирует, как производительность эволюционировала в течение двух лет..
Ниже представлены выводы о том, как бизнес-образование и рынки труда должны адаптироваться по мере роста возможностей frontier AI в данном классе задач. Лучшие frontier модели достигают точности выше 87% по оценке на основе рубрик при частичном начислении баллов, что свидетельствует о высоком совокупном уровне выполнения этих задач, многие из которых требуют рассуждения и суждений в условиях неопределенной и неоднозначной информации. Улучшение характеристик между поколениями моделей носит широкомасштабный характер: прирост составляет примерно 23 процентных пункта внутри одного семейства моделей за два года и не ограничивается количественными подзадачами, где у более старых моделей ранее было больше всего возможностей для совершенствования (hendrycks_measuring_2021-1). Дисциплина связана с гораздо более значительными различиями в сложности моделей, чем тип вопроса, при этом разрывы между вопросами из вымышленных и реальных кейсов, числовыми и нечисловыми вопросами, а также субъективными и объективными вопросами являются незначительными по сравнению с вариативностью между дисциплинами. Наконец, реальные пределы возможностей встречаются редко. Менее 7% вопросов оказываются нерешаемыми для всех frontier моделей, что указывает на то, что необходимые знания распределены по всему frontier, а не отсутствуют в нем, и что полные и исчерпывающие ответы на высокоструктурированные аналитические задачи остаются главной проблемой и возможностью для сотрудничества человека и AI..
| Case Discipline | Representative Question Summary | Case Discipline | Representative Question Summary |
|---|---|---|---|
| Business & Government Relations | Write a Supreme Court judicial opinion that rules on a patent settlement between a branded pharmaceutical firm and a generic manufacturer, and establishes a legal framework lower courts can apply to similar agreements. | Leadership & Organizational Behavior | Advise a hospital’s chief medical officer on whether to promote a division chief whose clinical excellence conflicts with the institution’s collaborative culture. |
| Economics | As a municipal consultant, analyze participatory-budgeting voting data from a prior city program to evaluate whether approval voting produces fair, proportional outcomes and recommend a voting rule for a new initiative. | International Business | Advise an executive at a multinational’s overseas subsidiary navigating conflicting demands from headquarters and local workplace norms, proposing a strategy that delivers measurable results while respecting local cultural practices. |
| Business Ethics | Analyze a data scientist’s ethical stance when asked to add a feature that estimates pregnancy likelihood for female job applicants to AI hiring software. | Finance | Build a discounted cash flow valuation of a luxury automaker at its public offering and quantify how equity value changes under a sharp currency depreciation and alternative management responses. |
2 Обзор
BusinessCaseBench оценивает открытую аналитическую интеллектуальную работу с использованием 238 бизнес-кейсов, дополненных решениями преподавателей, что дает 615 вопросов по восемнадцати дисциплинам, от «Стратегии» и «Финансов» до «Лидерства и организационного поведения», с полным составом которых можно ознакомиться в Приложении SI, раздел A1 Final dataset schema. Бенчмарк охватывает как субъективные и открытые аналитические вопросы, так и объективные вопросы на численные рассуждения. Мы классифицируем каждый вопрос в зависимости от того, основан ли он на кейсе о вымышленной или реальной фирме, является ли вопрос численным или нечисленным, а также субъективным или объективным. Бенчмарк включает 245 вопросов по вымышленным фирмам и 370 по реальным, 184 численных и 431 нечисленный вопрос, а также 339 субъективных и 276 объективных вопросов. Каждый вопрос соотнесен с таксономией профессий O*NET, разработанной Министерством труда США (onet_online_2026), на уровнях рабочей деятельности (WA), промежуточной рабочей деятельности (IWA) и детальной рабочей деятельности (DWA). В совокупности эти метки охватывают 24 WA, 55 IWA и 108 DWA, поэтому результаты можно интерпретировать как в контексте профессиональной классификации работ, так и в контексте академических дисциплин; табличные сводки этих соответствий см. в Приложении SI, раздел A1 Final dataset schema..
Для каждого вопроса решения кейсов от преподавателя предоставляют эталонное решение, которое мы извлекаем и используем для создания рубрики в стиле контрольного списка, как показано на рис. 1. Модель получает полное описание кейса и текст вопроса в экзаменационном стиле, после чего формирует развернутый вариант решения. Затем этот вариант оценивается с помощью протокола LLM-as-judge (zheng_judging_2023) на соответствие критериям рубрики с использованием эталонного решения. Мы приводим два взаимодополняющих показателя оценки. Стандартная оценка начисляет частичные баллы как взвешенную долю выполненных критериев рубрики. Она отражает, какую часть того, что ожидалось в решении кейса от преподавателя, модель фактически предоставила, даже если присутствуют не все элементы. Оценка Complete Answer, показанная на рис. 2, является более строгой и работает по принципу «все или ничего». Она фиксирует, удовлетворяет ли модель каждому критерию рубрики вопроса. Стандартная оценка суммирует, насколько ответ охватывает рубрику преподавателя, и, особенно в случае с открытыми и субъективными вопросами, часто обеспечивает более точный показатель качества ответа, когда полное выполнение контрольного списка не требуется или не всегда достижимо. Оценка Complete Answer дополняет её, фиксируя, как часто ответы тем не менее удовлетворяют всем критериям — это консервативная проверка полноты, когда баллы за частичное выполнение уже высоки. Точные формальные определения и протокол оценки приведены в разделе Методы и в Приложении SI, раздел 6. Для подмножества вопросов три обученных аннотатора независимо составили рубрику и оценили каждый назначенный ответ до того, как увидели какую-либо автоматизированную рубрику или оценку. Этот слепой протокол проверяет, точно ли оценка, автоматизированные рубрики и автоматизированное выставление баллов измеряют успех или неудачу предложенного решения способом, который коррелирует с человеческим суждением; подробности см. в разделе Методы и в Приложении SI, раздел B3 LLM-as-judge grading prompt..
Основные сравнения используют три передовые модели ИИ: OpenAI GPT-5.4 (singh_openai_2026), Anthropic Claude Sonnet 4.6 (anthropic_system_2025) и Google Gemini 3 Flash Preview (deepmind_gemini_2025), оцененные по всем 615 вопросам с закрепленными идентификаторами моделей и настройками выборки, задокументированными в Приложении SI, Раздел 6. Внутрисемейный поколенческий анализ оценивает четыре последовательные модели OpenAI, охватывающие примерно два года (от GPT-4 Turbo до GPT-5.4), на одном и том же фиксированном бенчмарке (openai_gpt-4_2024). Это сравнение отслеживает, как производительность LLM в данном классе задач эволюционировала за примерно два года разработки моделей..
3 Производительность LLM в полном спектре бизнес-задач
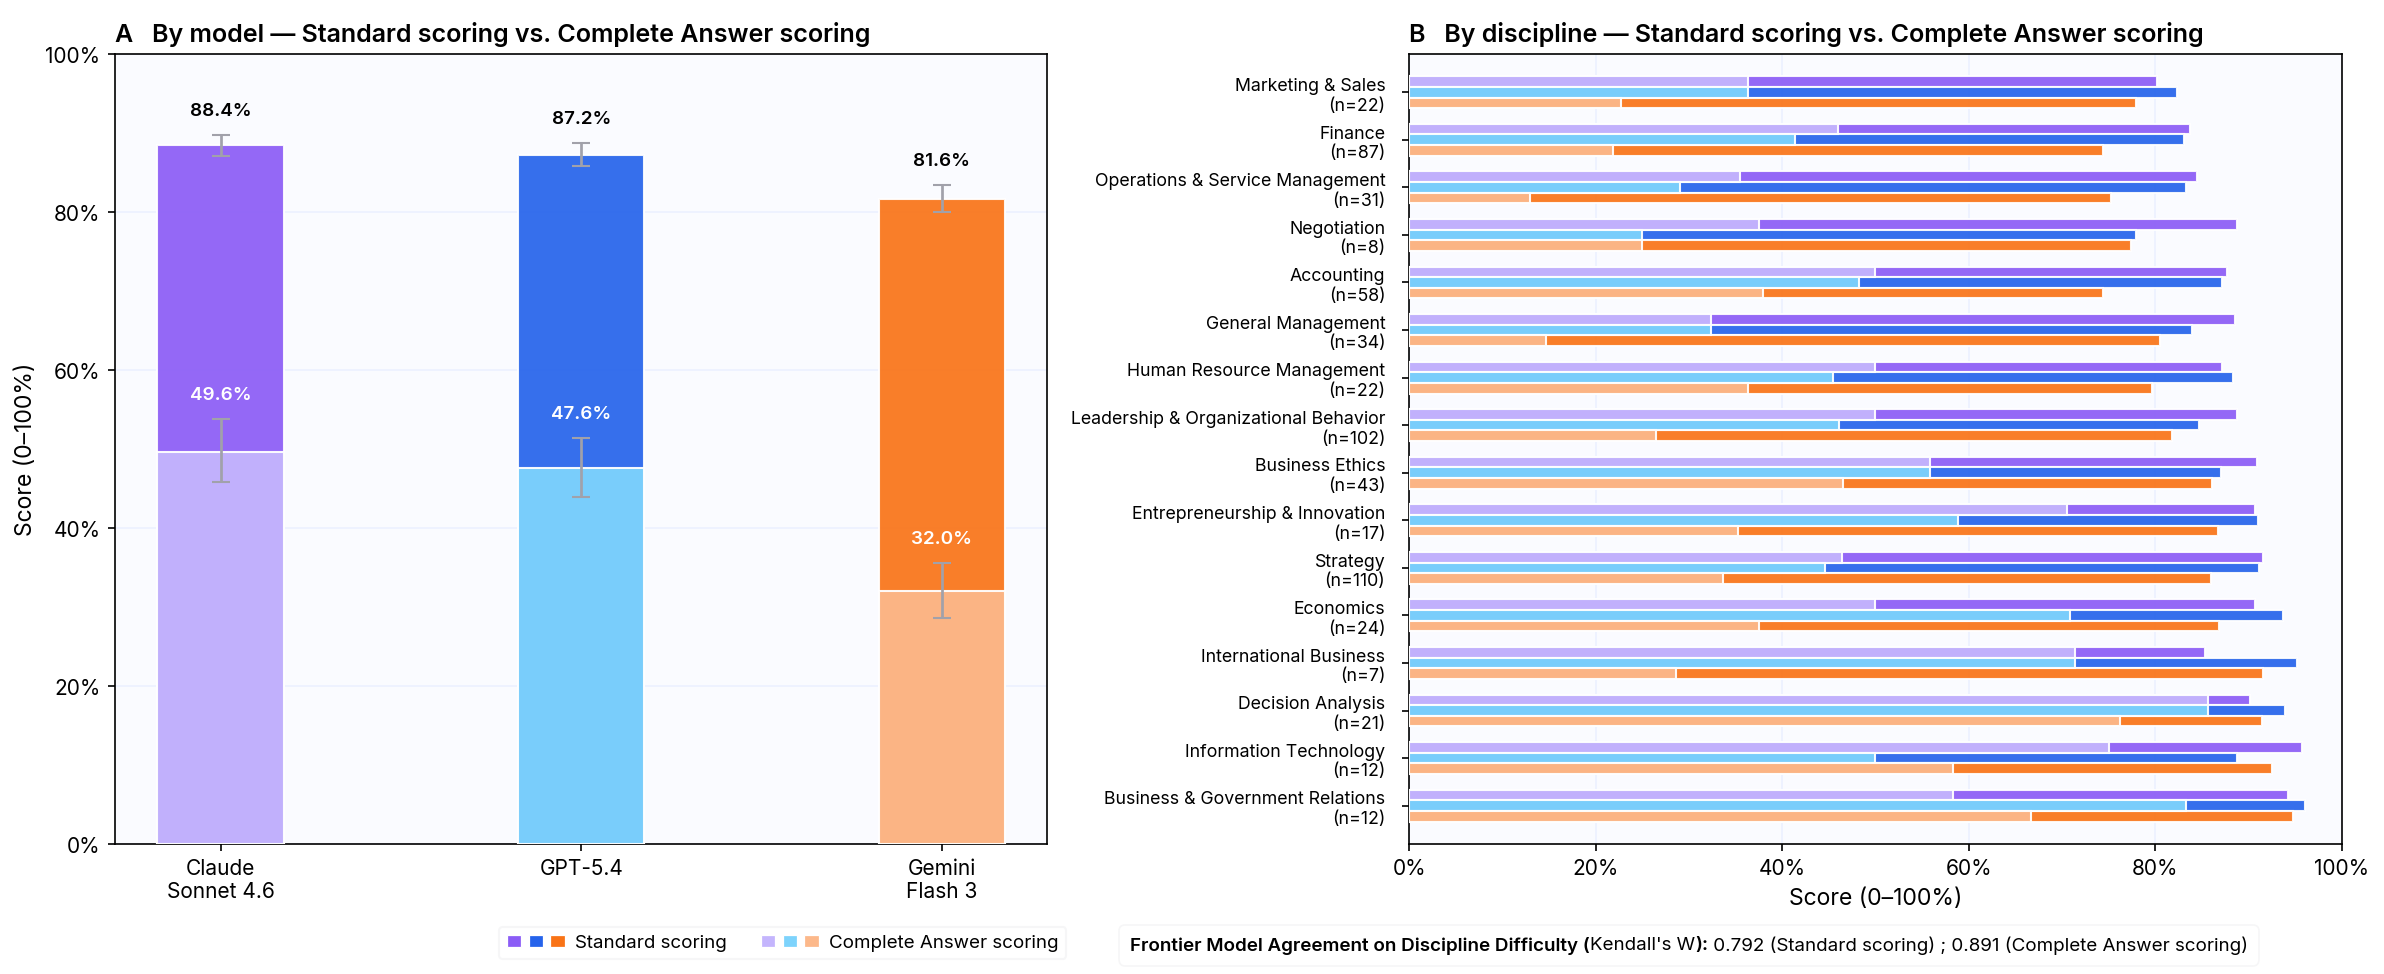
По всему бенчмарку из 615 вопросов прослеживается закономерность: широкая компетентность при частичном начислении баллов, значительно более низкий уровень полного соответствия критериям при том же масштабе, а также порядок дисциплин, общий для всех трех моделей. Рис. 2 обобщает эту структуру для GPT-5.4, Claude Sonnet 4.6 и Gemini 3 Flash Preview при оценке по стандартам Standard и Complete Answer..
3.1 Совокупная производительность
При стандартной оценке все три передовые модели демонстрируют одинаково высокий уровень выполнения всего бенчмарка. Рис. 2A показывает Claude Sonnet 4.6 на уровне 88,4% (95% ДИ [87,1, 89,7]), GPT-5.4 на уровне 87,2% (95% ДИ [85,8, 88,7]) и Gemini 3 Flash Preview на уровне 81,6% (95% ДИ [80,0, 83,4]). Разброс между лучшим и худшим результатом составляет всего 6,8 процентных пункта, а доверительные интервалы для двух лидирующих моделей полностью перекрываются. Эти показатели свидетельствуют о том, что при независимом начислении баллов по критериям рубрикатора передовые модели уже охватывают большую часть того, что ожидается в решениях преподавателей для открытых бизнес-кейсов, охватывающих весь дисциплинарный канон..
3.2 Результаты работы AI как черновики, а не окончательные решения
Высокие баллы за частичное выполнение скрывают более строгую картину. Оценка «Полный ответ» требует выполнения каждого критерия рубрикатора по вопросу, и полное соответствие встречается гораздо реже. На рис. 2A более светлые наложенные столбцы показывают, что Claude Sonnet 4.6 достигает этого в 49,6% вопросов (95% ДИ [45,9, 53,8]), GPT-5.4 — в 47,6% (95% ДИ [43,9, 51,4]), а Gemini 3 Flash Preview — в 32,0% (95% ДИ [28,6, 35,6]). Даже ведущая модель оставляет более половины вопросов без полностью завершенного ответа по стандартам преподавателя. Разброс от верхнего до нижнего значения увеличивается до 17,6 процентных пункта, что примерно в 2,6 раза превышает разброс при стандартной оценке, поскольку ответ может получить высокий балл за частичное выполнение, при этом пропуская один или несколько обязательных элементов. Оценка «Полный ответ» в этом смысле намеренно является консервативной нижней границей оценки производительности. Любой пропущенный критерий приводит к невыполнению вопроса, даже если выполненная часть рубрикатора уже могла бы обеспечить высокую оценку за частичное выполнение, которую многие преподаватели могли бы счесть аналитически достаточной в субъективных вопросах открытого типа, где полное соответствие рубрикатору может быть неоправданно строгим ожиданием. Таким образом, высокие стандартные баллы описывают аналитически сильные черновики, которые охватывают большую часть ожидаемого анализа, а не результаты, соответствующие полному объему рубрикатора преподавателя без доработки..
3.3 Вариативность на уровне дисциплин
Производительность на уровне дисциплин является структурированной, а не хаотичной. На рис. 2B шестнадцать дисциплин, содержащих не менее пяти вопросов, упорядочены по возрастанию среднего стандартного балла. В приложении SI, таблица S11, представлены соответствующие средние значения по моделям: стандартные баллы варьируются от 80,1% в маркетинге и продажах до 95,0% в сфере бизнеса и государственных отношений — разброс, превышающий разрыв между самими тремя моделями. При оценке по методу Complete Answer те же дисциплины разделяются более отчетливо: от 25,8% в управлении операциями и услугами до 82,5% в анализе решений. Все три передовые модели ранжируют дисциплины почти в одинаковом порядке, демонстрируя высокую конкордацию рангов ( Кендалла = 0,79 при стандартной оценке и 0,89 при оценке Complete Answer (kendall_problem_1939)), что указывает на то, что сложность отражает структуру задач, специфичную для дисциплины, в большей степени, чем особенности обучения любого отдельного провайдера..
4 Характеристика возможностей и сильных сторон моделей
Совокупные оценки скрывают то, как формулировка кейса, метаданные вопроса и межмодельные закономерности определяют остающийся разрыв. Поэтому мы характеризуем, что предсказывает остаточную сложность и как вопросы бенчмарка соотносятся с профессиональной деятельностью..
4.1 Вымышленные кейсы немного проще реальных
Вопросы из реальных кейсов оцениваются немного выше, чем вопросы из вымышленных кейсов по полному бенчмарку (86,5% против 84,6% при стандартной оценке, разрыв в 1,9 процентного пункта) — закономерность, объяснимая главным образом выбросом в дисциплине «Финансы», а не единообразным эффектом вымышленных и реальных данных. В шести из девяти дисциплин, где представлено достаточное количество вопросов обоих типов, вопросы из вымышленных кейсов оцениваются на уровне или выше вопросов из реальных кейсов, что согласуется с тем, что реальные нарративы привносят более длинные контексты, большую двусмысленность и посторонние детали, которые усложняют синтез и делают вопрос по кейсу более трудным. В финансах и бухгалтерском учете наблюдается обратная картина: вымышленные вопросы по финансам оцениваются на 15,0 процентных пунктов ниже, чем реальные финансовые вопросы (70,9% против 85,9%), а в бухгалтерском учете наблюдается меньший разрыв в 2,7 пункта в том же направлении, при этом финансы выделяются как единственный крупный отрицательный выброс в SI Appendix, Fig. SD5 Fictional-vs-real performance delta by discipline. Мы предполагаем, что вопросы из реальных кейсов в этих дисциплинах часто опираются на названия компаний, чьи финансовые профили могут фигурировать в публичной отчетности или финансовой прессе, что дает моделям преимущество за счет предварительного обучения, которого не обеспечивают вопросы из вымышленных кейсов, лишенные такой осведомленности. Таким образом, выброс в финансах, вероятно, отражает то, как предварительное обучение взаимодействует с формулировкой кейса, а не общее преимущество вымышленных материалов..
4.2 Сложность в значительной степени зависит от конкретного случая и вопроса
Характеристика того, что делает вопрос сложным, в значительной степени не поддается описанию с помощью грубых категориальных метаданных, таких как тип вопроса или дисциплина, и большая часть вариативности сложности лежит за пределами этих меток, в требованиях, специфичных для конкретного кейса или вопроса. SI Appendix, Fig. SD4 Scoring by question-type strata помещает среднюю производительность по шести стратам типов вопросов в узкий диапазон 82,3–87,2% при Standard оценке. Числовые вопросы имеют самый низкий балл (82,3%), а нечисловые — самый высокий (87,2%), субъективные и объективные вопросы различаются всего на 0,8 процентных пункта, а вопросы по вымышленным и реальным кейсам различаются на 1,9 пункта при объединении всех вопросов, хотя мы отмечали ранее, что для некоторых дисциплин этот разрыв больше. Оценка Complete Answer умеренно увеличивает эти разрывы по типам вопросов, но оставляет их небольшими по сравнению с разбросом по дисциплинам, который показывает Fig. 2. Регрессия среднего значения Standard оценки frontier на страты типов вопросов и категории дисциплин, с использованием кодирования эффектов, при котором дисциплины с менее чем пятью вопросами объединены в единую категорию Other, а стандартные ошибки кластеризованы по кейсам, подтверждает, что эти грубые метки объясняют лишь малую часть вариативности оценок. Теги типов вопросов сами по себе объясняют 2,6% вариативности оценок на уровне вопросов (adjusted ), дисциплина сама по себе — 3,6%, а обе вместе — 5,1%, и при кросс-валидации оба блока предсказывают отложенные кейсы сопоставимо. Каждый блок по-прежнему несет обнаруживаемую связь со сложностью. Добавление дисциплины после типа вопроса является совместно значимым (), как и добавление типа вопроса после дисциплины (). Как только дисциплина и другие страты учтены, оценки по вымышленным и реальным кейсам больше не различаются значимым образом, а числовые вопросы остаются умеренно более сложными (5,9 пункта). Таким образом, большая часть различий между более сложными и более легкими вопросами заключается в требованиях, специфичных для кейса и вопроса, которые не улавливаются грубыми метаданными типа вопроса и дисциплины, такими как более длинные неоднозначные нарративы, многокомпонентная структура рубрик и более открытые консультативные или оценочные рассуждения. Декомпозиция дисперсии по исходным кейсам подтверждает эту интерпретацию. Вопросы из одного и того же кейса имеют умеренно коррелирующую сложность (внутриклассовая корреляция ), знание того, из какого кейса взят вопрос, предсказывает его оценку гораздо лучше, чем грубые метки метаданных (adjusted против ), и почти половина вариативности оценок приходится на вопросы внутри одного и того же кейса. Полная статистика вложенных моделей, adjusted , сравнения с кросс-валидацией и декомпозиция на уровне кейсов представлены в SI Appendix, Section D5 Fictional-vs-real performance delta by discipline.
4.3 Сложность редко бывает абсолютной
Лишь немногие вопросы из бенчмарков оказываются не под силу каждой из оцениваемых моделей. В Приложении SI, Таблица S15 сообщается, что только 43 из 615 вопросов (7,0%) имеют максимальный стандартный балл на уровне или ниже 70% для GPT-5.4, Claude Sonnet 4.6 и Gemini 3 Flash Preview, и что только 521 из 8369 случаев применения критериев рубрикатора (6,2%) не получают зачет ни от одной из трех моделей. Межмодельный оракул, который для каждого вопроса выбирает лучший балл среди трех передовых моделей, достигает 92,8%, что на 4,5 процентных пункта выше показателя ведущей отдельной модели. Таким образом, то, что упускает одна модель в конкретном вопросе, часто фиксируется другой, поэтому остаточная ошибка чаще отражает неполное соответствие многокомпонентным рубрикаторам, чем абсолютные пределы возможностей; в Приложении SI, Раздел D6 Score variation by question type, discipline, and case задокументирована лежащая в основе модель взаимодополняемости..
4.4 От кейсов к профессиональной карте
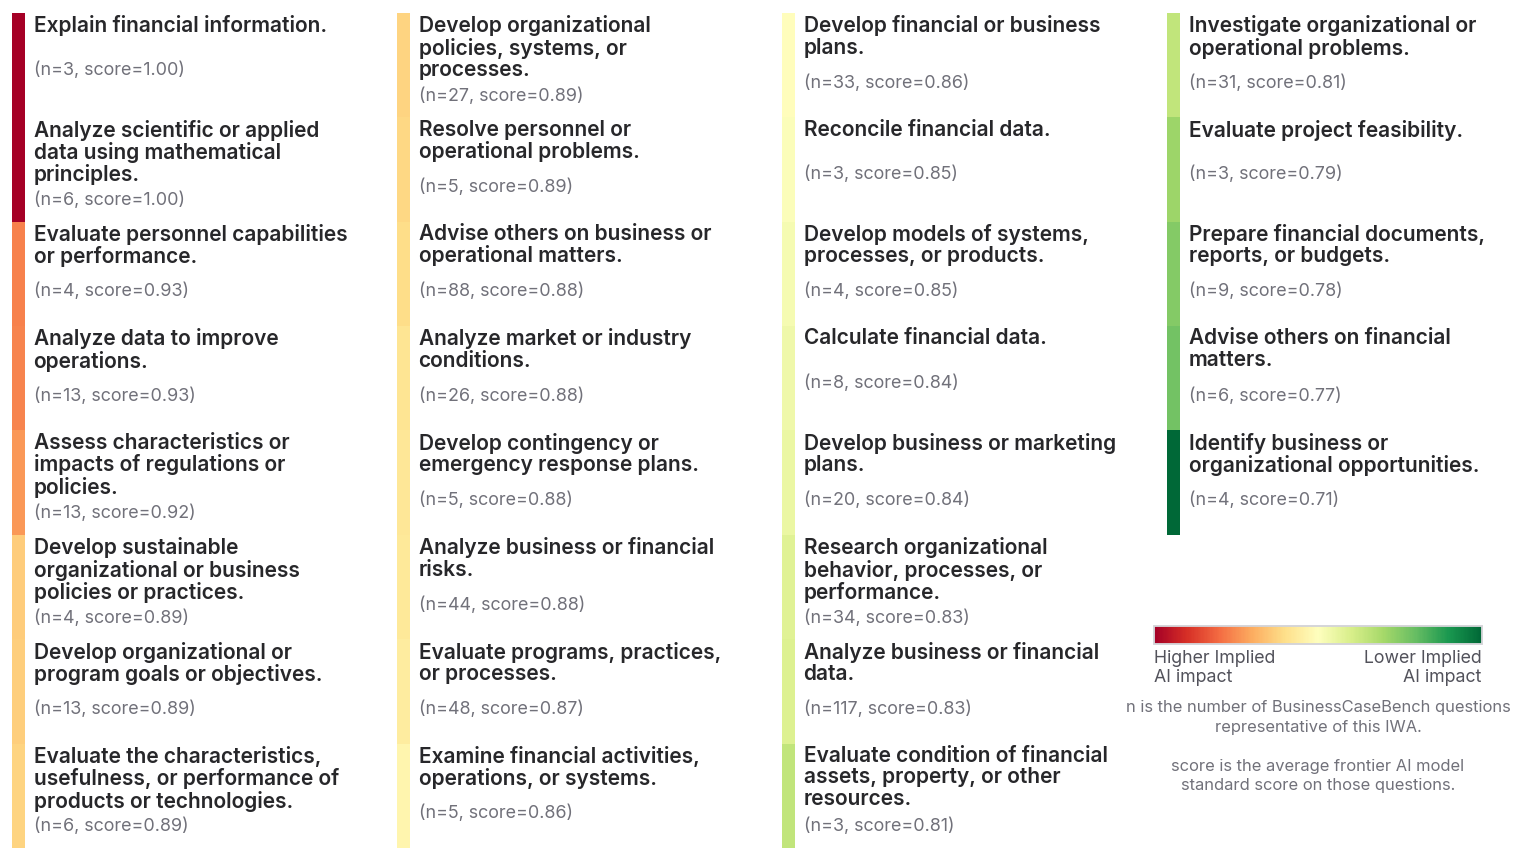
Рис. 3 сопоставляет вопросы бенчмарка с промежуточными рабочими задачами O*NET, связывая академические дисциплины с профессиональной деятельностью и профессиями для оценки предполагаемого влияния ИИ, которое прогнозирует BusinessCaseBench. Среди 29 промежуточных рабочих задач (IWA), содержащих не менее трех вопросов бенчмарка, средние стандартизированные баллы варьируются от 70,9% по направлению «Выявление бизнес-возможностей или организационных возможностей» до предельных показателей в задачах с ограниченным объяснительным и математическим анализом. Наиболее сложные задачи сочетают в себе формулирование рекомендаций открытого типа с количественным или оценочным обоснованием на основе конкретных кейсов, тогда как задачи по интерпретации данных с четко определенными границами и оценке эффективности приближаются к насыщению. Поскольку таксономия рабочих задач O*NET включает перекрывающиеся и частично избыточные категории на разных уровнях детализации (onet_limitations), мы рассматриваем эти сопоставления как ориентировочные, а не окончательные. Предполагаемое влияние ИИ на профессии, представленное в приложении SI, рис. SImplied AI impact on O*NET occupations, следует рассматривать вместе с диапазонами охвата на этом рисунке, которые показывают, насколько полно в бенчмарке представлены соответствующие рабочие задачи для каждой профессии..
5 Поколенческое сравнение внутри одного семейства моделей
Как быстро улучшались возможности ИИ в этом классе задач? Сохраняя неизменным набор тестов, мы оцениваем четыре последовательных релиза OpenAI, охватывающих примерно два года, от GPT-4 Turbo через GPT-4.1, GPT-5 и GPT-5.4, чтобы проследить поколенческую траекторию производительности в открытой аналитической интеллектуальной работе. Мы выбираем семейство моделей OpenAI, поскольку можем надежно получить доступ ко всем четырем моделям для ретроспективной оценки..
Траектория производительности четырех поколений
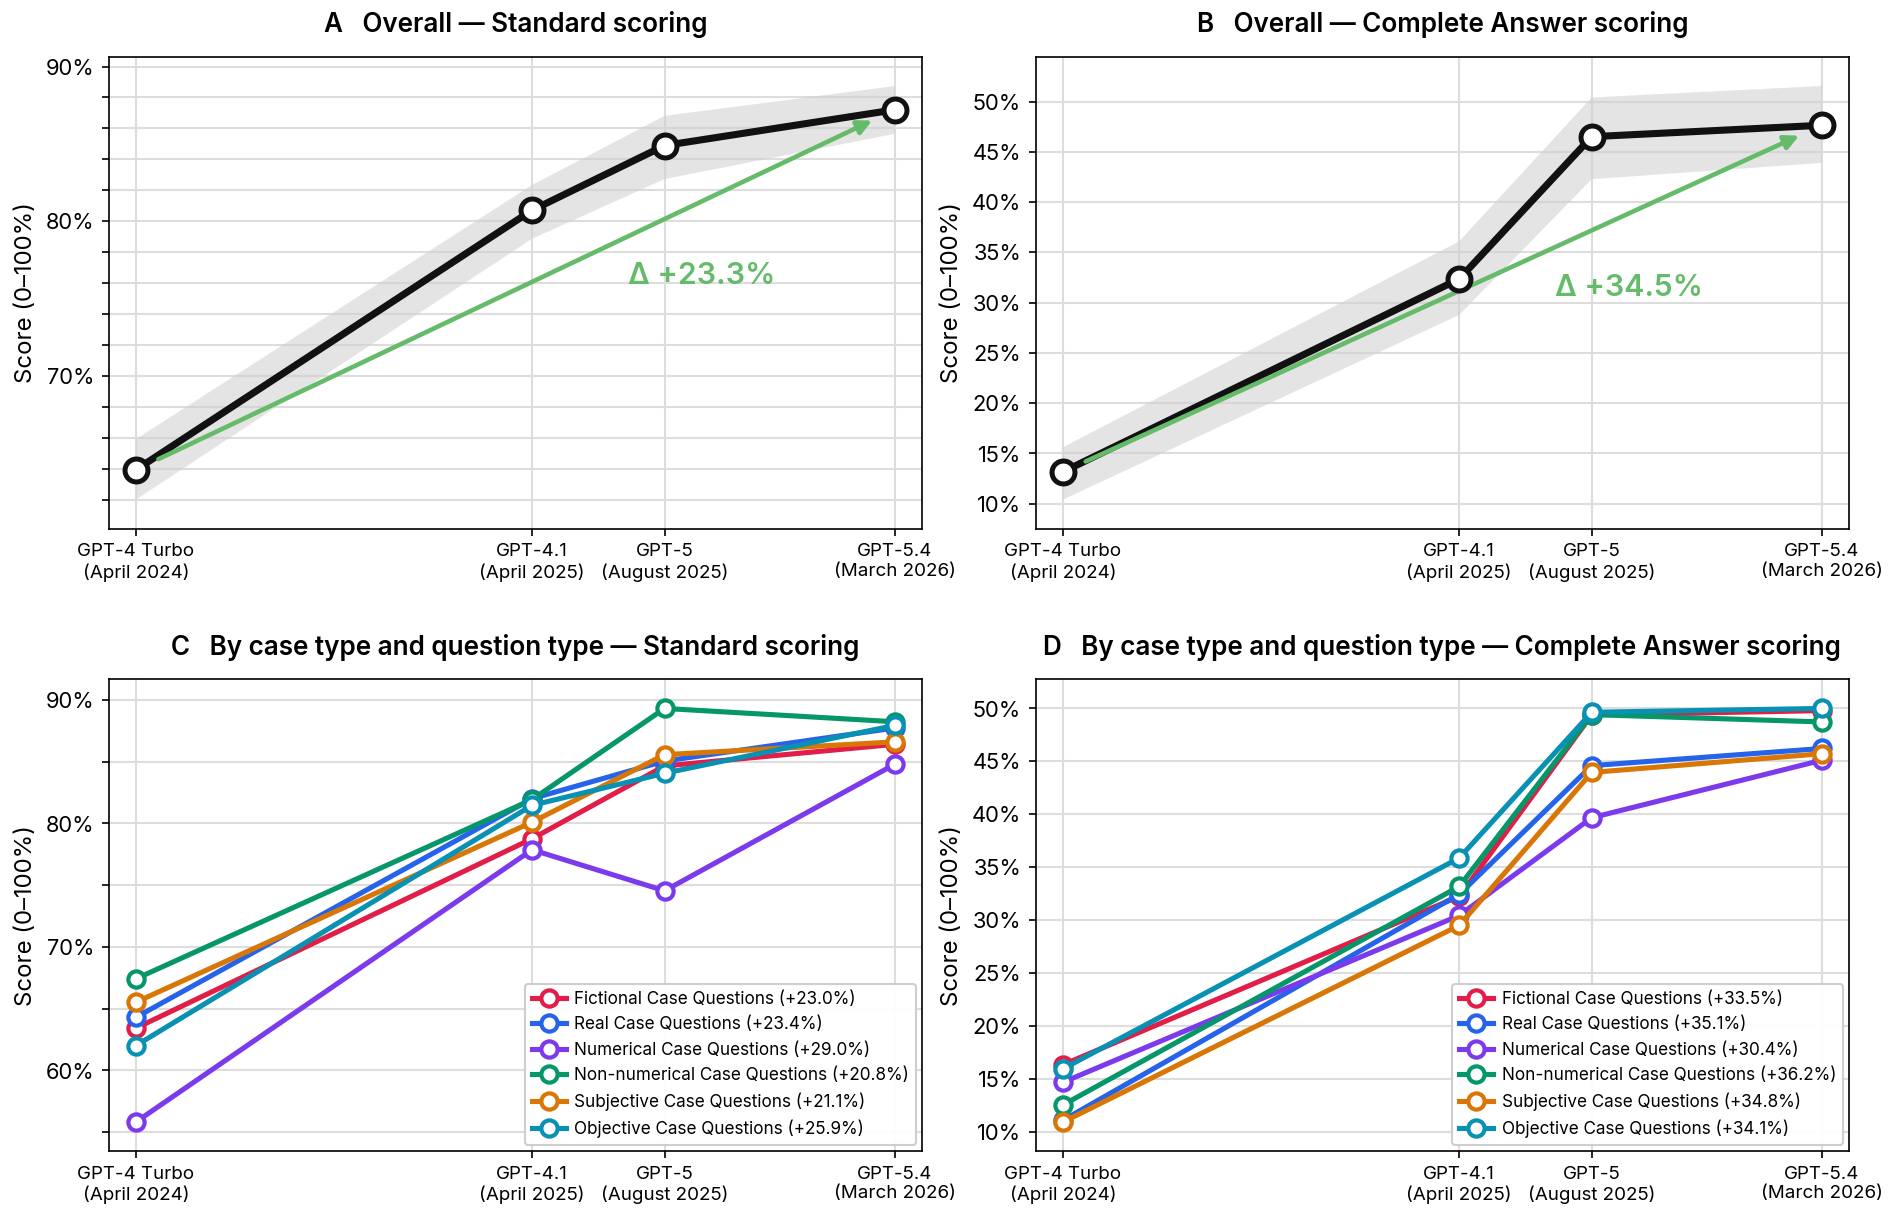
Рис. 4A и рис. 4B обобщают траекторию по всем 615 вопросам при стандартной оценке и оценке полных ответов. Средний стандартный балл повышается с 63,9% для GPT-4 Turbo (95% ДИ [62,0, 65,9]) до 87,2% для GPT-5.4 (95% ДИ [85,8, 88,7]), что составляет прирост в 23,3 процентных пункта для четырех моделей. Более строгая оценка полных ответов изменяется параллельно: с 13,2% (95% ДИ [10,7, 15,8]) до 47,6% (95% ДИ [43,9, 51,4]), что является приростом на 34,4 пункта, демонстрирующим улучшение в предоставлении полных и завершенных ответов, а не только частичных баллов. Промежуточные релизы последовательно повышают кривую: GPT-4.1 достигает 80,7% при стандартной оценке, а GPT-5 преодолевает отметку в 84,9%, прежде чем новейшая модель приближается к высоким уровням частичных баллов, представленным на рис. 2⟧.
Категоризация распределения улучшений
Прирост носит широкий характер, а не ограничивается лишь простыми сегментами бенчмарка. Рис. 4C и рис. 4D декомпозируют траекторию тех же четырех моделей по вымышленным и реальным кейсам, а также по числовым, нечисловым, субъективным и объективным вопросам. При стандартной оценке вымышленные и реальные кейсы улучшаются практически на одну и ту же величину (23,0 и 23,4 процентных пункта), числовые вопросы — на 29,0 пунктов, а нечисловые — на 20,8 пунктов. При оценке по полному ответу каждый страт прибавляет не менее 30 пунктов, причем нечисловые и субъективные вопросы улучшаются так же или даже сильнее, чем их числовые и объективные аналоги (например, +36,2 пункта по нечисловым вопросам против +30,4 по числовым). Эта закономерность противоречит гипотезе о том, что прогресс сосредоточен исключительно на количественных рассуждениях — типе способностей, с которыми ранние модели справлялись с трудом и которые измеряют популярные бенчмарки, — и этот акцент привел к улучшениям в числовой точности и математических рассуждениях (hendrycks_measuring_2021-1). Приложение SI, рис. SD3 OpenAI performance trajectory by discipline распространяет ту же закономерность на дисциплины в панелях A и B: все двенадцать дисциплин, содержащих не менее пятнадцати вопросов, демонстрируют двузначный прирост по стандартной оценке, включая значительные сдвиги в экономике (+31,7 пункта), бухгалтерском учете (+28,8 пункта) и финансах (+28,7 пункта), где GPT-4 Turbo начинала с уровней значительно ниже сегодняшних. Даже дисциплины, которые были относительно сильными еще в 2024 году, такие как деловая этика и стратегия, продолжают демонстрировать рост при оценке по полному ответу. Самый недавний шаг от GPT-5 к GPT-5.4 меньше (+2,3 пункта по стандартной оценке и +1,1 пункта по оценке по полному ответу), что указывает на замедление улучшений, что ожидаемо по мере приближения оценок к потолку. В целом, двухлетняя динамика подтверждает существенный рост способностей в аналитической работе, которую измеряет данный бенчмарк..
6 Расширенные результаты по последнему рубежу сверхкрупных моделей
После завершения основных экспериментов, описанных выше, компания Anthropic выпустила Claude Fable 5 — модель класса Mythos, значительно превосходящую по размеру ранее выпущенные публичные системы и позиционируемую с особым акцентом на возможности в области программной инженерии. Развертывание было временно приостановлено в связи с экспортным контролем правительства США, касающимся вопросов кибербезопасности (anthropic_redeploying_fable_2026). Поскольку этот релиз пришелся на конец периода оценки в рамках данного исследования, мы представляем Claude Fable 5 как дополнительный результат (Extended Result) в BusinessCaseBench, полученный постфактум. Цель этого дополнения — задокументировать, как современная сверхкрупная пограничная модель справляется с открытыми задачами интеллектуального труда, оцениваемыми в данной работе..
Совокупная производительность Claude Fable 5 практически неотличима от Claude Sonnet 4.6. При стандартной оценке (Standard scoring) Fable 5 достигает 88,0% (95% ДИ [86,4, 89,5]) по сравнению с 88,4% у Sonnet 4.6 (Приложение SI, Таблица S9). При оценке полных ответов (Complete Answer scoring) Fable 5 достигает 50,9% (95% ДИ [47,3, 54,8]), что на 1,3 процентного пункта выше по сравнению с 49,6% у Sonnet 4.6 (Приложение SI, Таблица S10). Доверительные интервалы для обеих моделей перекрываются по обоим показателям. Такое сходство согласуется со значительным перекрытием данных обучения между последовательными моделями внутри одного семейства провайдера. В Приложении SI, Таблица S11 представлен детальный разбор по дисциплинам для Fable 5; по всем дисциплинам Fable 5 остается близкой к Sonnet 4.6 и не меняет ранжирование более сложных и более простых областей, выявленных ранее..
На BusinessCaseBench схожий профиль производительности Claude Fable 5 и Claude Sonnet 4.6 может отражать больший акцент этого класса релизов на агентных возможностях разработки программного обеспечения, таких как кибербезопасность. Таким образом, Extended Result оставляет качественные выводы исследования неизменными. Frontier модели уже достигают высоких Standard баллов, удовлетворенность Complete Answer остается существенно более сложной задачей, а новейший сверхкрупный релиз Anthropic не меняет картину возможностей, которую этот бенчмарк устанавливает для бизнес-аналитики. Однако можно сделать один предварительный вывод: оптимизация под рабочие процессы разработки программного обеспечения не обязательно улучшает способности этих моделей в данном классе интеллектуальной работы..
7 Обсуждение
Передовые модели AI уже демонстрируют высокие результаты при решении открытых бизнес-кейсов, оцениваемых по экспертным решениям преподавателей, однако эта экономически значимая работа по-прежнему слабо представлена в бенчмарках, отслеживающих прогресс LLM. В данном бенчмарке совокупная производительность при стандартной оценке высока, а прирост возможностей внутри одного семейства моделей за два года значителен, что демонстрирует траектория поколений на рис. 4. Остаточная сложность характеризуется скорее пробелами в определенных бизнес-дисциплинах и профессиональной деятельности, чем простой категоризацией (числовые против нечисловых или субъективные против объективных вопросов). Лишь немногие вопросы систематически ставят в тупик все оцениваемые передовые модели AI, а кросс-модельный оракул показывает результаты значительно выше, чем лучшая отдельная модель. Эти закономерности позволяют предположить, что оставшийся разрыв чаще отражает неполное соответствие многокомпонентным критериям оценки, чем реальную нехватку предметных знаний — различие, которое рис. 2 делает особенно заметным при использовании оценки «Полный ответ», поскольку даже ведущие системы удовлетворяют всем критериям рубрикатора менее чем в половине вопросов. Пробелы в предлагаемых решениях часто являются специфичными для конкретной модели, а не абсолютными, и многое из того, что упускает одна модель, может быть учтено другой моделью при ответе на тот же вопрос. Эмпирический вопрос сместился от того, могут ли передовые модели выполнять аналитическую интеллектуальную работу, требуемую бизнес-кейсами, к тому, насколько полно они это делают, в чем они остаются наиболее слабыми и как бизнес-школы и фирмы должны реагировать по мере роста этих возможностей..
Наша оценка опирается на те же тщательно отобранные материалы, которые профессиональные школы используют для развития суждений, логического мышления и аналитических навыков. Использование написанных экспертами кейсов в качестве инструментов оценки становится все более привлекательным в специализированных областях, поскольку они ближе к реальным задачам, чем удобные суррогаты вроде стандартизированных экзаменов. Это обусловлено тем, что они содержат реалистичный контекст, имитируют информационные пробелы и неопределенность, требуют принятия решений в условиях неясности, а их развернутые повествования и аналитические решения гораздо ближе к реальному применению LLM, чем короткие вопросы с множественным выбором или краткими ответами, встречающиеся в стандартизированных экзаменах. nori_sequential_2025 продемонстрировали сложный бенчмарк для медицинской диагностики и логического мышления, используя комплексные медицинские кейсы NEJM как более реалистичную альтернативу оценке медицинского мышления с помощью стандартизированных экзаменов, таких как USMLE. Наше исследование и бенчмарк распространяют этот паттерн проектирования на кейсы бизнес-школ для проверки навыков аналитического мышления, необходимых в реальной интеллектуальной работе. В обеих работах ограничения лицензий на кейсы создают издержки для открытости, но они также повышают валидность, поскольку дословное заучивание при предварительном обучении менее вероятно, а высокие баллы труднее списать на простое запоминание (Xu2024BenchmarkDC). В этом режиме оценки модели получают баллы за соответствие сформулированным ожиданиям, а не за совпадение с единственной короткой эталонной строкой, что лучше отражает качество ответа, ценой чего является необходимость в четко определенных и стабильно оцениваемых рубриках..
Формат кейсов также снижает барьеры для создания бенчмарков в специализированных областях. Эксперты в предметной области без технической подготовки могут описывать аутентичные ситуации в повествовательной форме — текущий контекст, что было известно, а что нет, взвешенные варианты, компромиссы и обоснование принятого решения, зафиксированное в эталонном решении. Как только кейсы и решения написаны в такой структуре, автоматизированное извлечение, синтез критериев оценки и проверка по чек-листам позволяют масштабировать измерение возможностей моделей с течением времени, что демонстрируют nori_sequential_2025 и BusinessCaseBench. Более сложные бенчмарки, в свою очередь, способствуют дальнейшему развитию моделей. Этот подход по-прежнему требует подтверждения того, что автоматизированные критерии и оценка соответствуют человеческим суждениям о качестве и навыках — шаг, который мы предпринимаем в нашем исследовании посредством аннотирования людьми..
Несколько ограничений сдерживают эти результаты и указывают на необходимость дальнейшей работы по оценке в данной области. Хотя мы не находим никаких доказательств дословного загрязнения материалов кейсов в распространенных крупных корпусах для предварительного обучения, передовые модели обучаются на проприетарных наборах данных, которые могут содержать или не содержать некоторые материалы кейсов, что было бы трудно проверить без открытого доступа. Как мы обсуждали ранее, некоторые кейсы, основанные на реальных фирмах, могут препятствовать объективной оценке, поскольку аналогичные данные могут быть опубликованы в рамках нормативной отчетности на публичном рынке или в финансовой прессе, хотя мы обнаружили, что этот эффект в значительной степени систематически затрагивает только одну дисциплину (Финансы). Как общеизвестно, оценка LLM-as-judge сохраняет остаточные риски, хрупкость при работе с длинными ответами и числовые ошибки даже после проверки человеком (zheng_judging_2023). При нашем оценивании высокий частичный балл по системе Standard scoring может сосуществовать с невыполнением критерия полноты по системе Complete Answer scoring в тех случаях, когда требования для получения полного балла являются необоснованно строгими, а ответ с высоким частичным баллом может служить достаточным базовым уровнем экспертной работы человека. Оценка по рубрикатору в целом проверяет только то, точно ли соблюден каждый заявленный критерий, но не проводит аудит ответа на наличие постороннего, необоснованного или фактически неверного контента вне контрольного списка. Бенчмарк представлен на английском языке, и другие языки, институциональные условия и педагогические нормы могут дать иные профили навыков и возможностей. Сопоставление профессий на рис. 3 является информативным, но неполным как из-за того, что рабочие задачи O*NET широки и могут быть лишь слабо связаны с некоторыми навыками, проверяемыми в кейсе, так и из-за того, что многие рабочие задачи редко встречаются в корпусе кейсов. Поэтому результаты следует рассматривать вместе с диапазонами охвата профессий, показанными в SI Appendix, рис. SImplied AI impact on O*NET occupations. Оценка также является одноходовой. Итеративное уточнение, сбор информации, активные переговоры и формальная подотчетность в фирмах выходят за рамки того, что мы измеряем, и такие области могут стать возможностями для взаимодействия человека и AI (ai_biz_impact_1)⟧.
Прогресс в области ИИ для интеллектуальной работы потребует портфеля бенчмарков, которые отделяют дискретные навыки от интегративного суждения и связывают модели с экономически значимыми задачами (patwardhan_gdpval_2025; wang_how_2026). Мы представляем BusinessCaseBench, междисциплинарный кейс-бенчмарк с оценкой по рубрикатору, который занимает нишу между узкими количественными/аналитическими наборами (chen_finqa_2022; koncel-kedziorski_bizbench_2024; xie_finben_2024) и агентскими бенчмарками, сфокусированными на использовании корпоративного программного обеспечения (drouin_workarena_2024; xu_theagentcompany_2025). Эффективность в сравнении со стандартами решений кейсов от преподавателей уже высока и растет как минимум в одном семействе моделей. Как обобщено на рис. 3, модели сравнительно сильны в структурированных аналитических задачах и более уязвимы в открытых консультационных и аналитических задачах. Они также часто не достигают полного соответствия рубрикатору при оценке по критерию «Полный ответ», даже когда частичные баллы по критерию «Стандартная оценка» существенны — разрыв, очевидный на рис. 2⟧.
Эти выводы из BusinessCaseBench имеют непосредственное значение для бизнес-образования и труда «белых воротничков». Кейс-метод развивает суждение, синтез и аргументированное обоснование, на формирование которых были нацелены программы MBA и бакалавриата — навыки, которые исторически лежали в основе аналитической работы на начальных этапах карьеры. Поскольку передовые модели уже получают высокие баллы по Standard оценке и быстро совершенствуются как минимум в рамках одного семейства моделей, создание качественного черновика ответа становится все менее затратным. Таким образом, проблема проектирования учебных программ для бизнес-школ заключается не столько в том, могут ли студенты генерировать правдоподобные анализы кейсов, сколько в том, как учебные планы развивают навыки верификации, тщательности и способности распознавать, что требуется для полностью завершенного ответа, особенно в задачах, где Standard баллы уже высоки, а удовлетворенность Complete Answer остается труднодостижимой (ai_biz_impact_2). Для рынков труда профессиональное картирование на рис. 3 и диапазоны охвата профессий в приложении SI, рис. SImplied AI impact on O*NET occupations помогают определить, где аналитическая работа начального уровня наиболее подвержена влиянию AI. Они также указывают на области, где преимущество человека может сохраняться, особенно в работе, зависящей от интеграции точек зрения заинтересованных сторон, реализации ответственности и учета организационного контекста. Подобные возможности выходят за рамки одноходовых бенчмарков и поэтому недостаточно полно отражены в таких оценках, как наша. Эти остающиеся пробелы являются естественными точками для взаимодействия человека и AI, а не для полной замены (dellacqua2026jagged; krakowski2025human). Внутрисемейная траектория, которую мы документируем, является нижней границей того, как быстро могут улучшаться возможности. Она не прогнозирует путь каждого поставщика моделей, но предостерегает от восприятия сегодняшних Standard баллов как потолка того, что организации и фирмы вскоре увидят на практике..
BusinessCaseBench также имеет значение для оценки AI и разработки моделей. Поскольку многие широко используемые бенчмарки AI приближаются к насыщению, измерение дальнейшего прогресса будет все чаще требовать оценок, основанных на экономически значимой интеллектуальной работе, а не только на узком воспроизведении фактов, математических рассуждениях или задачах по программированию. BusinessCaseBench выделяет подмножество аналитических рассуждений открытого типа, которые остаются сложными для передовых моделей, несмотря на их высокие общие показатели. Модели часто создают аналитически сильные черновики, пропуская при этом важные соображения, не интегрируя конкурирующие ограничения или не доводя дело до полноценной рекомендации. Таким образом, эти более сложные кейсы представляют собой естественную цель для будущей разработки моделей, включая пост-тренинг, обучение с подкреплением и генерацию синтетических данных, которые поощряют синтез, полноту, анализ компромиссов и принятие решений в условиях неопределенности..
Последующие работы могут объединить BusinessCaseBench с интерактивными протоколами, исследованиями организационного внедрения и прямыми человеческими базовыми показателями для установления связи между измеренными возможностями и институциональными результатами.
8 Методы
8.1 Создание бенчмарка
BusinessCaseBench был создан на основе лицензированных PDF-файлов бизнес-кейсов и соответствующих им PDF-файлов с решениями для преподавателей, распространяемых издателями в рамках соглашений об ограниченном использовании; см. Приложение SI, раздел E2 Scope of coverage, где приведен список опубликованных и скрытых артефактов. Все использование LLM при работе с этими материалами проводилось в соответствии с политикой нулевого хранения данных (ZDR). Каждый оцениваемый экземпляр связывает описание кейса с вопросом в стиле экзамена, эталонным решением, взятым непосредственно из решения кейса для преподавателя, равновесной контрольной рубрикой, метаданными типа вопроса и тегами рабочей деятельности O*NET. Схема набора данных описана в Приложении SI, раздел A Benchmark construction, а композиционная структура вопросов BusinessCaseBench представлена в Приложении SI, раздел A1 Final dataset schema⟧.
Все PDF-файлы были преобразованы в линеаризованный markdown с использованием OCR из инструментария olmOCR (poznanski_olmocr_2025), при этом модель vision-language allenai/olmOCR-2-7B-1025-FP8, обслуживаемая через vLLM (kwon_efficient_2023), применялась пакетно ко всему корпусу с последующим этапом очистки полученного текста с помощью LLM. Мы провели аудит дословного присутствия этих материалов в крупных корпусах для предварительного обучения, собранных методом веб-краулинга, с использованием InfiniGram (Liu2024InfiniGram) и не обнаружили признаков загрязнения в широко используемых наборах данных. В Приложении SI, Раздел E Validity, limitations, and reproducibility представлены протокол аудита и результаты для C4 (raffel2020exploring), The Pile (pile), RedPajama (together2023redpajama), Dolma (soldaini-etal-2024-dolma) и DCLM (li2025datacomplmsearchgenerationtraining). Перед составлением вопросов каждый кейс был независимо помечен как описывающий вымышленную организацию или конкретную реальную целевую организацию..
Вопросы и эталонные решения были извлечены исключительно из материалов, явно представленных в решении кейса для преподавателя, а не выведены из описания кейса; любые примеры, для которых в решении кейса для преподавателя отсутствовало явное эталонное решение, были исключены. Отобранные примеры были стандартизированы посредством проходов переписывания через LLM в самодостаточные экзаменационные вопросы, а автоматизированный контроль качества отсеивал любую выборку, не прошедшую базовые проверки на соответствие тройки «вопрос — эталонное решение». Мы дополнительно аннотировали каждый пример по признакам численного и нечисленного содержания, субъективной и объективной формулировки, бизнес-дисциплины и таксономии O*NET. Несмотря на то что конвейер создания опирался на помощь LLM от этапа извлечения вопросов до аннотирования метаданных (google/gemini-2.5-pro и google/gemini-2.5-flash, (comanici_gemini_2025)), каждый сохраненный вопрос, метаданные и эталонное решение прошли ручную проверку и контроль качества перед включением..
Для каждого примера на основе экзаменационного вопроса и эталонного решения из методического пособия преподавателя была составлена равновесная контрольная рубрика в соответствии с установленными передовыми методами автоматизированной оценки с использованием рубрик (min_factscore_2023; lin_wildbench_2024; wei_rocketeval_2025), при этом за каждый критерий начислялись бинарные баллы, а каждый критерий имел равный вес при распределении частичных баллов. Каждый вопрос был дополнительно соотнесен с метками O*NET Work Activity (WA), Intermediate Work Activity (IWA) и Detailed Work Activity (DWA), а количество по уровням приведено в Приложении SI, раздел A1 Final dataset schema. Рабочие процессы создания и оценки были организованы с помощью DataDreamer (patel_datadreamer_2024) для обеспечения воспроизводимости конвейеров LLM. Код конвейера оценки опубликован вместе со статьей (см. раздел Доступность данных).
8.2 Передовые модели AI и их оценка
Первичный кросс-модельный анализ сравнивает три передовые модели искусственного интеллекта: OpenAI GPT-5.4 (singh_openai_2026), Anthropic Claude Sonnet 4.6 (anthropic_system_2025) и Google Gemini 3 Flash Preview (deepmind_gemini_2025). В приложении SI, раздел 6, перечислены идентификаторы API и настройки выборки для каждой из них. Чтобы отследить развитие возможностей внутри одного семейства моделей, мы дополнительно оценили четыре последовательных релиза OpenAI, охватывающих примерно два года, от GPT-4 Turbo до GPT-4.1, GPT-5 и GPT-5.4 (openai_gpt-4_2024; singh_openai_2026), на одном и том же фиксированном наборе вопросов..
Каждая модель-решатель получала полное описание кейса и текст вопроса в стиле экзамена за один проход, без доступа к инструментам, расширенному поиску или уточнениям в несколько этапов; шаблон промпта для вывода, настройки провайдера и лимиты токенов приведены в Приложении SI, Раздел 6. Оценивание проводилось независимо от генерации с помощью фиксированной LLM-as-judge (zheng_judging_2023), которая оставалась неизменной для всех моделей-решателей. Мы используем меньшую, более быструю и эффективную модель Gemini 2.5 Flash (google/gemini-2.5-flash) (comanici_gemini_2025) для задачи оценивания, что является стандартом в конфигурациях LLM-as-judge. Судья оценивает каждое предложенное решение по критериям, присуждая бинарные баллы (0 или 1 балл) в соответствии с чек-листом и эталонным решением, следуя протоколу из Приложения SI, Раздел B2 Inference prompt template. Все семь моделей оценивались по одним и тем же 615 вопросам, при этом менялась только модель-решатель. Чтобы оценить, меняет ли выбор модели-судьи LLM сравнительные выводы, мы повторно оценили ответы от Claude Sonnet 4.6, GPT-5.4 и Gemini 3 Flash Preview с помощью трех соответствующих по семейству малых моделей-судей (Gemini 2.5 Flash, Claude Haiku 4.5 и GPT-5-mini) по всем вопросам. Мы измерили согласованность двумя взаимодополняющими способами. Ранговая конкордация использовала коэффициент конкордации Кендалла () и попарный коэффициент Кендалла для средних баллов по трем решателям. Конкордация относительных оценок использовала попарные корреляции Пирсона для оценок каждого судьи по тем же решателям, фиксируя, согласны ли судьи в том, насколько далеко модели отстоят друг от друга, оставаясь при этом инвариантными к абсолютному уровню баллов. Все три судьи выдали одинаковый общий рейтинг (; все попарные ), и относительные различия в баллах также совпали почти полностью (попарные ). На уровне отдельных вопросов согласованность была лишь умеренной (среднее попарное ; среднее попарное ; идентичный рейтинг в 35% вопросов), как и ожидалось из-за шума на уровне элементов, однако эти разногласия не изменили общий ранговый порядок. Таким образом, мы делаем вывод, что выбор модели-судьи LLM существенно не меняет сравнительные выводы в BusinessCaseBench.
8.3 Интерфейс аннотирования человеком и протокол слепой валидации
Для проверки автоматизированных рубрик и оценок по сравнению с экспертными суждениями о качестве ответов три аннотатора с опытом оценивания в бизнес-школах (аннотаторы A, B и C) выполнили протокол слепой оценки на стратифицированной случайной выборке. Процедуры набора и обучения описаны в SI Appendix, раздел C1 Interface and protocol. Рабочий процесс был реализован в специализированном веб-интерфейсе, показанном в SI Appendix, рис. SC1 Interface and protocol, с поэтапным раскрытием данных, что гарантировало, что человеческие рубрики и оценки не были сформированы под влиянием автоматизированных результатов; полный протокол см. в SI Appendix, раздел C Human annotation and blinded validation..
Для каждого назначенного вопроса аннотаторы сначала оценивали, являются ли промпт экзаменационного типа и эталонное решение пригодными для использования и корректно сформированными, чтобы в дальнейшем независимо подтвердить качество извлеченных вопросов и решений из PDF-файлов кейсов. Затем аннотаторы независимо составляли собственную контрольную рубрику и оценивали попытку решения, сгенерированную моделью, до ознакомления с автоматизированной рубрикой или оценкой. На последующих этапах аннотаторов просили оценить автоматизированную рубрику и выставление оценок, а также сравнить оба уровня непосредственно со своими собственными..
Оценка ответов на открытые кейсы неизбежно носит отчасти субъективный характер, поскольку разные преподаватели и проверяющие могут расходиться во мнениях относительно критериев приемлемости и порогов частичного начисления баллов. В данном слепом протоколе аннотаторы составляли независимые рубрики и зачастую присваивали разные баллы за частичное выполнение одним и тем же ответам модели. Учитывая, что эксперты-люди не приходят к единой оценке, мы не ожидаем, что автоматизированные оценки будут в точности совпадать с какой-либо одной оценкой человека. Статистика валидации приводится по десяти заданиям, в которых все три аннотатора оценивали один и тот же кейс, вопрос и ответ модели. Результаты подтверждают, что автоматически сгенерированные рубрики и процедура LLM-as-judge направленно согласуются с экспертным суждением и подходят для измерения относительного прогресса между моделями, дисциплинами и во времени: автоматизированные Standard оценки коррелировали с оценками частичного начисления баллов людьми на уровне Spearman ; аннотаторы оценили 100% автоматически сгенерированных рубрик как приемлемые или преимущественно приемлемые, а 96% Standard оценок LLM-as-judge — как приемлемые или преимущественно приемлемые; в 74% заданий они предпочли автоматизированную оценку или сочли её эквивалентной своей собственной. Дополнительные подробности и статистика согласованности приведены в SI Appendix, Section C2 Annotator recruitment and training.
8.4 Отчетность по метрикам оценки и статистике
Мы представляем две основные метрики результатов, формализованные следующим образом. Пусть модель отвечает на вопрос , который имеет равнозначных критериев оценки, и пусть обозначает, удовлетворен ли критерий при оценивании с помощью LLM-as-judge. Стандартная оценка для каждого вопроса — это
| (1) |
нормализованное значение в (представленное в виде процентного показателя в рисунках). Стандартный балл на уровне модели представляет собой невзвешенное среднее по вопросам бенчмарка ,
| (2) |
Оценка полного ответа отмечает, выполнен ли каждый критерий в вопросе. Определите индикатор
| (3) |
и оценку Полного ответа как его среднее значение по вопросам,
| (4) |
Те же определения применяются при расчете средних значений по подмножеству вопросов в рамках дисциплины, страт типов вопросов или для каждого IWA. Мы приводим полные таблицы лидеров и декомпозицию результатов в Приложении SI, раздел C3 Rubric and grading validation and agreement results. Неопределенность, если она указана, количественно оценивается с помощью непараметрической бутстреп-ресемплинг выборки по вопросам, извлекая повторных выборок с возвращением для каждой метрики и указывая 95% доверительные интервалы на основе перцентилей..
9 Благодарности
Авторы выражают благодарность Марку Яцкару, Дэниелу Року, Эрику Хорвицу и Митчу Вайсу за предварительные обсуждения на этапе концептуализации данной работы. Авторы благодарят анонимных рецензентов за их ценные предложения..
10 Конфликт интересов
Авторы заявляют об отсутствии конфликта интересов..
11 Дополнительные материалы
Дополнительные материалы доступны ниже.
12 Финансирование
Данная работа частично финансируется за счет средств Министерства войны США.
13 Вклад авторов
Концептуализация: А.П., К.Х., Р.К. и С.С.Б.; Курирование данных: А.П. и К.Х.; Методология, эксперименты и анализ: А.П.; Написание рукописи: А.П.; Рецензирование и редактирование рукописи: А.П., К.Х., Р.К., С.С.Б. и К.Л.; Ресурсы: К.Х., Р.К. и К.Л..
14 Доступность данных
Все данные и код (в случаях, когда условия лицензии позволяют нам делиться данными), необходимые для воспроизведения результатов данной статьи, были размещены на Zenodo по адресу https://doi.org/10.5281/zenodo.20211020⟧.
Список литературы
Дополнительные материалы
Дополнительные материалы к статье «Производительность передовых LLM в бизнес-дисциплинах: бенчмарк интеллектуальной работы и аналитического мышления на основе кейсов», содержащие информацию о дополнительных результатах, сведениях о воспроизводимости и деталях эксперимента..
Содержание
А Создание бенчмарка
A1 Итоговая схема набора данных
Каждый оцениваемый элемент представляет собой одну запись в формате JSON: метаданные кейса, полный текст кейса и решение кейса от преподавателя, отдельный вопрос экзаменационного типа, решение, полученное на основе решения кейса от преподавателя, контрольный список grading_rubric, флаги типа вопроса и теги рабочей деятельности O*NET. Приведенная ниже иллюстративная запись является репрезентативным примером формата; проприетарные текстовые поля обозначены многоточием.
{
  "case_name": "ILLUSTRATIVE-001",
  "case_title": "Acme Corp: European Expansion",
  "case_summary": "In late 2023, Acme Corp---a $480M U.S. manufacturer---weighed entering the European market...",
  "case_clean_text": "...",
  "instructor_case_solution_clean_text": "...",
  "question": "Provide an analysis of Acme Corp’s strategic position and make a recommendation on...",
  "solution": "An analysis should size the European TAM at roughly 11B EUR and note that three incumbents...",
  "task_description": "Evaluate a business’s market entry and channel development strategy.",
  "numerical": false,
  "subjective": true,
  "grading_rubric": [
    "Answer identifies European market size (TAM) correctly.",
    "Answer cites competitive threat from incumbent concentration.",
    "Answer computes or discusses break-even economics for entry.",
    "Answer notes regulatory or CE-mark compliance risk.",
    "Answer states a clear enter-or-defer recommendation for 2024.",
    "..."
  ],
  "discipline": "Strategy",
  "work_activity": "Making Decisions and Solving Problems",
  "work_activity_id": "4.A.2.b.1",
  "intermediate_work_activity": "Advise others on business or operational matters.",
  "intermediate_work_activity_id": "4.A.4.b.6.I05",
  "detailed_work_activity": "Measure effectiveness of business strategies or practices.",
  "detailed_work_activity_id": "4.A.2.a.1.I02.D03"
}
A2 Таблицы композиции
В следующих таблицах обобщен состав бенчмарка, использованного в нашем анализе. В них представлен общий охват и распределение вопросов в наборе данных по стратам, дисциплинам и таксономии рабочих задач O*NET, что обеспечивает компактное представление о распределении вопросов в бенчмарке..
| Strata | Questions |
|---|---|
| All questions | 615 |
| Fictional case | 245 |
| Real case | 370 |
| Numerical | 184 |
| Non-numerical | 431 |
| Subjective | 339 |
| Objective | 276 |
| Discipline | Fictional | Real | Numerical | Non-num. | Subjective | Objective | |
|---|---|---|---|---|---|---|---|
| Strategy | 110 | 19 | 91 | 20 | 90 | 77 | 33 |
| Leadership & Organizational Behavior | 102 | 52 | 50 | 1 | 101 | 81 | 21 |
| Finance | 87 | 32 | 55 | 64 | 23 | 28 | 59 |
| Accounting | 58 | 39 | 19 | 45 | 13 | 9 | 49 |
| Business Ethics | 43 | 30 | 13 | 2 | 41 | 36 | 7 |
| General Management | 34 | 8 | 26 | 4 | 30 | 29 | 5 |
| Operations & Service Management | 31 | 7 | 24 | 7 | 24 | 12 | 19 |
| Economics | 24 | 1 | 23 | 9 | 15 | 1 | 23 |
| Human Resource Management | 22 | 15 | 7 | 2 | 20 | 16 | 6 |
| Marketing & Sales | 22 | 7 | 15 | 3 | 19 | 16 | 6 |
| Decision Analysis | 21 | 18 | 3 | 19 | 2 | 3 | 18 |
| Entrepreneurship & Innovation | 17 | 4 | 13 | 3 | 14 | 11 | 6 |
| Information Technology | 12 | 2 | 10 | 0 | 12 | 1 | 11 |
| Business & Government Relations | 12 | 1 | 11 | 0 | 12 | 7 | 5 |
| Negotiation | 8 | 2 | 6 | 3 | 5 | 5 | 3 |
| International Business | 7 | 5 | 2 | 1 | 6 | 3 | 4 |
| Management Communications | 4 | 3 | 1 | 0 | 4 | 3 | 1 |
| Social Enterprise | 1 | 0 | 1 | 1 | 0 | 1 | 0 |
| Total | 615 | 245 | 370 | 184 | 431 | 339 | 276 |
| Work Activity | WA ID | |
|---|---|---|
| Analyzing Data or Information | 4.A.2.a.4 | 245 |
| Making Decisions and Solving Problems | 4.A.2.b.1 | 108 |
| Developing Objectives and Strategies | 4.A.2.b.4 | 89 |
| Judging the Qualities of Things, Services, or People | 4.A.2.a.1 | 28 |
| Provide Consultation and Advice to Others | 4.A.4.b.6 | 27 |
| Interpreting the Meaning of Information for Others | 4.A.4.a.1 | 24 |
| Processing Information | 4.A.2.a.2 | 19 |
| Selling or Influencing Others | 4.A.4.a.6 | 15 |
| Estimating the Quantifiable Characteristics of Products, Events, or Information | 4.A.1.b.3 | 13 |
| Evaluating Information to Determine Compliance with Standards | 4.A.2.a.3 | 9 |
| Thinking Creatively | 4.A.2.b.2 | 8 |
| Getting Information | 4.A.1.a.1 | 6 |
| Organizing, Planning, and Prioritizing Work | 4.A.2.b.6 | 5 |
| Identifying Objects, Actions, and Events | 4.A.1.b.1 | 4 |
| Coaching and Developing Others | 4.A.4.b.5 | 4 |
| Documenting/Recording Information | 4.A.3.b.6 | 2 |
| Training and Teaching Others | 4.A.4.b.3 | 2 |
| Monitor Processes, Materials, or Surroundings | 4.A.1.a.2 | 1 |
| Interacting With Computers | 4.A.3.b.1 | 1 |
| Resolving Conflicts and Negotiating with Others | 4.A.4.a.7 | 1 |
| Staffing Organizational Units | 4.A.4.c.2 | 1 |
| Updating and Using Relevant Knowledge | 4.A.2.b.3 | 1 |
| Performing Administrative Activities | 4.A.4.c.1 | 1 |
| Communicating with Persons Outside Organization | 4.A.4.a.3 | 1 |
| Intermediate Work Activity | IWA ID | |
|---|---|---|
| Analyze business or financial data. | 4.A.2.a.4.I11 | 117 |
| Advise others on business or operational matters. | 4.A.4.b.6.I05 | 88 |
| Evaluate programs, practices, or processes. | 4.A.2.a.1.I02 | 48 |
| Analyze business or financial risks. | 4.A.2.a.4.I03 | 44 |
| Research organizational behavior, processes, or performance. | 4.A.1.a.1.I09 | 34 |
| Develop financial or business plans. | 4.A.2.b.2.I09 | 33 |
| Investigate organizational or operational problems. | 4.A.1.a.1.I22 | 31 |
| Develop organizational policies, systems, or processes. | 4.A.2.b.4.I01 | 27 |
| Analyze market or industry conditions. | 4.A.2.a.4.I02 | 26 |
| Develop business or marketing plans. | 4.A.2.b.2.I03 | 20 |
| Assess characteristics or impacts of regulations or policies. | 4.A.2.a.4.I09 | 13 |
| Analyze data to improve operations. | 4.A.2.a.4.I07 | 13 |
| Develop organizational or program goals or objectives. | 4.A.2.b.2.I27 | 13 |
| Prepare financial documents, reports, or budgets. | 4.A.3.b.6.I01 | 9 |
| Calculate financial data. | 4.A.1.b.3.I03 | 8 |
| Advise others on financial matters. | 4.A.4.b.6.I11 | 6 |
| Evaluate the characteristics, usefulness, or performance of products or technologies. | 4.A.2.a.1.I07 | 6 |
| Analyze scientific or applied data using mathematical principles. | 4.A.2.a.4.I04 | 6 |
| Examine financial activities, operations, or systems. | 4.A.2.a.3.I03 | 5 |
| Resolve personnel or operational problems. | 4.A.4.a.7.I03 | 5 |
| Develop contingency or emergency response plans. | 4.A.2.b.2.I19 | 5 |
| Identify business or organizational opportunities. | 4.A.1.b.1.I02 | 4 |
| Evaluate personnel capabilities or performance. | 4.A.2.a.1.I04 | 4 |
| Develop sustainable organizational or business policies or practices. | 4.A.2.b.2.I20 | 4 |
| Develop models of systems, processes, or products. | 4.A.2.b.2.I21 | 4 |
| Explain financial information. | 4.A.4.a.1.I04 | 3 |
| Evaluate condition of financial assets, property, or other resources. | 4.A.2.a.1.I09 | 3 |
| Reconcile financial data. | 4.A.2.a.2.I04 | 3 |
| Evaluate project feasibility. | 4.A.2.a.1.I10 | 3 |
| Determine operational methods or procedures. | 4.A.2.b.1.I04 | 2 |
| Maintain sales or financial records. | 4.A.3.b.6.I10 | 2 |
| Develop research plans or methodologies. | 4.A.2.b.2.I23 | 2 |
| Plan work activities. | 4.A.2.b.6.I02 | 2 |
| Research laws, precedents, or other legal data. | 4.A.2.a.4.I08 | 1 |
| Develop systems or practices to mitigate or resolve environmental problems. | 4.A.2.b.2.I16 | 1 |
| Present research or technical information. | 4.A.3.b.6.I03 | 1 |
| Examine materials or documentation for accuracy or compliance. | 4.A.2.a.3.I01 | 1 |
| Research historical or social issues. | 4.A.1.a.1.I18 | 1 |
| Prepare reports of operational or procedural activities. | 4.A.3.b.6.I15 | 1 |
| Monitor external affairs, trends, or events. | 4.A.1.a.2.I08 | 1 |
| Investigate criminal or legal matters. | 4.A.1.a.1.I03 | 1 |
| Develop professional relationships or networks. | 4.A.4.a.4.I01 | 1 |
| Analyze environmental or geospatial data. | 4.A.2.a.4.I01 | 1 |
| Evaluate production inputs or outputs. | 4.A.2.a.1.I05 | 1 |
| Estimate project development or operational costs. | 4.A.1.b.3.I02 | 1 |
| Collect data about consumer needs or opinions. | 4.A.1.a.1.I14 | 1 |
| Develop marketing or promotional materials. | 4.A.2.b.2.I12 | 1 |
| Monitor operations to ensure adequate performance. | 4.A.1.a.2.I02 | 1 |
| Explain regulations, policies, or procedures. | 4.A.4.a.1.I02 | 1 |
| Evaluate the quality or accuracy of data. | 4.A.2.a.2.I01 | 1 |
| Process digital or online data. | 4.A.3.b.1.I06 | 1 |
| Prepare legal or regulatory documents. | 4.A.3.b.6.I14 | 1 |
| Monitor individual behavior or performance. | 4.A.1.a.2.I06 | 1 |
| Gather data about operational or development activities. | 4.A.1.a.1.I06 | 1 |
| Prepare proposals or grant applications. | 4.A.3.b.6.I07 | 1 |
| Detailed Work Activity | DWA ID | |
|---|---|---|
| Analyze business or financial data. | 4.A.2.a.4.I11.D04 | 57 |
| Develop operating strategies, plans, or procedures. | 4.A.2.b.4.I01.D02 | 37 |
| Advise others on business or operational matters. | 4.A.4.b.6.I05.D10 | 33 |
| Analyze financial information. | 4.A.2.a.4.I11.D02 | 29 |
| Measure effectiveness of business strategies or practices. | 4.A.2.a.1.I02.D03 | 27 |
| Analyze operational data to evaluate operations, processes or products. | 4.A.2.a.4.I07.D03 | 27 |
| Develop business or market strategies. | 4.A.2.b.2.I03.D01 | 26 |
| Analyze data to inform operational decisions or activities. | 4.A.2.a.4.I07.D12 | 23 |
| Analyze data to assess operational or project effectiveness. | 4.A.2.a.4.I07.D09 | 19 |
| Analyze market conditions or trends. | 4.A.2.a.4.I02.D04 | 18 |
| Assess risks to business operations. | 4.A.2.a.4.I03.D01 | 15 |
| Analyze risks to minimize losses or damages. | 4.A.2.a.4.I03.D03 | 14 |
| Analyze financial records or reports to determine state of operations. | 4.A.2.a.4.I11.D06 | 13 |
| Develop organizational policies or programs. | 4.A.2.b.4.I01.D01 | 13 |
| Analyze data to identify or resolve operational problems. | 4.A.2.a.4.I07.D14 | 12 |
| Develop financial or business plans. | 4.A.2.b.2.I09.D02 | 12 |
| Analyze costs and benefits of proposed designs or projects. | 4.A.2.a.4.I05.D08 | 10 |
| Apply mathematical models of financial or business conditions. | 4.A.2.a.4.I11.D03 | 10 |
| Develop organizational goals or objectives. | 4.A.2.b.2.I27.D02 | 10 |
| Analyze budgetary or accounting data. | 4.A.2.a.4.I11.D01 | 9 |
| Apply mathematical principles or statistical approaches to solve problems in scientific or applied fields. | 4.A.2.a.4.I04.D01 | 9 |
| Evaluate effectiveness of personnel policies or practices. | 4.A.2.a.1.I02.D04 | 8 |
| Calculate financial data. | 4.A.1.b.3.I03.D01 | 7 |
| Establish business management methods. | 4.A.2.b.4.I01.D05 | 7 |
| Develop marketing plans or strategies. | 4.A.2.b.2.I03.D03 | 7 |
| Develop sustainable business strategies or practices. | 4.A.2.b.2.I20.D02 | 7 |
| Recommend organizational process or policy changes. | 4.A.4.b.6.I05.D07 | 6 |
| Analyze industry trends. | 4.A.2.a.4.I02.D02 | 5 |
| Develop organizational methods or procedures. | 4.A.2.b.4.I01.D04 | 5 |
| Examine financial records to ensure compliance with policies or regulations. | 4.A.2.a.3.I03.D05 | 5 |
| Analyze operational or research data. | 4.A.2.a.4.I07.D02 | 5 |
| Analyze data to identify trends or relationships among variables. | 4.A.2.a.4.I04.D02 | 5 |
| Analyze financial records to improve budgeting or planning. | 4.A.2.a.4.I11.D05 | 4 |
| Analyze forecasting data to improve business decisions. | 4.A.2.a.4.I07.D08 | 4 |
| Evaluate civic projects or public policies. | 4.A.2.a.1.I02.D07 | 4 |
| Determine causes of operational problems or failures. | 4.A.2.b.1.I02.D01 | 4 |
| Analyze market or customer related data. | 4.A.2.a.4.I02.D06 | 4 |
| Advise others on ways to improve processes or products. | 4.A.4.b.6.I05.D11 | 4 |
| Prepare financial documents, reports, or budgets. | 4.A.3.b.6.I01.D02 | 4 |
| Evaluate applicable laws and regulations to determine impact on organizational activities. | 4.A.2.a.4.I09.D04 | 4 |
| Calculate data to inform organizational operations. | 4.A.2.a.4.I07.D01 | 3 |
| Develop sustainable organizational policies or practices. | 4.A.2.b.2.I20.D03 | 3 |
| Interpret research or operational data. | 4.A.2.a.4.I07.D05 | 3 |
| Develop plans for programs or services. | 4.A.2.b.2.I27.D03 | 3 |
| Evaluate potential of products, technologies, or resources. | 4.A.2.a.1.I07.D03 | 3 |
| Evaluate program effectiveness. | 4.A.2.a.1.I02.D01 | 3 |
| Develop contingency plans to deal with organizational emergencies. | 4.A.2.b.2.I19.D03 | 3 |
| Maintain financial or account records. | 4.A.3.b.6.I10.D03 | 2 |
| Prepare financial documents. | 4.A.3.b.6.I01.D01 | 2 |
| Maintain knowledge of business operations. | 4.A.2.b.3.I01.D17 | 2 |
| Conduct quantitative failure analyses of operational data. | 4.A.2.a.4.I12.D01 | 2 |
| Conduct research on social issues. | 4.A.1.a.1.I18.D03 | 2 |
| Evaluate project designs to determine adequacy or feasibility. | 4.A.2.a.1.I10.D01 | 2 |
| Negotiate contracts with clients or service providers. | 4.A.4.a.7.I02.D10 | 2 |
| Devise research or testing protocols. | 4.A.2.b.2.I23.D01 | 2 |
| Recommend investments to clients. | 4.A.4.b.6.I11.D02 | 2 |
| Analyze impact of legal or regulatory changes. | 4.A.2.a.4.I09.D03 | 2 |
| Develop emergency response plans or procedures. | 4.A.2.b.2.I19.D04 | 2 |
| Determine pricing or monetary policies. | 4.A.2.b.4.I01.D06 | 2 |
| Monitor financial indicators. | 4.A.1.a.2.I03.D05 | 1 |
| Evaluate employee performance. | 4.A.2.a.1.I04.D04 | 1 |
| Resolve operational performance problems. | 4.A.4.a.7.I03.D02 | 1 |
| Analyze market research data. | 4.A.2.a.4.I02.D08 | 1 |
| Investigate legal issues. | 4.A.1.a.1.I03.D04 | 1 |
| Make decisions in legal cases. | 4.A.2.b.1.I05.D01 | 1 |
| Develop marketing plans or strategies for environmental initiatives. | 4.A.2.b.2.I03.D02 | 1 |
| Develop environmental sustainability plans or projects. | 4.A.2.b.2.I08.D03 | 1 |
| Develop scientific or mathematical models. | 4.A.2.b.2.I26.D03 | 1 |
| Advise others on human resources topics. | 4.A.4.b.6.I05.D08 | 1 |
| Assess product or process usefulness. | 4.A.2.a.1.I07.D05 | 1 |
| Evaluate reports or designs to determine work needs. | 4.A.1.a.1.I02.D12 | 1 |
| Identify investment opportunities or strategies. | 4.A.1.b.1.I02.D03 | 1 |
| Advise others on financial matters. | 4.A.4.b.6.I11.D03 | 1 |
| Assess financial status of clients. | 4.A.2.a.1.I09.D02 | 1 |
| Evaluate the effectiveness of counseling or educational programs. | 4.A.2.a.1.I02.D02 | 1 |
| Establish interpersonal business relationships to facilitate work activities. | 4.A.4.a.4.I01.D04 | 1 |
| Determine the value of goods or services. | 4.A.2.b.1.I01.D02 | 1 |
| Advise others on analytical techniques. | 4.A.4.b.6.I05.D05 | 1 |
| Develop program goals or plans. | 4.A.2.b.2.I27.D01 | 1 |
| Design research studies to obtain scientific information. | 4.A.2.b.2.I23.D04 | 1 |
| Analyze risks related to investments in green technology. | 4.A.2.a.4.I03.D02 | 1 |
| Implement advertising or marketing initiatives. | 4.A.2.b.1.I09.D04 | 1 |
| Prepare analytical reports. | 4.A.3.b.6.I03.D05 | 1 |
| Resolve personnel problems. | 4.A.4.a.7.I03.D03 | 1 |
| Measure environmental characteristics. | 4.A.1.a.2.I09.D03 | 1 |
| Recommend changes or corrective procedures. | 4.A.4.b.6.I05.D12 | 1 |
| Develop detailed project plans. | 4.A.2.b.6.I02.D08 | 1 |
| Analyze data to inform personnel decisions. | 4.A.2.a.4.I07.D11 | 1 |
| Monitor external factors impacting operations. | 4.A.1.a.2.I08.D04 | 1 |
| Develop proposals for current or prospective customers. | 4.A.3.b.6.I07.D01 | 1 |
| Determine operational procedures. | 4.A.2.b.1.I04.D04 | 1 |
| Document organizational or operational procedures. | 4.A.3.b.6.I08.D30 | 1 |
| Identify strategic business investment opportunities. | 4.A.1.b.1.I02.D04 | 1 |
| Communicate with clients about products, procedures, and policies. | 4.A.4.a.1.I02.D06 | 1 |
| Identify opportunities to improve operational efficiency. | 4.A.1.b.1.I02.D06 | 1 |
| Assess the cost effectiveness of products, projects, or services. | 4.A.2.a.1.I07.D01 | 1 |
| Estimate costs of products, services, or materials. | 4.A.2.b.1.I01.D01 | 1 |
| Develop database parameters or specifications. | 4.A.2.b.2.I06.D01 | 1 |
| Prepare data for analysis. | 4.A.3.b.1.I06.D07 | 1 |
| Explain technical product or service information to customers. | 4.A.4.a.1.I01.D05 | 1 |
| Develop operating strategies, plans, or procedures for green or sustainable operations. | 4.A.2.b.2.I20.D01 | 1 |
| Conduct scientific research of organizational behavior or processes. | 4.A.1.a.1.I09.D03 | 1 |
| Research topics in area of expertise. | 4.A.2.b.3.I01.D10 | 1 |
| Analyze jobs using observation, survey, or interview techniques. | 4.A.2.a.4.I07.D10 | 1 |
| Evaluate environmental or sustainability projects. | 4.A.2.a.4.I05.D07 | 1 |
| Recruit personnel. | 4.A.4.c.2.I01.D05 | 1 |
| Forecast economic, political, or social trends. | 4.A.2.a.4.I02.D03 | 1 |
B Протокол оценки моделей
B1 Оцененные модели
В следующей таблице перечислены все оцененные модели: провайдер, идентификатор API, приблизительная дата выпуска и роль при инференсе. Для запросов к LLM мы используем temperature 0; там, где API это поддерживает, мы включаем провайдерское reasoning (приблизительно средние усилия, исключено из оцениваемого ответа). Каждое завершение от решателя ограничено 10 000 токенов для reasoning и итогового ответа в совокупности..
| Model name | Provider | API identifier | Approx. release | Role | Temp. |
|---|---|---|---|---|---|
| GPT-4 Turbo | OpenAI | gpt-4-turbo | Nov 2023 | Trajectory | 0 |
| GPT-4.1 | OpenAI | gpt-4.1 | Apr 2025 | Trajectory | 0 |
| GPT-5 | OpenAI | gpt-5 | Jan 2026 | Trajectory | 0 |
| GPT-5.4 | OpenAI | gpt-5.4 | Mar 2026 | Trajectory + Frontier trio | 0 |
| Claude Sonnet 4.6 | Anthropic | claude-sonnet-4.6 | Feb 2026 | Frontier trio | 0 |
| Gemini 3 Flash Preview | Google DeepMind | gemini-3-flash-preview | Dec 2025 | Frontier trio | 0 |
| Claude Fable 5 | Anthropic | claude-fable-5 | June 2026 | Extended Result | 0 |
B2 Шаблон промпта для вывода
Каждая модель-решатель получает полный текст кейса и вопрос бенчмарка в рамках промпта с одним циклом взаимодействия.:
You are given a business case and a question about the case. You must output
an answer that thoroughly addresses the question and instructions, with full
reasoning and justification for your answer.

The Question:
’’’
{question}
’’’

The Case:
’’’
{case_clean_text}
’’’
B3 Промпт для оценки LLM-as-judge
Фиксированная модель-судья (google/gemini-2.5-flash) оценивает каждый предложенный ответ при температуре 0 (рассуждения провайдера отключены) с тем же ограничением на завершение в 10 000 токенов. Судья присваивает 0 или 1 балл за каждый критерий рубрикатора и возвращает итоговую оценку в скобках << и >>.:
You are an experienced judge of LLM-generated answers. You are given an
LLM-generated answer to a question about a business case and a grading rubric
for the model’s answer to that question.

Remember that business cases sometimes involve subjective questions meant to
test critical-thinking and reasoning skills that have no objective correct
answers. Other times, there are objective questions that have a single
correct answer.

You will be provided a rubric of criteria items to grade the LLM-generated
answer against along with an example of a gold standard answer or description
of an answer to the question taken from the instructor case solution for this
business case.

**Your task:** Reason through each rubric criterion and grade the LLM-generated
answer against it. Each criterion is worth 1 point; assign 0 or 1 point per
criterion.

**Output:** Write out your reasoning for each criterion, then return your
final total score for the LLM-generated answer between << and >> brackets.

Question:
’’’
{question}
’’’

The LLM-Generated Answer:
’’’
{model_answer}
’’’

The Grading Rubric:
’’’
{grading_rubric_list}
’’’

Gold Standard Answer:
’’’
{solution}
’’’

Case Summary:
’’’
{case_summary}
’’’
C Аннотирование человеком и слепая валидация
C1 Интерфейс и протокол
Аннотаторы выполняют рабочий процесс из семи этапов по проверке рубрик и оценок в веб-интерфейсе (SI Appendix, Fig. SC1 Interface and protocol). Поэтапное раскрытие информации предотвращает предвзятость или влияние автоматических выводов модели на созданные человеком рубрики и оценки. На протяжении всего процесса аннотаторы могут ознакомиться с PDF-файлом кейса, PDF-файлом решения кейса от преподавателя, вопросом и эталонным решением, написанным экспертом; предлагаемый ответ и автоматические оценки раскрываются только при необходимости и после того, как аннотатор создал свою собственную рубрику и оценил по ней предлагаемое решение..
- ⟦1. Оцените вопрос и решение. Определите, являются ли вопрос бенчмарка и эталонное решение инструктора пригодными для использования и корректно сформулированными (отсутствие попытки ответа; отсутствие автоматизированной рубрики или оценки). Варианты: да / нет по вопросу; да / нет по решению; краткое обоснование по желанию (досрочный выход, если выбран вариант нет)).
- ⟦2. Составьте независимую рубрику. Разработайте контрольный список критериев оценки (без попытки дать ответ; без автоматизированной рубрики или балльной системы). Варианты: строки критериев в свободной форме (минимум три)).
- ⟦3. Оцените предложенный ответ. Ответ модели представлен впервые; отметьте, каким критериям человеческой рубрики он соответствует (автоматизированная рубрика или оценка пока отсутствуют). Варианты: выполнено / не выполнено по каждому критерию (рассчитанная оценка человеческого оценивания).
- ⟦4. Оцените автоматизированную рубрику. Представлен контрольный список рубрики конвейера. Варианты: приемлемо / преимущественно приемлемо / неприемлемо; необязательное обоснование.
- ⟦5. Оцените автоматизированную проверку. Представлены оценка и обоснование LLM-as-judge. Варианты: приемлемо / преимущественно приемлемо / неприемлемо; необязательное обоснование.
- ⟦6. Сравнение рубрик. Сопоставление контрольных списков, составленных человеком и автоматизированной системой. Варианты: A сильное соответствие / B расхождение при обоснованности / C расхождение при необоснованности; опциональное обоснование.
- ⟦7. Сравнение оценок. Сопоставление оценок, выставленных человеком и автоматизированной системой. Варианты: A предпочтение автоматизированной оценке / B эквивалентно / C предпочтение оценке человеком; необязательное обоснование.
Интерфейс ручной разметки, используемый для слепой валидации.
C2 Набор и обучение аннотаторов
Три аннотатора, прошедшие подготовку по оценке бизнес-кейсов, выполнили валидационный слой (обозначены как аннотаторы A, B и C). Перед выставлением оценок по реальным примерам каждый из них ознакомился с инструкциями по интерфейсу и выполнил практическое задание, охватывающее все семь этапов. Примеры задач были отобраны из стратифицированной случайной выборки бенчмарка. Анализ согласованности, приведенный ниже, сосредоточен на десяти заданиях по аннотированию, в которых все три аннотатора оценивали одни и те же кейсы, вопросы бенчмарка и ответы, сгенерированные LLM..
C3 Результаты валидации и согласованности рубрик и оценивания
Приложение SI, таблица S8 суммирует метрики валидации по семи этапам протокола. Центральный вопрос заключается в том, является ли автоматически сгенерированная рубрика, оцениваемая последовательно фиксированным LLM судьей, направленно согласованной с экспертной оценкой и получает ли она одобрение приемлемости от экспертов-оценщиков, которые независимо разработали свои собственные рубрики и оценки..
| Step | Validation target | Primary metric | Value | Supporting metric |
|---|---|---|---|---|
| 1 | Question and solution quality | % yes (question / solution) | 100% / 100% | 100% agreement |
| 2 | Independent human rubrics | Mean criteria items per rubric | 10.7 | Mean pairwise difference 3.6 criteria items |
| 3 | Human vs. automated scores | Spearman | 0.54 | 40% within 10 percentage points |
| 4 | Automated rubric quality | % acceptable or mainly acceptable | 100% | 100% agreement |
| 5 | Automated grading quality | % acceptable or mainly acceptable | 96% | 90% agreement |
| 6 | Rubric alignment | % strong alignment (A) or divergent but still valid (B) | 96% | 90% agreement |
| 7 | Score equivalence | % prefer automated (A) or equivalent (B) | 74% | Mean bias percentage points |
На этапе 1 все три аннотатора оценили каждый вопрос и эталонное решение как пригодные к использованию и корректно составленные (100% ответов «да» по обоим критериям; 100% согласованность). На этапе 2 аннотаторы составили независимые рубрики по каждому вопросу (в среднем 10,7 критериальных пунктов; средняя попарная разница составила 3,6 критериальных пункта). Различия в объеме рубрик у разных аннотаторов ожидаемы, поскольку оценивание кейсов с открытым ответом является в некоторой степени субъективным, даже когда проверяющие работают с одними и теми же материалами кейса и эталонными решениями..
На этапе 3 баллы за частичное выполнение, выставленные человеком, коррелируют с автоматизированными стандартными баллами на уровне Spearman . В 40% заданий по аннотированию оценки, выставленные человеком и автоматизированной системой, различались не более чем на десять процентных пунктов, по сравнению с 46,7% пар оценок между аннотаторами, которые попадали в тот же диапазон в десять процентных пунктов. Таким образом, согласованность автоматизированных и человеческих оценок близка к уровню согласованности, наблюдаемому между независимыми экспертами-людьми. Автоматизированный судья в среднем на 6,4 процентного пункта более снисходителен. Согласованность часто оказывается высокой по простым пунктам и снижается, когда аннотаторы составляют рубрики разной степени детализации или применяют разные пороги частичного начисления баллов к одному и тому же ответу..
После просмотра автоматизированных результатов аннотаторы оценили автоматически сгенерированную рубрику как приемлемую или преимущественно приемлемую в 100% завершенных суждений на этапе 4 и оценили стандартную оценку LLM-as-judge как приемлемую или преимущественно приемлемую в 96% суждений на этапе 5. Единственное неприемлемое оценочное суждение произошло в случае, где человеческие оценки варьировались от 0% до 100% среди аннотаторов с разными рубриками, что указывает на значительные разногласия между аннотаторами. На этапе 6 96% сравнений рубрик были классифицированы как сильно согласованные или расходящиеся, но все еще валидные (A или B), и одно сравнение было оценено как невалидное (C). На этапе 7 74% сравнений оценок отдали предпочтение автоматизированной стандартной оценке или признали две оценки эквивалентными (A или B).
Эти результаты не устанавливают точного соответствия между автоматизированными и экспертными оценками, и их не следует интерпретировать таким образом, учитывая субъективность, прослеживаемую на этапах 2–3 и 7. Они подтверждают более узкое утверждение, достаточное для использования в качестве бенчмарка: отобранные вопросы и эталонные решения, подготовленные преподавателями, прошли проверку качества экспертами; эксперты-оценщики одобрили автоматически сгенерированную рубрику и оценки LLM-as-judge Standard после независимой работы; а автоматизированные оценки Standard коррелируют с экспертными оценками частичного кредита в том же направлении (Spearman ). Доказательства валидации указывают на то, что процедура автоматического оценивания направленно согласуется с экспертным суждением и подходит для отслеживания относительного прогресса между моделями, дисциплинами и поколениями моделей..
D Расширенные результаты
D1 Полные таблицы лидеров при обоих режимах оценки
В таблицах ниже представлены совокупные показатели эффективности по всем 615 вопросам при стандартной системе оценки и системе оценки полного ответа, с 95% доверительными интервалами, полученными методом бутстрепа ( повторных выборок).
| Model | Score | 95% CI lower | 95% CI upper |
|---|---|---|---|
| Claude Sonnet 4.6 | 88.4% | 87.1% | 89.7% |
| GPT-5.4 | 87.2% | 85.8% | 88.7% |
| Gemini 3 Flash Preview | 81.6% | 80.0% | 83.4% |
| GPT-5 | 84.9% | 82.8% | 86.8% |
| GPT-4.1 | 80.7% | 78.8% | 82.4% |
| GPT-4 Turbo | 63.9% | 62.0% | 65.9% |
| Claude Fable 5 | 88.0% | 86.4% | 89.5% |
| Model | Score | 95% CI lower | 95% CI upper |
|---|---|---|---|
| Claude Sonnet 4.6 | 49.6% | 45.9% | 53.8% |
| GPT-5.4 | 47.6% | 43.9% | 51.4% |
| Gemini 3 Flash Preview | 32.0% | 28.6% | 35.6% |
| GPT-5 | 46.5% | 42.4% | 50.6% |
| GPT-4.1 | 32.4% | 28.6% | 35.9% |
| GPT-4 Turbo | 13.2% | 10.7% | 15.8% |
| Claude Fable 5 | 50.9% | 47.3% | 54.8% |
D2 Матрица оценок по дисциплинам для каждой модели
Данная матрица содержит средние стандартные баллы для каждой оцениваемой модели в рамках каждой из восемнадцати бизнес-дисциплин, демонстрируя, где возможности являются единообразными, а где модели демонстрируют расхождения..
| Standard scoring (%) | Complete Answer scoring (%) | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Discipline | GPT-5.4 | Claude | Gemini | Mean | Fable 5 | GPT-5.4 | Claude | Gemini | Mean | Fable 5 | |
| Marketing & Sales | 22 | 82.3 | 80.2 | 77.9 | 80.1 | 85.2 | 36.4 | 36.4 | 22.7 | 31.8 | 40.9 |
| Finance | 87 | 83.1 | 83.7 | 74.5 | 80.4 | 82.5 | 41.4 | 46.0 | 21.8 | 36.4 | 42.5 |
| Operations & Service Mgmt. | 31 | 83.3 | 84.4 | 75.2 | 81.0 | 80.3 | 29.0 | 35.5 | 12.9 | 25.8 | 32.3 |
| Negotiation | 8 | 78.0 | 88.8 | 77.4 | 81.4 | 90.5 | 25.0 | 37.5 | 25.0 | 29.2 | 37.5 |
| Accounting | 58 | 87.2 | 87.7 | 74.4 | 83.1 | 88.6 | 48.3 | 50.0 | 37.9 | 45.4 | 62.1 |
| General Management | 34 | 83.9 | 88.6 | 80.5 | 84.4 | 85.0 | 32.4 | 32.4 | 14.7 | 26.5 | 35.3 |
| HRM | 22 | 88.4 | 87.2 | 79.7 | 85.1 | 86.7 | 45.5 | 50.0 | 36.4 | 43.9 | 45.5 |
| L&OB | 102 | 84.7 | 88.8 | 81.8 | 85.1 | 89.1 | 46.1 | 50.0 | 26.5 | 40.8 | 46.1 |
| Business Ethics | 43 | 87.0 | 90.9 | 86.1 | 88.0 | 91.4 | 55.8 | 55.8 | 46.5 | 52.7 | 65.1 |
| E&I | 17 | 91.0 | 90.7 | 86.8 | 89.5 | 94.8 | 58.8 | 70.6 | 35.3 | 54.9 | 52.9 |
| Strategy | 110 | 91.1 | 91.5 | 85.9 | 89.5 | 87.3 | 44.5 | 46.4 | 33.6 | 41.5 | 47.3 |
| Economics | 24 | 93.7 | 90.7 | 86.8 | 90.4 | 94.0 | 70.8 | 50.0 | 37.5 | 52.8 | 62.5 |
| International Business | 7 | 95.2 | 85.4 | 91.5 | 90.7 | 89.7 | 71.4 | 71.4 | 28.6 | 57.1 | 71.4 |
| Decision Analysis | 21 | 93.9 | 90.2 | 91.4 | 91.9 | 93.6 | 85.7 | 85.7 | 76.2 | 82.5 | 81.0 |
| IT | 12 | 88.8 | 95.8 | 92.5 | 92.4 | 97.1 | 50.0 | 75.0 | 58.3 | 61.1 | 75.0 |
| B&GR | 12 | 96.1 | 94.2 | 94.8 | 95.0 | 100.0 | 83.3 | 58.3 | 66.7 | 69.4 | 100.0 |
D3 Траектория производительности OpenAI по дисциплинам
На рисунке отслеживаются четыре модели OpenAI по двенадцати дисциплинам, содержащим не менее пятнадцати вопросов, в рамках обоих режимов оценки, чтобы показать, как прирост производительности между поколениями варьируется в зависимости от дисциплины..
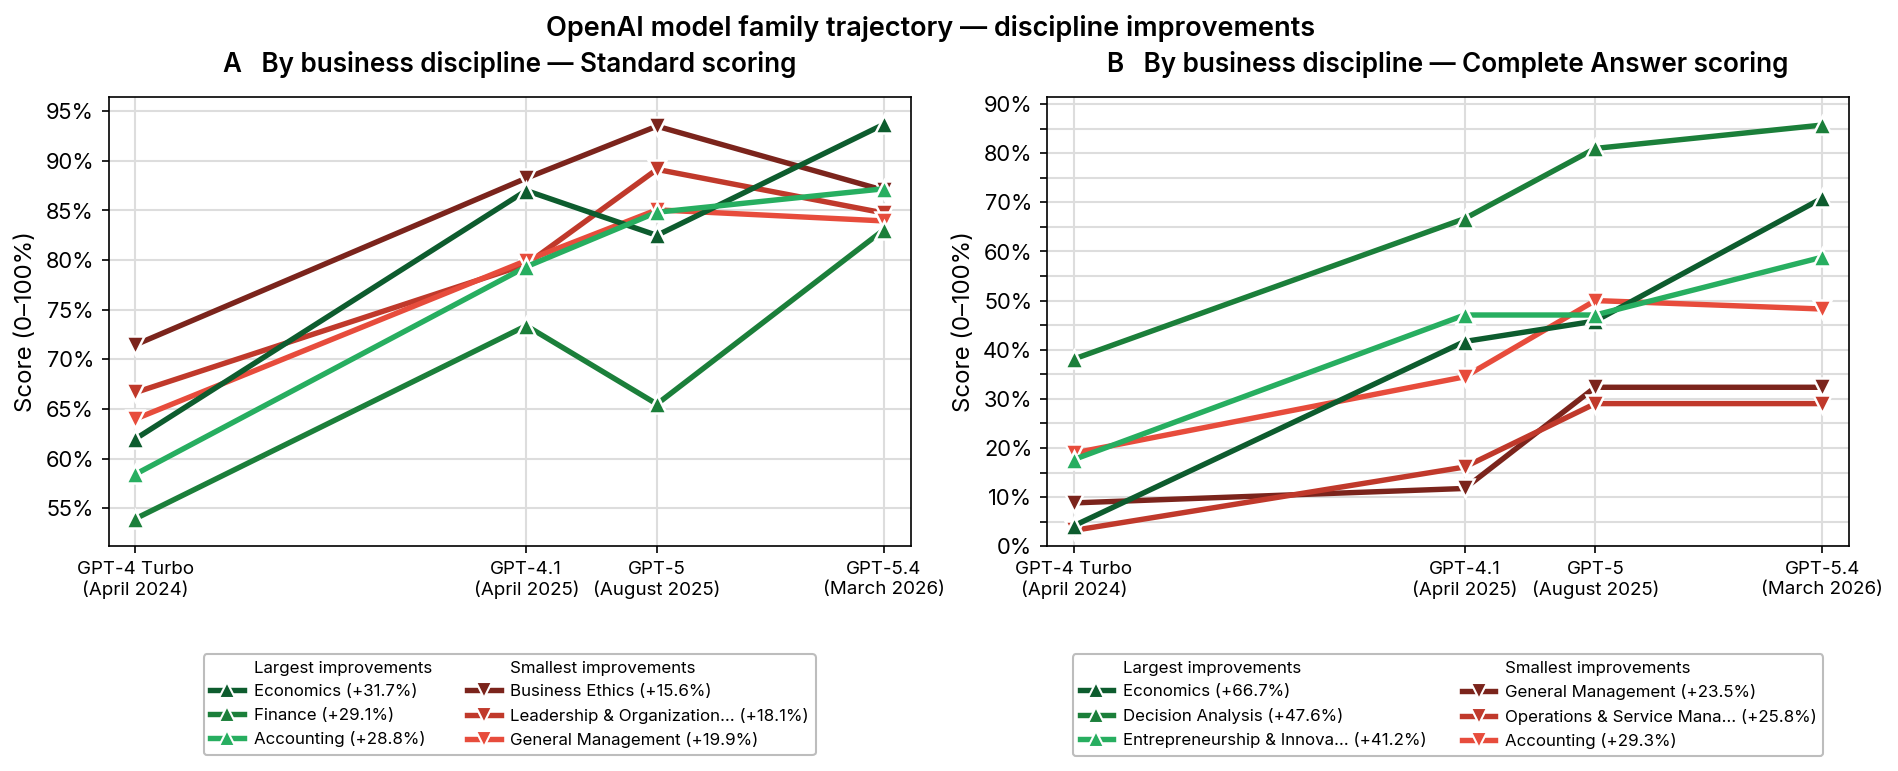
Траектории семейства моделей OpenAI на уровне дисциплин (двенадцать дисциплин с вопросами). А) Стандартная оценка по моделям; линии выделяют три наибольших и три наименьших прироста на уровне дисциплин от GPT-4 Turbo до GPT-5.4. B) Оценки по методу Complete Answer по моделям для тех же дисциплин. Каждая отслеживаемая дисциплина показывает улучшение по обоим метрикам, однако величины прироста и конечные уровни различаются..
D4 Оценка по стратам типов вопросов
Мы представляем средние показатели производительности передовых моделей (при оценке по стандартным и полным ответам) по различным стратам типов вопросов, включая вопросы, основанные на вымышленных и реальных кейсах, численные и нечисленные вопросы, а также субъективные и объективные вопросы..
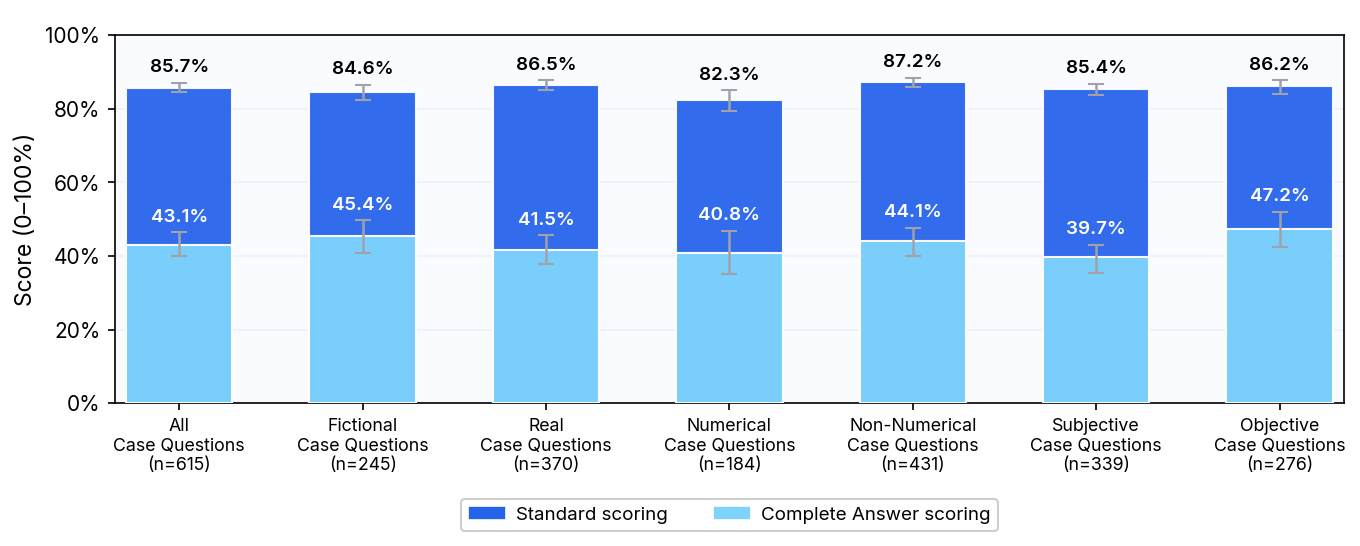
Производительность по типам кейсов и типам вопросов при стандартной оценке и оценке по полному ответу. Группированные столбцы показывают средние баллы с 95% доверительными интервалами методом бутстрепа для вымышленных и реальных кейсов, числовых и нечисловых вопросов, а также субъективных и объективных вопросов, при этом каждый вопрос усреднен по GPT-5.4, Claude Sonnet 4.6 и Gemini 3 Flash Preview. При стандартной оценке все шесть страт попадают в узкий диапазон; баллы при оценке по полному ответу несколько увеличивают эти разрывы, но они остаются небольшими по сравнению с межпредметной вариативностью, задокументированной на рис. 2⟧.
D5 Разница в производительности между вымышленными и реальными сценариями по дисциплинам
На рисунке для каждой дисциплины, по которой имеется достаточное количество вопросов в обеих группах, отображена разница между средним пороговым баллом по вымышленным кейсам и средним баллом по реальным кейсам, что выделяет дисциплину «Финансы» как значимый выброс, о чем говорится в основном тексте..
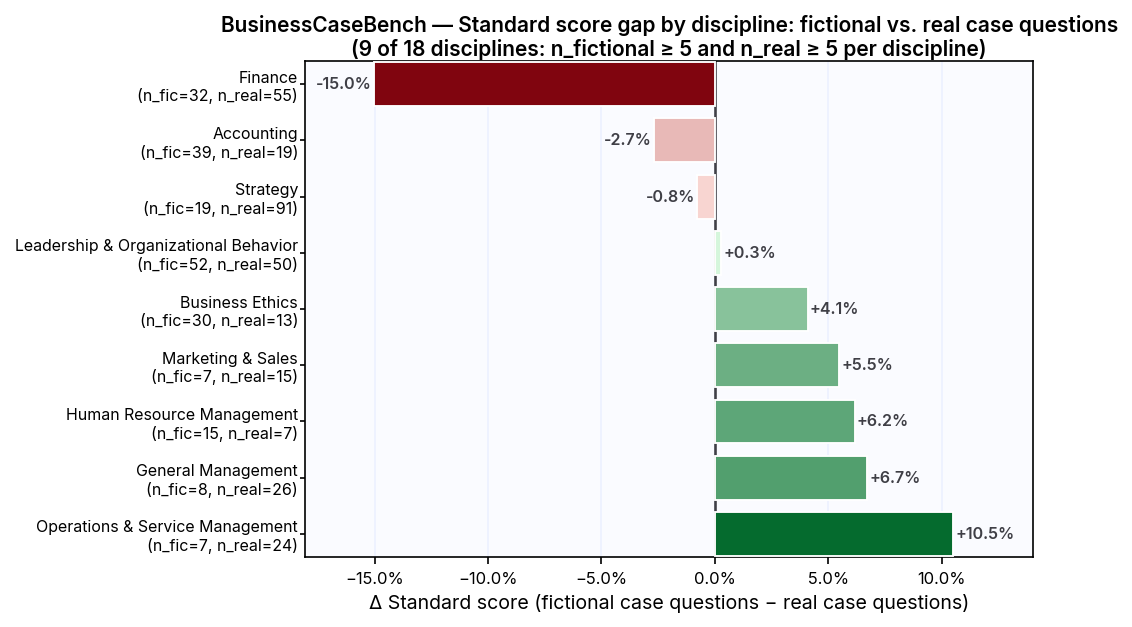
Разрыв внутри дисциплины между вымышленными и реальными вопросами кейсов при стандартной оценке. Для каждой дисциплины с достаточным количеством вопросов в обеих группах ( и ) столбцы показывают средний стандартный балл по вопросам вымышленных кейсов минус средний стандартный балл по вопросам реальных кейсов, усредненный по GPT-5.4, Claude Sonnet 4.6 и Gemini 3 Flash Preview. Положительные значения указывают на более высокие баллы по вымышленным кейсам; финансы являются выраженным отрицательным выбросом (баллы по вымышленным кейсам значительно ниже реальных), в то время как большинство других дисциплин демонстрируют небольшое преимущество вымышленных кейсов или почти полное равенство..
D6 Вариативность оценок в зависимости от типа вопроса, дисциплины и кейса
В дополнение к описательным стратам и сравнениям дисциплин в основном тексте мы подбираем описательные модели метода наименьших квадратов, прогнозирующие средний пограничный Standard score каждого вопроса (среднее значение для GPT-5.4, Claude Sonnet 4.6 и Gemini 3 Flash Preview). Оценки находятся в диапазоне от 0 до 1, поэтому коэффициенты можно интерпретировать как разницу в процентных пунктах среднего балла. Независимыми переменными являются бинарные индикаторы для численных, субъективных и вымышленных кейсовых вопросов, а также фиксированные эффекты дисциплин, закодированные с использованием контрастов с суммой, равной нулю. При таком кодировании коэффициенты дисциплин представляют собой отклонения от скорректированного среднего эффекта дисциплины. Дисциплины, представленные менее чем пятью вопросами (Социальное предпринимательство, ; Управленческие коммуникации, ), перед подгонкой объединяются в единую категорию «Прочее»: столь разреженные ячейки создают наблюдения с высоким влиянием, чьи робастные стандартные ошибки ненадежны, поэтому объединенный термин «Прочее» включен только в качестве контрольного, а его коэффициент не интерпретируется. Поскольку несколько вопросов из одного и того же кейса могут иметь общую неявную сложность, при выводе используются стандартные ошибки, кластеризованные по кейсам (238 кластеров; ).
В приложении SI, таблица S12 содержит данные о вложенных моделях. Если рассматривать их буквально, то одни лишь теги типов вопросов объясняют 3,1% вариативности оценок на уровне вопросов, дисциплина объясняет 6,1%, а вместе они объясняют 8,0%. На основе скорректированного теги типов вопросов объясняют 2,6%, дисциплина — 3,6%, а вместе — 5,1%. Каждый из этих факторов дополняет информацию другого. Добавление дисциплины после тегов типов вопросов повышает скорректированный на 0,025 (кластеризованный тест Вальда , ), а добавление тегов типов вопросов после дисциплины повышает его на 0,015 (, ). Дисциплина сохраняет небольшое преимущество по скорректированному (3,6% против 2,6%), однако оба набора меток оставляют большую часть различий между сложными и простыми вопросами на долю специфических требований конкретных кейсов и вопросов, которые грубые метаданные не охватывают. В качестве более строгой проверки мы проанализировали, насколько хорошо каждый набор меток предсказывает оценки, на которых он не был обучен, используя кросс-валидацию (-кратная, повторений). Когда целые кейсы исключаются из выборки, так что модель должна предсказывать оценки для кейсов, которые она никогда не видела, теги типов вопросов предсказывают немного лучше, чем дисциплина (среднее значение вне выборки около против , где отрицательное значение означает, что предсказания не лучше, чем угадывание общего среднего балла). Дисциплина по сути является свойством кейса, распределенным по множеству мелких категорий, поэтому то, что она объясняет в рамках данной выборки, не переносится на новые кейсы. Таким образом, мы интерпретируем дисциплину и тип вопроса как факторы, каждый из которых имеет обнаружимую, но слабую связь со сложностью, а не как доказательство того, что дисциплина является более сильным предиктором в целом..
| Model / comparison | Adj. | Adj. | (df) | ||
|---|---|---|---|---|---|
| Question-type tags only | 0.031 | 0.026 | — | — | — |
| Discipline only | 0.061 | 0.036 | — | — | — |
| Question type + discipline | 0.080 | 0.051 | — | — | — |
| Discipline beyond question type | — | — | 0.025 | 3.11 (16, 237) | |
| Question type beyond discipline | — | — | 0.015 | 4.16 (3, 237) | 0.007 |
В приложении SI, таблица S13 содержит коэффициенты совместной модели. В этой спецификации числовые вопросы оцениваются ниже, чем нечисловые, в то время как субъективная против объективной и вымышленная против реальной формулировки не отличаются от нуля, как только включены другие предикторы. Относительно общего среднего показателя по дисциплине, «Бизнес и государственные отношения» и «Стратегия» имеют более высокие баллы, а «Управление операциями и услугами» — более низкие при ; «Анализ решений» незначительно выше (), тогда как «Финансы» не отличаются от нуля (). Эти описательные декомпозиции показывают, что грубые метаданные оставляют большую часть вариативности оценок на уровне вопросов необъясненной. Анализ на уровне кейсов ниже задает вопрос о том, какая часть этого остатка является общей внутри кейсов.
| Term | Coef | SE | ||
|---|---|---|---|---|
| Intercept | 0.904 | 0.013 | 70.85 | |
| Numerical (vs non-numerical) | 0.019 | 0.002 | ||
| Subjective (vs objective) | 0.017 | 0.058 | ||
| Fictional case (vs real) | 0.019 | 0.606 | ||
| Discipline (vs overall mean) | ||||
| Business & Government Relations () | 0.066 | 0.018 | 3.76 | |
| Operations & Service Management () | 0.030 | 0.028 | ||
| Strategy () | 0.026 | 0.013 | 1.98 | 0.048 |
| Decision Analysis () | 0.081 | 0.041 | 1.96 | 0.051 |
| Marketing & Sales () | 0.036 | 0.060 | ||
| Finance () | 0.027 | 0.117 | ||
| Information Technology () | 0.024 | 0.019 | 1.25 | 0.214 |
| Leadership & Organizational Behavior () | 0.019 | 0.241 | ||
| Negotiation () | 0.051 | 0.374 | ||
| General Management () | 0.028 | 0.385 | ||
| Economics () | 0.024 | 0.032 | 0.74 | 0.458 |
| Entrepreneurship & Innovation () | 0.024 | 0.036 | 0.68 | 0.499 |
| International Business () | 0.032 | 0.048 | 0.68 | 0.499 |
| Business Ethics () | 0.012 | 0.022 | 0.56 | 0.574 |
| Accounting () | 0.029 | 0.592 | ||
| Human Resource Management () | 0.035 | 0.599 | ||
| Other (; pooled) | 0.011 | 0.025 | 0.45 | 0.652 |
Чтобы проверить, связана ли сложность, не объясненная общими метаданными, с лежащим в основе кейсом, мы сравниваем, насколько сильно варьируются баллы между исходными кейсами и между вопросами внутри одного и того же кейса. Вопросы, взятые из одного кейса, имеют умеренно коррелирующую сложность (внутриклассовая корреляция ), а средние баллы различаются между кейсами сильнее, чем это могло бы произойти случайно (, ). Знание того, из какого кейса взят вопрос, также предсказывает его балл гораздо лучше, чем общие метки метаданных (скорректированный против для тегов типа вопроса и дисциплины в совокупности, Приложение SI, Таблица S14). Учет принадлежности к кейсу в дополнение к модели метаданных повышает скорректированный с до , а эффекты кейса остаются совместно значимыми после блока метаданных (, ), поэтому сигнал на уровне кейса — это не просто переформулированные метки метаданных. Тем не менее, почти половина вариации баллов приходится на вопросы внутри одного и того же кейса, а теги типа вопроса объясняют лишь около этой оставшейся вариации. Таким образом, сложность отчасти является свойством кейса, что обосновывает использование стандартных ошибок, кластеризованных по кейсам, приведенных выше, но она в значительной степени остается свойством отдельного вопроса..
| Model / comparison | ICC | Adj. | Adj. | (df) | ||
|---|---|---|---|---|---|---|
| Case (ANOVA) | 0.219 | — | — | — | — | — |
| Metadata (question type + discipline) | — | 0.080 | 0.051 | — | — | — |
| Case fixed effects | — | 0.520 | 0.218 | — | 1.72 (237, 377) | |
| Metadata + case fixed effects | — | 0.558 | 0.243 | — | — | — |
| Case beyond metadata | — | — | — | 0.192 | 1.64 (236, 359) |
Поскольку кейсы содержат неравное количество вопросов (60 из 238 кейсов содержат только один вопрос, в то время как остальные — от двух до десяти), мы пересчитываем ICC кейсов и подгонку фиксированных эффектов кейсов после последовательного исключения кейсов, размер которых ниже каждого порогового значения. Ограничение выборки 178 кейсами, содержащими не менее двух вопросов, дает ICC и скорректированный (). Повышение порога до трех, четырех или пяти вопросов на кейс оставляет ICC в узком диапазоне 0,20–0,23, а скорректированный — в диапазоне 0,20–0,22. Таким образом, ассоциация на уровне кейсов не является артефактом одиночных кейсов или неравномерного распределения размеров кластеров..
D7 Взаимодополняемость моделей
В таблице обобщено, насколько возрастает производительность при выборе лучшего результата среди трио передовых моделей для каждого вопроса (потолок оракула), а также как часто все три модели одновременно не справляются с одними и теми же вопросами или критериями оценки для определения «универсальной сложности» ⟦BROKEN_K0⟧”.
| Metric | Count | Share |
|---|---|---|
| Question-level analysis () | ||
| Questions scored by all three models | 615 | 100% |
| Universally hard (max Standard scoring across all frontier models ) | 43 | 7.0% |
| Criterion-level analysis | ||
| Total rubric criterion instances | 8,369 | 100% |
| Never-full-credit criteria (all three frontier models score 0) | 521 | 6.2% |
| Metric | Count | Standard Score |
| Best single model (Claude Sonnet 4.6) | — | 88.4% |
| Oracle ceiling (per-question max, averaged) | — | 92.8% |
| Oracle lift over best single model | — | 4.5 pp |
D8 Результаты расширенной таксономии O*NET
Данные дополнительные анализы расширяют результаты IWA из основного текста (рис. 3) как на профессии O*NET, так и на более детализированную таксономию Detailed Work Activity (DWA).
Подразумеваемое влияние AI на профессии O*NET
Диаграмма профессий (SI Appendix, Fig. SImplied AI impact on O*NET occupations) группирует рабочие места O*NET в зависимости от того, насколько плотно бенчмарк охватывает соответствующие им IWA, и представляет средние пограничные баллы в рамках каждого диапазона охвата, демонстрируя предполагаемое влияние AI на профессии O*NET согласно данному бенчмарку.
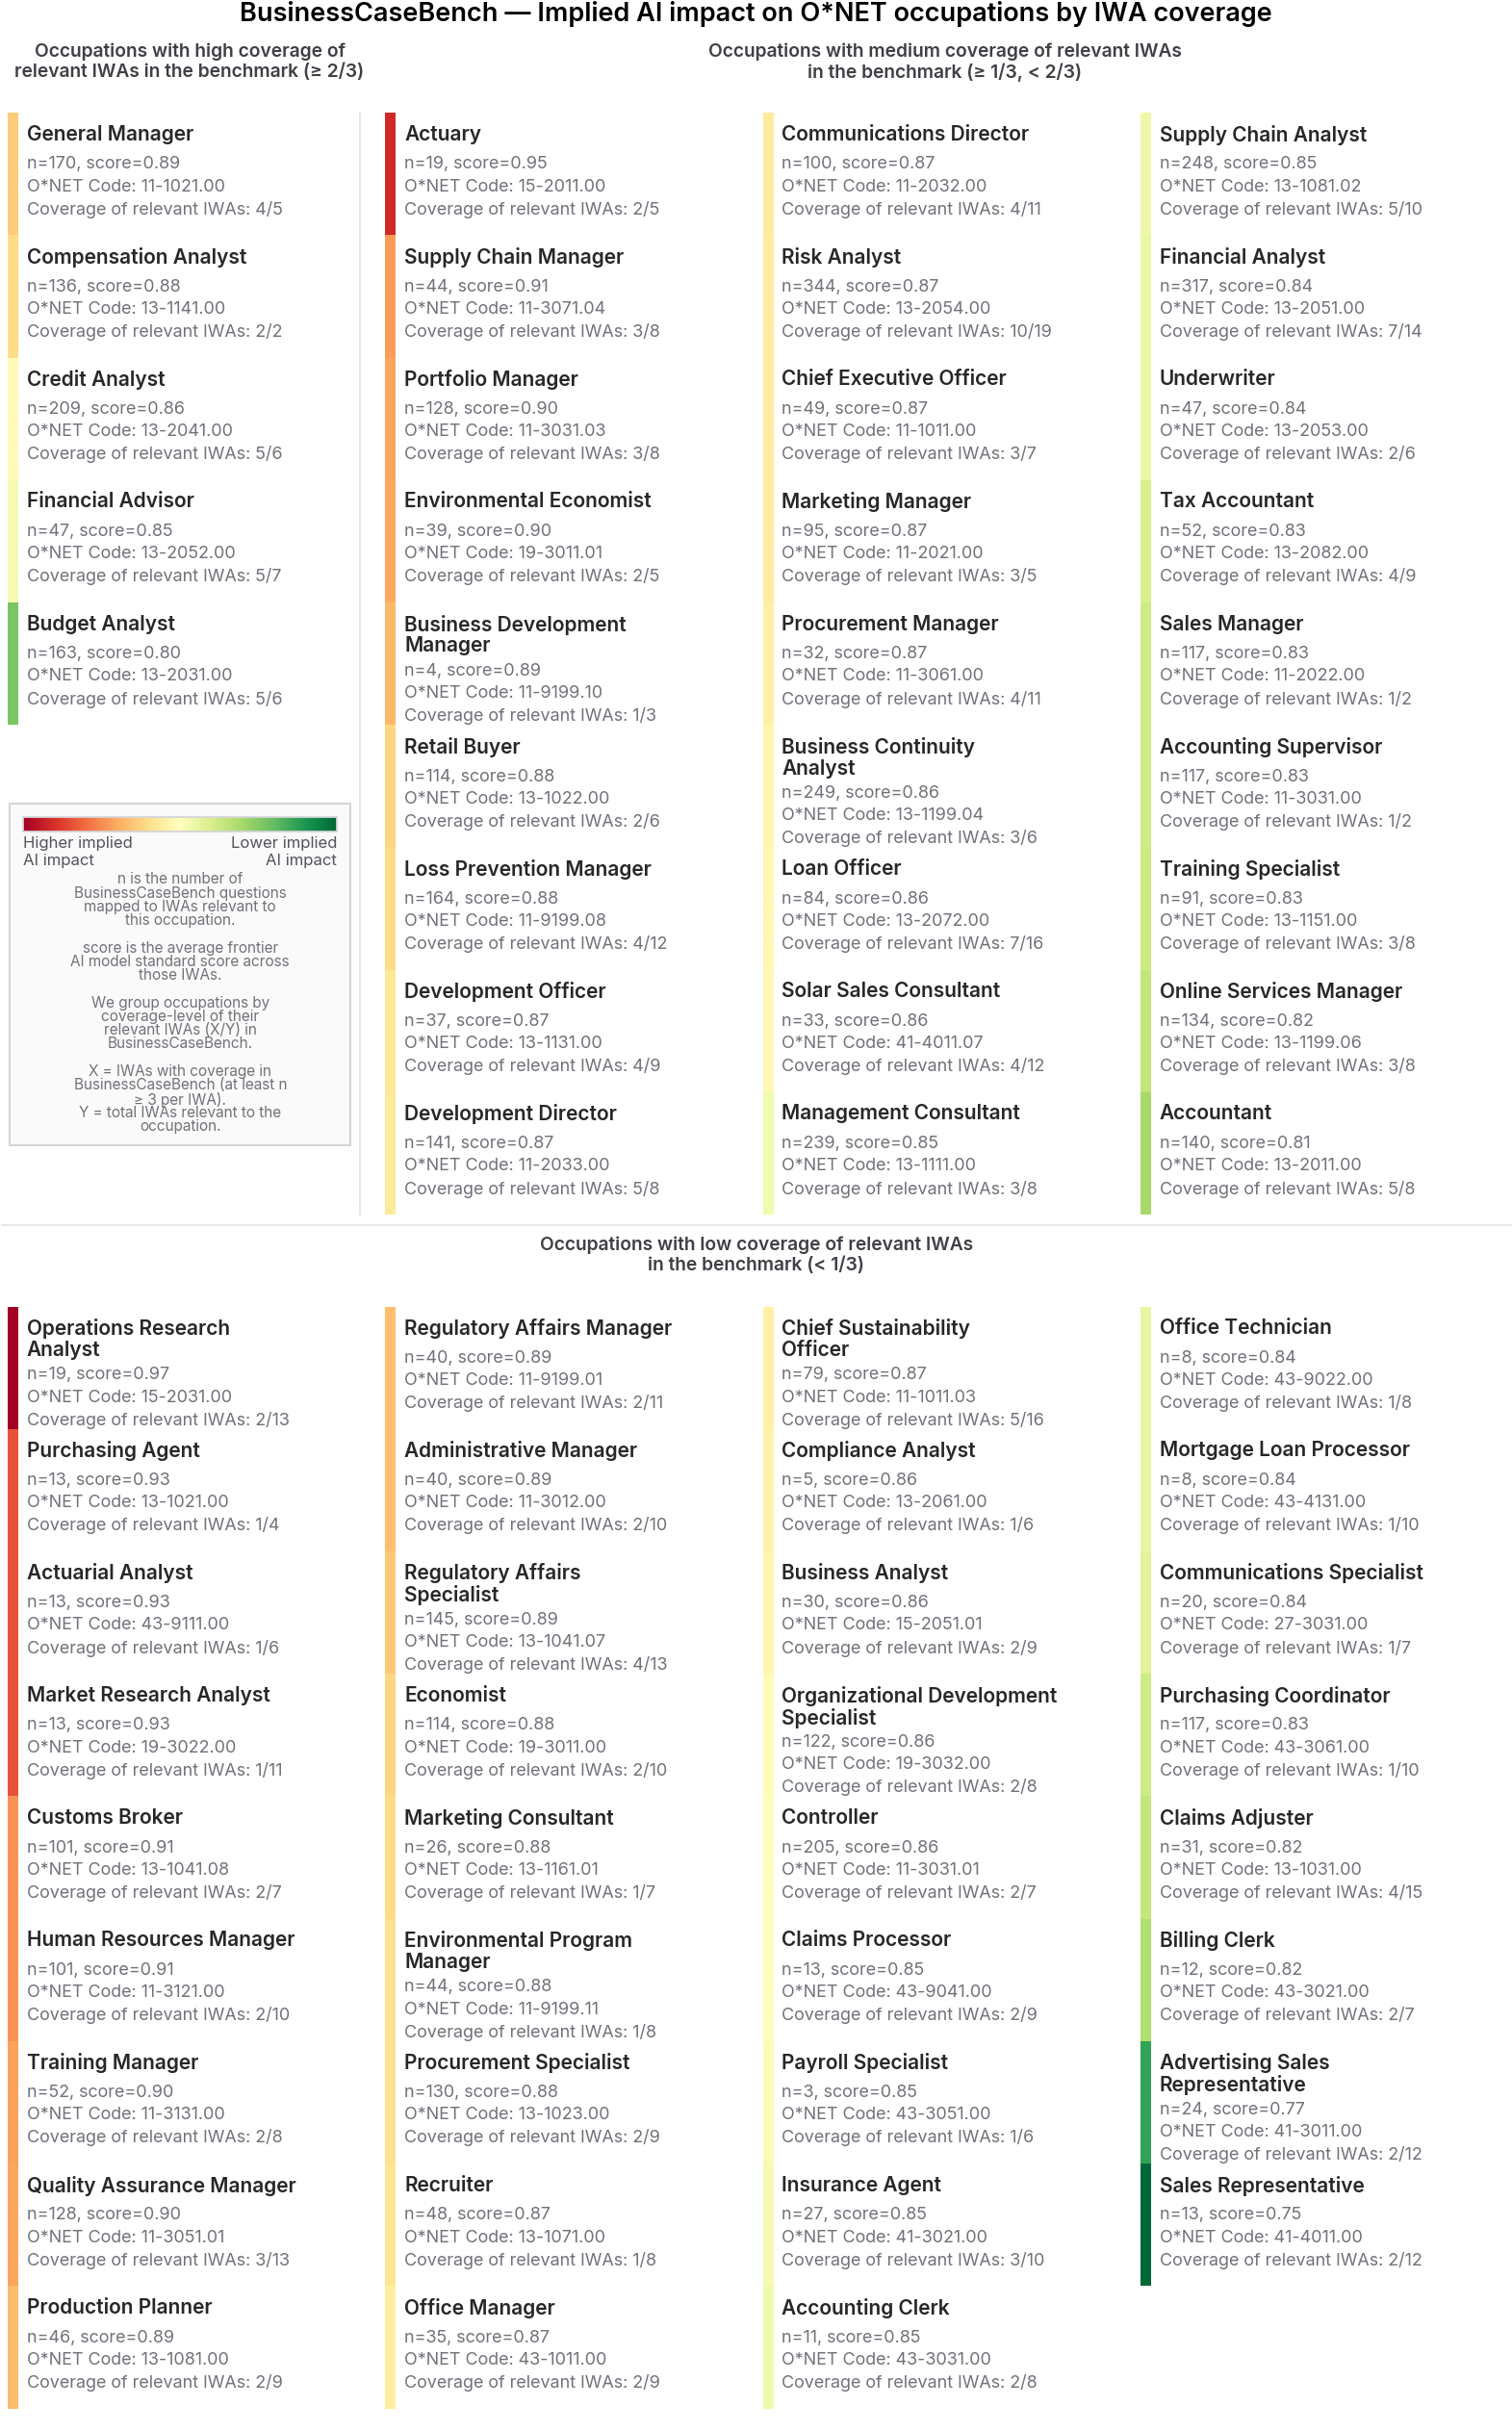
Производительность Frontier AI для профессий из базы O*NET, представленных в бенчмарке, сгруппированных по широте охвата соответствующих промежуточных рабочих действий (IWA). Профессии разделены на группы с высоким, средним и низким уровнем охвата в зависимости от того, сколько IWA, относящихся к профессии, достаточно представлены в бенчмарке (); внутри каждой группы цветные полосы кодируют средний балл при стандартной оценке (Standard scoring), усредненный по GPT-5.4, Claude Sonnet 4.6 и Gemini 3 Flash Preview по вопросам бенчмарка, связанным с соответствующими IWA для данной профессии, с указанием общего количества учитываемых вопросов. Профессии отсортированы по предполагаемому влиянию AI внутри каждой группы охвата. На рисунке обобщено, какие профессии бенчмарк охватывает наиболее плотно и где концентрируется предполагаемое влияние AI на уровне должностей..
Подразумеваемое влияние ИИ на основе детальных рабочих операций
Тепловая карта DWA (Приложение SI, рис. SImplied AI impact by detailed work activity) расширяет представленный в основном тексте обзор IWA до наиболее детализированного уровня рабочих операций O*NET.
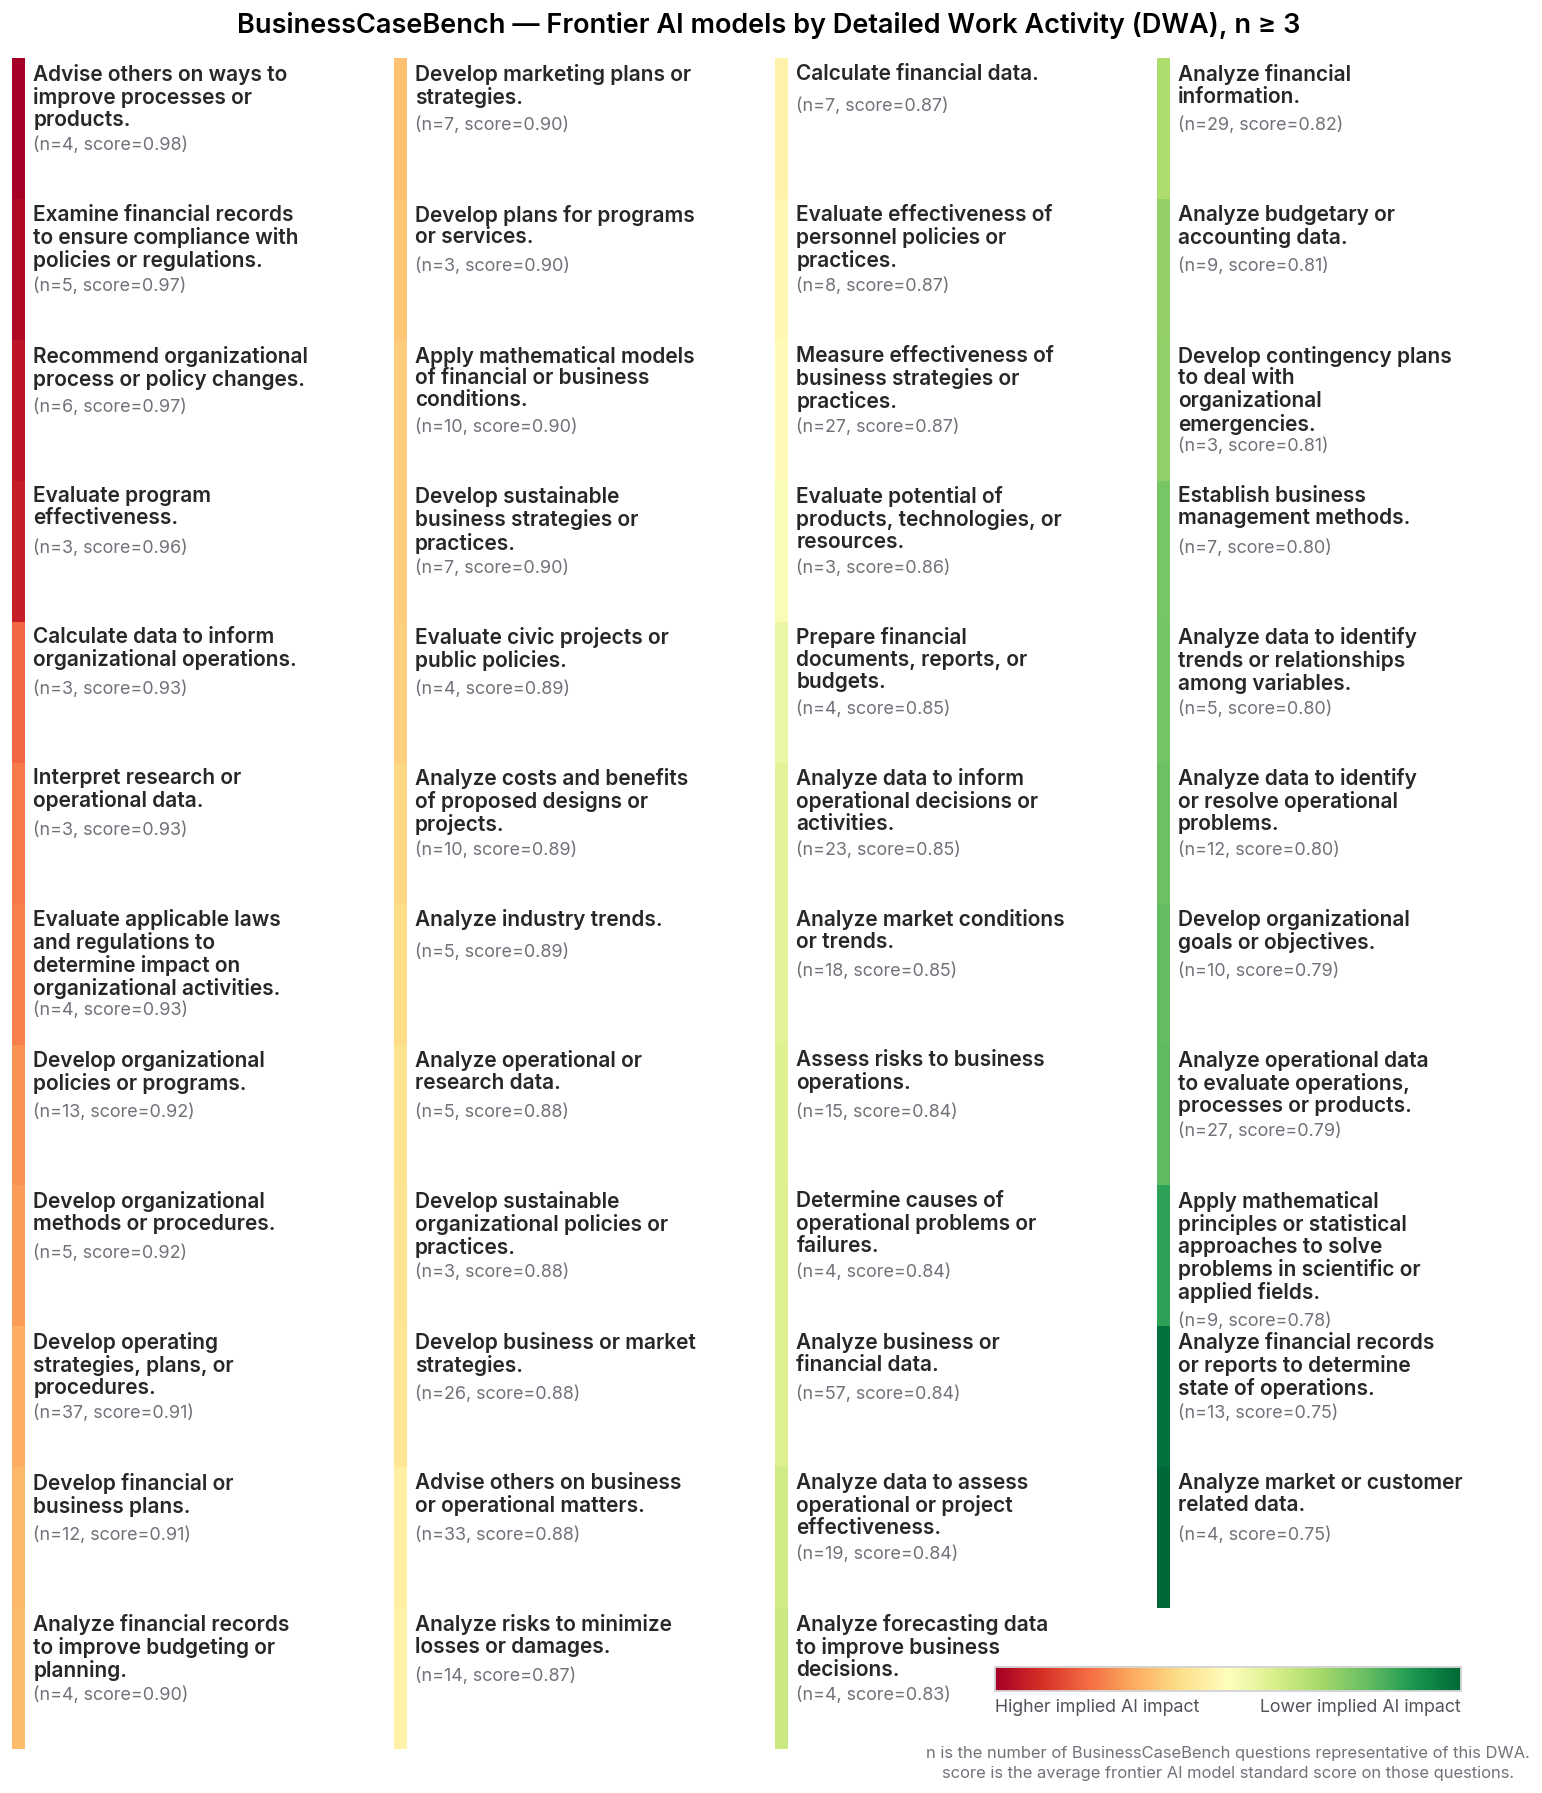
Производительность Frontier AI по детализированным рабочим активностям (DWA) O*NET. Каждая ячейка представляет собой DWA, содержащую как минимум три вопроса для бенчмаркинга (); цвет кодирует средний балл при стандартной оценке, усредненный по GPT-5.4, Claude Sonnet 4.6 и Gemini 3 Flash Preview для этих вопросов, с аннотациями и баллами. DWA отсортированы по предполагаемому влиянию ИИ. Более детальная таксономия DWA выявляет дополнительную гранулярность, показывая, какие конкретные профессиональные подзадачи сопротивляются полному соответствию критериям оценки относительно совокупных паттернов на уровне IWA..
E Валидность, ограничения и воспроизводимость
E1 Доказательства загрязнения данных
Мы проводим аудит дословного присутствия материалов оценки с использованием InfiniGram (Liu2024InfiniGram), который поддерживает эффективный поиск подстрок по крупным, широко используемым корпусам данных, полученным путем веб-краулинга (C4 (raffel2020exploring), The Pile (pile), RedPajama (together2023redpajama), Dolma (soldaini-etal-2024-dolma) и DCLM (li2025datacomplmsearchgenerationtraining)). Для каждого кейса и его решения от преподавателя мы извлекаем три случайные подстроки длиной 5–10 токенов и проверяем, встречаются ли они в этих индексах. Мы не обнаружили совпадений для кейсов, используемых в конвейере оценки, поэтому индексированные корпуса не предоставляют доказательств дословной контаминации в рамках данной проверки на контаминацию при предварительном обучении..
E2 Область охвата
Бенчмарк является одноходовым, и каждый пример предоставляет полный контекст кейса в одном промпте без уточнения или итеративного сбора доказательств (в отличие от интерактивной диагностики или бенчмарков агентной работы). Это сделано намеренно, так как именно так кейсы обычно и используются, что помогает изолировать улучшение в интеллектуальной работе и аналитическом мышлении, не смешивая это с возможностями использования инструментов или навыками ведения диалога. Он представлен только на английском языке и основан на традиции кейс-метода бизнес-школ (длинные повествовательные кейсы с эталонными стандартами, разработанными преподавателями), поэтому он измеряет аналитический и консультативный синтез в рамках этого конкретного педагогического формата. Результаты следует интерпретировать как возможности в рамках данного контролируемого протокола для оценки бизнес-знаний и логического мышления..
E3 Опубликованные и скрытые артефакты, а также путь доступа
Выпущено.
Код инструмента оценки, закрепленные идентификаторы моделей, гиперпараметры и промпты (включая те, что приведены в Приложении SI, раздел 6), структура метаданных и критериев бенчмарка, а также агрегированные выходные данные и оценки моделей.
Удержано.
Полные версии кейсов и решения для преподавателей в формате PDF и текстовых файлах, распространение которых в открытом доступе запрещено лицензиями издателей и клиринговых центров.
Путь доступа.
Квалифицированные исследователи могут реконструировать набор для оценки, получая кейсы через стандартные центры распространения кейсов бизнес-школ и каналы доступа для преподавателей, а затем повторяя процедуру на локально хранящихся материалах. Лицензионные ограничения снижают возможность открытого повторного использования, но также ограничивают дословное включение проприетарных кейсов в корпуса для предварительного обучения — это то же самое ограничение, которое позволяет таким кейсам быть валидной мерой прогресса в интеллектуальной работе с низким риском загрязнения данных..