[1]\fnmКшитидж \surМадхав Джадхав
1]\orgnameTCS Research, \orgaddress\cityПуна, \postcode411057, \stateМахараштра, \countryИндия
2]Работа выполнена во время деятельности в TCS Research
Помощь в проведении финансового аудита с использованием обнаружения дезинформации и объяснимости
Аннотация
Финансовая отчетность, такая как бухгалтерский баланс, отчет о прибылях и убытках и отчет о движении денежных средств, обобщает годовые финансовые показатели компании. Финансовая отчетность широко используется для оценки корпоративного управления, кредитной оценки, анализа рисков, проверки налогообложения, принятия инвестиционных решений и т. д. Финансовый аудит — это сложная и наукоемкая дисциплина, одной из важных целей которой является обеспечение целостности, точности, справедливости и отсутствия существенных искажений в опубликованной финансовой отчетности. Учитывая важность финансовой отчетности, существуют стимулы скрывать, опускать или фальсифицировать информацию, чтобы исказить истинное финансовое состояние компании; например, для снижения налоговых обязательств или повышения доверия инвесторов. Учитывая сложный, трудоемкий и зависящий от экспертных знаний характер аудита, аудиторам была бы полезна система с поддержкой AI, которая автоматически обнаруживает случаи дезинформации в предоставленной финансовой отчетности и определяет вероятные источники этой дезинформации в финансовых данных. В данной статье мы представляем методы обучения без учителя для выявления дезинформации в финансовой отчетности, а также генерируем объяснения относительно того, какие финансовые переменные являются вероятными источниками дезинформации. Затем аудитор может более детально изучить связанные источники данных и бизнес-процессы, чтобы подтвердить эти предположения. Важной особенностью нашего подхода является использование накопленного корпуса финансовой отчетности и связанных с ней аудиторских отчетов для получения аналитических данных, которые помогают в предоставлении поддержки. Мы демонстрируем эффективность этих методов на большом корпусе из 11 460 финансовых отчетов за 5 лет и связанных с ними аудиторских отчетов. Данная статья объединяет и добавляет новые вклады по сравнению с ранее опубликованными исследованиями (Shinde et al., 2022)[SVAP22], (Vaishampayan et al., 2022)[VSPP22], (Pawar et al., 2023)[PAPV23], которые мы использовали в качестве основы для нашей системы помощи аудитору с поддержкой AI..
ключевые слова: финансовый аудит, обнаружение дезинформации, объяснимый искусственный интеллект, обнаружение аномалий, финансовая отчетность, обучение без учителя, помощь в аудите ⟦K0⟧:
Финансовый аудит, финансовая отчетность, обнаружение дезинформации, объяснимость, обнаружение аномалий, классификация текста, LLM1 Введение
Финансовый аудит — это сложная и наукоемкая дисциплина в бухгалтерском учете, важными целями которой являются обеспечение достоверности публикуемой финансовой информации, укрепление доверия к бизнес-процессам и практикам, а также обеспечение качества управления в организации [AEB16]. Финансовый аудит (или просто аудит) состоит из множества взаимосвязанных задач, таких как: проверка внутреннего контроля, обеспечение сохранности активов, оценка текущих и будущих рисков, предоставление предложений по улучшению управления, обеспечение соблюдения установленных процессов, обеспечение соответствия стандартам, руководящим принципам, законам и нормативным актам, а также обеспечение того, чтобы представленная финансовая информация была объективной и точной. Заинтересованные стороны используют аудированную финансовую отчетность (FS), такую как бухгалтерский баланс (BS), отчет о прибылях и убытках, отчет о движении денежных средств и т. д., для принятия решений. Примеры: регулирующие органы используют FS для проверки соблюдения нормативных требований, налоговые службы используют FS для подтверждения уплаченных налогов и заявленных льгот, инвесторы используют FS для оценки финансового состояния компании и принятия инвестиционных решений..
Финансовый аудитор несет ответственность за проведение финансового аудита организации. В данной статье мы фокусируемся на важном результате аудита, а именно: проверке и подтверждении того, что финансовые данные, указанные в FS компании, являются достоверными, точными и не содержат дезинформации. При подготовке FS бухгалтеры придерживаются Общепринятых принципов бухгалтерского учета (GAAP)111https://asc.fasb.org/ и Международных стандартов финансовой отчетности (IFRS)222https://www.ifrs.org/. Во многих практических областях, таких как корпоративное управление, кредитная оценка, анализ рисков, налогообложение, аудит и инвестиционные решения, содержание финансовой отчетности (которая, как правило, является общедоступной для публичных компаний) тщательно анализируется с различных точек зрения [FL07], [DF12]. Таким образом, проверка качества информации в FS является важной задачей при аудите. Эта проверка обычно выполняется аудитором путем сбора доказательств из (а) цепочек бизнес-процессов, принятых в компании (например, платежные квитанции, выписки по транзакциям, договорные документы, письма в банки, органы власти, клиентам и поставщикам и от них и т. д.); а также из (б) физических проверок (например, складских помещений). Если данные в FS согласуются с собранными доказательствами, аудитор заявляет в аудиторском заключении, что FS являются достоверными и точными, а также представлены в соответствии с соответствующими стандартами бухгалтерского учета. В противном случае аудитор делает критические замечания относительно выявленных или потенциальных случаев несоответствия, дезинформации, нарушений, противоречий, ошибок, неточностей, мошенничества, упущений, несоблюдения требований и т. д. Критические замечания часто также включают рекомендации аудиторов по улучшению. Очевидно, что знания и опыт аудитора играют жизненно важную роль в эффективном и результативном проведении аудита..
Учитывая значимость финансовой отчетности, компании часто имеют веские стимулы скрывать, опускать или манипулировать информацией, чтобы исказить свое истинное финансовое положение — например, для минимизации налоговых обязательств или повышения доверия инвесторов. [BCH99]. Распространенные формы дезинформации в финансовой отчетности включают завышение активов, доходов или прибыли фирмы, а также занижение ее обязательств, расходов или убытков333https://www.acfe.com. Широко признано, что многочисленные крупные корпоративные мошенничества имеют свои корни в бухгалтерских искажениях; например, Enron в 2001 году в США [HP03], WorldCom в 2003 году в США444https://www.scu.edu/ethicsI-areas/businessethics/ resources/worldcom/ и Satyam Computers в 2009 году в Индии [Bhas13]. Дезинформация в финансовой отчетности может привести к значительным денежным потерям для клиентов, сотрудников и кредиторов, а также нанести ущерб репутации, доверию и деловой активности компании в случае обнаружения. Аудиторы и судебно-бухгалтерские эксперты применяют различные следственные методы для проверки источников цифр, отраженных в финансовой отчетности, и тем самым выявляют потенциальную дезинформацию [Nigr20]. Эти методы по большей части являются ручными и в значительной степени опираются на глубокие предметные знания профессионалов. Из-за трудоемкого и субъективного характера таких расследований было разработано множество аналитических методов для выявления финансовой отчетности, которая с высокой вероятностью содержит дезинформацию
Учитывая эти проблемы, в данной статье мы рассматриваем разработку методов для оказания помощи аудиторам. В частности, мы рассматриваем сценарий, в котором аудитор проводит финансовый аудит конкретной компании за определенный финансовый год и имеет доступ к соответствующим FS. Мы предлагаем следующий подход к оказанию помощи аудитору: использовать большую внешнюю базу данных (базы данных) полуструктурированных FS различных компаний, а также соответствующий корпус текстовых аудиторских отчетов; извлекать выводы из этих входных данных; затем использовать эти входные данные для оказания помощи аудитору при выполнении следующих задач:
- ⟦1. Обнаружение дезинформации: классифицируйте предоставленную финансовую отчетность на предмет вероятного наличия финансовой дезинформации и подтвердите результаты, используя уточненные метки (описанные ниже).
- ⟦2. Объяснение дезинформации: Если ответ утвердительный, то мы разрабатываем методы для формирования понятного человеку объяснения характера вероятной финансовой дезинформации в финансовой отчетности.
- ⟦3. Генерация аудиторских гипотез: формирование предложений (гипотез) для аудиторов с целью более детального изучения.
В рамках предварительной обработки мы также генерируем серебряные метки для каждой FS во входной базе данных. Поскольку достоверные метки для FS — содержат ли они какие-либо примеры дезинформации или нет — обычно недоступны, мы разрабатываем методы использования соответствующего аудиторского отчета для автоматического присвоения серебряной метки FS. На рисунке 1 показан концептуальный поток вспомогательных средств в нашей системе.
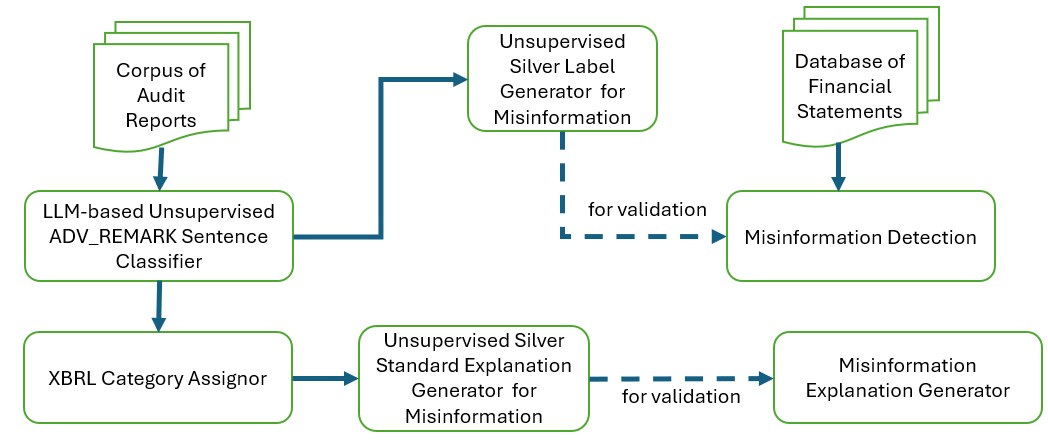
В данной статье по существу объединены отдельные части ранее опубликованных исследований [SVAP22], [PAPV23], [VSPP22], которые мы использовали в качестве основы для нашей системы помощи аудитору с поддержкой AI. Помимо концептуального объединения предыдущих методов помощи аудиторам, в данной статье также представлены следующие новые разработки:.
- ⟦1. Использованные нами данные финансовой отчетности значительно превышают объемы, применявшиеся в предыдущих работах. Мы используем данные финансовой отчетности и аудиторские заключения 2292 компаний за пять лет (всего 11 460 отчетов), в отличие от более ранних исследований, где использовались данные только за один год. В предыдущих работах также применялись только бухгалтерские балансы, тогда как мы объединяем несколько видов финансовой отчетности: бухгалтерский баланс, отчет о прибылях и убытках (IS) и отчет о движении денежных средств (CS).
- ⟦2. В данной статье мы расширяем количество финансовых переменных в нашем наборе данных по сравнению с теми, что использовались ранее, включая дополнительные финансовые переменные из отчета о прибылях и убытках и отчета о движении денежных средств. Это повышает эффективность методов обнаружения дезинформации в финансовой отчетности..
- ⟦3. Мы предлагаем две различные стратегии использования аудиторских отчетов и генеративных языковых моделей для создания данных с серебряной разметкой с целью обнаружения дезинформации в финансовой отчетности. Этот подход является масштабируемым и может быть использован для автоматической разметки всей финансовой отчетности в нашем наборе данных. В наборах данных в более ранних работах для валидации использовалось небольшое подмножество финансовой отчетности с ручной разметкой..
- ⟦4. Мы используем модель кодировщика-декодировщика на базе T5[raffel2020exploring] с генеративными возможностями для классификации предложений в аудиторских отчетах. Эта модель предоставляет метку классификации и объяснение для классификации. Это улучшенная модель по сравнению с моделью Attn-BERT, использовавшейся в более ранних исследованиях [PAPV23].
- ⟦5. В отличие от предыдущих работ (в которых использовались объяснения, созданные вручную), мы предлагаем метод обучения без учителя для автоматической генерации «серебряного стандарта» объяснений для финансовой отчетности, идентифицированной как аномальная, то есть вероятно содержащая недостоверную информацию. При выполнении этой задачи мы используем международный стандарт финансовой лексики (называемый XBRL). Идея заключается в выявлении негативных замечаний в аудиторском отчете, присвоении каждому из них категорий XBRL и сопоставлении этих категорий с используемыми нами финансовыми переменными, что и составляет объяснение «серебряного стандарта»..
- ⟦6. По сути, наша интегрированная система устраняет ручной труд, связанный с различными этапами формирования помощи, делая систему эффективной, масштабируемой и более объективной.
Краткий обзор мотивации для предоставления помощи аудиторам на основе ИИ выглядит следующим образом. Учитывая критическую важность аудита и значительные требования к знаниям, опыту и усилиям аудиторских групп, крайне важно минимизировать зависимость от ручных процессов и человеческого опыта в ходе аудиторских проверок. Подобная помощь может повысить как результативность, так и эффективность аудита за счет сокращения времени, затрат и усилий. Низкое качество аудита — будь то преднамеренное или случайное — может привести к тяжелым последствиям, включая мошенничество, потерю доходов, подрыв деловой репутации, судебные споры, неспособность продолжать деятельность и даже банкротство; см., например, [LL19]. Существует множество причин, по которым аудит может быть низкого качества: недостаток опыта у аудиторской группы [RW10], нарушение независимости аудитора [TL15], предвзятость аудиторов, консерватизм (признание плохих новостей вместо хороших) [Bas97] и нежелание аудиторов идти на риск, отсутствие сотрудничества со стороны руководства, недостаточное время/усилия, затраченные на аудит, и т. д. Закон Сарбейнса-Оксли 2002 года был специально принят для укрепления аудиторской практики и улучшения раскрытия публичной информации после серии затяжных скандалов, вызванных провалами в аудите, такими как Enron [beasley1999fraudulent] и Satyam [Bhas13]. Комплексный и высококачественный аудиторский отчет служит ключевым показателем эффективного аудита. Контролирующие органы, такие как Институт присяжных бухгалтеров (CA) Индии, выпустили руководящие принципы, определяющие основные компоненты аудиторских отчетов, в которых изложены аспекты, которые аудиторы должны рассматривать и описывать. Как мы показываем в этой статье, ИИ может извлекать полезные выводы из прошлых аудитов и использовать их для оказания эффективной помощи в улучшении различных аудиторских задач при проведении нового аудита, тем самым повышая качество нового аудита..
Структура данной статьи представлена следующим образом. В разделе 2 мы рассматриваем некоторые связанные работы. Раздел 3 содержит описание различных наборов данных, используемых в этой статье. В этом же разделе мы разрабатываем метод использования предварительно обученных LLM для бинарной классификации предложений из аудиторских отчетов на содержащие негативные замечания и не содержащие их (например, [PAPV23]). Также в этом разделе описан простой метод генерации серебряных меток для каждой FS (содержит она дезинформацию или нет). Использование методов регрессии без учителя и методов обнаружения аномалий для выявления дезинформации в структурированных данных FS описано в разделе 4. В разделе 5 предлагаются методы автоматической генерации понятных человеку объяснений для каждой FS, в которой, согласно прогнозам, вероятно содержатся случаи дезинформации. Это объяснение принимает форму набора финансовых переменных, ответственных за то, что компании были отмечены как аномальные в наших прогностических методах обнаружения дезинформации. Раздел 5.7 описывает методы, которые можно использовать для генерации предложений в помощь аудитору. Наконец, мы завершаем наше обсуждение в разделе 6 и добавляем задачи, которые предстоит выполнить в будущем..
2 Связанные работы
Контролируемое обнаружение дезинформации в финансовой отчетности: Каждая финансовая отчетность обычно представляется в виде вектора общепринятых финансовых коэффициентов. Помимо финансовой отчетности, многие компании также публикуют аудиторское заключение, в котором освещаются любые проблемы или несоответствия, выявленные в ходе аудита. Финансовая отчетность, отмеченная в таких отчетах, называется квалифицированной. Финансовая отчетность помечается как положительный случай дезинформации, если она является квалифицированной, и как отрицательный случай, если она является неквалифицированной, для создания размеченного набора данных финансовой отчетности. [Spa02] обучили классификатор бинарной логистической регрессии на размеченном наборе данных, состоящем из финансовой отчетности 76 производственных фирм (38 мошеннических и 38 немошеннических), каждая из которых представлена 10 финансовыми коэффициентами. Аналогичным образом, [KKTT06] проанализировали финансовую отчетность 164 фирм за 2001–02 годы (41 мошенническая), используя 23 финансовых коэффициента. Они применили ранговое влияние для выбора 8 ключевых коэффициентов и обучили несколько моделей классификации, достигнув точности до 96,7% с помощью ансамблевого подхода стекинга. [Che16] предложили двухэтапную структуру для обнаружения мошеннической финансовой отчетности: на этапе 1 использовались модели CART и CHAID для определения значимых переменных, в то время как на этапе 2 для обнаружения мошенничества объединялись такие классификаторы, как CART, CHAID, байесовские сети доверия, SVMs и искусственные нейронные сети. Аналогичная методология была принята [Jan18] на примере 160 компаний (40 мошеннических) с Тайваньской фондовой биржи, что позволило достичь точности 90,83% при обнаружении мошеннической отчетности..
Неконтролируемое обнаружение дезинформации в финансовой отчетности: [MM20] применили самоорганизующиеся карты (SOM) к неразмеченному набору данных финансовой отчетности 1560 муниципалитетов Южной Африки, каждый из которых представлен тремя финансовыми коэффициентами. Полученная карта была кластеризована с использованием K-Means, а негативные комментарии аудиторов использовались для маркировки определенных кластеров как мошеннических. Аналогичным образом, [LTV19] использовали метод обнаружения аномалий на основе расстояния Махаланобиса для неразмеченного набора данных из 937 вьетнамских компаний (каждая представлена 24 финансовыми коэффициентами) с целью выявления аномальной финансовой отчетности, потенциально содержащей дезинформацию. Другая форма бухгалтерской ошибки возникает, когда семантически эквивалентные факты, представленные в разных разделах финансовой отчетности, имеют противоречивые числовые значения. Для решения этой проблемы [LYCY20] предложили систему на основе нейронных сетей для определения того, относятся ли две ячейки таблицы к одному и тому же факту. Помимо финансовой отчетности, дезинформация также распространена в других финансовых документах, таких как налоговые отчеты, в основном в целях уклонения от уплаты налогов. Неконтролируемые методы обычно используются для обнаружения подозрительных налоговых отчетов [dPMd18], [MdM15], [GV13], [WOLC12]. В целом, эти методы включают кластеризацию налоговых отчетов, изучение закономерностей, характеризующих каждый кластер (например, правила ассоциации, внутрикластерные распределения вероятностей, специфичные для кластера деревья классификации CHAID), а затем использование этих закономерностей для выявления подозрительных отчетов..
Объяснения аномалий: Базовое объяснение для выброса может быть получено путем идентификации подпространства, в котором точка наиболее сильно отличается от остальных. Эти аспекты выбросов [zhang2004hos] обычно определяются с использованием двух подходов: (i) выбор топ подпространств с наивысшими показателями аномальности (оценка и поиск), или (ii) идентификация небольшого релевантного подпространства, согласованного с целями выбора признаков [samariya2020comprehensive]. [zhang2004hos] представили метрику на основе расстояния, называемую степенью выброса (OD), и структуру динамического поиска подпространств, HOS-miner, для обнаружения подпространств, в которых объект запроса является выбросом. OAMiner [duan2015mining] использует эвристическую стратегию поиска, ранжируя подпространства на основе оценки ядерной плотности объекта запроса. Чтобы решить проблему поиска среди экспоненциально большого количества подпространств, [vinh2016discovering] предложили методы, не зависящие от размерности, такие как Z-оценка плотности и iPath, в сочетании с алгоритмом лучевого поиска. OARank [vinh2015scalable], гибридная структура, объединяет эффективность выбора признаков с универсальностью методов оценки и поиска. На первом этапе признаки ранжируются по их потенциалу делать точку выбросом; на втором этапе оценка и поиск применяются к меньшему подмножеству наиболее значимых признаков, где — общее количество признаков..
Метод локальных выбросов с графовой проекцией (LOGP) [dang2014discriminative] вводит набор целевых функций для обучения локального дискриминантного подпространства для точки с использованием графового преобразования. Оценка выброса вычисляется как статистическое расстояние между точкой и её соседями в преобразованном подпространстве. [angiulli2017outlying] предложили критерий, который оценивает функцию плотности вероятности (pdf) значения атрибута для выброса относительно pdf того же атрибута для других экземпляров — чем ниже вероятность, тем более вероятно, что экземпляр является выбросом. Метод объяснения вклада аномалий (ACE) [zhang2019ace] и его вариант ACE-KL предоставляют вклады на уровне признаков в виде вектора вещественных чисел. ACE аппроксимирует окрестность выброса путем генерации синтетических соседей и подгонки модели линейной регрессии с модифицированной функцией потерь, в то время как ACE-KL добавляет регуляризатор для максимизации KL-дивергенции между равномерным распределением и вычисленным распределением вкладов. [siddiqui2019sequential] представили последовательные объяснения признаков (SFE), которые предъявляют признаки пользователям по одному до тех пор, пока не будет принято уверенное решение об аномалии, что сформулировано как задача оптимизации..
Explainer [kopp2020anomaly] предоставляет объяснения в форме дизъюнкций правил, полученных из деревьев решений в рамках случайного леса для заданной аномальной точки. LOOKOUT [gupta2018beyond], получив набор выбросов и их наборы признаков, генерирует оптимальное количество двумерных графиков фокусировки на основе заданного пользователем бюджета, обеспечивая визуальное выделение аномалий с наивысшими показателями. Чтобы решить проблему NP-трудности генерации оптимальных графиков, авторы предлагают аппроксимационный алгоритм. Однако ни один из вышеперечисленных методов, включая [gupta2018beyond] и [samek2016evaluating], не проводит качественную оценку объяснений при отсутствии эталонных данных. Более того, некоторые подходы зависят от модели, что означает, что на качество сгенерированных объяснений влияет точность базовой модели..
Наш метод, EiForest, использует Isolation Forest (iForest) в качестве структуры данных, извлекая при этом дополнительные новые признаки, в отличие от iPath [vinh2016discovering], который полагается исключительно на длину пути как механизм оценки для подпространств. Использование только длины пути ограничивает корректность объяснений точностью алгоритма iForest. Напротив, наш метод EMI генерирует набор правил, который идентифицирует подпространство в -мерном пространстве, где аномальная точка наиболее изолирована, не требуя какого-либо обучения. Это отличается от Explainer [kopp2020anomaly], где правила выражены в дизъюнктивной форме, а деревья решений обучаются на несбалансированных данных..
Негативные замечания в аудиторских отчетах: выявление предложений с негативными замечаниями из корпуса аудиторских отчетов по сути является задачей классификации предложений. Мы используем FinBERT, который широко применяется в финансовых приложениях; например, [yadav2019sentiment] использовали его для анализа тональности финансовых новостей с целью изучения влияния общественных настроений на цены акций. Эти модели обычно классифицируют предложения как позитивные, негативные или нейтральные. Однако негативная тональность не всегда указывает на негативное замечание — например, фраза «компания понесла убыток в размере 320 лакхов рупий» отражает финансовый факт, а не негативное замечание, несмотря на свою негативную тональность. Наша задача B напоминает экстремальную многометочную классификацию (XMLC), поскольку существует 1437 категорий XBRL, и одно предложение может соответствовать нескольким категориям. Подходы на основе контролируемого обучения (Supervised ML) сложны из-за значительных затрат времени и усилий экспертов-бухгалтеров на создание размеченных обучающих данных. SurveyCoder [PP13], [patil2015active] предлагают методы обучения без учителя (unsupervised methods) для присвоения одного или нескольких кодов из предопределенной системы кодирования ответам клиентов на открытые вопросы путем проверки совпадений семантических единиц. Аналогично, [devine2022unsupervised] представляет подход XMLC без учителя для тегирования сообщений на технических форумах (например, StackOverflow) с использованием эмбеддингов сообщений и тегов категорий из моделей на основе transformers, сравнивая их с помощью косинусного сходства и отбирая теги выше определенного порога. [loukas2022finer] моделирует тегирование XBRL как задачу распознавания именованных сущностей, но использует контролируемый подход и рассматривает только 139 категорий, в то время как мы работаем со всеми 1437 категориями для разработки интерпретируемого метода обучения без учителя..
3 Наборы данных
| Name | Size | +1% | Description |
| #sent=300 | 42.0 ADV_REMARK% | Adverse remarks manually annotated | |
| #sent=500 | 16.4 ADV_REMARK% | Adverse remarks manually annotated | |
| #sent=13698 | 20.7 ADV_REMARK% | Adverse remarks using linguistic rules | |
| #sent=1152 | 47.6 ADV_REMARK% | Adverse remarks using MISTRAL-7B-Instruct555https://huggingface.co/mistralai/Mistral-7B-Instruct-v0.3 | |
| #companies= 11460 | - | 2292 companies for 5 years, 42 financial variables + 22 ratios | |
| #labels=11460 | 19.8 MISINFO% | Silver labels for misinformation | |
| #reports= 11460 | - | Audit reports of 2292 companies for 5 years |
Мы собрали с помощью веб-скрейпинга полуструктурированные финансовые отчеты (ФО) — преимущественно бухгалтерские балансы (ББ), отчеты о прибылях и убытках (ОПУ) и отчеты о движении денежных средств (ОДДС) — 2292 публичных индийских компаний за пять лет (с 2010 по 2014 год)666https://www.moneycontrol.com/. Мы извлекли в общей сложности 42 финансовые переменные — или просто переменные — (28 из ББ, 9 из ОПУ и 5 из ОДДС) и 22 финансовых коэффициента, которые мы использовали для поиска компаний с недостоверной информацией в их ФО. Таблицы LABEL:tab:var_stat_2014, 5 содержат описание используемых финансовых переменных и коэффициентов соответственно. Обратите внимание, что данные не содержат каких-либо меток относительно того, содержит ли ФО какой-либо вид недостоверной информации или нет. Это делает использование методов обучения с учителем неуместным. Этот необработанный структурированный набор данных обозначается как , где каждая из строк состоит из 64 (42+22) признаков для конкретной компании за конкретный год..
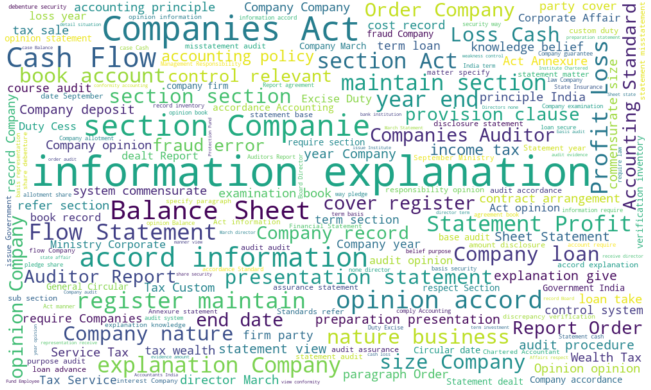
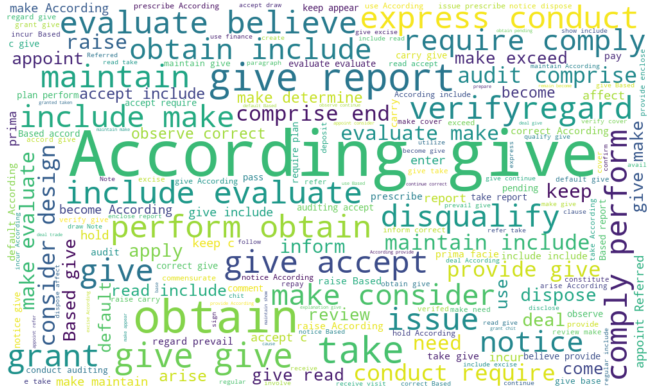
Аудиторские отчеты (в виде текстовых файлов) доступны для каждой из этих компаний за все 5 лет. Мы собрали с помощью веб-скрейпинга6 аудиторские отчеты этих компаний за тот же 5-летний период. Финансовое состояние компании и точность информации в ее финансовой отчетности оцениваются аудиторами в их аудиторских отчетах. Для 2292 компаний за 5 лет в общей сложности было получено аудиторских отчетов. Исходный корпус аудиторских отчетов обозначен как . После очистки и удаления коротких строк и строк, не являющихся предложениями (например, таблиц), содержит 578789 предложений и 22233701 слово. Среднее количество предложений и слов на один аудиторский отчет в наборе данных составляет 50,50 и 1891,40 соответственно. На рисунках 2(a) и 2(b) представлены облака слов существительных и глаголов из соответственно..
Наша цель — извлечь (из каждого аудиторского отчета) предложения, указывающие на замечания аудиторов. Эти замечания оказывают существенную помощь в определении того, может ли связанная с ними финансовая отчетность содержать недостоверную информацию или нет. Мы создали несколько наборов данных на основе этих двух исходных наборов данных (Таблица ⟦LABEL:tab:dataset_summ⟧).
- ⟦• Набор данных : Мы использовали лингвистические правила из [PAPV23] для автоматической маркировки каждого предложения из набора данных как ADV_REMARK или NA. В результате 13698 предложений (2,37%) были помечены как ADV_REMARK, а остальные — как NA.
- ⟦• Набор данных : Мы использовали обученную модель BERT для классификации негативных замечаний из [PAPV23], чтобы предсказать метки для каждого предложения в . В результате 33308 предложений (5,75%) были помечены как ADV_REMARK, а остальные как NA. В попытке отобрать наиболее разнообразные предложения в качестве негативных замечаний, мы выполнили кластеризацию этих 33308 предложений и выбрали по 1 репрезентативному предложению из каждого кластера; это дало 1152 предложения. Для кластеризации мы использовали алгоритм Fast Clustering из библиотеки sentence-transformers на языке Python [reimers-2019-sentence-bert]. Затем мы использовали LLM MISTRAL-7B-Instruct для разметки этих 1152 предложений в наборе данных как ADV_REMARK или NA. Промпт, предоставленный LLM для классификации, был следующим: Проверьте, является ли следующее предложение из отчета финансового аудита негативным замечанием. Предложение: Ответьте «Да» или «Нет», а затем дайте краткое объяснение. Ответ: и если на выходе получается «Да», то мы помечаем его как ADV_REMARK, в противном случае как NA.
- ⟦• Набор данных : Этот набор данных состоит из 300 случайно выбранных предложений из , каждое из которых было вручную помечено как ADV_REMARK или NA. Руководство по аннотированию приведено ниже.
- ⟦• Набор данных : Для получения ранее не встречавшихся предложений с целью оценки моделей классификации предложений мы использовали аудиторские отчеты за 2015 год, удалили предложения, в которых отсутствовал глагол, или длина которых составляла менее 10 или более 50 слов, и из оставшихся предложений случайным образом отобрали 500, убедившись, что они достаточно сильно отличаются друг от друга, чтобы избежать появления почти дубликатов. Мы разработали подробные руководства по аннотированию, используя которые, вручную пометили каждое предложение как ADV_REMARK или NA. В общей сложности 82 предложения (16,4%) были помечены как ADV_REMARK, а оставшиеся 418 — как NA.
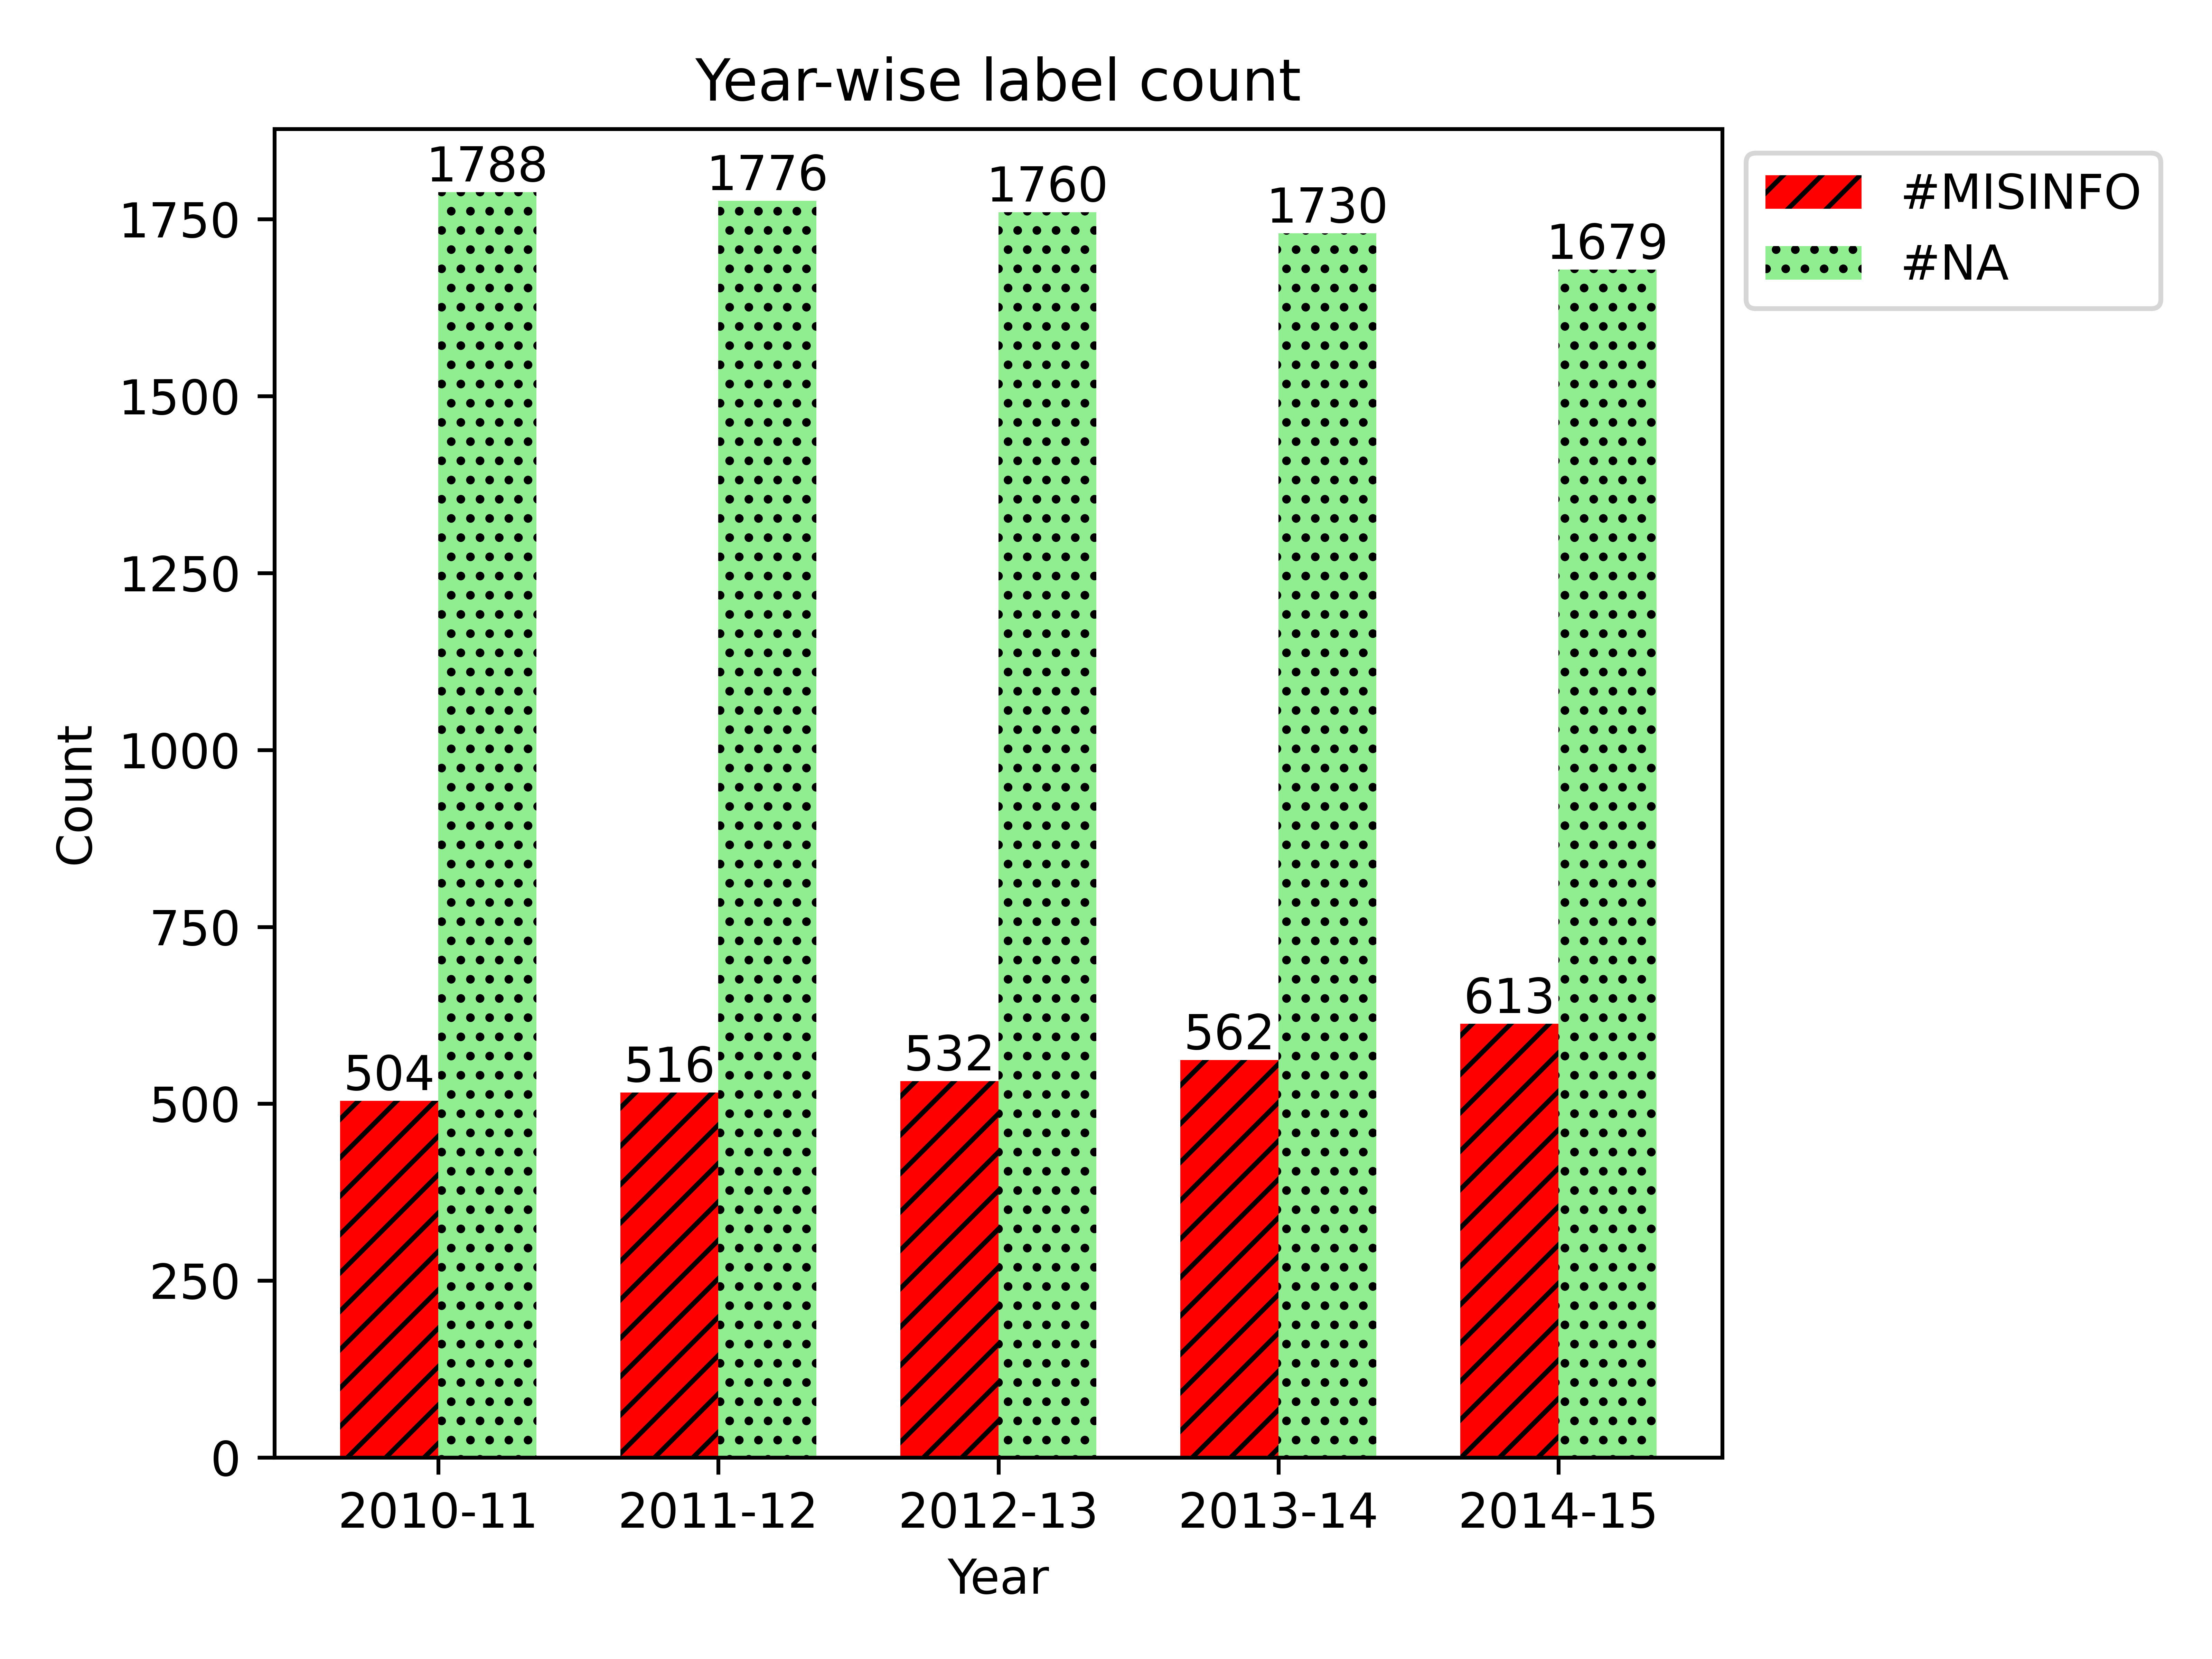
- ⟦• Набор данных : У нас нет эталонных данных о дезинформации ни для одной компании ни за один год. Поэтому, чтобы обеспечить оценку наших методов обнаружения дезинформации, мы создали набор данных с «серебряным» стандартом, где для каждой компании и каждого года метка указывает, содержит ли ее финансовая отчетность за этот год дезинформацию или нет. Метод присвоения такой прогнозируемой «серебряной» метки заключается в следующем. Пусть обозначает аудиторский отчет для компании за год . Мы используем MISTRAL-7B-Instruct для маркировки каждого предложения в как ADV_REMARK или NA. Мы также используем наш специально обученный классификатор T5 (описанный ниже) для маркировки каждого предложения в как ADV_REMARK или NA. Если содержит как минимум 2 предложения, каждое из которых помечено как ADV_REMARK и MISTRAL, и классификатором T5, то мы присваиваем метку MISINFO (содержит дезинформацию) кортежу ; в противном случае мы присваиваем ему метку NA. Мы обозначаем этот набор данных как . Используя этот метод, из 11460 компаний (за 5 лет) компаний (19,80%) были помечены как содержащие дезинформацию. Распределение «серебряных» меток по годам приведено на Рисунке 3⟧.
Краткий обзор руководящих принципов аннотирования для маркировки предложения как ADV_REMARK выглядит следующим образом: Негативные замечания — это предложения, содержащие упоминания о выявленных или потенциальных случаях несоответствия, дезинформации, нарушений, противоречий, ошибок, неточностей, мошенничества, упущений, несоблюдения нормативных требований и т. д.; например, убыток за текущий год занижен на X рупий, а текущие обязательства также занижены на Y рупий. Негативные замечания часто также включают предложения аудиторов по улучшению. Кроме того, предложение, содержащее упоминание о действиях руководства или состоянии компании, указывающее на проблему, должно быть помечено как негативное. Пример: Компания не в состоянии выполнить свои финансовые обязательства. Предложение, в котором аудитор только констатирует факты (без отрицательного мнения), не должно помечаться как негативное, даже если факты могут казаться отрицательными с деловой точки зрения. Пример: предложение «Компания раскрыла влияние предстоящих судебных разбирательств в финансовой отчетности» не должно помечаться как ADV_REMARK, поскольку аудитор отмечает, что компания предприняла правильное действие. Статистика каппа для согласованности между аннотаторами (2 аннотатора) составила = 0.718, что указывает на существенное согласие..
| Sentence | In this situation , we are unable to comment upon the non provision of statutory liabilities for current year as well as for the earlier years. |
|---|---|
| Label | ADV_REMARK |
| Explanation from MISTRAL | This sentence is an adverse remark because it indicates that the company has not made sufficient provisions for statutory liabilities, which could result in under reported expenses and potential financial instability. The auditor is unable to provide an opinion on the accuracy of the financial statements due to this significant deficiency. |
| input_text | Check whether the following sentence from a financial audit report contains an adverse remark. Answer as "adverse_remark" or "NA" followed by a short explanation in 1 sentence. Sentence: In this situation , we are unable to comment upon the non provision of statutory liabilities for current year as well as for the earlier years. Answer: |
| output_text | Label: adv_remark Explanation: This sentence is an adverse remark because it indicates that the company has not made sufficient provisions for statutory liabilities, which could result in under reported expenses and potential financial instability. The auditor is unable to provide an opinion on the accuracy of the financial statements due to this significant deficiency. |
Обучение классификатора T5: Теперь мы объясним, как мы обучали классификатор T5 для маркировки заданного предложения как ADV_REMARK или NA. Мы использовали наборы данных предложений , и для обучения модели T5. Процесс обучения включал два этапа:
- ⟦1. Сначала мы сгенерировали однострочное объяснение с использованием MISTRAL-7B-Instruct для каждой пары предложение-метка в наборах данных. Промпт для генерации объяснения для любого предложения с меткой ADV_REMARK (или, соответственно, NA) в наборе данных представлен как Explain why the following sentence from a financial audit report is an adverse remark (or, not an adverse remark, respectively). Keep the explanation concise and up to 2 sentences. Sentence:{}. Explanation:
- ⟦2. Предположим, что для пары предложение-метка в наборе данных сгенерированное объяснение в представляет собой . Мы использовали генеративную способность классификатора T5 (модель кодировщик-декодировщик) для генерации текста в качестве вывода. Обучающие данные для классификатора T5 состоят из input_text и output_text. Параметр input_text содержит текстовую подсказку, объединенную с предложением , в то время как output_text содержит метку для соответствующего предложения, , и объяснение , сгенерированное в для . Пример образца, используемого при обучении, приведен в Таблице 2.
Классификатор T5, обученный на этих данных, способен классифицировать заданное аудиторское предложение как ADV_REMARK или NA и предоставить однострочное объяснение своей классификации. Мы оценили классификатор на наборе данных . Мы извлекли предсказанные метки из выходных данных классификатора и оценили результаты с помощью F1-score в качестве метрики оценки (см. таблицу 3). Классификатор T5 имеет F1-score, равный .
| Model | P | R | F1 |
|---|---|---|---|
| -BERT[PAPV23] | 0.76 | 0.70 | 0.72 |
| T5 | 0.85 | 0.76 | 0.80 |
| Variable | Mean | Stdev | Q1 | Q2 | Q3 |
| Equity Share Capital | 65.76 | 407.39 | 5.10 | 10.97 | 25.25 |
| Reserves and Surplus | 912.39 | 6437.14 | 1.43 | 29.12 | 213.41 |
| Total Shareholders Funds | 991.00 | 6657.67 | 9.30 | 45.44 | 258.93 |
| Long Term Borrowings | 568.60 | 4930.10 | 0.00 | 3.22 | 46.05 |
| Deferred Tax Liabilities [Net] | 42.74 | 475.25 | 0.00 | 0.03 | 4.31 |
| Other Long Term Liabilities | 44.02 | 416.29 | 0.00 | 0.00 | 1.44 |
| Long Term Provisions | 31.07 | 576.92 | 0.00 | 0.10 | 1.64 |
| Total Non-Current Liabilities | 686.44 | 5334.67 | 0.50 | 9.30 | 77.31 |
| Short Term Borrowings | 221.53 | 1434.74 | 0.00 | 7.93 | 60.57 |
| Trade Payables | 209.32 | 1667.88 | 0.32 | 8.99 | 54.12 |
| Other Current Liabilities | 245.01 | 1283.46 | 0.44 | 6.41 | 50.16 |
| Short Term Provisions | 59.62 | 642.18 | 0.06 | 1.00 | 7.70 |
| Total Current Liabilities | 735.47 | 4337.37 | 4.00 | 40.50 | 231.55 |
| Total Capital And Liabilities | 2417.84 | 14339.12 | 22.84 | 124.10 | 611.38 |
| Fixed Assets | 787.58 | 6084.09 | 2.09 | 25.05 | 154.91 |
| Non-Current Investments | 304.64 | 2191.23 | 0.00 | 1.89 | 28.12 |
| Deferred Tax Assets [Net] | 4.92 | 57.39 | 0.00 | 0.00 | 0.00 |
| Long Term Loans And Advances | 392.88 | 5210.24 | 0.22 | 2.76 | 20.69 |
| Other Non-Current Assets | 26.63 | 305.05 | 0.00 | 0.00 | 0.60 |
| Total Non-Current Assets | 1516.65 | 10130.76 | 9.02 | 49.88 | 303.29 |
| Current Investments | 80.64 | 977.09 | 0.00 | 0.00 | 0.00 |
| Inventories | 224.10 | 1842.32 | 0.14 | 10.06 | 66.23 |
| Trade Receivables | 195.23 | 1023.19 | 0.85 | 14.12 | 72.03 |
| Cash And Cash Equivalents | 136.10 | 1244.63 | 0.31 | 2.38 | 14.24 |
| Short Term Loans And Advances | 182.56 | 1241.64 | 0.76 | 6.22 | 36.33 |
| OtherCurrentAssets | 82.51 | 796.76 | 0.00 | 0.23 | 3.75 |
| Total Current Assets | 901.14 | 5195.71 | 9.32 | 56.93 | 285.37 |
| Total Assets | 2417.84 | 14339.12 | 22.84 | 124.10 | 611.38 |
| Other Income | 46.51 | 449.75 | 0.13 | 1.06 | 6.42 |
| Total Revenue | 1746.50 | 15693.73 | 7.16 | 80.63 | 469.23 |
| Cost Of Materials Consumed | 726.48 | 9090.48 | 0.00 | 4.93 | 142.91 |
| Changes In Inventories Of FGWIP And Stock-In Trade | -5.05 | 87.19 | -1.45 | 0.00 | 0.11 |
| Employee Benefit Expenses | 105.82 | 895.59 | 0.48 | 5.34 | 28.72 |
| Depreciation And Amortisation Expenses | 52.98 | 403.43 | 0.16 | 2.01 | 12.84 |
| Other Expenses | 184.24 | 1069.26 | 0.86 | 9.06 | 58.22 |
| Profit/Loss Before Tax | 152.70 | 1336.24 | -0.10 | 1.09 | 19.14 |
| Current Tax | 39.39 | 294.63 | 0.00 | 0.17 | 4.22 |
| Net Profit/Loss Before Extraordinary Items And Tax | 156.39 | 1358.32 | -0.07 | 1.06 | 19.72 |
| Net CashFlow From Operating Activities | 142.94 | 1690.20 | -0.26 | 2.28 | 28.41 |
| Net Cash Used In Investing Activities | -131.03 | 1674.14 | -14.42 | -0.69 | 0.10 |
| Net Cash Used From Financing Activities | -16.20 | 909.41 | -12.87 | -0.30 | 0.59 |
| Net Inc/Dec In Cash And Cash Equivalents | -2.37 | 449.75 | -0.95 | 0.00 | 0.64 |
4 Методы обучения без учителя для обнаружения дезинформации
Как упоминалось ранее, набор данных не содержит эталонных меток ни для одного из FS относительно того, содержат ли FS какие-либо известные и подтвержденные случаи дезинформации. Мы используем негативные замечания, обнаруженные в аудиторском отчете, связанном с FS компании, для автоматического создания таких меток; это набор данных (Рисунок 3). Очевидно, что эти метки в лучшем случае будут серебряным стандартом, и положительная метка не обязательно означает наличие фактического случая дезинформации. Основываясь на нашем изучении набора данных, мы рассматриваем FS как квалифицированный (то есть содержащий дезинформацию), если его аудиторский отчет содержит как минимум 2 предложения, которые были помечены как ADV_REMARK как классификатором T5, так и LLM MISTRAL-7B-Instruct из аудиторского отчета за текущий или следующий год. Причина использования аудиторских отчетов за текущий и следующий год заключается в том, что последствия дезинформации иногда накапливаются и усиливаются с течением времени, что означает, что аудитору может быть легче обнаружить ее в следующем году..
Мы используем несколько типов алгоритмов обучения без учителя на структурированном наборе данных для обнаружения FS в конкретном году, которые, вероятно, содержат дезинформацию. Затем мы используем серебряные метки в наборе данных для вычисления точности этих методов обнаружения следующим образом. Предположим, что FS компании за год определены как вероятно содержащие дезинформацию. Если соответствующая метка является MISINFO либо для этого года, либо для следующего года (если доступно), то мы помечаем как истинно положительный результат, в противном случае — как ложноположительный..
| Name | Formula | Mean | Stdev | Q1 | Q2 | Q3 |
|---|---|---|---|---|---|---|
| / | 0.15 | 0.16 | 0.02 | 0.11 | 0.24 | |
| / | 0.50 | 0.27 | 0.30 | 0.51 | 0.71 | |
| / | 0.28 | 0.24 | 0.05 | 0.24 | 0.44 | |
| 4.83 | 2.44 | 3.14 | 4.83 | 6.42 | ||
| / | 0.06 | 0.12 | 0.01 | 0.02 | 0.05 | |
| 3.80 | 3.00 | 2.03 | 4.06 | 5.85 | ||
| (-)/ | 10.20 | 86.77 | 0.56 | 0.97 | 2.25 | |
| (+)/ | 0.93 | 6.47 | 0.23 | 0.51 | 0.71 | |
| / | 4.03 | 50.50 | 0.35 | 0.73 | 1.01 | |
| (+)/ | 0.86 | 38.34 | 0.16 | 0.81 | 1.95 | |
| / | 0.64 | 5.63 | 0.13 | 0.32 | 0.50 | |
| / | 0.13 | 0.20 | 0.02 | 0.05 | 0.13 | |
| / | 0.14 | 0.16 | 0.00 | 0.10 | 0.22 | |
| / | -5.65 | 243.44 | -0.02 | 0.03 | 0.11 | |
| (-)/ | 0.11 | 3.26 | 0.00 | 0.04 | 0.12 | |
| (-)/ | -0.01 | 0.56 | -0.01 | 0.01 | 0.05 | |
| (-)/ | -5.67 | 243.44 | -0.02 | 0.02 | 0.09 | |
| / | 0.24 | 14.22 | -0.04 | 0.11 | 0.34 | |
| /(-) | 5.01 | 204.69 | -0.41 | 0.80 | 2.50 | |
| (+)/(+) | 0.10 | 0.19 | 0.01 | 0.03 | 0.10 | |
| (+)/(+) | 0.42 | 0.30 | 0.10 | 0.44 | 0.65 | |
| (+)/(+) | 0.26 | 0.24 | 0.06 | 0.20 | 0.38 |
4.1 Обнаружение аномалий (AD)
Одной из обоснованных гипотез является то, что любая финансовая отчетность, содержащая недостоверную информацию, будет выглядеть аномальной в определенном смысле по сравнению с достоверной финансовой отчетностью (то есть не содержащей недостоверной информации). Чтобы проверить эту идею, мы использовали несколько хорошо известных алгоритмов обнаружения аномалий, реализованных в пакете PyOD [ZLN19] на структурированном наборе данных для выявления аномальной (то есть подозрительной) финансовой отчетности. Ансамблевый метод выбирает топ-20 финансовой отчетности, имеющей наибольшее количество алгоритмов обнаружения аномалий, которые отметили ее как аномальную (мы делаем это по годам).
Таблица 6 демонстрирует результаты точности на 20 (P@20) для 18 (17 + 1 ансамблевый) алгоритмов AD. Как видно, алгоритм Connectivity-Based Outlier Factor (COF) [TCWC01] имеет наивысший показатель P@20 (0,60) за 2014 год, то есть 12 из 20 компаний, идентифицированных им как аномальные, действительно помечены как MISINFO в . Результаты P@20 всех алгоритмов за 2010–2014 годы можно увидеть в Таблице 6. Столбец показывает среднюю точность алгоритма за 5 лет. Заметим, что алгоритм Linear Outlier Factor (LOF) [zhong2019steganographer] дает наивысшую точность в течение 4 (из 5) лет в данных. Алгоритм LOF вычисляет локальную плотность каждой точки на основе расстояния до ее k-ближайших соседей. Точки с меньшей плотностью выдаются как выбросы. Другие алгоритмы, такие как COF и SOS, имеют высокую точность за 2014 год и дают приемлемую среднюю точность за все годы соответственно. С другой стороны, алгоритм Histogram Based Outlier Detection (HBOS) [goldstein2012histogram] показывает низкие результаты во все годы. HBOS строит гистограммы для каждого признака с фиксированным или динамическим количеством корзин (в зависимости от распределения данных) и определяет выбросы путем оценки плотности на основе частоты выборок в каждой корзине. Чем ниже плотность, тем выше вероятность того, что это выброс..
4.2 Пошаговая регрессия
Когда финансовая отчетность компании идентифицируется как подозрительная (то есть вероятно содержащая недостоверную информацию), важно предоставить обоснование или объяснение этого прогноза, понятное для человека. Для повышения удобства использования ключевой вопрос, на который необходимо ответить, звучит так: где именно в финансовой отчетности присутствует недостоверная информация? Хорошо известно, что некоторые финансовые показатели в финансовой отчетности — например, связанные с активами и обязательствами — более подвержены недостоверной информации, чем другие; например, замечания аудиторов чаще основаны именно на этих переменных[SVAP22]. Например, недостоверная информация часто имеет тенденцию к занижению убытков или обязательств либо к завышению прибыли.
| Algorithm | 2010 | 2011 | 2012 | 2013 | 2014 | averageP@20 |
| ABOD | 0.30 | 0.25 | 0.20 | 0.25 | 0.35 | 0.27 |
| CBLOF | 0.30 | 0.25 | 0.15 | 0.25 | 0.25 | 0.24 |
| COF | 0.40 | 0.60 | 0.30 | 0.35 | 0.60 | 0.45 |
| HBOS | 0.10 | 0.25 | 0.10 | 0.15 | 0.20 | 0.16 |
| iForest | 0.15 | 0.20 | 0.15 | 0.20 | 0.25 | 0.19 |
| KNN | 0.30 | 0.25 | 0.15 | 0.20 | 0.20 | 0.22 |
| LMDD | 0.20 | 0.15 | 0.30 | 0.35 | 0.40 | 0.28 |
| LODA | 0.25 | 0.20 | 0.10 | 0.30 | 0.20 | 0.21 |
| LOF | 0.65 | 0.65 | 0.55 | 0.40 | 0.55 | 0.56 |
| Mahalanobis | 0.35 | 0.30 | 0.45 | 0.40 | 0.30 | 0.36 |
| MCD | 0.30 | 0.25 | 0.20 | 0.25 | 0.40 | 0.28 |
| OCSVM | 0.20 | 0.30 | 0.25 | 0.00 | 0.15 | 0.18 |
| PCA | 0.35 | 0.25 | 0.30 | 0.30 | 0.30 | 0.30 |
| SOD | 0.30 | 0.30 | 0.30 | 0.25 | 0.25 | 0.28 |
| SOS | 0.40 | 0.50 | 0.50 | 0.25 | 0.45 | 0.42 |
| Auto-Encoder | 0.35 | 0.25 | 0.30 | 0.30 | 0.30 | 0.30 |
| VAE | 0.35 | 0.25 | 0.30 | 0.30 | 0.30 | 0.30 |
| Ensemble | 0.35 | 0.25 | 0.25 | 0.35 | 0.30 | 0.30 |
Мы использовали первый подход из метода обнаружения аномалий на основе моделей из [SVAP22], где моделями выступают различные пошаговые регрессионные модели. Чтобы проиллюстрировать этот подход, мы рассмотрели переменные, относящиеся к обязательствам, в качестве подверженных риску переменных (мы могли бы легко добавить и другие виды переменных). Мы строим регрессионные модели и используем их для выявления подозрительных FS. Мы начинаем с заданной подверженной риску переменной в качестве зависимой переменной, определяем другие переменные, от которых зависит эта подверженная риску переменная (независимые переменные), и используем только эти переменные для построения регрессионной модели (моделей) для этой подозрительной переменной. Наконец, мы используем эти регрессионные модели для выявления подозрительных FS. Подход состоит из следующих шагов:
- ⟦1. Выберите подверженную риску переменную (например, ⟧);
- ⟦2. Определите переменные, наиболее сильно коррелирующие с в качестве зависимых переменных;
- ⟦3. Используйте пошаговую регрессию для постепенного построения нескольких моделей регрессии методом наименьших квадратов (OLS) для и выберите лучшую модель регрессии для , имеющую наибольшее значение скорректированного .;
- ⟦4. Используйте для выявления подозрительных следующим образом. Возьмите , предскажите значение , используя значения (в данном ) независимых переменных, применяемых в , вычислите ошибку прогнозирования и отметьте те 20 как подозрительные, которые имеют наибольшую квадратичную ошибку прогнозирования в с использованием ⟧.
- :
-
⟦ Финансовый аудит Выявление дезинформации Объяснимый искусственный интеллект Выявление аномалий Финансовая отчетность Обучение без учителя Аудиторская поддержка ⟧]
- :
-
⟦ Финансовый аудит Выявление дезинформации Объяснимый искусственный интеллект Выявление аномалий Финансовая отчетность Обучение без учителя Аудиторская поддержка ⟧]
- :
-
⟦ Финансовый аудит Выявление дезинформации Объяснимый искусственный интеллект Выявление аномалий Финансовая отчетность Обучение без учителя Аудиторская поддержка ⟧]
- :
-
⟦ Финансовый аудит Выявление дезинформации Объяснимый искусственный интеллект Выявление аномалий Финансовая отчетность Обучение без учителя Аудиторская поддержка ⟧]
Помимо регрессии методом наименьших квадратов, мы использовали модели с той же структурой входных и выходных данных, но построенные на основе Lasso, Ridge, регрессии на опорных векторах (SVR) и случайного леса (RFR). Lasso (или Ridge) — это метод регуляризации, который дополняет формулировку метода наименьших квадратов путем добавления (или соответственно) к целевой функции. SVR (основанная на алгоритме машин опорных векторов) используется для моделирования сложных нелинейных зависимостей в данных и прогнозирования непрерывных выходных значений для заданных входных данных. RFR подбирает ряд регрессоров на основе деревьев решений для различных подвыборок набора данных и использует усреднение для повышения точности прогнозирования и контроля переобучения [regressionRFR]. Для иллюстрации в таблице 7 представлены 4 лучшие регрессионные модели, построенные с использованием пошаговой регрессии методом наименьших квадратов для подверженных влиянию переменных, связанных с обязательствами: , , , . Мы использовали в общей сложности переменных и коэффициентов, относящихся к обязательствам, в качестве подверженных влиянию переменных и построили регрессионные модели. Результаты P@20 для этих регрессионных моделей на данных за 5 лет приведены в таблице 8. Как мы видим, модели SVR обладают более высокой точностью по сравнению с другими моделями..
| Model | 2010-P@20 | 2011-P@20 | 2012-P@20 | 2013-P@20 | 2014-P@20 | average-P@20 |
|---|---|---|---|---|---|---|
| OLS M14 | 0.65 | 0.70 | 0.70 | 0.65 | 0.70 | 0.68 |
| OLS M15 | 0.55 | 0.55 | 0.5 | 0.6 | 0.45 | 0.53 |
| OLS M16 | 0.65 | 0.65 | 0.65 | 0.50 | 0.50 | 0.59 |
| OLS M17 | 0.70 | 0.60 | 0.65 | 0.60 | 0.70 | 0.65 |
| Ridge M14 | 0.65 | 0.75 | 0.70 | 0.65 | 0.70 | 0.69 |
| Ridge M15 | 0.55 | 0.60 | 0.50 | 0.60 | 0.45 | 0.54 |
| Ridge M16 | 0.65 | 0.65 | 0.65 | 0.50 | 0.50 | 0.59 |
| Ridge M17 | 0.70 | 0.60 | 0.65 | 0.60 | 0.70 | 0.65 |
| Lasso M14 | 0.65 | 0.70 | 0.80 | 0.70 | 0.70 | 0.71 |
| Lasso M15 | 0.55 | 0.65 | 0.50 | 0.70 | 0.50 | 0.58 |
| Lasso M16 | 0.65 | 0.65 | 0.65 | 0.50 | 0.50 | 0.59 |
| Lasso M17 | 0.70 | 0.75 | 0.65 | 0.60 | 0.70 | 0.68 |
| SVR M14 | 0.80 | 0.70 | 0.90 | 0.75 | 0.75 | 0.78 |
| SVR M15 | 0.55 | 0.60 | 0.70 | 0.75 | 0.95 | 0.71 |
| SVR M16 | 0.65 | 0.65 | 0.80 | 0.55 | 0.55 | 0.64 |
| SVR M17 | 0.80 | 0.90 | 0.90 | 0.75 | 0.80 | 0.83 |
| RFR M14 | 0.50 | 0.50 | 0.40 | 0.45 | 0.50 | 0.47 |
| RFR M15 | 0.65 | 0.35 | 0.55 | 0.60 | 0.60 | 0.55 |
| RFR M16 | 0.55 | 0.50 | 0.60 | 0.50 | 0.50 | 0.53 |
| RFR M17 | 0.65 | 0.50 | 0.45 | 0.40 | 0.55 | 0.51 |
5 Объяснения для дезинформации
Для дальнейшей обработки выявленных случаев дезинформации в финансовой отчетности часто бывает полезно автоматически генерировать понятные человеку обоснования или объяснения для каждого случая. Такие объяснения помогают определить, действительно ли финансовая отчетность компании содержит дезинформацию или это просто ложное срабатывание. Исследования в области Explainable AI (XAI) [TSP22] сосредоточены на создании объяснений для прогнозов, сделанных моделями AI, преимущественно моделями классификации..
| Name | Description |
|---|---|
| Average depth of the trees | |
| Average size of the leaf containing | |
| Number of paths that contain feature | |
| Average % drop in the partition after split | |
| Number of short paths (less than the maximum tree depth) | |
| The level at which feature is present on average | |
| Average % drop in the partition after split for short paths | |
| The level at which feature is present in short paths on average |
XAI нацелен на предоставление объяснений в различных формах, таких как взвешенные или невзвешенные подмножества признаков, наборы правил, визуальные представления и описания на естественном языке. В отличие от этого, область исследований Outlying Aspect Mining (OAM) [SM22], [LBS23] фокусируется на генерации объяснений аномальности точки, как правило, в виде подмножества признаков, формирующих подпространство. В то время как XAI объясняет логику работы базовой модели, OAM предлагает целостный, модельно-независимый взгляд на то, почему точка является интересной или аномальной..
| Parameters: |
| : Number of features in the dataset |
| : Number of points in the dataset |
| : The anomalous point to be explained |
| : Maximum number of features to be included in the explanation |
| : size matrix representing whether other points have higher values than the anomalous point |
| only if feature of point is greater than |
| otherwise |
| : size matrix representing whether other points have lower values than the anomalous point |
| only if feature of point is less than |
| otherwise |
| Variables: |
| : length binary array such that implies that the feature is included in the explanation as |
| : length binary array such that implies that the feature is included in the explanation as |
| : length array such that: |
|
only if
( is 1 only if point breaks at least one condition used in the explanation) |
| otherwise ( need not be an integer) |
| Objective: |
| (maximize no. of other points which do not satisfy at least one condition used in the explanation) |
| Constraints: |
| : (At most variables can be chosen in final explanation) |
|
: , s.t.
(A variable should not be repeated in the set of L variables used for the explanation.) |
|
: , s.t.
( has to be at least 1 if is 1 for any feature which is included in the explanation.) |
|
: , s.t.
( has to be at least 1 if is 1 for any feature which is included in the explanation.) |
|
: , s.t.
( should remain 0 for the points which do not contain 1 for any of the selected variables in and .) |
| : , s.t. ( should be at most 1.) |
5.1 Постановка задачи
У нас есть -мерный набор данных , где каждый и — это набор признаков (названия признаков). Предположим, нам дан аномальный экземпляр , полученный с помощью некоторого неизвестного нам метода AD. Цель состоит в том, чтобы сгенерировать объяснение , которое поясняет, почему данная точка данных должна считаться аномальной. Хотя объяснения могут принимать различные формы, обычно представляет собой либо подмножество признаков , либо набор логических правил для . В нашем случае — это набор данных FS компаний, где каждая компания представлена как -мерный вектор признаков, а — это аномальная компания, которая подозревается в наличии дезинформации в своей FS..
Мы обсуждаем 3 метода генерации объяснений того, почему точка может быть аномальной; эти методы такие же, как в [VSPP22]. Однако они использовали вручную составленные объяснения для оценки автоматически сгенерированных объяснений. В этой статье мы предлагаем новый метод автоматического создания эталонных объяснений (silver standard). Более того, мы используем гораздо больший набор данных для оценки алгоритмов..
5.2 Объяснение с использованием расстояния Махаланобиса (EMD)
Мы сортируем все точки в в порядке убывания их расстояния Махаланобиса от вектора среднего значения . Ранг Махаланобиса точки определяется как её позиция в этом отсортированном списке. Для любого собственного подмножества признаков определяется аналогичным образом, за исключением того, что расстояния Махаланобиса вычисляются после удаления всех признаков в из каждой точки в . Заметим, что меньшее значение ранга указывает на то, что точка лежит дальше от вектора среднего значения с точки зрения расстояния Махаланобиса..
Объяснение может быть любым подмножеством из булеана . Алгоритм EMD генерирует набор объяснений-кандидатов для заданной (предположительно аномальной) точки данных таким образом, что для каждого подмножества разница рангов превышает заранее определенный порог , где и — среднее значение и стандартное отклонение всех разностей рангов. Это гарантирует, что подмножество объясняет, почему является аномальным. Размер каждого подмножества-кандидата ограничен максимум . Если ни одно такое подмножество не удовлетворяет условию, алгоритм возвращает пустое множество..
Мы вычисляем уверенность в объяснении , используя стандартное отклонение разности рангов между и для всех экземпляров. В частности, уверенность рассчитывается как:
Это значение представляет собой количество стандартных отклонений, на которое разность рангов для отклоняется от среднего значения всех разностей рангов. Иными словами, оно измеряет расстояние Махаланобиса разности рангов для от среднего значения. Затем каждый набор кандидатов и соответствующее ему значение уверенности подаются на вход методу объединения свидетельств Демпстера-Шафера [Demp68]. Подмножество с наивысшим показателем уверенности считается наиболее обоснованным объяснением..
5.3 Объяснение с использованием iForest (EiForest)
Хорошо известный алгоритм обнаружения аномалий, iForest [liu2008isolation], рекурсивно разбивает данные путем случайного выбора признака и его значений для разделения. Экземпляры данных, которые изолируются на более ранних этапах разбиения, считаются аномалиями. Мы использовали iForest для построения леса из таких деревьев случайного разбиения. Пусть обозначает набор путей, которые ведут к . Для заданного экземпляра мы определяем набор признаков , которые появляются по крайней мере на одном пути в , способствуя изоляции . Для каждой переменной мы конструируем 8-мерный вектор сводных признаков , используя пути, ведущие к , которые содержат (подробности см. в таблице 9). Затем мы строим набор векторов сводных данных для всех точек и всех переменных в наборе данных. Далее мы вычисляем расстояние Махаланобиса от среднего значения для каждого . Наконец, топ переменных, отсортированных в порядке убывания , выбираются в качестве объяснения ⟧.
5.4 Объяснение с использованием максимальной изоляции ⟦K0⟧)
Мы предлагаем метод, основанный на целочисленном линейном программировании (ILP), который изолирует аномальную точку в максимально возможной степени. Объяснение , генерируемое этим методом, называемое объяснением с использованием максимальной изоляции (EMI), представляет собой конъюнкцию заданных условий. Эти условия, при применении в качестве фильтров ко всему набору данных, минимизируют количество точек, отличных от аномальной, которые удовлетворяют всем условиям..
При заданном наборе признаков и аномальной точке , подлежащей объяснению, объяснение принимает форму:
где — это значение для признака . Эти условия служат объяснением аномальной природы , поскольку они описывают, чем отличается от остальной части набора данных.
В таблице LABEL:tab:ILP подробно описана формулировка ILP. Ограничения , , и гарантируют, что становится тогда и только тогда, когда точка нарушает по крайней мере одно условие в объяснении. Целевая функция максимизирует количество таких точек, эффективно минимизируя количество других точек, которые удовлетворяют всем условиям наряду с , аномальной точкой, подлежащей объяснению..
5.5 Создание объяснений для эталонного набора данных Silver Standard
В нашем наборе данных содержатся финансовые отчеты 11 460 компаний, из которых 2727 были присвоены серебряные метки MISINFO с использованием метода, описанного ранее. Но в чем заключается объяснение (как подмножество наших 42 финансовых переменных) для каждой из этих 2727 компаний? Ручное определение такого подмножества требует слишком много усилий, времени и субъективности. Мы предлагаем новый автоматизированный метод построения объяснений серебряного стандарта для каждой из этих 2727 компаний. Идея заключается в том, чтобы использовать предложения, помеченные как ADV_REMARK в соответствующем аудиторском отчете для финансовой отчетности компании за конкретный год, извлечь финансовые переменные, упомянутые в каждом из этих предложений (помеченных как ADV_REMARK), и использовать этот набор в качестве объяснения. Однако здесь есть тонкость: каждая финансовая переменная, упомянутая в предложении, должна быть сопоставлена с одним из признаков, используемых в структурированном представлении финансовой отчетности..
Пример: в предложении В отношении спорных дел по [Подоходному налогу] и [Налогу с продаж] компания не установила сумму таких обязательств ., финансовые переменные, упомянутые в тексте, заключены в квадратные скобки. Однако ни одна из них не совпадает с каким-либо признаком из списка признаков. Чтобы определить соответствующий признак, мы сначала присваиваем предложению одну или несколько категорий XBRL, используя методы из [PAPV23] (описанные ниже). XBRL — это международный стандарт словаря, используемого в финансовой отчетности777www.xbrl.org. Мы используем 1724 категории из таксономии XBRL 2012 в качестве набора стандартизированных названий финансовых переменных. Затем одной из категорий XBRL, присвоенных этому предложению данным методом, является Налоги к уплате Налог с продаж; поскольку этого названия нет среди 42 используемых нами финансовых переменных, мы присваиваем его родительскую категорию XBRL Итого текущие обязательства (которая присутствует в списке признаков) в качестве одной из переменных эталонной выборки, что делает данную конкретную компанию аномальной.
Метод присвоения 0, 1 или более категорий XBRL в качестве серебряного стандарта объяснения того, почему конкретная компания (т.е. ее финансовая отчетность) помечена как MISINFO в базе данных , теперь разъяснен [PAPV23]. Это соответствует задаче B, упомянутой в [PAPV23]. Для года и компании , имеющей серебряную метку MISINFO, мы берем предложения (их как минимум два) из соответствующего аудиторского отчета, которые помечены как ADV_REMARK как T5, так и MISTRAL, как было объяснено ранее. Для каждой категории XBRL , содержащей слов, мы рассматриваем окна размером , , и и получаем все возможные непрерывные последовательности слов в заданном предложении путем скольжения этих окон. Сходство категории с предложением представляет собой наибольшее сходство Жаккара с любым из этих подмножеств. При вычислении сходства учитываются синонимы и морфологические вариации слова, а стоп-слова игнорируются. Категория сопоставляется с предложением, если вычисленное таким образом сходство Жаккара превышает пороговое значение (мы использовали = 0.6). После того как категории назначены, мы сопоставляем их с 42 финансовыми переменными, используемыми в данной статье. В случае, если мы не находим точного соответствия для категории XBRL среди этих переменных, мы используем иерархические отношения в таксономии XBRL и рассматриваем ее ближайшего родителя, который будет соответствовать переменным (см. пример выше). Таким образом, мы берем переменных, назначенных предложениям, в качестве эталонного объяснения для компании и года .⟧.
5.6 Эксперименты и результаты
Набор данных: Мы используем набор данных за конкретный год для формирования объяснений для любой компании (относящейся к ), помеченной как подозрительная. Как упоминалось в разделе 3, для каждого года набор данных состоит из 2292 компаний и значений 42 финансовых переменных, взятых из бухгалтерского баланса, отчета о прибылях и убытках и отчета о движении денежных средств..
Параметры настройки: значения параметров для алгоритма EMD установлены как = 0.5 и = 2. Для EiForest мы установили = 1000 и сохранили 5 наиболее значимых признаков ( = 5). Для EMI мы установили значение = 2. Для SHAP и LIME мы сохранили 5 наиболее значимых признаков, ответственных за предсказание модели..
Базовые методы: SHAP[kuhn1953contributions] и LIME[ribeiro2016should] — это два широко используемых метода генерации объяснений для классификации и регрессии. Оба требуют вспомогательного классификатора для генерации объяснений аномальных случаев; для этой цели мы используем классификатор Random Forest. Мы используем подмножество набора данных с серебряными метками 2024 года для обучения классификатора Random Forest..
В иллюстративных целях мы берем 20 ведущих компаний, чья финансовая отчетность за 2014 год была определена как аномальная с помощью регрессионной модели SVR M15 для 2014 года. Мы сравниваем объяснения, сгенерированные методами SHAP, LIME и нашими методами (EMD, EiForest, EMI), для этих компаний и сопоставляем данные объяснения с «серебряным стандартом» объяснений (описанным ранее); см. Таблицу LABEL:tab:exp_results, которая также включает объяснения, являющиеся «серебряным стандартом» достоверности. В таблицу включены только 7 из этих компаний (из 20), поскольку для остальных 13 компаний либо (i) пересечение предложений из аудиторских отчетов, классифицированных моделями T5 и MISTRAL как ADV_REMARK, является пустым (таким образом, согласно нашему критерию, в данной финансовой отчетности отсутствует дезинформация); либо (ii) пересечение сгенерированных объяснений (всеми 5 методами) с объяснением «серебряного стандарта» является пустым. Мы использовали точность , полноту и меру для каждого сгенерированного объяснения в качестве метрик оценки, сравнивая его со сгенерированным объяснением с использованием «серебряного стандарта» достоверности; см. Таблицу LABEL:tab:exp_results_prf. Чтобы охватить такие компании, мы могли бы смягчить наш критерий и генерировать объяснения, используя предложения, классифицированные как негативные замечания либо моделью T5, либо моделью MISTRAL..
Алгоритм EiForest продемонстрировал улучшенные результаты по сравнению с исходным исследованием [VSPP22]. Напротив, другие алгоритмы показывают снижение производительности относительно ранее заявленных результатов. Ключевым фактором, способствующим этому изменению, могло стать увеличенное количество финансовых переменных (18 в [VSPP22], в текущей статье: 42). Алгоритм EMI дает среднюю точность 0,21, что очень близко к точности EiForest. Мы отобрали топ признаков для алгоритмов SHAP, LIME и EiForest. Значение может влиять на показатели точности. Объяснения, предоставляемые SHAP и LIME, практически идентичны для большинства компаний, с разницей лишь в одну переменную между ними. Алгоритм EMD смог правильно определить переменные для 2 компаний. Средние значения алгоритма EiForest являются самыми высокими среди всех алгоритмов..
Одним из ограничений наших 3 методов генерации объяснений является то, что они предполагают наличие соответствующего аудиторского отчета, что может быть не так во всех возможных сценариях. В случае, если аудиторский отчет недоступен, а следовательно, недоступна и эталонная разметка silver label, мы можем использовать SHAP или LIME для генерации объяснения для компании, чья FS была идентифицирована как аномальная..
5.7 Генерация предложений для аудиторов:
Для выборочной компании, которая была определена как аномальная в ходе экспериментов, метод генерации объяснений EiForest выявил следующие объяснительные финансовые переменные, указывающие на то, почему финансовая отчетность, вероятно, является аномальной (также указана соответствующая категория XBRL)
- ⟦1. v40 Чистые денежные средства, использованные в инвестиционной деятельности Чистый денежный поток, использованный в инвестиционной деятельности
- ⟦2. v12 Краткосрочные резервы Резервы
- ⟦3. v15 Основные средства Основные средства
- ⟦4. v5 Отложенные налоговые обязательства [нетто] Чистые отложенные налоговые обязательства
- ⟦5. v28 Итого активы Итого активы
Мы сопоставили каждое предложение ADV_REMARK в наборе данных с 0, 1 или более категориями XBRL. Сопоставляя вышеуказанные категории XBRL, соответствующие приведенному выше объяснению, ниже представлены некоторые из совпадающих негативных замечаний в прошлых аудиторских отчетах:
- ⟦1. Адекватность резервов, созданных для покрытия обязательств перед работниками, не может быть установлена
- ⟦2. Не было создано адекватного резерва на случай невозврата дебиторской задолженности
- ⟦3. Не было создано резерва на обесценение инвестиций в акции компании X.
- ⟦4. не удалось количественно оценить отсутствие начисления процентов.
- ⟦5. Компания не создала резерв на сумму ожидаемого налога с продаж в размере Rs. X.
Мы могли бы легко преобразовать эти выбранные негативные замечания (используя LLM или простые лингвистические правила для преобразования текста) в аудиторские предложения. Например, последние два предложения с негативными замечаниями выше могут быть преобразованы в аудиторские предложения как:
- ⟦1. Проверьте, были ли созданы резервы по процентам.
- ⟦2. Проверьте, были ли созданы резервы по ожидаемым налоговым обязательствам.
| No. | Company | Ground truth | SHAP | LIME | EMD | EiForest | EMI |
| 1 | La Tim Metal | , , | , , , , | , , , , | NA | , , , , | 0.01 0.01 |
| 2 | Unimers India | , , , , , , | , , , , | , , , , | , , , | , , , , | 38.26 38.08 |
| 3 | Nicco Uco Fin | , , , , , , , , | , , , , | , , , , | , , , | , , , , | -564.2 8.7 |
| 4 | Entegra | , , | , , , , | , , , , | , , | , , , , | 0.08 162.68 |
| 5 | Quintegra Solut | ,, | , , , , | , , , , | NA | , , , , | -108.29 -135.11 |
| 6 | Modipon | , , , , , | , , , , | , , , | , , | , , | 21.7 21.69 |
| 7 | Encore Software | , , | , , , , | , , , , | , , | , , , , | 24.6 23.27 |
| SHAP | LIME | EMD | EiForest | EMI | ||||||||||||
| No. | Company | P | R | F | P | R | F | P | R | F | P | R | F | P | R | F |
| 1 | La Tim Metal | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.40 | 0.67 | 0.50 | 0.00 | 0.00 | 0.00 |
| 2 | Unimers India | 0.20 | 0.14 | 0.17 | 0.20 | 0.14 | 0.17 | 0.00 | 0.00 | 0.00 | 0.20 | 0.14 | 0.17 | 0.50 | 0.14 | 0.22 |
| 3 | Nicco Uco Fin | 0.20 | 0.11 | 0.14 | 0.20 | 0.11 | 0.14 | 0.25 | 0.11 | 0.15 | 0.40 | 0.22 | 0.29 | 0.00 | 0.00 | 0.00 |
| 4 | Entegra | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.20 | 0.33 | 0.25 | 0.00 | 0.00 | 0.00 |
| 5 | Quintegra Solut | 0.20 | 0.33 | 0.25 | 0.20 | 0.33 | 0.25 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.50 | 0.33 | 0.40 |
| 6 | Modipon | 0.20 | 0.17 | 0.18 | 0.20 | 0.17 | 0.18 | 0.33 | 0.17 | 0.22 | 0.33 | 0.17 | 0.22 | 0.00 | 0.00 | 0.00 |
| 7 | Encore Software | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.20 | 0.33 | 0.25 | 0.50 | 0.33 | 0.40 |
| Average | 0.11 | 0.11 | 0.11 | 0.11 | 0.11 | 0.11 | 0.08 | 0.04 | 0.05 | 0.25 | 0.27 | 0.24 | 0.21 | 0.12 | 0.15 | |
6 Заключение и будущие исследования
Финансовый аудит играет важную роль в поддержании доверия и прозрачности компании. Выявление недостоверной информации, присутствующей в финансовой отчетности, является важным результатом, ожидаемым от аудита. В данной статье мы предлагаем комплексный набор методов на основе искусственного интеллекта, опирающийся на предыдущие работы [SVAP22], [PAPV23], [VSPP22], для оказания помощи аудиторам с целью сокращения времени, усилий и субъективности, связанных с процессом аудита, а также повышения его эффективности. Идея заключается в предоставлении эффективной поддержки аудиторам путем извлечения знаний из накопленного корпуса финансовой отчетности и соответствующих аудиторских отчетов..
Мы собрали широкий спектр финансовых переменных из трех типов финансовой отчетности. Мы предложили методы обучения без учителя (обнаружение аномалий без учителя, а также методы на основе регрессии) для выявления дезинформации в финансовой отчетности и показали, что они с хорошей точностью обнаруживают компании, чья финансовая отчетность, вероятно, содержит дезинформацию. Из-за отсутствия достоверных данных о наличии дезинформации в финансовой отчетности мы использовали методы NLP и языковые модели для анализа аудиторских отчетов, чтобы сгенерировать серебряные стандарты меток для этих данных финансовой отчетности. Эти методы показали повышенную точность на гораздо большем наборе данных, использованном в данной статье, по сравнению с более ранними работами. Чтобы точно определить, где присутствует дезинформация, мы предложили методы генерации объяснений для выявленных подозрительных компаний с использованием explainable AI (XAI) и других методов интерпретируемости, как было предложено в нашей предыдущей работе. Вместо ручной проверки сгенерированных объяснений (как это делалось ранее), мы использовали метод коэффициента Жаккара и категории XBRL для получения серебряного стандарта достоверных данных для объяснений. Мы сопоставляем категории XBRL, наиболее похожие на предложения из аудиторского отчета, которые содержат критические замечания, отображаем назначенные категории XBRL на финансовые переменные, используемые в этой статье, и рассматриваем объединение отображенных переменных как серебряный стандарт достоверных данных. Мы реализовали полный процесс предоставления такой помощи аудиторам без привлечения ручного труда. Это снижает субъективность, присутствовавшую в нашей предыдущей работе. Наши методы позволяют выделить конкретную область, которая кажется подозрительной, что может быть полезно для аудиторов при проведении аудита..
В рамках будущих исследований мы работаем над интеграцией нескольких других компонентов нашей научной работы в систему, которую смогут использовать аудиторы для получения помощи в повышении качества и эффективности аудиторских проверок. Оценка результативности и удобства использования такой системы, в частности достоверности дезинформации и ее объяснения, является важной задачей, требующей решения. Сбор отзывов аудиторов о выявленной дезинформации, ее объяснении, а также о сгенерированных аудиторских предложениях и обучение на основе этих отзывов для постепенного совершенствования систем — это важный аспект, над которым мы будем работать. Мы также работаем над включением других источников аудиторских знаний в виде графов знаний для повышения качества генерируемых результатов..
7 Заявления и декларации
7.1 Декларация о конфликте интересов
От имени всех авторов автор-корреспондент заявляет об отсутствии конфликта интересов.
7.2 Конкурирующие интересы
Неприменимо
7.3 Информация о финансировании
Мы не получали никакого финансирования.
7.4 Вклад авторов
• Кшитидж Мадхав Джадхав – Концептуализация, Кураторство данных, Формальный анализ, Исследование, Руководство проектом, Программное обеспечение, Написание – черновой вариант, Визуализация • Судходхан Вайшампаян – Концептуализация, Формальный анализ, Исследование, Методология, Написание – рецензирование и редактирование, Курирование • Манодж Апте – Концептуализация, Формальный анализ, Методология, Написание – рецензирование и редактирование, Курирование • Сачин Павар – Концептуализация, Формальный анализ, Методология, Написание – рецензирование и редактирование, Курирование • Нитин Рамракхияни – Концептуализация, Формальный анализ, Методология, Написание – рецензирование и редактирование, Курирование • Гириш Кешав Палшикар – Концептуализация, Методология, Формальный анализ, Руководство проектом, Написание – черновой вариант, Курирование
7.5 Заявление о доступности данных
Данные, использованные в исследовании, находятся в открытом доступе на https://www.moneycontrol.com/. Дальнейшая обработка данных выполнена в соответствии с этапами, приведенными в рукописи..
7.6 Исследования с участием людей и/или животных
Неприменимо
7.7 Информированное согласие
Неприменимо
7.8 Декларация о согласии на публикацию
Неприменимо
7.9 Декларация о согласии на участие
Неприменимо
7.10 Декларация этики
Неприменимо