Интеллектуальная навигация группы беспилотных летательных аппаратов в ITNTN: иерархический подход на основе LLM Электронные адреса: {zijiang, pingw, hinat}@yorku.ca, haozhou029@gmail.com, wael.jaafar@etsmtl.ca, jianhuapei98@gmail.com, halim@sce.carleton.ca.
Аннотация
Развертывание высокоскоростных беспилотных летательных аппаратов в трехмерных воздушных коридорах требует надежной координации физической кинематики полета и многоуровневых сетевых переключений. В то время как Deep Reinforcement Learning предлагает быстрое тактическое управление, ему не хватает стратегического рассуждения с нулевым количеством примеров, необходимого для быстрой адаптации к динамическим Integrated Terrestrial and Non-Terrestrial Networks. Напротив, LLM превосходно справляются с семантическим рассуждением, но страдают от высокой задержки вывода, что делает их непригодными для аэродинамического управления в реальном времени. Чтобы преодолеть этот разрыв, мы предлагаем новую иерархическую систему управления на основе LLM. Масштабная облачная LLM, развернутая на High-Altitude Platform Station, управляет глобальной балансировкой нагрузки в медленном временном масштабе, в то время как облегченные edge-LLM на отдельных беспилотных летательных аппаратах преобразуют локальные наблюдения в тактические подцели. Эти подцели направляют физический DRL-контроллер, работающий в быстром временном масштабе, для выполнения траекторий, свободных от столкновений и учитывающих переключения. Результаты моделирования показывают, что наша агентная архитектура значительно снижает частоту столкновений и улучшает совокупную пропускную способность системы по сравнению с существующими базовыми показателями..
Предметные указатели:
Беспилотные летательные аппараты (UAV), LLM, интегрированные наземные и неземные сети (ITNTN), управление хендовером.I Введение
Стремительное распространение беспилотных летательных аппаратов (UAV) стимулирует концептуализацию трехмерных воздушных магистралей — выделенных коридоров, предназначенных для обеспечения плотной и высокоскоростной автономной логистики [2]. Безопасная эксплуатация в таких условиях требует непрерывных каналов управления и контроля (C2) и телеметрии [9]. Для удовлетворения этих строгих требований к связности архитектуры 6G переходят к интегрированным наземным и неземным сетям (ITNTN) [7], используя высотные платформенные станции (HAPS) для дополнения зоны покрытия наземных базовых станций (TBS). Однако, поскольку UAV перемещаются между этими перекрывающимися уровнями покрытия на высоких скоростях, они неизбежно провоцируют частые сетевые переключения (HO) [13], что требует совместной оптимизации физической кинематики полета и надежности связи..
Хотя глубокое обучение с подкреплением (DRL) широко применяется для планирования траекторий БПЛА и ассоциации сот [3], оно по своей сути опирается на исследование методом проб и ошибок [9]. В многоагентных воздушных коридорах такое исследование часто приводит к локальной и жадной оптимизации, что может повлечь за собой системное истощение общих ресурсов. Нескоординированные агенты могут непреднамеренно перегрузить конкретные TBS или насытить ограниченную пропускную способность HAPS, что в конечном итоге поставит под угрозу как совокупную системную емкость, так и безопасность полетов [6, 10].
В последнее время интеграция генеративного ИИ, особенно LLM, стала трансформационным подходом для управления автономными транспортными средствами [5]. LLM обладают непревзойденными способностями к zero-shot рассуждениям, что позволяет адаптироваться к сложным миссиям и осуществлять глобальное стратегическое планирование [11]. Тем не менее, стандартный вывод LLM страдает от значительных задержек. Опора исключительно на LLM фундаментально несовместима с выполнением задач в быстром временном масштабе, требуемом для субмиллисекундных RF channel handovers и высокочастотного управления роторами [1, 12]. Преодоление разрыва между семантическими рассуждениями в медленном временном масштабе и физическим исполнением в быстром временном масштабе остается открытой проблемой..
Для преодоления этих ограничений в данной статье предлагается новая архитектура иерархической LLM с двумя временными шкалами, которая объединяет когнитивное рассуждение базовых моделей с быстрым исполнением DRL. Действительно, учитывая потенциал Agentic AI и проблемы задержек, присущие динамическим воздушным сетям, мы предлагаем здесь новую облачно-периферийную структуру, которая совместно оптимизирует мобильность UAV и управление передачей обслуживания. В частности, мы сначала формулируем задачу как иерархический многоцелевой частично наблюдаемый марковский процесс принятия решений (H-MO-POMDP), который строго учитывает высокоточную кинематику твердого тела в 3D и реалистичные ограничения пропускной способности ITNTN. Для решения этой сложной иерархии мы внедряем архитектуру с двумя временными шкалами на базе LLM. В частности, стратегический мета-контроллер (Qwen3.5-122B [15]), развернутый на HAPS, работает в медленном временном масштабе для определения глобальных политик балансировки нагрузки. Более того, в отличие от предыдущих исследований, которые полагались исключительно на DRL методом проб и ошибок, мы интегрируем здесь облегченные периферийные агенты (Qwen3.5-9B [15]) непосредственно на отдельные UAV. Последние генерируют когнитивные рефлексии для динамической настройки функций вознаграждения быстродействующей глубокой сети двойного Q-обучения (DDQN), успешно связывая семантическое рассуждение с физическим исполнением в реальном времени. Наконец, обширное моделирование в высокоточной 3D-физической среде демонстрирует, что предложенная структура под управлением LLM смягчает серьезные штрафы за столкновения и максимизирует пропускную способность системы, тем самым превосходя базовые показатели..
Оставшаяся часть данной статьи организована следующим образом. В разделе II описывается системная модель ITNTN, включая высокоточную трехмерную кинематику БПЛА и многоуровневую архитектуру связи. В разделе III задача совместной оптимизации формулируется как H-MO-POMDP. Предложенная двухуровневая иерархическая структура LLM и ее модули когнитивного рассуждения представлены в разделе IV. В разделе V приведены численные результаты и оценки производительности. Наконец, в разделе VI подводятся итоги статьи..
II Системная модель
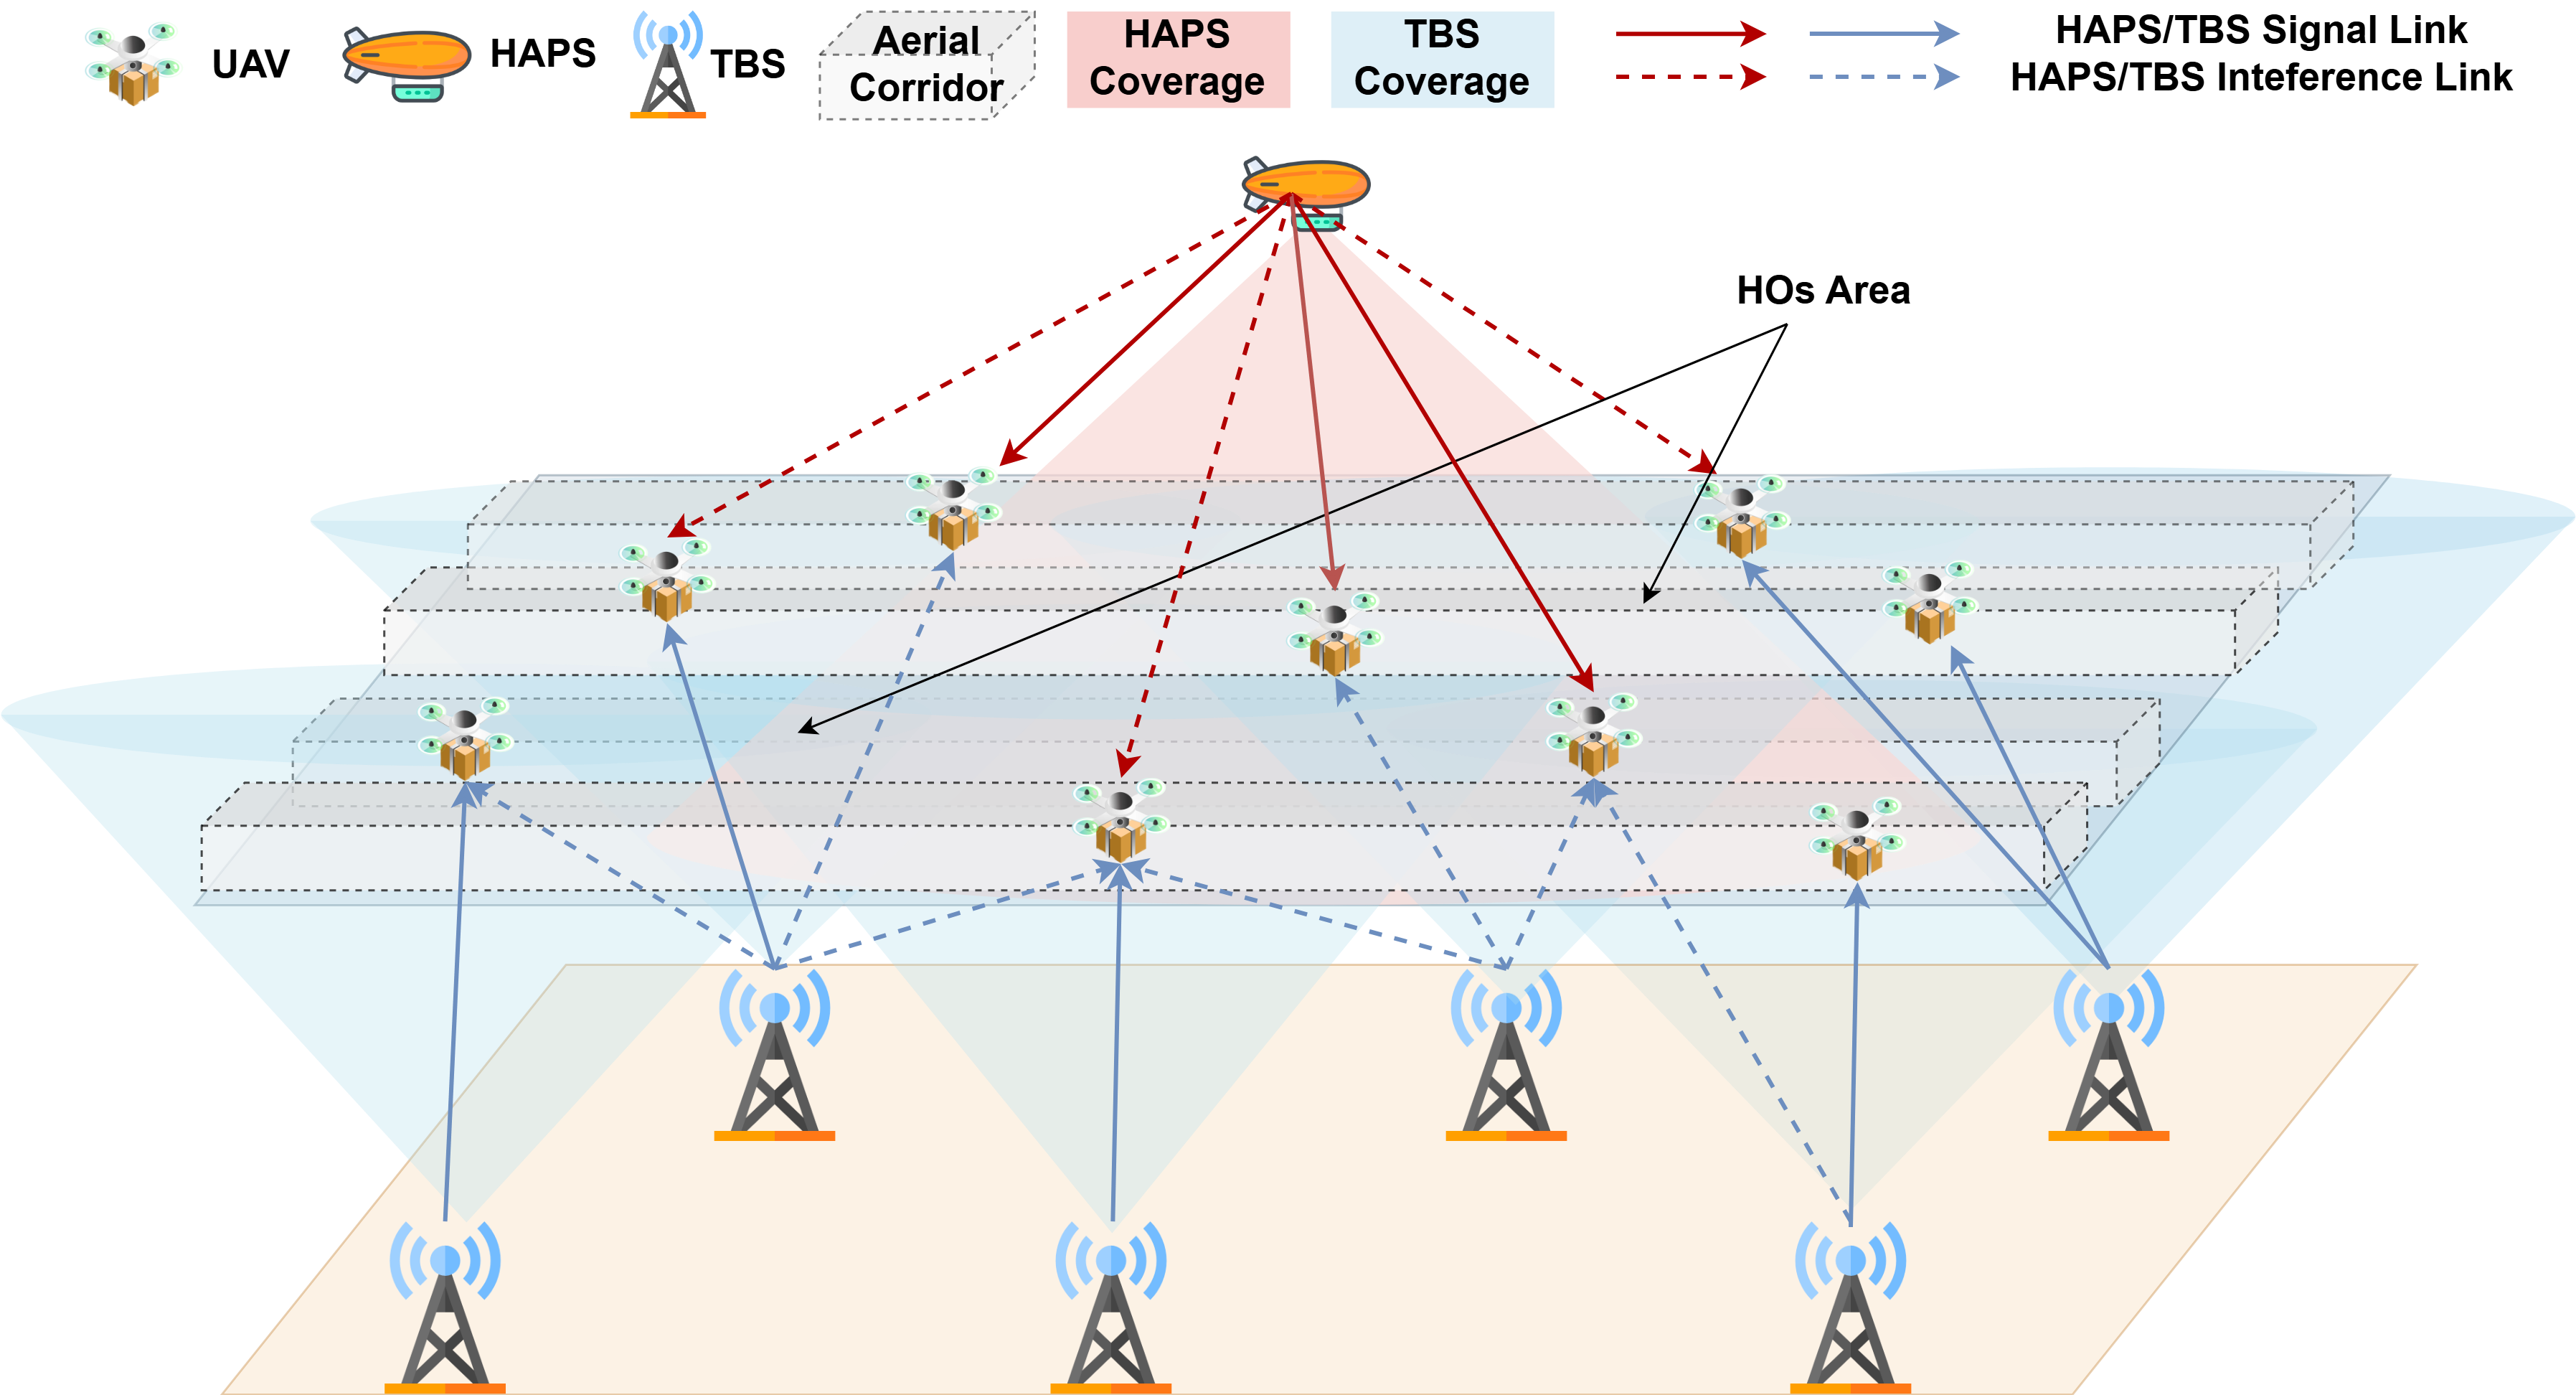
II-A Трехмерная воздушная магистраль и архитектура ITNTN
Как показано на рис. 1, мы рассматриваем динамическую трехмерную воздушную магистраль, где набор БПЛА, обозначаемых как , осуществляют навигацию в общем воздушном пространстве. Каждому БПЛА назначена независимая транзитная миссия к уникальной трехмерной целевой путевой точке , и он должен непрерывно корректировать свою высоту и курс для обхода препятствий и предотвращения столкновений..
Для поддержки критически важных задач C2 и телеметрии воздушное пространство покрывается ITNTN. Сеть включает в себя набор TBS, обозначаемых как , и одну HAPS, обозначаемую . БПЛА может подключаться к любому обслуживающему узлу , однако высокоскоростное перемещение инициирует процедуры handover..
II-B Модель связи
Для оценки надежности каналов управления и передачи данных (C2) мы формулируем отношение сигнал/шум плюс помеха (SINR)[4]. Пусть обозначает линейное усиление мощности канала между БПЛА и обслуживающим узлом в момент времени , включающее как крупномасштабные потери при распространении, так и мелкомасштабные рэлеевские замирания. Принимаемое значение SINR по нисходящей линии связи на БПЛА определяется как
| (1) |
где — это мощность передачи узла , — спектральная плотность мощности шума, а — выделенная полоса пропускания. Член представляет собой совокупную интерференцию от других активных передающих узлов в ярусе.
Достижимая скорость передачи данных для БПЛА рассчитывается как
| (2) |
Чтобы штрафовать за задержки и потерю пакетов, связанные с частым переключением сети, мы определяем взвешенную скорость передачи данных с учетом переключения как
| (3) |
где — это бинарный индикатор, который равен , если передача обслуживания происходит в момент времени , а — коэффициент штрафа за передачу обслуживания. Кроме того, HAPS ограничена максимальной совокупной емкостью , а любой узел имеет емкость ассоциации пользователей , .
II-C Кинематическая модель
Мы используем высокоточную модель кинематики твердого тела в 3D, где физическое состояние БПЛА в момент времени определяется его 3D-позицией и линейной скоростью . Система развивается с быстрым дискретным временным шагом (например, =0.05 с), а непрерывные обновления кинематического состояния регулируются [8]
| (4) |
| (5) |
где — масса БПЛА, — вектор ускорения свободного падения, а — аэродинамическое сопротивление. Вектор суммарной тяги вычисляется на основе скоростей вращения (RPM) четырех отдельных роторов в режиме реального времени. Для обеспечения безопасности полета налагается строгий штраф за столкновение, если трехмерное евклидово расстояние между любыми двумя БПЛА опускается ниже физического порога безопасности: для любого .
III Постановка задачи
Для учета сопряженной динамики полетной кинематики и сетевых переключений в различных операционных временных масштабах мы формулируем систему как H-MO-POMDP, состоящую из глобального мета-контроллера с медленным временным масштабом (HAPS) и тактических граничных агентов с быстрым временным масштабом (UAVs).
III-A Пространства состояний и наблюдений
Из-за ограниченного радиуса действия датчиков отдельных БПЛА, глобальное состояние окружающей среды является частично наблюдаемым. На быстром тактическом временном интервале каждый БПЛА получает локальное наблюдение , определяемое как
| (6) |
где — это множество соседних БПЛА в пределах радиуса действия датчиков, — текущий обслуживающий узел, а — взвешенная скорость передачи данных с учетом процедуры передачи обслуживания. Напротив, на медленном стратегическом временном интервале , HAPS получает глобальное мета-наблюдение , включающее совокупную нагрузку на каждую TBS, доступную пропускную способность транспортной сети HAPS и пространственное распределение роя БПЛА..
III-B Гибридные пространства действий
Пространство действий охватывает как непрерывные физические элементы управления, так и дискретные сетевые решения следующим образом.
III-B1 Стратегическое действие HAPS
На каждом макрошаге агент HAPS выдает дискретное метадействие . Эти директивы транслируются в конкретные зоны высокой плотности трафика для обеспечения балансировки нагрузки до того, как емкость узлов будет исчерпана..
III-B2 Тактическая деятельность БПЛА
На каждом микрошаге БПЛА выполняет совместное гибридное действие . Непрерывное действие по перемещению регулирует частоту вращения четырех отдельных роторов для физической 3D-навигации. Одновременно с этим дискретное телекоммуникационное действие выбирает целевой обслуживающий узел, инициируя передачу обслуживания, если .
III-C Многоцелевые функции вознаграждения
Для одновременной оптимизации мобильности и связности мы определяем скаляризованные структуры вознаграждения для уровней периферийных вычислений и HAPS ⟦BROKEN_K0⟧.
III-C1 Награда для периферийных вычислительных узлов БПЛА
Цель БПЛА заключается в безопасной навигации к своей цели при поддержании надежного канала управления и связи. Награда сформулирована как
| (7) |
где поощряет движение вперед, наказывая при этом за агрессивные, энергозатратные маневры роторов. Член максимизирует скорость передачи данных, наказывая за переключения между базовыми станциями. Наконец, применяет значительный отрицательный штраф в случае нарушения безопасной дистанции . Весовые коэффициенты балансируют вознаграждения и штрафы..
III-C2 Награда HAPS
Целью мета-контроллера HAPS является максимизация совокупной пропускной способности системы при соблюдении ограничений емкости узлов. Его вознаграждение определяется как
| (8) |
где — количество БПЛА, в настоящее время связанных с узлом . Второй член значительно штрафует любую стратегию, которая приводит к перегрузке сети (то есть превышению емкости ), сбалансированную весами . Чтобы учесть сопряженную динамику управления трехмерной траекторией и ассоциации сот с учетом передачи обслуживания, мы определяем задачу совместной оптимизации ниже. Цель состоит в максимизации совокупной полезности системы при соблюдении физической кинематики и ограничений пропускной способности сети..
|
|
(9) |
В (), и () обозначают совместную гибридную стратегию действий и динамически настраиваемые веса многоцелевой функции вознаграждения для всех БПЛА на протяжении операционного горизонта соответственно. представляет собой вектор гибридных действий. C1 гарантирует, что обновления траектории соответствуют модели физики твердого тела в 3D, определенной в (4)-(5). C2 поддерживает физическую безопасную дистанцию между любыми двумя БПЛА. C3 гарантирует, что каждый БПЛА связан ровно с одним обслуживающим узлом (TBS или HAPS) в любой момент времени . C4 ограничивает количество связанных пользователей на узел его емкостью для предотвращения перегрузки сети. C5 определяет симплекс для весов когнитивного вознаграждения , настраиваемых с помощью edge-LLM..
Задача представляет собой высоконевыпуклую смешанно-целочисленную нелинейную задачу оптимизации, связывающую кинематику полета и воздушную связь. Для обеспечения управления в режиме реального времени мы декомпозируем эту оптимизацию с помощью двухуровневой иерархической многоцелевой структуры POMDP, делегируя конкретные ограничения отдельным когнитивным уровням LLM, как описано в следующем разделе..
IV Предложенная иерархическая структура LLM
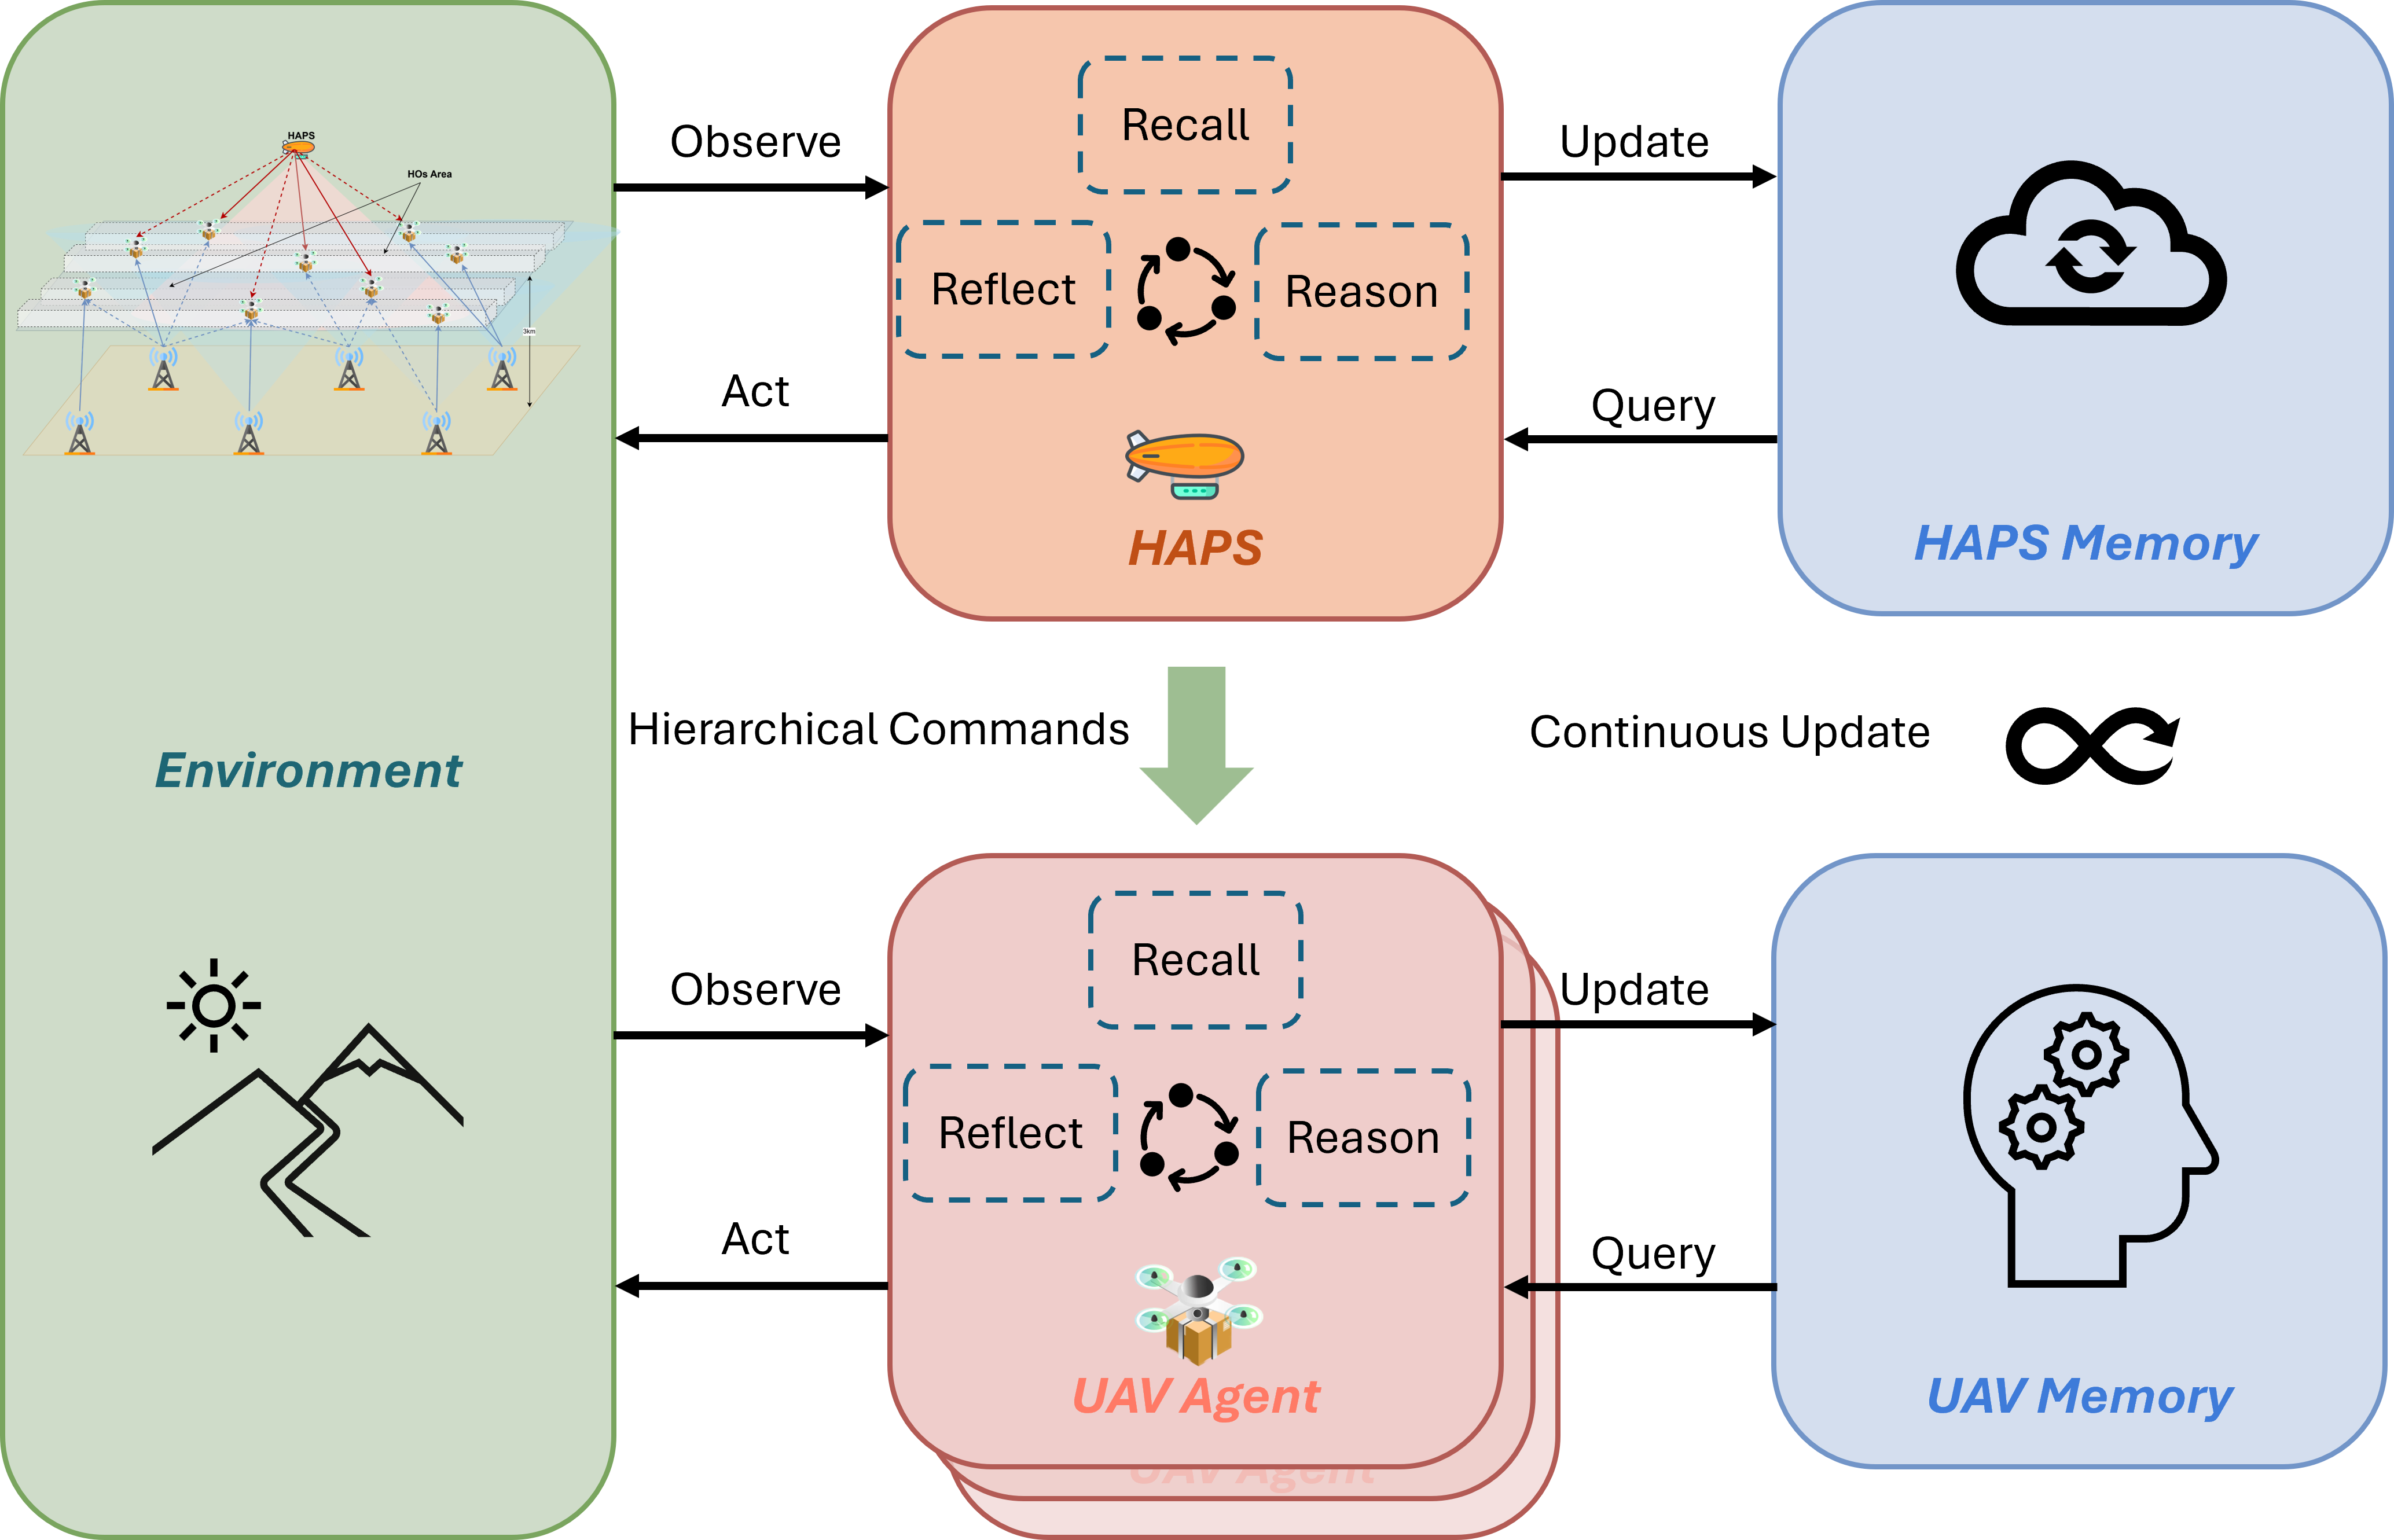
Чтобы преодолеть разрыв в задержке между семантическим рассуждением и аэродинамическим управлением в реальном времени, мы предлагаем архитектуру Cloud-Edge Agentic, как показано на рис. 2. Данная структура разделяет процесс принятия решений на три различных временных масштаба: 1) медленный стратегический мета-масштаб (), 2) промежуточный тактический масштаб рассуждений () и 3) быстрый масштаб физического исполнения (.⟧).
IV-A Облачный мета-контроллер HAPS
На самом высоком уровне иерархии HAPS выступает в роли глобального оркестратора. Поскольку глобальная балансировка нагрузки требует сложного пространственного мышления во всей ITNTN, мы развертываем большую базовую модель, а именно Qwen3.5-122B, размещенную в облачном вычислительном кластере HAPS. Работая на уровне с, мета-контроллер HAPS оценивает глобальное наблюдение . В частности, если количество пользователей, связанных с конкретной TBS , близко к , LLM генерирует стратегические директивы zero-shot (), принуждая конкретных периферийных агентов UAV переключать свои каналы C2 на соседние TBS или HAPS.
IV-B Агент на периферии БПЛА
Каждый БПЛА оснащен легковесной периферийной LLM (а именно Qwen3.5-9B), которая работает при с. Когнитивный периферийный агент преобразует локализованное наблюдение () в структурированную текстовую подсказку. Вместо вывода прямых команд управления двигателями, периферийная LLM выполняет когнитивную рефлексию, то есть, если БПЛА испытывает серьезные штрафы при передаче обслуживания или находится близко к порогу столкновения (), LLM динамически корректирует веса многоцелевого вектора вознаграждения. Таким образом, это семантическое рассуждение направляет базовый DRL, смещая его приоритет между агрессивным движением вперед и консервативной безопасностью..
IV-C Выполнение DRL в быстром масштабе времени
На самом нижнем уровне DDQN функционирует с физическим временным масштабом с (20 Гц). DDQN получает динамические веса вознаграждения, генерируемые edge-LLM, и выполняет непрерывные команды управления двигателями () и дискретные действия по переключению между базовыми станциями (). Перекладывая семантическое рассуждение на LLM, DDQN действует исключительно как высокоскоростной рефлексивный физический контроллер..
Полный ход выполнения обобщен в алгоритме 1.
для каждый физический микрошаг делать
IV-D Дискретизация состояний и проектирование промптов
Чтобы преодолеть разрыв между численной кинематикой и семантическим рассуждением граничной LLM Qwen3.5-9B, мы используем структурированную методологию проектирования промптов. Прямая подача массивов чисел с плавающей запятой высокой точности (например, ) часто ухудшает рассуждения LLM и увеличивает задержку вывода. Поэтому мы дискретизируем непрерывное наблюдение в семантические языковые дескрипторы, обозначенные как . В частности, трехмерное относительное расстояние до соседних БПЛА (, ) классифицируется по предопределенным семантическим зонам: Безопасная (), Предупреждающая () и Критическая (). Аналогичным образом, состояние сети с учетом передачи обслуживания отображается как Стабильное (когда Мбит/с, что указывает на отсутствие перегрузки канала), Ухудшенное (когда Мбит/с, что указывает на насыщение пропускной способности) или Передача обслуживания (когда , вызванное значительным штрафом во время переключения сети).).
Для улучшения zero-shot обобщения LLM мы используем выбор примеров few-shot на основе расстояния. Вместо использования статических промптов, периферийный агент извлекает набор исторических состояний из своего локального буфера памяти , которые демонстрируют кратчайшее евклидово расстояние до текущего кинематического состояния. Успешные конфигурации весов вознаграждения из этих извлеченных состояний добавляются в качестве примеров in-context learning..
Итоговый синтезированный промпт строго следует модульному шаблону: [Роль], [Текущее состояние], [Исторические примеры] и [Задача]. Иллюстративный пример сгенерированного промпта представлен ниже:
[[Роль]: Вы являетесь автономным периферийным агентом БПЛА, осуществляющим навигацию в трехмерном коридоре. Ваша задача — динамически настраивать веса многоцелевой функции вознаграждения DRL для эффективности транзита, надежности сети и безопасности. [Текущее состояние]: Расстояние до цели сокращается. Соседний БПЛА-3 находится в зоне предупреждения (7,2 м). Сетевое соединение с TBS-2 стабильно. [Исторический пример]: Когда сосед находился в зоне предупреждения, а соединение было стабильным, оптимальными весами были , чтобы отдать высокий приоритет предотвращению столкновений по сравнению с движением вперед. [Задача]: На основе текущего состояния выведите обновленные веса скаляризации в точном формате [w1, w2, w3]. Не выводите разговорный текст или пояснения..
V Численные результаты
V-A Настройка моделирования
Мы оцениваем предложенную агентную облачно-периферийную структуру, используя высокоточный 3D-симулятор физики мультироторных систем на базе gym-pybullet-drones [8]. Среда ITNTN состоит из 4 TBS и 1 HAPS, обслуживающих ряд UAV . LLM на базе Qwen взаимодействуют с физической симуляцией посредством структурированных вызовов API. Подробные параметры симуляции сведены в таблицу I.
Ключевой проблемой при применении генеративного ИИ в высокоскоростных сетях БПЛА является задержка вывода LLM, которая несовместима с быстрым временем реакции, необходимым для аэродинамической стабилизации. Для решения этой проблемы мы приняли двухуровневую архитектуру HAPS–UAV с разделенными когнитивными и управляющими временными шкалами. На периферии БПЛА мы рассматриваем 4-битную квантованную Qwen3.5-9B, развернутую на платформе edge-AI. При средней скорости генерации около токенов/с структурированный промпт и лаконичный вывод дают расчетную периферийную задержку в с. На уровне HAPS более крупный мета-контроллер Qwen3.5-122B работает на высокопроизводительном кластере GPU, при этом общая задержка моделируется как с.
Эти значения математически обосновывают предложенную нами иерархию временных шкал. Быстрый аэродинамический контур работает с частотой с, что делает прямое LLM-вывод в контуре управления физически нецелесообразным. Поэтому мы установили интервал когнитивной рефлексии на уровне БПЛА равным с, а интервал координации на уровне HAPS — с, строго соблюдая аппаратные ограничения и . В течение одного интервала вывода edge-LLM контроллер DDQN по-прежнему может выполнить 20 быстрых непрерывных шагов управления, используя последнюю подтвержденную конфигурацию вознаграждения. Такая асинхронная декомпозиция позволяет избежать сбоев, вызванных вычислительными затратами, обеспечивая при этом надежное стратегическое рассуждение LLM..
В наших симуляциях мы сравниваем предложенную иерархическую структуру LLM-DDQN с базовым методом «DDQN» [13, 16], который опирается на исследование методом проб и ошибок без когнитивной рефлексии LLM или балансировки нагрузки HAPS, а также с методом «Envelope MORL», предложенным в [14]⟧.
| Parameter | Value |
|---|---|
| Physics & Airspace Parameters | |
| Simulation airspace volume | m3 |
| Number of UAVs () | |
| UAV Mass () | kg |
| Physical safety separation () | m |
| Gravity () | m/s2 |
| Control frequency () | Hz ( s) |
| ITNTN Communication Parameters | |
| Number of TBSs () | |
| HAPS altitude | km |
| Carrier frequencies | GHz (HAPS), GHz (TBS) |
| Node bandwidth () | MHz |
| HAPS total capacity () | Mbps |
| Node transmit power () | dBm ( mW) |
| TBS peak antenna gain () | dBi |
| Node capacity quota () | concurrent users |
| Path loss exponents | , |
| Rician LoS factor | dB |
| Noise power spectral density () | dBm/Hz |
| Algorithm & Cognitive Parameters | |
| HAPS Meta-Controller LLM | Qwen3.5-122B |
| UAV Edge-Agent LLM | Qwen3.5-9B |
| HAPS strategic timescale () | s |
| UAV LLM reasoning interval () | s |
| Edge inference latency () | s |
| Cloud inference latency () | s |
| Reflection trigger threshold () | |
| Collision crash penalty () | |
| HAPS reward weights () | |
| UAV reward weights () | |
| Handover penalty coeff. () | |
| Energy penalty coeff. () | |
| Memory retrieval size () | experiences |
| DDQN learning rate | |
| Discount factor () | |
| Target update frequency | steps |
V-B Результаты моделирования
Для оценки устойчивости в перегруженных воздушных коридорах на рис. 3 представлены ключевые показатели, а именно: вознаграждение за транспортировку, время выживания, вознаграждение за связь и вероятность HO..
На рис. 3(a) и рис. 3(b) проиллюстрирована сходимость вознаграждения за транспортировку и количества шагов выживания соответственно. Как показано на рис. 3(a), традиционный базовый алгоритм DDQN обучается быстро, но достигает насыщения в субоптимальном локальном минимуме. Это связано с тем, что стандартный DRL испытывает трудности при работе с обширным и разреженным пространством исследования, объединяющим 3D-кинематику и выбор сети. Напротив, предложенная структура демонстрирует более крутую и устойчивую кривую обучения, обгоняя DDQN примерно на 1500-м эпизоде и достигая наивысшего установившегося вознаграждения..
Это превосходство напрямую связано с физической безопасностью, что отражено в количестве шагов выживания на рис. 3(b). В частности, в DDQN серьезные столкновения приводят к преждевременному завершению. Поскольку последний полагается только на метод проб и ошибок, он страдает от частых ранних столкновений. Напротив, когда БПЛА в нашей структуре обнаруживает состояние высокого риска, бортовая edge-LLM немедленно изменяет веса скаляризации посредством когнитивной рефлексии, чтобы приоритизировать штраф за столкновение (). Это руководство zero-shot позволяет избежать преждевременных завершений и дает предлагаемой структуре возможность сходиться к почти максимальной длине эпизода..
Рис. 3(c) оценивает коммуникационное вознаграждение как функцию от количества TBS. Изначально, при отсутствии TBS, БПЛА подключены к HAPS без какого-либо затухания качества канала. Однако внедрение одной или двух TBS создает серьезные помехи и несогласованные возможности для передачи обслуживания между TBS и HAPS, что вызывает резкое падение коммуникационного вознаграждения для всех методов. Тем не менее, по мере добавления большего количества TBS для обеспечения непрерывного покрытия вознаграждение восстанавливается и достигается лучшая координация. Предложенная структура стабильно поддерживает наивысшее коммуникационное вознаграждение, поскольку мета-контроллер HAPS интеллектуально координирует ассоциации для минимизации межъярусных помех..
На рис. 3(d) показана вероятность передачи обслуживания при увеличении плотности роя БПЛА от до . По мере перегрузки воздушного пространства базовые агенты DRL жадно преследуют сильнейший мгновенный сигнал, что приводит к хаотичным высокочастотным передачам обслуживания. Напротив, мета-контроллер HAPS прогнозирует перегрузку и выдает директивы по пространственной разгрузке в режиме zero-shot. Такая стратегическая координация успешно подавляет ненужные переключения в сети, обеспечивая предложенной структуре самую низкую и стабильную вероятность передачи обслуживания при любой плотности трафика..
VI Заключение
В данной статье мы предложили структуру Cloud-Edge Agentic AI для совместной оптимизации трехмерной мобильности БПЛА и управления передачей обслуживания в ITNTN. За счет разделения стратегического обоснования и быстрого физического управления в различных временных масштабах, данная структура связывает рассуждения LLM с выполнением DRL в режиме реального времени. Мета-контроллер на базе HAPS снижает перегрузку сети, в то время как edge-LLM улучшают локальное принятие решений с учетом безопасности. Результаты моделирования показывают явные преимущества перед традиционным DRL в вопросах безопасности, эффективности обучения и пропускной способности системы. В будущих работах будет исследована легковесная квантовизация для снижения задержки вывода на периферии..
Список литературы
- ⟦[1] Дж. Чен и др. (2021) BDFL: метод децентрализованного федеративного обучения с устойчивостью к византийским отказам для автономных транспортных средств. IEEE Trans. Veh. Technol. 70 (9), стр. 8639–8652. Цитируется в: §I.
- ⟦[2] Н. Шериф и др. (2021) Трехмерная воздушная магистраль: ключевой фактор трансформации розничной торговли. IEEE Commun. Mag. 59 (9), стр. 65–71. Цитируется в: §I.
- ⟦[3] Н. Шериф и др. (2024) Планирование траектории грузовых БПЛА и ассоциация с сотами на основе RL для минимизации хендоверов, разрывов связи и энергопотребления. IEEE Trans. Veh. Technol. 73 (5), стр. 7304–7309. Внешние ссылки: Document Цитируется: §I⟧.
- ⟦[4] Н. Шериф (2022) Сотовые беспилотные летательные аппараты в беспроводных сетях следующего поколения. Диссертация на соискание степени доктора философии, Университет Оттавы. Цитируется в: §II-B.
- ⟦[5] Л. Донг и др. (2026) Воздушный агентный AI: Синергия LLM и SLM для низковысотных беспроводных сетей. arXiv препринт arXiv:2603.22866. Цитируется в: §I.
- ⟦[6] У. Джаафар и Х. Яникомероглу (2020) Динамика БПЛА с лазерной зарядкой: взгляд со стороны аккумулятора. IEEE Internet Things J. 8 (13), стр. 10573–10582. Цитируется в: §I.
- ⟦[7] У. Джаафар и Х. Яникомероглу (2022) HAPS-ITS: обеспечение будущих интеллектуальных транспортных систем на трансконтинентальных автомагистралях. IEEE Commun. Mag. 60 (10), стр. 80–86. Внешние ссылки: Document Цитируется: §I.
- ⟦[8] Дж. Панерати и др. (2021) Обучение полету — среда gym с физическим движком pybullet для обучения с подкреплением многоагентного управления квадрокоптерами. В сб.: Proc. IEEE/RSJ Int. Conf. Intell. Robots Syst. (IROS), стр. 7512–7519. Цитируется в: §II-C, §V-A.
- ⟦[9] З. Ян и др. (2023) Управление скоростью группы БПЛА с предотвращением столкновений и ассоциацией сот с учетом передачи обслуживания: DRL с ветвлением действий. В сб. трудов IEEE Global Commun. Conf. (GLOBECOM), стр. 5067–5072. Цитируется в: §I, §I.
- ⟦[10] З. Ян и др. (2025) Вариационная квантовая оптимизация на основе CVaR для ассоциации пользователей в транспортных сетях с поддержкой хендовера. В сб.: IEEE Int. Conf. Commun. (ICC), стр. 6088–6093. Цитируется в: §I.
- ⟦[11] З. Ян и др. (2025) Иерархическое и совместное управление на основе LLM для движения и связи нескольких БПЛА в интегрированных наземных и неземных сетях. arXiv preprint arXiv:2506.06532. Цитируется в: §I.
- ⟦[12] З. Ян и др. (2025) Гибридная оптимизация связи V2I и автономного вождения на основе LLM-DDQN. IEEE Wireless Commun. Lett. 14 (4), стр. 1214–1218. Внешние ссылки: Document Цитируется: §I⟧.
- ⟦[13] З. Ян и Х. Табассум (2022) Обучение с подкреплением для совместного выбора сети V2I и стратегий автономного вождения. В сб. трудов IEEE Global Commun. Conf. (GLOBECOM), стр. 1241–1246. Внешние ссылки: Document Цитируется в: §I, §V-A.
- ⟦[14] З. Ян и Х. Табассум (2025) Обобщенное многоцелевое обучение с подкреплением с использованием конвертных обновлений в транспортных сетях с поддержкой URLLC. IEEE Trans. Veh. Technol. 74 (11), стр. 17666–17682. Внешние ссылки: Document Цитируется: §V-A⟧.
- ⟦[15] А. Янг и др. (2025) Технический отчет Qwen3. Препринт arXiv:2505.09388. Цитируется в: §I.
- ⟦[16] К. Чжан и др. (2024) Набор инструментов на основе машинного обучения для программируемых плоскостей данных p4. IEEE Trans. Netw. Serv. Manag. 21 (4), стр. 4450–4465. Цитируется в: §V-A.