FORCE-Bench: бенчмарк, набор данных и инструментарий оценки для агентного AI в корпоративных финансах


Аннотация
Недавние достижения в области LLM ускорили внедрение агентных систем в операционные финансы. Существующие бенчмарки делают упор на измерение общих возможностей, следование инструкциям или безопасность, однако лишь немногие из них напрямую затрачивают рабочие процессы операционных финансов, для автоматизации которых сейчас развертываются агентные системы. Финансовым специалистам требуются агенты, которые не только предоставляют фактически верную и должным образом обоснованную информацию, но и обеспечивают ее проверяемость, а также последовательное соблюдение правил и ограничений предметной области операционных финансов. Мы представляем FORCE-Bench, который содержит 251 экспертно аннотированный запрос и оценивает ответы с использованием системы на основе рубрик, откалиброванной в соответствии с требованиями предметной области операционных финансов, по восьми измерениям: точность, цитирование, ясность, глубина, обоснованность, актуальность, релевантность и структура. FORCE-Bench оценивает агентные системы по трем типам задач: исследование финансовых обязательств (запросы к ERP системам для получения данных о дебиторской и кредиторской задолженности), исследование эффективности финансовых организаций (ответы на вопросы с временными ограничениями на основе публичной отчетности и рыночных данных) и создание бизнес-сводок (синтез отчетов о деятельности компаний из нескольких источников). Чтобы отразить реальные условия развертывания, мы оцениваем нашего специализированного агента, а также агентные системы общего назначения в условиях общего доступа к инструментам и ограничений по задержке. Результаты показывают, что агентные системы общего назначения не всегда соответствуют требованиям к качеству в финансовой сфере при операционных ограничениях, в то время как специализированный Finance Agent для Microsoft 365 Copilot является более надежным по всем измерениям. Мы выпускаем набор данных, рубрики, инструментарий и код анализа в качестве открытого программного обеспечения для поддержки воспроизводимого сравнения и адаптации к другим средам корпоративных финансов..
Ключевые слова Agentic AI, Finance, Enterprise Resource Planning, Benchmark, Evaluation
1 Введение
Растет интерес к потенциалу AI агентов — систем, которые автономно рассуждают, извлекают информацию и действуют с помощью инструментов для выполнения многошаговых задач, — способных открыть новые уровни автоматизации в различных отраслях. Финансы являются одной из наиболее перспективных областей для таких систем, однако реализация этого потенциала требует, чтобы производительность агентов измерялась способом, соответствующим данной предметной области и отвечающим ожиданиям финансовых специалистов. Бенчмарки LLM общего назначения, такие как MMLU (Hendrycks et al., 2020), BIG-Bench (Srivastava et al., 2023), MT-Bench (Zheng et al., 2023) и TruthfulQA (Lin et al., 2022), были разработаны для оценки широких возможностей моделей и их согласованности, а не того, может ли агент надежно обслуживать финансового специалиста в рамках ограничений и ожиданий реальных операций. Существующие агентные бенчмарки, включая AgentBench (Liu et al., 2024), -Bench (Yao et al., 2024), ReAct (Yao et al., 2022b) и ToolBench (Yu et al., 2026), закладывают важные основы для оценки интерактивных систем, использующих инструменты, но они ориентированы на сценарии общего назначения или розничной торговли, а не на рабочие процессы, источники данных и профессиональные стандарты финансовой сферы. Мы представляем FORCE-Bench (Financial Obligations, Research, and Composition Evaluation) — ориентированную на рабочие процессы систему оценки, разработанную специально для AI агентов, работающих в операционных финансах. Бенчмарк предоставляет: (i) входные запросы, взятые из реалистичных финансовых сценариев, (ii) экспертно аннотированные эталонные ответы, (iii) систему метрик на основе рубрик с определениями оценок по каждому измерению и (iv) инструментарий для оценки, который другие могут использовать для тестирования своих агентов на нашем наборе данных или на своих собственных наборах данных..
Важно отметить, что инструментарий оценки отделен от любой конкретной реализации агента: специалисты могут применять критерии оценки к собственным наборам данных, настраивать конфигурацию агента или изменять гиперпараметры в соответствии со своими требованиями к оценке или развертыванию..
Бенчмарк охватывает 251 экспертно аннотированный запрос по трем типам финансовых задач: исследование финансовых обязательств (запросы к внутренним ERP системам для получения данных о дебиторской и кредиторской задолженности), исследование эффективности финансовых организаций (ответы на вопросы с временными ограничениями о публичных компаниях на основе отчетности и рыночных данных) и создание бизнес-сводок (синтез структурированных отчетов о деятельности компаний из нескольких источников). Вместо измерения успеха как бинарного показателя прохождения/непрохождения — как в -Bench (Yao et al., 2024) и аналогичных работах — мы оцениваем ответы по восьми критериям, основанным на ожиданиях финансовых специалистов: точность, цитирование, ясность, глубина, обоснованность, актуальность, релевантность и структура. Каждый критерий операционализируется с помощью тщательно отобранных утверждений, что позволяет детально понять, в чем система преуспевает, а в чем она не дотягивает. Этот нюансированный взгляд необходим лицам, принимающим решения о внедрении агентных систем в рабочие процессы операционных финансов: недостаточно знать, что система справляется или терпит неудачу — необходимо понимать, почему и по каким критериям..
Остальная часть данной статьи организована следующим образом. Раздел 2 содержит обзор смежных работ по бенчмаркам для LLM и агентов. Раздел 3 описывает три столпа бенчмарка: набор данных запросов (раздел 3.1), систему оценки на основе рубрик (раздел 3.2), а также агентные среды и статистическую методологию, используемые для их сравнения (раздел 3.4). Затем мы представляем экспериментальные результаты, за которыми следуют заключительные замечания..
Мы надеемся, что FORCE-Bench послужит полезным ресурсом для исследователей и практиков, занимающихся разработкой и оценкой AI агентов для финансовой сферы. Набор данных, критерии оценки, реализации инструментария и скрипты для анализа находятся в открытом доступе по адресу https://github.com/microsoft/FinanceBenchmark.
2 Связанные работы
2.1 Бенчмарки LLM
Существующие бенчмарки LLM оценивают возможности моделей по различным измерениям, однако немногие из них затрагивают специфическую для предметной области надежность и эксплуатационную устойчивость, необходимые для внедрения на уровне предприятия. Большинство из них фокусируются на статических знаниях, общем следовании инструкциям или безопасности в отрыве от контекста, тогда как наши условия делают упор на последовательное соблюдение правил, обоснованный поиск информации и объяснения с опорой на источники для финансовых операций. Мы классифицируем предыдущие работы на четыре категории:
Бенчмарки общих возможностей.
Бенчмарки, такие как MMLU Hendrycks et al. (2020), BIG-Bench Srivastava et al. (2023), MATH Hendrycks et al. (2021) и GSM8K Cobbe et al. (2021), оценивают фундаментальные знания моделей и их способность к рассуждению в широких областях. Они в основном оценивают возможности выполнения задач за один проход, а не сквозное интерактивное завершение задач с учетом предметных ограничений и требований к доказательствам, основанным на инструментах. Наша работа выходит за рамки оценки изолированных возможностей, чтобы измерить, могут ли модели надежно выполнять реалистичные финансовые рабочие процессы, соблюдая правила предметной области и ссылаясь на авторитетные источники..
Следование инструкциям и качество.
Бенчмарки, такие как MT-Bench Zheng et al. (2023) и AlpacaEval Li et al. (2023), оценивают способность моделей следовать сложным инструкциям и создавать высококачественные результаты. Хотя они фиксируют общее соблюдение инструкций, они не измеряют систематически качественные атрибуты в конкретной предметной области (например, надлежащее финансовое цитирование, точное происхождение расчетов, соблюдение нормативных требований). Наш бенчмарк включает эти профессиональные качественные измерения, оценивая, могут ли агенты соответствовать специфическим стандартам, требуемым финансовыми специалистами для надежной поддержки принятия решений..
Фактологичность и достоверность.
TruthfulQA Lin et al. (2022), FactKG Kim et al. (2023) и бенчмарки на понимание прочитанного, такие как SQuAD Rajpurkar et al. (2016), оценивают смежные аспекты фактической надежности, включая правдивость при ответах на провокационные запросы, верификацию фактов и ответы на вопросы на основе доказательств. В отличие от этих бенчмарков, наш бенчмарк оценивает способность агентов поддерживать обоснованность и точность на протяжении сложных рабочих процессов с множественными этапами извлечения данных и выбором вызовов инструментов..
Безопасность и согласование.
Ориентированные на безопасность оценки и работы по выравниванию, включая SafetyBench Zhang et al. (2024), ToxiGen Hartvigsen et al. (2022) и Constitutional AI Bai et al. (2022), оценивают вредоносные выходные данные и соответствие человеческим ценностям. Хотя они необходимы для моделей общего назначения, они не решают специфические проблемы доверия и надежности в корпоративной среде; например, соблюдают ли агенты последовательно политики предметной области, правильно ли интерпретируют нормативные ограничения и прозрачно ли признают ограничения данных. Наш бенчмарк нацелен на эти аспекты операционного доверия в предметной области наряду с безопасностью..
2.2 Бенчмарки, ориентированные на финансы
Усилия по оценке, ориентированные на финансы, быстро расширяются, но они делают акцент на иных сегментах проблемного пространства, нежели наша среда, ориентированная на рабочие процессы. FinanceBench (Islam et al., 2023) установил важный базовый уровень для финансового QA с открытой книгой, содержащий 10 231 вопрос о публичных компаниях и строки доказательств, демонстрируя, что мощные пограничные модели все еще испытывают трудности с фактологией в финансовой предметной области. Однако его дизайн сосредоточен на одноходовом QA по публичным документам, а не на корпоративных рабочих процессах, основанных на ERP, или синтезе отчетов из нескольких источников..
BloombergGPT (Wu et al., 2023) усовершенствовала оценку специализированных моделей в предметной области путем объединения открытых финансовых задач с внутренними корпоративными бенчмарками и показала, что предварительное обучение на смешанных доменах может улучшить финансовые показатели без ущерба для общих возможностей. Тем не менее, эта методология оценки привязана к исследованию по разработке моделей и частично проприетарным наборам бенчмарков, что ограничивает возможность прямого повторного использования в качестве открытого стандартизированного агентного бенчмарка..
FinBen (Xie et al., 2024) расширил оценку финансовых LLM до 36 наборов данных и 24 задач, охватывающих извлечение, QA, генерацию, прогнозирование и принятие решений. Эта широта крайне ценна для сравнения моделей на уровне ландшафта, но она отдает приоритет широкому охвату задач, а не операционной реалистичности на уровне предприятия, и не фокусируется на поведении агентов, основанном на ERP, в условиях ограничений развертывания..
2.3 Бенчмарки агентов
Недавние бенчмарки начали затрагивать оценку агентов, фокусируясь на интерактивном выполнении задач в разнообразных средах. Большинство из них делают упор на успешность выполнения задач или метрики возможностей (например, function calling, reasoning, navigation), в то время как наши условия добавляют измерения профессионального качества для финансовых рабочих процессов: точность, citations, ясность, глубина, обоснованность, актуальность, релевантность и структура. Мы классифицируем соответствующие бенчмарки агентов следующим образом:
Бенчмарки интерактивной среды.
AgentBench Liu et al. (2024), WebShop Yao et al. (2022a) и ScienceWorld Wang et al. (2022) предоставляют разнообразные среды моделирования для оценки агентов. AgentBench охватывает 8 различных сред (просмотр веб-страниц, запросы к базам данных, ввод-вывод файлов и т. д.); WebShop имитирует электронную коммерцию с 1,18 миллиона реальных товаров; ScienceWorld проверяет научное мышление в интерактивных сценариях. Несмотря на свою ценность, эти бенчмарки в основном измеряют показатели успешности выполнения задач без оценки обоснованности, цитирования или соблюдения политик, специфичных для предметной области..
Использование инструментов и вызов функций.
Gorilla Patil et al. (2024), ReAct Yao et al. (2022b) и ToolBench Yu et al. (2026) фокусируются на способности агентов корректно использовать инструменты, вызывать API и рассуждать о выборе функций. Gorilla представляет APIBench для оценки точности вызова функций; ReAct предлагает синергетическую структуру рассуждения-действия; ToolBench проводит бенчмаркинг использования инструментов в сценариях реального мира. Они затрагивают критически важную возможность, но в первую очередь фокусируются на точности вызова функций, а не на оценке качества ответов по измерениям, релевантным для профессиональных приложений..
Интерактивные бенчмарки агентов и пользователей.
⟦-Bench Yao et al. (2024) имитирует динамические диалоги между симулированными пользователями и агентами с использованием специализированных инструментов и руководящих принципов политики. -Bench оценивает способность агентов взаимодействовать естественным образом, придерживаясь правил в многоходовых сценариях. Это представляет собой более близкое соответствие нашей работе, хотя -Bench оценивает успех агента через проверку состояния базы данных, а не через профессиональные качественные измерения, такие как цитирование, ясность, глубина, актуальность, релевантность и структура..
Бенчмарки для финансовых агентов.
Недавние работы начали оценивать агентные системы непосредственно на финансовых задачах. Finance Agent Benchmark (Bigeard et al., 2025) оценивает LLM агентов на 537 экспертных вопросах по финансовым исследованиям из реальной практики с использованием инструментов (например, поиск и EDGAR), предоставляя надежный инструмент для сравнения в сфере публичных финансов. FinAgentBench (Choi et al., 2025) фокусируется на агентном поиске в финансовом QA, разделяя выбор типа документа и выбор фрагмента для стресс-тестирования многошагового логического вывода при поиске. В совокупности эти усилия существенно продвигают оценку финансовых агентов, однако они в основном ориентированы на исследования публичных компаний и сценарии поиска; в отличие от них, FORCE-Bench дополнительно оценивает рабочие процессы по обязательствам, основанные на корпоративных ERP системах, и синтез структурированных бизнес-сводок в условиях типичных ограничений по задержке..
2.4 Обзор ландшафта бенчмарков и цели проектирования
В совокупности предыдущие семейства бенчмарков создают прочную основу, но охватывают разные уровни проблемы оценки. Коротко говоря, общие бенчмарки LLM характеризуют широкие способности к рассуждению и следованию инструкциям, агентские бенчмарки проверяют интерактивное использование инструментов и многошаговое выполнение, а бенчмарки, ориентированные на финансы, повышают предметную релевантность, особенно для ответов на вопросы по публичным документам. Эта последовательность проясняет, что уже хорошо измерено, а где потребности внедрения в корпоративные финансы остаются недостаточно определенными..
Три пробела мотивируют FORCE-Bench. Во-первых, существующие бенчмарки редко оценивают сквозные рабочие процессы в операционных финансах, которые объединяют внутренние записи ERP с внешними финансовыми источниками. Во-вторых, многие оценки делают упор на завершение задач или успешность поиска, но обеспечивают ограниченную видимость таких аспектов профессионального качества, как качество цитирования, обоснованность, ясность, структура и глубина. В-третьих, настройки бенчмарков часто абстрагируются от ограничений развертывания (например, бюджеты задержек и условия совместного доступа к инструментам), которые существенно влияют на практическую полезность..
Соответственно, FORCE-Bench разработан с учетом трех целей: (i) реалистичный охват рабочих процессов в области исследования обязательств, анализа эффективности деятельности организаций и подготовки бизнес-сводок; (ii) диагностическая, основанная на критериях многомерная оценка, соответствующая ожиданиям финансовых специалистов; и (iii) воспроизводимая, не зависящая от реализации оценка в операционно значимых условиях. Эти цели напрямую определяют структуру набора данных, систему оценки и методологию инструментария, описанные в следующем разделе..
3 Методы
В этом разделе описываются три столпа бенчмарка: набор данных запросов (раздел 3.1), система оценки на основе критериев (раздел 3.2) и статистическая методология, используемая для сравнения agentic harnesses (раздел 3.4). Набор данных, критерии оценки, реализации harnesses и скрипты анализа находятся в открытом доступе по адресу https://github.com/microsoft/FinanceBenchmark.
3.1 Набор данных
Набор данных для бенчмаркинга включает 251 запрос, охватывающий три типа задач, каждый из которых проверяет отдельную возможность финансового агента.:
Исследование финансовых обязательств.
Этот тип задач включает запросы к внутренним базам данных дебиторской (AR) и кредиторской (AP) задолженности, основанные на синтетическом экземпляре Dynamics 365 Finance (подробности см. ниже). Запросы охватывают проверку баланса клиентов, анализ просроченной задолженности, детали счетов-фактур, историю платежей, условия работы с поставщиками и мероприятия по взысканию. Набор данных содержит 100 запросов по финансовым обязательствам: 72 ориентированы на AR и 28 на AP. Типичные сценарии включают Aged Balance, Cash Collections, Cash Discounts, Collections, Collections Tasks, Credit Limit, Credit Notes, Credit Rating, Customer Setup, Discounts, Dispute, Invoicing History, Outstanding Balance, Payment History, Sales Orders, AP Invoices, AP Payments, AP Purchase Orders, Vendor Balance.
Пример запроса: «Каков остаток дебиторской задолженности для компании Birch Company по состоянию на 2 марта 2026 года»?”
Ожидаемый ответ: Структурированный ответ, содержащий сумму дебиторской задолженности, идентификатор клиента и соответствующие данные о сроках погашения или статусе платежа, основанный на данных ERP со ссылкой на ERP-систему или запись..
Исследование эффективности финансовых организаций.
Запросы о финансовых показателях публичных компаний, составленные на основе отчетов о прибылях и убытках, документов, подаваемых в SEC, и данных от финансовых провайдеров. Этот набор содержит 126 запросов, охватывающих такие темы, как прибыль на акцию, соотношение заемного и собственного капитала, показатели выручки, денежные потоки, капитальные затраты, оборачиваемость запасов и метрики ESG. Запросы ограничены конкретными финансовыми периодами и требуют от агентов поиска и цитирования актуальных публичных данных..
Пример запроса: «Для нашей кредитной оценки Caterpillar, каково их отношение долгосрочного долга к собственному капиталу (среднее значение за 3 года) по состоянию на сентябрь 2025 года? Мне нужно это для обоснования нашей оценки кредитного плеча».”
Ожидаемый ответ: «Отношение долгосрочного долга к собственному капиталу компании Caterpillar (среднее значение за 3 года) по состоянию на сентябрь 2025 года составляет 1,42 (или 142%). Этот показатель отражает взаимосвязь между долгосрочным долгом и собственным капиталом Caterpillar, характеризуя долгосрочную структуру капитала компании. Источник: Квартальные отчеты о прибылях и убытках и отчеты по форме 10-K компании Caterpillar Inc.».”
Генерация бизнес-сводок.
Запросы на создание структурированных профилей компаний, синтезирующих финансовые данные, бизнес-контекст и операционные детали. Набор данных включает 25 запросов для бизнес-сводок. Ответы представляют собой многосекционные отчеты, охватывающие обзор компании, финансовые показатели, направления деятельности, конкурентное позиционирование и стратегические шаги. Эти задачи оценивают синтез и глубину проработки на основе гетерогенных источников данных..
Пример запроса: «Краткий деловой отчет компании Apple Inc..”
Ожидаемый ответ: Комплексный структурированный документ с разделами об обзоре компании, финансовых результатах (отчет о прибылях и убытках, бухгалтерский баланс, коэффициенты), направлениях деятельности/сегментах, конкурентном позиционировании относительно аналогов, недавних стратегических шагах и ключевых показателях — все это основано на цитируемых источниках..
3.2 Обзор оценки
Ответы оцениваются на основе системы критериев, опирающейся на ожидания в финансовой сфере. Каждый вопрос аннотирован набором оценочных измерений (тегов), каждое из которых содержит несколько утверждений. Утверждение — это проверяемое требование относительно того, что финансовый специалист ожидал бы или ценил бы в ответе, например: «ответ обосновывает финансовые показатели ссылками на источники» или «ответ расшифровывает редкие аббревиатуры при первом использовании». Эти утверждения разработаны так, чтобы быть ясными и диагностическими, поддерживая последовательную оценку ответов..
Производительность измеряется по восьми параметрам: точность, citations, ясность, глубина, groundedness, актуальность, релевантность и структура. Только подмножество из этих восьми параметров оценивается для всех трех типов задач: citations, ясность, глубина, groundedness, релевантность, структура. Мы включаем параметр актуальность только для исследования финансовых организаций и подготовки бизнес-сводок, в то время как актуальность исключается для исследования финансовых обязательств, поскольку этот параметр не совсем применим при запросах к системе учета (Dynamics 365 for Finance). С другой стороны, исследование финансовых обязательств уникальным образом включает точность, в то время как мы не измеряем точность для двух других задач, поскольку достоверные данные иногда могут быть субъективными и быстро меняться со временем. Вместо этого мы фокусируемся на groundedness для этих двух типов задач..
Даже для общего набора измерений лишь некоторые утверждения являются общими для разных типов задач, в то время как мы также добавили специфические для задач утверждения, адаптированные к источникам данных и сложности типа задачи. Например, для создания бизнес-сводок мы включаем утверждения о глубине проработки конкретных разделов (например, «ответ должен содержать раздел Обзор компании»), тогда как исследование эффективности финансовых организаций включает утверждения о глубине проработки конкретных тем (например, «ответ включает сравнение с аналогами» для запросов о конкурентном позиционировании).
Оценка выполняется LLM-судьей, реализованным с использованием DSPy (Khattab et al., 2023), который оценивает каждое утверждение по непрерывной шкале от 0.0 до 1.0, где промежуточные значения (0.25, 0.5, 0.75) представляют частичное соответствие. Оценка измерения представляет собой среднее арифметическое оценок его утверждений..
По умолчанию мы использовали OpenAI GPT-5.2 в качестве модели-судьи на постоянной основе во всех оценочных запусках. Для сравнения двух различных судей см. Приложение A.
3.3 Метрические измерения и рубрикаторы
Процесс разработки рубрикатора был итеративным и совместным, с привлечением множества заинтересованных сторон для обеспечения того, чтобы метрики были одновременно релевантными и практически применимыми. Первоначальный список утверждений был сформирован на основе данных от внутренних профильных экспертов и качественных результатов опросов внешних финансовых специалистов. Затем утверждения были откалиброваны с учетом реальных результатов работы моделей, что привело к удалению избыточных утверждений и пересмотру двусмысленных формулировок. На протяжении всего этого процесса основное внимание уделялось специфическим для финансов аспектам, чтобы гарантировать соответствие рубрикатора данной предметной области. Полученные измерения описаны ниже..
Точность.
Корректность фактических утверждений относительно эталонных данных. Эта метрика оценивается только для исследований финансовых обязательств, где показатели, полученные из ERP (сальдо клиентов, суммы счетов и статус платежей), могут быть проверены по системе учета. Она не применяется к исследованиям эффективности финансовых организаций или задачам по составлению бизнес-сводок, где эталонные данные распределены по различным источникам и подвержены временным изменениям или различиям в определениях. Например, коэффициент P/E может различаться в разных источниках в зависимости от того, используется ли показатель за последние двенадцать месяцев или прогнозная оценка; вместо этого для таких типов задач основным сигналом фактической обоснованности служит groundedness. Пример утверждения: «ключевые факты в ответе (сальдо клиентов, суммы счетов, статус платежей) соответствуют эталонным данным, зафиксированным в системе ERP».”
Источники.
Наличие и уместность ссылок на источники. Финансовые ответы должны содержать ссылки на источники данных для обеспечения возможности проверки и принятия профессиональных решений. Для исследований финансовых обязательств ссылки указывают на сущности ERP или системные URI — например, «ответ включает как минимум один URL, ведущий к записи или сущности в ERP; отсутствие URL допустимо только в том случае, если записи не были найдены». Для исследований эффективности финансовых организаций ссылки должны указывать на отслеживаемого поставщика финансовых данных — например, «ответ ссылается на источник данных путем указания поставщика (например, Bloomberg, S&P Capital IQ или корпоративная отчетность)». Для бизнес-сводок каждый раздел должен быть обоснован указанным источником или встроенной гиперссылкой — например, «ответ ссылается на источники данных путем указания поставщика (например, Bloomberg, S&P Capital IQ, корпоративная отчетность) или предоставления отслеживаемого URL»..”.
Ясность.
Качество объяснения и точность определений. Ответы должны содержать определения редких аббревиатур при первом упоминании (стандартные финансовые сокращения, такие как GAAP, EBITDA и DSO, считаются знакомыми финансовым специалистам) и поддерживать единообразие терминологии на протяжении всего текста. Ответы должны быть структурированы иерархически, следует избегать расплывчатых определений (например, «сильный» или «значительный» без количественной оценки).).
Глубина.
Достаточность и широта контекста. Для исследования финансовых обязательств глубина означает охват всех релевантных аспектов запроса (например, периоды просрочки, условия и история платежей, если это требуется). Для исследования эффективности финансовых субъектов глубина требует точности на уровне отдельных требований — например, «каждое требование соотносится с числом, датой или именованным источником; приблизительные квалификаторы используются только в том случае, если точные значения недоступны» — и сравнительного контекста (трехлетние тренды, отраслевые показатели и изменения за период), если таковые имеются. Для бизнес-сводок глубина оценивается по разделам — например, «ответ включает раздел Обзор компании, охватывающий краткую информацию о компании, руководство, дату основания и местоположение» и «ответ включает раздел Конкурентный/отраслевой анализ, сравнивающий аналоги по нескольким атрибутам»..”.
Обоснованность.
Фактические утверждения, прослеживаемые до извлеченного исходного контента. Бенчмарк фиксирует фрагменты источников и результаты работы инструментов во время вывода и оценивает, подтверждаются ли утверждения в ответе этими источниками или могут быть обоснованно выведены из них. Источники взяты из выходных данных ERP систем (исследование финансовых обязательств), контента, полученного из сети, и финансовых баз данных (исследование эффективности финансовых организаций), а также из синтеза данных из нескольких источников (бизнес-сводки).).
Актуальность.
Использование актуальных данных. Ответы должны привязывать данные, чувствительные ко времени, к конкретным датам или периодам (например, «по состоянию на третий квартал 2025 года», а не «в настоящее время») и отдавать приоритет самым последним доступным показателям. Эта метрика оценивается для исследований эффективности финансовых организаций и бизнес-сводок, где актуальность данных напрямую влияет на качество принимаемых решений. Она не измеряется для исследований финансовых обязательств, где дата снимка ERP фиксируется во время вывода. Для исследований эффективности финансовых организаций утверждения требуют явной привязки к дате — например, «ответ привязывает данные, чувствительные ко времени, к конкретной дате или периоду, вместо использования относительных терминов, таких как в настоящее время или недавно». Для бизнес-сводок актуальность оценивается с точки зрения соответствия данных намерению пользователя — например, «ответ соотносит актуальность данных с намерением пользователя, например, последняя котировка для запроса текущей цены в сравнении с историческими показателями для анализа трендов»..”.
Актуальность.
Прямое обращение к запросу пользователя без второстепенной информации. Релевантный ответ отвечает на поставленный вопрос, избегает не относящихся к делу отступлений и честно сообщает об ограничениях данных, когда запрашиваемая информация недоступна. Для исследования финансовых обязательств релевантность означает фокусировку на конкретном юридическом лице, клиенте или периоде времени, указанном в запросе; для исследования эффективности финансовых организаций это означает избегание информации о несвязанных компаниях или аналогах; для бизнес-сводок это означает соблюдение рамок, специфичных для компании..
Структура.
Качество организации и форматирования. Ответы должны содержать наиболее важную информацию в начале (ответ перед подробностями), использовать четкие иерархии (заголовки, разделы и таблицы) там, где это уместно, и поддерживать единообразное форматирование для сопоставимых данных (например, валюта, форматы дат и структура таблиц). Для исследования финансовых обязательств структурные требования дополнительно предписывают табличное представление ответов с несколькими записями — например, «если возвращаются две или более записи, ответ представляется в виде структурированной таблицы с четкими заголовками столбцов и единообразным форматированием (например, валюта, даты, идентификаторы клиентов)».).”.
3.3.1 Подготовка набора данных
Курирование охватывало несколько этапов: проектирование задач, генерация запросов, сбор контекста для обоснования и итеративное уточнение. Мы начали с определения репрезентативных возможностей для каждого из трех типов задач — создание бизнес-сводок, исследование эффективности финансовых организаций и исследование финансовых обязательств — и сформировали наборы запросов, отражающие реальные пользовательские сценарии. Мы непрерывно обновляли наборы данных на основе результатов оценки, расширяя охват за счет включения сложных случаев, граничных условий и наблюдаемых режимов сбоев..
Генерация бизнес-сводок.
Набор данных для генерации бизнес-сводок состоял из промптов, которые инициировали создание структурированных многосекционных отчетов по реальным объектам, каждый из которых был сопоставлен с отобранным контекстом обоснования из финансовых документов и конвейеров поиска, что позволило оценивать качество синтеза, а не точное совпадение ответов. Мы внедрили процесс с участием SME, в рамках которого ответы, сгенерированные моделью, сравнивались, фильтровались и уточнялись на основе предпочтений практиков, что привело к получению того, что мы называем полуэталонными выходными данными: ответов, которые отражают ожидания практиков относительно структуры, ясности, глубины и атрибуции источников, не предполагая наличия единственного неизменного ответа. Набор данных подчеркивал реалистичные модели потребления бизнес-сводок, где полезность, прослеживаемость утверждений и организация выводов имеют решающее значение для последующего принятия решений..
Исследование эффективности финансовых организаций.
Набор данных для исследования эффективности финансовых организаций охватывал широкий спектр задач финансового обоснования, включая анализ эффективности, динамику рынка и интерпретацию рисков. Мы сформировали и отфильтровали запросы для обеспечения тематического охвата и релевантности, предоставив контекст обоснования с помощью соответствующих финансовых данных и результатов поиска. Поскольку ответы в этой области могут со временем меняться или зависеть от интерпретации, мы отдали приоритет репрезентативному охвату и высококачественным эталонным ответам, а не фиксированным каноническим ответам, при этом обратная связь от SME сыграла центральную роль в уточнении как запросов, так и ответов..
Исследование финансовых обязательств.
Набор данных для исследования финансовых обязательств был создан в реалистичной среде финансов и операций (FnO), наполненной синтетическими, но структурно достоверными корпоративными данными, включая клиентов, поставщиков и записи о транзакциях. Мы сосредоточили внимание на широте и сложности рабочих процессов ERP, включив такие сценарии, как запросы к нескольким сущностям, межмодульные рассуждения, неоднозначность при разрешении сущностей и граничные случаи. Запросы были сопоставлены с обоснованными ответами, полученными непосредственно из базовой среды данных, что обеспечило воспроизводимую и последовательную оценку; при необходимости подсказки включали явные условия, такие как даты «по состоянию на» для вопросов о сальдо с истекающим сроком давности, чтобы привязать ответы к существующему состоянию данных и избежать запуска процессов, таких как создание снимков старения, которые могли бы изменить эталонные данные. Мы итеративно расширяли набор данных, чтобы устранить пробелы в охвате и провести стресс-тестирование возможностей системы. Среда FnO включала данные, описывающие 1000 поставщиков и 1000 клиентов, а также более 3400 записей в журналах дебиторской и кредиторской задолженности (каждая).
3.4 Агентные системы ⟦K0⟧
Бенчмарк оценивается с помощью трех агентных сред: специализированного финансового агента в Microsoft 365 Copilot и двух универсальных сред — интерфейса командной строки Anthropic Claude и API ответов OpenAI. Последние две были включены не для воспроизведения финансового агента, а для измерения базового опыта, который пользователь получил бы при развертывании универсальной агентной системы для финансовых запросов. Обе получают одинаковые общие системные инструкции и доступ к инструментам и отличаются от стандартного развертывания только тремя минимальными дополнениями: (i) им сообщается, что бенчмарк состоит из трех типов задач, (ii) им явно разрешено использовать веб-поиск и получение данных по URL, и (iii) им дано указание направлять все запросы по дебиторской и кредиторской задолженности на ERP MCP сервер, а не полагаться на общие веб-знания. Полная информация о конфигурации доступна в публичном репозитории: https://github.com/microsoft/FinanceBenchmark.
Для основных экспериментов все три инструмента тестирования были запущены с одинаковым ограничением по времени на каждый вопрос для Finance Agent: 60 с для исследования финансовых обязательств и показателей деятельности финансовых организаций, и 300 с для подготовки бизнес-сводок. Эта асимметрия отражает различные ожидания пользователей от каждой задачи: первые два типа задач предназначены для поиска в режиме, близком к реальному времени, подобно чату, в то время как подготовка бизнес-сводок включает синтез данных из нескольких источников и требует пропорционально больше времени. Инструменты тестирования общего назначения оцениваются при reasoning_effort=low (OpenAI) и в стандартном режиме без расширенного мышления (Claude CLI) на протяжении всех основных экспериментов. Включение более высокого уровня reasoning effort привело бы к тому, что ограничение в 60 с срабатывало бы еще чаще, что дополнительно снизило бы производительность; распределение задержек по каждому провайдеру при настройках мышления по умолчанию приведено в Приложении C.
Интерфейс командной строки Claude.
Инструментарий Claude CLI вызывает командную строку Anthropic claude как асинхронный подпроцесс, при этом вывод передается в виде потока событий JSON, разделенных символами новой строки. Этот инструментарий является агентным в том смысле, что CLI автономно управляет циклом многоходового рассуждения и использования инструментов: на каждом шаге модель может вызывать один или несколько инструментов, проверять их выходные данные и принимать решение о продолжении работы или формировании окончательного ответа, вплоть до достижения максимума в max_turns = 20 шагов. Использовались модели claude-opus-4-7 и claude-haiku-4-5; опциональный параметр effort управляет расширенным бюджетом мышления (low / medium / high). Доступные инструменты включают веб-поиск (через встроенное разрешение WebSearch) и ERP MCP сервер (предоставляемый через отфильтрованный --mcp-config, указывающий на один MCP сервер). Инструменты файловой системы (Read, Write, Edit, Bash, Grep, Glob) и инструменты управления навыками, не относящиеся к бенчмаркингу, явно заблокированы..
Интерфейс прикладного программирования ответов OpenAI.
Инструментарий OpenAI вызывает Responses API (client.responses.create), который отличается от Chat Completions API тем, что агентный цикл — выбор инструментов, выполнение и итерация — управляется на стороне сервера, а не вызывающей стороной. Модель автономно выполняет вызовы инструментов до тех пор, пока не сформирует итоговый ответ или не достигнет max_tool_calls = 20. Используемая модель — gpt-5.5; опциональный параметр reasoning_effort (low / medium / high) управляет бюджетом токенов рассуждения для моделей рассуждения. Два типа инструментов зарегистрированы нативно: запись сервера MCP, указывающая на конечную точку ERP, и встроенный инструмент web_search_preview.
3.4.1 Сравнительный анализ агентных сред и запусков вывода
Для статистического сравнения производительности между различными запусками вывода или между различными агентными обвязками (Finance Agent, Claude CLI и OpenAI Responses API) мы используем линейные смешанные модели (LMM), которые учитывают структуру повторных измерений данных: одни и те же вопросы оцениваются для каждого провайдера, поэтому наблюдения в рамках одного вопроса не являются независимыми между провайдерами..
Спецификация модели.
Для каждой метрики оценки мы подбираем модель со смешанными эффектами вида:
| (1) |
где обозначает категориальные (фиксированные) эффекты. Модель включает основной эффект для провайдера, основной эффект для типа задачи и их взаимодействие. Случайное пересечение, сгруппированное по идентификатору вопроса, учитывает вариативность базовой сложности и индивидуальные особенности отдельных запросов, принимая во внимание тот факт, что некоторые запросы по своей сути являются более сложными, чем другие, для всех провайдеров. Эта структура случайных эффектов имеет важное значение: она гарантирует, что сравнения провайдеров не искажаются различиями в сложности вопросов, что является критически важным фактором при оценке производительности агентов в рамках гетерогенных, реалистичных задач..
Проверка гипотез и контрасты.
Мы конструируем гипотетические тесты для оценки эффектов провайдеров, используя две взаимодополняющие схемы контрастов (Judd and McClelland, 1989). Во-первых, мы вычисляем равновесный маржинальный контраст по типам задач, где каждый тип задачи вносит равный вклад независимо от количества назначенных ему вопросов. Этот подход согласуется с нашей основной стратегией агрегирования (взвешенные оценки, усредняющие типы задач с равным весом). В частности, пусть провайдер обозначает эталон, а провайдер — объект сравнения; равновесный маржинальный контраст принимает форму:
| (2) |
где — это основной эффект провайдера (относительно ), — коэффициенты взаимодействия провайдера и типа задачи, — эталонный тип задачи, а — общее количество типов задач. Во-вторых, мы вычисляем контрасты для конкретных типов задач на основе той же подобранной модели, что позволяет нам сообщать об эффектах провайдера в рамках каждой предметной области задач..
Все модели оцениваются методом максимального правдоподобия (ML), а не ограниченным методом максимального правдоподобия (REML), что необходимо для корректного вывода по фиксированным эффектам на основе оцененной ковариационной матрицы (Verbeke and Molenberghs, 2000).
Для каждой подобранной модели мы проверяем контрасты провайдеров, используя процедуру Вальда (Verbeke and Molenberghs, 2000): при заданном векторе контраста оценка и ее стандартная ошибка составляют
| (3) |
где — вектор оценок фиксированных эффектов, а — его оценочная ковариационная матрица. При нулевой гипотезе статистика асимптотически является стандартной нормальной, что дает двусторонние -значения . Мы приводим -значения (отображаемые как маркеры значимости на рисунках) наряду с точечными оценками с 95% бутстреп-доверительными интервалами ( повторных выборок; планки погрешностей на рисунках и в таблице 1) для поддержки прямой интерпретации практической значимости. LMM используется только для проверки значимости; направление каждого сравнения берется из разности необработанных равновесных оценок для обеспечения согласованности со значениями, представленными на рисунках и в таблице 1⟧.
Устойчивость.
Мы внедряем несколько механизмов защиты для обеспечения надежного вывода. Модели с отсутствием сходимости, нулевой дисперсией результатов или недостаточным размером выборки на провайдера (менее 5 наблюдений) помечаются и исключаются из отчетности. Пропущенные данные в столбцах с оценками удаляются по списку в рамках каждой метрики, что является обоснованным допущением, учитывая, что пропущенные значения в наших оценках LLM judge встречаются редко и обычно представляют собой кратковременные сбои при оценке, а не систематические проблемы. Мы не применяем явные поправки на множественные сравнения (например, Bonferroni) для различных метрик; вместо этого акцент на предметно-ориентированных метриках (ясность, обоснованность и т. д.) и отчетность по размеру эффекта позволяют читателям оценивать доказательства в контексте, что является стандартной практикой в прикладном ML benchmarking (Demšar, 2006; Dror et al., 2018).
4 Результаты
4.1 Общая производительность
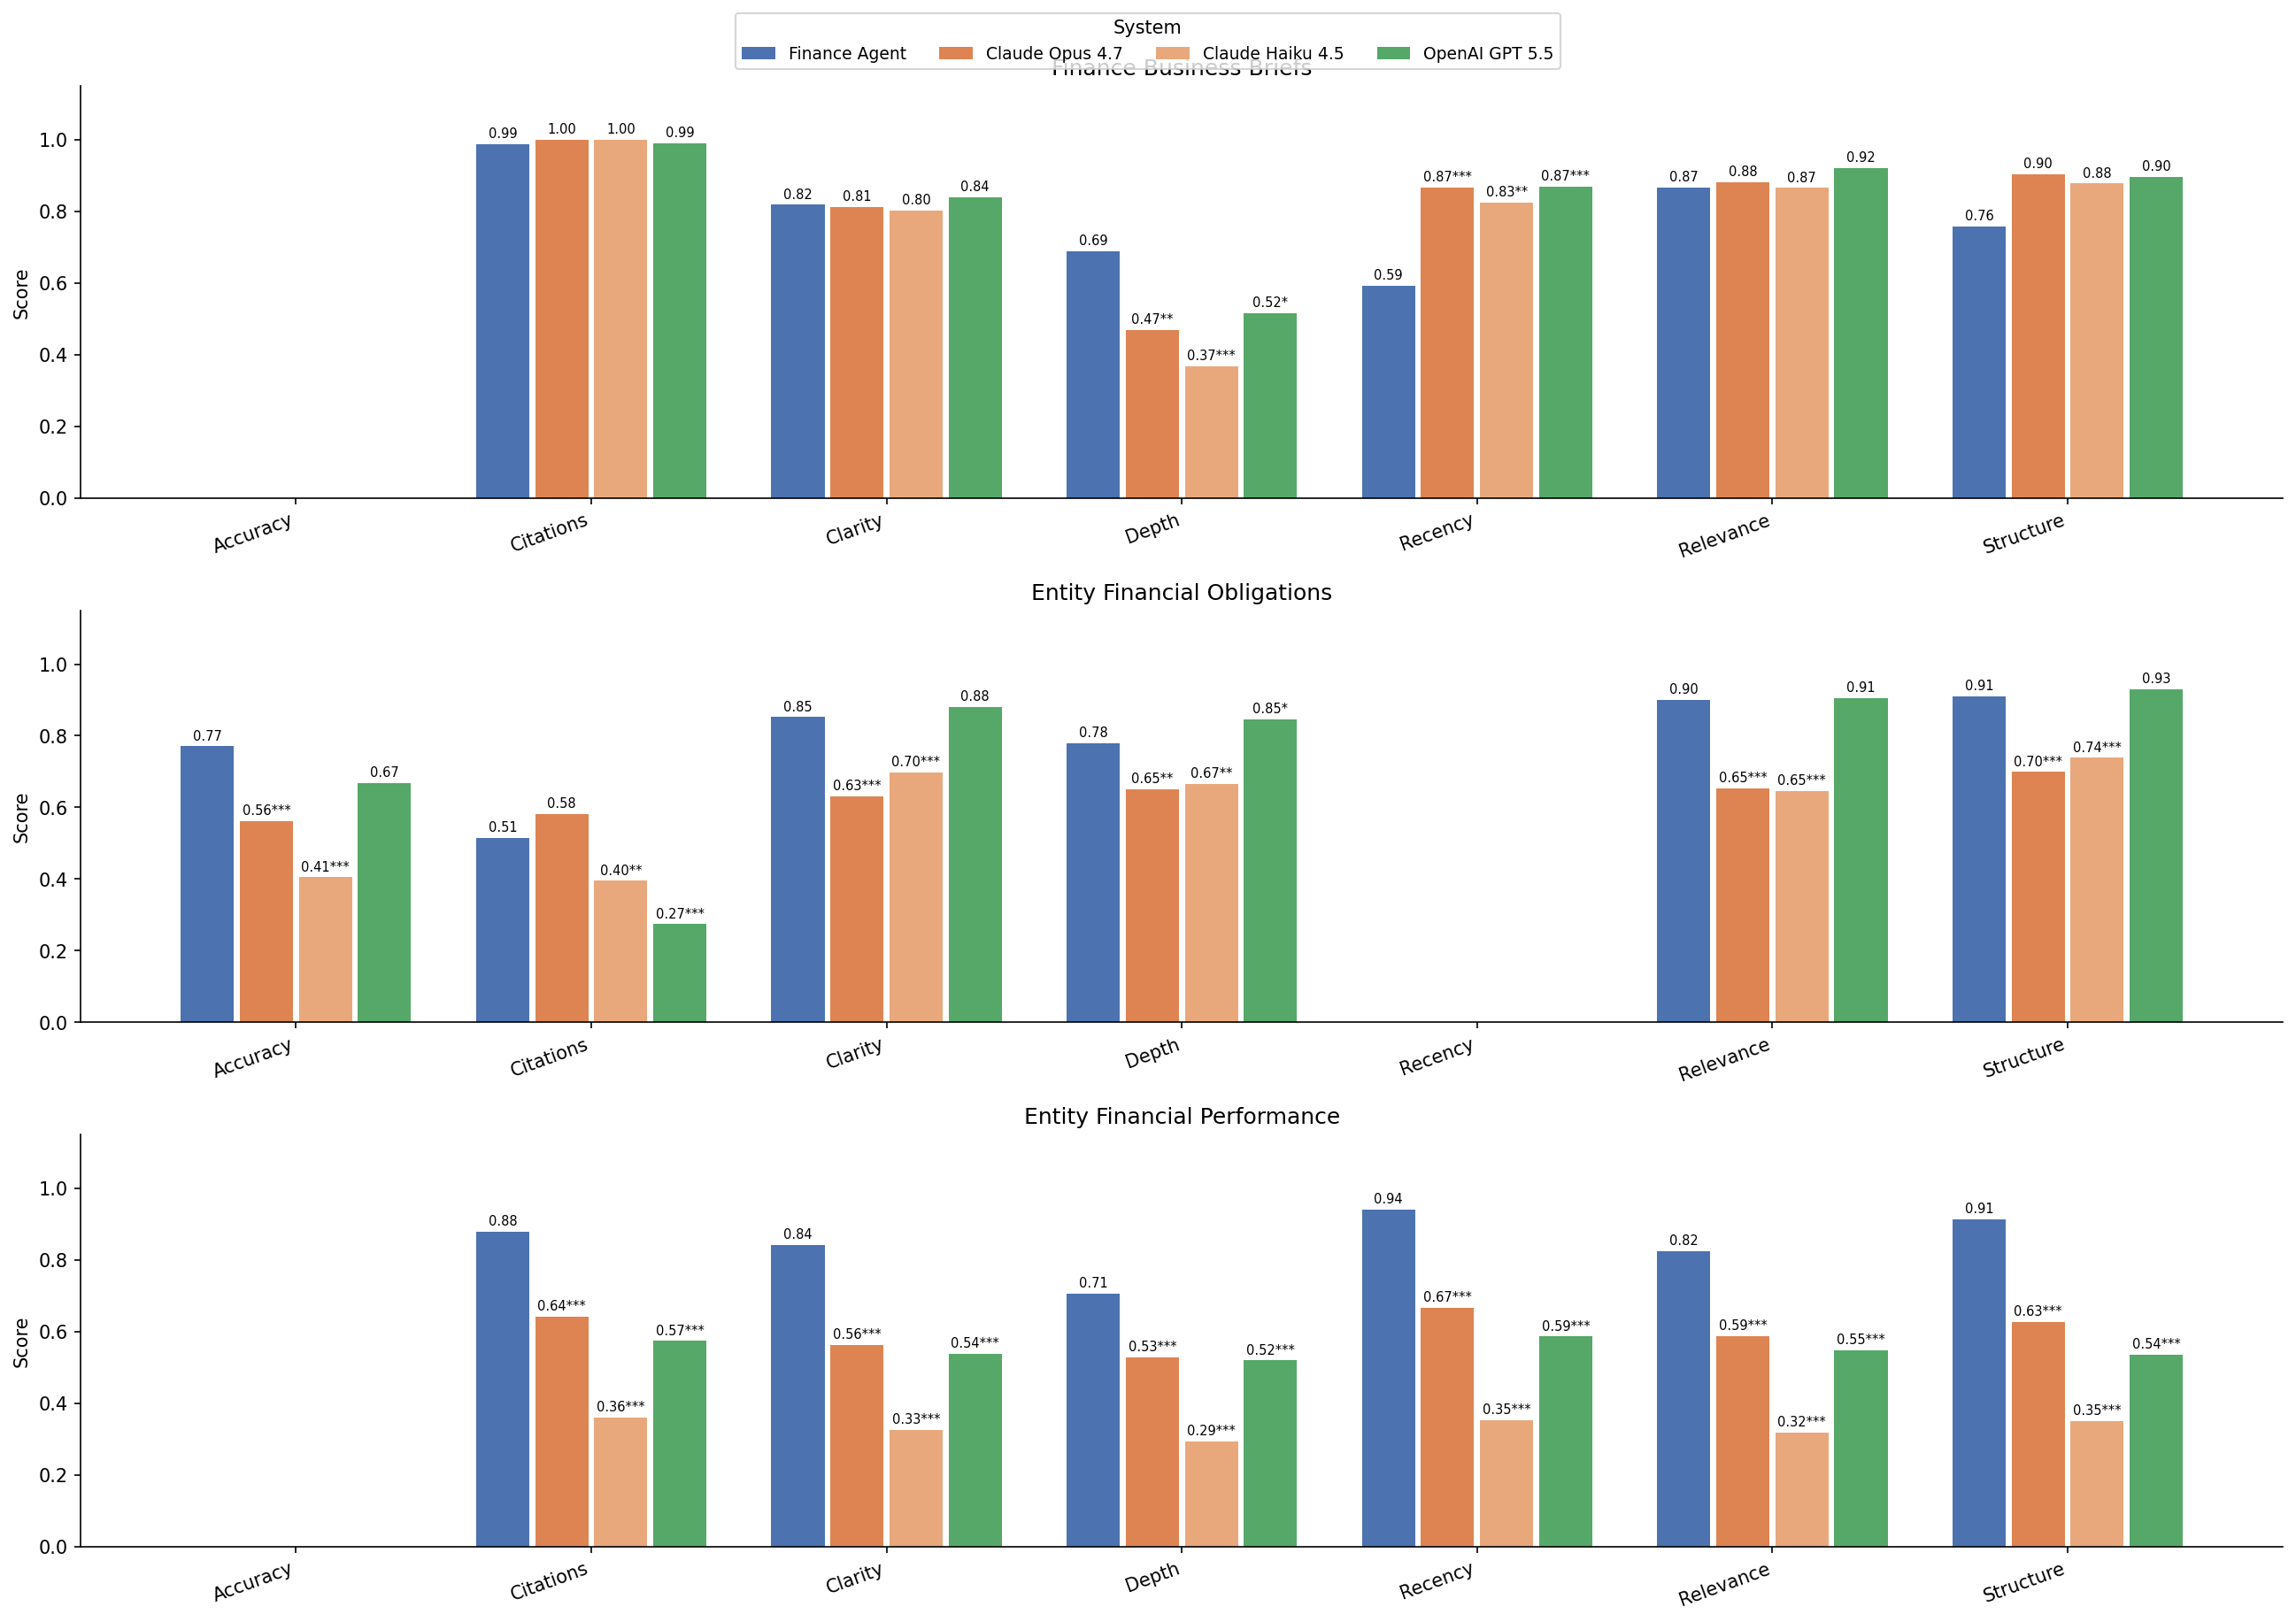
На Рисунке 1 и в Таблице 1 представлены результаты тестирования по всем восьми измерениям оценки для Finance Agent, Claude Opus 4.7 (Anthropic Claude CLI), Claude Haiku 4.5 (Anthropic Claude CLI) и GPT 5.5 (OpenAI Responses API). Finance Agent лидирует по всем измерениям со статистически значимым отрывом по большинству метрик: точность 0,77 по сравнению с 0,67, 0,40 и 0,56 для GPT 5.5, Claude Haiku 4.5 и Claude Opus 4.7 соответственно, а также аналогичные преимущества в цитировании, ясности, глубине, релевантности и структуре..
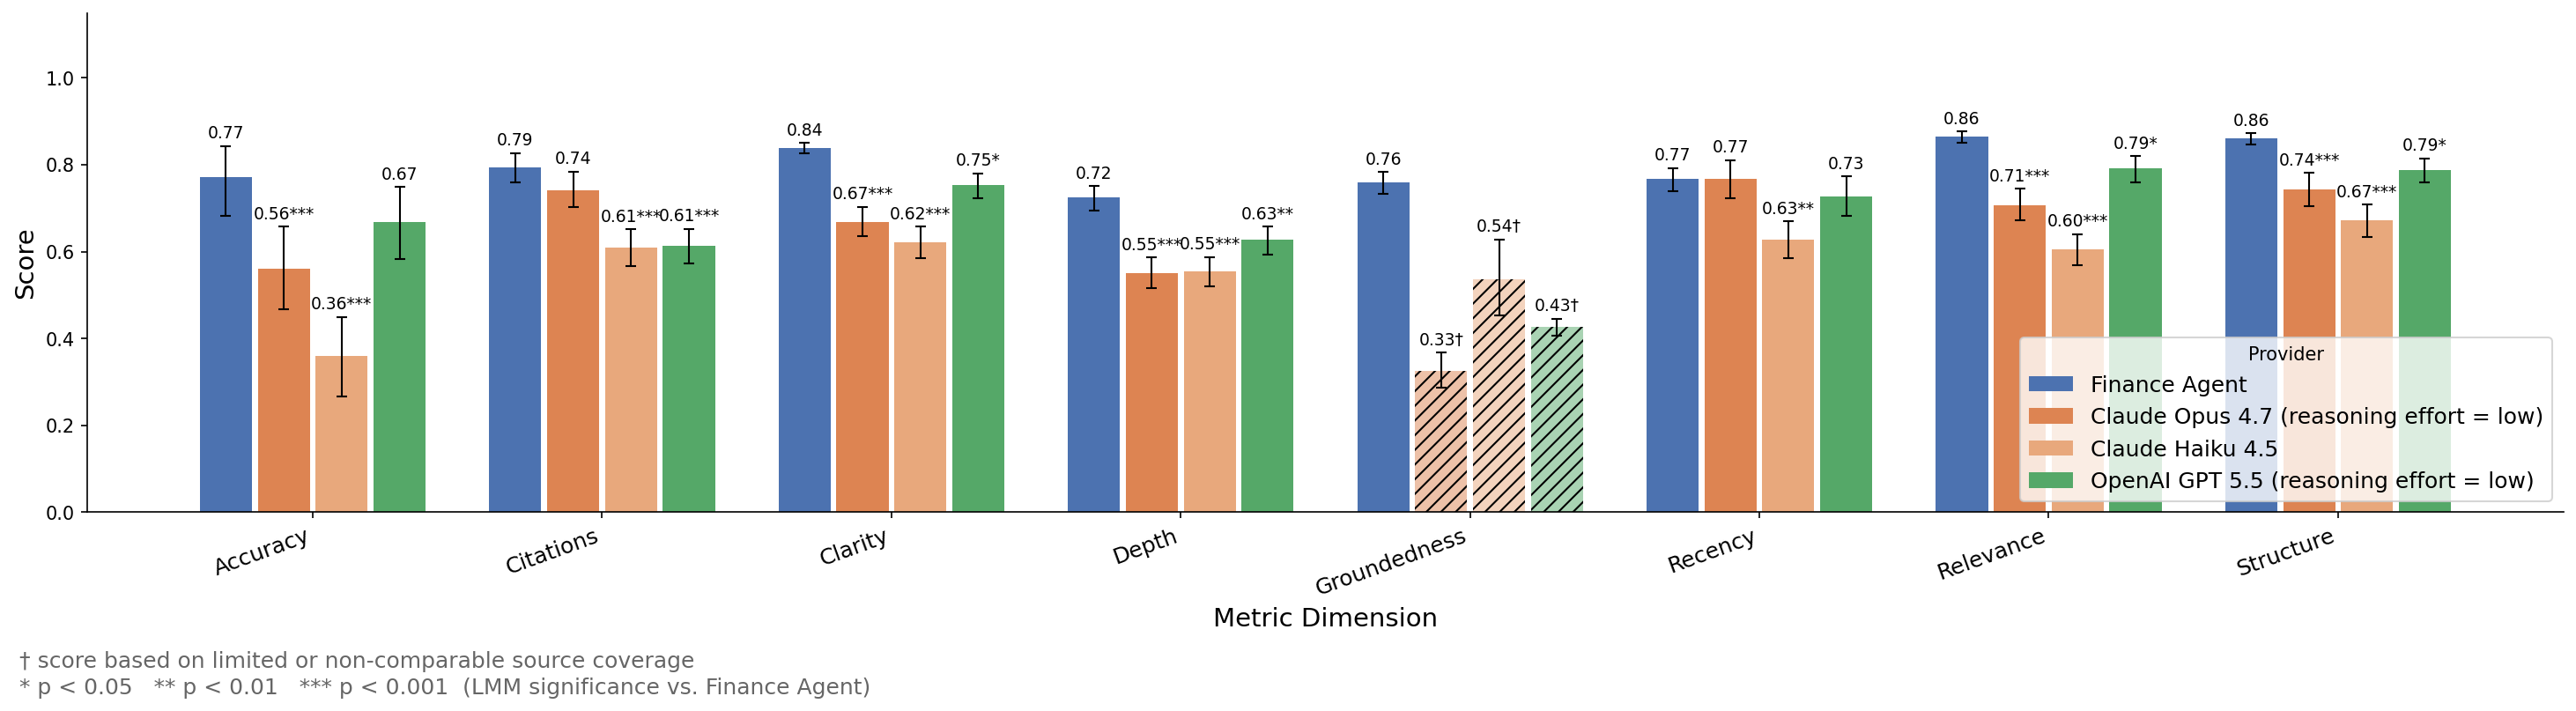
| Provider | Finance Agent | Claude Opus 4.7 | Claude Haiku 4.5 | OpenAI GPT 5.5 |
|---|---|---|---|---|
| Metric | ||||
| Accuracy | 0.77 [0.69, 0.84] | 0.56 [0.47, 0.66] | 0.40 [0.33, 0.47] | 0.67 [0.59, 0.75] |
| Citations | 0.79 [0.76, 0.83] | 0.74 [0.70, 0.78] | 0.59 [0.55, 0.63] | 0.61 [0.57, 0.66] |
| Clarity | 0.84 [0.83, 0.85] | 0.67 [0.63, 0.70] | 0.61 [0.58, 0.64] | 0.75 [0.73, 0.78] |
| Depth | 0.72 [0.70, 0.75] | 0.55 [0.51, 0.59] | 0.44 [0.41, 0.47] | 0.63 [0.59, 0.66] |
| Groundedness | 0.76 [0.73, 0.79] | 0.33 [0.29, 0.37] | 0.53 [0.45, 0.60] | 0.43 [0.41, 0.45] |
| Recency | 0.77 [0.74, 0.79] | 0.77 [0.72, 0.81] | 0.59 [0.54, 0.63] | 0.73 [0.68, 0.77] |
| Relevance | 0.86 [0.85, 0.88] | 0.71 [0.67, 0.74] | 0.61 [0.58, 0.64] | 0.79 [0.76, 0.82] |
| Structure | 0.86 [0.85, 0.87] | 0.74 [0.71, 0.78] | 0.65 [0.62, 0.69] | 0.79 [0.76, 0.81] |
| Overall | 0.80 [0.77, 0.82] | 0.63 [0.59, 0.68] | 0.55 [0.51, 0.60] | 0.67 [0.64, 0.71] |
4.2 Производительность по типу задачи
На рисунке 3 представлены оценки эффективности по всем трем типам задач. Охват метрик намеренно варьируется в зависимости от задачи: точность измеряется только для исследования финансовых обязательств, где эталонные данные являются авторитетными и детерминированными (ERP система учета); актуальность исключена для того же типа задач, поскольку дата снимка ERP фиксирована во время вывода, а временная привязка данных не является значимым сигналом качества. И наоборот, точность не применяется к исследованию эффективности финансовых организаций или составлению бизнес-сводок, где правильные ответы распределены по нескольким источникам и меняются с течением времени..
4.2.1 Генерация бизнес-отчетов по финансам
Все системы достигают почти идеальных показателей цитирования (0,99–1,00), что подтверждает надежность выявления ссылок на источники при генерации отчетов из нескольких разделов. Finance Agent лидирует по глубине (0,69 против 0,37–0,52, значимо на уровне или выше для всех сравниваемых систем). Напротив, актуальность — это единственный параметр, по которому Finance Agent уступает всем сравниваемым системам: Claude Haiku 4.5 (0,83), Claude Opus 4.7 (0,87) и GPT 5.5 (0,87) показывают значительно более высокие результаты ( или выше), что указывает на то, что сравниваемые системы более последовательно привязывают чувствительные ко времени показатели к конкретным датам и периодам. По цитированию, ясности, релевантности и структуре Finance Agent находится на одном уровне с ведущим провайдером по каждому из параметров, при этом ни одна из сравниваемых систем не демонстрирует статистически решающего преимущества. Точность для бизнес-сводок не оценивается..
4.2.2 Исследование финансовых обязательств
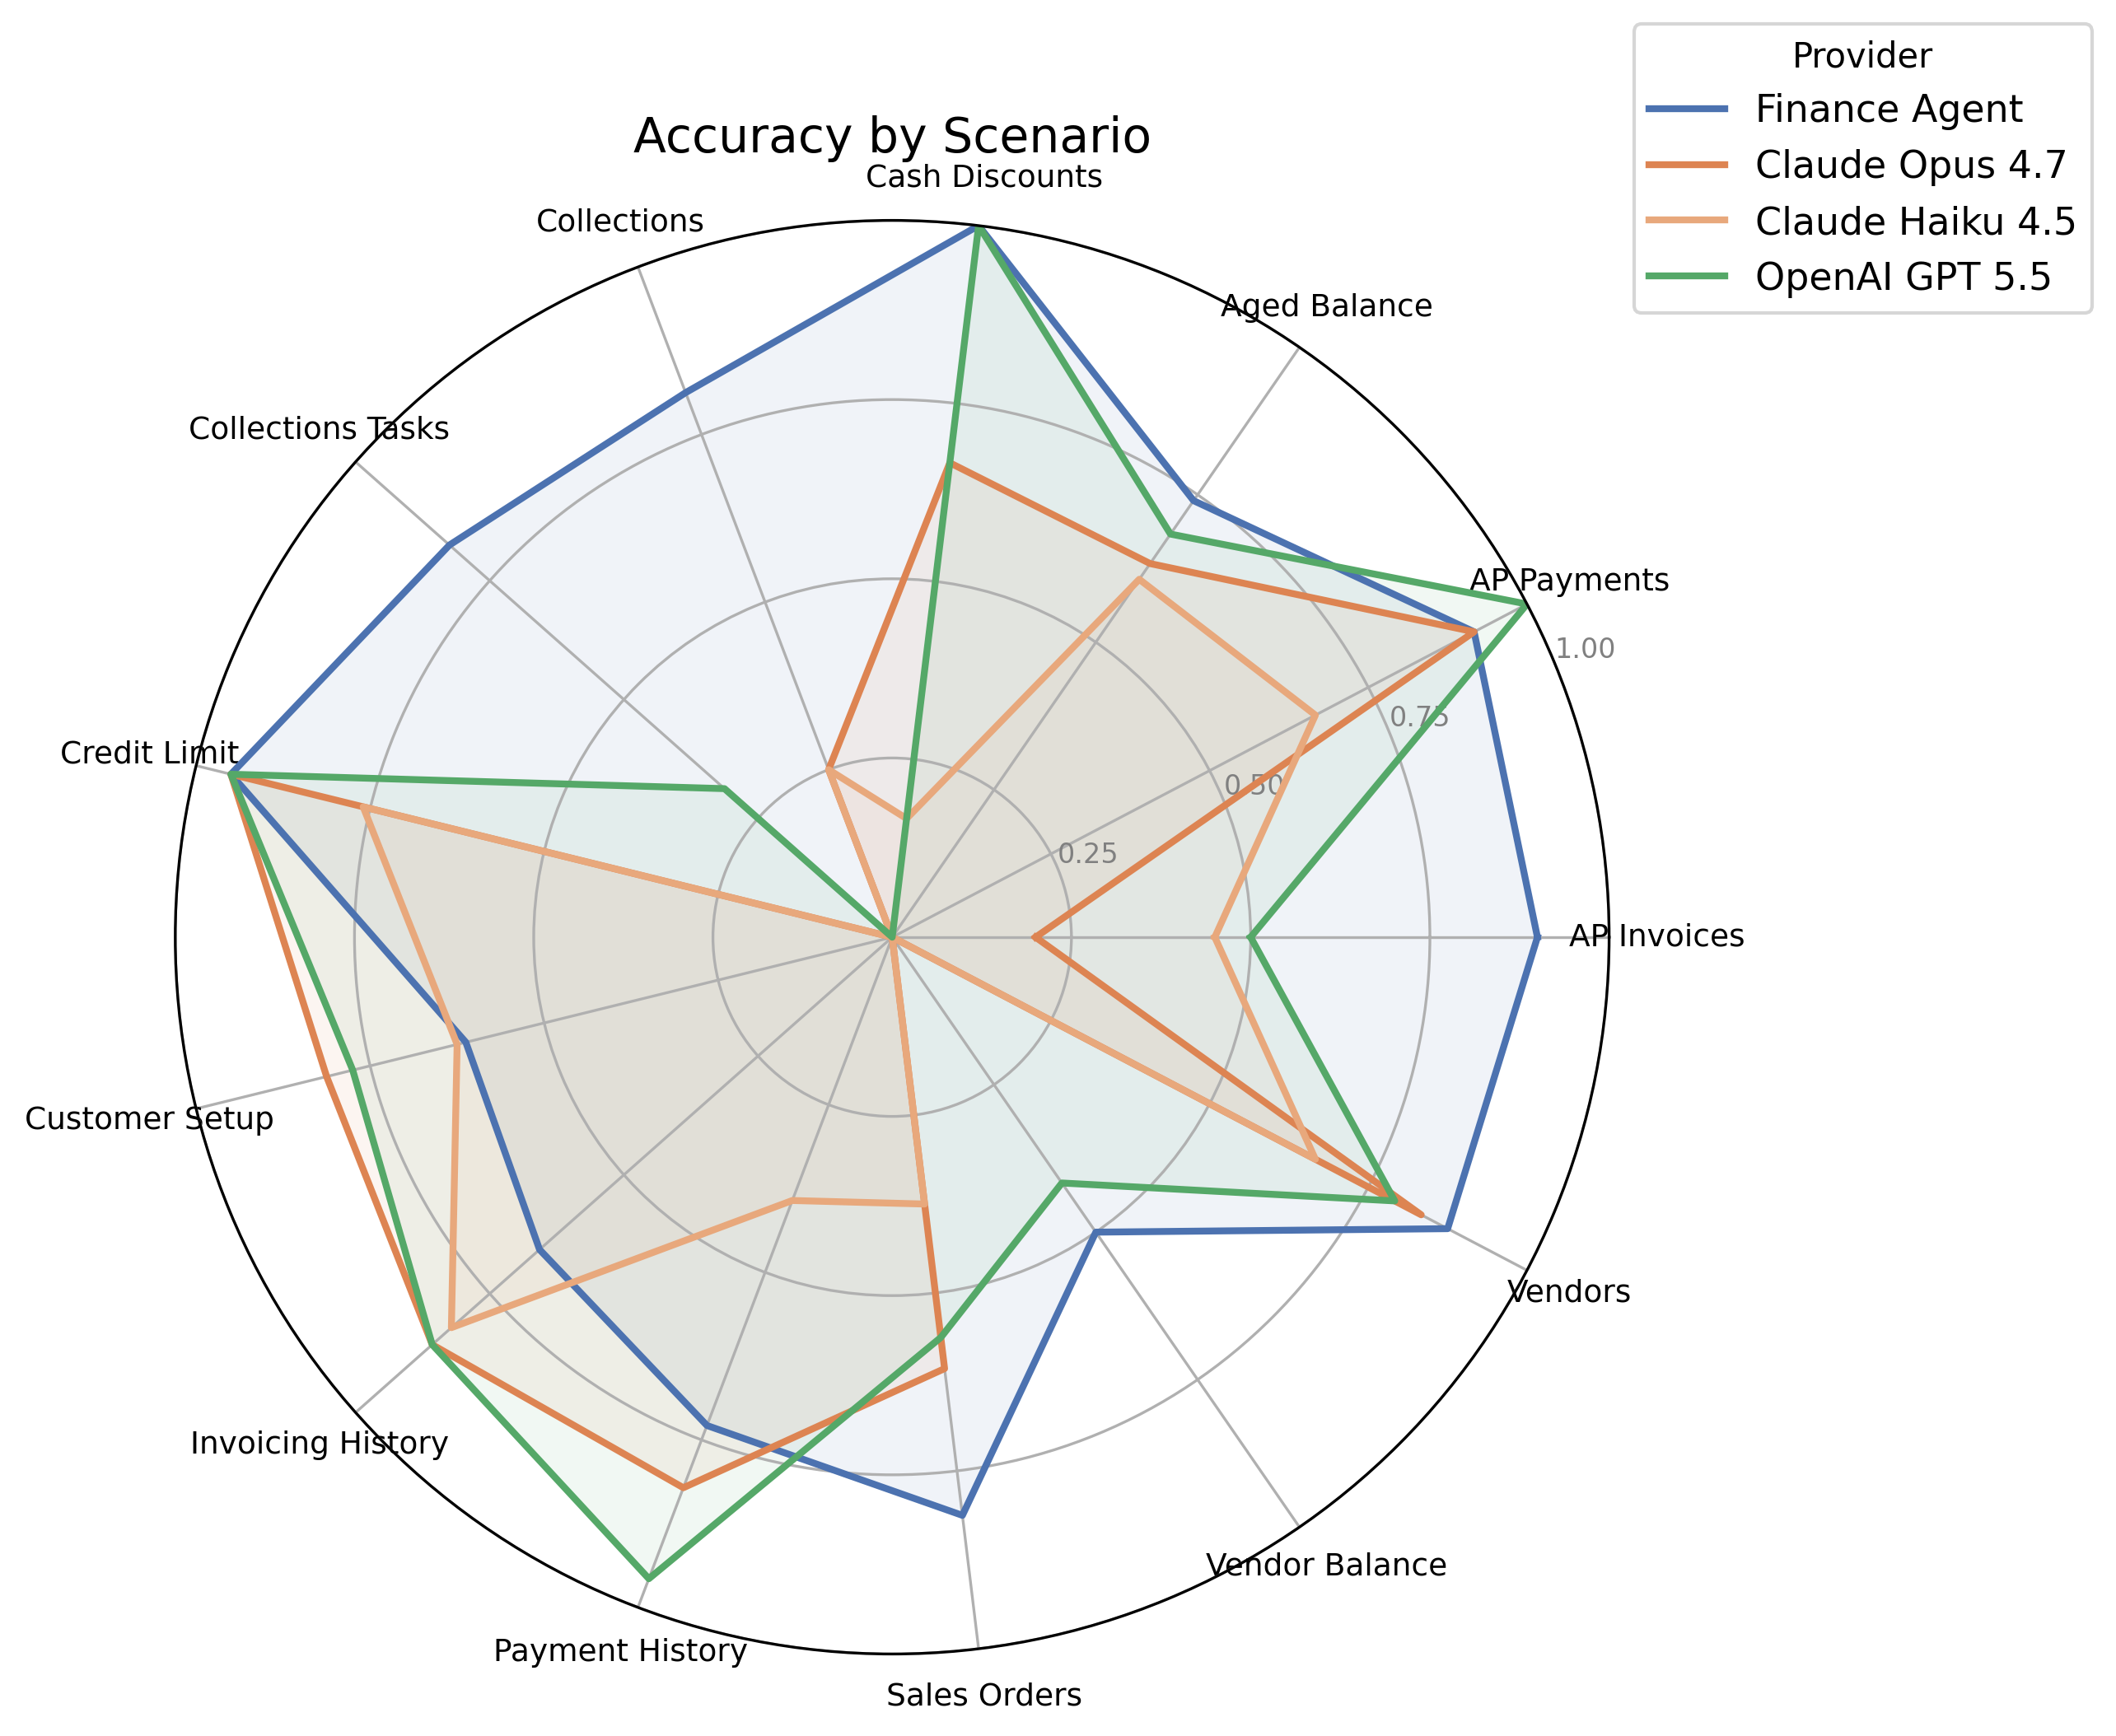
Финансовый агент лидирует по точности (0.77 против 0.67 у GPT 5.5, 0.56 у Claude Opus 4.7 и 0.41 у Claude Haiku 4.5), он находится на одном уровне с ведущей системой общего назначения по остальным параметрам, при этом по каждому из других параметров лидирует разная система общего назначения. Это отражает его специализированную интеграцию с Dynamics 365 Finance ERP: запросы о балансах клиентов, сроках оплаты счетов или статусе платежей обрабатываются непосредственно на основе данных из системы учета, что обеспечивает высокую фактическую точность и строгую опору на источники..
Поскольку исследование финансовых обязательств является единственным типом задач с детерминированной истиной, мы можем дополнительно детализировать точность по сценариям ERP. На рисунке 2 представлена лепестковая диаграмма точности Finance Agent по всем сценариям; преимущество Finance Agent наиболее выражено в четырех категориях: задачи по взысканию задолженности, взыскание задолженности, счета-фактуры кредиторской задолженности и заказы на продажу..
Задачи по взысканию задолженности.
Эти запросы требуют от агента навигации по модулю рабочих списков дебиторской задолженности: какие открытые последующие действия существуют для заданного клиента, какие клиенты отображаются в рабочем списке агента по взысканию на указанную дату и какие открытые дела по взысканию являются нерешенными в масштабах всей организации. Правильные ответы требуют сопоставления идентификаторов клиентов, чтения полей статуса задач и возврата структурированных списков действий с датами и состояниями дел — шаблон извлечения, который интеграция ERP для Finance Agent обрабатывает с помощью специально созданных инструкций вызова инструментов..
Взыскание задолженности.
Эти запросы сосредоточены на формальном процессе отправки уведомлений о задолженности: какие письма о взыскании были отправлены клиенту, когда было отправлено последнее письмо, сколько писем получил конкретный клиент и сколько клиентов не закреплено ни за одной группой взыскания. Успех требует навигации по модулю писем о взыскании и агрегирования данных по объектам — задач, которые выигрывают от целевой маршрутизации запросов к ERP со стороны Finance Agent..
Счета на оплату.
Запросы по кредиторской задолженности охватывают реестр счетов: общую стоимость неоприходованных счетов поставщиков, количество счетов, ожидающих утверждения, суммы, проведенные за определенный период, и статус трехсторонней сверки между заказами на закупку, поступлениями товаров и счетами. Они требуют доступа к специализированным модулям AP и правильной интерпретации статуса жизненного цикла счета (неоприходован, на рассмотрении, сверен), где преимущество обеспечивается за счет специализированного инструментария AP для Finance Agent..
Заказы на продажу.
Эти запросы охватывают открытые и исторические заказы на продажу в разрезе клиентов: крупнейшие заказы для конкретного клиента, списки открытых заказов, количество возвратов и детали уровня заказа, такие как менеджер по продажам, оформивший заказ. Хотя заказы на продажу являются прежде всего конструкцией цикла получения выручки, а не метрикой дебиторской задолженности, они напрямую влияют на контекст дебиторской задолженности, а более широкая интеграция Finance Agent с ERP системами позволяет получать доступ к этим записям более надежно, чем при использовании общего веб-поиска..
4.2.3 Исследование эффективности финансовых организаций
Финансовый агент лидирует по всем измеренным показателям: актуальность (0.94 против 0.35–0.67), структурированность (0.91 против 0.35–0.63), цитирование (0.88 против 0.36–0.64), ясность (0.84 против 0.33–0.56), релевантность (0.82 против 0.32–0.59) и глубина (0.71 против 0.29–0.53), при этом все различия значимы на уровне по сравнению с каждым аналогом. Эти достижения отражают специально разработанный конвейер поиска агента и системные инструкции, которые прямо требуют использования источников с привязкой к дате и структурированного представления..
4.3 Влияние усилий на рассуждение и ограничения по времени ожидания
Все запуски общего назначения, описанные в данной статье, используют фиксированные настройки рассуждения: API OpenAI Responses было настроено с параметром reasoning_effort=low, в то время как Claude CLI вызывался без явного параметра усилия, что соответствует стандартному режиму без расширенного бюджета на мышление. Данный выбор отражает базовый уровень развертывания с низкой задержкой; более высокие бюджеты на рассуждение существенно увеличили бы стоимость токенов и время отклика..
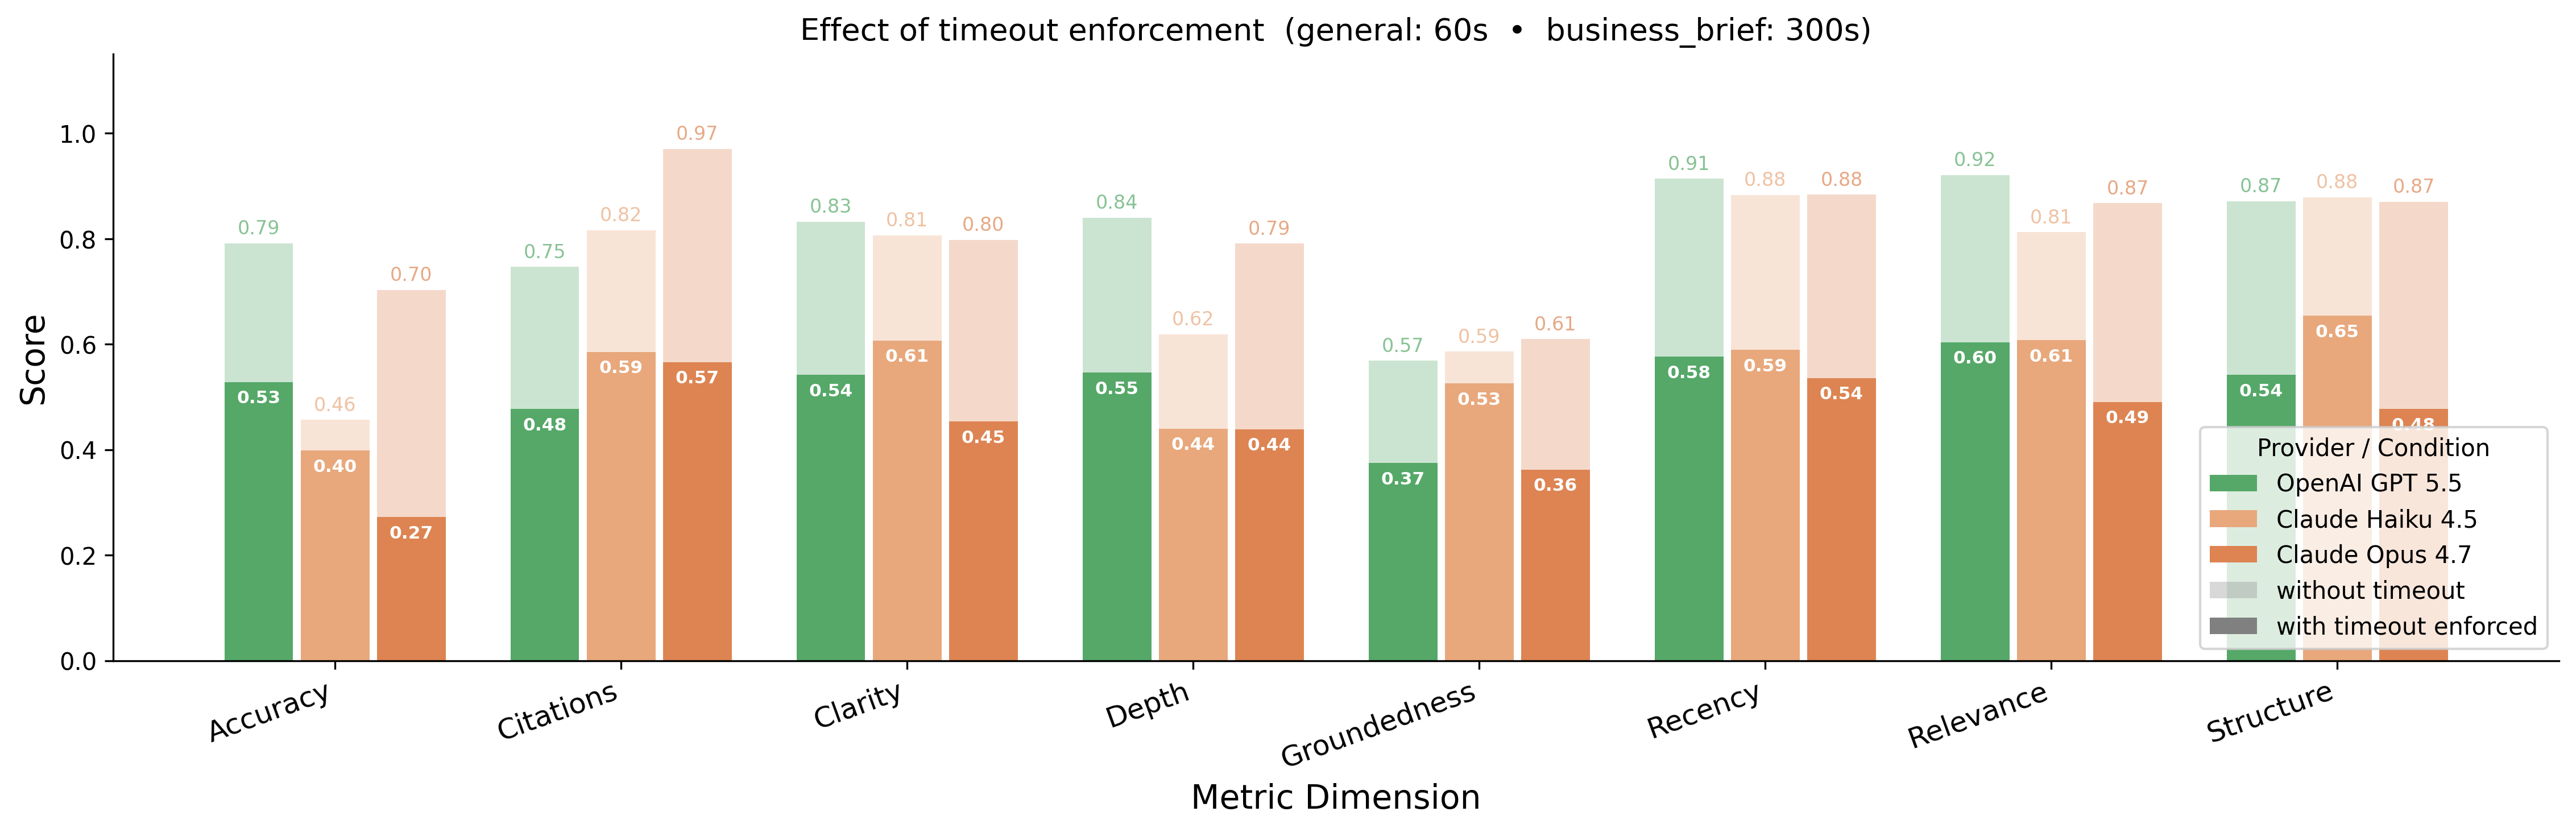
Чтобы продемонстрировать прирост производительности, доступный при ослаблении этих ограничений, мы провели абляционное исследование, в котором GPT 5.5, Claude Haiku 4.5 и Claude Opus 4.7 были повторно оценены при едином тайм-ауте в 300 с для всех типов задач, при одновременном повышении уровня reasoning effort с низкого до стандартного значения. На практике, даже при повышенном reasoning effort, ограничение в 300 с применяется редко: как показано в Приложении C, p90 задержки при стандартных настройках reasoning достигают максимум 194 с. Включение еще более высоких бюджетов reasoning, вероятно, дополнительно повысило бы качество в нерегулируемом режиме, но одновременно усилило бы деградацию при бюджете в 60 с, делая отдельные последовательности tool-call еще более затратными по времени..
На рисунке 4 представлены результаты этого абляционного исследования, демонстрирующие оценки в условиях отсутствия ограничений по времени 300 с (полупрозрачные столбцы) по сравнению с исходными запусками с ограничением 60 с (сплошные столбцы) при увеличении вычислительных затрат на рассуждение.
Принудительное ограничение времени ожидания в 60 с существенно снижает производительность по большинству параметров для всех трех провайдеров. Наиболее значительные падения наблюдаются в точности (OpenAI: ; Claude Haiku: ), цитировании (Claude Opus: ), глубине (OpenAI: ) и структуре (OpenAI: ), что отражает тот факт, что многие поисковые запросы по финансовым обязательствам требуют выполнения нескольких последовательных вызовов инструментов для извлечения записей ERP или финансовых данных, прежде чем может быть сформирован полный ответ (распределения вызовов инструментов для каждого провайдера приведены в Приложении B⟧).
В семействе Claude наблюдается поучительная инверсия в измерении точности: при ограничении в 60 с Claude Opus 4.7 (0.27) уступает Claude Haiku 4.5 (0.40), несмотря на то что Opus превосходит Haiku при отсутствии ограничений. Эта инверсия обусловлена задержкой: как показано в приложении C, Claude Opus генерирует более длинные и продуманные последовательности вызовов инструментов, для завершения которых требуется больше реального времени. При ограничении в 60 с Opus чаще, чем более быстрый Haiku, прерывается по тайм-ауту в процессе поиска, что приводит к преждевременному завершению работы, существенно снижающему точность. Меньший размер модели и более быстрое время отклика Haiku позволяют ему завершать большинство поисковых запросов в ERP в рамках бюджета, избегая этого штрафа..
В совокупности эти результаты показывают, что выбор времени ожидания является значимым гиперпараметром для специалистов, развертывающих агентные системы для решения финансовых задач: пороговые значения, подходящие для чувствительных к задержкам операционных запросов (60 с), накладывают существенное ограничение на качество выполнения задач, требующих многошагового поиска..
5 Ограничения
Совместная разработка бенчмарка и агента.
Финансовый агент был разработан итеративно параллельно с бенчмарком: охват набора данных был расширен на основе результатов оценки, а обратная связь от SME по выводам модели напрямую повлияла на уточнение рубрикатора (Раздел 3.1). Таким образом, Финансовый агент получил преимущество от прямого воздействия сигналов бенчмарка, которые не были доступны компараторам общего назначения, и его преимущество в производительности следует рассматривать отчасти как результат этой совместной разработки, а не исключительно как архитектурное различие..
Масштаб набора данных.
Бенчмарк включает 251 запрос. Хотя в абсолютном выражении это число невелико, набор данных был разработан с упором на широту охвата сценариев и качество аннотирования: три типа задач охватывают различные финансовые рабочие процессы и источники данных, а запросы были отобраны для покрытия репрезентативных сценариев, граничных случаев и наблюдаемых режимов сбоев с высококачественными аннотациями. Тем не менее, размер выборки ограничивает статистическую мощность для проведения детального анализа по подсегментам..
Одноходовая оценка.
Все запросы оцениваются в рамках одноходового сценария с одним вопросом. Многоходовые диалоги, уточняющие обмены репликами и перенос контекста в рамках сессии — обычные для реальных внедрений — выходят за рамки текущего исследования..
Измерение точности для задач на общедоступных данных.
Точность измеряется только для исследования финансовых обязательств, где авторитетная система ERP предоставляет детерминированные эталонные данные. Для исследования эффективности финансовых организаций и подготовки бизнес-сводок строгая оценка точности не применяется, поскольку эталонные данные распределены по различным источникам и зависят от различий в определениях и временного дрейфа (раздел 3.2); обоснованность служит основным сигналом фактического подтверждения для этих типов задач..
Единый момент времени.
Все запуски логического вывода проводились в фиксированный момент времени; общедоступные финансовые данные, фундаментальные показатели компаний и возможности моделей постоянно развиваются. Представленные здесь оценки отражают производительность системы на дату проведения оценки и могут не распространяться на будущие версии моделей или обновленные финансовые данные..
Зависимость инфраструктуры QA ERP ⟦K0⟧.
Воспроизведение результатов ERP QA требует наличия среды Microsoft Dynamics 365 Finance, загруженной синтетическими данными AP/AR из бенчмарка, а также сервера MCP, описанного в публичном репозитории: https://github.com/microsoft/FinanceBenchmark. Подробные инструкции по настройке приведены в репозитории, поэтому это не является фундаментальным препятствием для воспроизводимости; однако это требует лицензии Dynamics 365 и усилий по развертыванию, что может ограничить доступность для некоторых исследователей. Задачи по исследованию эффективности финансовых организаций и созданию бизнес-сводок требуют только доступа к веб-поиску и полностью воспроизводимы без дополнительной инфраструктуры..
Предвзятость LLM judge.
Приложение A исследует калибровку между различными судьями и согласованность рангов между GPT-5.2 и Claude Opus 4.6 на одном общем прогоне вывода, обнаруживая хорошую согласованность рангов и последовательное, но умеренное смещение калибровки (GPT-5.2 систематически более строг). Однако это попарное сравнение на одном прогоне не является систематической оценкой предвзятости судей по всем провайдерам и конфигурациям, представленным в данной статье. В частности, мы не можем полностью исключить, что GPT-5.2 в качестве основного судьи может проявлять предвзятость в пользу самого себя — отдавая предпочтение стилям ответов, более соответствующим выводам, сгенерированным OpenAI, по сравнению с теми, что созданы моделями Anthropic, — равно как и то, что любой подобный эффект является единообразным для всех типов задач и метрических измерений. Анализ в приложении демонстрирует, что ранжирование между провайдерами устойчиво к выбору судьи, однако абсолютные уровни оценок и мелкозернистые различия следует интерпретировать с учетом этого предостережения..
6 Обсуждение и выводы
Специализированные агенты лидируют по всем параметрам; разрыв наиболее значителен в точности ERP.
Финансовый агент лидирует по всем восьми измерениям оценки, с наибольшим абсолютным отрывом по точности в задачах исследования финансовых обязательств — типе задач, требующем точного поиска с разрешением сущностей в работающей системе ERP, где специализированная маршрутизация инструментов обеспечивает решающее преимущество перед подходами, основанными на поиске в интернете общего назначения. Когда уровень рассуждений повышается, а ограничение по времени ослабляется (неограниченная абляция в разделе 4.3), разрыв между финансовым агентом и системами общего назначения сокращается по большинству измерений, что подтверждает способность передовых моделей выдавать более качественные финансовые ответы при наличии достаточного времени и вычислительного бюджета. Однако это улучшение сопровождается значительными затратами на задержку (Приложение C), и эффект задержки удваивает штраф при операционном временном бюджете: повышение уровня рассуждений увеличивает время выполнения каждого вызова инструмента, поэтому применение более высокого уровня рассуждений при ограничении в 60 с привело бы к тому, что тайм-аут срабатывал бы еще чаще, чем при низком уровне, снижая производительность в условиях ограничений ниже показателей, достигаемых при запусках с низким уровнем усилий. Это взаимодействие между уровнем рассуждений и тайм-аутом является критически важным фактором для практиков: бюджет в 60 с, использованный в основных экспериментах, отражает требования к пользовательскому опыту в стиле чата, и в рамках этого режима низкий уровень рассуждений является не просто выбором для экономии затрат, а конфигурацией, которая максимизирует качество для систем общего назначения..
Методология оценки и будущие направления.
Оценка на основе рубрик по нескольким критериям предоставляет значительно более богатый диагностический сигнал, чем бинарные метрики прохождения или отказа, позволяя специалистам понять не только то, работает ли система, но и по каким параметрам она превосходит аналоги или не дотягивает до них, а также как эти показатели меняются при ограничениях развертывания. Будущие исследования должны расширить бенчмарк до многоходовых диалоговых сценариев, дополнительных финансовых областей (управление казначейством, финансовое планирование и анализ, регуляторная отчетность) и структурированных подходов к проверке фактов, которые могли бы обеспечить измерение точности для задач с публичными данными без необходимости использования статического корпуса эталонных данных..
7 Отказ от ответственности
© © Корпорация Майкрософт, 2026. Все права защищены. Данный документ предоставляется «как есть». Информация и мнения, изложенные в данном документе, включая ссылки на URL и другие интернет-сайты, могут быть изменены без предварительного уведомления. Вы несете риск использования данного документа. Приведенные здесь примеры предназначены только для иллюстрации..
Настоящий документ не предоставляет вам никаких юридических прав на интеллектуальную собственность в отношении любого продукта Microsoft. Вы можете копировать и использовать данный документ для своих внутренних справочных целей
Список литературы
- ⟦ Конституционный искусственный интеллект: безопасность на основе обратной связи от искусственного интеллекта. arXiv preprint arXiv:2212.08073. Цитируется в: §2.1⟧.
- ⟦ Контроль частоты ложных открытий: практичный и эффективный подход к множественному тестированию. Журнал Королевского статистического общества: серия B (Методологическая) 57 (1), стр. 289–300. Цитируется в: Appendix A.
- ⟦ Агентный финансовый бенчмарк: оценка LLM на реальных задачах финансовых исследований. Препринт arXiv:2508.00828. Цитируется в: §2.3.
- ⟦ Статистические методы оценки согласованности между двумя методами клинических измерений. The lancet 327 (8476), стр. 307–310. Цитируется в: Appendix A.
- ⟦ FinAgentBench: набор данных для бенчмаркинга агентного поиска в финансовых вопросах и ответах. Препринт arXiv:2508.14052. Цитируется в: §2.3⟧.
- ⟦ Обучение верификаторов для решения математических текстовых задач. arXiv preprint arXiv:2110.14168. Цитируется в: §2.1.
- ⟦ Статистические сравнения классификаторов на нескольких наборах данных. Journal of Machine Learning Research 7, стр. 1–30. Цитируется в: §3.4.1⟧.
- ⟦ Автостопом по галактике: руководство по проверке статистической значимости в обработке естественного языка. В материалах 56-го ежегодного собрания Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), стр. 1383–1392. Цитируется в: §3.4.1.
- ⟦ Toxigen: крупномасштабный набор данных, созданный машиной для обнаружения состязательной и неявной речи ненависти. В материалах 60-го ежегодного собрания ассоциации компьютерной лингвистики (том 1: Длинные статьи), стр. 3309–3326. Цитируется в: §2.1.
- ⟦ Оценка понимания языка в масштабных многозадачных средах. arXiv preprint arXiv:2009.03300. Цитируется в: §1, §2.1.
- ⟦ Измерение навыков решения математических задач с помощью набора данных math. arXiv preprint arXiv:2103.03874. Цитируется в: §2.1.
- ⟦ FinanceBench: новый бенчмарк для ответов на финансовые вопросы. arXiv preprint arXiv:2311.11944. Цитируется в: §2.2.
- ⟦ Анализ данных: подход на основе сравнения моделей. Харкорт Брейс Йованович, Сан-Диего, Калифорния. Цитируется в: §3.4.1.
- ⟦ Dspy: компиляция декларативных вызовов языковых моделей в самосовершенствующиеся конвейеры. arXiv препринт arXiv:2310.03714. Цитируется в: §3.2.
- ⟦ FactKG: проверка фактов посредством рассуждений на графах знаний. В материалах 61-го ежегодного собрания Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), стр. 16190–16206. Цитируется в: §2.1⟧.
- ⟦ AlpacaEval: автоматический оценщик моделей, следующих инструкциям. GitHub. Примечание: https://github.com/tatsu-lab/alpaca_eval Цитируется: §2.1⟧.
- ⟦ Truthfulqa: измерение того, как модели имитируют человеческие заблуждения. В материалах 60-го ежегодного собрания ассоциации компьютерной лингвистики (том 1: длинные статьи), стр. 3214–3252. Цитируется в: §1, §2.1.
- ⟦ AgentBench: оценка LLM в качестве агентов. В материалах Международной конференции по обучению представлениям (ICLR) 2024 года, Цитируется: §1, §2.3.
- ⟦ Оценщики LLM распознают и отдают предпочтение собственным генерациям. Достижения в системах нейронной обработки информации 37, стр. 68772–68802. Цитируется в: Appendix A.
- ⟦ Gorilla: большая языковая модель, подключенная к масштабным API. В сборнике Advances in Neural Information Processing Systems (NeurIPS), Цитируется: §2.3.
- ⟦ Squad: 100,000+ вопросов для машинного понимания текста. В материалах конференции 2016 года по эмпирическим методам в обработке естественного языка, стр. 2383–2392. Цитируется в: §2.1.
- ⟦ За пределами игры в имитацию: количественная оценка и экстраполяция возможностей языковых моделей. Труды по исследованиям в области машинного обучения. Цитируется в: §1, §2.1.
- ⟦ Линейные смешанные модели для лонгитюдных данных. Шпрингер, Нью-Йорк. Цитируется в: §3.4.1, §3.4.1.
- ⟦ Большие языковые модели не являются объективными оценщиками. В материалах 62-го ежегодного собрания Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), стр. 9440–9450. Цитируется в: Appendix A.
- ⟦ ScienceWorld: умнее ли ваш агент пятиклассника?. В материалах конференции 2022 года по эмпирическим методам в обработке естественного языка (EMNLP), Цитируется: §2.3.
- ⟦ BloombergGPT: большая языковая модель для финансов. Препринт arXiv:2303.17564. Цитируется в: §2.2⟧.
- ⟦ FinBen: комплексный финансовый бенчмарк для LLM. arXiv preprint arXiv:2402.12659. Цитируется в: §2.2.
- ⟦ WebShop: на пути к масштабируемому взаимодействию с реальными веб-ресурсами с помощью языковых агентов, основанных на контексте. В сборнике трудов Advances in Neural Information Processing Systems (NeurIPS), Цитируется в: §2.3.
- ⟦ -Bench: бенчмарк для взаимодействия агента с инструментами и пользователем в реальных предметных областях. arXiv preprint arXiv:2406.12045. Цитируется в: §1, §1, §2.3.
- ⟦ ReAct: синергия рассуждения и действия в языковых моделях. arXiv preprint arXiv:2210.03629. Цитируется в: §1, §2.3.
- ⟦ Бенчмаркинг использования инструментов LLM в реальных условиях. arXiv preprint arXiv:2604.06185. Цитируется в: §1, §2.3.
- ⟦ Safetybench: оценка безопасности больших языковых моделей. В материалах 62-го ежегодного собрания Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), стр. 15537–15553. Цитируется в: §2.1.
- ⟦ Оценка LLM-as-a-judge с использованием MT-Bench и Chatbot Arena. Достижения в системах нейронной обработки информации 36, стр. 46595–46623. Цитируется в: Appendix A, §1, §2.1⟧.
Приложение
Appendix A Анализ предвзятости LLM Judge
Чтобы оценить, влияет ли выбор LLM в качестве судьи на выводы бенчмарка, мы оценили один и тот же набор ответов агентов с помощью двух судей: GPT-5.2 (основной) и Claude Opus 4.6 (валидационный). Анализ проводился на результатах инференса Claude Haiku 4.5, который показал самые низкие показатели точности среди всех провайдеров в основных результатах; поэтому нашей главной задачей было выяснить, может ли судья систематически ставить эту систему в невыгодное положение, и если да, то какая часть наблюдаемого разрыва в точности по отношению к Finance Agent может быть отнесена на счет калибровки судьи, а не реальных различий в качестве ответов. Недавние исследования показали, что LLM судьи не всегда являются объективными оценщиками [Zheng et al., 2023, Wang et al., 2024] и часто отдают предпочтение выводам, полученным от моделей собственного семейства [Panickssery et al., 2024]. Это позволило получить 25–150 сопоставленных пар вопросов для каждого типа задач после выполнения внутреннего соединения по (question, task-type, segment).
Метод.
Для каждой ячейки (тип задачи, метрика), содержащей не менее пяти сопоставленных пар, мы вычислили дельту оценок для каждого вопроса и применили двусторонний критерий знаковых рангов Уилкоксона, чтобы оценить, значимо ли среднее смещение отличается от нуля. Значения P-values были скорректированы с учетом множественных сравнений с использованием процедуры контроля частоты ложных обнаружений Бенджамини–Хохберга [Benjamini and Hochberg, 1995]. Ранговые корреляции Спирмена были вычислены для оценки того, согласуются ли эксперты в относительном ранжировании качества ответов, независимо от любого сдвига уровня. Мы определили порог практической значимости как минимальное смещение, операционно значимое для сравнения поставщиков (изменение на пять пунктов по шкале от 0 до 100).).
Сдвиг калибровки.
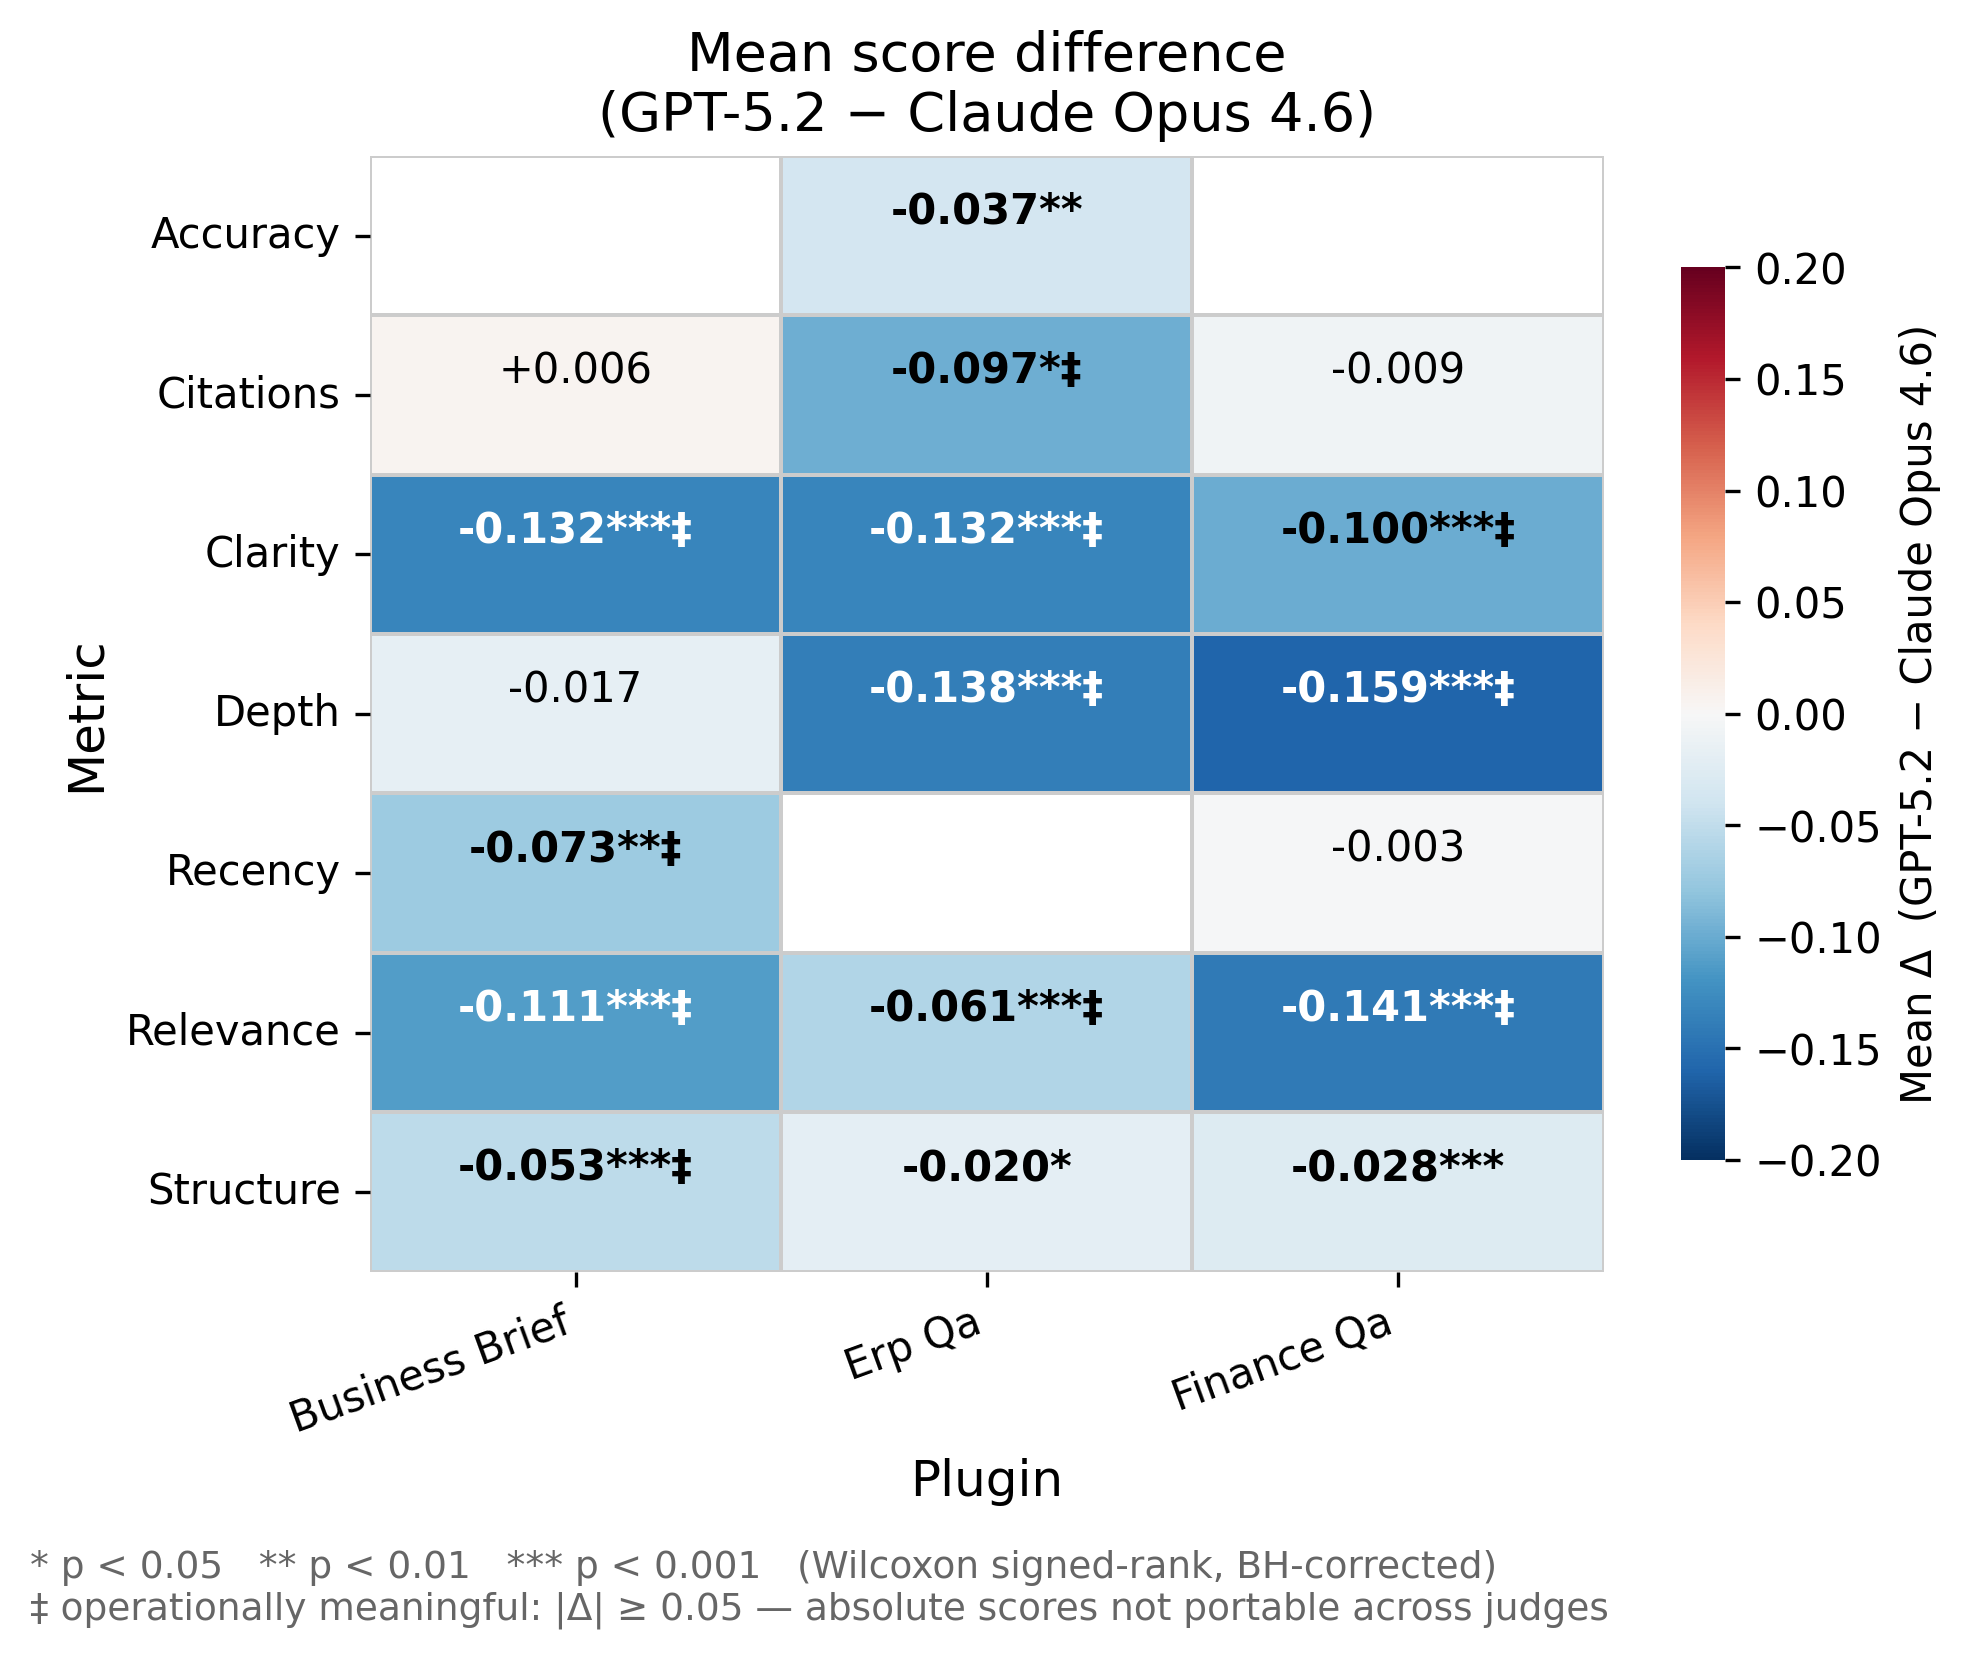
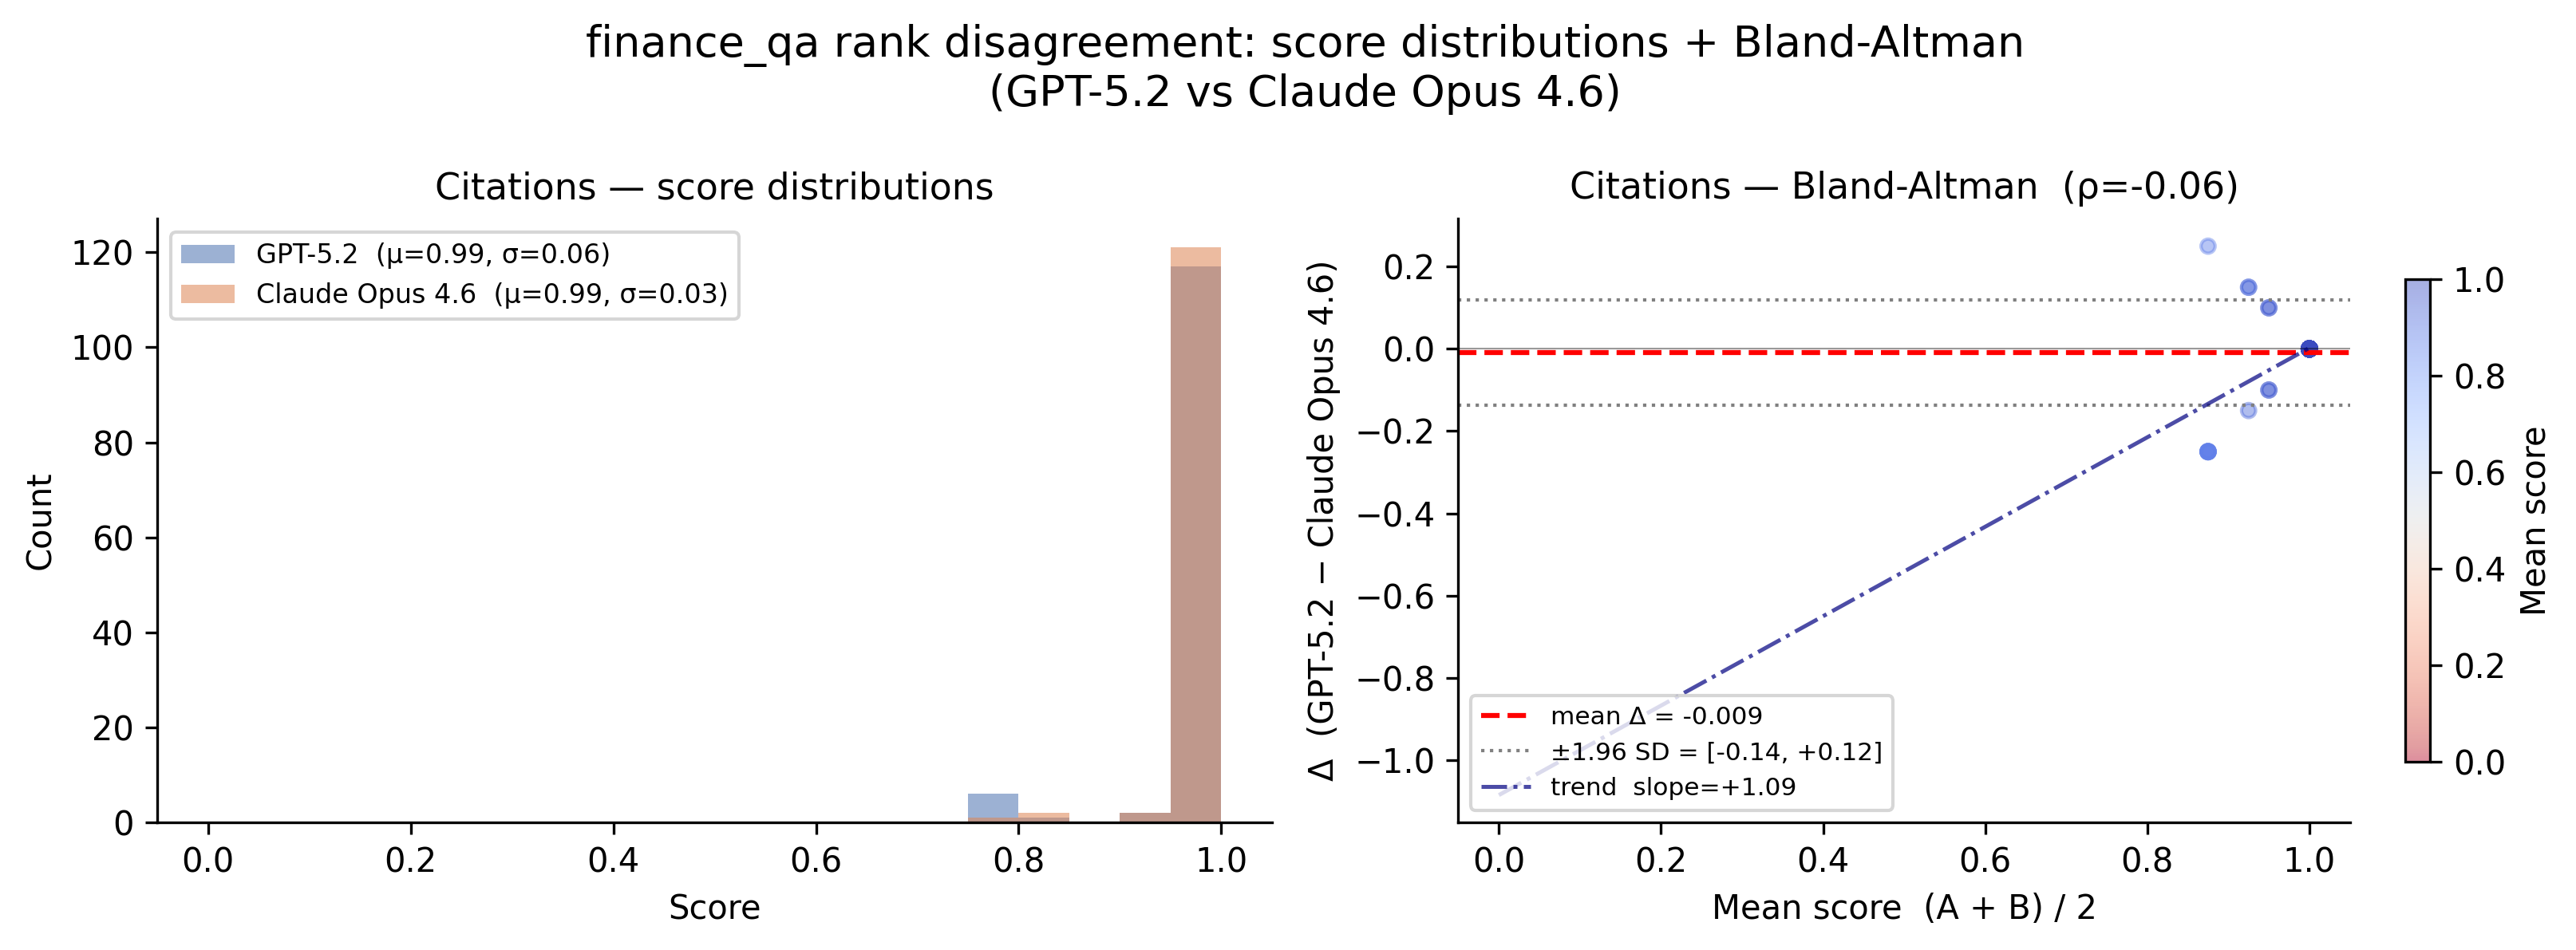
На рисунке 5 показана разница средних баллов для каждой ячейки (тип задачи, метрика). GPT-5.2 является значительно более строгим судьей в 14 из 18 значимых ячеек. Ясность демонстрирует наибольшие отклонения по всем трем типам задач (от до ), что согласуется с применением GPT-5.2 более строгих стилистических стандартов. Исключениями являются ячейки, в которых оба судьи выставляют оценки, близкие к максимальным, что не оставляет места для систематического отклонения. Для генерации бизнес-сводок нет существенной разницы между судьями в отношении цитирований (–). Также нет существенной разницы между судьями для измерений исследования сущностей финансовых показателей: актуальности (–) и цитирований (–). Несмотря на относительно низкие баллы по метрике глубины для генерации бизнес-сводок и глубины (–), мы также не наблюдали существенной разницы между судьями для этих ячеек..
Согласованность рангов.
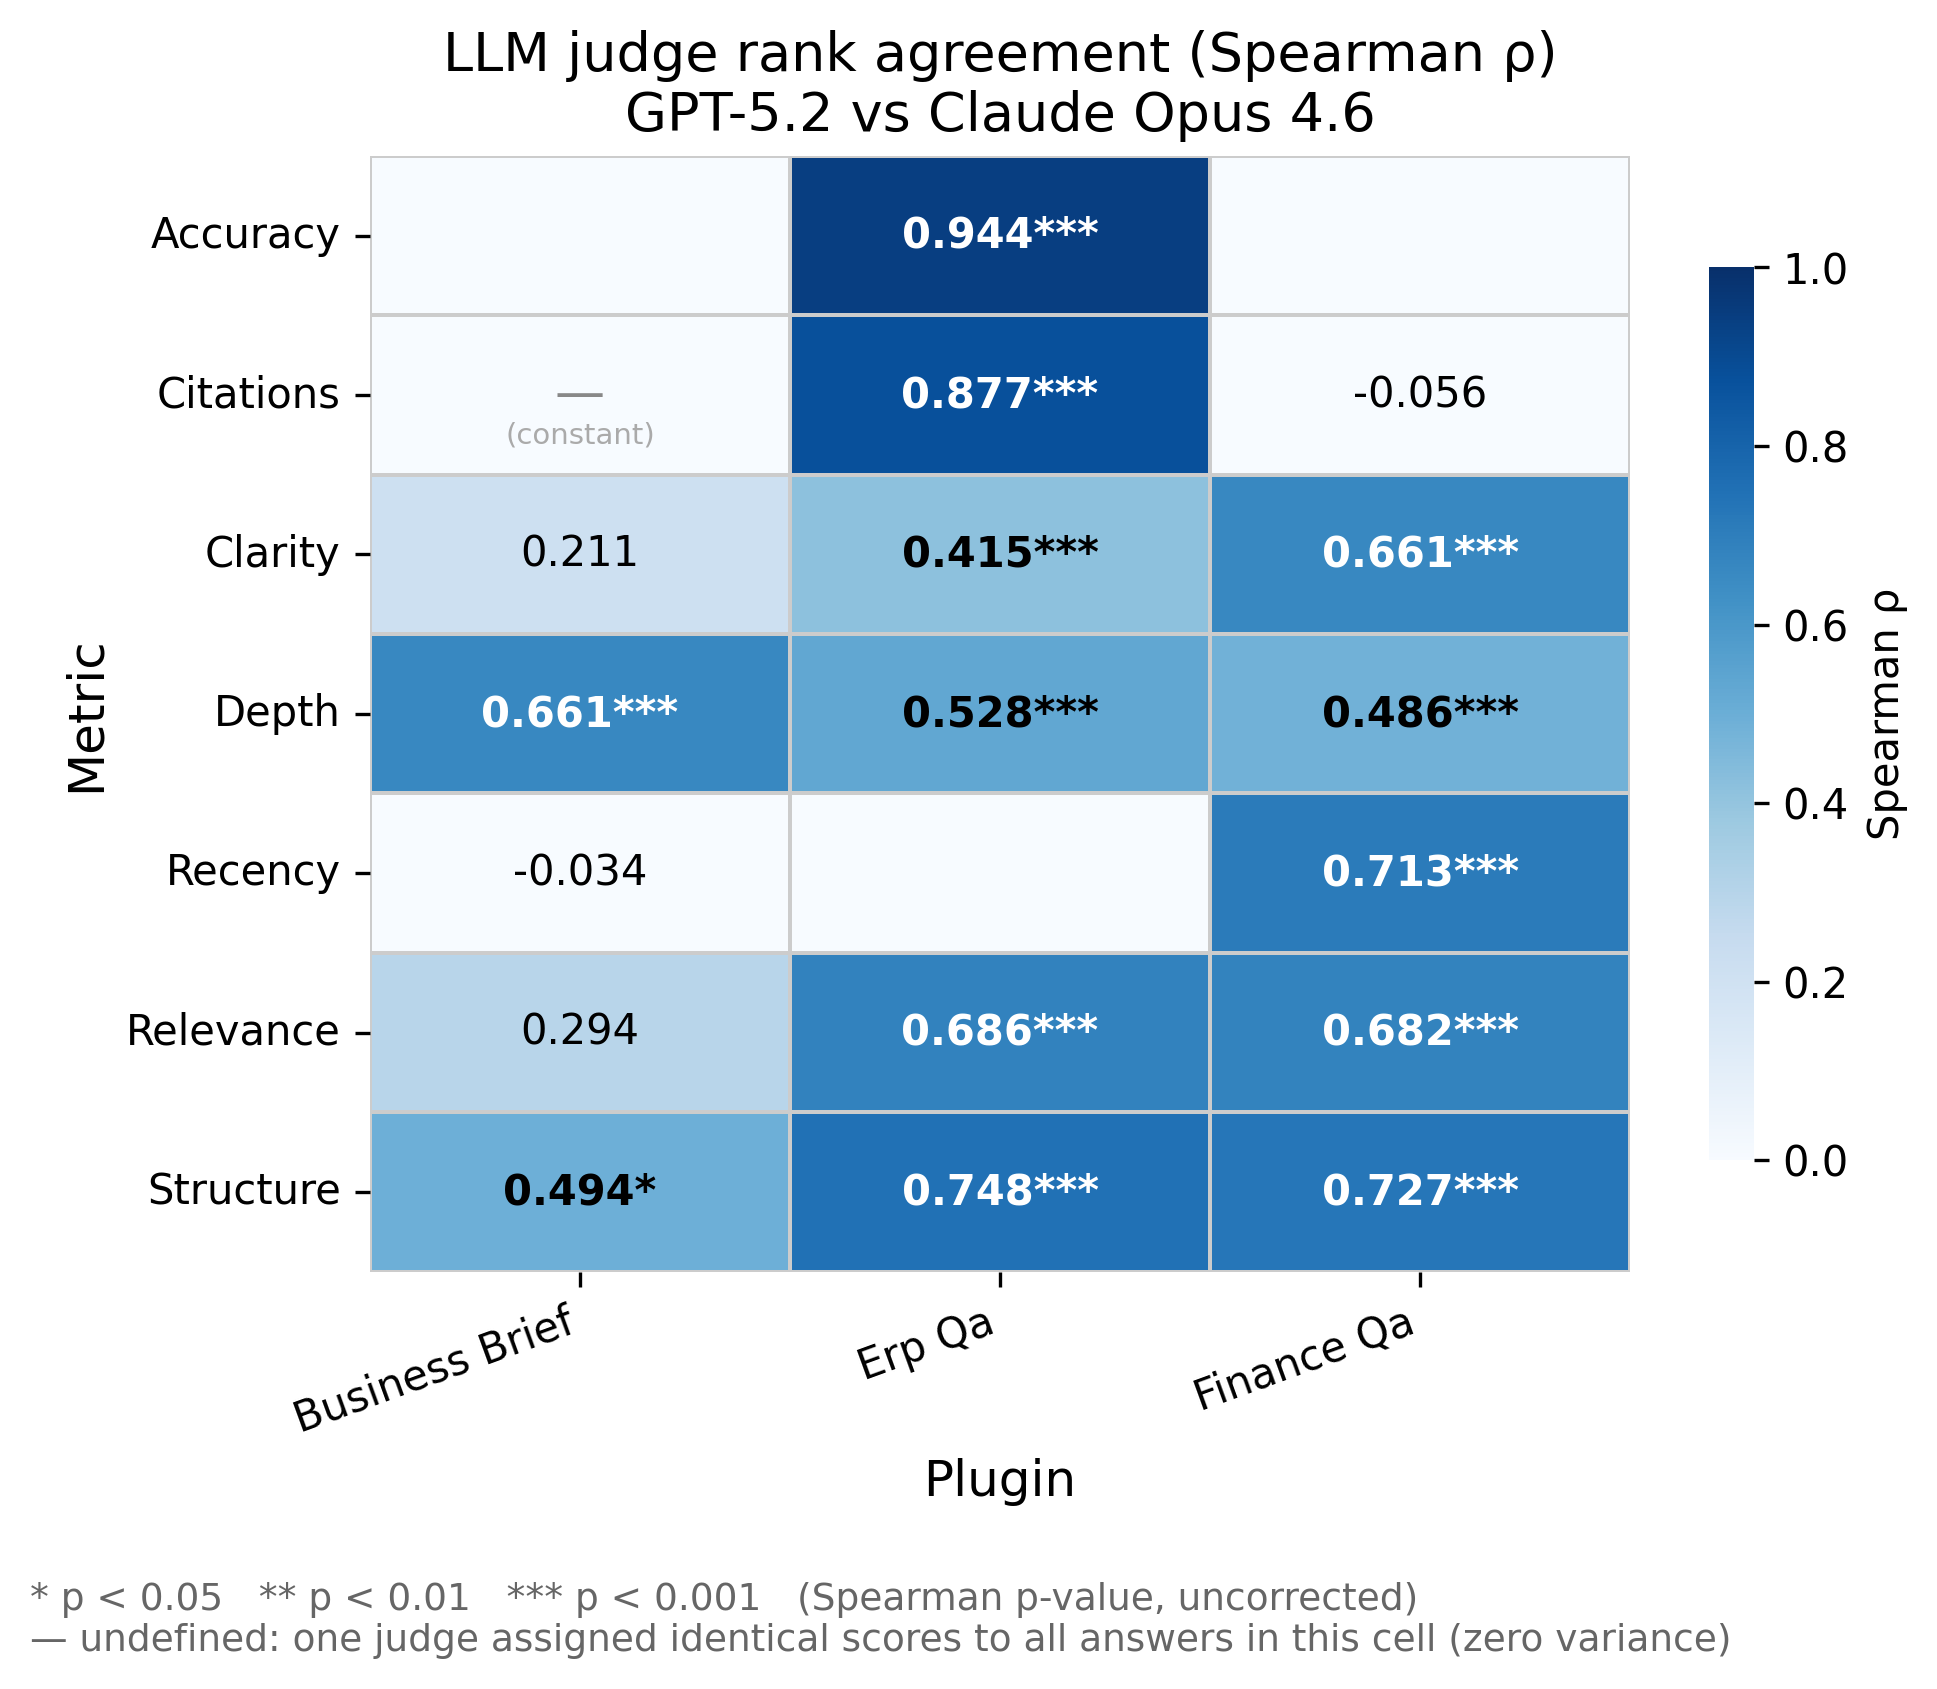
На рисунке 6 показаны значения Spearman для каждой ячейки. Точность ERP является наиболее устойчивой ячейкой (): эксперты приходят к твердому согласию относительно того, какие ответы являются фактически верными, несмотря на небольшое смещение уровня (). В ячейке цитирования бизнес-сводок сообщается о неопределенном , поскольку GPT-5.2 присвоила идентичные оценки всем 25 ответам (нулевая дисперсия); эта метрика не обладает дискриминационной способностью для бизнес-сводок независимо от эксперта..
Несогласие в ранжировании.
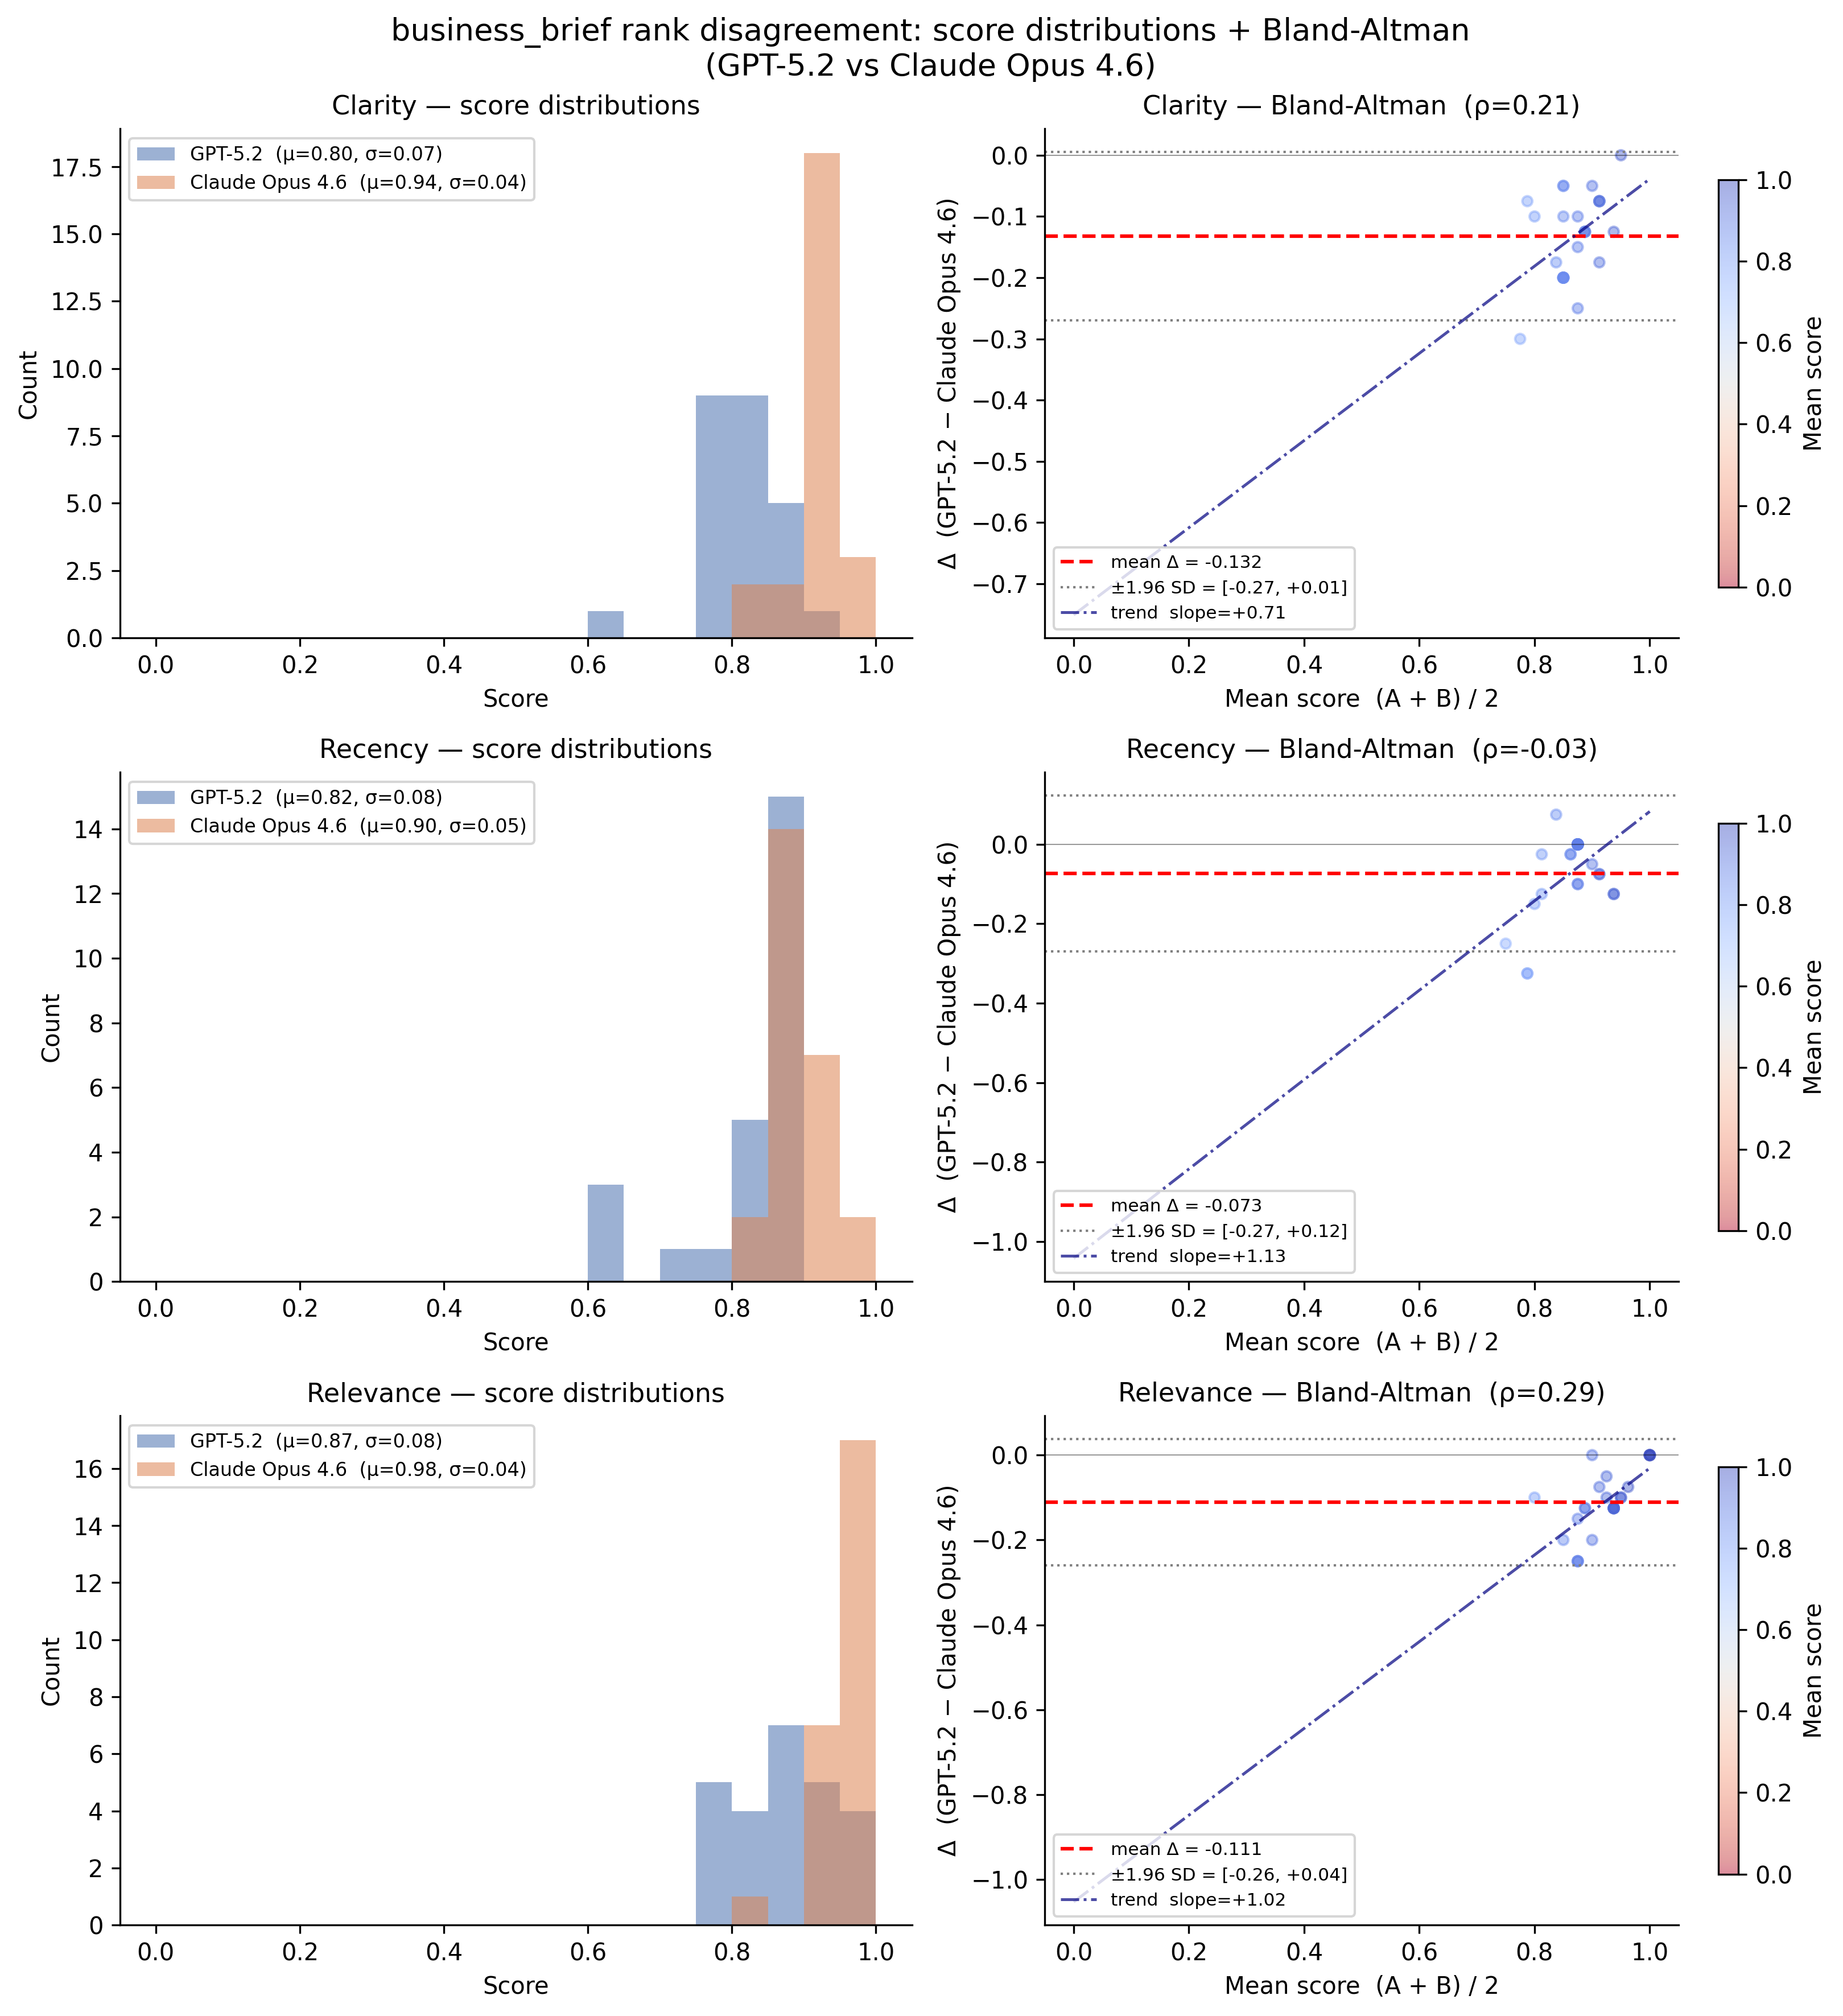
Для исследований эффективности финансовых организаций цитирования показывают наименьшее согласие по рангам (). Для генерации бизнес-сводок ясность, актуальность и релевантность показывают наименьшее согласие по рангам (–). Чтобы диагностировать, отражает ли это подлинное расхождение в оценке качества или является статистическим артефактом, на Рисунке 7 и Рисунке 8 представлены распределения оценок и графики Бланда-Альтмана [Bland and Altman, 1986] для двух типов задач. Они демонстрируют закономерность, которая согласуется с артефактом сжатия потолка, а не с фундаментальным расхождением в оценке качества; низкие значения обусловлены узким диапазоном оценок Opus, снижающим ранговую дискриминацию..
Последствия.
Что касается конкретной проблемы, побудившей к проведению данного анализа — объясняет ли предвзятость судьи разрыв в точности между Finance Agent (0.77) и Claude Haiku 4.5 (0.41) в исследованиях финансовых обязательств, — ячейка точности ERP дает уверенность: ранговое согласие очень высокое (), а среднее смещение уровня мало (), что означает, что GPT-5.2 оценивает точность ERP примерно на 0.037 ниже, чем Opus 4.6 для ответов Haiku. Даже если бы это смещение было применено в качестве поправки, скорректированная точность Haiku в все равно значительно уступала бы показателю Finance Agent в 0.77, оставляя существенный разрыв неизменным. Таким образом, предвзятость судьи объясняет лишь малую часть наблюдаемой разницы в точности. Абсолютные оценки, однако, не являются переносимыми между запусками оценки, в которых используются разные модели-судьи; практикам, желающим сравнить оценки между запусками судей, следует применять поправки для каждой пары (тип задачи, метрика), используя смещения, указанные на Рисунке 5.⟧.
Appendix B Распределения вызовов инструментов
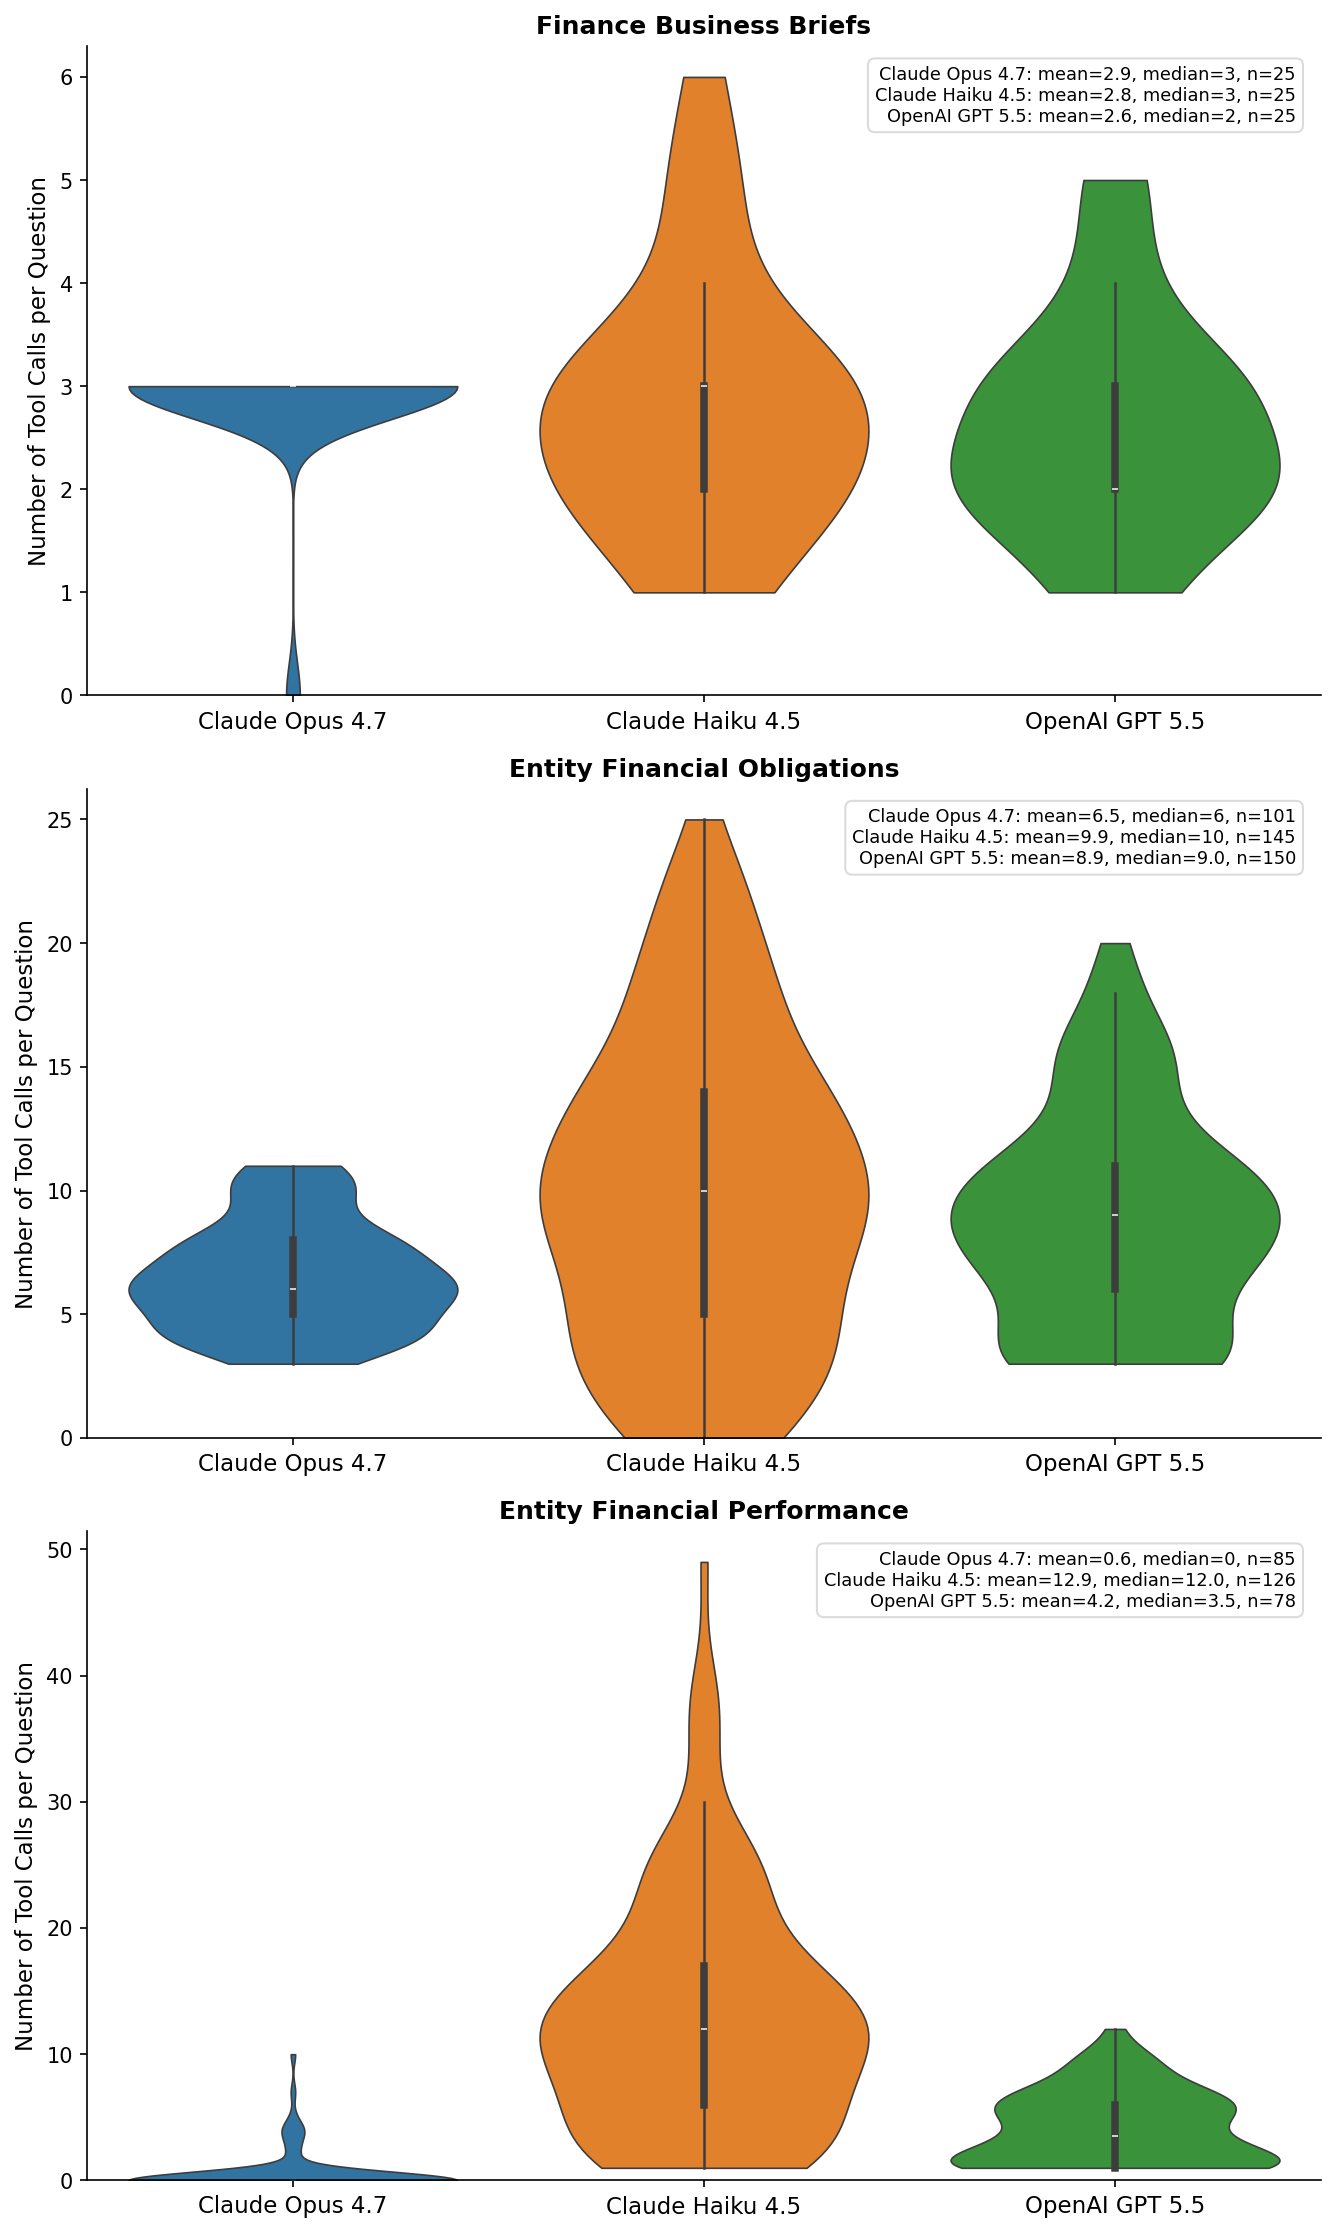
На рисунке 9 показано распределение вызовов инструментов на один вопрос для каждого провайдера и типа задачи.
Для исследований финансовых обязательств Claude Haiku 4.5 и GPT 5.5 совершают в среднем 9–10 вызовов на вопрос, а Claude Opus 4.7 — в среднем 6; для исследований эффективности финансовых организаций Claude Haiku 4.5 достигает медианного значения в 12 вызовов. Этот более высокий объем вызовов напрямую объясняет снижение производительности, наблюдаемое при ограничениях по времени ожидания (раздел 4.3): агенты, которым требуется множество последовательных этапов поиска для формирования полного ответа, несоразмерно сильно штрафуются при жестком ограничении по времени..
Для исследования эффективности финансовых организаций Claude Opus 4.7 демонстрирует медиану в 0 вызовов инструментов, при этом распределение сильно сконцентрировано на нуле. Это согласуется с тем, что модель часто полагается на параметрические знания, а не на оперативное извлечение данных для данного типа задач при стандартной конфигурации рассуждений, используемой в основных запусках. Интересно, что на Рисунке 10 показано, что отсутствие вызовов инструментов не приводит к существенно меньшей задержке для Opus 4.7 в задачах этого типа, что позволяет предположить, что модель может тратить больше времени на внутренние размышления или генерацию более длинных ответов, а не на выполнение внешних вызовов, либо что Claude CLI не полностью зафиксировал все вызовы инструментов, сделанные моделью..
Appendix C Распределения задержки вывода
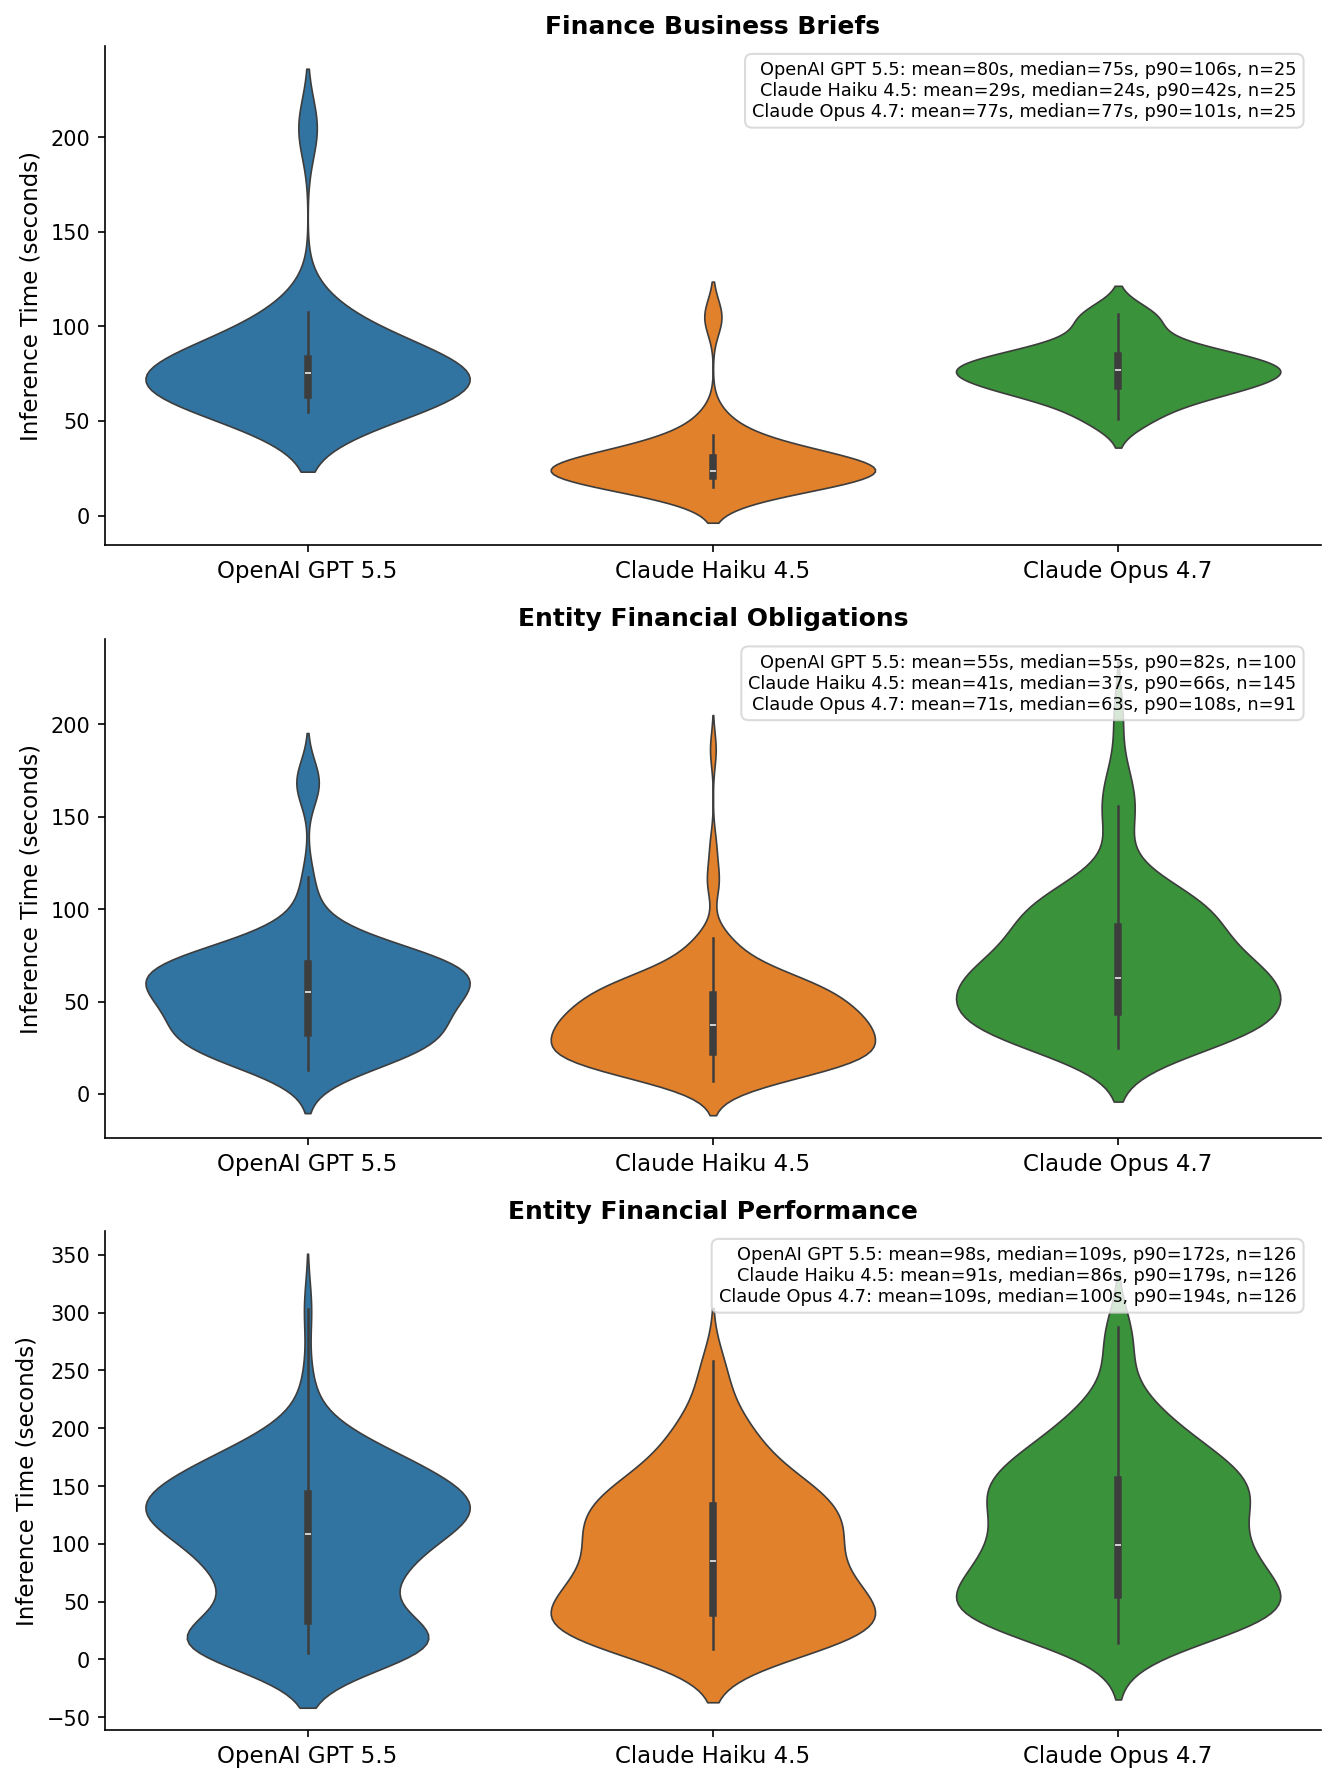
На рисунке 10 показаны распределения задержки вывода на один вопрос для трех универсальных провайдеров по всем типам задач, измеренные при нерегулируемых запусках с настройками рассуждения по умолчанию для GPT 5.5, Claude Haiku 4.5 и Claude Opus 4.7. Finance Agent исключен, так как его специализированный конвейер имеет другие характеристики задержки, которые невозможно напрямую сопоставить с универсальными инструментами..
Claude Haiku 4.5 значительно быстрее двух других провайдеров при подготовке бизнес-сводок (медиана 24 с против 75–77 с), что согласуется с меньшим размером модели. Однако для исследования эффективности финансовых организаций все три провайдера демонстрируют схожие диапазоны задержки (среднее значение 91–109 с, p90 172–194 с), что отражает большое количество последовательных вызовов инструментов, необходимых для данного типа задач, независимо от размера модели (см. Приложение B⟧).
Распределения задержек также позволяют контекстуализировать результаты абляционного исследования тайм-аутов (Раздел 4.3). Для исследования эффективности финансовых организаций p90 задержки всех трех провайдеров (172–194 с) значительно превышают бюджет в 60 с, что объясняет резкое снижение оценок, наблюдаемое при данном ограничении. Для исследования финансовых обязательств значения p90 варьируются от 66 с (Claude Haiku 4.5) до 108 с (Claude Opus 4.7), что означает, что значительная часть вопросов уже превышает лимит в 60 с при работе без ограничений. Генерация бизнес-сводок комфортно укладывается в бюджет 300 с для всех провайдеров (p90 106 с), что согласуется с отсутствием значимого снижения оценок при данном ограничении..