ClinFusion: Мультимодальная LLM-система с визуально-ориентированной архитектурой для комплексного медицинского анализа
Аннотация
Мультимодальные LLM обладают огромным потенциалом для революционизирования клинической практики, однако их внедрение в медицинской сфере является фундаментально vision-centric задачей: модели должны усваивать знания из гетерогенных 2D и 3D медицинских изображений, а протоколы оценки должны соответствовать клинической практике радиологов и обеспечивать точную, детализированную и основанную на фактах оценку. В этой статье мы представляем ClinFusion, vision-centric MLLM, разработанную для целостного медицинского понимания, которая систематически устраняет эти ограничения. Мы предлагаем композиционную и каскадную архитектуру vision encoder, включающую оператор Cascade Spatial-Aware Locality Fusion, который объединяет понимание разнообразных 2D и нативных 3D медицинских изображений в рамках единого encoder. Мы также представляем основанную на визуальных данных структуру оценки, включая MedIF-Bench для оценки instruction-following и метод, основанный на region-of-interest, для оценки генерации отчетов, ориентированной на клиническое соответствие и фактическую точность. Мы показываем, что ClinFusion устанавливает новый state-of-the-art для комплексного набора 2D и 3D мультимодальных медицинских бенчмарков — охватывающих visual question answering, генерацию отчетов и instruction following, — а также текстовых медицинских задач, превосходя ведущие open-source медицинские MLLM (например, Hulu-Med, Lingshu) по 20 из 24 бенчмарков и демонстрируя мультимодальные возможности, превосходящие мощные проприетарные модели, такие как GPT-5.2 и Gemini-3-Flash, по 13 из 16 бенчмарков, и может быть дополнительно расширена за счет agentic tool use для retrieval-augmented и tool-assisted клинических рабочих процессов. Слепая оценка сертифицированными радиологами подтверждает, что ClinFusion создает отчеты с наивысшим рейтингом, и подтверждает, что наша RoI-grounded метрика достигает сильнейшей корреляции с экспертным суждением среди всех рассмотренных автоматических метрик оценки..
Github: https://github.com/alibaba-damo-academy/ClinFusion⟧
Huggingface: https://huggingface.co/collections/Alibaba-DAMO-Academy/clinfusion⟧
1 Введение
Недавнее распространение мультимодальных больших языковых моделей (MLLMs) открыло беспрецедентные возможности в интеграции и анализе различных модальностей данных [1, 2, 3, 4, 5]. Вследствие этого медицинская сфера стала благодатной почвой для интеллектуальных систем на базе MLLM, которые обладают огромным потенциалом для революционного преобразования таких задач, как автоматизированная диагностика, генерация клинических отчетов и интерактивная поддержка принятия решений..
Поскольку клинические решения преимущественно опираются на визуальные доказательства — от рентгенограмм и патологических препаратов до объемных КТ и МРТ-сканов, — успешное внедрение MLLMs в критически важной медицинской сфере является фундаментально задачей, ориентированной на визуальное восприятие. Эта задача проявляется в двух тесно связанных аспектах: 1) Усвоение визуальных знаний: архитектура должна нативно обрабатывать и интериоризировать гетерогенные визуальные знания, уникальные для медицины, охватывающие разнообразные 2D и 3D модальности визуализации; и 2) Оценка на основе визуальных данных: система оценки должна выходить за рамки поверхностного текстового сопоставления и вместо этого оценивать визуальное понимание модели посредством клинически значимого анализа на уровне областей, который отражает реальную диагностическую практику. В основе обоих аспектов лежит принципиальный конвейер подготовки данных, который обеспечивает разнообразный и высококачественный визуальный обучающий сигнал, необходимый для надежного медицинского восприятия. Действительно, недавние достижения в области медицинских MLLMs позволили сделать шаги в решении этих аспектов [6, 7, 8, 9, 10, 11, 12, 13].
Несмотря на многообещающие результаты на установленных бенчмарках для мультимодальных [14, 15, 16] и текстовых [17, 18, 19] медицинских задач, сохраняются критические пробелы в обоих указанных выше аспектах, ориентированных на визуальное восприятие — усвоение визуальных знаний и оценку на основе визуальных данных, — которые препятствуют переходу MLLM к реальной клинической практике. Первая критическая проблема заключается в гетерогенном усвоении визуальных знаний: Одиночный монолитный vision encoder зачастую неадекватен для захвата разнообразных знаний, заложенных в гетерогенных медицинских данных. Медицинская визуализация фундаментально мультимодальна и охватывает широкий спектр 2D (например, рентгеновские снимки, патологические слайды, изображения глазного дна) и 3D (например, КТ и МРТ сканы) модальностей. Это разнообразие представляет собой гораздо более сложную задачу для извлечения и понимания визуальных признаков, чем в приложениях общего назначения. Преобладающий подход в медицинских MLLM был преимущественно ориентирован на данные: такие модели, как Lingshu [6], Hulu-Med [7], LLaVA-Med [9] и HuatuoGPT-Vision [12], адаптируют vision-language бэкбоны общего назначения посредством поэтапного SFT на тщательно отобранных наборах данных «изображение-текст», однако их базовые архитектуры зрения остаются по большей части неизменными — как правило, это одиночный монолитный энкодер. Существующие архитектурные стратегии можно в широком смысле разделить на две группы: 2D-центричный подход, который рассматривает все визуальные данные как 2D-изображения путем выборки плотных срезов из 3D-объемов [20, 6, 7, 8], что неизбежно приводит к потере критически важной 3D-структурной информации; 3D-центричный подход, который использует репрезентативные энкодеры для 3D-данных, требующие обширных и сложных процедур выравнивания [21, 22, 23]. Хотя многоэнкодерные конструкции исследовались в области general vision-language [24, 25, 26, 27, 28, 29], они нацелены на входные данные с разным разрешением или более высокую остроту зрения, а не на уникальные проблемы медицинской визуализации. Наиболее близкая работа, Cambrian-1 [26], использует параллельную конструкцию для агрегации визуальной информации от нескольких vision encoders, но ей не хватает нативного 3D-энкодера и механизма управляемой фузии, который предлагаем мы..
Вторая критическая проблема заключается в оценке, основанной на визуальных данных. Текущие протоколы оценки для медицинских MLLM имеют два критических пробела. Первый заключается в том, что существующие бенчмарки упускают из виду способность следовать инструкциям, которая часто снижается при дообучении (SFT) под конкретную предметную область, но остается обязательным условием для любой значимой последующей оценки и клинического внедрения. Второй сосредоточен на генерации отчетов. Генерация отчетов является одним из наиболее клинически важных приложений медицинских MLLM, однако ее оценка остается фундаментально несовершенной. Распространенная практика оценки способности к генерации отчетов заключается в том, чтобы 1) предоставить общую инструкцию для MLLM по созданию комплексного отчета, а затем 2) сравнить сгенерированный отчет с эталонным. Однако эта парадигма не соответствует клинической практике: радиологи интерпретируют изображения, руководствуясь клиническим контекстом пациента (например, показания к направлению, история болезни), что направляет их внимание на конкретные анатомические области и формирует структуру их отчетов, в то время как текущие протоколы заставляют модели создавать комплексные отчеты без какой-либо ориентации на пациента. Более того, существующие метрики сравнивают сгенерированные отчеты с эталонными посредством поверхностного лексического или семантического сопоставления (например, BLEU, ROUGE [30], METEOR [31], CIDEr [32], BERTScore [33]), извлечения и сопоставления на уровне сущностей, которые опираются на правила или маломасштабные модели с ограниченной точностью (например, RadGraph-F1 [34], RaTEScore [35]), или целостной оценки на основе LLM, которая смешивает точность и полноту (например, GREEN [36]) — ни один из этих методов не обеспечивает точную, детализированную и основанную на фактических данных декомпозицию совпавших, пропущенных и галлюцинированных клинических находок. Помимо этих двух основных проблем, ориентированных на визуальное восприятие, еще одним практическим соображением является то, что MLLM по своей сути являются пассивными и изолированными системами: их параметрические знания статичны, их рассуждениям не хватает прослеживаемости, и они сталкиваются с узкими местами в восприятии при выполнении специализированных задач, где специализированные модели ИИ остаются более эффективными [37, 38, 39, 40].
Для решения этих фундаментальных проблем мы представляем ClinFusion, мультимодальную LLM с ориентацией на визуальные данные, разработанную для целостного медицинского анализа. Как показано в fig. 1, наша работа представляет принципиальную структуру, которая систематически устраняет каждое из вышеупомянутых ограничений посредством вклада, охватывающего архитектуру, оценку и системную интеграцию..
Во-первых, чтобы преодолеть проблему усвоения гетерогенных визуальных знаний, мы предлагаем композиционный визуальный энкодер. Вместо того чтобы полагаться на монолитный энкодер, ClinFusion объединяет фундаментальный и хорошо согласованный vision transformer с ансамблем специализированных 2D-энкодеров. Что еще более важно, мы представляем Cascade Spatial-Aware Locality (CaSL11 1 CaSL произносится как «castle» (UK: /‘kA:s@l/, US: /‘kæs@l/).) Fusion — иерархический оператор, который обеспечивает каскадное взаимодействие между 2D-энкодерами, что постепенно обогащает фундаментальное визуальное представление, сохраняя при этом его согласованность. Для нативной обработки объемных данных мы дополнительно внедряем специализированный 3D-энкодер и проектируем 2D-привязанный CaSL Fusion с учетом глубины, где хорошо согласованные представления 2D-признаков направляют выравнивание 3D-признаков. В отличие от параллельных конструкций агрегации в предыдущих работах [26], ClinFusion уникальным образом включает нативный 3D-визуальный энкодер наряду с композиционным ансамблем 2D-энкодеров, координируемых оператором CaSL Fusion, который обеспечивает как каскадное взаимодействие между 2D-энкодерами для прогрессивного обогащения признаков, так и уникальное 2D-привязанное взаимодействие между 2D и 3D модальностями..
Во-вторых, чтобы преодолеть разрыв между оценкой и клинической практикой, мы представляем основанную на визуальных данных систему оценки, сосредоточенную на двух ключевых инновациях. Мы предлагаем MedIF-Bench, комплексный бенчмарк, который решает критическую, но упускаемую из виду проблему следования инструкциям в медицинском контексте, оценивая, могут ли MLLM точно выполнять сложные практические медицинские инструкции — необходимое условие для надежного клинического взаимодействия. Более фундаментально, для задач с интенсивным использованием визуальных данных, таких как генерация отчетов, мы вводим методологию оценки, основанную на области интереса (RoI), которая согласовывает генерацию с клинической практикой путем учета специфического для пациента клинического контекста (т.е. клинически значимых анатомических областей) и использует LLM-as-a-judge для декомпозиции диагностических утверждений на совпадающие, пропущенные и галлюцинированные находки, что обеспечивает точную и основанную на фактах оценку..
Чтобы подтвердить как нашу модель, так и нашу методологию оценки в сравнении с экспертным клиническим суждением, мы проводим слепую экспертную оценку, в ходе которой шесть сертифицированных радиологов независимо ранжируют отчеты, созданные ClinFusion, Gemini-3-Flash и Hulu-Med, по 300 клиническим случаям, охватывающим модальности КТ и рентгенографии. Это исследование служит двойной цели: оно подтверждает, что ClinFusion создает отчеты с наивысшим рейтингом по фактической точности, полноте и клинической полезности, а также демонстрирует, что наша метрика, основанная на RoI, достигает наиболее сильной корреляции с экспертным суждением среди всех одиннадцати исследованных автоматических метрик, предоставляя прямое клиническое доказательство того, что наша система оценки измеряет именно то, что ценят клиницисты..
Более того, для улучшения практического развертывания ClinFusion в реальных клинических условиях мы разрабатываем агентную систему использования инструментов, которая расширяет возможности модели за пределы ее параметрических знаний. Эта система оснащает ClinFusion генерацией с дополнением поиска (RAG) для обоснования ответов актуальной, цитируемой медицинской литературой, а также набором инструментов экспертного восприятия, которые позволяют ей вызывать специализированные модели AI для высокоточного анализа, такого как сегментация органов или классификация заболеваний. Хотя основные технические вклады данной работы заключаются в архитектуре зрения и системе оценки, описанных выше, это агентное расширение демонстрирует, как ClinFusion может быть практически развернут в качестве активного клинического ассистента с динамическим доступом к знаниям и проверяемыми рассуждениями, дополненными инструментами..
Подводя итог, наши основные вклады заключаются в следующем:
- ⟦• Композиционная и каскадная архитектура компьютерного зрения, которая нативно объединяет гетерогенные 2D и 3D медицинские изображения посредством CaSL Fusion, каскадного механизма взаимодействия с 2D-привязкой, и прогрессивно обогащает фундаментальное и хорошо выровненное визуальное представление.
- ⟦• Новая система оценки на основе визуальных данных, включающая MedIF-Bench для анализа следования инструкциям в медицинских сценариях и методологию на основе RoI для более клинически ориентированной и точной оценки генерации отчетов.
- ⟦• Ведущая производительность, подтвержденная как автоматическими бенчмарками, так и экспертами-радиологами. ClinFusion достигает результатов уровня state-of-the-art в 2D и 3D мультимодальных медицинских бенчмарках, а также в текстовых медицинских задачах, превосходя как универсальные, так и медицинские MLLM, при этом мультимодальная производительность сопоставима с ведущими проприетарными моделями, такими как GPT-5.2 и Gemini-3-Flash. Слепая оценка, проведенная шестью сертифицированными радиологами на 300 клинических случаях, дополнительно подтверждает, что ClinFusion создает отчеты с наивысшим рейтингом, а наша метрика, основанная на RoI, наилучшим образом отражает экспертное клиническое суждение. Мы дополнительно демонстрируем, что оснащение ClinFusion агентной системой использования инструментов — интегрирующей динамический поиск знаний и внешние специализированные модели — обеспечивает последовательные улучшения как в текстовых, так и в мультимодальных клинических сценариях..
2 Результаты
В этом разделе представлены результаты нашего исследования, начиная с обзора предложенной архитектуры ClinFusion и условий оценки, за которыми следует подробный анализ основных выводов..
2.1 Обзор
2.1.1 Обзор системы
ClinFusion — это мультимодальная LLM с ориентацией на визуальные данные, разработанная для комплексного медицинского анализа. Как показано в fig. 2, система построена на двух ключевых компонентах: 1) композиционный и каскадный визуальный энкодер с оператором CaSL Fusion, который унифицирует обработку разнообразных 2D и нативных 3D медицинских данных путем постепенного обогащения базового представления Qwen ViT признаками из специализированных энкодеров; и 2) основанная на визуальных данных система оценки, включающая MedIF-Bench для проверки следования инструкциям и методологию на основе RoI для оценки генерации отчетов. Для дальнейшего улучшения практического развертывания ClinFusion дополнена расширением для использования агентских инструментов, которое оснащает модель RAG и возможностью вызывать внешние специализированные модели в качестве инструментов, демонстрируя стабильные улучшения как в текстовых, так и в мультимодальных клинических сценариях. Мы представляем результаты для нескольких вариантов нашей предложенной архитектуры. Наши основные модели, ClinFusion-8B и ClinFusion-32B, построены на базе Qwen3-VL-8B и Qwen3-VL-32B соответственно..
2.1.2 Настройки оценки
Модели для сравнения. Для всесторонней оценки производительности ClinFusion мы проводим обширные сравнения с тремя категориями современных моделей:
- ⟦• Ведущие универсальные MLLM: Мы включаем ведущие MLLM с открытым исходным кодом для создания базовой линии в общей предметной области. Сюда входят серии Qwen2.5-VL [1], серии Qwen3-VL [2] и серии InternVL3 [41]⟧.
- ⟦• Ведущие медицинские MLLM: Чтобы определить место ClinFusion в текущем ландшафте медицинского ИИ, мы сравниваем его с широким спектром специализированных медицинских MLLM. Это включает в себя недавние модели, такие как Lingshu [6], Hulu-Med [7], MedGemma [8], HuatuoGPT-V [12], LLaVA-Med [9], BioMediX2 [42], HealthGPT [43], MedDr [44], BiomedGPT [13], Med-R1 [11] и MedVLM-R1 [10]⟧.
- ⟦• Ведущие проприетарные модели: Мы также включаем результаты ведущих проприетарных моделей, включая GPT-5.2, Gemini-3-Flash, Claude-Sonnet-4.5, для проведения сравнительного анализа с текущим передовым уровнем развития мультимодального ИИ.
Для обеспечения объективного и воспроизводимого сравнения мы используем единый набор инструментов оценки для ведущих моделей с открытым исходным кодом. Для моделей, по которым доступны официальные контрольные точки, мы проводим повторную оценку их производительности на нашем полном наборе тестов, используя этот стандартизированный протокол. Для 3D-объемных входных данных мы по умолчанию выбираем 32 среза на объем, каждый из которых масштабируется до , если только официальный код вывода модели не предписывает иные настройки, в этом случае мы следуем его собственной конфигурации (например, Hulu-Med [7], которая обрабатывает все срезы). Для 2D-тестов все доступные изображения в каждом образце предоставляются модели без субдискретизации..
Набор для сравнительного тестирования. Мы оцениваем все модели с помощью разнообразного набора тестов (подробно описанных в section 4.2 и расширенной таблице данных 2), классифицированных следующим образом:
- ⟦• Мультимодальные медицинские бенчмарки 2D: Стандартные задачи VQA и генерации отчетов по 2D медицинским изображениям.
- ⟦• 3D мультимодальные медицинские бенчмарки: задачи, требующие понимания объемных данных, таких как КТ/МРТ-сканы.
- ⟦• Текстовые медицинские бенчмарки: стандартные наборы данных для медицинских вопросов и ответов, предназначенные для оценки базовых языковых и интеллектуальных возможностей компонента LLM.
- ⟦• Бенчмарк следования медицинским инструкциям (наш MedIF-Bench): предложенный нами бенчмарк для целенаправленной оценки способности модели следовать сложным, клинически значимым инструкциям.
Метрики оценки. Для бенчмарков VQA (как 2D, так и 3D) мы приводим точность для вопросов с множественным выбором (MCQ) и вопросов с открытым ответом. Для бенчмарков генерации отчетов мы используем предложенную нами методологию оценки на основе RoI (section 4.2.3), сообщая показатели Precision, Recall и F1, вычисленные с помощью LLM-as-a-Judge, которая оценивает клиническую корректность в пределах заданных анатомических областей. Для текстовых медицинских бенчмарков мы приводим точность. Для MedIF-Bench мы приводим показатель Overall Instruction-Following (Overall-IF), который измеряет процент ответов, соответствующих предписанному формату вывода посредством проверки на основе regex, выделяя соответствие формату как необходимое условие для надежного клинического развертывания..
2.2 Оценка по бенчмарку
2.2.1 Оценка на 2D мультимодальных медицинских бенчмарках
Лидирующие возможности VQA среди медицинских MLLM, конкурентоспособные по сравнению с проприетарными моделями. ClinFusion демонстрирует передовую производительность в широком наборе 2D медицинских бенчмарков, существенно превосходя как ведущие модели с открытым исходным кодом, так и мощные проприетарные API в задачах генерации отчетов и сложных задачах VQA. Наша оценка разделена на две ключевые области: разнообразный набор бенчмарков VQA и комплексная генеративная задача по созданию клинических отчетов..
В задачах VQA модель ClinFusion неизменно занимает первое или второе место по всем восьми бенчмаркам, демонстрируя свои надежные и универсальные способности к визуальному рассуждению. fig. 3a сравнивает ClinFusion с ведущими проприетарными, универсальными и медицинскими MLLM на восьми 2D-бенчмарках (подробные баллы приведены в дополнительной таблице 1). Наша модель ClinFusion-8B достигает наивысших результатов среди всех медицинских MLLM на семи из восьми бенчмарков, включая сложные мультимодальные наборы данных, требующие всестороннего понимания всех визуальных модальностей, и ориентированный на рассуждения MedXpertQA. При сравнении с проприетарными моделями ClinFusion-8B и ClinFusion-32B превосходят мощную Gemini-3-Flash на шести бенчмарках (OmniMedVQA, PMC-VQA, MedFrameQA, VQA-RAD, SLAKE, PathVQA), что доказывает, что специализированная, хорошо спроектированная open-source модель может превзойти даже самые продвинутые универсальные API в узкоспециализированных задачах. Для чрезвычайно сложных бенчмарков на рассуждение, таких как MedXpertQA, мы наблюдаем разрыв между нашей моделью и проприетарной моделью. Мы ожидаем, что этот разрыв может быть сокращен за счет масштабирования модели, поскольку мы наблюдаем явный прирост производительности при масштабировании ClinFusion-8B до ClinFusion-32B.
Лидирующие возможности генерации клинических отчетов в формате 2D среди медицинских MLLM и проприетарных моделей. В области генерации клинических отчетов ClinFusion также устанавливает новый уровень state of the art. Как показано на fig. 3b (подробные баллы в Supplementary Table 2), наша модель ClinFusion-8B достигает F1 score 37.8 на CheXpert-Plus и впечатляющих 57.3 на IU-XRAY. Это представляет собой существенное улучшение по сравнению с предыдущей небольшой open-source медицинской MLLM, Hulu-Med-7B (31.9 и 46.5 соответственно), что демонстрирует превосходную способность нашей модели генерировать клинически точный и связный текст с использованием фундаментально улучшенных возможностей зрения. При сравнении с проприетарными моделями все версии нашей модели находятся на том же уровне или превосходят эти проприетарные модели, особенно на наборе данных CheXpert-Plus, который ClinFusion явно превосходит..
Качественный пример на Extended Data Fig. 1a дополнительно иллюстрирует диагностические возможности ClinFusion в 2D. Несмотря на явное наличие кардиомегалии и выраженности легочного сосудистого рисунка на рентгенограмме грудной клетки, несколько сильных базовых моделей, включая Hulu-Med, Lingshu и Gemini-3-Flash, ошибочно формируют «нормальные» отчеты, вероятно, из-за чрезмерной опоры на глобальные признаки. В отличие от них, ClinFusion точно идентифицирует обе патологии, корректно описывая «сердечный силуэт» как «умеренно увеличенный» и отмечая «незначительную выраженность легочной сосудистой сети» — это мелкозернистое восприятие стало возможным благодаря архитектуре композиционного vision encoder..
2.2.2 Оценка на 3D мультимодальных медицинских бенчмарках
Высокие возможности 3D мультимодальных VQA среди медицинских MLLM и проприетарных моделей. ClinFusion достигает лучших или близких к лучшим результатов в нативном 3D медицинском понимании в рамках бенчмарков объемных VQA, как показано на fig. 4a (подробные баллы в Supplementary Table 4). Такая производительность обусловлена нашей архитектурой, ориентированной на зрение, включающей специализированный 3D энкодер и механизм CaSL Fusion с привязкой к 2D для объемного рассуждения..
Наша модель ClinFusion-8B, несмотря на скромный размер, значительно превосходит гораздо более крупные модели. На AMOS-MCQ она достигает 80.2, превосходя предыдущую лучшую модель 7B, Hulu-Med-7B (65.7), на 14.5 пунктов и даже превышая показатели Hulu-Med-32B (73.9). При сравнении с проприетарными API, ClinFusion-8B превосходит Gemini-3-Flash на 16 пунктов на AMOS-MCQ. Наша модель ClinFusion-32B еще больше увеличивает это преимущество, достигая 81.7 на AMOS-MCQ и 89.0 на CT-Rate MCQ, оставаясь при этом конкурентоспособной по сравнению с Hulu-Med-32B на 3D-RAD.
Высокие возможности генерации 3D-отчетов среди медицинских MLLM и проприетарных моделей. fig. 4b сообщает показатели Precision, Recall и F1 при генерации 3D-отчетов в рамках протокола RoI-Grounded (подробные оценки в Supplementary Table 4). В наборе данных CT-Rate Report модель ClinFusion-32B достигает наилучшего показателя F1 (23.9) среди всех оцененных моделей, превосходя сильнейший медицинский бейзлайн Hulu-Med-32B (23.4) и все проприетарные API (Gemini-3-Flash 20.2; GPT-5.2 14.1). В наборе данных AMOS Report модель ClinFusion-32B получает лучший показатель F1 (16.1) среди медицинских MLLM с открытым исходным кодом, в то время как Gemini-3-Flash (23.4) лидирует в общем зачете, что указывает на потенциал для улучшения в области составления отчетов по КТ, который мы оставляем для будущих исследований. В меньшем масштабе ClinFusion-8B (F1: 12.0 / 21.6) стабильно превосходит свой медицинский аналог 7B Hulu-Med-7B (10.7 / 18.3) на обоих наборах данных..
Помимо количественных метрик, качественный анализ нативного КТ-случая в Extended Data Fig. 1b дополнительно иллюстрирует, как ClinFusion превосходит аналоги как в диагностической точности, так и в соблюдении клинического рабочего процесса. Что касается диагностической точности, в то время как проприетарная Gemini-3-Flash генерирует общий отчет, ошибочно утверждая, что печень «нормального размера и плотности», и упуская ключевой диагноз — типичная ошибка универсальных MLLM при работе с тонкими, диффузными изменениями плотности в объемных данных, — ClinFusion корректно определяет сниженную плотность печени и приходит к окончательному заключению «Impression: Mild fatty liver». Что касается соблюдения клинического рабочего процесса, отчет ClinFusion тщательно структурирован в соответствии с запрошенными «Areas of Focus», систематически оценивая каждую систему органов. Он также предоставляет специфические значимые отрицательные результаты, такие как «Внутрипеченочные и внепеченочные желчные протоки не расширены» и «В желчном пузыре аномалий не наблюдается», вместо общего утверждения из отчета ground-truth (GT) о том, что «органы верхнего отдела брюшной полости в норме». Такое сочетание точного выявления патологии и систематического подтверждения нормы позволяет создавать отчеты, которые являются точными, структурированными и клинически согласованными..
2.2.3 Оценка на MedIF-Bench
Высокое следование инструкциям сохраняется благодаря медицинской адаптации. Чтобы устранить критический разрыв между результатами на бенчмарках и практической полезностью, мы оценили модели на нашем недавно предложенном MedIF-Bench, который разработан для проверки сложных клинических инструкций. Как показано на fig. 4c (подробные баллы в Supplementary Table 5), ClinFusion достигает показателей Overall-IF 98.1 (8B) и 98.9 (32B), что является лучшими результатами среди медицинских MLLM и превосходит все проприетарные системы, включая GPT-5.2 (96.0), Gemini-3-Flash (96.6) и Claude-Sonnet-4.5 (86.5). Что еще более важно, в то время как MLLM общего назначения, такие как Qwen2.5-VL и Qwen3-VL, демонстрируют сильное следование инструкциям, существующие медицинские адаптации этих бэкендов (например, Lingshu-7B: 80.4; Lingshu-32B: 82.6) страдают от существенной деградации. ClinFusion — это медицински адаптированная модель, которая сохраняет способность следования инструкциям на уровне бэкенда, с неизменно высокими баллами по разнообразным задачам (подробные баллы в Supplementary Table 5), включая такие сложные, как «Seer» (прогноз на основе специфических состояний) и генерация структурированных отчетов, с которыми не справляется большинство других медицинских моделей..
Способность следовать инструкциям является обязательным условием для надежной оценки. MedIF-Bench также служит прокси-показателем «оцениваемости» модели: неспособность модели придерживаться форматов инструкций приводит к неточным оценкам ее фактических знаний. Случай MedGemma-1.5-4B-IT иллюстрирует это — модель достигает Overall-IF всего 27.4, и ручная проверка подтверждает, что она систематически не может предоставлять ответы в предписанных форматах, что делает оценку на основе правил и LLM-as-a-judge ненадежной. Этот недостаток напрямую проявляется в искусственно заниженных баллах на других бенчмарках (например, PMC-VQA: 18.7, Supplementary Table 1; SuperGPQA: 2.25, Supplementary Table 3), что доказывает: следование инструкциям является обязательным условием для оценки скрытых знаний любой MLLM. Примечательно, что MedGemma-1.5-4B-IT обучена на разнообразных медицинских данных, но лишена способности IF, что говорит о том, что одной лишь курации данных недостаточно, если методология обучения явно не прививает устойчивое следование инструкциям..
2.2.4 Оценка на текстовых медицинских бенчмарках
Архитектура, ориентированная на визуальные данные, не должна жертвовать текстовой компетенцией. Несмотря на то, что ClinFusion является архитектурой, ориентированной на визуальные данные, ее текстовые способности соответствуют или превосходят лучшие медицинские MLLM при унифицированной оценке, как показано на Extended Data Fig. 2 (подробные баллы в Supplementary Table 3). Наша модель ClinFusion-32B достигает лучших результатов среди всех медицинских MLLM по семи из восьми бенчмарков, с явным преимуществом над Hulu-Med-32B в MedXpertQA (26.7 против 19.8), Medbullets (74.8 против 67.5) и MedQA-MCMLE (93.8 против 87.0). В меньшем масштабе ClinFusion-8B конкурирует с Hulu-Med-7B, достигая лучших результатов в PubMedQA (77.6), MedQA-MCMLE (89.1) и MMLU-Med (81.3), при этом отставая в MedMCQA и MedQA-USMLE. При сравнении с MLLM общего назначения ClinFusion стабильно превосходит свои соответствующие базовые модели, демонстрируя, что медицинская адаптация улучшает, а не компрометирует текстовые знания. Мы отмечаем сохраняющийся разрыв с наиболее сильными проприетарными моделями, особенно в бенчмарках на сложные рассуждения, таких как MedXpertQA и SuperGPQA, хотя этот разрыв существенно сокращается при масштабировании с 8B до 32B (например, MedXpertQA: 20.0 → 26.7; SuperGPQA: 32.6 → 41.8), что предполагает, что дальнейшее масштабирование может устранить этот разрыв..
2.3 Клиническая валидация с участием экспертов-радиологов
В дополнение к автоматической оценке, представленной выше, и следуя методологическим прецедентам экспертной валидации отчетов, созданных ИИ [45], мы провели слепую экспертную оценку с участием шести сертифицированных радиологов (каждый с 6 годами клинического опыта или более). Мы случайным образом отобрали 300 случаев из наших бенчмарков генерации отчетов (100 рентгенограмм грудной клетки из [46], 100 КТ грудной клетки из 3D-RAD [47] и 100 КТ брюшной полости из AMOS-MM [48]). Затем мы собрали отчеты от четырех систем, соответствующих этим случаям: ClinFusion с агентными инструментами, ClinFusion (автономная версия), Gemini-3-Flash и Hulu-Med. Для каждого случая эксперты изучали исходное медицинское изображение наряду с четырьмя анонимизированными результатами работы моделей, после чего ранжировали все четыре отчета по трем клинически обоснованным критериям: Фактическая точность (минимальное количество галлюцинируемых находок), Полнота (минимальное количество пропущенных патологий) и Клиническая полезность (общая ценность для последующего принятия решений).).
Эксперты подтверждают клиническое преимущество ClinFusion и пользу агентного расширения. fig. 5a суммирует агрегированные баллы Борда по всем аннотаторам. ClinFusion с агентными инструментами занимает первое место по каждому измерению — Общее качество, Точность, Полнота и Операбельность — со статистически значимым отрывом от Hulu-Med () и Gemini-3-Flash (). Примечательно, что автономный ClinFusion уже превосходит как Gemini-3-Flash, так и Hulu-Med, а добавление агентных инструментов обеспечивает дальнейший последовательный прирост, подтверждая количественные показатели, представленные в Supplementary Table 2, Supplementary Table 3 и Supplementary Table 4.⟧.
Метрика генерации отчетов, основанная на RoI, достигает наивысшей корреляции с экспертной оценкой. Мы оценили, насколько точно каждая автоматическая метрика отражает клиническое качество, воспринимаемое рентгенологами, как показано в fig. 5b. Среди одиннадцати метрик, включая METEOR [31], BLEU-4 [49], ROUGE-L [30], RadGraph-F1 [50], BERTScore [33], CIDEr [32] и GREEN [36], наша предложенная метрика достигает наивысшей ранговой корреляции с экспертным консенсусом по всем трем мерам согласованности (Kendall’s , Spearman’s , Top-1 Accuracy ). На уровне отдельных случаев, как показано в fig. 5c, распределение Kendall’s для нашей метрики демонстрирует более высокое среднее значение и меньшую дисперсию, чем у всех альтернатив, что указывает на то, что ее преимущество является систематическим, а не обусловленным выбросами..
Согласованность между аннотаторами подтверждает надежность оценки. Для проверки научной строгости исследования аннотирования мы оценили согласованность между аннотаторами с использованием коэффициента конкордации Кендалла (). Как показано на fig. 5d, общая по всем измерениям составляет (), что указывает на существенное согласие среди радиологов. Как показано на fig. 5e, согласие является последовательным по модальностям (CT: ; X-ray: ) и по отдельным измерениям, при этом точность достигает . Эти значения подтверждают, что экспертные ранжирования воспроизводимы, а наблюдаемые различия между моделями отражают реальные качественные разрывы, а не шум аннотаторов..
2.4 Анализ архитектуры
В этом разделе проводится валидация двух наших ключевых проектных решений: методологии оценки на основе RoI и композиционной архитектуры, ориентированной на визуальные данные..
2.4.1 Анализ генерации отчетов на основе областей интереса ⟦K0⟧
Чтобы подтвердить обоснованность проектных решений, лежащих в основе нашей оценки генерации отчетов на основе RoI, которая достигает наивысшей корреляции с экспертной оценкой среди одиннадцати метрик (fig. 5b), мы представляем подробный анализ, сравнивающий нашу методологию с RadGraph-F1 [50], широко используемой клинической метрикой для генерации отчетов, применяемой в недавних работах [8]. Мы выявляем два ключевых ограничения этого традиционного подхода и показываем, как наш протокол их устраняет..
Клинический контекст обеспечивает значимые сравнения при генерации отчетов. В типичной схеме предварительной оценки, такой как используемая в MedGemma [8], модели предлагается сгенерировать отчет по изображению без какого-либо клинического контекста. Чтобы продемонстрировать, почему это является проблематичным, мы проводим абляционное исследование в рамках нашего конвейера RoI-Grounded (section 4.2.3) на предмет того, предоставляется ли извлеченный клинический контекст («Клинические показания» и «Область фокуса») во время генерации. Мы сравниваем две модели (ClinFusion-8B и Lingshu-7B [6]) на основе бенчмарков по генерации отчетов..
Как показано на fig. 6a (подробные оценки в Supplementary Table 6), контекстно-свободная настройка выявляет две проблемы: 1) показатели существенно снижаются для обеих моделей, и 2) разрыв в производительности между двумя моделями сильно сокращается — в контекстно-зависимой настройке ClinFusion-8B стабильно превосходит Lingshu-7B, однако в контекстно-свободной настройке обе модели выдают почти идентичные оценки. Первопричина заключается в том, что одно медицинское изображение содержит множество анатомических структур, но отчет радиолога иногда фокусируется только на областях, относящихся к конкретному клиническому показанию. Без этого контекста модель может описывать области, отсутствующие в GT отчете, и нет способа определить, являются ли такие утверждения галлюцинациями или законными находками, которые исходный радиолог решил не документировать — однако все они штрафуются как ложноположительные результаты, что приводит к низким оценкам генерации отчетов и узким разрывам в производительности. Благодаря внедрению извлеченного клинического контекста наш протокол RoI-Grounded ограничивает модель анатомическими областями, охваченными GT, гарантируя, что каждое утверждение может быть классифицировано как истинно положительное, ложноотрицательное или ложноположительное..
Типичный случай показан на Extended Data Fig. 3: При наличии клинического контекста (слева) результат работы ClinFusion остается в рамках анатомического охвата GT (плевральный выпот, перикардиальный выпот, уплотнения в легких, соответствующие пневмонии при Covid-19, и изменения в печени), поэтому каждое утверждение поддается проверке. Без контекста (в центре) та же самая модель выдает дополнительные находки в областях, которые GT вообще не затрагивает — например, смещение средостения, кардиомегалия, спленомегалия, анасарка, костные поражения и диагноз декомпенсированной застойной сердечной недостаточности, — которые невозможно отличить от галлюцинаций, и они единообразно штрафуются как ложноположительные результаты, что снижает итоговый балл..
Оценка LLM-as-a-Judge позволяет преодолеть нечувствительность к синонимам и предвзятость по длине. В качестве альтернативы метрикам текстового сопоставления, таким как RadGraph-F1 [34, 8], наш протокол RoI-Grounded использует LLM-as-a-Judge для оценки отчетов. RadGraph-F1 сначала анализирует как предсказанные, так и GT отчеты с помощью RadGraph-XL [50] — transformers, обученного извлекать клинические сущности (например, анатомические структуры, наблюдения) и их отношения (например, «наводит на мысль о», «расположен в») из радиологического текста, а затем вычисляет F1-score по сопоставленным наборам сущностей и отношений. Важно отметить, что RadGraph-XL работает в закрытом формате: он отображает входной текст в фиксированную, заранее определенную схему, в отличие от оценщиков на базе LLM, которые принимают и создают естественный язык в открытой форме; кроме того, будучи относительно небольшим экстрактором, он обладает ограниченной точностью при работе с out-of-distribution клиническими формулировками. Эта жесткость обеспечивает конвейер без использования LLM, который является вычислительно дешевым, но приводит к двум режимам сбоев. 1) Нечувствительность к синонимам: Семантически эквивалентные, но иначе сформулированные находки не получают оценки — например, «печень выглядит увеличенной» не совпадает с «присутствует гепатомегалия», получая нулевой балл, несмотря на клиническую идентичность, так как они отображаются в разные записи схемы без совпадения токенов. 2) Предвзятость по длине: Поскольку RadGraph-XL извлекает сущности из всего входного текста, более длинные выводы имеют большую статистическую вероятность совпадения с GT сущностями, поэтому даже чисто многословный язык, в котором случайно упоминаются анатомические термины, может завысить оценку, не отражая клиническую точность..
⟦fig. 6b (подробные оценки в Supplementary Table 7) предоставляет количественные доказательства обоих типов сбоев. Во-первых, показатели RadGraph-F1 группируются в узком диапазоне для первых трех моделей (11,8–21,0 в CheXpert-Plus; 16,3–36,6 в IU-XRAY), что затрудняет определение качества моделей, в то время как наш LLM-as-a-Judge охватывает более широкий и дифференцированный диапазон (16,8–37,8 в CheXpert-Plus; 36,7–57,3 в IU-XRAY). Во-вторых, вариант Long Output существенно завышает RadGraph-F1 (11,818,8 в CheXpert-Plus; 16,333,0 в IU-XRAY), несмотря на создание менее качественных результатов, в то время как наш LLM-as-a-Judge корректно штрафует за многословность (16,815,1 в CheXpert-Plus; 36,733,6 в IU-XRAY).
2.4.2 Абляционные исследования архитектурного дизайна
Все исследования абляции архитектурных решений (например, вклад различных энкодеров или стратегий слияния) проводятся на 2D и 3D мультимодальных медицинских бенчмарках, поскольку эти задачи наиболее чувствительны к изменениям в визуальном восприятии. Для обеспечения быстрой итерации мы проводим обучение на подмножестве полных обучающих данных и, учитывая высокую вычислительную стоимость 3D-оценки, также используем выборку из 3D-данных для оценки. Мы гарантируем, что каждое сравнение в рамках одной таблицы или рисунка выполняется при идентичных настройках..
Локальное перекрестное внимание является лучшим механизмом слияния по сравнению с другими альтернативами. Мы сравниваем предложенный нами оператор CaSL Fusion с тремя альтернативами: 1) поканальная конкатенация, которая объединяет карты признаков вдоль размерности каналов; 2) глобальное перекрестное внимание, где каждый токен запроса соотносится со всей картой признаков ключа/значения, в отличие от нашего локализованного подхода; и 3) подход смеси экспертов зрения, который вычисляет покомпонентную взвешенную комбинацию признаков с помощью обученного механизма стробирования [51]. Модель сконфигурирована с использованием Qwen ViT в качестве базового энкодера и DINOv2 в качестве дополнительного энкодера зрения. Для обеспечения эффективной валидации модель обучается на первых трех этапах обучения на подмножестве полного корпуса. Как показано на fig. 6c (подробные оценки в Supplementary Table 8), все оцененные стратегии слияния превосходят базовую модель с одним энкодером (только Qwen ViT), что подтверждает нашу гипотезу о том, что хорошо согласованный базовый энкодер может быть улучшен за счет дополнительных признаков от специализированной модели. Среди четырех механизмов локальное перекрестное внимание достигает наивысшей средней производительности, и мы принимаем его в качестве стандартного во всех последующих абляционных исследованиях.
DINOv2 лучше всего дополняет Qwen ViT. Далее мы определяем наиболее эффективный отдельный специализированный энкодер для дополнения базового Qwen ViT, сравнивая DINOv2, ConvNext и Medsiglip. Как показано на fig. 6d (подробные баллы в Supplementary Table 9), ни один отдельный энкодер не доминирует в обеих задачах: Medsiglip лидирует в 2D VQA (64.8 против 64.5 / 64.1), в то время как ConvNext незначительно лидирует в генерации отчетов (27.9 против 27.8 / 26.6). Однако DINOv2 — это единственный энкодер, который входит в лучших в обеих задачах, в то время как ConvNext показывает более низкие результаты в VQA, а Medsiglip отстает в генерации отчетов. Мы предполагаем, что самообучающееся предварительное обучение DINOv2 дает более универсальные визуальные признаки, которые хорошо переносятся на оба типа задач, вместо специализации на какой-то одной. Поэтому мы принимаем DINOv2 в качестве специализированного энкодера во всех последующих экспериментах с несколькими энкодерами..
Дополнительные визуальные энкодеры дополняют Qwen ViT, при этом эффективность снижается при добавлении более одного дополнительного энкодера. Основываясь на нашем выводе о том, что DINOv2 является наиболее эффективным отдельным специализированным энкодером в дополнение к Qwen ViT, мы далее исследуем оптимальные комбинации двух дополнительных энкодеров, оценивая ансамбли DINOv2 в паре с ConvNeXt или Medsiglip при различных порядках каскадирования. Как показано на fig. 6e (подробные баллы в Supplementary Table 10), каскад DINOv2Medsiglip достигает наивысшего среднего балла VQA (65.2), в то время как каскад DINOv2ConvNeXt достигает наивысшего среднего балла по генерации отчетов (28.8). По сравнению с лучшей конфигурацией с одним энкодером (fig. 6d), второй специализированный энкодер добавляет максимум к VQA и к генерации отчетов, что указывает на снижение эффективности при добавлении более одного дополнительного специализированного энкодера. Поскольку генерация отчетов предъявляет более высокие требования к визуальному восприятию — требуя как глобального понимания, так и локализованных находок, — мы принимаем комбинацию Qwen ViT + DINOv2 + ConvNeXt в качестве специализированного ансамбля в нашей финальной архитектуре ClinFusion..
Каскадная интеграция превосходит параллельную интеграцию при генерации отчетов. Мы дополнительно сравниваем два способа объединения одной и той же пары энкодеров DINOv2 + ConvNeXt: нашу каскадную интеграцию (DINOv2ConvNeXt) и параллельную интеграцию, при которой каждый специализированный энкодер независимо интегрируется в запрос Qwen ViT. Как показано на fig. 6e (подробные баллы в Supplementary Table 10), обе стратегии демонстрируют схожие результаты в 2D VQA (64.4 против 64.6), но каскадная интеграция значительно превосходит параллельную при генерации отчетов (28.8 против 27.3). Мы предполагаем, что каскадная архитектура позволяет постепенно обогащать представление данных через специализированные энкодеры, что приносит больше пользы для задач генерации с открытым ответом, чем для задач VQA с закрытым ответом. Поэтому мы используем каскадную интеграцию в качестве стандартной в нашей итоговой архитектуре..
Нативный 3D-энкодер необходим для понимания 3D-объемов. Мы количественно оцениваем вклад нашего специализированного модуля 3D-восприятия путем деактивации 3D-энкодера во время инференса, заставляя модель полагаться исключительно на разреженно отобранные 2D-срезы. Как показано на fig. 6f (подробные баллы в Supplementary Table 11), удаление 3D-энкодера стабильно снижает производительность во всех оцениваемых задачах: средний балл 3D VQA падает на 3,0 пункта (65,8 62,8), а средний показатель F1 для генерации 3D-отчетов падает на 4,0 пункта (15,7 11,7), при этом наибольшее снижение по отдельным задачам наблюдается в CT-Rate Open VQA (63,6 56,4) и CT-Rate Report F1 (20,3 15,5). Эти результаты указывают на то, что объемные признаки, извлеченные нативным 3D-энкодером, не могут быть заменены только разреженными 2D-срезами, что подтверждает необходимость включения специализированного модуля 3D-восприятия в ClinFusion.
2.5 Практическое расширение с использованием агентных инструментов
Мы расширяем ClinFusion агентной структурой использования инструментов, которая объединяет инструмент RAG и экспертные инструменты восприятия в рамках рабочего процесса планирования и действий. Мы оцениваем это расширение на медицинских бенчмарках, основанных только на тексте, а также на 2D/3D мультимодальных бенчмарках в масштабах 8B и 32B, и иллюстрируем рабочий процесс на репрезентативных текстовых и мультимодальных примерах..
Агентные инструменты улучшают мультимодальные оценки 2D и 3D, при этом наибольший прирост наблюдается в описательных задачах. На мультимодальных бенчмарках (fig. 7, левый столбец; подробные баллы в Supplementary Table 2 и Supplementary Table 4) агентные инструменты улучшают ClinFusion как в задачах генерации 2D отчетов, так и в 3D VQA / задачах по отчетам в обоих масштабах. Для ClinFusion-8B наибольший прирост наблюдается в задачах, требующих описательного вывода, включая CheXpert-Plus 2D report (+12.4), 3D-RAD Open VQA (+8.4), AMOS Report (+4.6) и CT-Rate Report (+3.7), в то время как прирост в задачах 3D MCQ закрытого типа меньше (AMOS MCQ +5.5, 3D-RAD MCQ +2.2, CT-Rate MCQ +2.8). ClinFusion-32B следует аналогичной схеме, где наибольший прирост снова сосредоточен на задачах с описательным выводом (3D-RAD Open VQA +9.4, CheXpert-Plus +6.8, CT-Rate Report +3.7, AMOS Report +3.0), а не на задачах MCQ закрытого типа, в которых выбор осуществляется среди предопределенных вариантов..
Агентные инструменты улучшают оценки только для текстовых данных, обеспечивая существенный прирост на бенчмарках, требующих глубоких знаний. На медицинских бенчмарках, использующих только текст (fig. 7, правый столбец; подробные баллы в Supplementary Table 3), агентные инструменты стабильно улучшают ClinFusion в обоих масштабах. Для ClinFusion-8B наибольший прирост наблюдается на бенчмарках, требующих наиболее глубоких знаний, включая SuperGPQA (+12.8), MedQA-U (+11.1), MedXpertQA (+7.7) и MedMCQA (+7.3); единственным исключением является MedQA-M, где балл снижается на 4.8 пункта. Мы связываем это с ограниченным охватом китайского языка в нашем корпусе для поиска, что ограничивает полезность RAG на экзаменационном бенчмарке на китайском языке. Для ClinFusion-32B прирост следует аналогичной схеме (SuperGPQA +9.1, MedXpertQA +4.5, MedQA-U +4.2), а дефицит MedQA-M больше не проявляется (+0.7), что согласуется с более сильными многоязычными возможностями более крупной базовой модели, которая лучше использует преимущественно англоязычные извлеченные доказательства..
Агентная структура делает решения модели проверяемыми посредством доказательств, полученных с помощью инструментов. Мы иллюстрируем агентный рабочий процесс (показан на Extended Data Fig. 4c, подробно описан в section 4.4) на двух репрезентативных примерах (Extended Data Fig. 4a,b). В представленном текстовом примере (Extended Data Fig. 4a) ClinFusion декомпозирует клинический вопрос на дополнительные поисковые запросы, вызывает гибридный поисковый движок для сбора доказательств с учетом источников (например, PubMed, учебники, StatPearls), обобщает доказательства в прослеживаемое промежуточное заключение перед генерацией окончательного ответа. В представленном мультимодальном примере (Extended Data Fig. 4b) ClinFusion идентифицирует входные данные как 3D объем компьютерной томографии грудной клетки, вызывает сегментатор поражений нескольких органов, который возвращает структурированные результаты (например, количество и размер поражений), и интегрирует эти верифицированные выходные данные в отчет радиологического типа с разделами «Результаты» и «Заключение». В обоих сценариях промежуточные выходные данные инструментов остаются открытыми и доступными для аудита, что делает цепочку рассуждений проверяемой, а не основанной исключительно на неявной параметрической генерации..
3 Обсуждение
Интеграция MLLM в клиническую практику обладает значительным потенциалом, однако этот переход сдерживается фундаментальными препятствиями: сложностью обработки гетерогенных медицинских данных, разрывом между академической оценкой и реальными клиническими потребностями, а также статичностью знаний моделей. В данной работе мы представили ClinFusion, ориентированную на визуальные данные MLLM, которая обеспечивает систематическую и целостную структуру для устранения этих критических ограничений. Наша работа представляет систематическую структуру, которая решает данные ограничения и демонстрирует высокие показатели в бенчмарках, предлагая жизнеспособный путь к развертыванию MLLM в клинических условиях..
В основе достижений ClinFusion лежат два главных вклада. Архитектурно мы отошли от монолитных визуальных энкодеров, предложив композиционную и каскадную архитектуру, включающую оператор CaSL Fusion. Данная конструкция объединяет разнообразные 2D и нативные 3D данные посредством каскадного и 2D-центрированного механизма взаимодействия, создавая богатое и синергетическое визуальное представление, которое неизменно способствует выполнению тонких диагностических задач, что подтверждается нашими исследованиями абляции. Чтобы преодолеть разрыв между оценкой и практикой, мы представили новую систему оценки на основе визуального обоснования. Она включает MedIF-Bench для обеспечения надежного следования инструкциям, а также новую методологию генерации отчетов с привязкой к RoI для оценки генерации отчетов, ориентированных на клиническую точность и фактическую достоверность. Для дальнейшего улучшения практического развертывания мы разработали расширение для использования агентных инструментов, которое оснащает ClinFusion генерацией с дополненной выборкой и способностью использовать внешние специализированные модели в качестве инструментов, демонстрируя последовательные улучшения как в текстовых, так и в мультимодальных клинических сценариях..
Наши всесторонние эксперименты демонстрируют, что эти инновации обеспечивают производительность уровня state-of-the-art. ClinFusion не только превосходит ведущие open-source модели (например, Hulu-Med и Lingshu) по широкому спектру 2D, 3D и текстовых бенчмарков, но и обходит мощные проприетарные API в мультимодальных задачах. Превосходная производительность, особенно в комплексном мультимодальном понимании, подтверждает нашу архитектурную гипотезу о том, что целостное медицинское восприятие выигрывает от композиционной системы зрения, способной нативно обрабатывать гетерогенные 2D и 3D данные, вместо опоры на единый монолитный encoder. Независимо от этого, сильная корреляция между нашей оценкой RoI-Grounded и суждениями экспертов-радиологов подтверждает, что метрики, основанные на визуальном обосновании и фактической точности, лучше отражают реальные клинические потребности, чем традиционные подходы на основе сопоставления текста. Последовательные улучшения, наблюдаемые при дополнении ClinFusion агентным использованием инструментов, дополнительно свидетельствуют о том, что динамический поиск знаний и интеграция специализированных инструментов могут дополнять возможности базовой модели. Более того, убедительные результаты на MedIF-Bench подчеркивают, что сильные способности к следованию инструкциям сохраняются в процессе медицинской адаптации — это критический фактор для клинической применимости и свойство, которое часто деградирует в других медицинских MLLM..
Более широкое значение нашей работы заключается в смене парадигмы, которую она продвигает. Наши результаты показывают, что развитие медицинского ИИ требует равного внимания как к архитектуре восприятия, так и к методологии оценки — созданию модульных, верифицируемых систем при обеспечении того, чтобы оценка точно отражала клинические потребности. ClinFusion иллюстрирует одну из реализаций этой философии модульного проектирования. Его композиционная архитектура позволяет гибко интегрировать новые специализированные энкодеры по мере развития технологий визуализации. Его расширение для агентного использования инструментов демонстрирует, как непрерывное обновление знаний и делегирование задач проверяемым высокоточным инструментам могут дополнительно усилить мощную базовую модель для практического развертывания. Одновременно с этим, предложенная нами парадигма оценки обеспечивает строгий анализ, необходимый для того, чтобы гарантировать, что эти сложные системы являются не только функциональными, но также надежными и согласованными с клиническими рабочими процессами..
Несмотря на высокую эффективность, мы признаем наличие ряда ограничений, которые открывают путь для будущих исследований. Во-первых, хотя наша агентная система демонстрирует возможности использования инструментов, текущий набор инструментов ограничен. Будущая работа должна расширить эту экосистему, чтобы охватить более широкий спектр модальностей (например, ультразвуковое исследование, МРТ) и функциональных возможностей (например, симуляторы планирования лечения). Во-вторых, несмотря на конкурентоспособную производительность среди медицинских MLLM с открытым исходным кодом, сохраняется заметный разрыв между ClinFusion и мощными проприетарными моделями (например, Gemini-3-Flash) в текстовых бенчмарках, требующих глубоких знаний. Мы связываем это прежде всего с различиями в емкости и масштабах обучающих данных между нашей ClinFusion и значительно более крупными проприетарными системами, и отмечаем, что наше расширение для использования агентных инструментов частично нивелирует этот разрыв за счет поиска знаний. Наконец, хотя ClinFusion превосходит показатели в офлайн-бенчмарках, ее внедрение в клиническую практику требует тщательной оценки с участием человека для подтверждения влияния на точность диагностики, эффективность и результаты лечения пациентов, при одновременном соблюдении сложных этических и нормативных требований..
В заключение, ClinFusion закладывает основу для перцептивно мощной, строго оцениваемой и верифицируемой медицинской системы искусственного интеллекта. Мы надеемся, что эта работа послужит стимулом для дальнейших исследований по созданию более клинически ориентированных и прикладных медицинских систем искусственного интеллекта..
4 Методы
4.1 Архитектура
ClinFusion построен на базе серии Qwen-VL [2, 1], которая состоит из LLM, переработанной архитектуры Vision Transformer (ViT), которую мы называем Qwen ViT в статье, и модуля объединения визуальных и языковых данных. Ядро перцептивных возможностей проистекает из Qwen ViT, предварительно обученного на обширных данных общей предметной области для формирования глубокого понимания общих визуальных концепций. Однако для единой архитектуры, даже такой мощной, как Qwen ViT, сложно охватить весь спектр визуальной информации, присутствующей в медицинской визуализации, который варьируется от высокочастотных текстурных деталей (критически важных для патологии) до глобальной структурной семантики (для анатомии органов). Мы черпали вдохновение в недавних работах, демонстрирующих, что композиция моделей может изучать распределения более эффективно с точки зрения данных [52] и что стратегическая композиция энкодеров может значительно усилить возможности [26]. Опираясь на эту философию, ClinFusion расширяет архитектуру Qwen-VL путем внедрения композиционного ансамбля специализированных визуальных энкодеров, которые синергетически объединяют разнообразные нативные 2D и 3D представления, обеспечивая более целостное и надежное восприятие медицинских изображений, как показано на fig. 2a и fig. 2b.
4.1.1 Восприятие с помощью композиционных визуальных энкодеров
Улучшение двумерного восприятия с помощью дополнительных двумерных визуальных энкодеров. Для создания комплексной системы двумерного восприятия мы формируем композиционный ансамбль визуальных энкодеров, где каждая модель подбирается так, чтобы дополнять возможности Qwen ViT, устраняя присущие универсальному Qwen ViT ограничения. Два наших специализированных энкодера следующие: 1) Специалист по локальным признакам: мы внедряем ConvNeXt [53], современную сверточную сеть. Ее сильное индуктивное смещение в сторону пространственной локальности делает ее исключительно эффективной в захвате высокочастотных текстурных деталей и локальных паттернов, которые критически важны для интерпретации патологических слайдов или тонких радиологических находок. 2) Специалист по устойчивой семантике: мы включаем DINOv2 [54], мощную модель с самообучением. Обучаясь на визуальных данных без явного языкового контроля, она развивает устойчивые высокоуровневые семантические представления, менее подверженные смещениям наборов данных, что повышает ее способность к обобщению на различных модальностях медицинской визуализации. Этот выбор дополнительно обоснован недавними данными о том, что энкодеры с самообучением могут эффективно масштабироваться для понимания медицинских изображений даже без текстового контроля [55]. Мы дополнительно оценили MedSigLIP [8] в качестве кандидата на роль специалиста по предметным знаниям, поскольку его предварительное обучение на крупномасштабных парах медицинских изображений и текстов (по духу схожее с BiomedCLIP [56]) может напрямую внедрять клинические предметные знания. Однако наши абляционные исследования (Дополнительная таблица 10) показывают, что это не дает последовательного преимущества, и в конечном итоге мы выбираем DINOv2 из-за его более сильного общего баланса между VQA и генерацией отчетов. Мы отмечаем, что клинические предметные знания вместо этого внедряются в модель посредством прогрессивного поэтапного обучения (section 4.5).
Сжатие представлений с помощью CaSL Fusion . Для эффективного объединения признаков из ансамбля композиционных энкодеров мы разрабатываем стратегию слияния, основываясь на двух ключевых принципах: 1) Принцип 1: Информационная плотность важнее длины токенов: Мы отдаем приоритет увеличению информационной плотности визуальных токенов, подаваемых в LLM, а не увеличению количества токенов. Это обосновано результатами исследований, согласно которым стандартные визуальные представления в MLLM часто содержат значительную избыточность, и сжатие более богатой информации в последовательность фиксированной длины является более эффективным [57, 58]. 2) Принцип 2: Управляемое выравнивание с помощью базового энкодера: Мы должны использовать сильное, заранее существующее выравнивание между Qwen ViT и декодером LLM. Следовательно, представления от вновь внедряемых энкодеров должны объединяться таким образом, чтобы направлять их в это установленное пространство «зрение-язык», а не нарушать его..
Пусть набор энкодеров обозначается как , где всегда является базовым Qwen ViT. Для входного изображения каждый энкодер извлекает карту признаков . Чтобы гармонизировать признаки, которые происходят из различных пространств эмбеддингов и конвейеров предварительной обработки, мы сначала проецируем и изменяем их размер:
| (1) |
Здесь — это обучаемая матрица проекции, которая отображает признаки из энкодера в скрытую размерность модели Qwen ViT. Операция изменения размера (Resize) выравнивает каждую карту признаков в соответствии с пространственной формой Qwen ViT , где . Одним из исключений является ConvNeXt, карта признаков которого вместо этого масштабируется до большего пространственного разрешения для лучшего сохранения высокочастотных деталей; мы откладываем эту специфичную для энкодера обработку до section 4.6.
Для достижения этого слияния мы предлагаем каскадное пространственно-ориентированное локальное слияние (CaSL Fusion), обозначаемое оператором . Основная идея CaSL заключается в постепенном обогащении фундаментального представления Qwen ViT признаками от специализированных энкодеров пространственно-ориентированным и вычислительно эффективным способом. Это реализуется посредством каскадного применения механизма локального перекрестного внимания, как показано на fig. 2c.
Мы иллюстрируем этот процесс на примере слияния двух карт признаков, . Сначала мы определяем экстрактор пространственного локального поля, , который извлекает патч соседних токенов (размер окна подробно описан в section 4.6). Для -го токена признака мы рассматриваем его как запрос . Соответствующие ключи и значения и извлекаются из локальной окрестности, центрированной в том же пространственном местоположении внутри второй карты признаков .⟧:
| (2) |
где содержит набор индексов вокруг -го признака в пространственном измерении. Это локальное извлечение обеспечивает сильное пространственное индуктивное смещение и значительно снижает вычислительные затраты с квадратичных (от ) до линейных. Затем слияние выполняется посредством стандартной операции cross-attention [59]:
| (3) |
Заметим, что для ясности мы опускаем формулировку с несколькими головами и проекции для запросов, ключей, значений и выходов. Агрегированный признак затем интегрируется обратно в представление запроса с использованием остаточного соединения и сети прямого распространения (FFN), формируя полный блок слияния:
| (4) |
где обозначает процесс в eq. 3 для всех токенов.
Для ансамбля энкодеров слияние применяется каскадным образом, последовательно обогащая базовое представление:
| (5) |
Критически важно, что оператор слияния является асимметричным и левоассоциативным, где левый операнд всегда выступает в качестве запроса. Это гарантирует, что хорошо выровненное представление Qwen ViT остается центральной основой процесса слияния, который постепенно дополняется специализированными энкодерами. Слитый признак заменяет исходный и подается в LLM декодер.
CaSL Fusion со стохастической остаточной регуляризацией. Потенциальной проблемой в нашей каскадной архитектуре слияния является риск возникновения оптимизационных сокращений. Поскольку Qwen ViT () уже хорошо согласован с LLM, модель может научиться преимущественно полагаться на этот путь во время SFT, фактически игнорируя вклад менее согласованных специализированных энкодеров. Чтобы смягчить это, мы внедряем метод стохастической регуляризации во время обучения. В частности, мы модифицируем остаточное соединение в блоке слияния (eq. 10) путем стохастического отбрасывания исходного представления запроса. Правило обновления принимает вид:
| (6) |
Во время обучения это заставляет модель извлекать значимые представления из признаков специализированных энкодеров. Во время инференса эта стохастичность отключается путем установки и , что обеспечивает стабильное и полное использование всех признаков. по умолчанию установлено на 0.1.
Совместимость CaSL Fusion с DeepStack. Qwen3-VL [2] представила механизм DeepStack [60], который внедряет визуальные признаки в несколько более глубоких слоев LLM, чтобы избежать размытия визуальной информации, обеспечивая более глубокое и устойчивое согласование зрения и языка. CaSL Fusion полностью совместима с этой парадигмой глубокого слияния и разработана для ее использования. Мы обозначаем карту признаков из базовой Qwen ViT () на -м слое DeepStack как , где . На каждом слое специфичный для слоя признак Qwen ViT, , служит запросом для нового каскадного слияния. Затем признаки специалистов последовательно объединяются с этим запросом. Этот процесс дает набор из обогащенных признаков DeepStack . Вычисление может быть сформулировано как:
| (7) |
⟦ затем заменяет исходный признак DeepStack и внедряется в LLM. Благодаря интеграции CaSL Fusion с DeepStack мы гарантируем, что рассуждения LLM остаются непрерывно обоснованными визуальными данными..
4.1.2 2D-привязанное нативное 3D-объемное понимание
Ограничением существующих медицинских MLLM является их неспособность нативно обрабатывать 3D-объемные данные, такие как КТ и МРТ-сканы. Некоторые методы [6, 7] рассматривают 3D-объемы как последовательность независимых 2D-срезов, что приводит к потере критически важного межсрезового пространственного контекста и анатомической непрерывности. ClinFusion решает эту проблему путем интеграции специализированного 3D-энкодера и предложения 2D-привязанного 3D CaSL Fusion для обогащения признаков 2D-якорей 3D-объемными признаками. Наша ключевая мотивация для этой стратегии заключается в двух аспектах: 1) Ускоренное выравнивание: за счет использования сильного языкового выравнивания 2D-признаков в качестве якорей, 3D-признаки могут быстро сходиться в пространство vision-language без необходимости в обширных данных для 3D-специфичного выравнивания; 2) Перенос знаний: даже при обработке 3D-данных модель извлекает выгоду из богатых предобученных знаний, заложенных в 2D-энкодеры, что обеспечивает надежную генерализацию для различных модальностей объемной визуализации..
Двухпутевая обработка с 2D-якорями. Для заданного 3D-объема мы применяем стратегию двухпутевой обработки.
Путь 1: Нативное 3D-кодирование. Мы внедряем 3D vision encoder [61] и предварительно выравниваем его с языком посредством контрастивного обучения на 3D медицинских объемах и соответствующих им радиологических отчетах, следуя парадигме, которая доказала свою эффективность как для 2D рентгенограмм [62], так и для 3D онкологической визуализации [23]. Это предварительное выравнивание наделяет encoder внутренним пониманием 3D анатомических структур, одновременно устанавливая базовую связь с языковым пространством. В частности, мы обрабатываем весь 3D объем, используя 3D encoder, и получаем 3D feature map , где обозначает используемый 3D объем.
Путь 2: кодирование 2D-якорей. Одновременно набор из репрезентативных 2D-срезов случайным образом выбирается из входного объема (мы устанавливаем , используемое идентично при обучении и выводе). Таким образом, якорные срезы обозначаются как . 2D-признаки (после проекции и изменения размера) для этих выбранных кадров могут быть обозначены как: . Используя оператор CaSL Fusion в eq. 5, мы можем получить их объединенные 2D-признаки, , для всех срезов в ⟧:
| (8) |
Этот процесс генерирует набор опорных карт признаков, каждая из которых насыщена семантикой, выровненной по 2D, и готова направлять слияние с нативным 3D-представлением.
2D-anchored depth-aware CaSL Fusion . Для эффективного объединения 3D-признаков с 2D-представлениями опорных срезов мы расширяем CaSL Fusion до depth-aware варианта. Ключевая идея заключается в том, что каждый 2D-опорный срез должен учитывать 3D-признаки не только в своей пространственной окрестности, но и вдоль глубины, тем самым захватывая объемный контекст, окружающий каждый срез..
После операции проецирования и изменения размера, упомянутой в eq. 1, мы также выполняем эту операцию для 3D признака , получая , где его пространственная форма согласуется с пространственным размером , а представляет глубину объема 3D признаков (, полученную из 32-кадрового входного сигнала с коэффициентом понижающей дискретизации 8 вдоль размерности глубины). Затем мы иллюстрируем процесс на примере слияния 2D якорных признаков с 3D признаками, . Мы определяем экстрактор пространственного локального поля с учетом глубины, , который извлекает фрагмент, охватывающий пространственную область по всей глубине . Для -го токена признака в мы рассматриваем его как запрос . Соответствующие ключи и значения и извлекаются с использованием экстрактора пространственного локального поля с учетом глубины.:
| (9) |
где содержит набор индексов вокруг -го признака в пространственном и глубинном измерении. После определения запроса, ключей и значений мы можем выполнить операцию внимания, определенную в eq. 3, и остаточные связи, определенные в eq. 10⟧:
| (10) |
Полученные признаки конкатенируются для формирования полной последовательности длиной и подаются в LLM декодер для выполнения инференса. Как и в случае с 2D CaSL Fusion , также совместим с DeepStack и стохастической остаточной регуляризацией для обеспечения надежного обучения признаков..
4.2 Система оценки, основанная на визуальных данных
Чтобы оценить, может ли медицинская мультимодальная LLM функционировать как полезный клинический инструмент, мы представляем комплексную систему оценки, которая отражает интегрированные навыки радиолога. Как подробно описано в Extended Data Table 2, эта система опирается на предыдущие фреймворки, такие как MedGemma [8], Lingshu [6], HuLu-Med [7] и HuatuoGPT [63], для оценки пяти критических аспектов: фундаментальное понимание 2D и 3D визуальных данных (оценивается с помощью задач 2D и 3D VQA), медицинские знания на основе текста (оцениваются с помощью задач QA), генерация клинических отчетов и следование медицинским инструкциям. Стоит отметить, что мы расширяем предыдущие фреймворки за счет включения оценки следования медицинским инструкциям, поскольку эта способность упускается из виду во всех существующих бенчмарках, но является критически важной для определения пригодности модели к использованию. В следующих подразделах мы описываем протокол оценки для каждой категории бенчмарка..
4.2.1 Шаблоны оценочных промптов для VQA и QA
Для задач 2D и 3D медицинского VQA, а также для задач QA только с текстовыми данными в рамках бенчмарка, мы используем набор тщательно разработанных промптов и процедур оценки. Полные шаблоны промптов представлены на Extended Data Fig. 5a.
Вопросы с множественным выбором (MCQ). Как показано на левой панели Extended Data Fig. 5a, промпт MCQ предписывает модели ответить на вопрос с множественным выбором на основе предоставленного изображения (изображений). Обратите внимание, что для задач QA только с текстом фраза «на основе предоставленного изображения (изображений)» удаляется из промпта. В промпте прямо указано, что модель должна выбрать ровно один вариант и вывести только одну заглавную букву правильного варианта, заключенную в теги <answer></answer>. Чтобы уменьшить двусмысленность, промпт включает как пример правильного формата (например, <answer>A</answer>), так и несколько примеров неправильного формата, которые привели бы к сбою автоматической оценки, таких как включение дополнительного текста, отсутствие тегов, вывод текста варианта вместо буквы или выбор нескольких букв. Мы разработали этот промпт строгим по трем причинам: 1) мы заметили, что некоторые open-source модели обладают низкой способностью следовать инструкциям, и более простые промпты часто не позволяют получить правильный формат вывода, который необходим для надежной оценки на основе правил посредством сопоставления с регулярными выражениями; 2) подавление несвязанного вывода сокращает время декодирования и, таким образом, ускоряет оценку; и 3) промпт отличается от обучающих промптов большинства моделей, поэтому он также служит проверкой обобщающей способности на ранее не встречавшихся промптах, как рекомендуется в [64]. Затем извлеченная буква напрямую сравнивается с ответом GT для выставления оценки..
Открытые вопросы VQA. Как показано на верхней правой панели Extended Data Fig. 5a, открытый запрос требует от модели проанализировать предоставленное изображение (изображения) и дать краткий, прямой ответ на вопрос. Аналогичным образом, для задач QA только с текстом фраза «на основе предоставленного изображения (изображений)» удаляется из запроса. Запрос остается минималистичным, чтобы избежать предвзятости ответа, при этом препятствуя излишней многословности. Поскольку ответы на открытые вопросы нельзя оценить путем точного сопоставления строк, мы используем подход LLM-as-a-Judge22 2 Если не указано иное, во всех оценках LLM-as-a-Judge в данной работе в качестве модели-судьи используется OpenAI gpt-4.1-2025-04-14. для выставления оценок. Запрос для судьи, показанный на нижней правой панели Extended Data Fig. 5a, предоставляет исходный вопрос, GT ответ и ответ модели языковой модели-судье. Судье дается указание определить, является ли ответ модели правильным, проверяя семантическую эквивалентность с GT — если ответ модели выражает схожий смысл или допустимую альтернативную интерпретацию стандартного ответа, он считается правильным. Судья выводит структурированный вердикт (правильно или неправильно) под тегом [JUDGEMENT], который затем анализируется для выставления оценки..
4.2.2 MedIF-Bench
Мы наблюдаем, что дообучение в медицинской предметной области часто ухудшает способность модели следовать инструкциям. В наших собственных экспериментах по обучению, а также при оценке нескольких медицинских MLLM с открытым исходным кодом, мы обнаружили, что модели MLLM общего назначения, дообученные на медицинских SFT данных, часто не соблюдают требования к формату вывода — даже когда базовые медицинские знания верны. Это является проблемой, поскольку реальные клинические приложения часто требуют вывода данных в специфических структурированных форматах (например, JSON для интеграции с EHR, отчеты со стандартизированными заголовками разделов или цепочки рассуждений с уровнями достоверности). Модель, которая ставит правильный диагноз, но игнорирует требуемый формат, имеет ограниченную практическую полезность. Чтобы отследить эту проблему, мы разработали MedIF-Bench, бенчмарк, который оценивает, могут ли медицинские MLLM следовать разнообразным, клинически значимым инструкциям по форматированию..
Создание бенчмарка. MedIF-Bench содержит в общей сложности 900 образцов, построенных на основе набора вручную отобранных инструкций по форматированию, организованных по категориям задач. Для каждого образца модель получает как медицинскую задачу, так и специфическую инструкцию по форматированию, которая определяет, как должен быть структурирован вывод. Важно отметить, что данный бенчмарк оценивает только соответствие формату, а не медицинскую точность — цель состоит в том, чтобы измерить, может ли модель создавать выходные данные, соответствующие запрошенной структуре, независимо от того, является ли медицинское содержание верным. Каждый ответ проверяется по заранее определенному шаблону регулярного выражения: ответ получает оценку 1.0 тогда и только тогда, когда он полностью соответствует требуемому формату, и 0.0 в противном случае..
Пул инструкций охватывает семь категорий задач, каждая из которых имеет собственный набор вручную отобранных инструкций и соответствующих регулярных выражений. Первая группа категорий — MCQ, MCQ с контекстом и Open — в основном построена на основе эталонных наборов данных, перечисленных в Extended Data Table 2. Для этих категорий мы подбираем промпты, которые охватывают ряд общих требований к форматированию со специальными маркерами и структурами, где модель должна представить выбранный вариант или ответ в предписанном формате. Вторая группа категорий — прогноз, генерация отчетов, SEER и лечение — сосредоточена на извлечении структурированных клинических переменных из данных визуализации или данных пациентов для конкретных клинических задач, таких как прогноз выживаемости, генерация отчетов и рекомендации по лечению. Для этих категорий некоторые образцы взяты из эталонных наборов данных в Extended Data Table 2, в то время как другие построены с использованием реальных записей пациентов из онкологического регистра SEER [65], что обосновывает оценку реалистичными онкологическими данными. Три примера из MedIF-Bench показаны на Extended Data Fig. 5b.
4.2.3 Генерация отчетов на основе RoI
Существующие конвейеры оценки для генерации медицинских отчетов страдают от двух основных недостатков. Во-первых, они обычно побуждают модель генерировать полный отчет исключительно на основе изображения, полностью лишенный какой-либо клинической справочной информации. Во-вторых, существующие метрики оценки, будь то поверхностное лексическое или семантическое сопоставление (такие как BLEU [49], ROUGE [30], BERTScore [33]), извлечение на уровне сущностей, которое опирается на маломасштабные модели с ограниченной точностью (такие как RadGraph-F1 [50]), или целостная оценка на основе LLM, которая смешивает точность и полноту (такая как GREEN [36]), не обеспечивают детализированной, основанной на фактах декомпозиции клинических данных..
Для устранения этих ограничений мы предлагаем новую парадигму оценки: генерацию отчетов на основе RoI, которая строится на двух ключевых инновациях: 1) генерация отчетов с учетом контекста и 2) оценка LLM-as-a-Judge, основанная на фактической точности. Полный рабочий процесс (Extended Data Fig. 6) состоит из трех этапов. Во-первых, мы извлекаем клинический контекст из отчета GT, состоящий из потенциальной справочной информации и областей интереса. Затем мы используем этот контекст, чтобы направить модель на создание сфокусированного медицинского отчета, основанного на RoI. Наконец, LLM-судья сравнивает утверждения в сгенерированном отчете с GT, классифицируя утверждения модели для расчета точной клинической точности, полноты и F1-показателей..
Генерация отчетов с учетом контекста. Вместо того чтобы наивно просить модель описывать все изображение с нуля, мы сначала извлекаем высокоуровневый клинический контекст для генерации отчетов, более соответствующих клинической практике. В частности, клинические показания и анатомические области интереса извлекаются из отчета GT с использованием LLM. Этот извлеченный контекст затем внедряется в промпт для тестируемой модели. На этапе извлечения применяется строгое ограничение безопасности, чтобы гарантировать, что никакие конкретные результаты или отклонения от нормы не будут раскрыты. Такой выбор архитектуры обусловлен двумя фундаментальными обоснованиями: 1) Имитация реальных рабочих процессов: В реальных условиях врачи-рентгенологи не изучают снимки «вслепую»; они последовательно просматривают справочную информацию о пациенте и клинические показания перед написанием отчета. Наш конвейер достоверно имитирует эту стандартную клиническую практику. 2) Обеспечение проверяемости: Выходные данные модели могут быть строго проверены только в том случае, если ее утверждения подпадают под область охвата эталонного отчета. Если модель оценивается без контекста и описывает область, не упомянутую в GT, невозможно объективно определить, галлюцинировала ли модель или исходный врач-рентгенолог просто опустил описание нормального состояния. Ограничивая модель конкретными областями интереса (RoIs), определенными в GT, мы гарантируем, что сгенерированные утверждения могут быть сопоставлены с эталонным отчетом, что существенно повышает проверяемость оценки..
На Extended Data Fig. 6a представлен дизайн промпта для извлечения контекста вместе с реальным примером с использованием GPT 4.1 API. Extended Data Fig. 6b иллюстрирует, как этот контекст используется в качестве условия для генерации отчета на том же реальном образце с использованием нашей MLLM.
Оценка на основе фактической точности с использованием LLM-as-a-Judge. Чтобы выйти за рамки грубого семантического сходства, мы используем расширенные возможности обработки текста современных LLM для оценки точной клинической фактичности. Вместо формирования единой обобщенной оценки, перед LLM-судьей ставится задача сравнения отчета GT с отчетом, сгенерированным моделью, для классификации диагностических утверждений по трем явным спискам отклонений: [MATCHED_ABNORMALITY] (истинно положительные результаты, ), что означает, что в GT упоминается отклонение, и модель правильно его идентифицирует; [MISSED_ABNORMALITY] (ложноотрицательные результаты, ), что означает, что в GT упоминается отклонение, но модель либо пропускает его, либо ошибочно утверждает, что область является нормальной; и [HALLUCINATED_ABNORMALITY] (ложноположительные результаты, ), что означает, что модель выдумывает отклонение, которое либо явно указано как нормальное, либо вообще не упоминается в GT.
На основе этих точных подсчетов мы вычисляем строгие клинические метрики: Precision , Recall и F1-score , которые предоставляют прозрачные, детализированные показатели диагностической точности. Extended Data Fig. 6c содержит проработанный пример этого процесса оценки, демонстрирующий, как значения TP, FN и FP извлекаются и преобразуются в Precision, Recall и F1..
В разделе Результаты (section 2.4.1) мы дополнительно подтверждаем этот дизайн оценки путем сравнения с традиционным конвейером context-free + RadGraph-F1 [50, 8], демонстрируя, что 1) генерация без контекста делает метрики ненадежными, классифицируя непроверяемые утверждения как ложноположительные, и 2) RadGraph-F1 страдает от нечувствительности к синонимии и предвзятости по длине, чего позволяет избежать наш подход LLM-as-a-Judge.
4.3 Курирование данных
Обучение клинически полезной медицинской MLLM требует данных, которые одновременно поддерживают 1) надежное мультимодальное восприятие разнородных медицинских изображений, 2) медицинское обоснование и ответы на основе доказательств и 3) реалистичные клинические рабочие процессы, особенно интерпретацию 3D-объемных КТ. С этой целью мы собираем и создаем крупномасштабный обучающий корпус, разработанный для нашей многоэтапной учебной программы (section 4.5), как показано на Extended Data Fig. 7. Общий корпус содержит 22,2 миллиона образцов: 12,6 млн медицинских мультимодальных, 4,7 млн медицинских текстовых, 3,4 млн общих мультимодальных и 1,5 млн общих текстовых (Extended Data Table 1).
Источники данных. Наши данные происходят из трех взаимодополняющих источников: 1) медицинские мультимодальные наборы данных с открытым исходным кодом, охватывающие радиологию и патологию; 2) корпуса медицинских доказательств, включающие клинические рекомендации, журнальные статьи и отчеты о клинических случаях; и 3) данные, согласованные по типу КТ–отчет, объединяющие КТ-исследования из открытых источников с высококачественными отчетами и собранные в больницах КТ-сканы с синтезированными отчетами.
Конвейеры синтеза данных. Для устранения конкретных узких мест при обучении мы разрабатываем четыре конвейера синтеза данных. Подробные процедуры и иллюстрации (Supplementary Fig. 1) для каждого конвейера представлены в Supplementary Methods.
- ⟦• Искажение инструкций (дополнительное примечание S1.1). Медицинская адаптация имеет тенденцию снижать общую способность следовать инструкциям, что, в свою очередь, ограничивает способы выражения базовых медицинских знаний в реалистичных клинических условиях (например, структурированные выходные данные, ограничения области применения, соблюдение формата). Чтобы сохранить эту способность во время SFT, мы вручную создаем 120 исходных инструкций, охватывающих различные клинические роли, сценарии и требования к форматированию, и используем расширение на основе LLM для создания 21 тысячи разнообразных шаблонов инструкций, которые применяются к существующим выборкам посредством перекомпоновки на основе схем..
- ⟦• Генерация плотных подписей (дополнительное примечание S1.2). Подписи к рисункам в статьях обеспечивают лишь разреженный контроль, а составные изображения вносят шум. Мы выполняем сегментацию подрисунков и многоэтапную фильтрацию для выделения высококачественных медицинских изображений, после чего генерируем плотные визуально обоснованные описания с использованием консенсусного конвейера на базе dual-VLM, что позволяет получить 610 тысяч образцов с плотными подписями из 100 тысяч журнальных статей и 785 тысяч клинических отчетов..
- ⟦• Интерактивная мультимодальная аннотация с цепочкой рассуждений (дополнительное примечание S1.3). Для обучения мультимодальному рассуждению на длинных горизонтах мы отбираем 100 тысяч сложных для рассуждения примеров (большая длина генерации при низкой точности) и решаем их с помощью конвейера с несколькими агентами [66], объединяющего текстовый оркестратор с мультимодальным визуальным граундером посредством итеративного взаимодействия для поиска доказательств, сохраняя 67 тысяч траекторий, выводы которых совпадают с эталонными ответами.
- ⟦• Масштабируемое описание компьютерной томографии с экспертным набором инструментов (дополнительное примечание S1.4). Для обеспечения нативного 3D-понимания в больших масштабах мы подготовили 0,2 млн открытых исследований компьютерной томографии с высококачественными отчетами [67, 16, 68, 69] и разработали конвейер аннотирования с поддержкой сегментации, основанный на моделях сегментации поражений [70] и органов [71], для генерации псевдоотчетов в качестве контроля для 1,1 млн компьютерных томограмм, собранных в больницах, что существенно расширяет объем данных, согласованных между компьютерной томографией и отчетами. Корпус компьютерной томографии поддерживает как этап ④ (быстрое выравнивание 3D-энкодера), так и этап ⑤ (целостная настройка инструкций для 2D/3D).).
4.4 Агентное использование инструментов
Помимо основных архитектурных и оценочных вкладов, мы разрабатываем расширение для использования агентных инструментов, чтобы улучшить практическое клиническое развертывание ClinFusion. Хотя MLLM превосходно справляются с языковыми рассуждениями и гибким следованием инструкциям, их надежность в условиях высокой ответственности может быть дополнительно повышена за счет решения следующих задач: 1) медицинские знания, чувствительные к фактору времени, которые невозможно полностью запомнить в параметрах, 2) строгие требования к прослеживаемости для обеспечения клинической подотчетности, и 3) узкие места восприятия в определенных задачах визуализации, где специализированные модели зрения остаются сильнее, чем универсальные MLLM.
Для решения этих задач по развертыванию мы оснащаем ClinFusion экосистемой инструментов и явным рабочим процессом планирования и действий, проиллюстрированным на Extended Data Fig. 4c. Получая мультимодальные клинические входные данные (запрос пользователя вместе с одним или несколькими медицинскими изображениями), ClinFusion сначала переходит к этапу планирования, на котором анализирует запрос, при необходимости выполняет переписывание мультизапросов для текстовых входных данных [72], определяет доказательства, необходимые для ответа на него, и создает упорядоченный план вызова инструментов. На последующем этапе использования инструментов и выполнения ClinFusion последовательно вызывает запланированные инструменты — которые делятся на две взаимодополняющие категории: инструменты знаний для поиска на основе доказательств и экспертные инструменты восприятия для высокоточного анализа медицинских изображений (описанные ниже) — и собирает их структурированные выходные данные в качестве проверяемых промежуточных доказательств. Наконец, модель синтезирует запрос, исходные визуальные входные данные и агрегированные выходные данные инструментов в единый клинический ответ, гарантируя, что окончательный ответ подкреплен прослеживаемыми доказательствами, а не только неявным параметрическим воспроизведением. Эта конструкция следует принципу композиционности возможностей: ClinFusion служит центральным механизмом рассуждения и оркестрации, в то время как инструменты предоставляют проверяемые доказательства и специализированные сигналы восприятия, которые могут быть проверены и интегрированы в окончательные выходные данные..
4.4.1 Инструменты знаний для поиска с опорой на доказательства
В клинических условиях ответы должны быть подкреплены актуальными, авторитетными доказательствами и оставаться прослеживаемыми. Чисто параметрического воспроизведения недостаточно, поскольку медицинские знания быстро развиваются, а неверифицируемые утверждения недопустимы. Поэтому мы оснащаем ClinFusion инструментом знаний RAG, построенным на гибридном поисковом движке, который сочетает векторный поиск по фрагментам текста с поиском концептов на основе графа знаний (KG). Для обработки повсеместной неоднозначности в медицинских текстах (синонимы, аббревиатуры, торговые и непатентованные названия лекарств) поисковый движок выполняет нормализацию концептов с использованием UMLS [73] перед выполнением запроса, сопоставляя медицинские сущности в запросе со стандартизированными концептами. Затем векторный канал извлекает семантически подходящие фрагменты из крупномасштабных текстовых корпусов, в то время как канал KG использует UMLS и PrimeKG [74] для расширения нормализованных концептов посредством клинически значимых связей (например, лекарство–болезнь, симптом–болезнь, противопоказание), уменьшая количество пропусков, вызванных несоответствием поверхностных форм. Извлеченные фрагменты из обоих каналов затем агрегируются путем кластеризации контента, содержащего одинаковые клинические утверждения, и ClinFusion суммирует каждый кластер с приложенными цитатами для создания компактного, обоснованного доказательствами контекста..
Мы организуем наши ресурсы доказательной базы в три взаимодополняющих блока: 1) крупномасштабные неструктурированные текстовые корпуса для широкого охвата, включая PubMed [75], Wikipedia, StatPearls [76] и медицинские учебники [77], в соответствии с MedRAG [78]; 2) медицинские графы знаний с открытым исходным кодом (UMLS и PrimeKG, описанные выше); и 3) курируемые внутренние репозитории, включающие базу знаний руководящих принципов из 18 тысяч клинических рекомендаций и экспертных консенсусов, выпущенных с 2006 года официальными органами Китая и США, а также журнальную базу знаний из 100 тысяч исследовательских статей из ведущих медицинских журналов, опубликованных с 2015 года. Подробные процедуры поиска и агрегации приведены в Supplementary Methods.
4.4.2 Инструменты восприятия для специализированного визуального анализа
MLLMs предлагают гибкое мультимодальное рассуждение, но могут быть ненадежными в задачах визуализации, критически важных для восприятия, которые требуют точности на уровне вокселей и стабильной количественной оценки (например, точные границы поражений, обнаружение малых структур и тонкие признаки на КТ). В клинических условиях эти результаты восприятия часто определяют последующие выводы — измерения, стадирование, оценку ответа на терапию и сопоставимость при динамическом наблюдении. Поэтому мы оснащаем ClinFusion экспертными инструментами восприятия и рассматриваем их как внешние органы чувств: когда вопрос зависит от детализированных визуальных доказательств, ClinFusion активно делегирует восприятие специализированным моделям, а затем рассуждает на основе их структурированных результатов. В настоящее время мы интегрируем трех экспертов, специализирующихся на КТ, и двух экспертов, специализирующихся на рентгенографии грудной клетки.:
- ⟦• Эксперт по сегментации поражений нескольких органов [70] сегментирует 29 распространенных типов поражений в восьми органах (молочная железа, толстая кишка, пищевод, желудок, почка, легкое, печень, поджелудочная железа) и создает структурированные описи поражений с указанием их количества, локализации и размеров.
- ⟦• Эксперт по оценке жировой дистрофии печени [79] определяет степень тяжести жировой дистрофии печени по данным КТ и локализует область паренхимы печени, используемую для оценки, формируя степень тяжести с указанием соответствующей области паренхимы.
- ⟦• Эксперт по сегментации лимфатических узлов брюшной полости [80] сегментирует лимфатические узлы брюшной полости и выводит их перечисление с измерениями размера, поддерживая обнаружение лимфаденопатии.
- ⟦• Эксперт по классификации результатов рентгенографии органов грудной клетки [81, 82] прогнозирует структурированные вероятности для торакальных находок на основе рентгенограмм грудной клетки, интегрируя TorchXRayVision (18 общих находок) и CheXFound (40 находок).
- ⟦• Эксперт по генерации заключений по рентгенографии органов грудной клетки [83] создает клинически согласованные описания результатов рентгенографии, используемые в качестве доказательств на уровне предложений, когда одних лишь оценок классификации недостаточно.
Каждый инструмент создает структурированные выходные данные, которые нормализуются в компактные объекты доказательств и вербализуются в утверждения на естественном языке, прежде чем быть переданными обратно в ClinFusion. Полные описания инструментов и детали маршрутизации приведены в Supplementary Methods.
4.5 Прогрессивное поэтапное обучение
Обучение сложной многокомпонентной архитектуры, такой как ClinFusion, с нуля является трудной и вычислительно затратной задачей. Для обеспечения стабильности и эффективного переноса знаний от предварительно обученных компонентов мы разработали стратегию прогрессивного обучения. Этот подход, подобный учебной программе, систематически наращивает возможности модели путем постепенного увеличения сложности задач и модальности данных, переходя от 2D-выравнивания к целостному 3D-следование инструкциям. Весь процесс обобщен в Extended Data Table 3 и подробно описан ниже.
- ⟦• Этап 1: Поверхностное выравнивание мульти-энкодеров (2D). На начальном этапе основное внимание уделяется быстрой синхронизации пространств признаков недавно внедренных специализированных 2D-энкодеров с базовой моделью Qwen ViT. Используя обширный корпус пар 2D медицинских изображений и текстов, мы обучаем исключительно проекционные слои, модули CaSL Fusion и все энкодеры. LLM и все базовые визуальные энкодеры остаются замороженными, что обеспечивает эффективное и целенаправленное выравнивание компонентов восприятия, в частности, в медицинской области..
- ⟦• Этап 2: Глубокое визуально-языковое выравнивание (2D). После гармонизации визуальных признаков этот этап направлен на установление глубокого семантического соответствия между объединенным 2D визуальным представлением и всей LLM. Мы размораживаем LLM и продолжаем обучение на тех же данных 2D выравнивания изображения и текста. Этот шаг выполняет SFT всей модели для понимания и описания насыщенной визуальной информации, полученной от нескольких энкодеров..
- ⟦• Этап 3: 2D instruction tuning. Поскольку модель теперь способна к обоснованному 2D-восприятию, мы обучаем её следовать сложным инструкциям и выполнять разнообразные медицинские задачи. Мы проводим SFT всей модели на высококачественном многозадачном наборе данных для 2D-визуальных инструкций. Этот этап наделяет модель расширенными возможностями рассуждения и выполнения задач для 2D-изображений.
- ⟦• Этап 4: Быстрое выравнивание 3D-энкодера. На этом этапе внедряется 3D-модальность. Используя нашу стратегию, основанную на 2D-привязке, мы стремимся эффективно выровнять новый 3D-энкодер с остальной частью модели и сохранить возможности выполнения задач для 2D-изображений. Используя данные для выравнивания 3D-объемов и текста, мы замораживаем LLM и все компоненты 2D-восприятия (энкодеры и модули слияния) и обучаем только 3D-энкодер и модули слияния с учетом глубины, основанные на 2D-привязке. Это изолирует обучение новых 3D-компонентов, обеспечивая быструю и стабильную сходимость..
- ⟦• Этап 5: Комплексная настройка инструкций для 2D/3D. На заключительном этапе мы раскрываем полный потенциал модели путем SFT всех компонентов на всеобъемлющем наборе данных визуальных инструкций, объединяющем 2D и 3D медицинские изображения. Этот шаг унифицирует возможности модели, позволяя ей обрабатывать сложные инструкции, требующие глубокого понимания как 2D, так и 3D медицинских данных..
Такое поэтапное обучение гарантирует, что каждая новая возможность выстраивается на стабильной основе, кульминацией чего становится надежная и мощная мультимодальная медицинская модель.
4.6 Детали реализации
Архитектурные детали. Финальная версия ClinFusion построена на базе Qwen3-VL, чей нативный ViT обрабатывает изображения с динамическим разрешением (размер патча с объединением токенов ). Мы дополняем её двумя специализированными 2D-энкодерами (DINOv2-Large и ConvNeXt-Large-d-320) и нативным 3D-энкодером (PE-3D). Каждый энкодер работает с входным разрешением своей предобученной контрольной точки, чтобы сохранить исходное качество представления; поэтому данные разрешения различаются в зависимости от энкодера: (центральная обрезка) для DINOv2-Large и для ConvNeXt-Large-d-320, в то время как PE-3D обрабатывает объемы с разрешением (глубинавысоташирина) с размером патча . MedSigLIP, оцениваемый только в качестве кандидата для абляции при , не является частью финальной конфигурации. Для 3D-входов мы выбираем опорных срезов, и итоговая глубина 3D-признаков составляет (вход из 32 кадров, уменьшенный в 8 раз по измерению глубины). Во время обучения стохастическая остаточная регуляризация использует вероятность отсева , которая отключается при инференсе путем установки . Размер окна локального cross-attention в CaSL Fusion (eq. 3) задается для каждого энкодера отдельно, а не является общим: для DINOv2 и нативного 3D-энкодера, и для ConvNeXt. Большее окно для ConvNeXt связано со специальной схемой изменения размера: карта признаков ConvNeXt напрямую апсемплится до для сохранения более тонких пространственных деталей (больший коэффициент апсемплинга не был принят из-за ограничений памяти во время обучения). Следовательно, каждый токен Qwen ViT соответствует высокочастотной подобласти карты признаков ConvNeXt, что сохраняет высокочастотные текстурные детали, для захвата которых специализируется ConvNeXt..
Детали обучения. Все этапы используют одинаковую настройку оптимизации. Мы используем оптимизатор AdamW (, , ) с коэффициентом затухания весов и отсечением градиентов по максимальной норме . Скорость обучения установлена на уровне для всех обучаемых компонентов (LLM, проекционные слои и визуальные энкодеры) в соответствии с косинусным графиком с шагами прогрева, а всё обучение выполняется в точности BF16. Обучение реализовано с помощью DeepSpeed ZeRO-3, FlashAttention-2 и градиентного чекпоинтинга с использованием длины отсечения последовательности и проводится на графических процессорах NVIDIA H20. Конфигурации для каждого этапа различаются в основном количеством графических процессоров, эффективным размером пакета и количеством эпох. Этапы 1–3 используют эффективный размер пакета на графических процессорах и обучаются в течение , и эпох соответственно. Этап 4 использует эффективный размер пакета на графических процессорах в течение эпохи. Этап 5 использует эффективный размер пакета на графических процессорах в течение эпох..
Список литературы
- ⟦Bai et al. [2025a] Шуай Бай, Кецинь Чэнь, Сюэцзин Лю, Цзялинь Ван, Вэньбинь Гэ, Сибо Сун, Кай Дан, Пэн Ван, Шицзе Ван, Цзюнь Тан и др. Технический отчет Qwen2. 5-vl. arXiv preprint arXiv:2502.13923, 2025a.
- ⟦Bai et al. [2025b] Шуай Бай, Юйсюань Цай, Жуйчжэ Чэнь, Кэцинь Чэнь, Сюнхуэй Чэнь, Зесэнь Чэн, Лянхао Дэн, Вэй Дин, Чан Гао, Чуньцзян Гэ, Вэньбинь Гэ, Чжифан Го, Цидун Хуан, Цзе Хуан, Фэй Хуан, Биньюань Хуэй, Шутун Цзян, Чжаохай Ли, Миншэн Ли, Мэй Ли, Кайсинь Ли, Цзычэн Линь, Цзюньян Линь, Сюэцзин Лю, Цзявэй Лю, Чэнлун Лю, Ян Лю, Дайихэн Лю, Шисюань Лю, Дуньцзе Лу, Жуйлинь Ло, Чэньсюй Люй, Жуй Мэнь, Линчэнь Мэн, Сюаньчэн Жэнь, Синчжан Жэнь, Сибо Сун, Юйчун Сунь, Цзюнь Тан, Цзяньхун Ту, Цзяньцян Ван, Пэн Ван, Пэнфэй Ван, Цююэ Ван, Юйсюань Ван, Тяньбао Се, Ихэн Сюй, Хайян Сюй, Цзинь Сюй, Чжибо Ян, Минкунь Ян, Цзяньсинь Ян, Ань Ян, Бовэнь Юй, Фэй Чжан, Хан Чжан, Си Чжан, Бо Чжэн, Хумень Чжун, Цзинжэнь Чжоу, Фань Чжоу, Цзин Чжоу, Юаньчжи Чжу и Кэ Чжу. Технический отчет Qwen3-vl. arXiv preprint arXiv:2511.21631, 2025b.
- ⟦Liu et al. [2023] Хаотянь Лю, Чуньюань Ли, Цинъян У и Ён Джэ Ли. Настройка визуальных инструкций. Достижения в системах нейронной обработки информации, 36:34892–34916, 2023.
- ⟦Hurst et al. [2024] Аарон Херст, Адам Лерер, Адам П. Гаучер, Адам Перельман, Адитья Рамеш, Эйдан Кларк, Эй Джей Остроу, Акила Велихинда, Алан Хейс, Алек Рэдфорд и др. Системная карта GPT-4o. arXiv preprint arXiv:2410.21276, 2024.
- ⟦Liu et al. [2024a] Хаотянь Лю, Чуньюань Ли, Юхэн Ли и Ён Джэ Ли. Улучшенные базовые модели с настройкой визуальных инструкций. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 26296–26306, 2024a.
- ⟦Xu et al. [2025] Вэйвэнь Сюй, Хоу Понг Чан, Лонг Ли, Махани Альджунид, Жуйфэн Юань, Цзяньюй Ван, Чэнхао Сяо, Гуйчжэнь Чэнь, Чаоцюнь Лю, Чжаодунхуэй Ли и др. Lingshu: Универсальная фундаментальная модель для унифицированного мультимодального медицинского понимания и рассуждения. arXiv preprint arXiv:2506.07044, 2025.
- ⟦Jiang et al. [2025] Сунтао Цзян, Юань Ван, Сибо Сун, Тяньсян Ху, Чэньи Чжоу, Бинь Пу, Янь Чжан, Чжибо Ян, Ян Фэн, Джоуи Тяньи Чжоу и др. Hulu-med: Прозрачная универсальная модель для целостного медицинского визуально-языкового понимания. Препринт arXiv:2510.08668, 2025.
- ⟦Sellergren et al. [2025] Эндрю Селлергрен, Сахар Каземзаде, Тиам Джароенсри, Атилла Кирали, Мадлен Траверс, Тимо Колбергер, Шон Сюй, Фаяз Джамиль, Сиан Хьюз, Чарльз Лау и др. Технический отчет Medgemma. arXiv preprint arXiv:2507.05201, 2025.
- ⟦Li et al. [2023a] Чуньюань Ли, Клифф Вонг, Шэн Чжан, Наото Усуяма, Хаотянь Лю, Цзяньвэй Ян, Тристан Науманн, Хойфун Пун и Цзяньфэн Гао. Llava-med: Обучение большого языково-визуального помощника для биомедицины за один день. Advances in Neural Information Processing Systems, 36:28541–28564, 2023a.
- ⟦Pan et al. [2025] Цзячжэнь Пань, Че Лю, Цзюньдэ У, Фэнлинь Лю, Цзяюань Чжу, Хунвэй Бран Ли, Чэнь Чэнь, Чэн Оуян и Дэниел Рюкерт. Medvlm-r1: Стимулирование способности к медицинскому рассуждению у vision-language models (vlms) посредством reinforcement learning. В сборнике International Conference on Medical Image Computing and Computer-Assisted Intervention, страницы 337–347. Springer, 2025.
- ⟦Lai et al. [2025] Юйсян Лай, Цзике Чжун, Мин Ли, Шитянь Чжао, Юйхэн Ли, Константинос Псунис и Сяофэн Ян. Med-r1: Reinforcement learning для обобщаемых медицинских рассуждений в vision-language models. arXiv preprint arXiv:2503.13939, 2025.
- ⟦Chen et al. [2024a] Джуньин Чен, Чи Гуй, Жуйи Оуян, Аннингчжэ Гао, Шунянь Чен, Гуймин Харди Чен, Сидун Ван, Жуйфэй Чжан, Чжэньян Цай, Кэ Цзи и др. Huatuogpt-vision, на пути к внедрению медицинских визуальных знаний в мультимодальные LLM в масштабе. arXiv preprint arXiv:2406.19280, 2024a.
- ⟦Zhang et al. [2024a] Кай Чжан, Жун Чжоу, Ишан Адхикарла, Чжилин Янь, Исинь Лю, Цзюнь Юй, Чжэнлян Лю, Сюнь Чэнь, Брайан Д. Дэвисон, Хуэй Жэнь и др. Универсальная мультимодальная модель зрения и языка для решения широкого спектра биомедицинских задач. Nature Medicine, 30(11):3129–3141, 2024a.
- ⟦Hu et al. [2024] Ютао Ху, Тяньбинь Ли, Цюаньфэн Лу, Вэньци Шао, Цзюньцзюнь Хэ, Юй Цяо и Пин Ло. Omnimedvqa: Новый крупномасштабный комплексный эталонный тест для медицинских LVLM. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), страницы 22170–22183, июнь 2024 г. URL https://openaccess.thecvf.com/content/CVPR2024/papers/Hu_OmniMedVQA_A_New_Large-Scale_Comprehensive_Evaluation_Benchmark_for_Medical_LVLM_CVPR_2024_paper.pdf.
- ⟦Liu et al. [2021] Бо Лю, Ли-Мин Чжан, Ли Сюй, Линь Ма, Янь Ян и Сяо-Мин У. Slake: семантически размеченный набор данных с расширенными знаниями для медицинских визуальных вопросов и ответов. В материалах 18-го Международного симпозиума IEEE по биомедицинской визуализации (ISBI) 2021 года, страницы 1650–1654, 2021. URL https://ieeexplore.ieee.org/document/9434010.
- ⟦Hamamci et al. [2026] Ибрагим Этем Хамамджи, Сезгин Эр, Чэньюй Ван, Фуркан Алмас, Айше Гюльнихан Шимшек, Шевваль Ниль Эсиргун, Ирем Доган, Омер Фарук Дуругол, Бенджамин Хоу, Супросанна Шит и др. Универсальные базовые модели на основе мультимодального набора данных для 3D компьютерной томографии. Nature Biomedical Engineering, страницы 1–19, 2026.
- ⟦Hendrycks et al. [2021] Дэн Хендрикс, Коллин Бернс, Стивен Басарт, Энди Зоу, Мантас Мазейка, Доун Сонг и Джейкоб Стейнхардт. Оценка масштабного многозадачного понимания языка. В материалах Международной конференции по обучению представлениям, 2021. URL https://openreview.net/forum?id=d7KBjmI3GmQ.
- ⟦Zuo et al. [2025] Юйсинь Цзо, Шан Цюй, Ифэй Ли, Чжан-Жэнь Чэнь, Сюэкай Чжу, Эрмо Хуа, Кайянь Чжан, Нин Дин и Бовэнь Чжоу. Medxpertqa: Бенчмаркинг экспертного уровня медицинских рассуждений и понимания. В сборнике: Международная конференция по машинному обучению, страницы 80961–80990. PMLR, 2025.
- ⟦Jin et al. [2019] Цяо Цзинь, Бхуван Дхингра, Чжэнпин Лю, Уильям Коэн и Синхуа Лу. Pubmedqa: Набор данных для ответов на вопросы по биомедицинским исследованиям. В материалах конференции 2019 года по эмпирическим методам в обработке естественного языка и 9-й международной объединенной конференции по обработке естественного языка (EMNLP-IJCNLP), страницы 2567–2577, 2019.
- ⟦Li et al. [2025a] Чэн-И Ли, Као-Юнг Чанг, Чэн-Фу Янг, Син-Ю Ву, Вентинг Чен, Хритик Бансал, Линг Чен, И-Пинг Янг, Ю-Чун Чен, Ши-Пин Чен и др. На пути к целостной структуре для multimodal LLM в генерации радиологических отчетов по 3D компьютерной томографии головного мозга. Nature Communications, 16(1):2258, 2025a. 10.1038/s41467-025-57426-0.
- ⟦Xin et al. [2025] Ю Синь, Горкем Джан Атес, Куанг Гонг и Вэй Шао. Med3dvlm: Эффективная мультимодальная модель зрения и языка для 3D-анализа медицинских изображений. IEEE Journal of Biomedical and Health Informatics, 2025.
- ⟦Wu et al. [2025a] Чаои Ву, Сяомань Чжан, Я Чжан, Хуэй Хуэй, Яньфэн Ван и Вейди Се. На пути к созданию универсальной фундаментальной модели для радиологии на основе использования медицинских данных 2D и 3D в масштабах сети. Nature Communications, 16(1):7866, 2025a.
- ⟦Pai et al. [2024] Сурадж Пай, Деннис Бонтемпи, Ибрагим Хаджич, Васко Пруденте, Матео Сокач, Тафадзва Л. Чаунзва, Саймон Бернатц, Ахмед Хосни, Рэймонд Х. Мак, Николай Дж. Биркбак и Хьюго Дж. В. Л. Аертс. Фундаментальная модель для биомаркеров визуализации рака. Nature Machine Intelligence, 6(3):354–367, 2024. 10.1038/s42256-024-00807-9⟧.
- ⟦Shi et al. [2025] Мин Ши, Фусяо Лю, Шихао Ван, Шицзя Ляо, Субхашри Радхакришнан, Илин Чжао, Де-Ан Хуан, Хунсюй Инь, Каран Сапра, Ясер Якуб и др. Eagle: Исследование пространства проектирования для multimodal LLM с использованием смеси энкодеров. В материалах Международной конференции по обучению представлениям, том 2025, страницы 92628–92646, 2025.
- ⟦Li et al. [2024a] Юхуэй Ли, Фанъюнь Вэй, Чао Чжан и Хунъян Чжан. Eagle-2: Более быстрое выполнение вывода языковых моделей с использованием динамических черновиков деревьев. В материалах конференции 2024 года по эмпирическим методам в обработке естественного языка, страницы 7421–7432, 2024a.
- ⟦Tong et al. [2024] Питер Тонг, Эллис Браун, Пенгхао Ву, Сангхюн Ву, Адитья Джайрам Ведагири АЙЕР, Сай Чарита Акула, Шушенг Янг, Джихан Янг, Манодж Миддепогу, Зитенг Ванг и др. Cambrian-1: Полностью открытое, ориентированное на зрение исследование мультимодальных LLM. Advances in Neural Information Processing Systems, 37:87310–87356, 2024.
- ⟦Li et al. [2025b] Яньвэй Ли, Юэчэнь Чжан, Чэнъяо Ван, Чжишэн Чжун, Исинь Чэнь, Жуйхан Чу, Шаотэн Лю и Цзяя Цзя. Mini-gemini: Раскрытие потенциала мультимодальных vision language models. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2025b.
- ⟦Karamcheti et al. [2024] Сиддхарт Карамчети, Сурадж Наир, Ашвин Балакришна, Перси Лян, Томас Коллар и Дорса Садиг. Prismatic vlms: Исследование пространства проектирования визуально-обусловленных языковых моделей. В рамках Сорок первой международной конференции по машинному обучению, 2024.
- ⟦Luo et al. [2025] Джен Луо, Ийи Чжоу, Юксин Чжан, Сяву Чжэн, Сяошуай Сунь и Жунжун Цзи. Наслаждайтесь зрелищем: адаптация смеси разрешений для мультимодальных LLM. В материалах Международной конференции по обучению представлениям, том 2025, страницы 84491–84506, 2025.
- ⟦Lin [2004] Чин-Ю Линь. Rouge: Пакет для автоматической оценки аннотаций. В сборнике Text summarization branches out, страницы 74–81, 2004.
- ⟦Banerjee and Lavie [2005] Сатанджив Банерджи и Алон Лави. Meteor: Автоматическая метрика для оценки машинного перевода с улучшенной корреляцией с экспертными оценками людей. В материалах семинара acl по внутренним и внешним мерам оценки машинного перевода и/или суммаризации, страницы 65–72, 2005.
- ⟦Vedantam et al. [2015] Рамакришна Ведантам, К. Лоуренс Зитник и Деви Парих. Cider: Оценка описания изображений на основе консенсуса. В материалах конференции IEEE по компьютерному зрению и распознаванию образов, страницы 4566–4575, 2015.
- ⟦Zhang et al. [2020] Тяньи Чжан, Варша Кишор, Феликс Ву, Килиан К. Вайнбергер и Йоав Артци. Bertscore: Оценка генерации текста с помощью bert. В материалах Международной конференции по обучению представлениям, 2020.
- ⟦Delbrouck et al. [2022] Жан-Бенуа Дельбрук, Пьер Шамбон, Кристиан Блютген, Эмили Цай, Омар Альмуса и Кертис Ланглоц. Повышение фактической точности генерации радиологических отчетов с помощью семантических вознаграждений. В сборнике материалов Ассоциации компьютерной лингвистики: EMNLP 2022, страницы 4348–4360, Абу-Даби, Объединенные Арабские Эмираты, декабрь 2022 года. Ассоциация компьютерной лингвистики. URL https://aclanthology.org/2022.findings-emnlp.319.
- ⟦Zhao et al. [2024] Вейке Чжао, Чаои У, Сяомань Чжан, Я Чжан, Яньфэн Ван и Вейди Се. Ratescore: метрика для генерации радиологических отчетов. В материалах конференции 2024 Conference on Empirical Methods in Natural Language Processing, страницы 15004–15019, 2024.
- ⟦Ostmeier et al. [2024] Софи Остмайер, Джастин Сюй, Чжихун Чен, Майя Варма, Луи Бланкмейер, Кристиан Блютген, Арне Эдвард Михальсон, Майкл Мозли, Кертис Ланглоц, Акшай С. Чаудхари и др. Green: Генеративная оценка радиологических отчетов и аннотирование ошибок. В материалах Ассоциации компьютерной лингвистики: EMNLP 2024, страницы 374–390, 2024.
- ⟦Qiu et al. [2024] Цзянин Цю, Кайл Лам, Гохао Ли, Амиш Ачарья, Тьен Инь Вонг, Ара Дарзи, У Юань и Эрик Дж. Топол. LLM-based agentic systems in medicine and healthcare. Nature Machine Intelligence, 6(12):1418–1420, 2024.
- ⟦Wang et al. [2025a] Вэньсюань Ван, Цзичжань Ма, Чжэн Ван, Чэнхань У, Цзямин Цзи, Вэньтин Чэнь, Сян Ли и Исюань Юань. Обзор LLM-агентов в медицине: насколько мы близки к Бэймаксу? Результаты Ассоциации компьютерной лингвистики: ACL 2025, страницы 10345–10359, 2025a.
- ⟦Wang et al. [2025b] Цзыюэ Ван, Цзюньдэ У, Линхань Цай, Чан Хань Лоу, Сихун Ян, Цясюань Ли и Юэмин Цзинь. Medagent-pro: На пути к мультимодальной медицинской диагностике на основе доказательств с помощью агентного рабочего процесса рассуждения. arXiv preprint arXiv:2503.18968, 2025b.
- ⟦Li et al. [2024b] Биньсюй Ли, Тянькай Янь, Юаньтин Пань, Цзе Ло, Жуйян Цзи, Цзяюань Дин, Чжэ Сюй, Шилун Лю, Хаоюй Дун, Цзыхао Линь и др. Mmedagent: Обучение использованию медицинских инструментов с помощью мультимодального агента. В сборнике трудов Ассоциации компьютерной лингвистики: EMNLP 2024, страницы 8745–8760, 2024b.
- ⟦Zhu et al. [2025] Цзинго Чжу, Вэйюнь Ван, Чжэ Чэнь, Чжаоян Лю, Шэнлун Е, Лисинь Гу, Хао Тянь, Юйчэнь Дуань, Вэйцзе Су, Цзе Шао и др. Internvl3: Исследование передовых методов обучения и тестирования для мультимодальных моделей с открытым исходным кодом. arXiv preprint arXiv:2504.10479, 2025.
- ⟦Mullappilly et al. [2025] Сахал Шаджи Муллапилли, Мохаммед Ирфан Курпат, Сара Пьери, Саид Яхья Альсейари, Шанавас Чолаккал, Халед Алдахмани, Фахад Хан, Рао Анвер, Салман Хан, Тимоти Болдуин и др. Bimedix2: Bio-medical expert LLM для различных медицинских модальностей. В сборнике материалов ассоциации по компьютерной лингвистике: EMNLP 2025, страницы 14051–14071, 2025.
- ⟦Lin et al. [2025] Тяньвэй Линь, Вэньцяо Чжан, Сыцзин Ли, Юйцянь Юань, Биньхэ Юй, Хаоюань Ли, Вангуй Хэ, Хао Цзян, Мэнцзэ Ли, Сун Сяохуэй и др. Healthgpt: Медицинская большая визуально-языковая модель для унификации понимания и генерации посредством адаптации гетерогенных знаний. В сборнике: Международная конференция по машинному обучению, страницы 37975–37995. PMLR, 2025.
- ⟦He et al. [2024] Сунань Хэ, Юйсян Не, Хунмэй Ван, Шу Ян, Ихуэй Ван, Чжиюань Цай, Чжисюань Чэнь, Инсюэ Сюй, Луян Ло, Хуэйлин Сян и др. Gsco: На пути к обобщаемому искусственному интеллекту в медицине через сотрудничество специалистов общего и узкого профиля. arXiv preprint arXiv:2404.15127, 2024.
- ⟦Tanno et al. [2025] Рютаро Танно, Дэвид Г. Т. Барретт, Эндрю Селлергрен, Сумедх Гайсас, Сумант Дататхри, Эбигейл Си, Йоханнес Велбл, Чарльз Лау, Тао Ту, Шекуфе Азизи и др. Сотрудничество между клиницистами и vision–language models при составлении радиологических отчетов. Nature Medicine, 31(2):599–608, 2025. 10.1038/s41591-024-03302-1.
- ⟦Chambon et al. [2024] Пьер Шамбон, Жан-Бенуа Дельбрук, Томас Сунак, Ши-Чен Хуан, Чжихун Чен, Майя Варма, Стивен Кью-Эйч Труонг, Чу Тхе Чуонг и Кертис П. Ланглоц. Chexpert plus: дополнение обширного набора данных рентгенограмм грудной клетки текстовыми радиологическими отчетами, демографическими данными пациентов и дополнительными форматами изображений. ArXiv, abs/2405.19538, 2024. URL https://arxiv.org/abs/2405.19538.
- ⟦Gai et al. [2025a] Сяотан Гай, Цзясян Лю, Ичэнь Ли, Цзыцзе Мэн, Цзянь У и Цзочжу Лю. 3d-rad: Комплексный набор данных 3D радиологических Med-VQA с мультитемпоральным анализом и разнообразными диагностическими задачами. arXiv preprint arXiv:2506.11147, 2025a.
- ⟦Ji et al. [2022] Юаньфэн Цзи, Хаотянь Бай, Чунцзянь Гэ, Цзе Ян, Е Чжу, Жуймао Чжан, Чжэнь Ли, Линъянь Чжан, Ванлин Ма, Сян Ван и др. Amos: крупномасштабный эталонный набор данных для сегментации множественных органов брюшной полости на медицинских изображениях. Advances in neural information processing systems, 35:36722–36732, 2022.
- ⟦Papineni et al. [2002] Кишор Папинени, Салим Рукос, Тодд Уорд и Вэй-Цзин Чжу. Bleu: метод автоматической оценки машинного перевода. В материалах 40-го ежегодного собрания Ассоциации вычислительной лингвистики, страницы 311–318, 2002.
- ⟦Delbrouck et al. [2024] Жан-Бенуа Дельбрук, Пьер Шамбон, Чжихун Чен, Майя Варма, Эндрю Джонстон, Луи Бланкмейер, Дэйв Ван Вин, Тан Буй, Стивен Труонг и Кертис Ланглоц. RadGraph-XL: Крупномасштабный набор данных, размеченный экспертами, для извлечения сущностей и отношений из радиологических отчетов. В редакции Лун-Вэй Ку, Андре Мартинса и Вивека Срикумара, Findings of the Association for Computational Linguistics ACL 2024, страницы 12902–12915, Бангкок, Таиланд и виртуальная встреча, август 2024 года. Association for Computational Linguistics. URL https://aclanthology.org/2024.findings-acl.765.
- ⟦Fedus et al. [2022] Уильям Федус, Баррет Зоф и Ноам Шазир. Switch transformers: Масштабирование до моделей с триллионом параметров при помощи простой и эффективной разреженности. Journal of Machine Learning Research, 23(120):1–39, 2022.
- ⟦Du and Kaelbling [2024] Илунь Ду и Лесли Пэк Каэблинг. Позиция: Композиционное генеративное моделирование: одной модели недостаточно. В материалах Международной конференции по машинному обучению, страницы 11721–11732. PMLR, 2024.
- ⟦Liu et al. [2022] Чжуан Лю, Ханзи Мао, Чао-Юань У, Кристоф Фейхтенхофер, Тревор Даррелл и Сайнинг Се. Сверточная нейронная сеть для 2020-х годов. Труды конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), 2022.
- ⟦Oquab et al. [2024] Максим Окуаб, Тимоте Дарсе, Тео Мутаканни, Хюи В. Во, Марк Шафранец, Васил Халидов, Пьер Фернандес, Даниэль АЗИЗА, Франсиско Масса, Алаэльдин Эль-Нуби, Мидо Ассран, Николас Баллас, Войцех Галуба, Рассел Хаус, По-Яо Хуан, Шан-Вэнь Ли, Ишан Мисра, Майкл Раббат, Васу Шарма, Габриэль Синнаев, Ху Сюй, Эрве Жегу, Жюльен Майраль, Патрик Лабату, Арман Жулен и Петр Бояновский. DINOv2: Обучение устойчивым визуальным признакам без учителя. Transactions on Machine Learning Research, 2024. ISSN 2835-8856. URL https://openreview.net/forum?id=a68SUt6zFt. Рекомендованная сертификация.
- ⟦Pérez-García et al. [2025] Фернандо Перес-Гарсия, Харшита Шарма, Сэм Бонд-Тейлор, Кенза Бузид, Валентина Сальвателли, Максимилиан Ильзе, Шрути Баннур, Дэниел К. Кастро, Антон Швайгхофер, Мэттью П. Лангрен и др. Исследование масштабируемых кодировщиков медицинских изображений вне рамок текстового обучения. Nature Machine Intelligence, 7(1):119–130, 2025.
- ⟦Zhang et al. [2025a] Шенг Чжан, Янбо Сюй, Наото Усуяма, Ханвэнь Сюй, Джасприт Багга, Роберт Тинн, Сэм Престон, Раджеш Рао, Му Вэй, Навин Валлури и др. Мультимодальная биомедицинская фундаментальная модель, обученная на пятнадцати миллионах пар изображение-текст. Nejm Ai, 2(1):AIoa2400640, 2025a.
- ⟦Yang et al. [2025a] Сенцяо Ян, Юкан Чэнь, Чжотао Тянь, Чэнъяо Ван, Цзинъяо Ли, Бэй Юй и Цзяя Цзя. Visionzip: Длиннее — значит лучше, но не обязательно в vision language models. В материалах конференции Computer Vision and Pattern Recognition, страницы 19792–19802, 2025a.
- ⟦Zhang et al. [2025b] Юань Чжан, Чунь-Кай Фань, Цзюньпэн Ма, Вэньчжао Чжэн, Тао Хуан, Куань Чэн, Денис А. Гудовский, Томоюки Окуно, Ёхэй Наката, Курт Кёйцер и др. Sparsevlm: Разрежение визуальных токенов для эффективного вывода vision-language моделей. В материалах Международной конференции по машинному обучению, страницы 74840–74857. PMLR, 2025b.
- ⟦Vaswani et al. [2017] Ашиш Васвани, Ноам Шазир, Ники Пармар, Якоб Узкорейт, Ллион Джонс, Эйдан Н. Гомес, Лукаш Кайзер и Илья Полосухин. Attention is all you need. В сборнике NeurIPS, страницы 5998–6008, 2017.
- ⟦Meng et al. [2024] Линчэнь Мэн, Цзяньвэй Ян, Жуй Тянь, Сиян Дай, Цзусюань У, Цзяньфэн Гао и Юй-Ган Цзян. Deepstack: Глубокое стекирование визуальных токенов удивительно просто и эффективно для LMM. Advances in Neural Information Processing Systems, 37:23464–23487, 2024.
- ⟦Bolya et al. [2025] Дэниел Боля, По-Яо Хуан, Пейзе Сунь, Чан Хён Чо, Андреа Мадотто, Чен Вэй, Тэнъюй Ма, Цзяле Чжи, Джатушан Раджасегаран, Хануна Рашид и др. Perception encoder: The best visual embeddings are not at the output of the network. arXiv preprint arXiv:2504.13181, 2025.
- ⟦Zhou et al. [2022] Хун-Юй Чжоу, Сяоюй Чэнь, Инхао Чжан, Жуйбан Ло, Ляньшэн Ван и Ичжоу Юй. Обобщенное обучение представлений рентгеновских снимков посредством перекрестного контроля между изображениями и радиологическими отчетами в свободном текстовом формате. Nature Machine Intelligence, 4(1):32–40, 2022. 10.1038/s42256-021-00425-9⟧.
- ⟦Zhang et al. [2023a] Хунбо Чжан, Цзюньин Чэнь, Фэн Цзян, Фэй Юй, Чжихун Чэнь, Гуймин Чэнь, Цзяньцюань Ли, Сянбо У, Чжан Чжии, Цинъин Сяо и др. Huatuogpt, на пути к обучению языковой модели быть врачом. В сборнике материалов ассоциации по компьютерной лингвистике: EMNLP 2023, страницы 10859–10885, 2023a.
- ⟦Mizrahi et al. [2024] Моран Мизрахи, Гай Каплан, Дэн Малкин, Ротем Дрор, Дафна Шахаф и Габриэль Становски. Состояние какого искусства? призыв к мультипромптной оценке LLM. Transactions of the Association for Computational Linguistics, 12:933–949, 2024.
- ⟦National Cancer Institute, Surveillance Research Program [2025] Национальный институт рака, Программа исследований эпидемиологического надзора. Программа эпидемиологического надзора, анализа данных и конечных результатов (SEER) (www.seer.cancer.gov), 2025. URL https://seer.cancer.gov/data/. База данных SEER; данные проанализированы с использованием SEER*Stat. Посетите https://seer.cancer.gov/data/.
- ⟦Jian et al. [2025] Пу Цзянь, Цзюньхун У, Вэй Сунь, Чэнь Ван, Шо Жэнь и Цзяцзюнь Чжан. Взгляни еще раз, думай медленно: Улучшение визуальной рефлексии в vision-language models. В материалах конференции 2025 года по эмпирическим методам в обработке естественного языка, страницы 9262–9281, 2025.
- ⟦Bai et al. [2024] Фань Бай, Юйсинь Ду, Тецзюнь Хуан, Макс К.-Х. Мэн и Бо Чжао. M3d: Продвижение анализа трехмерных медицинских изображений с помощью мультимодальных LLM. arXiv preprint arXiv:2404.00578, 2024.
- ⟦Blankemeier et al. [2026] Луи Бланкмейер, Ашвин Кумар, Джозеф Пол Коэн, Цзямин Лю, Лонгчао Лю, Дэйв Ван Вин, Сайед Джамал Сафдар Гардези, Хункунь Юй, Магдалини Пасхали, Чжихун Чен и др. Merlin: фундаментальная модель и набор данных компьютерной томографии на основе зрения и языка. Nature, страницы 1–11, 2026.
- ⟦Huang et al. [2023] Ши-Ченг Хуанг, Зепенг Хуо, Итан Стейнберг, Чиа-Чун Чианг, Кертис Ланглоц, Мэттью Лангрен, Серена Йенг, Нигам Шах и Джейсон Фрис. Inspect: Мультимодальный набор данных для прогнозирования исходов пациентов с тромбоэмболией легочной артерии. В сборнике Advances in Neural Information Processing Systems 36 (NeurIPS), трек Datasets and Benchmarks, страницы 17742–17772, 2023. URL https://proceedings.neurips.cc/paper_files/paper/2023/hash/39736af1b9d87a1fddad9f84a6bcf64c-Abstract-Datasets_and_Benchmarks.html.
- ⟦He et al. [2025] Юфан Хэ, Пэнфэй Го, Ючэн Тан, Андрей Мироненко, Вишвеш Нат, Цзыюэ Сюй, Дун Ян, Цань Чжао, Бенджамин Саймон, Мейсон Белью и др. Vista3d: Унифицированная фундаментальная модель сегментации для 3D медицинских изображений. В материалах конференции по компьютерному зрению и распознаванию образов, страницы 20863–20873, 2025.
- ⟦Wasserthal et al. [2023] Якоб Вассерталь, Ханнс-Кристиан Брайт, Манфред Т. Мейер, Морис Праделла, Даниэль Хинк, Александр В. Саутер, Тобиас Хейе, Даниэль Т. Болл, Джоши Сириак, Шань Ян и др. Totalsegmentator: надежная сегментация 104 анатомических структур на компьютерных томограммах. Radiology: Artificial Intelligence, 5(5):e230024, 2023.
- ⟦Li et al. [2024c] Чжицун Ли, Цзяхао Ван, Чжишу Цзян, Ханьюй Мао, Чжунся Чэнь, Цзячжэнь Ду, Юаньсин Чжан, Фучжэн Чжан, Ди Чжан и Юн Лю. Dmqr-rag: Разнообразная многозапросная переработка для RAG. arXiv preprint arXiv:2411.13154, 2024c.
- ⟦National Library of Medicine (2024) [US] Национальная медицинская библиотека (США). Источники знаний UMLS, выпуск 2024aa, 2024. http://www.nlm.nih.gov/research/umls/licensedcontent/umlsknowledgesources.html (дата обращения: 15 июля 2024 г.).
- ⟦Chandak et al. [2023] Пайал Чандак, Кесин Хуан и Маринка Зитник. Построение графа знаний для обеспечения прецизионной медицины. Scientific Data, 10(1):67, 2023. 10.1038/s41597-023-01960-3⟧.
- ⟦Sayers et al. [2024] Эрик У. Сэйерс, Эван Э. Болтон, Дж. Родни Бристер и др. Базы данных ресурсов национального центра биотехнологической информации. Nucleic Acids Research, 52(D1):D33–D43, 2024. 10.1093/nar/gkad1044.
- ⟦StatPearls Publishing [2026] Издательство StatPearls. StatPearls [Интернет]. Издательство StatPearls, Трежер-Айленд, Флорида, 2026. Доступно по адресу: https://www.ncbi.nlm.nih.gov/books/NBK430685/ (дата обращения: 27 февраля 2026 г.)).
- ⟦Jin et al. [2021] Ди Джин, Эйлин Пэн, Нассим Уфаттоле, Вэй-Хун Венг, Ханьи Фанг и Питер Золовиц. Каким заболеванием страдает этот пациент? крупномасштабный набор данных для ответов на вопросы в открытой предметной области на основе медицинских экзаменов. Applied Sciences, 11(14):6421, 2021. 10.3390/app11146421.
- ⟦Xiong et al. [2024] Г. Сюн, К. Цзинь, З. Лу и др. Бенчмаркинг retrieval-augmented generation для медицины. В сборнике Findings of the Association for Computational Linguistics: ACL 2024, страницы 6233–6251, 2024.
- ⟦Gao et al. [2026] Юань Гао, Чунли Ли, Вансин Чан, Бай Ду, Сянхуа Е, Йи Хуэй Йео, Ингда Ся, Хэн Го, Сяомин Чжан, Вэй Лю и др. Мультимодальный AI для оппортунистического скрининга, стадирования и стратификации риска прогрессирования стеатозной болезни печени. Nature Communications, 17(1):1562, 2026.
- ⟦Yu et al. [2024] Циньцзи Юй, Ижуй Ван, Ке Янь, Хаошэнь Ли, Дачжоу Го, Ли Чжан, На Шэнь, Цифэн Ван, Сяовэй Дин, Лэ Лу и др. Эффективное обнаружение лимфатических узлов на компьютерной томографии с использованием выбора запросов с устраненным смещением местоположения и контрастного представления запросов в transformers. В материалах European Conference on Computer Vision, страницы 180–198. Springer, 2024.
- ⟦Cohen et al. [2020] Джозеф Пол Коэн, Мохаммад Хашир, Руперт Брукс и Адриен Бертран. О пределах кросс-доменной генерализации в автоматизированном прогнозировании рентгеновских снимков. В Medical Imaging with Deep Learning (MIDL), том 121 из Proceedings of Machine Learning Research, страницы 136–155. PMLR, 2020. URL https://proceedings.mlr.press/v121/cohen20a.html.
- ⟦Yang et al. [2025b] Зефан Ян, Сюанан Сюй, Цзяцзинь Чжан, Гэ Ван, Маннудип К. Калра и Пинкунь Янь. Фундаментальная модель для рентгенографии грудной клетки с интеграцией глобальных и локальных представлений. IEEE Transactions on Medical Imaging, 44(12):4787–4799, 2025b. 10.1109/TMI.2025.3581907.
- ⟦Chen et al. [2024b] Чжихун Чен, Майя Варма, Жан-Бенуа Дельбрук, Магдалини Пасхали, Луи Бланкмейер, Дэйв Ван Вин, Джая Мария Хосе Валанарасу, Алаа Юссеф, Джозеф Пол Коэн, Эдуардо Понтес Рейс, Эмили Б. Цай, Эндрю Джонстон, Кэмерон Олсен, Танишк Мэтью Абрахам, Сергиос Гатидис, Акшай С. Чаудхари и Кертис Ланглоц. Chexagent: На пути к фундаментальной модели для интерпретации рентгеновских снимков грудной клетки. В материалах весеннего симпозиума AAAI 2024 по клиническим фундаментальным моделям, 2024b. URL https://arxiv.org/abs/2401.12208.
- ⟦Lin et al. [2023] Вэйсюн Линь, Цзыхэн Чжао, Сяомань Чжан, Чаои У, Я Чжан, Яньфэн Ван и Вэйди Се. Pmc-clip: Контрастивное языково-визуальное предварительное обучение с использованием биомедицинских документов. В сборнике: Международная конференция по медицинской визуализации и компьютерной поддержке вмешательств, страницы 525–536. Springer, 2023.
- ⟦Pelka et al. [2018] Обиома Пелка, Свенья Коитка, Йоханнес Рюккерт, Феликс Ненса и Кристоф М. Фридрих. Радиологические объекты в контексте (ROCO): мультимодальный набор данных изображений. В сборнике «Крупномасштабная аннотация биомедицинских данных и синтез экспертных меток» (LABELS) 2018, проведенном совместно с MICCAI 2018, том 11043 серии «Конспекты лекций по информатике», страницы 180–189. Springer, 2018. 10.1007/978-3-030-01364-6_20⟧.
- ⟦Rückert et al. [2024] Йоханнес Рюккерт, Луиза Блох, Рафаэль Брюнгель, Ахмад Идрисси-Ягир, Хеннинг Шефер, Синтия С. Шмидт, Свен Койтка, Обиома Пелка, Асма Бен Абача, Альба Г. Секо де Эррера и др. Rocov2: Radiology objects in context version 2, обновленный мультимодальный набор данных изображений. Scientific Data, 11(1):688, 2024.
- ⟦Chen et al. [2024c] Джуньин Чен, Чи Гуй, Руйи Оуян, Аннингчже Гао, Шунянь Чен, Гуймин Харди Чен, Сидун Ван, Чжэньян Цай, Ке Цзи, Сян Ван и Бенью Ван. На пути к внедрению медицинских визуальных знаний в мультимодальные LLM в масштабе. В материалах конференции 2024 года по эмпирическим методам в обработке естественного языка (EMNLP), страницы 7346–7370. Ассоциация компьютерной лингвистики, ноябрь 2024c. 10.18653/v1/2024.emnlp-main.418.
- ⟦Johnson et al. [2019] Алистер Э. У. Джонсон, Том Дж. Поллард, Сет Дж. Берковиц, Натаниэль Р. Гринбаум, Мэттью П. Лангрен, Чи-ин Дэн, Роджер Г. Марк и Стивен Хорнг. Mimic-cxr, деидентифицированная общедоступная база данных рентгенограмм грудной клетки с отчетами в свободном текстовом формате. Scientific data, 6(1):317, 2019.
- ⟦Demner-Fushman et al. [2016a] Дина Демнер-Фешман, Марк Д. Коли, Марк Б. Розенман, Соня Е. Шушан, Ларица Родригес, Самир Антани, Джордж Р. Тома и Клемент Дж. Макдональд. Подготовка коллекции радиологических исследований для распространения и поиска. Journal of the American Medical Informatics Association, 23(2):304–310, 2016a. 10.1093/jamia/ocv080⟧.
- ⟦Subramanian et al. [2020] Санджай Субраманьян, Люси Лу Ван, Бен Богин, Сачин Мехта, Мадлен Ван Зюлен, Сраванти Параса, Самир Сингх, Мэтт Гарднер и Ханнане Хаджиширзи. Medicat: Набор данных медицинских изображений, подписей и текстовых ссылок. В материалах конференции Ассоциации вычислительной лингвистики: EMNLP 2020, страницы 2112–2120, 2020.
- ⟦Siragusa et al. [2025] Ирен Сирагуса, Сальваторе Контино, Массимо Ла Чура, Розарио Аликата и Роберто Пирроне. Medpix 2.0: комплексный мультимодальный биомедицинский набор данных для передовых приложений AI с использованием RAG и графов знаний. Data Science and Engineering, страницы 1–17, 2025.
- ⟦Lozano et al. [2025] Алехандро Лосано, Мин У Сун, Джеймс Берджесс, Лянъюй Чэнь, Джеффри Дж. Ниршл, Джеффри Гу, Иван Лопес, Джосайя Аклилу, Остин Вольфганг Катцер, Коллин Чиу, Анита Рау, Сяохань Ван, Юйхуэй Чжан, Альфред Сынхун Сон, Роберт Тибширани и Серена Йенг-Леви. Biomedica: открытый архив биомедицинских изображений и подписей к ним, набор данных и vision-language models, полученные из научной литературы. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), страницы 19724–19735, 2025. 10.1109/CVPR52734.2025.01837⟧.
- ⟦Liu et al. [2024b] Хаотянь Лю, Чуньюань Ли, Юхэн Ли и Ён Джэ Ли. Улучшенные базовые модели с настройкой визуальных инструкций. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), страницы 26296–26306, июнь 2024b.
- ⟦Deitke et al. [2025] Мэтт Дейтке, Кристофер Кларк, Сангхо Ли, Рохун Трипати, Юэ Ян, Чжэ Сон Пак, Мохаммадреза Салехи, Никлас Мюннигхофф, Кайл Ло, Лука Солдаини и др. Molmo и pixmo: Открытые веса и открытые данные для современных vision-language models. В материалах конференции Computer Vision and Pattern Recognition, страницы 91–104, 2025.
- ⟦Li et al. [2023b] Чуньюань Ли, Клифф Вонг, Шэн Чжан, Наото Усуяма, Хаотянь Лю, Цзяньвэй Ян, Тристан Науманн, Хойфунг Пун и Цзяньфэн Гао. Llava-med: Обучение большого языково-визуального ассистента для биомедицины за один день. Advances in Neural Information Processing Systems, 36:28541–28564, 2023b.
- ⟦Seyfioglu et al. [2024] Мехмет Сайгин Сейфиоглу, Висдом О Икезогво, Фатеме Гезлу, Ранджай Кришна и Линда Шапиро. Quilt-llava: Визуальная настройка инструкций путем извлечения локализованных повествований из гистопатологических видео с открытым исходным кодом. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 13183–13192, 2024.
- ⟦Gautam et al. [2024] Сушант Гаутам, Андреа Сторас, Чисе Мидоглу, Стивен А. Хикс, Ваджира Тхамбавита, Пол Халворсен и Майкл А. Риглер. Kvasir-vqa: Набор данных пар текст-изображение желудочно-кишечного тракта. В материалах 2-го международного семинара по Vision-Language Models для биомедицинских приложений (VLM4Bio ’24), страницы 15–24, Нью-Йорк, штат Нью-Йорк, США, 2024 год. Ассоциация вычислительной техники. ISBN 979-8-4007-0435-2. 10.1145/3689096.3689458.
- ⟦Bae et al. [2024] Сонсу Бэ, Даун Кён, Джэхи Рю и др. MIMIC-Ext-MIMIC-CXR-VQA: комплексный, разнообразный и крупномасштабный набор данных для визуальных ответов на вопросы по рентгеновским снимкам грудной клетки, 2024. PhysioNet, https://physionet.org/content/mimic-ext-mimic-cxr-vqa/.
- ⟦He et al. [2021] Сюэхай Хэ, Чжо Цай, Вэньлань Вэй, Ичэнь Чжан, Луньтянь Моу, Эрик Син и Пэнтао Се. На пути к визуальным ответам на вопросы по патологическим изображениям. В материалах 59-го ежегодного собрания Ассоциации компьютерной лингвистики и 11-й Международной объединенной конференции по обработке естественного языка (Том 2: Краткие статьи), страницы 708–718. Ассоциация компьютерной лингвистики, 2021. 10.18653/v1/2021.acl-short.90. URL https://aclanthology.org/2021.acl-short.90/.
- ⟦Zhang et al. [2024b] Сяомань Чжан, Чаои У, Цзыхэн Чжао, Вэйсюн Линь, Я Чжан, Яньфэн Ван и Вэйди Се. Разработка крупномасштабного набора данных для медицинских визуальных вопросов и ответов. Communications Medicine, 4(1):23, 2024b. 10.1038/s43856-024-00709-2.
- ⟦Ben Abacha et al. [2019] Асма Бен Абача, Садид А. Хасан, Вивек В. Датла, Джоуи Лю, Дина Демнер-Фушман и Хеннинг Мюллер. VQA-Med: Обзор задачи медицинских визуальных ответов на вопросы на ImageCLEF 2019. В рабочих заметках CLEF 2019, материалы семинара CEUR, том 2380, 2019. URL https://ceur-ws.org/Vol-2380/paper_272.pdf.
- ⟦Lau et al. [2018] Джейсон Дж. Лау, Сумья Гайен, Асма Бен Абача и Дина Демнер-Фушман. Набор данных клинически сгенерированных визуальных вопросов и ответов о радиологических изображениях. Scientific data, 5(1):1–10, 2018. URL https://doi.org/10.1038/sdata.2018.251.
- ⟦Su et al. [2025] Яньчжоу Су, Тяньбинь Ли, Цзияо Лю, Чэнлун Ма, Цзюньчжи Нин, Чэн Тан, Сибо Цзюй, Цзинь Е, Пэнчэн Чэнь, Мин Ху и др. Gmai-vl-r1: Использование обучения с подкреплением для мультимодальных медицинских рассуждений. arXiv preprint arXiv:2504.01886, 2025.
- ⟦Chen et al. [2024d] Гуймин Харди Чен, Шунянь Чен, Жуйфэй Чжан, Цзюньин Чен, Сянбо У, Чжии Чжан, Чжихун Чен, Цзяньцюань Ли, Сян Ван и Бэнью Ван. Allava: Использование синтезированных данных gpt4v для облегченных vision-language моделей. arXiv preprint arXiv:2402.11684, 2024d.
- ⟦Ben Abacha and Demner-Fushman [2019] Асма Бен Абача и Дина Демнер-Фушман. Подход на основе логического следования для ответов на вопросы. BMC Bioinformatics, 20(1):511, 2019. 10.1186/s12859-019-3119-4⟧.
- ⟦Chen et al. [2024e] Цзюньин Чэнь, Чжэньян Цай, Кэ Цзи, Сидун Ван, Ваньлун Лю, Жуншэн Ван, Цзянье Хоу и Бэнью Ван. Huatuogpt-o1, на пути к медицинским сложным рассуждениям с помощью LLM. arXiv preprint arXiv:2412.18925, 2024e.
- ⟦Wang et al. [2024a] Сидун Ван, Нуо Чэнь, Цзюньинь Чэнь, Идун Ван, Гожуй Чжэнь, Чуньсянь Чжан, Сянбо У, Янь Ху, Аньнинчжэ Гао, Сян Вань и др. Apollo: Легковесная многоязычная медицинская LLM для демократизации медицинского ИИ для 6 миллиардов человек. arXiv preprint arXiv:2403.03640, 2024a.
- ⟦Zhang et al. [2023b] Синлу Чжан, Чэньсинь Тянь, Сяньцзюнь Ян, Личан Чэнь, Зекунь Ли и Линда Рут Петцольд. Alpacare: Instruction-tuned LLM для медицинских приложений. arXiv preprint arXiv:2310.14558, 2023b.
- ⟦Li et al. [2023c] Юньсян Ли, Цзыхань Ли, Кай Чжан, Жуйлун Дань, Стив Цзян и Ю Чжан. Chatdoctor: медицинская чат-модель, дообученная на базе большой языковой модели meta-AI (LLaMA) с использованием знаний в области медицины. Cureus, 15(6):e40895, 2023c. 10.7759/cureus.40895.
- ⟦Wu et al. [2024] Чаои Ву, Вэйсюн Линь, Сяомань Чжан, Я Чжан, Вэйди Се и Яньфэн Ван. Pmc-llama: на пути к созданию языковых моделей с открытым исходным кодом для медицины. Journal of the American Medical Informatics Association, 31(9):1833–1843, 2024.
- ⟦Chen et al. [2023] Джуньин Чен, Сидун Ван, Аннингчже Гао, Фэн Цзян, Шунянь Чен, Хунбо Чжан и др. Huatuogpt-ii, одноэтапное обучение для медицинской адаптации LLM. arXiv preprint arXiv:2311.09774, 2023.
- ⟦Wu et al. [2025b] Джунченг Ву, Венлонг Денг, Ксингксуан Ли, Шенг Лю, Таомиан Ми, Ифан Пенг, Зиянг Ксу, Йи Лю, Хьюнджин Чо, Чанг-Ин Чой и др. Medreason: Выявление фактических этапов медицинского рассуждения в LLM с помощью графов знаний. arXiv preprint arXiv:2504.00993, 2025b.
- ⟦Wei [2025] Хао Вэй. Medthoughts-8k: набор данных для медицинских рассуждений, дистиллированный из deepseek-r1. https://huggingface.co/datasets/hw-hwei/MedThoughts-8K, 2025.
- ⟦Wang et al. [2024b] Сидун Ван, Гуймин Чэнь, Сун Динцзе, Чжан Чжии, Чжихун Чэнь, Цинъин Сяо, Цзюньин Чэнь, Фэн Цзян, Цзяньцюань Ли, Сян Вань, Бэнью Ван и Хайчжоу Ли. CMB: Комплексный медицинский бенчмарк на китайском языке. В материалах конференции 2024 года Североамериканского отделения Ассоциации компьютерной лингвистики: Технологии человеческого языка (Том 1: Длинные статьи), страницы 6184–6205, Мехико, Мексика, июнь 2024b. Ассоциация компьютерной лингвистики. 10.18653/v1/2024.naacl-long.343. URL https://aclanthology.org/2024.naacl-long.343/.
- ⟦Zhang et al. [2018] Шэн Чжан, Синь Чжан, Хуэй Ван, Лисян Го и Шаньшань Лю. Многомасштабные сети внимательного взаимодействия для выбора ответов на медицинские вопросы на китайском языке. IEEE Access, 6:74061–74071, 2018. 10.1109/ACCESS.2018.2883637.
- ⟦Wang et al. [2025c] Госинь Ван, Миньюй Гао, Шуай Ян и др. Citrus: Использование экспертных когнитивных путей в медицинской языковой модели для расширенной поддержки принятия клинических решений. arXiv preprint arXiv:2502.18274, 2025c.
- ⟦Kim et al. [2025] Хюнчжэ Ким, Хён Хван, Джиу Ли, Сихён Пак, Даин Ким и др. Малые языковые модели приобретают улучшенные навыки рассуждения на основе медицинских учебников. npj Digital Medicine, 8(1):240, 2025. 10.1038/s41746-025-01653-8⟧.
- ⟦Teknium [2023] Teknium. Openhermes 2.5: Открытый набор данных синтетических данных для LLM-ассистентов общего назначения, 2023. Наборы данных Hugging Face, https://huggingface.co/datasets/teknium/OpenHermes-2.5.
- ⟦Zhang et al. [2024c] Сяомань Чжан, Чаои У, Цзыхэн Чжао, Цзяюй Лэй, Я Чжан, Яньфэн Ван и Вэйди Се. Radgenome-chest ct: Обоснованный визуально-языковой набор данных для анализа компьютерной томографии грудной клетки. arXiv preprint arXiv:2404.16754, 2024c.
- ⟦amo [2024] AMOS-MM: Набор данных для конкурса по мультимодальному анализу брюшной полости, 2024. Zenodo, https://zenodo.org/doi/10.5281/zenodo.10992154 (дата обращения: 23 февраля 2026 г.)).
- ⟦Gai et al. [2025b] Сяотан Гай, Цзясян Лю, Ичэнь Ли, Цзыцзе Мэн, Цзянь У и Цзочжу Лю. 3d-rad: Комплексный набор данных 3d-радиологии для med-vqa с мультитемпоральным анализом и разнообразными диагностическими задачами. В сборнике Advances in Neural Information Processing Systems, том 38, 2025b.
- ⟦Yu et al. [2025] Сухао Юй, Хаоцзинь Ван, Цзюньчэн У, Цихан Се и Юйин Чжоу. Medframeqa: бенчмарк для медицинских VQA с использованием нескольких изображений для клинического обоснования. arXiv preprint arXiv:2505.16964, 2025.
- ⟦Ye et al. [2024] Цзинь Е, Гоань Ван, Яньцзюнь Ли, Чжунъин Дэн, Вэй Ли, Тяньбинь Ли, Хаодун Дуань, Цзыянь Хуан, Яньчжоу Су, Бэнью Ван и др. Gmai-mmbench: Комплексный мультимодальный оценочный бенчмарк для общего медицинского AI. Advances in Neural Information Processing Systems, 37:94327–94427, 2024.
- ⟦Pal et al. [2022] Анкит Пал, Логеш Кумар Умапати и Малайканнан Санкарасуббу. Medmcqa: Крупномасштабный многопредметный набор данных с множественным выбором для ответов на вопросы в медицинской области. В сборнике: Херардо Флорес, Джордж Х. Чен, Том Поллард, Джойс С. Хо и Тристан Науманн, редакторы, Труды конференции по здравоохранению, выводам и обучению, том 174 Трудов по машинному обучению, страницы 248–260. PMLR, апр. 2022 г. URL https://proceedings.mlr.press/v174/pal22a.html.
- ⟦Chen et al. [2025] Ханджи Чен, Чжоусян Фан, Яш Сингла и Марк Дредзе. Бенчмаркинг LLM при ответе на сложные медицинские вопросы и их объяснении. В материалах конференции 2025 года отделения стран Америки Ассоциации компьютерной лингвистики: Человеческие языковые технологии (Том 1: Длинные статьи), страницы 3563–3599, Альбукерке, Нью-Мексико, апрель 2025 года. Ассоциация компьютерной лингвистики. URL https://aclanthology.org/2025.naacl-long.182/.
- ⟦Du et al. [2025] Синьжунь Ду, Ифань Яо, Кайцзин Ма, Бинли Ван, Тяньюй Чжэн, Кинг Чжу, Минхао Лю, Имин Лян, Сяолун Цзинь, Чжэньлинь Вэй, Чуцзе Чжэн, Кайсинь Дэн, Шуюэ Го, Шиань Цзя, Сычао Цзян, Иянь Ляо, Жуй Ли, Циньжуй Ли, Сыжунь Ли, Ичжи Ли, Юньвэнь Ли, Дэхуа Ма, Юаньшэн Ни, Хаожань Цюэ, Цияо Ван, Чжоуфуту Вэнь, Сывэй У, Тяньшунь Син, Мин Сюй, Чжэньчжу Ян, Зекун Мур Ван, Цзюньтин Чжоу и др. Supergpqa: Масштабирование оценки LLM по 285 дисциплинам уровня магистратуры. В сборнике Advances in Neural Information Processing Systems 38 (NeurIPS), трек Datasets and Benchmarks, 2025. URL https://openreview.net/forum?id=6WgflzYQpf.
- ⟦Demner-Fushman et al. [2016b] Дина Демнер-Фешман, Марк Д. Коли, Марк Б. Розенман, Соня Е. Шушан, Ларица Родригес, Самир Антани, Джордж Р. Тома и Клемент Дж. Макдональд. Подготовка коллекции радиологических исследований для распространения и поиска. Journal of the American Medical Informatics Association, 23(2):304–310, 2016b. URL https://doi.org/10.1093/jamia/ocv080⟧.
- ⟦Selvaraju et al. [2020] Рампрасаат Р. Сельвараджу, Майкл Когсвелл, Абхишек Дас, Рамакришна Ведантам, Деви Парик и Дхрув Батра. Grad-cam: визуальные объяснения глубоких сетей посредством локализации на основе градиентов. Международный журнал компьютерного зрения, 128(2):336–359, 2020.
Благодарности
Мы благодарим всех сертифицированных радиологов, которые приняли участие в слепом экспертном исследовании.
Вклад авторов
H.Y., Y.Q., Z.T., X.X., P.W. и W.C. разработали концепцию и дизайн исследования. J.W. (Jitao Wang), J.D., W.C., F.X., F.W., Y.Y. и J.T. осуществляли руководство проектом. H.Y., Y.Q., Z.T., X.X., Y.X., P.W. и Y.H. разработали алгоритм. H.Y., X.X., Z.T., Q.X., W.Y., P.W. и Y.X. внесли вклад в интерпретацию данных и визуализацию. H.Y., Y.Q., Z.T., X.X., J.W. (Jinwang Wang), S.Y., Z.L. и S.W. участвовали в подготовке первоначального черновика и редактировании рукописи. X.X., H.Y., Z.T., L.W., Z.Z. и S.L. провели сбор данных. H.Y., Y.Q., S.Y., J.W. (Jinwang Wang) и T.F. участвовали в анализе данных. Все авторы обсудили результаты и одобрили статью..
Конкурирующие интересы
H.Y., Y.Q., Z.T., X.X., L.W., J.W. (Jinwang Wang), P.W., Y.H., Y.X., S.L., J.T., W.C. и F.W. являются сотрудниками DAMO Academy, Alibaba Group. Остальные авторы заявляют об отсутствии конфликта интересов..
Доступность данных
Публичные наборы данных, использованные для обучения и оценки модели, перечислены в Extended Data Table 1 и Extended Data Table 2. Их ссылки для скачивания и условия доступа задокументированы в Extended Data Table 4, и все наборы данных доступны из соответствующих первоисточников. Данные из онкологического регистра SEER, использованные для создания части оценки MedIF-Bench, доступны по адресу https://seer.cancer.gov/data/. Инструмент знаний опирается на общедоступные источники медицинских знаний, включая UMLS (https://www.nlm.nih.gov/research/umls/), PrimeKG (https://github.com/mims-harvard/PrimeKG), PubMed (https://pubmed.ncbi.nlm.nih.gov/), StatPearls (https://www.statpearls.com/), Wikipedia (https://www.wikipedia.org/) и стандартные медицинские учебники. Внутренняя база знаний клинических рекомендаций и журнальных статей, наряду с собранными в больнице данными КТ, использованными в данном исследовании, не являются общедоступными из-за конфиденциальности пациентов, этических ограничений и институциональных соглашений об использовании данных. Обезличенные исследовательские данные могут быть предоставлены для академических и некоммерческих целей по обоснованному запросу к авторам-корреспондентам при условии институционального одобрения и заключения соглашения об использовании данных..
Доступность кода
Исходный код для ClinFusion, включая все скрипты оценки, реализации бенчмарков и предложенный MedIF-Bench, доступен по адресу https://github.com/alibaba-damo-academy/ClinFusion. Веса моделей для ClinFusion-8B и ClinFusion-32B доступны по адресу https://huggingface.co/collections/Alibaba-DAMO-Academy/clinfusion.
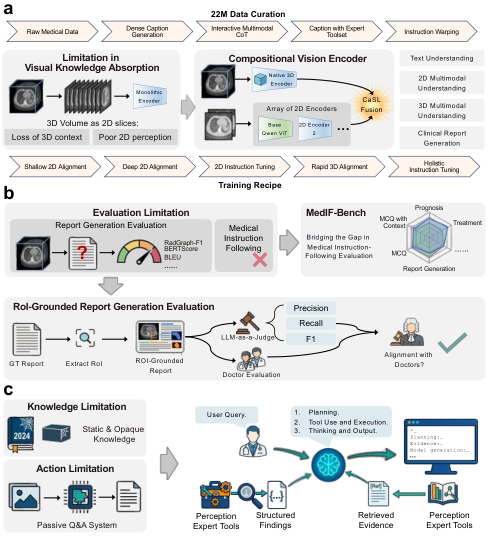
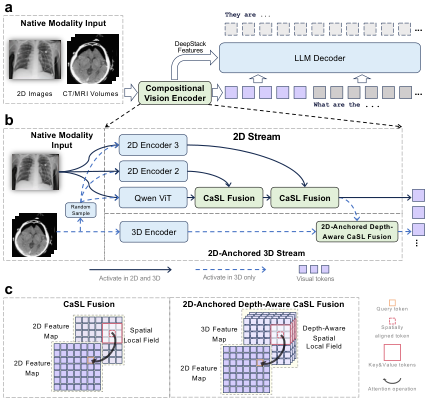
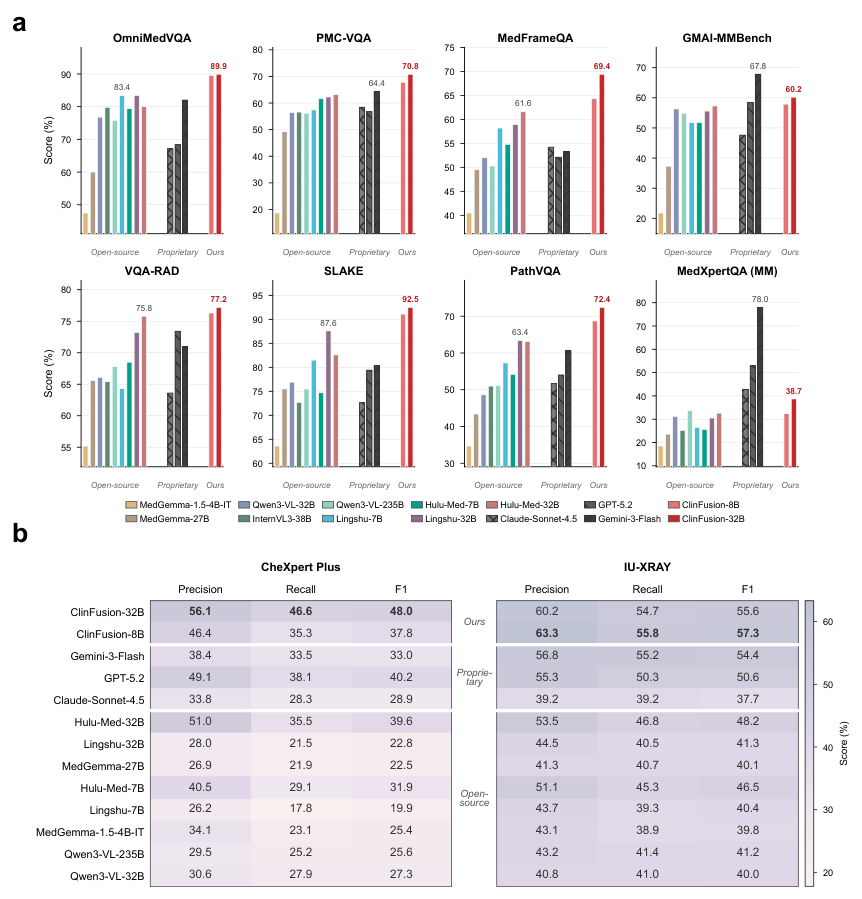
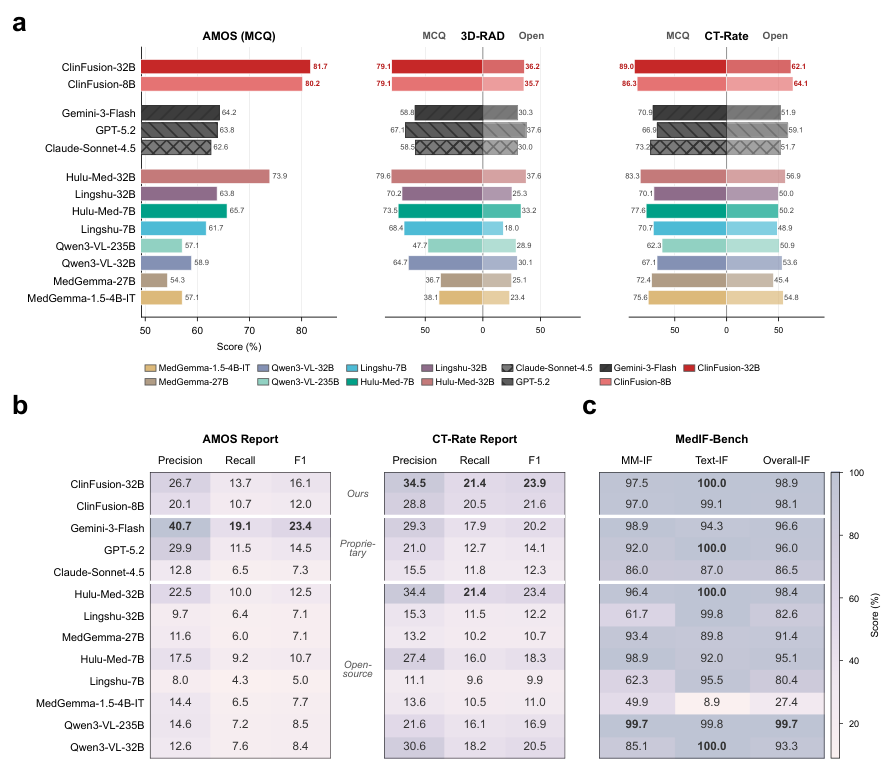
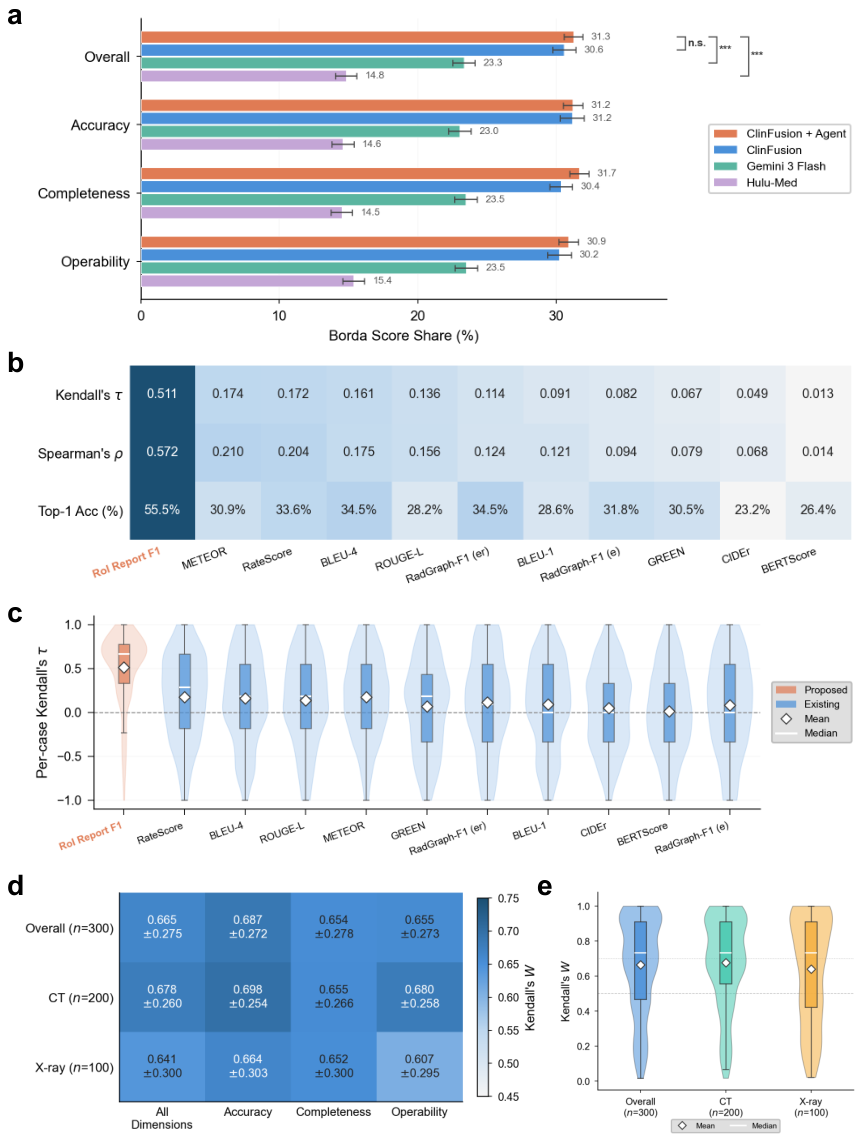
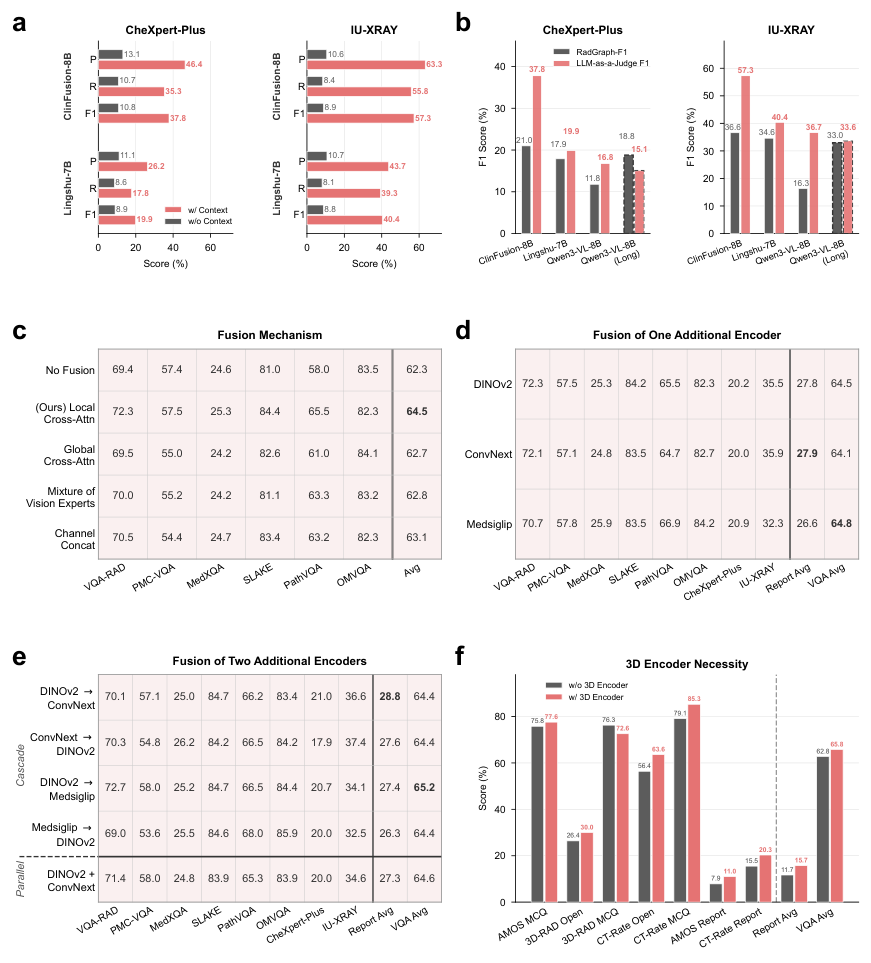
Расширенные данные
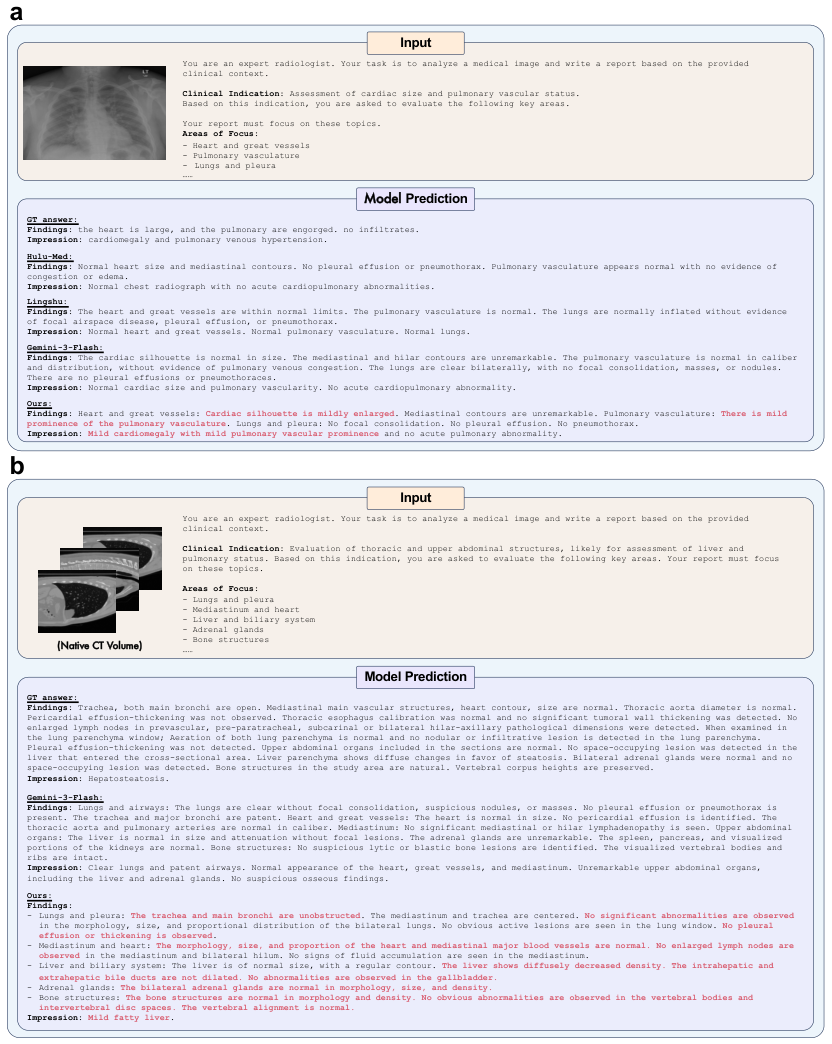
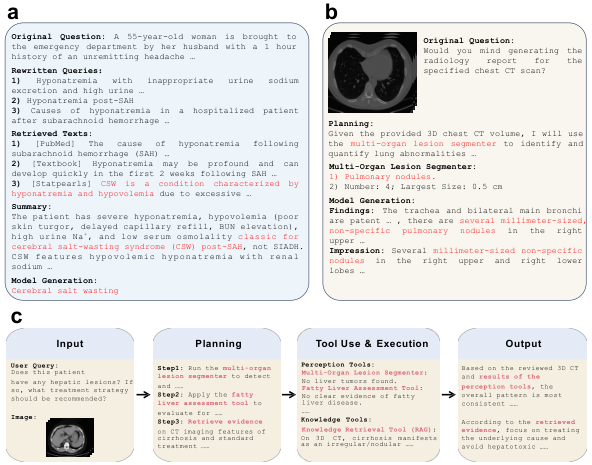
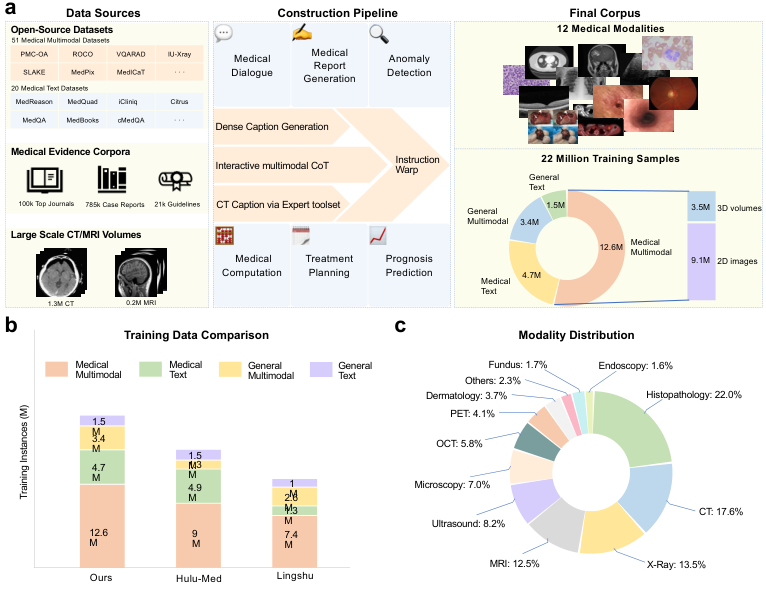
| Stage | Modality | Datasets | Scale |
| S1 | Medical multimodal | PMC-OA Lin et al. 2023; ROCO Pelka et al. 2018; ROCOv2 Rückert et al. 2024; PubMedVision Chen et al. 2024c; MIMIC-CXR Johnson et al. 2019; IU-Xray Demner-Fushman et al. 2016a; open-i Demner-Fushman et al. 2016a; MedICaT Subramanian et al. 2020; MedPix-2.0 Siragusa et al. 2025; BIOMEDICA Clinical Subset Lozano et al. 2025; BIOMEDICA Dermatology Subset Lozano et al. 2025; BIOMEDICA Histopathology Subset Lozano et al. 2025; BIOMEDICA Microscopy Subset Lozano et al. 2025; BIOMEDICA Surgery Subset Lozano et al. 2025; Synthetic Case Report Caption∗; Synthetic Journal Caption∗. | 3.9M |
| General multimodal | Llava-v1.5-Caption Liu et al. 2024b; PixMo Deitke et al. 2025. | 2.3M | |
| S2 | Medical multimodal | Same as S1 Medical Multimodal datasets. | 3.8M |
| General multimodal | Same as S1 General multimodal datasets. | 2.3M | |
| S3 | Medical multimodal | LLaVA-Med Li et al. 2023b; Quilt-LLaVA Seyfioglu et al. 2024; FairVLMed; CheXpert Plus Chambon et al. 2024; Kvasir-VQA Gautam et al. 2024; LLaVA-1.5-Instruct Liu et al. 2024b; MIMIC-Ext-MIMICCXR-VQA Bae et al. 2024; PathVQA He et al. 2021; PMC-VQA Zhang et al. 2024b; SLAKE Liu et al. 2021; VQA-Med-2019 Ben Abacha et al. 2019; VQA-RAD Lau et al. 2018; PMC-VQA-2-recaptions; SLAKE-recaptions; VQA-Med-2019-recaptions; VQA-RAD-recaptions; Path-VQA-recaptions; GMAI-Reasoning10K Su et al. 2025; Synthetic Medical OCR∗; Private CT∗; Synthetic Case Report VQA∗; Synthetic Journal VQA∗. | 5.3M |
| General multimodal | Llava-v1.5-MM Liu et al. 2024b; ALLaVA Chen et al. 2024d. | 1.1M | |
| Medical text | MedQuAD Ben Abacha and Demner-Fushman 2019; medical-o1-verifiable-problem Chen et al. 2024e; medical-o1-reasoning-SFT; ApolloCorpus Wang et al. 2024a; Medical-R1-Distill-Data; AlpaCare-MedInstruct-52k Zhang et al. 2023b; HealthCareMagic-100k Li et al. 2023c; PMC-LLaMA Wu et al. 2024; HuatuoGPT2-GPT4-SFT-140K Chen et al. 2023; MedReason Wu et al. 2025b; MedThoughts-8K Wei 2025; MedQA Jin et al. 2021; open-book-CMB-exam Wang et al. 2024b; cMedQA Zhang et al. 2018; HealthCareMagic Li et al. 2023c; iCliniq-10K Li et al. 2023c; Citrus_S3 Wang et al. 2025c; MedBooks-18-CoT Kim et al. 2025; Synthetic Case Report Long CoT∗. | 4.7M | |
| General text | Llava-v1.5-text-subset Liu et al. 2024b; OpenHermes-2.5 Teknium 2023. | 1.5M | |
| S4 | Medical multimodal | CT-Rate-report Hamamci et al. 2026; Merlin-report Blankemeier et al. 2026; RadGenome-ChestCT Zhang et al. 2024c; M3D-CAP Bai et al. 2024; OLD-INSPECT Huang et al. 2023; AMOS-MM-report amo 2024; AbdomenCT∗; ChronicCT∗; CardiovascularCT∗; PulmonaryNodulesCT∗. | 1.3M |
| S5 | Medical multimodal | All S3 medical multimodal datasets + AMOS-MM-VQA amo 2024; CT-Rate-VQA Hamamci et al. 2026; 3D-RAD Gai et al. 2025b; Synthetic-M3d-VQA∗; Merlin-MCQ Blankemeier et al. 2026; Merlin-VQA Blankemeier et al. 2026. | 6.4M |
| General multimodal | Same as S3 General multimodal datasets. | 1.1M | |
| Medical text | Same as S3 Medical text datasets. | 4.7M | |
| General text | Same as S3 General text datasets. | 1.5M |
| Benchmark | Modality/Genre | Scale (#) | Type | Lang. | Source |
| 2D Multimodal Medical VQA (Total: 141,587) | |||||
| VQA-RAD | Radiology (Single) | 451 | MCQ & Open | EN | Lau et al. 2018 |
| SLAKE | Radiology (Single) | 2,094 | MCQ & Open | EN & CN | Liu et al. 2021 |
| PathVQA | Pathology (Single) | 6,719 | MCQ & Open | EN | He et al. 2021 |
| PMC-VQA | Diverse (Single) | 33,430 | MCQ | EN | Zhang et al. 2024b |
| OmniMedVQA | Diverse (Single) | 88,996 | MCQ | EN | Hu et al. 2024 |
| MedFrameQA | Diverse (Multi) | 2,851 | MCQ | EN | Yu et al. 2025 |
| GMAI-MMBench | Diverse (Single) | 4,550 | MCQ | EN | Ye et al. 2024 |
| MedXpertQA (MM) | Diverse (Multi) | 2,000 | MCQ | EN | Zuo et al. 2025 |
| Text-only Medical Knowledge (Total: 17,074) | |||||
| MedQA (USMLE) | Clinical Exam | 1,273 | MCQ | EN | Jin et al. 2021 |
| MedQA (MCMLE) | Clinical Exam | 3,426 | MCQ | CN | Jin et al. 2021 |
| MedMCQA | Entrance Exam | 4,183 | MCQ | EN | Pal et al. 2022 |
| MMLU (Medical) | Multi-discipline | 1,871 | MCQ | EN | Hendrycks et al. 2021 |
| PubMedQA | Research QA | 500 | MCQ | EN | Jin et al. 2019 |
| MedBullets | Clinical Knowledge | 616 | MCQ | EN | Chen et al. 2025 |
| SuperGPQA | General Practice | 2,755 | MCQ | EN | Du et al. 2025 |
| MedXpertQA (Text) | Diverse | 2,450 | MCQ | EN | Zuo et al. 2025 |
| 3D Volumetric Medical VQA (Total: 48,907) | |||||
| CT-Rate-VQA | Non-Contrast Chest CT | 12,210 | MCQ & Open | EN | Hamamci et al. 2026 |
| 3D-RAD | Non-Contrast Chest CT | 33,910 | MCQ & Open | EN | Gai et al. 2025a |
| AMOS-MM | Abdominal CT | 2,787 | MCQ | EN | Ji et al. 2022 |
| 2D/3D Clinical Report Generation (Total: 3,935) | |||||
| IU-Xray | Chest X-ray | 296 | Report | EN | Demner-Fushman et al. 2016b |
| CheXpert-Plus | Chest X-ray | 200 | Report | EN | Chambon et al. 2024 |
| CT-Rate | Non-Contrast Chest CT | 3,039 | Report | EN | Hamamci et al. 2026 |
| AMOS-MM | Abdominal CT | 400 | Report | EN | Ji et al. 2022 |
| Medical Instruction Following | |||||
| MedIF-Bench | Mixed | 900 | IF | EN | Ours |
| Stage | Objective | Training Data | Trainable Components |
| ① | Shallow multi-encoder alignment (2D) | 2D Image-Text Pairs | All Encoders, 2D Fusion Modules |
| Align specialist 2D encoders. | |||
| ② | Deep vision-language alignment (2D) | 2D Image-Text Pairs | Full Model (All Encoders, 2D Fusion Modules, LLM) |
| Align fused 2D features with LLM. | |||
| ③ | 2D Instruction Tuning | 2D Instruction Datasets | Full Model (All Encoders, 2D Fusion Modules, LLM) |
| Teach 2D task execution. | |||
| ④ | Rapid 3D encoder alignment | 3D Volume-Text Pairs | 3D Encoder, 3D Fusion Modules |
| Efficiently align 3D encoder. | |||
| ⑤ | Holistic 2D/3D instruction tuning | 2D/3D Instruction Datasets | Full Model (All Encoders, All Fusion Modules, LLM) |
| Unlock full 2D/3D capabilities. |
Название набора данных Ссылка Доступ Этап применения: S1 – Медицинский мультимодальный PMC-OA https://huggingface.co/datasets/axiong/pmc_oa По лицензии CC ROCO https://github.com/razorx89/roco-dataset По лицензии CC ROCOv2 https://huggingface.co/datasets/eltorio/ROCOv2-radiology CC BY-NC-SA 4.0 PubMedVision https://huggingface.co/datasets/FreedomIntelligence/PubMedVision Apache 2.0 MIMIC-CXR https://physionet.org/content/mimic-cxr/ Лицензия PhysioNet IU-Xray https://openi.nlm.nih.gov/ Открытый доступ open-i https://openi.nlm.nih.gov/ Открытый доступ MedICaT https://github.com/allenai/medicat По лицензии CC MedPix-2.0 https://github.com/CHILab1/MedPix-2.0 CC BY-NC-SA 4.0 BIOMEDICA Clinical Subset https://huggingface.co/datasets/BIOMEDICA/biomedica_webdataset_24M По лицензии CC BIOMEDICA Dermatology Subset https://huggingface.co/datasets/BIOMEDICA/biomedica_webdataset_24M По лицензии CC BIOMEDICA Histopathology Subset https://huggingface.co/datasets/BIOMEDICA/biomedica_webdataset_24M По лицензии CC BIOMEDICA Microscopy Subset https://huggingface.co/datasets/BIOMEDICA/biomedica_webdataset_24M По лицензии CC BIOMEDICA Surgery Subset https://huggingface.co/datasets/BIOMEDICA/biomedica_webdataset_24M По лицензии CC Synthetic Case Report Caption Синтетические данные Внутренние синтетические данные Synthetic Journal Caption Синтетические данные Внутренние синтетические данные Этап применения: S1 – Общий мультимодальный LLaVA-v1.5-Caption https://github.com/haotian-liu/LLaVA CC BY-NC 4.0 PixMo https://huggingface.co/datasets/allenai/pixmo-cap ODC-BY v1.0 Этап применения: S2 – Медицинский мультимодальный То же, что и для медицинских мультимодальных наборов данных S1 Те же условия доступа, что и для S1 Medical multimodal Этап применения: S2 – Общий мультимодальный То же, что и для общих мультимодальных наборов данных S1 Те же условия доступа, что и для S1 General multimodal Этап применения: S3 – Медицинский мультимодальный LLaVA-Med https://github.com/microsoft/LLaVA-Med CC BY-NC 4.0 Quilt-LLaVA https://huggingface.co/datasets/wisdomik/QUILT-LLaVA-Instruct-107K CC BY-NC-ND 3.0 FairVLMed https://zenodo.org/records/13178701 CC BY-NC-ND 4.0 CheXpert Plus https://aimi.stanford.edu/datasets/chexpert-plus Доступ по учетным данным Kvasir-VQA https://datasets.simula.no/kvasir-vqa/ CC BY-NC 4.0 LLaVA-1.5-Instruct https://github.com/haotian-liu/LLaVA CC BY-NC 4.0 MIMIC-Ext-MIMICCXR-VQA https://physionet.org/content/mimic-ext-mimic-cxr-vqa/1.0.0/ Лицензия PhysioNet PathVQA https://huggingface.co/datasets/flaviagiammarino/path-vqa MIT PMC-VQA https://huggingface.co/datasets/RadGenome/PMC-VQA MIT SLAKE https://huggingface.co/datasets/BoKelvin/SLAKE CC BY 4.0 VQA-Med-2019 https://zenodo.org/records/10499039 CC BY 4.0 VQA-RAD https://huggingface.co/datasets/flaviagiammarino/vqa-rad CC0-1.0 PMC-VQA-2-recaptions https://huggingface.co/datasets/RadGenome/PMC-VQA Внутренние синтетические данные SLAKE-recaptions https://huggingface.co/datasets/BoKelvin/SLAKE Внутренние синтетические данные VQA-Med-2019-recaptions https://zenodo.org/records/10499039 Внутренние синтетические данные VQA-RAD-recaptions https://huggingface.co/datasets/flaviagiammarino/vqa-rad Внутренние синтетические данные Path-VQA-recaptions https://huggingface.co/datasets/flaviagiammarino/path-vqa Внутренние синтетические данные GMAI-Reasoning10K https://huggingface.co/datasets/General-Medical-AI/GMAI-Reasoning10K CC BY 4.0 Synthetic Medical OCR Синтетические данные Внутренние синтетические данные Synthetic Case Report VQA Синтетические данные Внутренние синтетические данные Synthetic Journal VQA Синтетические данные Внутренние синтетические данные Этап применения: S3 – Общий мультимодальный LLaVA-v1.5-MM https://github.com/haotian-liu/LLaVA CC BY-NC 4.0 ALLaVA https://huggingface.co/datasets/FreedomIntelligence/ALLaVA-4V Apache 2.0 Этап применения: S3 – Медицинский текст MedQuAD https://huggingface.co/datasets/lavita/MedQuAD Открытый доступ medical-o1-verifiable-problem https://huggingface.co/datasets/FreedomIntelligence/medical-o1-verifiable-problem Apache 2.0 medical-o1-reasoning-SFT https://huggingface.co/datasets/FreedomIntelligence/medical-o1-reasoning-SFT Apache 2.0 ApolloCorpus https://huggingface.co/datasets/FreedomIntelligence/ApolloCorpus Apache 2.0 Medical-R1-Distill-Data https://huggingface.co/datasets/FreedomIntelligence/Medical-R1-Distill-Data Apache 2.0 AlpaCare-MedInstruct-52k https://huggingface.co/datasets/lavita/AlpaCare-MedInstruct-52k CC BY 4.0 HealthCareMagic-100k https://huggingface.co/datasets/lavita/ChatDoctor-HealthCareMagic-100k Apache 2.0 icliniq10k https://huggingface.co/datasets/zhengComing/iCliniq-10K Apache 2.0 PMC-LLaMA https://github.com/chaoyi-wu/PMC-LLaMA Apache 2.0 HuatuoGPT2-GPT4-SFT-140K https://huggingface.co/datasets/FreedomIntelligence/HuatuoGPT2-GPT4-SFT-140K Apache 2.0 MedReason https://huggingface.co/datasets/UCSC-VLAA/MedReason CC BY 4.0 MedThoughts-8K https://huggingface.co/datasets/hw-hwei/MedThoughts-8K MIT MedQA https://github.com/jind11/MedQA MIT open-book-CMB-exam https://huggingface.co/datasets/wangrongsheng/open-book-CMB-exam Apache 2.0 cMedQA https://github.com/zhangsheng93/cMedQA2 GPL-3.0 HealthCareMagic https://huggingface.co/datasets/lavita/ChatDoctor-HealthCareMagic-100k Apache 2.0 iCliniq-10K https://huggingface.co/datasets/zhengComing/iCliniq-10K Apache 2.0 Citrus_S3 https://huggingface.co/datasets/jdh-algo/Citrus_S3 MIT MedBooks-18-CoT https://huggingface.co/datasets/dmis-lab/meerkat-instructions CC BY-NC 4.0 Synthetic Case Report Long CoT Синтетические данные Внутренние синтетические данные Этап применения: S3 – Общий текст LLaVA-v1.5-text-subset https://github.com/haotian-liu/LLaVA CC BY-NC 4.0 OpenHermes-2.5 https://huggingface.co/datasets/teknium/OpenHermes-2.5 Apache 2.0 Этап применения: S4 – Медицинский мультимодальный CT-Rate-report https://huggingface.co/datasets/ibrahimhamamci/CT-RATE CC BY-NC-SA 4.0 Merlin-report https://github.com/StanfordMIMI/Merlin MIT RadGenome-ChestCT https://huggingface.co/datasets/RadGenome/RadGenome-ChestCT CC BY 4.0 M3D-CAP https://huggingface.co/datasets/GoodBaiBai88/M3D-Cap Apache 2.0 OLD-INSPECT https://aimi.stanford.edu/datasets/inspect-Multimodal-Dataset… Доступ по учетным данным AMOS-MM-report https://zenodo.org/doi/10.5281/zenodo.10992154 CC BY 4.0 AbdomenCT Синтетические данные Внутренние синтетические данные ChronicCT Синтетические данные Внутренние синтетические данные CardiovascularCT Синтетические данные Внутренние синтетические данные PulmonaryNodulesCT Синтетические данные Внутренние синтетические данные Этап применения: S5 – Медицинский мультимодальный Все медицинские мультимодальные наборы данных S3 Те же условия доступа, что и для S3 Medical multimodal AMOS-MM-VQA https://zenodo.org/doi/10.5281/zenodo.10992154 CC BY 4.0 CT-Rate-VQA https://huggingface.co/datasets/ibrahimhamamci/CT-RATE CC BY-NC-SA 4.0 3D-RAD https://github.com/Tang-xiaoxiao/3D-RAD MIT Synthetic-M3d-VQA Синтетические данные Внутренние синтетические данные Merlin-MCQ https://github.com/StanfordMIMI/Merlin MIT Merlin-VQA https://github.com/StanfordMIMI/Merlin MIT Этап применения: S5 – Общий мультимодальный То же, что и для общих мультимодальных наборов данных S3 Те же условия доступа, что и для S3 General multimodal Этап применения: S5 – Медицинский текст То же, что и для медицинских текстовых наборов данных S3 Те же условия доступа, что и для S3 Medical text Этап применения: S5 – Общий текст То же, что и для общих текстовых наборов данных S3 Те же условия доступа, что и для S3 General text
Дополнительная информация
S1 Дополнительные методы: конвейеры синтеза данных
В этом разделе представлены подробные процедуры для четырех конвейеров синтеза данных, обобщенных в Методах (Раздел 4.3). Эти конвейеры направлены на устранение различных узких мест при обучении: 1) искажение инструкций (instruction warping) диверсифицирует медицинские инструкции для смягчения потери способности следовать инструкциям в процессе медицинской адаптации; 2) генерация плотных подписей (dense caption generation) преобразует зашумленные пары «рисунок из статьи — подпись» в обоснованное, детализированное визуально-языковое обучение; 3) интерактивная мультимодальная аннотация CoT синтезирует долгосрочные, визуально обоснованные траектории рассуждений для сложных задач мультимодального QA; и 4) крупномасштабные подписи к КТ с использованием экспертного инструментария создают 1,1 млн псевдоотчетов в радиологическом стиле для собранных в больницах томов КТ, не имеющих описаний. Полные рабочие процессы для генерации плотных подписей, создания подписей к КТ с экспертным инструментарием и интерактивной мультимодальной аннотации CoT проиллюстрированы на Дополнительном рис. 1⟧.
S1.1 Искажение инструкций
Медицинская адаптация имеет тенденцию снижать общую способность следовать инструкциям, что, в свою очередь, ограничивает способы выражения базовых медицинских знаний в реалистичных клинических условиях, таких как структурированные выходные данные (JSON), ограничение области действия («описывать только область интереса»), негативные ограничения («игнорировать легкие») или специфическое для предметной области форматирование, требуемое клиническими рабочими процессами. Для решения этой проблемы мы создаем конвейер аугментации инструкций посредством деформации инструкций, вдохновленный методом self-instruction, чтобы диверсифицировать инструкции по нескольким осям, сохраняя при этом медицинскую семантику..
Исходные шаблоны. Мы вручную создали 120 исходных инструкций, охватывающих разнообразные сценарии клинического применения и типы задач, каждая из которых содержит четкие требования к форматированию (например, строгие заголовки, JSON схемы, столбцы таблиц и фиксированный якорь Итогового ответа). Исходные данные разработаны для охвата четырех осей: 1) роли в диалоге (например, заметка радиолога, объяснение для пациента, помощник по сортировке); 2) сценарии (например, амбулаторная консультация, сортировка в отделении неотложной помощи, сравнение результатов динамического наблюдения, междисциплинарное обсуждение); 3) следование формату (JSON/таблицы/маркированные списки/контрольные списки с ограничениями по длине и полям); и 4) ограничения (только в рамках области, негативные ограничения, обработка неопределенности, требования к цитированию)).
Расширение на основе LLM. Опираясь на эти исходные данные, мы используем GPT-5.1 для их автоматического расширения до 21 тысячи шаблонов инструкций. Для каждого образца данных мы анализируем его, преобразуя в поля структурированной схемы, а затем пересобираем, используя выбранный шаблон, что существенно повышает разнообразие инструкций при минимальном семантическом сдвиге..
S1.2 Генерация плотных описаний
Значительная часть крупномасштабных медицинских мультимодальных данных собирается из бумажных иллюстраций, сопровождаемых подписями. Однако эти пары часто страдают от низкого качества согласования: подписи обычно содержат только наиболее важные выводы и, следовательно, обеспечивают слабое, неполное обучение; в то же время иллюстрации в статьях часто являются составными, смешивая медицинские изображения с графиками, стрелками, символами и аннотациями. Подобный визуальный шум вносит помехи, а также отклоняется от реальных клинических изображений, снижая возможность переноса моделей в практические медицинские условия (Supplementary Fig. 1a).
Сегментация и фильтрация подрисунков. Следуя Lozano et al. 2025, мы выполняем сегментацию подрисунков на снимках документов, чтобы разложить сложные рисунки на изображения-кандидаты. Затем мы применяем многоэтапный конвейер фильтрации, чтобы сохранить только высококачественные медицинские изображения: 1) удаление неизобразительных панелей (графиков/таблиц); 2) удаление областей с большим количеством аннотаций или низким разрешением; 3) проверка модальности и медицинской значимости; и 4) дедупликация почти идентичных изображений.
Регенерация плотных описаний. Для сохраненных под-изображений мы генерируем плотные описания, основываясь на исходной подписи и визуальном контенте, переходя от «заголовочных» подписей к обоснованному, детализированному контролю, который инвентаризирует видимые находки, анатомический контекст и специфические для модальности паттерны, избегая при этом не визуальных предположений. Мы используем двухпроходную схему генерации: 1) Визуальная инвентаризация. Мы используем две взаимодополняющие VLM, GPT-5.1 и Gemini 3 Pro, для независимого создания визуальной инвентаризации, которая перечисляет непосредственно наблюдаемые элементы (например, находки, локализации и признаки внешнего вида). Затем мы сохраняем только согласованные, перекрывающиеся между моделями элементы в качестве фильтра надежности. 2) Клинически связное описание. Консенсусный перечень затем используется для генерации клинически связного описания с соответствующей медицинской формулировкой и структурой.
Мы сформировали наш исходный корпус из 100 тысяч журнальных статей и 785 тысяч отчетов о клинических случаях, получив 749 тысяч высококачественных медицинских изображений в паре с подписями. Применение вышеуказанного конвейера плотного аннотирования позволяет получить 610 тысяч образцов с плотными подписями, обобщенных как Synthetic Case Report Caption и Synthetic Journal Caption в Extended Data Table 1. Эти плотные подписи в основном используются на ранних этапах выравнивания для усиления связи между визуальными и языковыми данными, а также служат в качестве богатого источника контроля для последующей instruction tuning..
S1.3 Интерактивная мультимодальная аннотация с цепочкой рассуждений
Помимо восприятия, медицинские MLLM должны поддерживать многошаговое рассуждение на основе мультимодальных доказательств. Мы обнаружили, что многие существующие экземпляры медицинских VQA либо слишком коротки, либо могут быть решены с помощью поверхностного сопоставления с образцом, и поэтому не создают сильных стимулов для долгосрочного мультимодального рассуждения. Чтобы целенаправленно обучить этой способности, мы создаем сложный набор данных для мультимодального рассуждения с помощью конвейера аннотирования на основе мультиагентной системы, следуя основной идее итеративного повторного анализа Jian et al. 2025 (Дополнительный рис. 1c).
Майнинг сложности. Мы присваиваем каждому кандидату мультимодального QA-экземпляра оценку сложности, используя фиксированную модель-решатель. Для каждого экземпляра мы запрашиваем решатель по стандартизированному промпту для получения стохастических выборок и вычисляем: 1) эмпирический коэффициент правильности (pass@1); и 2) среднюю длину генерации, измеренную в выходных токенах. На практике мы используем Qwen3-VL-8B Bai et al. 2025b в качестве модели-решателя..
Наша интуиция заключается в том, что примеры с низкой точностью, но большой длиной генерации часто провоцируют обширные, но непродуктивные рассуждения, которые являются желаемыми исходными данными для построения обучающих выборок, сфокусированных на логических выводах. Соответственно, мы приоритизируем примеры по:
| (11) |
где обозначает точность решателя на одном примере, а — среднюю длину ответа. Мы помечаем экземпляры с как сложные для рассуждения примеры и дополнительно применяем выборку с учетом разнообразия, чтобы избежать избыточного представления повторяющихся паттернов, получая 100 тысяч разнообразных сложных для рассуждения экземпляров.
Мультиагентное рассуждение. Мы проектируем мультиагентный конвейер, который связывает текстовый оркестратор с мультимодальным визуальным граундером посредством итеративного взаимодействия, направленного на поиск доказательств. Для каждого экземпляра оркестратор имеет доступ только к текстовым компонентам (вопрос и варианты ответов) и не может напрямую наблюдать изображение/объем. Сначала он анализирует вопрос, чтобы определить визуальные атрибуты, анатомические признаки или области, которые необходимо проверить, а затем преобразует их в целевые подвопросы для проверки фактов. Визуальный граундер получает медицинское изображение/объем вместе с запросами оркестратора, изучает визуальные доказательства и возвращает обоснованные наблюдения. Мы используем GPT-5.1 в качестве оркестратора и Gemini 3 Pro в качестве визуального граундера..
Оркестратор интегрирует полученные доказательства, обновляет свои гипотезы и либо запрашивает дополнительные, более специфические визуальные проверки, либо формирует окончательный ответ, как только накопленных доказательств становится достаточно. Это взаимодействие с замкнутым контуром продолжается в течение нескольких раундов и гарантирует, что каждый шаг рассуждения подкрепляется вновь полученными визуальными доказательствами, тем самым смягчая проблему дрейфа обоснования по мере увеличения глубины рассуждений. Мы сохраняем только те траектории, итоговый вывод которых совпадает с эталонным ответом, что дает 67 тысяч высоконадежных примеров сложных мультимодальных рассуждений, которые в основном используются для instruction tuning с целью повышения точности долгосрочных, визуально обоснованных рассуждений..
S1.4 Масштабируемое описание компьютерной томографии с экспертным набором инструментов
Компьютерная томография является ключевым методом диагностики и дифференциации многих заболеваний, а нативное понимание трехмерных объемов компьютерной томографии имеет решающее значение для реального клинического внедрения. Поэтому мы выстраиваем согласованное обучение на основе данных компьютерной томографии и отчетов в широком масштабе с помощью двусторонней стратегии: 1) сбор наборов данных компьютерной томографии с открытым исходным кодом, которые уже включают высококачественные отчеты, и 2) расширение охвата за счет собранных в больницах сканов компьютерной томографии, не имеющих отчетов, путем генерации псевдометок в стиле отчетов (дополнительный рис. 1b).
КТ с открытым исходным кодом и высококачественными отчетами. Мы отобрали 0,2 млн КТ-исследований из наборов данных с открытым исходным кодом, сопровождаемых высококачественными радиологическими отчетами Bai et al. 2024, Hamamci et al. 2026, Blankemeier et al. 2026, Huang et al. 2023. Они обеспечивают чистое парное обучение для 3D-выравнивания и оценки генерации отчетов..
Сбор данных компьютерной томографии в больницах и генерация псевдоотчетов. Для дальнейшего развития моделирования, ориентированного на компьютерную томографию, мы сотрудничаем с несколькими больницами для создания крупномасштабного внутреннего набора данных, включающего 1,5 миллиона КТ-сканов. Из-за соглашений о конфиденциальности данных нам было разрешено получить доступ только к деидентифицированным КТ-изображениям без сопутствующих радиологических отчетов. Чтобы обеспечить контроль на уровне отчетов в широком масштабе, мы разработали конвейер аннотирования КТ-отчетов под руководством аннотаций, основанный на наборе инструментов визуальной экспертизы, который в основном состоит из модели сегментации поражений He et al. 2025 и модели сегментации органов Wasserthal et al. 2023. Этот набор инструментов создает структурированные псевдоаннотации на основе изображений, которые впоследствии преобразуются в подписи в радиологическом стиле..
Конвейер состоит из четырех этапов. 1) Модель сегментации очагов поражения создает маски очагов с анатомическими метками, которые агрегируются в структурированное представление CT, отражающее клинически значимые атрибуты (например, наличие органа, локализацию очага и паттерны поражения). 2) Для каждой записи об очаге мы извлекаем репрезентативные срезы CT, охватывающие очаг, и накладываем маркеры области поражения на выбранные срезы. 3) Отмеченные срезы вместе с метаданными об очаге передаются в VLM для генерации локальных описаний, сфокусированных на очаге. 4) Затем мы синтезируем структурированные атрибуты и описания очагов в стандартизированный текст в стиле радиологических заключений/впечатлений посредством генерации с медицинскими ограничениями..
На всех этапах применяется строгий контроль качества, включающий проверку корректности масок (границы размера и топологические ограничения), верификацию согласованности между срезами и проверку на текстовом уровне для уменьшения количества ложных результатов и предотвращения необоснованных утверждений. Используя этот конвейер, мы генерируем псевдоотчеты для 1,1 млн случаев КТ, существенно расширяя масштаб и разнообразие данных, согласованных между КТ и отчетами..
Полный корпус, согласованный с компьютерной томографией и отчетами (0,2 млн с открытым исходным кодом + 1,1 млн с псевдоразметкой), поддерживает как этап ④ (быстрое выравнивание 3D-энкодера), так и этап ⑤ (целостная настройка инструкций для 2D/3D). Большая часть с псевдоразметкой улучшает объемное разнообразие и устойчивость, в то время как меньшая часть с открытым исходным кодом обеспечивает высокоточные опорные точки для выравнивания..
S2 Дополнительные методы: Агентное использование инструментов
В этом разделе представлены подробные алгоритмы поиска для инструмента знаний (Раздел 4.4.1), а также маршрутизация инструментов и дизайн интерфейса для экспертных инструментов восприятия (Раздел 4.4.2), обобщенные в Методах.
S2.1 Инструмент знаний: Гибридный поиск и агрегация из нескольких источников
Инструмент знаний объединяет два взаимодополняющих канала поиска, за которыми следует агрегация доказательств из разных источников ⟦BROKEN_K0⟧.
Гибридный поиск с нормализацией концептов. Медицинские запросы и документы содержат повсеместную неоднозначность (синонимы, аббревиатуры, торговые и непатентованные названия лекарств, варианты написания). Чтобы уменьшить такую неоднозначность на этапе поиска, мы выполняем нормализацию концептов с использованием UMLS перед выполнением запроса: медицинские сущности, упомянутые в запросе, сопоставляются со стандартизированными медицинскими концептами. Затем поиск осуществляется по двум взаимодополняющим каналам. Во-первых, векторная поисковая система извлекает семантически соответствующие фрагменты доказательств из крупномасштабных корпусов, улучшая полноту поиска при лингвистической вариативности. Во-вторых, поиск на основе KG использует два медицинских графа знаний с открытым исходным кодом: UMLS National Library of Medicine (2024) US, который предоставляет стандартизированные идентификаторы медицинских концептов для надежной нормализации синонимов и аббревиатур, и PrimeKG Chandak et al. 2023, который предлагает богатые биомедицинские связи (например, лекарство–болезнь, симптом–болезнь, противопоказание), поддерживающие расширение на основе связей до клинически значимых вышестоящих/нижестоящих концептов. Такой структурированный поиск обеспечивает маршрутизацию от концепта к доказательству и уменьшает пропуски, вызванные несоответствием поверхностных форм. Два канала интегрируются посредством нормализованных концептов и семантического сходства, формируя набор доказательств-кандидатов, основанный на явных медицинских сущностях и отношениях..
Агрегация доказательств из различных источников. Медицинские QA часто выигрывают от объединения взаимодополняющих представлений доказательств: векторный поиск обычно возвращает фрагменты, максимально соответствующие запросу, в то время как поиск на основе KG обеспечивает более богатый контекст вышестоящих/нижестоящих связей, привязанный к нормализованным сущностям. Поскольку эти два канала различаются по гранулярности и поверхностной форме, мы агрегируем доказательства путем кластеризации извлеченных фрагментов из обоих каналов, используя семантическое сходство и пересечение нормализованных медицинских сущностей, группируя контент, который утверждает одно и то же клиническое положение или предлагает взаимную поддержку из разных источников. Затем ClinFusion суммирует каждый кластер, чтобы сохранить общее клиническое заключение вместе с ключевыми квалификаторами (например, показания, противопоказания, ограничения дозировки), и прикрепляет ссылки на подтверждающие фрагменты. Такая агрегация по принципу «кластеризация с последующим обобщением» совместно использует точность поиска на основе эмбеддингов и реляционную широту поиска KG, создавая компактный, обоснованный доказательствами контекст для получения достоверных и прослеживаемых клинических ответов..
S2.2 Экспертные инструменты восприятия: описания инструментов и маршрутизация
Подробные описания инструментов. Мы предоставляем расширенные описания пяти экспертов по восприятию, интегрированных в ClinFusion, каждый из которых формирует структурированные выводы, которые агент может напрямую использовать для обоснованного рассуждения..
- ⟦• Эксперт по сегментации поражений нескольких органов He et al. 2025 сегментирует 29 распространенных типов поражений в восьми органах: молочной железе, толстой кишке, пищеводе, желудке, почках, легких, печени и поджелудочной железе. Это позволяет ClinFusion обосновывать ответы на основе точных перечней поражений (количество, локализация, размер), поддерживать количественную оценку опухолевой нагрузки и обеспечивать согласованность в случаях с множественными поражениями или поражениями нескольких органов, где визуальное описание в свободной форме подвержено ошибкам..
- ⟦• Эксперт по оценке жировой дистрофии печени Gao et al. 2026 оценивает степень тяжести жировой дистрофии печени по данным КТ и локализует область паренхимы печени, используемую для оценки. Это позволяет ClinFusion обеспечивать стандартизированную оценку стеатоза с отслеживаемыми визуальными доказательствами (область паренхимы), повышая воспроизводимость для скрининга, стратификации рисков и динамического наблюдения..
- ⟦• Эксперт по сегментации абдоминальных лимфатических узлов Yu et al. 2024 сегментирует абдоминальные лимфатические узлы и чувствителен к их размеру, что способствует выявлению лимфаденопатии. Это позволяет ClinFusion выполнять структурированную оценку узлов (перечисление узлов + критерии на основе размера), что является центральным элементом онкологического стадирования и отслеживания ответа на терапию, и что трудно надежно выполнить с помощью общего визуально-языкового восприятия.
- ⟦• Эксперт по классификации результатов рентгенографии грудной клетки Cohen et al. 2020, Yang et al. 2025b прогнозирует структурированные вероятности для широкого спектра торакальных патологий на основе рентгеновских снимков грудной клетки. В нашей системе этот эксперт объединяет TorchXRayVision, который обеспечивает стандартизированную предобработку и мощные предобученные модели рентгенографии грудной клетки для 18 распространенных патологий, с CheXFound — базовой моделью для рентгенографии грудной клетки, предобученной на миллионе изображений и поддерживающей классификацию по 40 патологиям. Этот эксперт позволяет ClinFusion дополнять свободное понимание изображений явными доказательствами на уровне патологий, повышая надежность и согласованность при генерации отчетов и медицинском VQA.
- ⟦• Эксперт по генерации заключений по рентгенограммам грудной клетки Chen et al. 2024b создает клинически согласованные описания результатов рентгенографии. Построенный на базе CheXagent, фундаментальной модели зрения и языка, обученной на крупномасштабном наборе данных CheXinstruct и оцененной в различных задачах интерпретации рентгенограмм грудной клетки, этот эксперт в основном используется для составления описаний в стиле заключений, которые суммируют видимые аномалии грудной клетки и их визуальный контекст. Это позволяет ClinFusion получать более богатые доказательства на уровне предложений, когда одних только оценок классификации недостаточно, что улучшает полноту и связность составления отчетов по рентгенографии грудной клетки и ответов на вопросы, ориентированных на результаты исследований..
Маршрутизация инструментов и интерфейс с приоритетом схемы. ClinFusion не следует жесткому рабочему процессу; вместо этого система ищет конкретные визуальные доказательства, требуемые вопросом пользователя, и вызывает соответствующие инструменты. Когда запрос подразумевает, что ответ зависит от точной локализации или измерения — например, запрос размера наибольшего очага поражения, вопрос об увеличении лимфатических узлов, запрос степени ожирения печени или подсчет очагов поражения в целевом органе — ClinFusion рассматривает это как нехватку доказательств и инициирует вызовы инструментов, вместо того чтобы полагаться на приблизительное визуальное суждение. Чтобы сделать использование инструментов стабильным, контролируемым и пригодным для ClinFusion, мы применяем интерфейс с приоритетом схемы. Каждый эксперт по восприятию регистрируется с помощью карты возможностей, которая определяет поддерживаемые анатомические области и набор меток, измеряемые конечные точки, такие как диаметры, объемы и степени тяжести, а также типы клинических вопросов, которые инструмент может решить. Эта явная спецификация обеспечивает целенаправленную маршрутизацию. Выходные данные инструментов нормализуются в компактные объекты доказательств, а затем вербализуются в утверждения о доказательствах на естественном языке, прежде чем быть возвращенными в ClinFusion. Чрезмерно детализированные числовые поля, такие как координаты на уровне вокселей, отображаются в укрупненные стандартизированные дескрипторы местоположения, например, liver_top, что снижает чувствительность к шуму координат при сохранении клинически значимой локализации..
S3 Дополнительные абляционные исследования
Стохастическая остаточная регуляризация демонстрирует преимущества для понимания трехмерных объемов. На основе вышеуказанных экспериментов мы добавляем 3D ViT в качестве четвертого визуального энкодера для обеспечения нативного понимания объемов. Мы обучаем модель на всех пяти этапах с использованием частичных 2D и 3D данных для обеспечения быстрой обратной связи. Наши предыдущие эксперименты указывали на эффект убывающей отдачи при добавлении третьего визуального энкодера, что предполагает, что компоненты на более поздних этапах могут с трудом эффективно интегрироваться в уже мощную модель. Мы выдвинули гипотезу, что более сильная схема регуляризации может смягчить этот побочный эффект за счет стимулирования более надежного обучения признаков. Чтобы проверить это, мы оценили влияние применения стохастической остаточной регуляризации во время обучения. Результаты, представленные в Supplementary Table 12, подтверждают нашу гипотезу. Использование стохастического подхода приводит к явному улучшению как среднего балла 3D VQA (с 64.8 до 65.8), так и средних метрик генерации отчетов (с 23.4 / 13.3 / 15.1 до 23.7 / 14.0 / 15.7). Однако мы также заметили, что эти преимущества зависят от достаточной продолжительности обучения. При более коротких циклах обучения разрыв в производительности между стохастическими и детерминированными моделями был незначительным или даже обратным. Это говорит о том, что, хотя стохастическая регуляризация обеспечивает более надежный обучающий сигнал, для полного проявления ее преимуществ требуются адекватные шаги оптимизации..
Интерпретация функциональности дополнительных энкодеров. Для качественной интерпретации того, как композиционная архитектура зрения способствует итоговому прогнозу, мы используем Grad-CAM Selvaraju et al. 2020 для визуализации областей внимания наших специализированных энкодеров, DINOv2 и ConvNext. Мы анализируем два примера генерации отчетов по рентгенографии грудной клетки, чтобы проиллюстрировать, как эти энкодеры демонстрируют взаимодополняющее разделение труда, которое затем объединяется нашим механизмом CaSL Fusion для создания всестороннего и точного отчета. Как показано на Supplementary Fig. 2, специализированные энкодеры демонстрируют различные, но синергетические паттерны внимания. В первом примере (верхний ряд), где описывается послеоперационная грудная клетка, визуализации Grad-CAM выявляют четкое разделение задач. DINOv2, известный своим мощным извлечением семантических признаков, направляет свое внимание непосредственно на контур сердца. Этот глобальный семантический фокус критически важен для оценки общего размера и формы органа, что приводит к выявлению кардиомегалии. Для сравнения, ConvNext, обладающий мощным индуктивным смещением для локальных паттернов и текстур, точно выделяет проволоку после стернотомии по средней линии. Это демонстрирует его специализацию на выявлении мелкозернистых искусственных объектов или текстурных аномалий. Второй пример (нижний ряд) дополнительно подтверждает это наблюдение. Случай включает множественные находки, включая двусторонний плевральный выпот и ателектаз. Здесь DINOv2 охватывает широкую область внимания, фокусируясь на двустороннем плевральном выпоте и основаниях легких, которые являются ключевыми для идентификации описанного базального ателектаза. Интересно, что в этом конкретном случае визуализация ConvNext не показывает значительной активации, что предполагает, что его роль может быть более тонкой или зависящей от контекста. Это может указывать на то, что для случаев, в которых преобладают крупномасштабные изменения жидкости и плотности (такие как выпот), доминирует глобальное семантическое понимание DINOv2, в то время как вклад ConvNext становится более критичным, когда мелкозернистые текстурные детали имеют диагностическое значение. Это динамическое взаимодействие, управляемое нашим каскадным слиянием, позволяет ClinFusion гибко использовать наиболее релевантные визуальные доказательства для любого полезного случая, что приводит к более надежному и целостному восприятию..
S4 Дополнительные рисунки
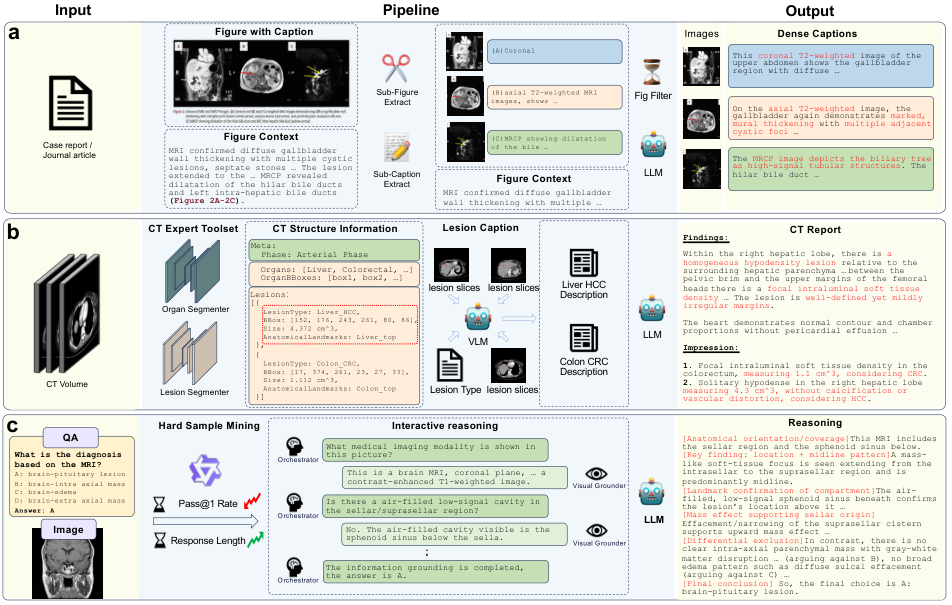
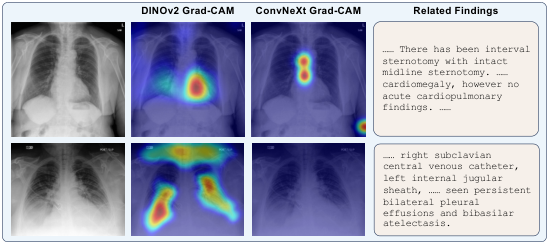
S5 Дополнительные таблицы
| Multi-modality | Specific-modality | Reasoning | ||||||
| Benchmarks | Benchmarks | Benchmark | ||||||
| Models | OM.VQA | PMCVQA | MedF | GMAI | VQA-RAD | SLAKE | PathVQA | MedXQA |
| Proprietary Models | ||||||||
| GPT-5.2† | 68.4 | 56.7 | 52.1 | 58.4 | 73.4 | 79.4 | 54.0 | 52.9 |
| Gemini-3-Flash† | 82.0 | 64.4 | 53.3 | 67.8 | 71.0 | 80.3 | 60.6 | 78.0 |
| Claude-Sonnet-4.5† | 67.1 | 58.4 | 54.2 | 47.6 | 63.6 | 72.6 | 51.7 | 42.8 |
| General-purpose MLLMs | ||||||||
| Qwen2.5-VL-7B† | 63.3 | 51.7 | 46.9 | 44.0 | 59.6 | 67.4 | 43.4 | 22.5 |
| Qwen3-VL-8B† | 76.4 | 54.0 | 42.1 | 54.0 | 61.9 | 70.4 | 42.8 | 24.9 |
| InternVL3-8B | 79.1 | 53.8 | – | – | 65.4 | 72.8 | 48.6 | 22.4 |
| InternVL3-14B | 78.9 | 54.1 | – | – | 66.3 | 72.8 | 48.0 | 23.1 |
| Qwen2.5-VL-32B† | 67.2 | 53.2 | 51.5 | 47.4 | 72.7 | 77.2 | 46.3 | 25.4 |
| Qwen3-VL-32B† | 76.8 | 56.5 | 52.0 | 56.3 | 66.1 | 76.9 | 48.6 | 31.2 |
| InternVL3-38B | 79.8 | 56.6 | – | – | 65.4 | 72.7 | 51.0 | 25.2 |
| Qwen3-VL-235B† | 75.8 | 56.2 | 50.3 | 54.9 | 67.8 | 75.5 | 51.1 | 33.7 |
| Medical MLLMs | ||||||||
| — Models ¡ 10B — | ||||||||
| BiomedGPT | 27.9 | 27.6 | – | – | 16.6 | 13.6 | 11.3 | – |
| Med-R1-2B | – | 47.4 | – | – | 39.0 | 54.5 | 15.3 | 21.1 |
| MedVLM-R1-2B | 77.6 | 48.8 | – | – | 49.2 | 56.3 | 36.0 | 21.4 |
| HealthGPT-M3 | 71.5 | 55.4 | – | – | 56.8 | 70.8 | 55.4 | 22.4 |
| BioMediX2-8B | 66.0 | 41.8 | – | – | 55.7 | 54.1 | 34.6 | 21.9 |
| LLaVA-Med-7B | 34.8 | 22.7 | – | – | 46.6 | 51.9 | 35.2 | 20.8 |
| MedGemma-4B-IT | 70.7 | 49.2 | – | – | 72.3 | 78.2 | 48.1 | 25.4 |
| HuatuoGPT-V-7B | 74.3 | 53.1 | – | – | 67.6 | 68.1 | 44.8 | 23.2 |
| Lingshu-7B | 82.9 | 56.3 | – | – | 67.9 | 83.1 | 61.9 | 26.7 |
| Hulu-Med-7B | 84.2 | 66.8 | – | – | 78.0 | 86.8 | 65.6 | 29.0 |
| MedGemma-1.5-4B-IT† | 47.5 | 18.7 | 40.5 | 21.8 | 55.2 | 63.6 | 34.7 | 18.5 |
| Lingshu-7B† | 83.4 | 57.4 | 58.2 | 51.8 | 64.3 | 81.5 | 57.3 | 26.4 |
| Hulu-Med-7B† | 79.4 | 61.7 | 54.8 | 51.8 | 68.5 | 74.7 | 54.2 | 25.6 |
| ClinFusion-8B | 89.6 | 67.8 | 64.3 | 57.9 | 76.3 | 91.1 | 68.7 | 32.4 |
| — Models ¿ 10B — | ||||||||
| HealthGPT-14B | 75.2 | 56.4 | – | – | 65.0 | 66.1 | 56.7 | 24.7 |
| HuatuoGPT-V-34B | 74.0 | 56.6 | – | – | 61.4 | 69.5 | 44.4 | 22.1 |
| Lingshu-32B | 83.4 | 57.9 | – | – | 76.7 | 86.7 | 65.5 | 30.9 |
| MedDr-40B | 64.3 | 13.9 | – | – | 65.2 | 66.4 | 53.5 | – |
| Hulu-Med-14B | 85.1 | 68.9 | – | – | 76.1 | 86.5 | 64.4 | 30.0 |
| Hulu-Med-32B | 84.6 | 69.4 | – | – | 81.4 | 85.7 | 67.3 | 34.0 |
| MedGemma-27B-IT† | 60.0 | 49.2 | 49.5 | 37.3 | 65.6 | 75.5 | 43.4 | 23.6 |
| Lingshu-32B† | 83.4 | 62.3 | 58.9 | 55.6 | 73.2 | 87.6 | 63.4 | 30.5 |
| Hulu-Med-32B† | 80.0 | 63.2 | 61.6 | 57.3 | 75.8 | 82.6 | 63.1 | 32.6 |
| ClinFusion-32B | 89.9 | 70.8 | 69.4 | 60.2 | 77.2 | 92.5 | 72.4 | 38.7 |
| CheXpert-Plus | IU-XRAY | |||||
| Models | Precision | Recall | F1 | Precision | Recall | F1 |
| Proprietary Models | ||||||
| GPT-5.2† | 49.1 | 38.1 | 40.2 | 55.3 | 50.3 | 50.6 |
| Gemini-3-Flash† | 38.4 | 33.5 | 33.0 | 56.8 | 55.2 | 54.4 |
| Claude-Sonnet-4.5† | 33.8 | 28.3 | 28.9 | 39.2 | 39.2 | 37.7 |
| General-purpose MLLMs | ||||||
| Qwen2.5-VL-7B† | 13.7 | 11.5 | 12.0 | 33.0 | 32.9 | 32.4 |
| Qwen3-VL-8B† | 20.0 | 16.3 | 16.8 | 37.0 | 37.3 | 36.7 |
| Qwen2.5-VL-32B† | 22.2 | 16.2 | 17.3 | 33.5 | 31.9 | 31.9 |
| Qwen3-VL-32B† | 30.6 | 27.9 | 27.3 | 40.8 | 41.0 | 40.0 |
| Qwen3-VL-235B† | 29.5 | 25.2 | 25.6 | 43.2 | 41.4 | 41.2 |
| Medical MLLMs | ||||||
| — Models ¡ 10B — | ||||||
| MedGemma-1.5-4B-IT† | 34.1 | 23.1 | 25.4 | 43.1 | 38.9 | 39.8 |
| Lingshu-7B† | 26.2 | 17.8 | 19.9 | 43.7 | 39.3 | 40.4 |
| Hulu-Med-7B† | 40.5 | 29.1 | 31.9 | 51.1 | 45.3 | 46.5 |
| ClinFusion-8B | 46.4 | 35.3 | 37.8 | 63.3 | 55.8 | 57.3 |
| ClinFusion-8B + Agentic tools | 57.3 | 49.8 | 50.2 | 64.5 | 59.4 | 59.9 |
| — Models ¿ 10B — | ||||||
| MedGemma-27B-IT† | 26.9 | 21.9 | 22.5 | 41.3 | 40.7 | 40.1 |
| Lingshu-32B† | 28.0 | 21.5 | 22.8 | 44.5 | 40.5 | 41.3 |
| Hulu-Med-32B† | 51.0 | 35.5 | 39.6 | 53.5 | 46.8 | 48.2 |
| ClinFusion-32B | 56.1 | 46.6 | 48.0 | 60.2 | 54.7 | 55.6 |
| ClinFusion-32B + Agentic tools | 60.2 | 55.4 | 54.8 | 60.8 | 56.1 | 56.3 |
| Complex Reasoning Benchmarks | Text Understanding | Medical Exam Benchmarks | ||||||
| Benchmark | ||||||||
| Models | MedXQA | Medbullets | SGPQA | PubMedQA | MedMCQA | MedQA-U | MedQA-M | MMLU-Med |
| Proprietary Models | ||||||||
| GPT-5.2 | 40.4 | 81.3 | 55.6 | 77.6 | 79.1 | 91.0 | 88.9 | 90.5 |
| Gemini-3-Flash | 65.3 | 85.6 | 73.9 | 80.4 | 85.5 | 95.1 | 94.0 | 91.7 |
| Claude-Sonnet-4.5 | 36.9 | 81.8 | 59.4 | 74.8 | 78.8 | 90.4 | 90.6 | 92.1 |
| General-purpose MLLMs | ||||||||
| Qwen2.5-VL-7B† | 12.0 | 43.0 | 25.8 | 74.6 | 53.2 | 56.4 | 76.9 | 74.1 |
| Qwen3-VL-8B† | 14.6 | 51.9 | 36.9 | 72.2 | 60.7 | 66.2 | 87.2 | 80.0 |
| InternVL3-8B | 13.1 | 48.5 | 31.2 | 75.4 | 57.7 | 62.1 | – | 77.5 |
| InternVL3-14B | 14.1 | 49.5 | 37.9 | 77.2 | 62.0 | 70.1 | – | 81.7 |
| Qwen2.5-VL-32B† | 15.8 | 54.2 | 39.3 | 71.6 | 62.9 | 70.8 | 90.0 | 83.3 |
| Qwen3-VL-32B† | 18.2 | 60.1 | 47.4 | 71.0 | 68.2 | 77.5 | 91.7 | 86.6 |
| InternVL3-38B | 16.0 | 54.6 | 42.5 | 73.2 | 64.9 | 73.5 | – | 83.8 |
| Qwen3-VL-235B† | 23.3 | 69.6 | 53.8 | 75.2 | 74.3 | 85.2 | 93.7 | 88.8 |
| Medical MLLMs | ||||||||
| — Models ¡ 10B — | ||||||||
| MedVLM-R1-2B | 11.8 | 33.8 | 19.1 | 66.4 | 39.7 | 42.3 | – | 51.8 |
| BioMediX2-8B | 13.4 | 45.9 | 25.2 | 75.2 | 52.9 | 58.9 | – | 68.6 |
| MedGemma-4B-IT | 12.8 | 45.6 | 21.6 | 72.2 | 52.2 | 56.2 | – | 66.7 |
| HealthGPT-M3 | 11.5 | 41.4 | 18.9 | 57.8 | 54.2 | 55.0 | – | 72.5 |
| LLaVA-Med-7B | 9.90 | 34.4 | 16.1 | 26.4 | 39.4 | 42.0 | – | 50.6 |
| HuatuoGPT-V-7B | 10.1 | 40.9 | 21.9 | 72.8 | 51.2 | 52.9 | – | 69.3 |
| Lingshu-7B | 16.5 | 56.2 | 26.3 | 76.6 | 55.9 | 63.3 | – | 74.5 |
| Hulu-Med-7B | 19.6 | 61.5 | 31.1 | 77.4 | 67.6 | 73.5 | – | 79.5 |
| MedGemma-1.5-4B-IT† | 9.18 | 33.4 | 2.25 | 6.26 | 6.29 | 35.7 | 4.23 | 10.3 |
| Lingshu-7B† | 17.0 | 56.2 | 28.9 | 75.0 | 55.5 | 62.5 | 78.4 | 75.6 |
| Hulu-Med-7B† | 20.0 | 64.3 | 32.6 | 75.2 | 64.2 | 76.0 | 81.2 | 77.9 |
| ClinFusion-8B | 20.0 | 64.3 | 32.6 | 77.6 | 62.8 | 72.6 | 89.1 | 81.3 |
| ClinFusion-8B + Agentic tools | 27.7 | 69.5 | 45.4 | 79.1 | 70.1 | 83.7 | 84.3 | 86.0 |
| — Models ¿ 10B — | ||||||||
| HealthGPT-14B | 11.3 | 39.8 | 25.7 | 68.0 | 63.4 | 66.2 | – | 80.2 |
| Lingshu-32B | 22.7 | 65.4 | 41.1 | 77.8 | 66.1 | 74.7 | – | 84.7 |
| HuatuoGPT-V-34B | 11.4 | 42.7 | 26.5 | 72.2 | 54.7 | 58.8 | – | 74.7 |
| MedDr-40B | 12.0 | 44.3 | 24.0 | 77.4 | 38.4 | 59.2 | – | 65.2 |
| Hulu-Med-14B | 23.2 | 68.5 | 37.7 | 79.8 | 70.4 | 78.1 | – | 83.3 |
| Hulu-Med-32B | 24.2 | 68.8 | 41.8 | 80.8 | 72.8 | 80.4 | – | 85.6 |
| MedGemma-27B-IT† | 15.8 | 56.8 | 31.4 | 75.4 | 64.7 | 71.4 | 73.1 | 80.7 |
| Lingshu-32B† | 22.2 | 65.3 | 41.4 | 77.4 | 65.6 | 73.4 | 89.6 | 84.5 |
| Hulu-Med-32B† | 19.8 | 67.5 | 38.0 | 78.8 | 68.5 | 77.1 | 87.0 | 83.7 |
| ClinFusion-32B | 26.7 | 74.8 | 41.8 | 78.8 | 70.7 | 82.4 | 93.8 | 87.9 |
| ClinFusion-32B + Agentic tools | 31.2 | 77.9 | 50.9 | 79.7 | 74.0 | 86.6 | 94.5 | 89.9 |
| AMOS | 3D-RAD | CT-Rate | AMOS Report | CT-Rate Report | |||||||
| Models | MCQ | MCQ | Open | MCQ | Open | Precision | Recall | F1 | Precision | Recall | F1 |
| Proprietary Models | |||||||||||
| GPT-5.2 | 63.8 | 67.1 | 37.6 | 66.9 | 59.1 | 29.9 | 11.5 | 14.5 | 21.0 | 12.7 | 14.1 |
| Gemini-3-Flash | 64.2 | 58.8 | 30.3 | 70.9 | 51.9 | 40.7 | 19.1 | 23.4 | 29.3 | 17.9 | 20.2 |
| Claude-Sonnet-4.5 | 62.6 | 58.5 | 30.0 | 73.2 | 51.7 | 12.8 | 6.49 | 7.35 | 15.5 | 11.8 | 12.3 |
| General-purpose MLLMs | |||||||||||
| Qwen2.5-VL-7B† | 53.4 | 40.8 | 28.6 | 67.3 | 44.5 | 6.31 | 4.18 | 4.69 | 10.6 | 9.42 | 9.61 |
| Qwen3-VL-8B† | 50.2 | 52.7 | 28.5 | 59.6 | 44.7 | 11.6 | 6.51 | 7.30 | 22.6 | 16.3 | 17.3 |
| Qwen2.5-VL-32B† | 55.8 | 46.4 | 24.0 | 64.0 | 53.1 | 6.55 | 4.09 | 4.57 | 16.9 | 13.7 | 14.2 |
| Qwen3-VL-32B† | 58.9 | 64.7 | 30.1 | 67.1 | 53.6 | 12.6 | 7.61 | 8.37 | 30.6 | 18.2 | 20.5 |
| Qwen3-VL-235B† | 57.1 | 47.7 | 28.9 | 62.3 | 50.9 | 14.6 | 7.25 | 8.53 | 21.6 | 16.1 | 16.9 |
| Medical MLLMs | |||||||||||
| — Models ¡ 10B — | |||||||||||
| MedGemma-1.5-4B-IT† | 57.1 | 38.1 | 23.4 | 75.6 | 54.8 | 14.4 | 6.53 | 7.74 | 13.6 | 10.5 | 11.0 |
| Lingshu-7B† | 61.7 | 68.4 | 18.0 | 70.7 | 48.9 | 7.96 | 4.35 | 5.04 | 11.1 | 9.61 | 9.86 |
| Hulu-Med-7B† | 65.7 | 73.5 | 33.2 | 77.6 | 50.2 | 17.5 | 9.18 | 10.7 | 27.4 | 16.0 | 18.3 |
| ClinFusion-8B | 80.2 | 79.1 | 35.7 | 86.3 | 64.1 | 20.1 | 10.7 | 12.0 | 28.8 | 20.5 | 21.6 |
| ClinFusion-8B + Agentic tools | 85.7 | 81.3 | 44.1 | 89.1 | 65.5 | 23.2 | 17.1 | 16.6 | 30.0 | 23.5 | 25.3 |
| — Models ¿ 10B — | |||||||||||
| MedGemma-27B-IT† | 54.3 | 36.7 | 25.1 | 72.4 | 45.4 | 11.6 | 6.00 | 7.07 | 13.2 | 10.2 | 10.7 |
| Lingshu-32B† | 63.8 | 70.2 | 25.3 | 70.1 | 50.0 | 9.65 | 6.41 | 7.10 | 15.3 | 11.5 | 12.2 |
| Hulu-Med-32B† | 73.9 | 79.6 | 37.6 | 83.3 | 56.9 | 22.5 | 9.97 | 12.5 | 34.4 | 21.4 | 23.4 |
| ClinFusion-32B | 81.7 | 79.1 | 36.2 | 89.0 | 62.1 | 26.7 | 13.7 | 16.1 | 34.5 | 21.4 | 23.9 |
| ClinFusion-32B + Agentic tools | 86.3 | 81.6 | 45.6 | 91.7 | 65.4 | 28.4 | 17.8 | 19.1 | 34.9 | 25.9 | 27.6 |
| Individual Metrics | Composite IF Scores | |||||||||||||
| Models | MCQ |
|
Open | Prognosis |
|
Seer | Treatment | MM-IF | Text-IF | Overall-IF | ||||
| Proprietary Models | ||||||||||||||
| GPT-5.2 | 100.0 | 100.0 | 87.0 | 100.0 | 84.0 | 100.0 | 100.0 | 92.0 | 100.0 | 96.0 | ||||
| Gemini-3-Flash | 98.0 | 100.0 | 100.0 | 98.9 | 97.0 | 83.0 | 97.0 | 98.9 | 94.3 | 96.6 | ||||
| Claude-Sonnet-4.5 | 73.5 | 76.0 | 90.0 | 96.2 | 80.0 | 100.0 | 100.0 | 86.0 | 87.0 | 86.5 | ||||
| General-purpose MLLMs | ||||||||||||||
| Qwen2.5-VL-7B† | 100.0 | 100.0 | 99.0 | 100.0 | 100.0 | 100.0 | 99.0 | 99.7 | 99.8 | 99.8 | ||||
| Qwen3-VL-8B† | 99.0 | 100.0 | 99.0 | 100.0 | 99.0 | 95.0 | 100.0 | 99.4 | 98.4 | 98.9 | ||||
| Qwen2.5-VL-32B† | 77.0 | 83.0 | 88.0 | 100.0 | 89.0 | 20.0 | 100.0 | 87.3 | 72.7 | 79.3 | ||||
| Qwen3-VL-32B† | 100.0 | 100.0 | 91.0 | 100.0 | 55.0 | 100.0 | 100.0 | 85.1 | 100.0 | 93.3 | ||||
| Qwen3-VL-235B† | 100.0 | 100.0 | 99.0 | 100.0 | 100.0 | 99.0 | 100.0 | 99.7 | 99.8 | 99.7 | ||||
| Medical MLLMs | ||||||||||||||
| — Models ¡ 10B — | ||||||||||||||
| MedGemma-1.5-4B-IT† | 50.5 | 21.0 | 97.0 | 3.8 | 0.0 | 0.0 | 0.0 | 49.9 | 8.9 | 27.4 | ||||
| Lingshu-7B† | 80.5 | 92.0 | 67.0 | 100.0 | 35.0 | 88.0 | 100.0 | 62.3 | 95.5 | 80.4 | ||||
| Hulu-Med-7B† | 99.0 | 100.0 | 100.0 | 98.9 | 96.0 | 69.0 | 100.0 | 98.9 | 92.0 | 95.1 | ||||
| ClinFusion-8B | 95.0 | 100.0 | 99.0 | 100.0 | 98.0 | 99.0 | 99.0 | 97.0 | 99.1 | 98.1 | ||||
| — Models ¿ 10B — | ||||||||||||||
| MedGemma-27B-IT† | 79.0 | 85.0 | 100.0 | 100.0 | 100.0 | 92.0 | 96.0 | 93.4 | 89.8 | 91.4 | ||||
| Lingshu-32B† | 82.5 | 100.0 | 73.0 | 100.0 | 31.0 | 100.0 | 91.0 | 61.7 | 99.8 | 82.6 | ||||
| Hulu-Med-32B† | 100.0 | 100.0 | 98.0 | 100.0 | 89.0 | 100.0 | 100.0 | 96.4 | 100.0 | 98.4 | ||||
| ClinFusion-32B | 100.0 | 100.0 | 91.0 | 100.0 | 100.0 | 100.0 | 100.0 | 97.5 | 100.0 | 98.9 | ||||
| Model | Setting | AMOS Report | CT Rate Report | CheXpert-Plus | IU-XRAY | ||||||||
| Precision | Recall | F1 | Precision | Recall | F1 | Precision | Recall | F1 | Precision | Recall | F1 | ||
| ClinFusion-8B | w/ Context | 20.1 | 10.7 | 12.0 | 28.8 | 20.5 | 21.6 | 46.4 | 35.3 | 37.8 | 63.3 | 55.8 | 57.3 |
| w/o Context | 0.89 | 0.39 | 0.46 | 7.99 | 3.68 | 4.71 | 13.1 | 10.7 | 10.8 | 10.6 | 8.43 | 8.87 | |
| Lingshu-7B | w/ Context | 7.96 | 4.35 | 5.04 | 11.1 | 9.61 | 9.86 | 26.2 | 17.8 | 19.9 | 43.7 | 39.3 | 40.4 |
| w/o Context | 0.17 | 0.12 | 0.13 | 5.83 | 4.92 | 4.91 | 11.1 | 8.58 | 8.94 | 10.7 | 8.10 | 8.76 | |
| Model | CheXpert-Plus | IU-XRAY | ||||||||||||
| RadGraph-F1 | LLM-as-a-Judge (Ours) | RadGraph-F1 | LLM-as-a-Judge (Ours) | |||||||||||
| Ent. F1 | Ent.-Rel. F1 | Prec. | Rec. | F1 | Ent. F1 | Ent.-Rel. F1 | Prec. | Rec. | F1 | |||||
| ClinFusion-8B | 23.2 | 21.0 | 46.4 | 35.3 | 37.8 | 38.7 | 36.6 | 63.3 | 55.8 | 57.3 | ||||
| Lingshu-7B | 20.0 | 17.9 | 26.2 | 17.8 | 19.9 | 35.1 | 34.6 | 43.7 | 39.3 | 40.4 | ||||
| Qwen3-VL-8B | 13.3 | 11.8 | 20.0 | 16.3 | 16.8 | 17.8 | 16.3 | 37.0 | 37.3 | 36.7 | ||||
| Qwen3-VL-8B (Long Output) | 20.6 | 18.8 | 13.8 | 18.9 | 15.1 | 34.7 | 33.0 | 29.4 | 42.1 | 33.6 | ||||
| Encoder Types | Fusion Mechanism | VQA-RAD | PMC-VQA | MedXQA | SLAKE | PathVQA | OMVQA | Average |
| Qwen ViT | - | 69.4 | 57.4 | 24.6 | 81.0 | 58.0 | 83.5 | 62.3 |
| Qwen ViT + DINOv2 | Local Cross-Attn (Ours) | 72.3 | 57.5 | 25.3 | 84.4 | 65.5 | 82.3 | 64.5 |
| Global Cross-Attn | 69.5 | 55.0 | 24.2 | 82.6 | 61.0 | 84.1 | 62.7 | |
| Mixture of Vision Experts | 70.0 | 55.2 | 24.2 | 81.1 | 63.3 | 83.2 | 62.8 | |
| Channel Concat | 70.5 | 54.4 | 24.7 | 83.4 | 63.2 | 82.3 | 63.1 |
| Additional Encoder | VQA Benchmarks | Report Generation | ||||||||
| VQA-RAD | PMC-VQA | MedXQA | SLAKE | PathVQA | OMVQA | Average | CheXpert-Plus | IU-XRAY | Average | |
| DINOv2 | 72.3 | 57.5 | 25.3 | 84.2 | 65.5 | 82.3 | 64.5 | 22.6 / 20.2 | 37.7 / 35.5 | 30.2 / 27.8 |
| ConvNext | 72.1 | 57.1 | 24.8 | 83.5 | 64.7 | 82.7 | 64.1 | 21.8 / 20.0 | 37.9 / 35.9 | 29.9 / 27.9 |
| Medsiglip | 70.7 | 57.8 | 25.9 | 83.5 | 66.9 | 84.2 | 64.8 | 23.1 / 20.9 | 34.6 / 32.3 | 28.9 / 26.6 |
| Fusion Mode | Additional Encoder 1 | Additional Encoder 2 | VQA Benchmarks | Report Generation | ||||||||
| VQA-RAD | PMC-VQA | MedXQA | SLAKE | PathVQA | OMVQA | Average | CheXpert-Plus | IU-XRAY | Average Report | |||
| Cascade | DINOv2 | ConvNext | 70.1 | 57.1 | 25.0 | 84.7 | 66.2 | 83.4 | 64.4 | 23.2 / 21.0 | 38.7 / 36.6 | 31.0 / 28.8 |
| ConvNext | DINOv2 | 70.3 | 54.8 | 26.2 | 84.2 | 66.5 | 84.2 | 64.4 | 20.2 / 17.9 | 39.2 / 37.4 | 29.7 / 27.6 | |
| DINOv2 | Medsiglip | 72.7 | 58.0 | 25.2 | 84.7 | 66.5 | 84.4 | 65.2 | 23.1 / 20.7 | 36.6 / 34.1 | 29.8 / 27.4 | |
| Medsiglip | DINOv2 | 69.0 | 53.6 | 25.5 | 84.6 | 68.0 | 85.9 | 64.4 | 22.4 / 20.0 | 35.1 / 32.5 | 28.8 / 26.3 | |
| Parallel | DINOv2 | ConvNext | 71.4 | 58.0 | 24.8 | 83.9 | 65.3 | 83.9 | 64.6 | 22.3 / 20.0 | 36.4 / 34.6 | 29.3 / 27.3 |
| Regularization | AMOS | 3D RAD | CT Rate | AMOS Report | CT Rate Report | Average | Average | ||||||
| MCQ | Open | MCQ | Open | MCQ | Precision | Recall | F1 | Precision | Recall | F1 | VQA | Report | |
| w/ 3D Encoder | 77.6 | 72.6 | 30.0 | 85.3 | 63.6 | 18.1 | 9.67 | 11.0 | 29.3 | 18.4 | 20.3 | 65.8 | 23.7 / 14.0 / 15.7 |
| w/o 3D Encoder | 75.8 | 76.3 | 26.4 | 79.1 | 56.4 | 12.1 | 6.82 | 7.86 | 27.0 | 13.4 | 15.5 | 62.8 | 19.6 / 10.3 / 11.7 |
| Regularization | AMOS | 3D RAD | CT Rate | AMOS Report | CT Rate Report | Average | Average | ||||||
| MCQ | Open | MCQ | Open | MCQ | Precision | Recall | F1 | Precision | Recall | F1 | VQA | Report | |
| Stochastic | 77.6 | 72.6 | 30.0 | 85.3 | 63.6 | 18.1 | 9.67 | 11.0 | 29.3 | 18.4 | 20.3 | 65.8 | 23.7 / 14.0 / 15.7 |
| Deterministic | 78.8 | 67.9 | 30.4 | 85.9 | 61.2 | 20.3 | 8.40 | 10.6 | 26.5 | 18.2 | 19.6 | 64.8 | 23.4 / 13.3 / 15.1 |