RSIBench-Data: Бенчмаркинг исследований, ориентированных на данные, для рекурсивного самосовершенствования
Аннотация
Рекурсивное самосовершенствование требует систем, способных преобразовывать данные о сбоях модели в более совершенные модели. Центральной частью этого процесса являются исследования в области пост-тренинга, ориентированные на данные: диагностика пробелов в возможностях, проектирование и валидация стратегии обучающих данных, а также обучение на основе обратной связи от чекпоинтов. Могут ли LLM агенты автоматизировать этот цикл совершенствования, ориентированный на данные? Существующие автоматизированные бенчмарки для пост-тренинга смешивают исследовательские решения с оптимизацией, обслуживанием, оценкой и реализацией системы, что затрудняет изоляцию исследовательских способностей агента. Чтобы заполнить этот пробел, мы представляем RSIBench-Data, контролируемый бенчмарк для оценки LLM агентов в качестве исследователей, ориентированных на данные, при фиксированном стеке пост-тренинга. В частности, от агентов требуется итеративно разрабатывать и пересматривать стратегии обучающих данных для фиксированной целевой модели, в то время как обучение и обслуживание используют общие сервисы на базе Tinker, официальная оценка проводится через E2B песочницы, оркестрируемые Harbor, а бюджеты ресурсов остаются фиксированными для всех агентов. Мы оцениваем четыре передовых агента по шести бенчмаркам, охватывающим разработку программного обеспечения, использование терминала, научные QA и математику. LLM агенты уже демонстрируют некоторые ключевые способности исследователей, ориентированных на данные: в 58,33% случаев они улучшают свою первую валидную попытку за счет уточнения стратегий обучающих данных на основе обратной связи. Однако они не демонстрируют последовательного улучшения на основе обратной связи: среди поисков, которые продолжаются после достижения своего лучшего наблюдаемого результата, 78,26% заканчиваются попыткой с более низким баллом, в то время как остальные лишь возвращаются к тому же пиковому значению. Таким образом, сильный кандидат может появиться в начале или середине выполнения задачи, даже если последующие итерации, основанные на обратной связи, не приводят к улучшению. Анализ траекторий выявляет четыре паттерна в более успешных запусках: точные гипотезы, супервизия на основе валидации, данные, соответствующие поведению, и сохранение сильных чекпоинтов. Эти результаты показывают, что текущие агенты могут совершать полезные исследовательские открытия, ориентированные на данные, но пока не могут последовательно преобразовывать обратную связь в улучшения. В целом, RSIBench-Data предоставляет измеримый и проверяемый испытательный стенд для изучения исследовательских возможностей, ориентированных на данные, которые необходимы для рекурсивного самосовершенствования. Мы открываем исходный код нашего проекта по адресу https://github.com/evolvent-ai/RSIBench-Data.
1 Введение
Рекурсивное самосовершенствование требует от системы ИИ многократного превращения данных об ошибках модели в эффективные улучшения модели. В последнее время LLM агенты все чаще оцениваются на задачах, требующих длительного взаимодействия с репозиториями программного обеспечения, терминалами и внешними инструментами (14; 19; 32). В отличие от статических задач типа «вход-выход», эти среды раскрывают промежуточные планы агента, вызовы инструментов, наблюдения, попытки восстановления и результаты верификаторов (10; 4; 5). Полученные траектории делают сбои хорошо наблюдаемыми, однако они остаются лишь свидетельствами поведения модели, а не опытом обучения, который может напрямую улучшить её (3). Чтобы устранить этот разрыв, недавние работы затрагивают различные части этого конвейера «от свидетельств к обучению» (8; 21; 24). SWE-Gym(21) и R2E-Gym (13) предоставляют исполняемые среды и обучающие ресурсы для агентов в области программной инженерии. DataComp (8) и DataComp-LM (18) изучают выбор данных в рамках контролируемого стека обучения. PostTrainBench (24) и Agent2 RL-Bench (6), напротив, оценивают более широкие автоматизированные системы пост-тренировки..
Эти парадигмы затрагивают более широкие вопросы, охватывающие выбор данных, построение среды и сквозное post-training, однако они не выделяют центральную исследовательскую проблему для рекурсивного самосовершенствования: могут ли LLM агенты надежно автоматизировать исследования в области data-centric post-training? В частности, для достижения этой цели агент должен сформулировать гипотезу об ошибке модели, превратить ее в исполняемые и проверяемые обучающие данные, а также пересмотреть стратегию синтеза на основе контролируемого обучения и обратной связи от оценки (21; 13). Мы называем LLM агента, который выполняет этот замкнутый процесс, data-centric researcher agent. Однако существующие бенчмарки переплетают исследовательские решения с оптимизацией, обслуживанием, оценкой и системной реализацией, что затрудняет выделение исследовательской способности агента (Рисунок 1(a)).
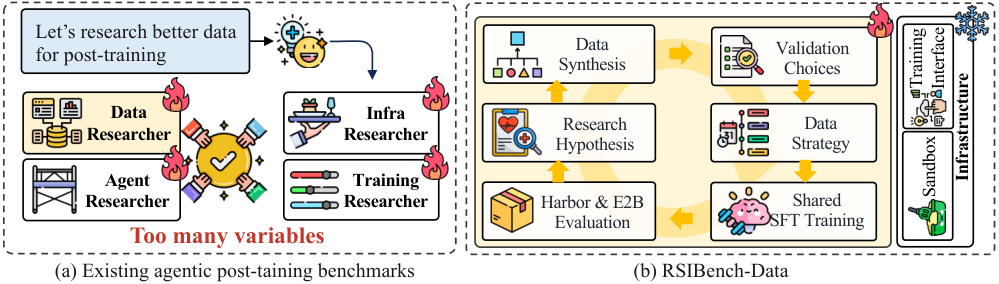
Чтобы устранить этот пробел, мы представляем RSIBench-Data, который изолирует ориентированный на данные исследовательский компонент рекурсивного самосовершенствования в рамках фиксированного окружения (Рисунок 1(b)). В частности, мы фиксируем базовую модель и ограниченный интерфейс обучения, предоставляем доступ к обучению и обслуживанию через общие службы Tinker, а также изолируем официальную оценку в «песочницах» E2B, управляемых Harbor, в рамках общего бюджета. Что еще более важно, RSIBench-Data оценивает итеративный процесс исследования данных для обучения, а не генерацию наборов данных на основе имитации. В каждом раунде агент решает, чему должна научиться целевая модель, разрабатывает и проверяет стратегию данных для обучения, обучает контрольную точку через общий LoRA SFT и использует контролируемую обратную связь по оценке для выбора следующей стратегии..
Наши результаты выявляют разрыв между способностью к открытиям и надежностью. На примере четырех передовых агентов и шести бенчмарков агенты улучшают свой первый валидный результат в 58,33% случаев за счет уточнения стратегий формирования обучающих данных на основе обратной связи. Этот результат показывает, что агенты уже демонстрируют некоторые ключевые возможности исследователей, ориентированных на данные. Однако эти достижения зависят от конкретной задачи и являются нестабильными. Ни один агент не доминирует последовательно: Codex gpt-5.6-sol лидирует в трех бенчмарках, не относящихся к SWE, но в трех задачах типа SWE побеждают три разных агента. Более того, агенты не демонстрируют последовательного улучшения на основе обратной связи: среди поисковых процессов, которые продолжаются после достижения наилучшего наблюдаемого результата, 78,26% завершаются с более низким итоговым показателем, в то время как остальные лишь возвращаются к прежнему пиковому значению. Таким образом, ранняя или промежуточная попытка может оставаться наиболее эффективной даже после того, как агент получает дополнительную обратную связь и пересматривает свою стратегию. Поэтапные записи выявляют повторяющиеся сбои: агенты неверно диагностируют целевые возможности, генерируют несогласованное обучение, пропускают сильные контрольные точки или не могут преобразовать новую обратную связь в более эффективную стратегию формирования обучающих данных..
В целом, наш вклад состоит из трех аспектов::
- ⟦• Новая цель оценки: ориентированные на данные исследования для рекурсивного самосовершенствования. Мы формулируем синтез данных после обучения как автоматизируемый исследовательский цикл, в котором LLM агент формирует гипотезы о возможностях, разрабатывает и проверяет стратегии обучающих данных, учится на основе контрольных точек и управляет выбором кандидатов в рамках фиксированного бюджета.
- ⟦• Контролируемый бенчмарк для исследовательских агентов, ориентированных на данные. Мы представляем RSIBench-Data с общим обучением и обслуживанием Tinker, а также официальной оценкой через «песочницы» Harbor и E2B. Эти границы делают эксперименты проверяемыми и отделяют изменения инфраструктуры от прогресса в исследованиях..
- ⟦• Эмпирические данные: способности исследователя проявляются, но остаются хрупкими. Агенты показывают улучшение при первой успешной попытке в 58.33% случаев, однако среди поисковых процессов, продолжающихся после достижения пика, 78.26% завершаются попыткой с более низким баллом, а остальные лишь возвращаются к этому пику. Такая немонотонность показывает, что агенты не всегда преобразуют обратную связь в более эффективные стратегии формирования обучающих данных. Более успешные запуски характеризуются точными гипотезами, контролем на основе валидации, данными, соответствующими целевому поведению, и сохранением контрольных точек..
2 Родственные работы
| Data-Synthesis Research | Closed-loop Evolution | Controlled Infrastructure | ||||
| Benchmark | Executable Experience Synthesis | Reusable Data- Synthesis Policy | Capability-gap Diagnosis | Feedback-driven Revision | Train/Eval Data Isolation | Service-isolated Train/Serve/Eval |
| DataComp | ✗ | ✗ | ✗ | ✗ | ✗ | ✗ |
| DataComp-LM | ✗ | ✗ | ✗ | ✗ | ✗ | ✗ |
| AgoraBench | ✗ | ✗ | ✗ | ✗ | ✗ | ✗ |
| DCA-Bench | ✗ | ✗ | ✗ | ✗ | ✗ | ✗ |
| DataEnvGym | ✗ | ✗ | ✓ | ✓ | ✗ | ✗ |
| Curation-Bench | ✗ | ✗ | ✗ | ✓ | ✗ | ✗ |
| PostTrainBench | ✗ | ✗ | ✓ | ✓ | ✗ | ✗ |
| Agent2 RL-Bench | ✓ | ✗ | ✗ | ✗ | ✗ | ✗ |
| RSIBench-Data (ours) | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
Бенчмарки для курирования и генерации данных.
Ранние ориентированные на данные бенчмарки контролируют окружающий стек обучения, чтобы изучить, какие примеры следует отобрать или подготовить из фиксированного корпуса (8; 18). Чтобы выйти за рамки предоставленного пула кандидатов, последующие работы оценивают сгенерированные наборы данных или способность агентов диагностировать скрытые дефекты данных (17; 12). DataEnvGym и Curation-Bench наиболее близки к нашей среде с замкнутым циклом: они внедряют обратную связь от студенческой модели или бенчмарка, чтобы агенты могли адаптировать учебные планы и стратегии подготовки данных на разных этапах (16; 15). RSIBench-Data развивает это направление, оценивая одного агента-исследователя, который владеет гипотезой синтеза данных и процессом пересмотра, в то время как внешний цикл обучения и оценки остается фиксированным..
Рекурсивное самосовершенствование и обучение агентов.
Чтобы решить проблему нехватки обоснованного опыта обучения для агентов, использующих инструменты, в ранних работах (27; 30) собираются траектории взаимодействия или предоставляются исполняемые среды для генерации такого опыта (21; 13). Опираясь на эти ресурсы, современные системы (9; 29; 26) автоматизируют получение опыта, используя исследование знаний, исторические следы выполнения или самостоятельно сгенерированные взаимодействия для формирования контроля и улучшения агента на протяжении нескольких раундов (11; 35). Эти системы, управляемые обратной связью, предоставляют механизмы, имеющие отношение к рекурсивному самосовершенствованию, но, как правило, оценивают конкретный метод, а не сравнивают, как различные LLM агенты выполняют одну и ту же роль исследователя, ориентированного на данные, в контролируемых экспериментальных сервисах. RSIBench-Data, напротив, изолирует компонент исследования, ориентированного на данные, с помощью которого агент-исследователь передового уровня улучшает отдельную целевую модель.
Автоматизированное пост-обучение и агентная оценка.
Автоматизированные бенчмарки для post-training проверяют, могут ли агенты улучшать другие модели, получая контроль над данными, оптимизацией, гиперпараметрами и реализацией (24; 6). Дополнительные исследования изучают устойчивую эволюцию мультиагентных систем, разрабатывают новые оценки, устойчивые к загрязнению данных, и предоставляют цели для долгосрочных задач SWE, работы в терминале и использования инструментов (22; 2; 34; 14; 19; 32). В совокупности эти бенчмарки измеряют, улучшается ли система end-to-end и достигает ли успеха итоговая модель, однако их широкий охват затрудняет оценку вклада исследовательских решений, ориентированных на данные..
Существующие бенчмарки делают фундаментальный выбор: одни изолируют отдельные операции с данными, в то время как другие предоставляют агентам широкий контроль над стеком post-training. RSIBench-Data занимает промежуточное положение: он оценивает, может ли LLM агент выступать в роли исследователя, ориентированного на данные, в то время как окружающий стек обучения, обслуживания и официальной оценки остается неизменным (Table 1). Вместо того чтобы оценивать только итоговый checkpoint, он фиксирует гипотезы, стратегии обучения на данных, основанные на обратной связи доработки и выбор checkpoint, которые к нему приводят. Общее обучение и обслуживание Tinker, а также фиксированная оценка Harbor–E2B делают этот исследовательский процесс проверяемым..
3 RSIBench-Data: Задача и протокол оценки
Традиционные оценки генерации данных задаются вопросом, может ли система создать полезный набор данных или контрольную точку. RSIBench-Data ставит исследовательский вопрос, центральный для рекурсивного самосовершенствования: может ли LLM агент сформировать полезную гипотезу о фиксированной модели, разработать стратегию целевых обучающих данных, интерпретировать свидетельства контрольных точек и сохранить свой лучший результат в рамках ограниченного бюджета?
3.1 Постановка задачи
Мы оцениваем исследовательские способности, ориентированные на данные, посредством финальной контрольной точки и экспериментального процесса, который ее формирует. Мы изучаем ограниченную кросс-моделевую среду, в которой агент-исследователь передового уровня итеративно улучшает отдельную целевую модель посредством пост-тренировки, ориентированной на данные. Производительность официальной контрольной точки остается основным результатом; записанный процесс поддерживает атрибуцию и диагностику, а не отдельную субъективную оценку. Опыт обучения включает примеры, исполняемые задачи и состояния, траектории использования инструментов и контроль, основанный на верификаторах. Формально, при заданной фиксированной базовой модели , данных бенчмарка и бюджетных ресурсах , исследовательская политика наблюдает и историю своих попыток , после чего предлагает данные для обучения и разрешенную конфигурацию обучения ⟧:
| (1) |
Каждый оценивается фиксированной службой оценки, формирующей разрешенную обратную связь по выбору , такую как баллы, траектории, результаты верификатора и диагностика выполнения. Предложения и обратная связь формируют , которые агент использует для внесения правок или остановки в рамках бюджета .
После реализованных попыток агент выбирает контрольную точку , используя только , до наблюдения официальных результатов. Затем оценщик проверяет её в новых средах задач без дополнительного обучения. Мы сообщаем об официальной производительности и, во вторую очередь, об улучшении по сравнению с фиксированной базовой моделью:
| (2) |
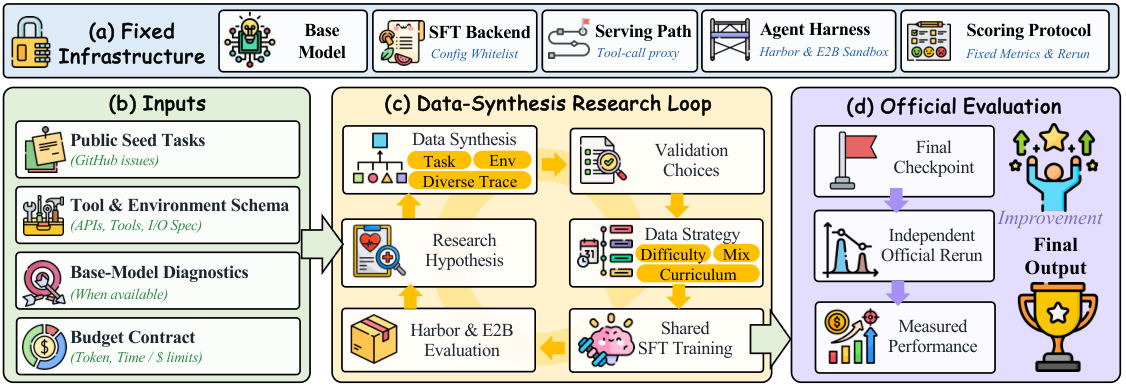
Два разделения поддерживают атрибуцию: агенты модифицируют опыт обучения через ограниченный интерфейс, но не через окружающий стек, и используют обратную связь отбора, а не официальные результаты, для итерации и выбора контрольных точек. Эти разделения реализованы посредством фиксированной инфраструктуры, входных данных для бенчмарков, исследовательского процесса синтеза данных с замкнутым циклом и отдельной официальной оценки (Рисунок 2⟧).
3.2 Фиксированная инфраструктура
RSIBench-Data фиксирует инфраструктуру, которая превращает стратегию обучающих данных в оцениваемую контрольную точку, благодаря чему агент-исследователь работает внутри фиксированных границ, а не во всем стеке post-training. Внутри этих границ агент решает, какой обучающий опыт сформировать и, через ограниченный интерфейс конфигурации, как представить его для обучения. Снаружи базовые модели, оптимизатор, путь обслуживания, песочница для оценки, верификатор и правило подсчета баллов являются фиксированными и общими для каждого агента: агент отправляет артефакты обучения, а не код обучения, и не может заменить ни один компонент окружающего стека..
Таким образом, каждая попытка следует по одному и тому же пути: от представленных данных до оцененной контрольной точки. В каждом раунде агент отправляет супервизию в формате сообщений вместе с конфигурацией обучения из белого списка. Исполнитель проверяет эти артефакты и вызывает тот же бэкенд LoRA SFT на базе Tinker из фиксированной базовой модели, а полученная контрольная точка обслуживается через тот же интерфейс сэмплера, который использует оценщик для запросов к ней. Затем выполнение делегируется Harbor в изолированных средах E2B через фиксированную границу сервиса, которая владеет средой бенчмарка, исполнителем, верификатором и правилом подсчета баллов, и возвращает агенту контролируемые доказательства. Оптимизация, обслуживание и оценка, таким образом, идентичны для всех агентов, в то время как распределение представленных данных и конфигурация внутри белого списка могут варьироваться..
Поскольку подача данных, обучение, обслуживание и оценка проходят через эту границу, каждая попытка оставляет структурированную запись, которая связывает стратегию обучающих данных с контрольной точкой и поведением при оценке. Это делает цикл проверяемым: мы можем проанализировать, почему выполнение улучшается или регрессирует, и приписать различия в производительности политике исследования обучающих данных агента, а не изменениям в стеке post-training..
3.3 Входные данные агентов и ограничения на использование данных
Каждый агент получает описание целевого бенчмарка, критерии успеха, соответствующие задачам публичные исходные репозитории или исходные примеры, схемы инструментов и среды, доступную диагностику базовой модели и бюджет ресурсов. Эти входные данные формируют без предоставления готового обучающего корпуса (Рисунок 2(b)). Исходные репозитории обеспечивают реалистичную структуру задач и эталон для целевого распределения: без такого обоснования синтез может свестись к простым примерам на основе правил, которые оторваны от реальных задач и обходят предполагаемую исследовательскую проблему..
Не вся информация, доступная агенту, может быть включена в . Каждый бенчмарк определяет, какие сиды и публичные источники могут использоваться для построения данных; задачи, предназначенные только для оценки, метки, траектории и другие защищенные материалы бенчмарков не могут использоваться в качестве обучающего сигнала. Такое разделение позволяет агенту диагностировать сбои без преобразования оценочной информации в обучающие данные..
3.4 Исследование синтеза данных с замкнутым циклом
RSIBench-Data фиксирует только внешнюю последовательность и границы обслуживания бюджетного цикла: агент синтезирует и отправляет данные, бенчмарк обучает контрольную точку через общую службу SFT, а фиксированный изолированный оценщик возвращает разрешенные сигналы (Рисунок 2(c)). Фильтрация, верификация, проектирование учебной программы, смешивание данных, атрибуция сбоев и решение о продолжении поиска не являются предписанными этапами бенчмарка; это варианты выбора, доступные для политики синтеза данных агента-исследователя. Бюджет ограничивает общие ресурсы, в то время как агент решает, как обратная связь от обучения и оценки должна изменить следующую стратегию обучения на данных. Приложение B описывает репрезентативные стратегии, а не обязательные фазы..
Синтез данных.
В рамках каждого раунда агент может выбирать источники данных, построение задач и среды, представление траекторий, правила фильтрации, методы верификации, учебные программы по сложности, смеси данных и параметры обучения. Бенчмарк не требует фиксированного предварительного диагноза и не предписывает внутренний порядок для этих операций; он требует лишь того, чтобы представленные артефакты удовлетворяли контракту данных и могли быть обработаны общим интерфейсом SFT. После обучения и оценки агент решает, продолжать ли работу и как развивать свою стратегию подготовки данных для следующего этапа..
Совместное SFT обучение.
Бенчмарк проверяет представленные артефакты и конфигурацию, а затем обучает LoRA чекпоинт из через общий SFT бэкенд. Все агенты используют одну и ту же реализацию обучения и одинаковый ограниченный интерфейс конфигурации. Это преобразует каждое предложенное распределение обучения в чекпоинт, не позволяя агенту заменить бэкенд оптимизации или иным образом перепроектировать стек обучения..
Оценка Harbor и E2B.
Контрольная точка запрашивается через фиксированный путь обслуживания и оценивается Harbor в изолированных средах E2B с использованием официального верификатора и протокола оценки. Сервис возвращает оценку разрешенного выбора вместе с траекториями задач, результатами верификатора, ошибками выполнения и инфраструктуры, использованием токенов, стоимостью обучения и выборки, а также затраченным временем. Поскольку оценка является фиксированной, эти сигналы предоставляют сопоставимые доказательства относительно представленной стратегии данных для обучения..
3.5 Финальная контрольная точка и официальная оценка
После завершения своих попыток агент выбирает одну контрольную точку из тех, что он создал. Мы оцениваем выбранную контрольную точку на тестовом наборе целевого бенчмарка, используя фиксированный протокол оценки, и сообщаем полученную производительность в качестве итогового балла агента..
4 Экспериментальная установка
Для изоляции исследовательских возможностей, ориентированных на данные, мы создаем контролируемую матрицу: агент-исследователь и целевой бенчмарк варьируются, в то время как целевая модель, ограниченный интерфейс обучения, сервисы оценки и бюджет на один запуск остаются неизменными..
4.1 Агенты-исследователи
Мы оцениваем четыре передовых LLM-агента исследователя в основной матрице бенчмарков: Claude Code (1) с Opus-4.8 и Sonnet-5, а также Codex (20) с gpt-5.6-sol и gpt-5.6-terra. Агенты Claude Code работают с высоким уровнем усилий на рассуждение, в то время как агенты Codex работают с максимальным уровнем усилий на рассуждение; все агенты получают одинаковый интерфейс задач, ограничения на использование данных и бюджет. Во всех экспериментах Claude Opus 4.8 зафиксирован как внешняя модель развертывания для генерации цепочек рассуждений, последовательностей использования инструментов или полных траекторий. Агенты отправляют обучающие данные вместе с конфигурацией из белого списка ; таким образом, наши сравнения оценивают data-centric исследования через общий ограниченный интерфейс раздела 3, а не только данные в рамках полностью фиксированного рецепта обучения. Мы отдельно включаем сравнение высокого и максимального уровней усилий на рассуждение для одной настройки Claude Code Sonnet-5 в разделе 5.4⟧.
4.2 Общий конвейер обучения
Каждая попытка обучает LoRA-адаптированную контрольную точку Qwen/Qwen3.5-35B-A3B-Base (23) через общий бэкенд Tinker SFT (28)11 1 https://github.com/thinking-machines-lab/tinker.. Служба оценки, управляемая Harbor, выполняет каждую контрольную точку в песочницах E2B и возвращает контролируемые доказательства, используемые для последующих исследовательских решений и выбора контрольной точки. Затем выбранная контрольная точка оценивается без дополнительного обучения через ту же фиксированную границу службы22 2 https://github.com/e2b-dev.. Каждый основной запуск имеет номинальный бюджет реального времени 16 часов и бюджет Tinker в размере $500..
4.3 Бенчмарки и оценка
Мы выбираем шесть бенчмарков, охватывающих различные режимы обучающего опыта. Три варианта SWE-bench — Verified (14), Multilingual (33) и Pro (7) — требуют контроля на основе репозитория для модификации кода и выполнения задач. Terminal-Bench 2.0 (19) делает упор на использование инструментов с долгосрочным горизонтом планирования и верификацию, в то время как GPQA Diamond (25) и AIME 202633 3 https://huggingface.co/datasets/MathArena/aime_2026 делают упор на проверяемые рассуждения и контроль сложности..
Для каждого бенчмарка все агенты используют одинаковое подмножество для оценки, среду выполнения, верификатор и параметры. Варианты SWE-bench используют Mini-SWE-Agent (31)44 4 https://github.com/SWE-agent/mini-swe-agent., в то время как остальные бенчмарки используют Terminus-2 (19). Три варианта SWE-bench и GPQA Diamond используют фиксированные подмножества из 100 примеров; Terminal-Bench 2.0 и AIME 2026 используют свои полные наборы, с четырьмя запусками декодирования для каждой задачи AIME. Гиперпараметры оценки, включая temperature, соответствуют официальным настройкам каждого бенчмарка. В приложении A представлен полный набор средств оценки и публичные репозитории с начальными данными, доступные для агентов-исследователей..
Основным результатом является официальный балл выбранной контрольной точки в нативных бенчмарках. Вторичные анализы отслеживают улучшение относительно фиксированной базовой модели, траектории выбора внутри прогона, первые и лучшие кандидаты, стоимость обучения и выборки, а также затраченное реальное время..
5 Результаты и анализ
5.1 Основные результаты
RSIBench-Data раскрывает две стороны автономных исследований, ориентированных на данные. Во-первых, итерации могут приводить к подлинным открытиям: последующие кандидаты превосходят первого валидного кандидата в 14 из 24 сценариев. Во-вторых, агенты не всегда преобразуют последующую обратную связь в дальнейшие улучшения: из 23 сценариев, которые продолжаются после достижения наблюдаемого пика, 18 завершаются с финальным кандидатом, который хуже их исторического максимума, и только в 5 случаях удается вернуться к тому же пику. Выбор контрольной точки с историческим максимумом позволяет сохранить более раннее открытие, несмотря на последующие регрессии, однако траектории все равно показывают, что пересмотры на основе обратной связи часто не способны обновить границу возможностей кандидатов. Поэтому мы анализируем бенчмарк в три этапа: официальная производительность в зависимости от задачи, согласованность и эффективность улучшений на основе обратной связи, а также исследовательские решения, связанные с более сильными траекториями..
Анализ производительности.
Официальные баллы и профили ресурсов для каждой настройки агент–бенчмарк сведены в Таблицу 2. Каждый балл получен в результате заранее определенного репрезентативного запуска. Производительность остается низкой в ряде исполняемых задач: лучший агент достигает лишь 9,00% в SWE-bench Pro, 22,00% в SWE-bench Multilingual и 20,22% в Terminal-Bench 2.0. Эти построчные потолки указывают на общую слабость современных исследовательских агентов. Некоторые обученные чекпоинты также не показывают улучшения по сравнению с базовой моделью, особенно в GPQA Diamond и SWE-bench Multilingual, что демонстрирует, что стратегии работы с обучающими данными могут быть как нейтральными или вредными, так и полезными. В то же время ни один исследовательский агент не доминирует во всем наборе. Claude Code Opus-4.8 лидирует в SWE-bench Verified, Claude Code Sonnet-5 в SWE-bench Multilingual, а Codex gpt-5.6-sol в SWE-bench Pro, GPQA Diamond, AIME 2026 и Terminal-Bench 2.0. Три задачи в стиле SWE по-прежнему выигрываются тремя разными агентами, что показывает, что широкое сходство семейств задач не приводит к стабильному ранжированию. Среди четырех обученных агентов разброс от лучшего к худшему дополнительно подтверждает силу этого взаимодействия: он составляет 8,00 процентных пункта в SWE-bench Pro, 13,00 в GPQA Diamond и SWE-bench Verified, 14,60 в Terminal-Bench 2.0, 17,00 в SWE-bench Multilingual и 20,00 в AIME 2026. Поскольку каждый запуск использует одну и ту же целевую модель и ограниченный интерфейс, эти разрывы отражают взаимодействие между политикой исследовательского агента и структурой бенчмарка, а не вариативность целевой модели или стека оценки..
| Benchmark | Agent | Official | Time (h) | Tinker cost ($) |
|---|---|---|---|---|
| SWE-bench Verified | Base model | 12.00% | – | – |
| Claude Code Opus-4.8 | 46.00% | 10.21 | 195.90 | |
| Claude Code Sonnet-5 | 35.00% | 14.91 | 181.70 | |
| Codex gpt-5.6-sol | 33.00% | 4.41 | 55.61 | |
| Codex gpt-5.6-terra | 42.00% | 2.80 | 59.79 | |
| SWE-bench Multilingual | Base model | 7.00% | – | – |
| Claude Code Opus-4.8 | 5.00% | 12.68 | 195.70 | |
| Claude Code Sonnet-5 | 22.00% | 14.20 | 363.77 | |
| Codex gpt-5.6-sol | 15.00% | 5.99 | 78.64 | |
| Codex gpt-5.6-terra | 6.00% | 5.18 | 56.87 | |
| SWE-bench Pro | Base model | 0.00% | – | – |
| Claude Code Opus-4.8 | 2.00% | 2.19 | 17.54 | |
| Claude Code Sonnet-5 | 4.00% | 9.54 | 45.63 | |
| Codex gpt-5.6-sol | 9.00% | 11.61 | 300.49 | |
| Codex gpt-5.6-terra | 1.00% | 3.85 | 34.39 | |
| GPQA Diamond | Base model | 61.00% | – | – |
| Claude Code Opus-4.8 | 56.00% | 5.98 | 27.92 | |
| Claude Code Sonnet-5 | 52.00% | 6.43 | 16.03 | |
| Codex gpt-5.6-sol | 65.00% | 2.42 | 10.37 | |
| Codex gpt-5.6-terra | 64.00% | 1.14 | 4.80 | |
| AIME 2026 | Base model | 30.00% | – | – |
| Claude Code Opus-4.8 | 40.83% | 4.89 | 61.36 | |
| Claude Code Sonnet-5 | 49.17% | 9.29 | 121.21 | |
| Codex gpt-5.6-sol | 53.33% | 8.90 | 63.65 | |
| Codex gpt-5.6-terra | 33.33% | 1.85 | 8.50 | |
| Terminal-Bench 2.0 | Base model | 1.12% | – | – |
| Claude Code Opus-4.8 | 10.11% | 8.99 | 175.63 | |
| Claude Code Sonnet-5 | 5.62% | 8.87 | 156.93 | |
| Codex gpt-5.6-sol | 20.22% | 9.56 | 69.07 | |
| Codex gpt-5.6-terra | 12.36% | 6.67 | 186.96 |
Анализ ресурсов.
Столбцы ресурсов показывают, что высокие официальные баллы достигаются при неравномерных затратах. Для 24 основных запусков медианное общее время выполнения составляет 6,55 часа, а медианная стоимость Tinker для валидных кандидатов — 62,51 доллара, однако разброс велик: время варьируется от 1,14 до 14,91 часа, а стоимость валидных кандидатов — от 4,80 до 363,77 доллара. Некоторые запуски с высокими баллами сравнительно недороги. Codex gpt-5.6-sol достигает 65,00% на GPQA Diamond за 2,42 часа при стоимости Tinker 10,37 доллара, а Codex gpt-5.6-terra достигает 64,00% на том же бенчмарке за 1,14 часа при стоимости 4,80 доллара. Другие конфигурации потребляют гораздо больше бюджета при скромных или слабых результатах: Claude Code Sonnet-5 на Terminal-Bench 2.0 использует 8,87 часа и 156,93 доллара, но набирает 5,62%, в то время как Codex gpt-5.6-sol на SWE-bench Pro тратит 300,49 доллара для достижения 9,00%. Эти контрасты показывают, что официальный балл следует интерпретировать вместе со временем поиска и стоимостью обучения..
5.2 Итеративная эволюция и отбор кандидатов
Итерация улучшает границу кандидатов в большинстве случаев.
Итоговая официальная оценка оценивает только выбранную контрольную точку и, следовательно, не показывает, улучшила ли итеративная обратная связь первого валидного кандидата агента. Поэтому мы сравниваем первого и лучшего валидных кандидатов в 24 настройках с валидными официальными оценками, исключая неудачные попытки и попытки без оценок выбора. Мы оцениваем всех кандидатов в рамках одного запуска, используя тот же протокол выбора. Более поздний кандидат превосходит первого в 14 из 24 настроек, тогда как в остальных 10 настройках первый кандидат остается лучшим. Таким образом, итеративная обратная связь часто помогает агентам обнаружить более сильного кандидата, но не в каждой настройке (Рисунок 3). Официальная оценка проводится отдельно для выбранной контрольной точки..
Улучшение на основе обратной связи редко бывает монотонным.
Из 23 настроек, которые продолжают работу после первого достижения своего лучшего показателя отбора, 18 завершаются с финальным кандидатом, чей результат ниже этого пика, а оставшиеся 5 лишь возвращаются к нему. Эта статистика описывает последовательность опробованных кандидатов, а не окончательно представленную контрольную точку: отбор по историческому максимуму позволяет сохранить более ранний пик, даже если последующие попытки имеют более низкие баллы. Результат же показывает, что агенты не всегда преобразуют дополнительную обратную связь в более эффективные стратегии формирования обучающих данных. В некоторых настройках первый кандидат остается сильнейшим; в других за промежуточным улучшением следуют более слабые доработки. Отбор по историческому максимуму смягчает влияние таких регрессий на итоговую работу, в то время как эффективная остановка и пересмотр стратегии остаются необходимыми для результативного поиска..
Ценность и скорость итерации сильно зависят от ⟦K0⟧ бенчмарков..
Чтобы разграничить, где итерация помогает и как быстро она это делает, мы сравниваем прирост от первой до лучшей попытки и время достижения пика. AIME 2026 показывает улучшение для трех из четырех агентов со средним приростом в 25,42 процентных пункта: Claude Code Sonnet-5 остается ниже 15,00% в течение восьми валидных попыток, прежде чем подскочить до 55,00% и достичь пика на отметке 55,83%, тогда как первый кандидат Codex gpt-5.6-terra уже является лучшим. GPQA Diamond начинается с более сильной границы (56,00%–65,00%) и прибавляет лишь 4,00 пункта в медиане, несмотря на то, что все четыре агента обновляют свой результат первого кандидата. Таким образом, ценность итерации отражает как доступный запас для роста, так и то, насколько эффективно агент преобразует обратную связь в новую стратегию обучающих данных..
Широкие семейства задач не определяют общую траекторию эволюции.
Чтобы проверить, вызывают ли семейства задач общую динамику поиска, мы сравниваем три профиля в стиле SWE и все четыре агента на Terminal-Bench 2.0. SWE-bench Verified показывает улучшение для одного агента, SWE-bench Multilingual — для двух, а SWE-bench Pro накапливает прирост только для Codex gpt-5.6-sol. На Terminal-Bench 2.0 показатель Claude Code Sonnet-5 улучшается с 4,49% до 7,87%, Codex gpt-5.6-sol восстанавливается после первоначальной неудачной попытки и вырастает с 7,87% до 15,73%, прежде чем упасть до 13,48%, Codex gpt-5.6-terra улучшается с 12,36% до плато в 14,61%, а Claude Code Opus-4.8 достигает пика сразу на отметке 5,62%. Эти различия делают взаимодействие агента и бенчмарка, а не метку семейства, релевантной единицей анализа..
5.3 Использование бюджета и эффективность поиска
Схожие итоговые оценки могут требовать существенно различающихся затрат на поиск.
Агенты существенно различаются по объему используемого поиска. В 24 конфигурациях медианное количество валидных кандидатов за прогон составляет 4,5 (диапазон: 2–15), стоимость — (–), а время выполнения — 6,55 часа (1,14–14,91). Таким образом, итоговая оценка сама по себе не измеряет эффективность: два прогона могут достичь схожих результатов, даже если один из них требует значительно больше времени и затрат. На рисунке 4 сравнивается оценка выбора каждого кандидата с совокупной стоимостью Tinker, понесенной до этой попытки, и выделяются кандидаты, которые устанавливают новый лучший результат в рамках прогона..
Продуктивный поиск может обернуться дорогостоящей регрессией после достижения пика.
Чтобы проверить, остаются ли ранние достижения на границе продуктивными, мы исследуем завершенные траектории Terminal-Bench 2.0 до и после их лучшего кандидата. Codex gpt-5.6-sol сначала восстанавливается после неудачной попытки, улучшая результат с 7.87% до 15.73% при совокупных затратах $45.28, а затем падает до 13.48% после достижения $69.07; тем не менее, выбранная им контрольная точка официально достигает 20.22% с наименьшими затратами Tinker на валидного кандидата среди четырех запусков Terminal-Bench. Claude Code Sonnet-5 улучшается с 4.49% до 7.87% при затратах $75.16, но тратит еще $81.77 без обновления границы и получает официальный балл 5.62%, в то время как Codex gpt-5.6-terra достигает плато выбора в 14.61% при затратах $90.23, а затем тратит еще $96.74 для получения официального балла 12.36%. Таким образом, поиск может обнаружить лучших кандидатов, однако продолжение расходов после достижения пика может не привести к обновлению границы, а более высокая стоимость не обязательно означает более сильную финальную контрольную точку..
Выбор контрольной точки сам по себе является решением в пользу эффективности.
Чтобы отделить эффективное обнаружение от эффективного развертывания, мы сравниваем выбранную контрольную точку с исторически лучшим показателем отбора. В 12 конфигурациях GPQA, AIME и Terminal-Bench каждый запуск выбирает контрольную точку, которая достигает своего лучшего наблюдаемого показателя отбора, поэтому правило отбора на этапе разработки не упускает измеренную границу. Тем не менее, пиковые значения отбора отличаются от официальных оценок в среднем на 3,89 процентных пункта: Claude Code Sonnet-5 на GPQA падает с пика отбора 64,00% до 52,00% официально, в то время как Codex gpt-5.6-sol на AIME поднимается с 48,33% до 53,33%, а Codex gpt-5.6-sol на Terminal-Bench поднимается с 15,73% до 20,22%. Траектории далее показывают, что дисциплина отбора может сэкономить значительные расходы после достижения пика: запуски Terminal-Bench тратят от $23,79 до $96,74 после первого достижения своего лучшего показателя отбора без его улучшения. Эти случаи показывают, что остановка и выбор контрольной точки определяют, преобразуются ли расходы на поиск в лучшую обнаруженную модель..
5.4 Анализ механизмов
Анализ механизмов связывает изменения оценок с конкретными исследовательскими решениями по синтезу данных..
Чтобы выйти за рамки сравнения итоговых оценок, мы кодируем каждую попытку в соответствии с выявленным пробелом в возможностях, источником данных, сигналом валидации и надзором, сохраняя при этом неизменными стек обучения и оценки. Мы сравниваем эти решения с выбором и официальными оценками, чтобы определить механизмы для разных случаев в таблице 3. В приложении B.6 представлены полные траектории и анализ на уровне отдельных случаев..
| Mechanism | Observation | Implication for researcher agents |
|---|---|---|
| Diagnose the real capability gap | Claude Code Sonnet-5 on AIME stays below 15.00% for eight valid attempts before jumping to 55.00% and then 55.83%. | Agents should recognize when local revisions are not changing the effective data strategy and search for a qualitatively different capability hypothesis. |
| Embed validation signals | AIME uses answer-agreement filtering, SWE-bench Pro uses environment-successful trajectories, and Terminal-Bench 2.0 uses sandbox execution with explicit task outcomes. | Agents should use executable or decidable checks rather than relying only on model self-judgment. |
| Match supervision to target behavior | Real submit behavior improves SWE-bench Pro; on Verified, final-action data reaches a 39.00% selection score while all-turn and safe variants reach 8.00% and 9.00%; Terminal-Bench 2.0 improves for Codex gpt-5.6-sol after a more focused candidate but regresses after a later stop-oriented modification. | Supervision granularity and action source are data-design variables, although training changes prevent a single-factor claim. |
| Preserve historical best candidates | Claude Code Sonnet-5 on AIME reaches its first 55.83% peak at the tenth valid candidate and later returns to but does not exceed it; Codex gpt-5.6-sol on SWE-bench Pro peaks at the ninth attempted round; Codex gpt-5.6-sol on Terminal-Bench peaks at its second valid candidate before regressing. | Agents need both continued search and explicit stop or rollback policies. |
| Reasoning effort changes search depth and resource allocation | On SWE-bench Verified with Claude Code Sonnet-5, max effort improves the first candidate from 25% to 36%, the best selection score from 44% to 49%, and the official score from 35% to 52%. | Effort should be analyzed as a research control that changes the search policy, not only as extra agent-side computation. |
Более высокие усилия при рассуждении улучшают эту диагностическую настройку путем изменения политики исследования данных для обучения ⟦K0⟧.
Мы сравниваем исследовательского агента Claude Code Sonnet-5 на SWE-bench Verified при высоком и максимальном уровне рассуждений, сохраняя неизменными модель развертывания, целевую модель, подмножество бенчмарка, бюджеты и конвейер обучения и оценки. Согласно этой диагностике (Рисунок 5), максимальный уровень усилий повышает средний балл выбора по первым четырем сопоставимым попыткам с 35,5% до 44,0%, улучшает показатель первого кандидата с 25% до 36% и увеличивает исторический максимум с 44% до 49%. Официальный балл также возрастает с 35% до 52%, хотя эту разницу в рамках одного запуска не следует интерпретировать как полностью изолированную причинно-следственную оценку..
Профиль ресурсов проясняет механизм. По сравнению с высоким уровнем усилий, максимальный уровень усилий завершает на одну допустимую попытку меньше, но выбранный набор данных значительно больше: 149 записей для обучения вместо 50, 2,681 обучаемый ход помощника вместо 595 и вместо в стоимости Tinker в цикле кандидатов. Таким образом, результат согласуется с компромиссом между глубиной и широтой: более высокие усилия позволяют раньше найти более сильного кандидата и создать более ресурсоемкую программу обучающих данных, при этом сокращая количество кандидатов, которые укладываются в фиксированный бюджет..
Эффективная эволюция сочетает в себе обоснованные решения по работе с данными и дисциплинированный поиск.
По основным траекториям улучшения связаны с диагностикой целевой способности, обоснованием данных на основе сигналов валидации, приведением контроля в соответствие с оцениваемым поведением и сохранением надежных контрольных точек. Диагностика усилий по рассуждению дополнительно предполагает, что более глубокое построение данных может заменить широту поиска качеством кандидатов. В совокупности эти закономерности поддерживают исследования обучающих данных с замкнутым циклом, а не генерацию, основанную на имитации..
5.5 Первичный эксперимент по RSI
Обстановка.
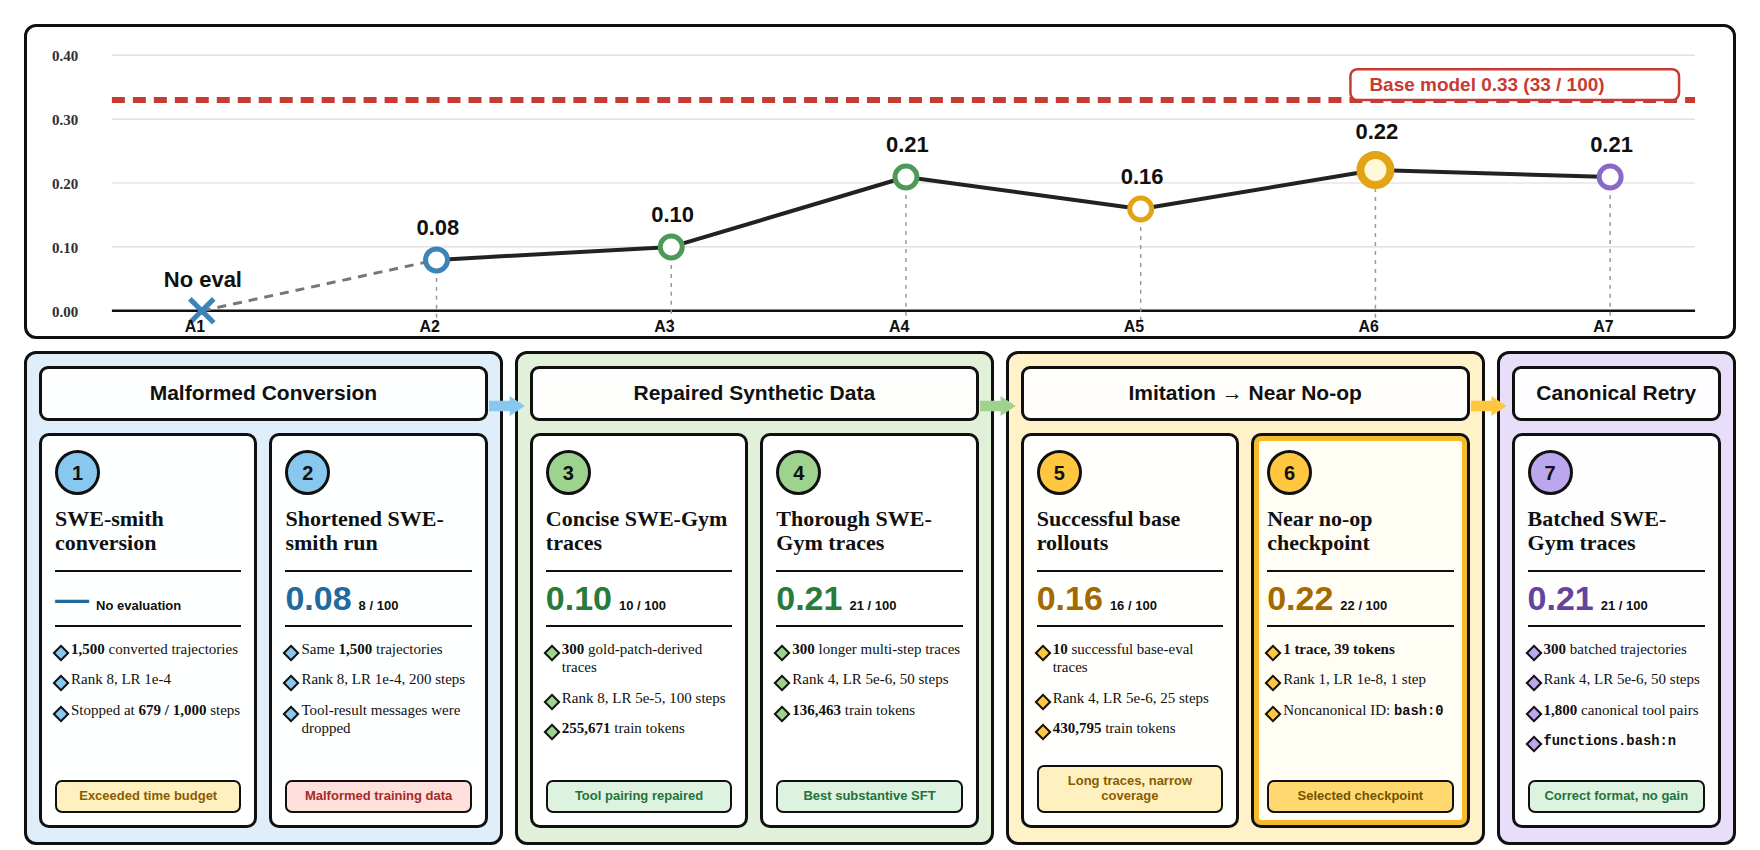
Мы проводим разведывательный эксперимент по RSI в рамках одного семейства вне основной матрицы. Инструментарий Claude Code, работающий на базе kimi-k2.6, выступает в роли агента-исследователя, целевой моделью является instruction-tuned moonshotai/Kimi-K2.6 на Tinker, а Claude Opus 4.8 используется как фиксированная модель развертывания. Кандидаты обучаются с помощью LoRA SFT и оцениваются через Mini-SWE-Agent посредством Harbor–E2B на фиксированном подмножестве из 100 задач SWE-bench Pro с параллелизмом 64 и ограничением в 200 шагов. Бэкенд использует контекстное окно в 32,768 токенов, ограничение промпта в 28,671 токен и до 4,096 выходных токенов. Запуск имеет бюджет 20 часов и $2,000, фактически затрачено 12.3 часа и ориентировочно $738.69. На рисунке 6 представлены оценки кандидатов в ходе выполнения..
Результаты.
Траектория демонстрирует явную эволюцию стратегии, но отсутствие эффективного улучшения модели. Агент сначала преобразует 1,500 решенных траекторий SWE-smith в полные диалоги помощника и инструмента и планирует 1,000 шагов с высоким learning rate, но останавливается на шаге 679 без оценки. Затем он сокращает тот же рецепт до 200 шагов, получая 8%; проверка показывает, что конвертер отбросил сообщения с результатами инструментов и создал некорректные данные для обучения. Следующие две попытки переключаются на 300 траекторий SWE-Gym, полученных из gold-patch, с исправленным сопряжением инструментов: краткие трассы набирают 10%, в то время как более длинные многошаговые трассы в сочетании с более низким learning rate и рангом LoRA улучшают результат до 21%. Затем агент извлекает 10 успешных развертываний неадаптированной модели в качестве данных для имитации, но их узкий охват снижает балл до 16%. Чтобы проверить, является ли само обучение деструктивным, он создает адаптер, почти не выполняющий операций, на основе одного примера из 39 токенов, одного шага, ранга 1 и пренебрежимо малого learning rate; это достигает 22% и выбирается. Последняя попытка возвращается к 300 траекториям SWE-Gym, объединяет команды в 1,800 канонических пар инструментов и меняет идентификаторы с форм типа bash:0 на functions.bash:n, но набирает 21%.
В заключение, хотя агент улучшил конвейер синтетических данных и повысил производительность с 8% до 21%, каждая контрольная точка остается ниже 33% неадаптированного эталона. Вероятно, это связано с тем, что целевая модель уже является способной инструктивной моделью на агентном бенчмарке, а текущих возможностей RSI исследователя недостаточно для обнаружения улучшающегося распределения обучения..
6 Обсуждение и ограничения
Официальная оценка еще не устанавливает адаптивную генерализацию.
Наша оценка отдает приоритет широкому охвату при значительных затратах на песочницу и обучение, используя один репрезентативный прогон для каждой настройки и фиксированные подмножества для четырех бенчмарков. Выбор контрольных точек и официальная оценка используют одно и то же подмножество задач, поэтому представленные баллы измеряют производительность в новых средах, но не обобщение на статистически отложенные задачи. Повторные испытания, закрытые для оценщика выборки и обновленные задачи необходимы для измерения стабильности и переносимости стратегий исследования агентных данных обучения. Личность исследователя также объединяет базовую LLM, агентный каркас и настроенные усилия по рассуждению, поэтому основная матрица сравнивает полные исследовательские системы, а не изолирует какой-либо один компонент..
7 Заключение
Мы представили RSIBench-Data, контролируемый бенчмарк для оценки исследовательских способностей, ориентированных на данные, которые необходимы для рекурсивного самосовершенствования в рамках фиксированного стека post-training. На примере четырех передовых агентов и шести бенчмарков агенты демонстрируют некоторые ключевые способности исследователей, работающих с данными: итерация улучшает первую успешную попытку в 58,33% случаев. Тем не менее, агенты не демонстрируют последовательного улучшения на основе обратной связи: среди поисковых процессов, которые продолжаются после достижения наилучшего наблюдаемого результата, 78,26% завершаются попыткой с более низким баллом, а в остальных случаях достигается лишь тот же пиковый показатель. Выбор исторически лучшего результата может защитить представленную контрольную точку от подобных регрессий, но это не делает лежащий в основе исследовательский процесс надежно прогрессивным. В совокупности эти результаты выявляют разрыв между способностью к открытиям и надежностью в том, как агенты преобразуют обратную связь в более эффективные стратегии формирования обучающих данных. Мы надеемся, что RSIBench-Data поможет в разработке более надежных агентов-исследователей, ориентированных на данные, для рекурсивного самосовершенствования, делая их исследовательский процесс измеримым и проверяемым..
Список литературы
- ⟦ Anthropic Claude code. Примечание: https://github.com/anthropics/claude-codeАгентный инструмент для программирования Цитируется: §4.1.
- ⟦ И. Бадертдинов, Ю. Голубев, Д. Михрин, М. Афанасьев, Д. Ковригин, М. Абрамов, А. Вацуренко, В. Тимофеев, М. Хабибуллин, Д. Хачатуров, Т. Садыков и А. Хорошилов SWE-rebench: автоматизированный конвейер для сбора задач и деконтаминированной оценки агентов в области программной инженерии. Внешние ссылки: 2505.20411 Цитируется: §2.
- ⟦ С. Барке, Дж. Куо и Н. Поликарпова AgentRx: диагностика сбоев агентов искусственного интеллекта на основе трассировок выполнения. Внешние ссылки: 2603.08806 Цитируется: §1.
- ⟦ Дж. Чен, Т. Ван, С. Мо, С. Мао, М. Ван, К. Го, А. Ю. Х. Чжан, Т. Шен, К. Ван, А. Яссин, М. Ду, В. Ши, С. Джи, К. Чо, М. Зенг, Д. Шен, З. Ван и Х. Вэй AI4Research: обзор искусственного интеллекта для научных исследований. Внешние ссылки: 2507.01903 Цитируется: §1.
- ⟦ К. Чен, Л. Цинь, Дж. Лю, Д. Пэн, Дж. Гуань, П. Ван, М. Ху, И. Чжоу, Т. Гао и В. Че На пути к эре рассуждений: обзор длинных цепочек мыслей для LLM, способных к рассуждению. Science China Information Sciences 69 (6), стр. 161101. Цитируется в: §1.
- ⟦ В. Чен, С. Ян, С. Ян, Т. Ша, К. Ли, З. Ван, Б. Сянь, Ф. Конг, В. Лю и Дж. Бьян Agent RL-Bench: могут ли LLM агенты проектировать агентное RL post-training?. Внешние ссылки: 2604.10547 Цитируется: §1, §2.
- ⟦ X. Deng, J. Da, E. Pan, Y. Y. He, C. Ide, K. Garg, N. Lauffer, A. Park, N. Pasari, C. Rane, K. Sampath, M. Krishnan, S. Kundurthy, S. Hendryx, Z. Wang, V. Bharadwaj, J. Holm, R. Aluri, C. B. C. Zhang, N. Jacobson, B. Liu, and B. Kenstler SWE-bench pro: могут ли LLM Agents решать долгосрочные задачи программной инженерии?. Внешние ссылки: 2509.16941, Link Цитируется в: §4.3⟧.
- ⟦ С. Й. Гадре, Г. Илхарцо, А. Фанг, Дж. Хайасе, Г. Смирнис, Т. Нгуен, Р. Мартен, М. Вортсман, Д. Гош, Дж. Чжан, Э. Оргад, Р. Энтезари, Г. Дарас, С. Пратт, В. Рамануджан, Й. Биттон, Дж. Маратхе, С. Муссманн, Р. Венку, М. Черти, Р. Кришна, П. У. Кох, О. Саух, А. Ратнер, С. Сонг, Х. Хаджиширзи, А. Фархади и Л. Шмидт DataComp: в поисках следующего поколения мультимодальных наборов данных. Внешние ссылки: 2304.14108 Цитируется: §1, §2.
- ⟦ К. Гао, С. Хонг, Б. Хе, Т. Лю, Ю. Шу и Х. С. Чжэн KARL: агент знаний посредством обучения с подкреплением для синтеза обучающих данных. Внешние ссылки: 2604.06008 Цитируется: §2.
- ⟦ Т. Го, С. Чен, Ю. Ван, Р. Чанг, С. Пей, Н. В. Чавла, О. Вист и С. Чжан Мультиагентные системы на основе LLM: обзор достижений и проблем. Внешние ссылки: 2402.01680 Цитируется: §1⟧.
- ⟦ Дж. Ху, Дж. Се, Ю. Су, З. Инь, К. Ли, Б. Ан и Х. Ли SEAL: саморазвивающиеся агенты и совместное обучение среды для обобщаемых мультиагентных систем на базе LLM. Внешние ссылки: 2603.02007 Цитируется: §2⟧.
- ⟦ Б. Хуан, Ю. Ю, Дж. Хуан, С. Чжан и Дж. Ма DCA-Bench: бенчмарк для агентов по курированию наборов данных. Внешние ссылки: 2406.07275 Цитируется: §2.
- ⟦ Н. Джайн, К. Хан, А. Г. Ли, В. Чжан, А. Албалак, Ю. Ван, В. Ким, Ч. Ли, Б. Абу-Салих, Ю. Ху, А. Хабиб, К. Раман, С. Нил, Н. Дзири, К. Кёйцер и И. Стойка R2E-Gym: процедурная генерация среды и гибридные верификаторы для масштабирования swe агентов с открытыми весами. Внешние ссылки: 2504.07164 Цитируется: §1, §1, §2⟧.
- ⟦ К. Э. Хименес, Дж. Янг, А. Веттиг, С. Яо, К. Пей, О. Пресс и К. Нарасимхан SWE-bench: могут ли языковые модели решать реальные проблемы github?. Внешние ссылки: 2310.06770 Цитируется в: §1, §2, §4.3⟧.
- ⟦ Ф. Канг, Х. Ли, А. Нгуен, М. Дабас, Дж. У. Ма, Ф. Сала, Д. Сонг и Р. Цзя Могут ли агенты-универсалы автоматизировать курирование данных?. Внешние ссылки: 2606.04261 Цитируется: §2⟧.
- ⟦ З. Хан, Э. Стенгель-Эскин, Дж. Чо и М. Бансал DataEnvGym: агенты генерации данных в средах учителей с обратной связью от учеников. В Международной конференции по представлениям обучения, Внешние ссылки: 2410.06215 Цитируется: §2⟧.
- ⟦ С. Ким, Дж. Сук, Х. Юэ, В. Вишванатан, С. Ли, И. Ван, К. Гаштеовски, К. Лоуренс, С. Веллек и Г. Нойбиг Оценка языковых моделей в качестве генераторов синтетических данных. Внешние ссылки: 2412.03679 Цитируется: §2.
- ⟦ Дж. Ли, А. Фанг, Г. Смирнис, М. Ивги, М. Джордан, С. Ю. Гадре, Х. Бансал, Э. Гуха, С. Кех, К. Арора, С. Г. Цзян, Г. К. Дзюгайте, М. Вортсман, Г. Илхарко, Л. Шмидт и Х. Хаджиширзи DataComp-LM: в поисках следующего поколения обучающих наборов для языковых моделей. Внешние ссылки: 2406.11794 Цитируется: §1, §2.
- ⟦ М. А. Меррилл, А. Г. Шоу, Н. Карлини, Б. Ли, Х. Радж, И. Беркович, Л. Ши, Дж. Ю. Шин, Т. Уолш, Э. К. Бьюкенен, Дж. Шен, Г. Йе, Х. Лин, Дж. Пулос, М. Ван, М. Нежурина, Дж. Джитсев, Д. Лу, О. М. Мастромихалакис, З. Сюй, З. Чен, Ю. Лю, Р. Чжан, Л. Л. Чен, А. Кашьяп, Дж. Услу, Дж. Ли, Дж. Ву, М. Ян, С. Бянь, В. Шарма, К. Сун, С. Диллманн, А. Ананд, А. Ланпутакхун, Б. Купа, К. Ху, Э. Гуха, Г. Х. С. Дрейман, Дж. Чжу, К. Краут, Л. Чжун, Н. Мюннигхофф, Р. Аманфу, С. Тан, С. Пимпалгаонкар, Т. Аггарвал, С. Лин, С. Лан, С. Чжао, Ю. Лян, Ю. Ван, З. Ван, К. Чжоу, Д. Хайнеман, Х. Лю, Х. Триведи, Дж. Ян, Дж. Лин, М. Шетти, М. Ян, Н. Оми, Н. Рауф, С. Ли, Т. Ю. Чжо, В. Лин, Ю. Дай, Ю. Ван, В. Чай, С. Чжоу, Д. Вахдани, З. Ше, Дж. Ху, З. Донг, Ю. Чжу, С. Цуй, А. Сайед, А. Колбейнссон, Дж. Ху, К. М. Риттинг, Р. Мартен, Ю. Ван, А. Димакис, А. Конвински и Л. Шмидт Terminal-bench: бенчмаркинг агентов на сложных, реалистичных задачах в интерфейсах командной строки. Внешние ссылки: 2601.11868, Link Цитируется: §1, §2, §4.3, §4.3.
- ⟦ OpenAI Codex CLI: легковесный агент для написания кода в терминале. Примечание: https://github.com/openai/codexАгент для написания кода на базе терминала Цитируется: §4.1.
- ⟦ Дж. Пан, С. Ван, Г. Нойбиг, А. Сур и Д. Фрид SWE-Gym: обучение агентов и верификаторов для разработки программного обеспечения. Внешние ссылки: 2412.21139 Цитируется: §1, §1, §2⟧.
- ⟦ А. Ку, Х. Чжэн, З. Чжоу, Ю. Янь, Ю. Тан, С. Ю. Онг, Ф. Хонг, К. Чжоу, К. Цзян, М. Конг, Дж. Чжу, Х. Цзян, С. Ли, К. Ву, Б. К. Х. Лоу, Дж. Чжао и П. П. Лян CORAL: на пути к автономной эволюции мультиагентных систем для открытых исследований. Внешние ссылки: 2604.01658 Цитируется: §2.
- ⟦ Команда Qwen Технический отчет Qwen3. Внешние ссылки: 2505.09388, Link Цитируется: §4.2.
- ⟦ Б. Ранк, Х. Бхатнагар, А. Прабху, С. Айзенберг, К. Нгуен, М. Бетге и М. Андрющенко PostTrainBench: могут ли LLM агенты автоматизировать LLM post-training?. Внешние ссылки: 2603.08640 Цитируется в: §1, §2.
- ⟦ Д. Рейн, Б. Л. Хоу, А. К. Стикленд, Дж. Петти, Р. Ю. Панг, Дж. Дирани, Дж. Майкл и С. Р. Боумен GPQA: бенчмарк вопросов и ответов уровня магистратуры, устойчивый к поиску в Google. Внешние ссылки: 2311.12022, Link Цитируется: §4.3⟧.
- ⟦ Дж. Шалев, Дж. З. Сонг, К. Хуанг, К. Аль-Хатер, М. Хамади, А. Гаттами, А. Босселут и А. М. Рахмани Обучение языковых агентов учиться на опыте. Внешние ссылки: 2601.16098 Цитируется: §2.
- ⟦ Й. Сонг, В. Сюн, Х. Чжао, Д. Чжу, В. Ву, К. Ван, К. Ли, В. Пенг и С. Ли AgentBank: на пути к обобщенным LLM агентам посредством дообучения на 50000+ траекториях взаимодействия. Внешние ссылки: 2410.07706 Цитируется: §2.
- ⟦ Лаборатория мыслящих машин Tinker: программный интерфейс обучения для дообучения языковых моделей. Примечание: https://thinkingmachines.ai/tinker/Управляемый программный интерфейс дообучения LoRA Цитируется: §4.2.
- ⟦ Б. Сяо, П. Лю и Ц. Лю Socratic-SWE: автономный маховик данных для автоматизированной разработки программного обеспечения. Внешние ссылки: 2606.07412 Цитируется: §2⟧.
- ⟦ И. Сюй, Д. Лу, З. Шэнь, Дж. Ван, З. Ван, И. Мао, К. Сюн и Т. Ю AgentTrek: синтез траекторий агентов посредством управляемого воспроизведения с использованием веб-руководств. Внешние ссылки: 2412.09605 Цитируется: §2.
- ⟦ Дж. Янг, К. Э. Хименес, А. Веттиг, К. Лирет, С. Яо, К. Р. Нарасимхан и О. Пресс SWE-agent: агентно-компьютерные интерфейсы обеспечивают автоматизированную разработку программного обеспечения. В материалах Тридцать восьмой ежегодной конференции по системам нейронной обработки информации, Внешние ссылки: Link Цитируется: §4.3⟧.
- ⟦ С. Яо, Н. Шинн, П. Разави и К. Нарасимхан -bench: бенчмарк для взаимодействия инструмента, агента и пользователя в предметных областях реального мира. В материалах Международной конференции по представлениям в обучении, Цитируется: §1, §2.
- ⟦ Д. Зан, З. Хуан, В. Лю, Х. Чен, Л. Чжан, С. Синь, Л. Чен, Ц. Лю, С. Чжун, А. Ли, С. Лю, Ю. Сяо, Л. Чен, Ю. Чжан, Дж. Су, Т. Лю, Р. Лонг, К. Шен и Л. Сян Multi-swe-bench: многоязычный бенчмарк для решения проблем. Внешние ссылки: 2504.02605, Link Цитируется: §4.3⟧.
- ⟦ Л. Чжан, С. Хэ, К. Чжан, Ю. Кан, Б. Ли, К. Се, Дж. Ван, М. Ван, Ю. Хуан, С. Фу, Э. Наллипогу, К. Лин, Ю. Данг, С. Раджмохан и Д. Чжан SWE-bench выходит в эфир!. Внешние ссылки: 2505.23419 Цитируется: §2.
- ⟦ С. Чжан, З. Чжан, К. Сонг, В. Чжоу, Дж. Лю, Дж. Хе, П. В. Ко и Л. Ван Q-Evolve: усиление контекстного качества в агентном обучении, основанном на опыте. Внешние ссылки: 2606.00458 Цитируется: §2.
Приложение
Appendix A Набор для оценки и репозитории исходных данных
Полный протокол оценки, используемый в основных экспериментах, приведен в таблице 4. Все агенты в рамках бенчмарка используют одинаковую выборку для оценки, протокол выборки, исполнитель, верификатор и настройки декодирования. В последнем столбце перечислены общедоступные репозитории с начальными данными или источники данных, доступные агентам-исследователям для формирования обучающего опыта..
| Benchmark | Evaluation items | Original size | Coverage | Evaluation runner | Metric | Seed repositories |
|---|---|---|---|---|---|---|
| SWE-bench Verified | 100 | 500 | Fixed subset, 20.0% | Mini-SWE-Agent | Resolved rate | SWE-smith; SWE-Gym; swe-factory |
| SWE-bench Multilingual | 100 | 300 | Fixed subset, 33.3% | Mini-SWE-Agent | Resolved rate | SWE-smith; SWE-Gym; swe-factory |
| SWE-bench Pro | 100 | 731 | Fixed subset, 13.7% | Mini-SWE-Agent | Resolved rate | SWE-smith; SWE-Gym; swe-factory |
| Terminal-Bench 2.0 | 89 | 89 | Full set | Terminus-2 | Task success rate | endless-terminals; tmax |
| GPQA Diamond | 100 | 198 | Fixed subset, 50.5% | Terminus-2 | Accuracy | synthetic-data-kit |
| AIME 2026 | 30 ( each) | 30 | Full set | Terminus-2 | Accuracy | synthetic-data-kit |
Appendix B Репрезентативные действия в рамках исследовательского цикла синтеза данных ⟦K0⟧
Приведенные ниже операции детализируют этапы цикла под управлением агента на рисунке 2(c). Они определяют репрезентативное пространство действий, а не обязательную модульную архитектуру: агент может реализовать любой подмножество, объединить несколько операций в одной процедуре или внедрить альтернативы, которые соответствуют контрактам бенчмарка по входным данным, целостности, обучению и оценке..
B.1 Диагностика потребности в следующих данных для обучения
Агент может классифицировать имеющиеся сбои по функциональным возможностям, типу ошибки, семейству задач, среде, инструментам, длительности взаимодействия или этапу выполнения. Он может отличать недостаток знаний от ошибок в рассуждениях, планировании, использовании инструментов, отслеживании состояния, восстановлении, верификации или завершении задачи, а также использовать поведение базовой модели или предыдущих попыток для оценки того, где дополнительное обучение принесет наибольшую пользу. Полученный диагноз определяет конкретную цель для следующего набора данных, вместо того чтобы рассматривать объем данных как решение..
Диагностика также позволяет сравнить предполагаемый урок предыдущего набора данных с поведением, которое фактически изменилось в результате обучения. Неудачная попытка может указывать на то, что исходная гипотеза о возможностях была неверной, что сгенерированные примеры не выражали предполагаемое поведение, что невалидные примеры прошли фильтрацию или что формат контроля не соответствовал целевому протоколу оценки. Эти альтернативы подразумевают различные доработки, даже если они приводят к одинаковому совокупному баллу.
B.2 Синтезировать целевой опыт обучения
Задачи и исполняемые состояния.
Агент может генерировать синтетические задачи, которые задействуют возможности, подразумеваемые его диагностикой. Для интерактивных задач он также может создавать начальное состояние, необходимое для их выполнения, включая файлы и репозитории, базы данных, состояния терминала или файловой системы, конфигурации инструментов или другие состояния среды. Сгенерированные задачи должны удовлетворять целевому контракту взаимодействия и демонстрировать поведение, которое может быть проверено фиксированной службой оценки..
Конструирование задач может варьироваться по охвату возможностей и составу, а не только по поверхностной формулировке. Агент может быть нацелен на конкретные типы ошибок, репозитории, инструменты или длительность взаимодействия; создавать контролируемые варианты существующих семейств задач; или комбинировать разрешенные общедоступные источники с вновь синтезированными экземплярами. Эти выборы определяют, какие области целевого поведения получают супервизию..
Успешные, неудачные и восстановительные траектории.
Для задач с длинным горизонтом планирования агент может генерировать траектории, содержащие действия, наблюдения, промежуточные состояния и сигнал завершения. Успешные или экспертные траектории демонстрируют поведение, которое приводит к верифицируемому результату. Неудачные траектории выявляют неверные вызовы инструментов, ошибочные планы, ошибки отслеживания состояния, преждевременное завершение или другие повторяющиеся типы сбоев. Траектории восстановления и исправления демонстрируют, как распознать ошибочное состояние, пересмотреть план и завершить задачу после получения новых данных..
Надзор не обязательно должен воспроизводить каждый шаг взаимодействия. Агент может обучаться на полных траекториях, выбранных точках принятия решений, финальных действиях, критических замечаниях, исправленных продолжениях или комбинациях этих представлений. Он также может решать, какие сообщения вносят вклад в функцию потерь при обучении, а какие остаются в качестве контекста. Релевантным проектным решением является выбор того, обучает ли представление поведению, требуемому целевым протоколом оценки, не перегружая при этом обучение нерелевантной историей взаимодействия..
B.3 Валидация и систематизация опыта обучения ⟦K0⟧
Верификация, фильтрация и дедупликация.
Кандидатные задачи и траектории могут быть проверены с помощью исполняемых сред, разработанных агентом или разрешенных вспомогательных верификаторов, согласования ответов, проверки схем, проверок на непротиворечивость или других разрешимых сигналов. Агент может отбрасывать примеры, которые являются недействительными, непроверяемыми, загрязненными, неправильно сформированными или не соответствующими заявленному результату, а также может удалять дубликаты, почти полные дубликаты или структурно избыточные примеры. Таким образом, вспомогательный верификатор или проверяющий механизм полезен не как изолированный компонент, а как механизм для принятия решения о том, какие предложенные данные достаточно надежны, чтобы влиять на модель..
Представление длинных траекторий.
Агентные траектории часто содержат длинные наблюдения, результаты работы инструментов, журналы тестирования и историю повторных взаимодействий. Агент может усекать, сжимать, суммировать, сегментировать или реконструировать эти контексты, сохраняя при этом состояние и доказательства, необходимые для принятия решений с учителем. Выбор представления включает в себя гранулярность действий с учителем, размещение наблюдений верификатора, обработку неудачных итераций и протокол, используемый для выражения завершения задачи..
Сложность, учебная программа и смесь.
Агент может оценивать сложность, используя метаданные задачи, длительность выполнения, сложность использования инструментов, результаты верификатора, расхождения в ответах генератора, производительность базовой модели или другие доступные сигналы. Он может использовать эти оценки для балансировки легких, средних и сложных примеров, упорядочивания их подачи при обучении или фокусировки на области, где модель с наибольшей вероятностью покажет улучшение. Решения о смешивании определяют пропорции семейств задач, категорий возможностей, типов траекторий, форматов супервизии и уровней сложности, включая баланс между успешным поведением, распознаванием ошибок, восстановлением, верификацией и завершением задачи..
B.4 Пересмотреть стратегию и управлять поиском
После каждого цикла совместного обучения и оценки агент может пересмотреть любое предыдущее решение. Он может заменить источник данных, сузить или расширить охват задач, изменить представление траектории, усилить вспомогательный модуль проверки данных, изменить пороги фильтрации, скорректировать интенсивность обучения или перебалансировать учебную программу и состав данных. Полезный пересмотр следует из диагностики предыдущей контрольной точки, а не из предположения, что еще одна попытка или больший набор данных обязательно помогут..
Эти доработки конкурируют за оставшиеся бюджеты времени выполнения и затрат на обучение. Агент должен решить, использовать ли многообещающий рецепт, исследовать другую гипотезу, вернуться к более ранней стратегии, сохранить исторически лучшую контрольную точку или остановиться. Распределение бюджета, откат, остановка и выбор финальной контрольной точки, следовательно, являются частью одной и той же итеративной политики.
B.5 Инстанцирование в различных семействах бенчмарков
Для бенчмарков по разработке программного обеспечения цикл может связывать состояние репозитория, интерпретацию проблемы, локализацию кода, генерацию патчей, выполнение тестов, проверку, верификацию и поведение при отправке. Для задач в терминале он может связывать начальное состояние файловой системы или инструментов, последовательности команд, изменения состояния, восстановление после неудачных команд, наблюдения при верификации и время завершения. Для ответов на научные вопросы и математики акцент может смещаться в сторону построения задач, цепочек рассуждений, проверки ответов, согласованности генераторов, контроля сложности и выбора того, какие этапы рассуждений требуют контроля..
Эти примеры иллюстрируют, почему маловероятно, что один универсальный рецепт синтетических данных будет равномерно переноситься на весь набор ⟦BROKEN_K0⟧. Стратегия выбора подходящих данных для обучения обусловлена целевым бенчмарком и текущими ошибками модели, в то время как сопутствующие механизмы SFT и оценки остаются неизменными ⟦BROKEN_K1⟧.
B.6 Примеры эволюции представителей
Мы выбираем три запуска с валидными официальными оценками, как минимум тремя валидными кандидатами и проверяемыми изменениями данных. Мы отображаем их указанные значения выбора и официальные баллы на Рисунке 7 и отслеживаем изменения стратегии, связанные с каждой траекторией, ниже.
Поздние изменения стратегии могут привести к дискретным приростам AIME.
Траектория AIME модели Claude Code Sonnet-5 показывает, что улучшение не обязательно должно быть постепенным. Первые восемь валидных кандидатов остаются слабыми, никогда не превышая показатель выбора в 15.00%. Девятый кандидат совершает скачок до 55.00%, а десятый достигает 55.83%; последующие кандидаты колеблются между 47.50% и 55.83%, не превосходя этот пик. Выбранная десятая контрольная точка официально получает 49.17%, что выше эталонного значения базовой модели в 30.00%, но ниже пика на этапе разработки. Эта траектория предполагает фазовый переход на фабрике данных: повторяющихся локальных исправлений до скачка было недостаточно, в то время как более поздняя стратегия выявила гораздо более мощный режим обучения рассуждениям. Сама по себе последовательность оценок не позволяет изолировать компонент, вызвавший скачок, поэтому мы рассматриваем это как процессуальное свидетельство качественного изменения стратегии, а не как однофакторную абляцию..
Траектории, согласованные с поведением, превосходят синтетические сокращения завершения в ⟦K0⟧ SWE-bench Профессиональный случай.
Чтобы проверить, обеспечивает ли успешное исправление среды достаточное обучение, мы сравниваем, как Codex gpt-5.6-sol представляет завершение задачи в SWE-bench Pro. Агент начинает с траекторий исправления, которые успешно выполняются, а затем использует сбои при оценке для создания учебного плана, который учит модель проверять свой финальный diff, верифицировать правки и отправлять задачу. Его показатели валидного выбора прогрессируют от 3.00% до 4.00%, 6.00%, 6.00% и 8.00%; вариант, обученный на синтетических завершающих действиях, регрессирует до 7.00%, тогда как обоснование завершающего поведения на реальных отправках из успешных траекторий достигает 9.00% и выбирается для официальной оценки. Этот контраст связывает более высокую производительность SWE с обучением, которое представляет полное использование инструментов и поведение по завершению задачи, а не только наличие корректного патча..
Восстановление после сбоев и целенаправленный контроль отделяют валидность от производительности в Terminal-Bench 2.0.
Траектория Terminal-Bench 2.0 модели Codex gpt-5.6-sol сначала создает кандидата, который терпит неудачу, прежде чем дать пригодный для использования балл отбора. После восстановления первый валидный кандидат достигает 7,87%. Более сфокусированный второй валидный кандидат повышает балл отбора до 15,73% и выбирается, в то время как последующая модификация, ориентированная на остановку, регрессирует до 13,48%. Выбранная контрольная точка официально получает 20,22% (18/89) по сравнению с 1,12% у базовой модели. Эта траектория разделяет три способности: восстановление неудачного прогона обучения создает валидного кандидата, сфокусированное обучение продвигает границу, а сохранение исторически лучшего результата предотвращает перезапись более сильной контрольной точки последующей целевой модификацией..